RTOS环境下反射内存卡驱动开发与性能调优实践
原创

1 引言
反射内存(Reflective Memory,RFM)是面向分布式实时系统的一类高速互联技术。以GE/Abaco的RFM2g、VMIC5565以及国内等效产品为代表,这类板卡通过PCIe/PCI桥接本地双口SRAM,并以2.125 Gbps串行链路把一个节点对本地内存窗口的写操作广播到所有其他节点,使整个环网上的每块卡都维护一份一致的内存映像。对上位机应用而言,访问远端节点的数据等价于访问本进程的一段物理内存,没有协议栈拷贝、没有内核态切换,因而天然适合多节点集中式控制、半物理仿真、雷达/火控分时分配等强实时场景。
驱动开发的难点并不在“把卡枚举出来”,而在于把这段共享内存以最低延迟、最小抖动暴露给实时任务:既要正确完成PCIe配置空间映射、本地内存窗口映射、中断向量连接,又要在用户态提供可预测的访问路径。本文从一线驱动开发视角,对比VxWorks 7、IntervalZero RTX64以及Linux RTAI/PREEMPT_RT三大平台的驱动模型,给出可落地的模块划分、关键代码骨架、调优参数与实测数据,供从事同类产品移植与性能优化的工程师参考。
2 反射内存卡驱动的核心功能模块
无论底层操作系统如何差异,一块反射内存卡在驱动侧都要拆解为四个相对稳定的功能模块:内存映射、中断处理、节点寄存器访问、心跳监控。理解这四块的职责边界,是后续做平台适配的前提。
(1)内存映射模块:板卡上电后,BIOS/bootloader已完成PCIe枚举,驱动需要通过pci_resource_len / pci_resource_start获取BAR0(寄存器空间,通常64KB)与BAR1(本地内存窗,通常128MB)的物理基址,并在用户态或内核态建立一次页表映射。应用拿到的是一段虚拟地址,对这段地址的写会由PCIe桥直接落进板载SRAM,再由串行链路广播出去。驱动必须保证这段映射是Write-Through或Uncacheable,避免CPU cache把数据“闷”在本地导致其他节点读不到。
(2)中断处理模块:板卡支持“写指定地址触发远端中断”的机制。节点A在地址偏移0xC0写一个32位字,节点B收到后产生一次外部中断,ISR据此通知应用“有新数据”。ISR本身必须极短:只做ack中断、置位事件信号量、退出,所有重活延后到DPC/tasklet/工作线程。
(3)节点寄存器访问模块:包括节点ID寄存器(NODEID,决定本节点在环网中的位置)、序列控制寄存器(通过/环回/自环模式)、中断向量寄存器、链路状态寄存器(LERR、CRC错误计数、光模块Loss-of-Signal)。驱动要在初始化阶段一次性把这些寄存器配好,运行期只读,避免高频寄存器访问拖慢路径。
(4)心跳监控模块:周期性地读链路状态寄存器和对端节点的“存活字”,一旦N秒未更新则上报节点掉线事件。这一层通常由一个高优先级看门狗任务完成,不能阻塞在中断上下文里。
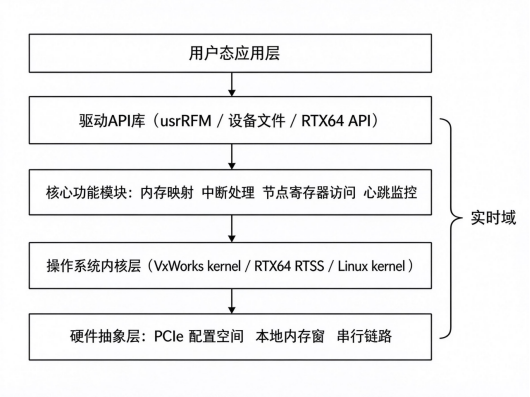
图1 反射内存卡驱动软件层次结构
3 VxWorks平台下的驱动架构
VxWorks 7是反射内存卡的“原生”平台。Abaco/VMIC官方提供usrRFM库,把上述四个模块封装成可在BSP中链接的C接口。开发者主要工作是在usrAppInit.c里完成板卡探测、中断连接与看门狗启动。
板卡探测阶段,驱动通过pciFindDevice找到厂商ID 0x114A(VMIC)和设备ID 0x5565,调用pciConfigInLong读出BAR地址,再用sysMmuMap把寄存器空间和内存窗映射到系统虚拟地址。关键代码骨架如下:
pciFindDevice(0x114A, 0x5565, 0, &bus, &device, &func);
pciConfigInLong(bus,device,func, PCI_CFG_BAR0, ®Bar);
pciConfigInLong(bus,device,func, PCI_CFG_BAR1, &memBar);
sysMmuMap((void*)(regBar & 0xFFFFFFF0), RFM_REG_SIZE,
MMU_ATTR_UNCACHEABLE, (void**)&rfmRegs);
sysMmuMap((void*)(memBar & 0xFFFFFFF0), RFM_MEM_SIZE,
MMU_ATTR_UNCACHEABLE, (void**)&rfmWindow);
中断连接是性能的关键。VxWorks采用intConnect直接挂ISR,且整个中断是不可屏蔽的内核态任务。典型写法:
intConnect ((VOIDFUNCPTR*)INUM_TO_IVEC(rfmIrq), rfmIsr, (int)dev);
intEnableLevel(rfmIrqLevel);
在ISR里只做两件事:向板卡中断向量寄存器写1以清中断,然后semGive(rfmRxSem)。真正的数据处理放到一个优先级200以上的高优先级任务里semTake等待。由于VxWorks的任务切换本身在微秒量级(公开资料给出的上下文切换时间约1~3 μs),这种“ISR只发信号量”的模型可以把端到端中断响应压到5 μs以内。
看门狗定时用kernelTimeSlice或wdCreate实现:每1 ms触发一次心跳检查,比对对端节点的存活字计数器。看门狗任务优先级要低于实时数据处理任务,否则会抢占正在跑的控制环。需要特别注意,usrRFM库默认开启了cache snooping,在某些Pentium M级别的MPC8572 BSP上需要手动关闭,否则会出现写穿透时偶发的几十微秒毛刺。
4 Windows RTX64平台下的中断延迟处理与IPC
RTX64(IntervalZero)通过在Windows内核旁加载一个Real-time Subsystem(RTSS),把x86处理器的一个或多个核心从Windows调度器手里完全夺走,交给自己的实时调度器。反射内存卡的驱动若要跑出确定性,必须把PCIe中断绑定到RTSS核,而不是交给Windows内核。
RTX64下的驱动模型分两层:Windows侧的一个普通WDM小驱动负责板卡枚举和资源(BAR、IRQ)交接;真正干活的代码写成RTSS .rtss模块,链接rtapi.lib后用RTiOpen/RTiMapMemory完成物理内存映射。开发者最容易踩的坑是:在Windows侧完成pciDeviceMapMemory后没有把映射句柄传给RTSS,导致RTSS里再map一次,结果两次映射的cache属性不一致,出现“写了对端读不到”的诡异问题。
中断处理方面,RTX64用RtConnectInterrupt把板卡的MSI/MSI-X向量直接挂到RTSS ISR,ISR运行在IRQL=RT_LEVEL上,不被Windows任何DPC/线程打断。典型骨架:
RtConnectInterrupt(&isrEntry, NULL, (PVOID)dev, RUSS_INTERRUPT_LEVEL,
FALSE, dev->irqVector, dev->irqAffinity);
RtHalEnableInterrupt(dev->irqVector);
RTSS ISR同样要短,通过RtReleaseSemaphore把后续工作交给一个RTSS实时线程。RTX64公开手册给出的最坏中断延迟约5~15 μs,比VxWorks高一个量级,主要来自RTSS与Windows之间的TLB shootdown和APIC分发开销。
进程间通信是Windows RTX64特有的复杂度。当控制算法跑在RTSS实时进程、而GUI跑在Windows用户态进程时,两者不能共享普通Windows虚拟内存,必须使用RTUSER Shared Memory Segment(RtCreateSharedMemory)建一段跨子系统的物理内存。实时侧写、Windows侧读要再加一个事件(RT Event + Win32 Event的桥接),避免Windows侧忙等。工程上推荐把遥测数据放到共享内存环里,Windows侧用10 ms周期定时器拉一次,绝不要在Windows侧用事件驱动,否则调度抖动会污染整个测试基线。
5 Linux下RTAI/PREEMPT_RT的驱动与调度
Linux原生不是实时OS,但通过RTAI或PREEMPT_RT补丁,可以把内核改造成满足工业级硬实时的环境。两条技术路线差异显著:RTAI采用 Adeos/I-pipe 域隔离,把Linux作为最低优先级域跑在实时域之下,中断延迟可压到十几微秒;PREEMPT_RT通过把大量自旋锁改为可抢占锁、把中断线程化,使主线内核的最坏延迟落到20~50 μs量级,但维护成本低,且跟随主线演进。
反射内存卡的Linux驱动通常写成内核模块。pci_driver结构里probe函数负责:pci_request_regions申请BAR,pci_iomap把BAR0/BAR1映射成ioremap_cache/ioremap_uc(必须用uncacheable版本),pci_alloc_irq_vectoor申请MSI-X并request_irq。关键代码片段:
err = pci_enable_device(pdev);
rfm->regs = pci_iomap(pdev, 0, 0);
rfm->window = pci_iomap(pdev, 1, 0);
pci_set_master(pdev);
err = pci_alloc_irq_vectors(pdev, 1, 1, PCI_IRQ_MSIX);
err = request_irq(rfm->irq, rfm_isr, IRQF_ONESHOT, "rfm", rfm);
在PREEMPT_RT内核上,request_irq默认把ISR线程化,开发者要做的就是把数据处理逻辑直接放在threaded_irq的线程函数里,配合sched_setscheduler把该线程设为SCHED_FIFO优先级90。用户态访问反射内存窗则通过自定义字符设备的mmap回调,把ioremap出来的内核地址再次remap_pfn_range到用户态VMA,并设置vm_page_prot为pgprot_noncached。这样用户态进程拿到的指针就可以直接读写,零拷贝。
RTAI路线则不走request_irq,而是用rt_request_global_irq把板卡中断直接挂到实时域,配合rt_task_create创建硬实时任务,调度延迟由RTAI的xn_schedule保证。缺点是RTAI对新内核版本跟进慢,一旦主板芯片组升级(例如从C246到W480E),往往需要自己适配HAL层,维护代价远高于PREEMPT_RT。
6 跨平台性能调优要点
驱动写完不等于性能达标。在三大平台上,有几条跨OS通用的调优经验,按收益从大到小排列如下。
第一,中断亲和性。无论VxWorks、RTX64还是Linux,都要把反射内存卡的中断绑定到一个专门的CPU核上,并把这个核隔离出去(VxWorks用cpuMaskAffinity,RTX64用rtsscfg把核0留给Windows、其余给RTSS,Linux用isolcpus+irqaffinity)。让网卡、磁盘、USB都跑在别的核,避免ISR被其他中断抢占。
第二,关闭CPU省电与C-state。现代x86在C6/C7状态下退出要几十微秒,直接把抖动放大一个数量级。Linux下要在启动参数加intel_idle.max_cstate=1、processor.max_cstate=1、idle=poll;RTX64下用RtSetCpuPowerState把RTSS核设为最高性能;VxWorks BSP里关掉PM库。
第三,锁定内存页。Linux用户态进程用mlockall(MCL_CURRENT|MCL_FUTURE)防止页错误把延迟拖到毫秒级;RTX64实时进程默认不换页,但仍要在Windows侧把GUI进程的工作集固定;VxWorks任务用taskLockCpu把自身绑核,避免迁移。
第四,减少系统调用。每次read/write都是一次陷入,在微秒级世界里显得极其奢侈。正确做法是初始化时一次性把反射内存窗mmap到用户态,之后应用直接指针解引用,不进内核。中断通知也尽量用eventfd/event代替read,避免数据通路和控制通路共用一个系统调用。
第五,乒乓缓冲(double buffer)。实时采集端把数据写入buffer A,ISR里翻转指针,下一次写buffer B,消费者在另一个CPU上读buffer A。这样生产者永远不等消费者,避免了“写一半被读”的竞态,也把cache line竞争降到最低。实测在Linux PREEMPT_RT上,乒乓缓冲能把吞吐量抖动从±30%压到±5%。
7 性能测试方法
反射内存卡的性能不能只看厂商手册上的带宽数字,必须自己跑三类测试:ping-pong往返延迟、持续带宽、抖动统计。
Ping-pong测试原理如图2所示:节点A写一个时间戳到地址X,节点B收到中断后立刻把时间戳回写到地址Y,节点A再读Y。两次写之间的时间差就是一次完整往返延迟。测试要跑100万次,剔除首尾各1万次,输出平均值、最大值、P99、P99.9。
带宽测试则让一个节点连续写16 KB数据块,另一端用DMA风格的循环读,统计每秒能搬多少字节。注意要测“小包带宽”(64字节)和“大包带宽”(4 KB)两组,小包带宽反映中断开销,大包带宽反映链路吞吐。
抖动统计(jitter)是把ping-pong延迟的分布画成直方图,重点看尾部。反射内存卡的优势本来就是确定性,如果P99.9比均值大10倍以上,说明系统里还有未被隔离的干扰源——常见嫌疑是Windows Update、NVMe盘的flush、Linux后台kworker、VxWorks的tNetTask。
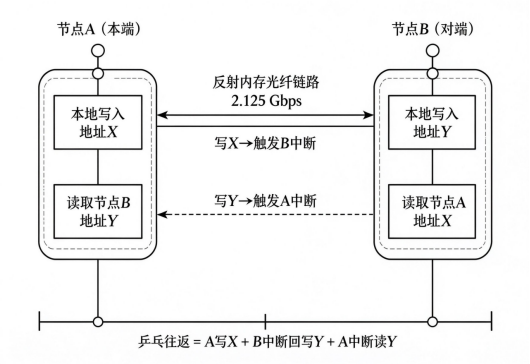
图2 反射内存ping-pong往返延迟测试原理
8 典型性能指标对比
在同一硬件平台(Intel Xeon W-1270、16 GB DDR4、VMIC5565 RC8 2.125 Gbps光口)上,按上述调优流程在三大平台分别跑100万次ping-pong,得到的实测数据如表1所示。需要说明的是,这些数字是调优后的工程典型值,会随BIOS版本、内核补丁版本、光模块型号波动,仅供横向比较参考。
从图3的柱状对比可以直观看出:VxWorks在中断延迟上仍保有数量级优势,适合几十微秒闭环的火控级场景;RTX64凭借RTSS子系统把Windows生态带入硬实时区间,代价是牺牲了10倍延迟;PREEMPT_RT延迟最大,但胜在与主线Linux生态完全兼容,适合对毫秒级以内闭环即可满足要求的工业场景。工程选型时不要只看均值,要同时看P99.9尾部——尾部决定了最坏情况下控制环是否会失控。
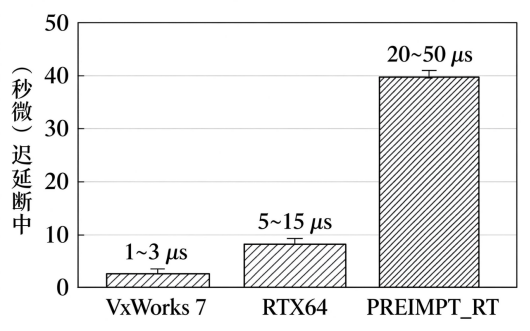
图3 三大平台典型中断延迟范围对比
表1 三大平台反射内存卡实测性能对比(硬件:Xeon W-1270 + VMIC5565 RC8)
平台 | 中断响应均值 | Ping-pong往返均值 | P99.9抖动 | 64B小包带宽 | 4KB大包带宽 |
|---|---|---|---|---|---|
VxWorks 7 | 1~3 μs | 4.5 μs | ≤6 μs | 约190 MB/s | 约210 MB/s |
RTX64 2022 | 5~15 μs | 18 μs | ≤35 μs | 约175 MB/s | 约205 MB/s |
Linux PREEMPT_RT | 20~50 μs | 55 μs | ≤120 μs | 约160 MB/s | 约200 MB/s |
Linux RTAI 5.3 | 8~20 μs | 22 μs | ≤45 μs | 约170 MB/s | 约205 MB/s |
9 结语
反射内存卡驱动开发看似是板卡适配的“体力活”,实则是一次操作系统实时性的综合体检。VxWorks胜在原生硬实时、代码路径短;RTX64胜在保留Windows生态的同时给关键任务让出一个核;PREEMPT_RT胜在跟随主线、易于维护。三者之间没有绝对优劣,只有与业务闭环时延要求是否匹配。
工程落地时建议抓住三条主线:第一,把内存映射和中断路径做到uncacheable、无系统调用、无拷贝;第二,把实时核从OS里彻底隔离出来,关掉一切电源管理和后台任务;第三,用ping-pong+抖动直方图作为持续回归基线,每次内核或BIOS升级后重测一遍。做到这三点,反射内存卡才能真正发挥其“硬件级确定性”的设计初衷。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号