REWS核心模块(一):流量采集与元数据提取
原创
REWS核心模块(一):流量采集与元数据提取
原创
慧贝行
发布于 2026-10-16 12:07:19
发布于 2026-10-16 12:07:19
一、上线前方案会上的三个运维问题
近期与售前同事到一所多校区高校做上线前方案确认,信息中心负责运维的工程师关心三件事。
- 设备安装是否需要断网。
- 校园网几个校区及服务器区的流量能否全部覆盖。
- 部署之后如何确认设备正在采集。
REWS核心模块(一):流量采集与元数据提取
这三个问题都落在落地环节:选型阶段技术负责人关注技术路线,设备交付后则由运维使用,运维关注的是改动大小、覆盖是否完整、状态是否可见。流量采集与元数据提取模块同时对应这三个问题,它决定采集设备如何接入现有网络、可捕获哪些流量、输出什么数据。以下按现场最常问的顺序,拆解这一模块。
二、接入形态:旁路镜像与探针,两类数据源进入同一系统
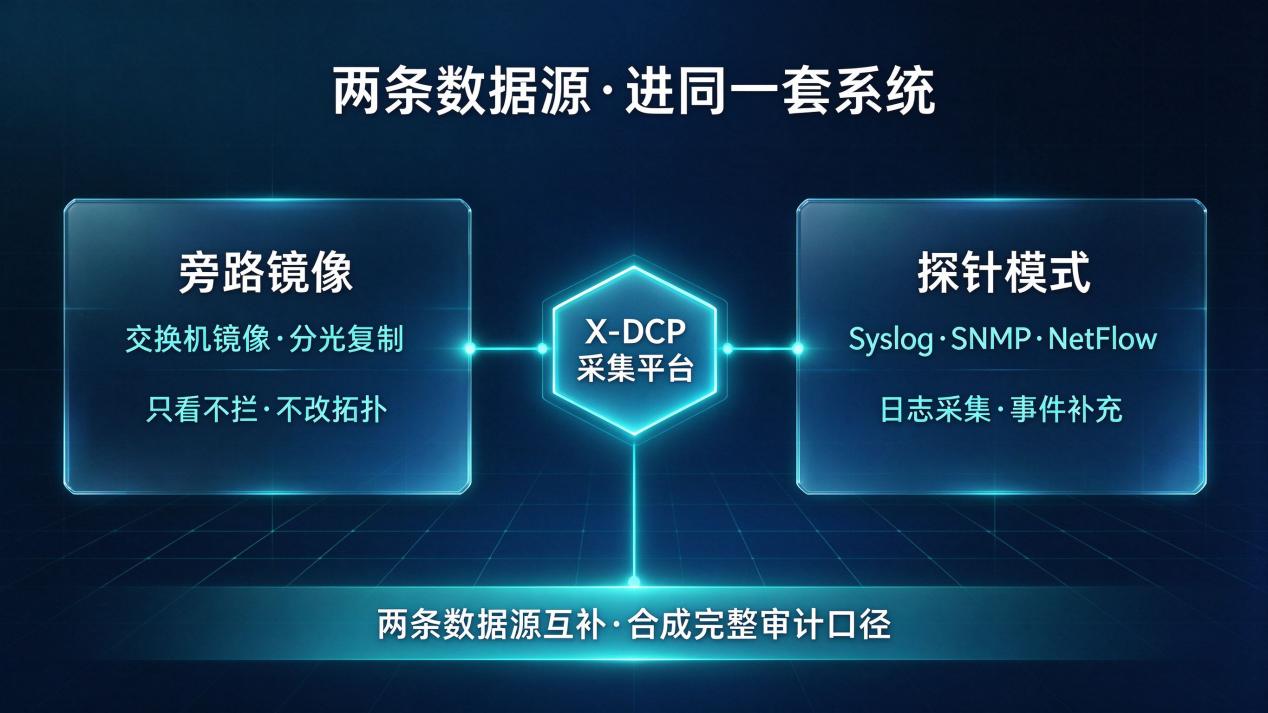
REWS的采集由数据采集平台(X-DCP)承担,接入方式有两种。
1、非探针模式,也是此类项目中的常见选择:交换机将某个端口的流量镜像给采集器,或用分光器从光链路复制流量。采集器只观察不拦截,不串入转发路径,也不占用业务服务器资源。旁路接入不改动现有拓扑,业务系统无需停机窗口,开头提到的断网问题由此得到解答。
2、探针模式,走日志采集:通过Syslog、SNMP、NetFlow等方式,将服务器、网络设备、安全设备上的日志接入系统。两类数据源互补,流量侧呈现会话与行为,日志侧补齐设备自身的事件记录,二者合并构成完整的审计口径。
REWS核心模块(一):流量采集与元数据提取
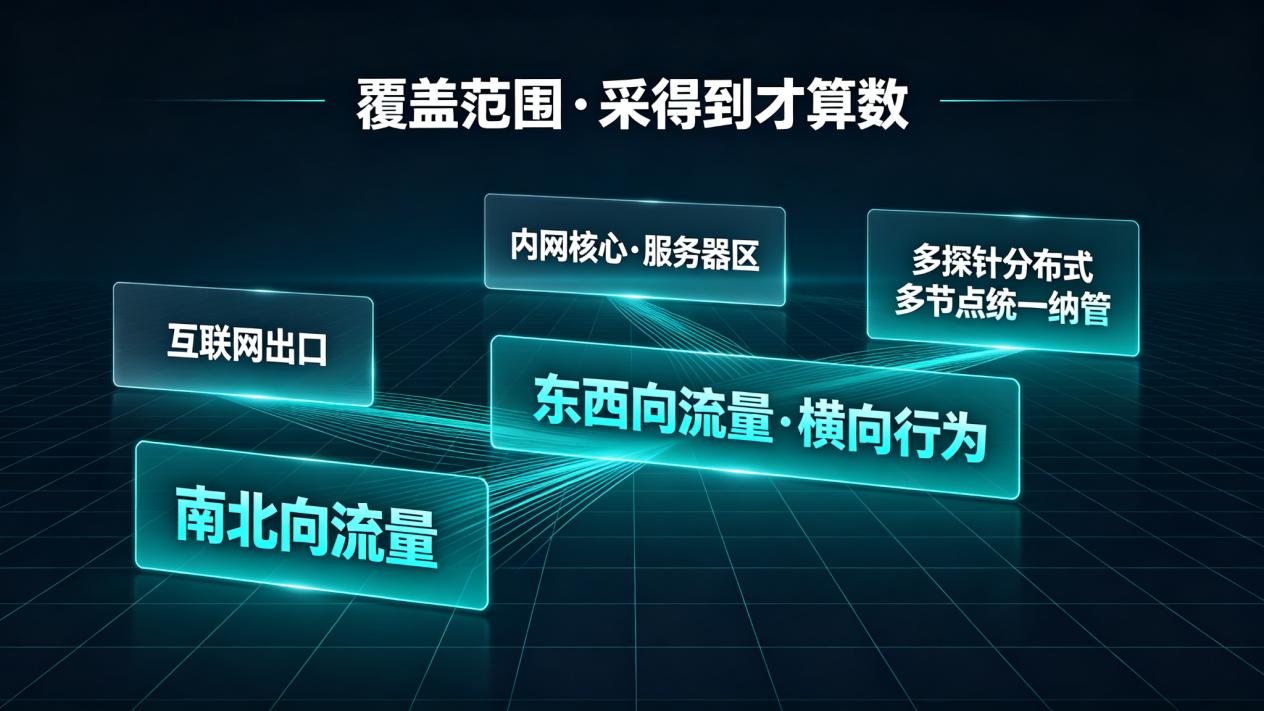
覆盖范围是运维更关注的部分。镜像口或分光点的位置决定可采集的范围:放在互联网出口,覆盖南北向流量;放在内网核心,覆盖主机之间的东西向访问。横向渗透、内网主机被控后的横向扫描,这类行为几乎全部发生在东西向流量中,仅关注出口的采集方案在此存在盲区。多校区单位可采用多探针分布式部署,各出口、各机房分别布设采集点,在系统设置中以添加节点的方式纳入同一平台统一纳管。
三、采集状态:首页可见
设备接入之后,运维的下一个问题通常是:如何确认它在正常工作
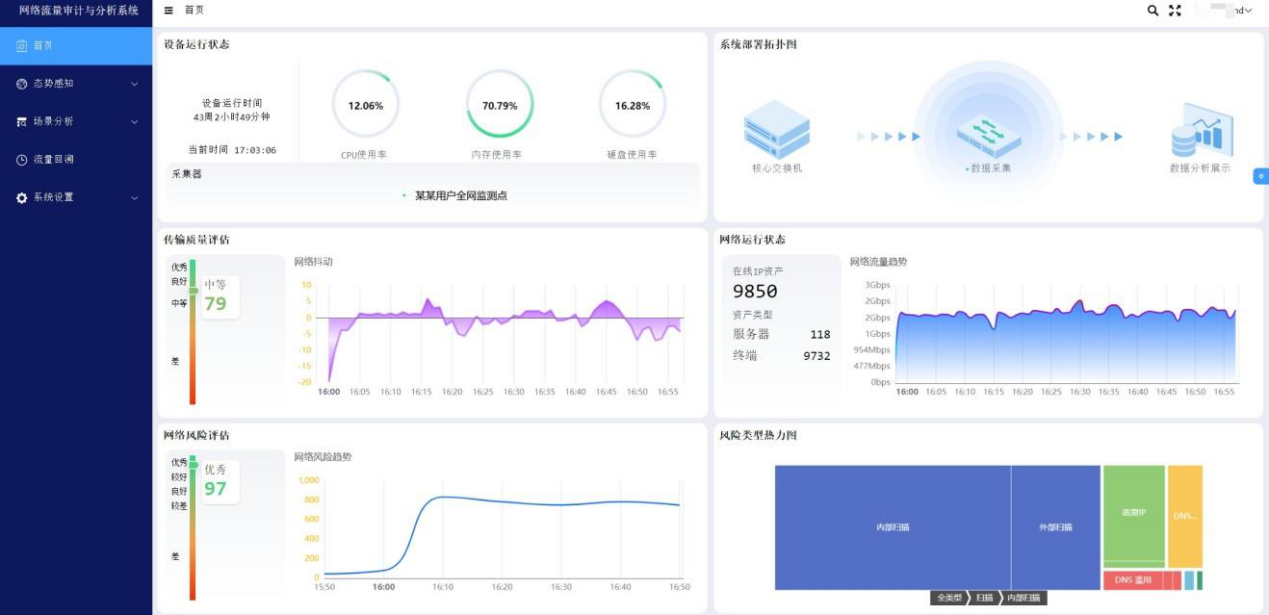
1、系统首页的设备运行状态即给出答案:采集器指示灯绿色表示正常工作,红色表示未正常工作;数据采集持续闪烁绿灯代表正在实时采集流量,状态转为灰色说明当前未采到流量,需检查采集器。
2、首页同时给出网络传输健康度与网络风险健康度,前者结合TCP延迟、网络抖动、重传、HTTP延迟量化打分。这些指标本身就是采集模块的输出:重传率、延迟、抖动等数值,需先由采集侧算出每条TCP会话的重传次数与RTT,才能汇总成曲线。采集一旦中断,曲线随即下降,运维无需登录后台查阅日志,从首页即可判断链路是否正常。
REWS核心模块(一):流量采集与元数据提取
四、一级加工:从报文到按维度切分的聚合索引
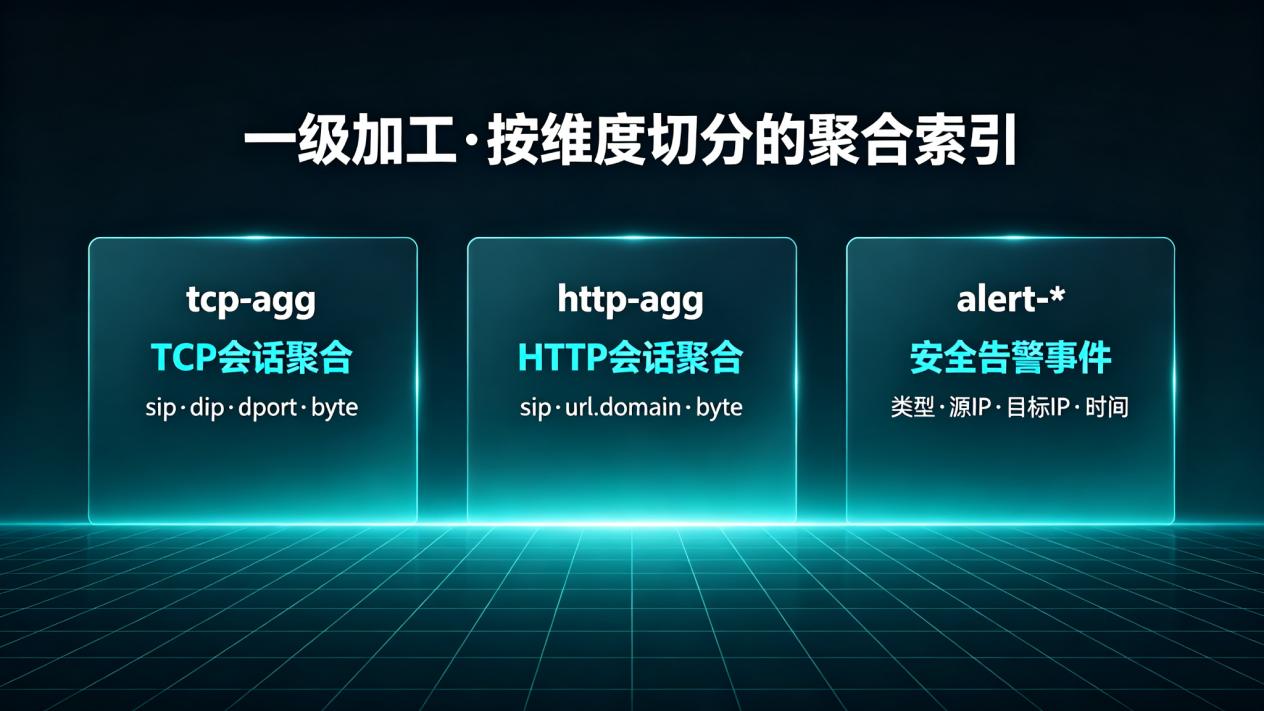
采集器在入口完成二至七层协议解析后,先在采集侧做一遍加工:过滤、聚合、排序、统计,不将原始字段直接推给分析层。落到存储与检索上,产出物是按维度与协议切分的索引:TCP会话进入tcp-agg-,HTTP会话进入http-agg-,告警事件归入alert-*,agg即聚合(aggregate)。
加工之后,元数据提取成为可查看的对象:
索引类型 | 加工维度 | 常用字段示例 | 能回答的问题 |
|---|---|---|---|
tcp-agg-* | TCP会话聚合 | sip、dip、dport、byte | 哪台主机访问了哪个端口、流量多大 |
http-agg-* | HTTP 会话聚合 | sip、url.domain、byte | 哪台主机访问了哪个域名 |
alert-* | 安全告警事件 | 告警类型、源IP、目标IP、时间 | 哪类风险、从哪来、什么时候发生 |
对采购与运维而言,这一设计的意义在于数据形态:采集侧产出的是按维度排好的会话字段表,而非大量待解析的原始文件。后续的检索、报表与关联分析都在这张表上展开。
REWS核心模块(一):流量采集与元数据提取
五、字段的使用方式:检索与钻取
字段表的使用方式较为直接:
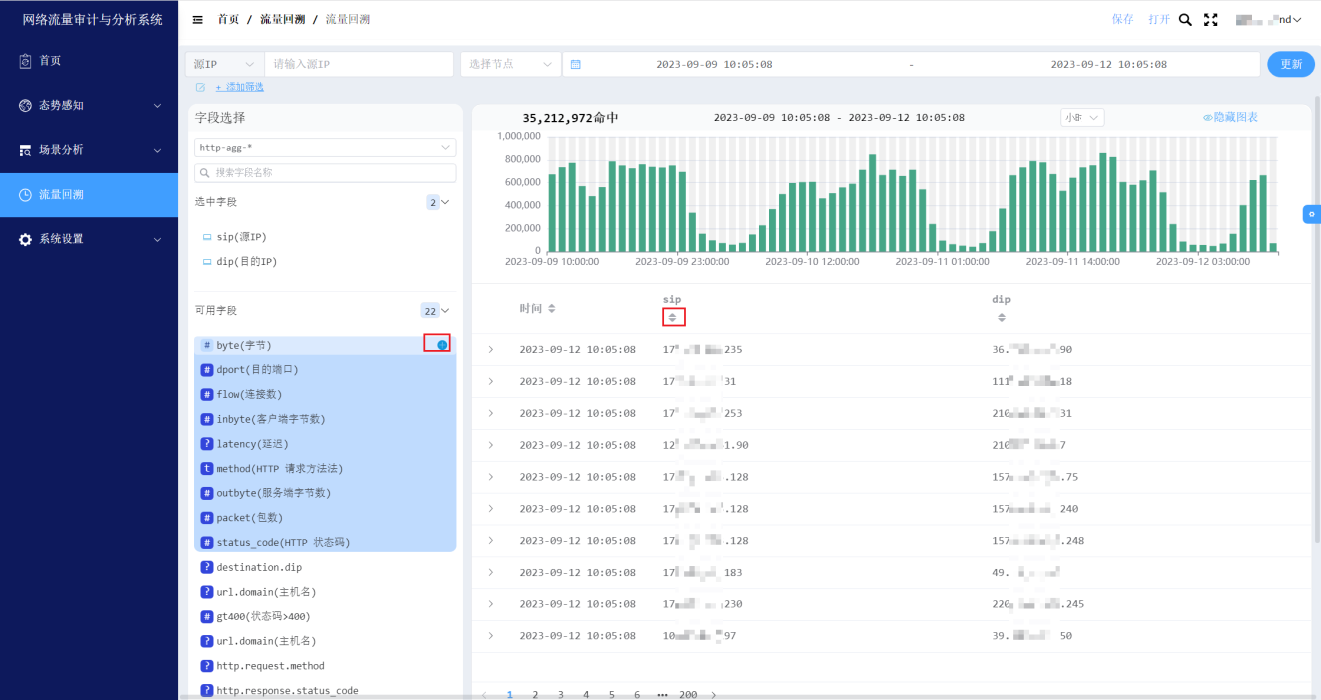
1、在流量回溯页面选择索引(如tcp-agg-、http-agg-)与字段,多个条件用AND、OR、NOT组合。
2、查询某台主机访问过的443端口会话,写sip:192.168.1.92 AND dport:443;查询一个网段,写sip:10.40.2.0 TO 10.40.2.255。
3、查询访问某域名的主机,切到http-agg-*按url.domain过滤。搜索类型组合覆盖IP、端口、域名、IP+端口、域名+源IP几种。
钻取是字段表更实用的一面,查到某个端口后,可按该端口继续下钻,将使用该端口的主机与各自流量单独列出。系统长期保存会话记录、协议解析、关联分析与告警日志,存储配置保证数据留存六个月。
这项能力在采购选型时容易被忽略,实际使用中却很关键:排查人员无需编写解析脚本,也无需报文解析经验,按字段输入条件即可即时获得结果。
REWS核心模块(一):流量采集与元数据提取
六、现场验证:模块解决的实际问题
回到那所多校区高校。出口与服务器区各布采集点,出口覆盖南北向,服务器区覆盖东西向。一次排查中,某台终端被通报存在异常外联,运维按sip过滤加时间片,列出该主机该时段的会话,对端地址、目的端口、上下行字节逐行排开,数分钟内定位到目标与影响范围。
REWS核心模块(一):流量采集与元数据提取
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号