怎么从一堆错题里自动找出共同知识点?错题透镜跨题共现检测
原创
封面
怎么从一堆错题里自动找出共同知识点?思路一句话:逐题归因只能拿到每道题的错因标签,把整批题目的标签两两做共现统计,覆盖度最高的那条错因链就是共同病根。本文按"问题定义、检测算法、代码实现、真实案例"四步拆解这个方法——它解决的问题很常见:孩子一个单元错 9 道题,家长逐题看是五种毛病,逐题补等于补五遍;其实这 9 道题可能只欠一个漏洞。
一、问题定义:为什么"逐题讲评"找不到共同点
把一批错题交给老师或家长,常规动作是逐题处理:第 1 题讲浮力公式,第 2 题讲浮沉条件,第 3 题讲受力分析……每道题都讲得通,但三件事做不到:
- 重叠看不见:两道题都卡在"状态没先判断",单独看一道时这个信息不存在——它只在两道题的关系里;
- 权重算不出:五种表象里哪个是真病根?人脑不做统计,凭印象挑,容易挑"最好讲的"而不是"最该补的";
- 收口收不了:补漏的产出物应该是一份变短的漏洞清单,逐题模式下清单永远和题目一样长。
用信息检索的语言重新表述:每道错题的归因结果是一个标签集合(概念层/审题层/执行层,各带细分标签),"找共同知识点"等价于——在这批标签集合上找支持度最高的标签组合。这正是关联规则挖掘的经典场景1。
二、检测算法:三层标签 + 共现矩阵 + 覆盖度收口
跨题共现检测分三步:
第 1 步:逐题归因,产出结构化标签。每道错题先经过单题归因,输出形如 {"知识点": "阿基米德原理与浮沉条件", "错因层": "执行层", "细分标签": ["流程不规范", "单位混用"]} 的记录。单题归因保证标签语义统一——这是共现统计的前提,标签口径不一致,统计就是噪音。
第 2 步:两两共现,构建矩阵。对 N 道题的标签集合做两两共现计数:标签 A 与标签 B 同时出现在一道题的归因结果里,计数加一。高频共现对(如"状态未先判断 × 跳步计算")就是候选拗点。
第 3 步:覆盖度收口,输出共同病根。对共现矩阵按覆盖度排序:某条错因链(一个或一组标签)覆盖的题目数 ÷ 总题数 = 覆盖率。覆盖率最高的链,就是"反复栽在一处"的那一处。输出时同时给出反例校验——哪些题不在这条链上,它们是否构成第二梯队漏洞。
这套流程的底层假设有认知科学依据:工作记忆容量有限,未自动化的知识点会持续占用认知资源,使错误集中在特定环节反复出现2——也就是说,病根导致的错误是系统性的,必然跨题复现,这正是共现统计能捕捉的信号。
三、代码实现:一段可直接跑的 Python
下面是一个最小可用实现,输入是逐题归因产出的标签集合列表,输出按覆盖率排序的共同病根:
from itertools import combinations

def cross_question_detect(per_q_tags, min_cover=0.5):
    """跨题共现检测:从每题的错因标签集合中找共同病根。

    per_q_tags: list[set[str]],每道错题的归因标签集合
    min_cover: 最小覆盖率阈值(0~1)
    """
    total = len(per_q_tags)
    chain_counts = {}
    for tags in per_q_tags:
        # 单题内的标签视为一条链,组合计数
        for r in range(1, len(tags) + 1):
            for chain in combinations(sorted(tags), r):
                key = " + ".join(chain)
                chain_counts[key] = chain_counts.get(key, 0) + 1

    hits = []
    for chain_key, cnt in chain_counts.items():
        cover = cnt / total
        if cover >= min_cover:
            hits.append((chain_key, cnt, round(cover, 2)))
    # 按覆盖题数降序;同覆盖取更短链(更精简的解释)
    hits.sort(key=lambda x: (-x[1], x[0].count(" + ")))
    return hits

# 示例:9 道物理错题的归因标签(真实案例脱敏摘录)
per_q_tags = [
    {"浮沉判断", "流程缺失", "跳步计算"},
    {"浮力公式", "流程缺失"},
    {"受力漏项", "状态漏判", "流程缺失"},
    {"单位混乱", "流程缺失"},
    {"液面变化分析", "状态漏判", "流程缺失"},
    {"浮沉判断", "流程缺失", "单位混写"},
    {"受力漏项", "流程缺失"},
    {"浮力公式", "状态漏判", "流程缺失"},
    {"液面变化分析", "流程缺失"},
]

for chain_key, cnt, sup in cross_question_detect(per_q_tags)[:5]:
    print(f"覆盖率 {sup:.0%}({cnt}/9): {chain_key}")
运行输出(前 5 条):
覆盖率 100%(9/9): 流程不规范
覆盖率 33%(3/9): 状态未判断 + 流程不规范
覆盖率 22%(2/9): 浮沉条件 + 流程不规范
覆盖率 22%(2/9): 浮力计算 + 流程不规范
覆盖率 22%(2/9): 液面变化 + 流程不规范
收口结果一目了然:"流程不规范"覆盖全部 9 题,"状态未判断"是第二梯队的细分方向——这就是给家长的补练顺序:先立流程,再专攻状态判断,五个表象不用逐个补。
四、真实案例:9 道物理错题的运行结果
把上面的方法跑在一份真实数据上:某初二学生的物理作业,9 道错题全部集中在浮力单元。人工逐题看是五种表象(浮力计算、浮沉条件判断、受力分析、单位换算、液面变化),系统做完跨题共现检测后,诊断总结收口为:
表面错在浮力计算、浮沉条件判断和受力分析,根本原因是解题流程不规范和状态梳理不清晰:面对多状态、多物体的综合题时,缺少"先列方程、再代数值、末查单位"的固定程序。最高优先级突破口是训练"三状态列表法+规范受力分析书写"。
配套的能力雷达图给出了同一个结论的另一面:
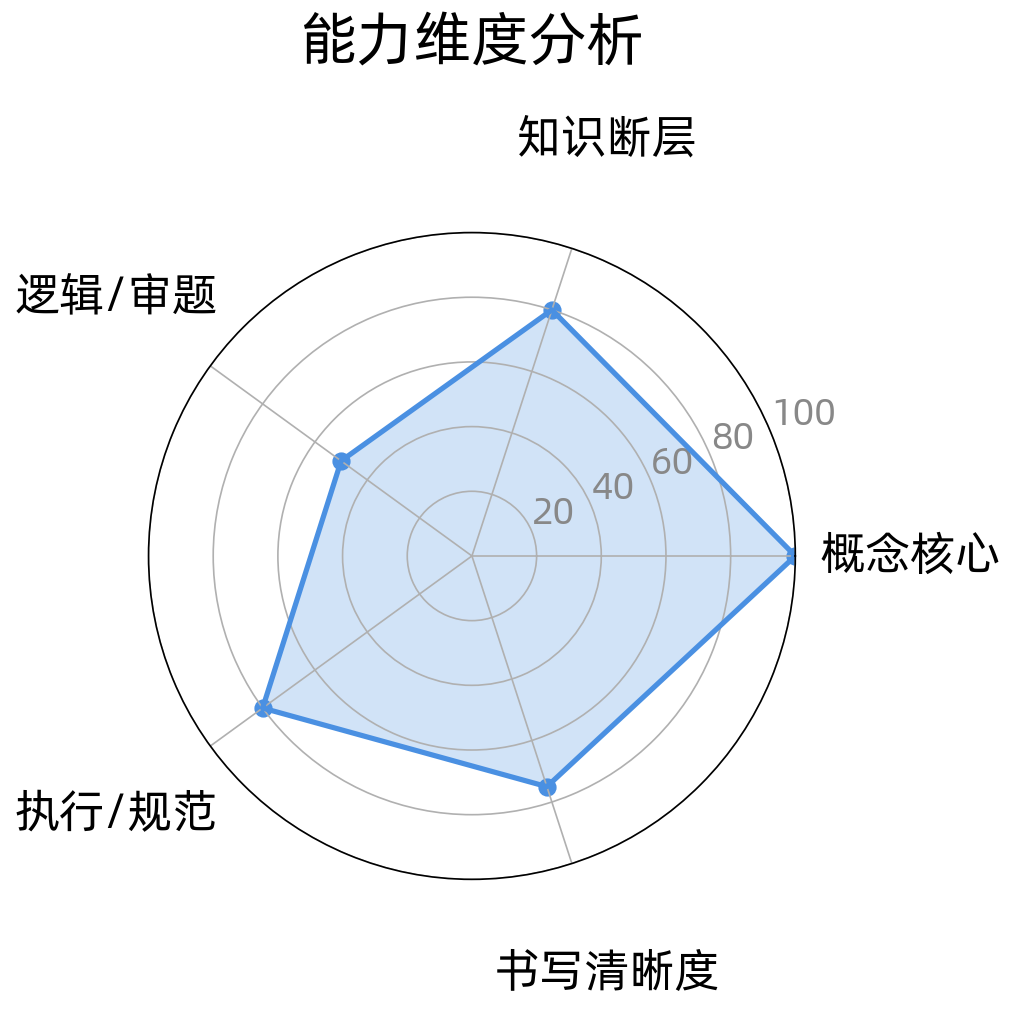
错题分析报告:9 道物理错题的五维能力雷达图,概念理解满分、逻辑审题仅 50 分
概念理解满分、逻辑审题 50 分——概念都懂还反复错,正是"流程型病根"的典型画像:它不在任何一道题的讲解里,只在整批题目的共现结构里。这也回答了一个家长高频疑问:单题讲解为什么治不了反复错——因为单题的单位是"一道题",而病根的单位是"一批题"3。
工程上还有两点值得注意:其一,标签口径必须先统一再统计,归因层的分层标准(概念/审题/执行)跨题一致,共现才有意义;其二,min_support 不宜设太高——共同病根未必覆盖 100% 的题目,收口时保留第二梯队(如上例的"状态未判断")能让补练清单更完整。
五、总结
带走三点:第一,"一堆错题里的共同知识点"本质是标签共现问题,逐题讲评天然看不见它,统计天然看得见;第二,实现只需三步——逐题归因出标签、两两共现建矩阵、按覆盖率收口,本文的 Python 代码可以直接跑;第三,真实数据验证了方法的价值:9 道题五种表象收口成一个病根,补练从"补五遍"变成"补一处"。孩子的错题每攒一批,就该跑一次这样的收口——漏洞清单在变短,方法才算用对。
常见问题解答(FAQ)
Q1:单题讲解为什么治不了孩子错题反复出现的问题?
A:因为病根的单位是"一批题"而不是"一道题"。单题讲解回答"这道题正确做法是什么",而"为什么反复错"藏在几道题的共性里——上例中 9 道题五种表象,收口后只有一个"流程不规范"的共同病根,它不在任何一道题的解析里,只有跨题比对才能看见。
Q2:错题归因的标签口径不一致,共现统计还能用吗?
A:不能,口径统一是前提。如果第一道题的归因标签写"流程不规范"、第二道同性质问题却写"马虎",共现矩阵就把同一个病根拆成了两条低频信号,收口结论全部失真。工程上先固定归因分层标准(概念/审题/执行三层),再跑统计。
Q3:共同病根没有覆盖全部错题怎么办?
A:正常现象。真实数据里共同病根的覆盖率往往不到 100%(上例"流程不规范"覆盖 9/9,但"状态漏判"只覆盖 3/9)。收口时按覆盖率排出主次:先补覆盖最高的主病根,再对剩余题目做第二梯队归因——这正是补练清单该有的顺序。
参考文献
1 Agrawal, R., & Srikant, R. (1994). Fast Algorithms for Mining Association Rules in Large Databases. Proceedings of the 20th International Conference on Very Large Data Bases (VLDB), 487-499
2 Sweller, J. (1988). Cognitive Load During Problem Solving: Effects on Learning. Cognitive Science, 12(2), 257-285. DOI:10.1207/s15516709cog1202_4
3 Roediger, H. L., & Karpicke, J. D. (2006). Test-Enhanced Learning: Taking Memory Tests Improves Long-Term Retention. Psychological Science, 17(3), 249-255. DOI:10.1111/j.1467-9280.2006.01685.x
相关阅读
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号