把一本书蒸馏成 40 集动画短剧:我的 AI 工具链实操复盘
原创
把一本书蒸馏成 40 集动画短剧:我的 AI 工具链实操复盘
原创
用户12832879
发布于 2026-10-21 10:39:52
发布于 2026-10-21 10:39:52
一篇完整的生产记录:拆书 → 结构化素材库 → 可复用专家包 → 40 集水墨动画。附 8 条实测踩坑解法与成本账单。
先说结论
我把《原来这才是春秋》(贾志刚,花城出版社,壹《称霸》、贰《争霸》)拆成了 40 篇小故事、30 条知识点、40 条典故,再把它们封装成一个可复用的 AI 专家,最后做成 40 集、每集 90–130 秒的水墨淡彩动画短剧。
全流程没装任何专业剪辑与绘画软件,只用一个对话式 AI 助手(WorkBuddy)加少量 Python 生态工具。核心结论有三条:
- 重资源只花在"会动"的地方。AI 视频按秒计费,是整条链路最贵的一环;构图、字幕、配音、拼接全部用免费方案解决,单集成本压到全 AI 视频方案的约十分之一。
- 内容资产先于内容产量。110 个结构化条目是最不起眼、却复用最多的资产:素材库、专家包、动画脚本、每集文案全部由它派生。
- 约束要写进流程,不能靠自觉。证据分级、戏说黑名单、"每篇必带看点"这些规则全部固化成文件,量产时才不会质量滑坡。
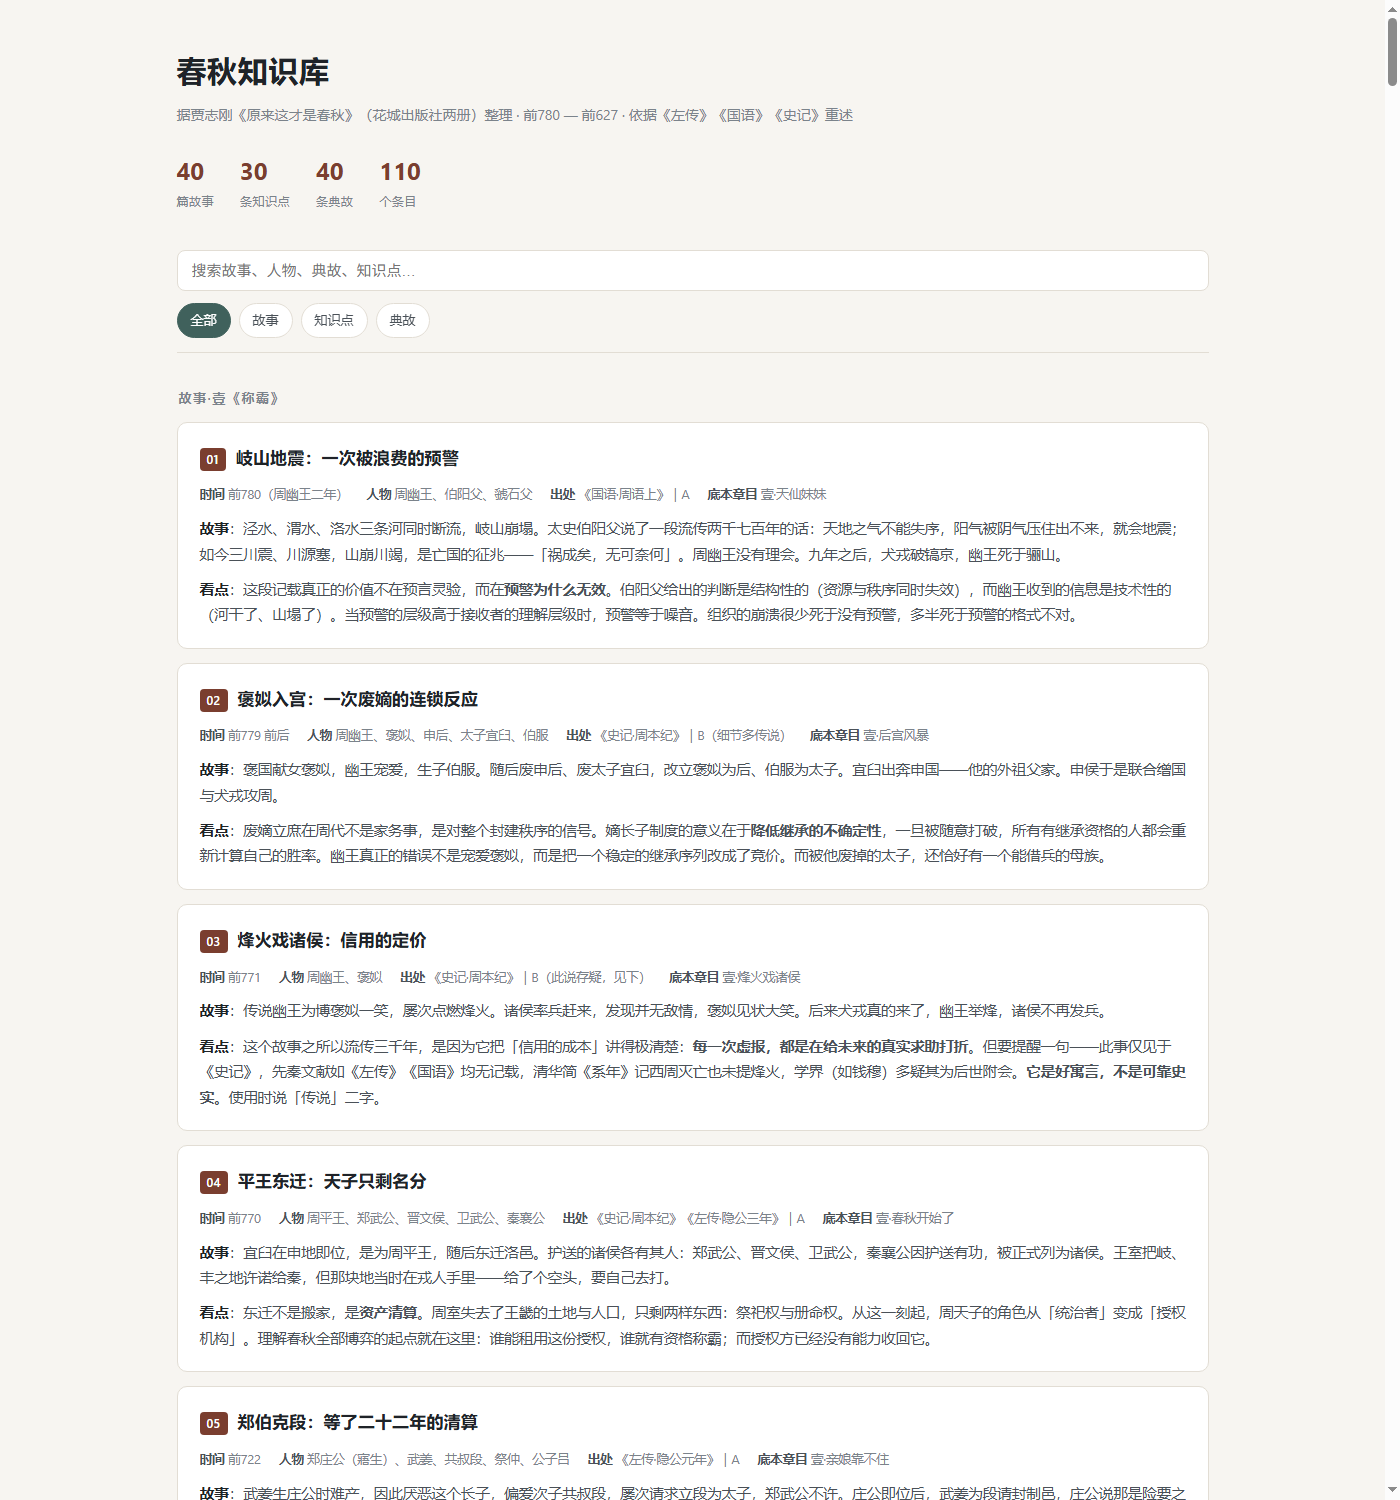
春秋知识库:40 篇故事、30 条知识点、40 条典故的可搜索页面
春秋知识库:40 篇故事、30 条知识点、40 条典故的可搜索页面
一、需求与总体思路
1.1 我想做什么
起因很简单:想把这两册书消化掉,并且让消化结果可复用——不只是自己读懂,还要能变成三类产物:
产物 | 用途 | 形态 |
|---|---|---|
结构化素材库 | 随时检索、引用 | 40 篇小故事 + 30 条知识点 + 40 条典故 |
可复用专家包 | 遇到类似场景直接按书里的框架分析 | 装进 AI 助手的"专家"插件 |
动画短剧 | 可发布、可追更的内容 | 每集约 90–130 秒,带旁白、字幕、动画 |
1.2 工具链全景
环节 | 工具 | 说明 |
|---|---|---|
拆书与结构化 | AI 助手对话 + Markdown | 检索交叉验证 → 人工确认 → 逐条产出 |
专家包封装 | expert-manager 技能脚本 | init / validate / register / package 四步 |
素材库网页 | Python 标准库 | 从 Markdown 自动生成可搜索单页 |
关键帧 | ImageGen(文生图 / 图生图) | 1536×1024,统一水墨淡彩风格提示词 |
动画片段 | VideoGen(图生视频) | 每段约 5 秒,传入关键帧 + 运动描述 |
旁白 | edge-tts | 微软语音合成接口,免费,zh-CN-YunjianNeural,语速 −12% |
合成 | imageio-ffmpeg + Pillow | 拼接、缩放、ASS 字幕烧录、混流 |
设计原则只有一条:把贵的生成资源花在刀刃上。
二、第一步:拆书——从"读完"到"拆出可复用单元"
2.1 先定规则,再动手
拆书最容易踩的坑是把"复述"当"提炼"。动手前先立了三条规则:
- 不复述原文。所有条目依据《左传》《国语》《史记》等公开史料重述,与原书文字脱钩——这既是版权边界,也倒逼我真正理解每个故事。
- 典故必须标出处与置信度。春秋典故是重灾区:烽火戏诸侯仅见于《史记》,《左传》《国语》均无记载;寒食起于介子推的割股焚山情节是后世叠加。这些流行说法单独立一条"存疑附录",而不是混进正文冒充史实。
- 每个故事必须带"看点"。只讲经过等于白拆,每条末尾强制写一句可迁移的判断,例如"瓜期不代"对应的现代教训是:毁诺的成本是总量而非边际。
2.2 结构化产出的最小格式
每个故事固定七个字段,保证后续任何环节(检索、配音脚本、分镜)都能机器可读地取用:
### 05|郑伯克段:等了二十二年的清算
- 时间:前722    - 人物:郑庄公、共叔段、武姜
- 出处:《左传·隐公元年》    - 等级:A(史实)
- 故事:(300 字以内重述)
- 看点:纵容有时不是昏聩,是策略——让对方的罪证自己长满。
40 篇故事、30 条知识点、40 条典故完成后,用一个 200 行左右的 Python 脚本(build_library.py)把 Markdown 解析成带全文搜索和类型筛选的单页 HTML——就是文首那张截图。素材库的价值在拆书阶段就体现出来了:后面做动画时,每一集旁白稿直接从对应条目改写,分镜直接对着"看点"设计,不需要回头翻书。
三、第二步:把方法论固化成"专家包"
素材库解决"讲什么",专家包解决"怎么分析"。这一步用 AI 助手的 expert-manager 技能完成,本质是四个命令:
# 1. 初始化骨架
python init_expert.py chunqiu-strategist --type agent --path <目标目录>
# 2. 校验(提示词规范、头像尺寸、字段完整性)
python validate_expert.py <专家目录>
# 3. 注册到本地市场
python register_expert.py <专家目录>
# 4. 打包成可安装的 zip
python package_expert.py <专家目录> <输出目录>中间的"肉"是两份文件:一份专家提示词(定义它是什么人、按什么流程回答),一份七套分析框架的参考文档(名分—实力错位、霸主生命周期、二阶后果评价等)。踩坑提醒:name、目录名、文件名是唯一标识,展示名称可以随便改,但唯一标识一动就等于重建。
值得单独说的是证据分级设计。这本书的写法是"史实骨架 + 现代梗"(书里把诸侯会盟称作"南联盟"之类),因此专家的参考文档里强制了四级标注——【史实】/【史实·有异说】/【贾说】(作者推断)/【戏说】——并维护一份"戏说黑名单"。这套约束让专家回答时能把"书里怎么讲"和"史料怎么说"分开,实测对问答质量提升明显。
四、第三步:动画流水线——四件套把成本压到十分之一
这是整条链路里工程量最大的部分,也是最有通用价值的部分。
4.1 总体管线
分集脚本(JSON) ──► TTS 旁白(mp3)
      │                │
      ▼                ▼
关键帧(每集12张) ─► 图生视频(每段5s) ─► ffmpeg 合成 ─► 成片
   ImageGen          VideoGen        拼接+字幕+混流
每一集由一个 JSON 分镜计划驱动:镜头列表、每镜旁白、该镜头用静帧还是动画片段。合成脚本读这个 JSON,自动完成 TTS、标题卡绘制、逐镜头视频段生成、拼接、ASS 字幕生成与烧录。做一集新动画只需要三步:生成 12 张关键帧、生成 9 段动画、跑一次合成脚本。
4.2 风格一致性:提示词模板 + 顺序生成
40 集画面要统一,靠的是一段固定的风格前缀提示词,每次只替换场景描述部分:
中国传统水墨淡彩画,绢本暖米色底,细墨线勾勒,设色克制
(墨黑、淡赭石、石青、朱砂点染),细腻颗粒质感,电影级宽幅构图,
春秋初期场景,写实而非卡通,画面内不得出现任何文字。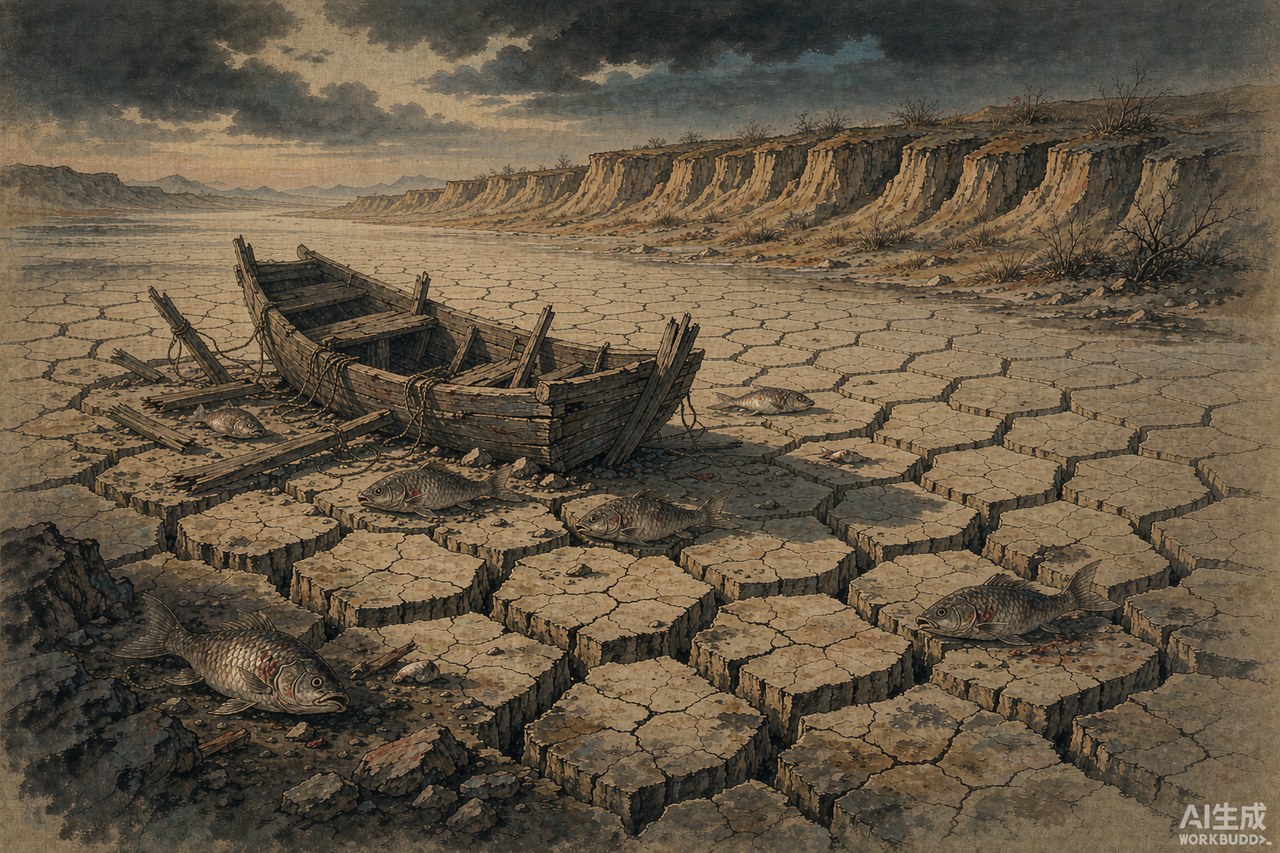
图02|用该模板生成的关键帧:干涸的河床(第 1 集)
图02|用该模板生成的关键帧:干涸的河床(第 1 集)
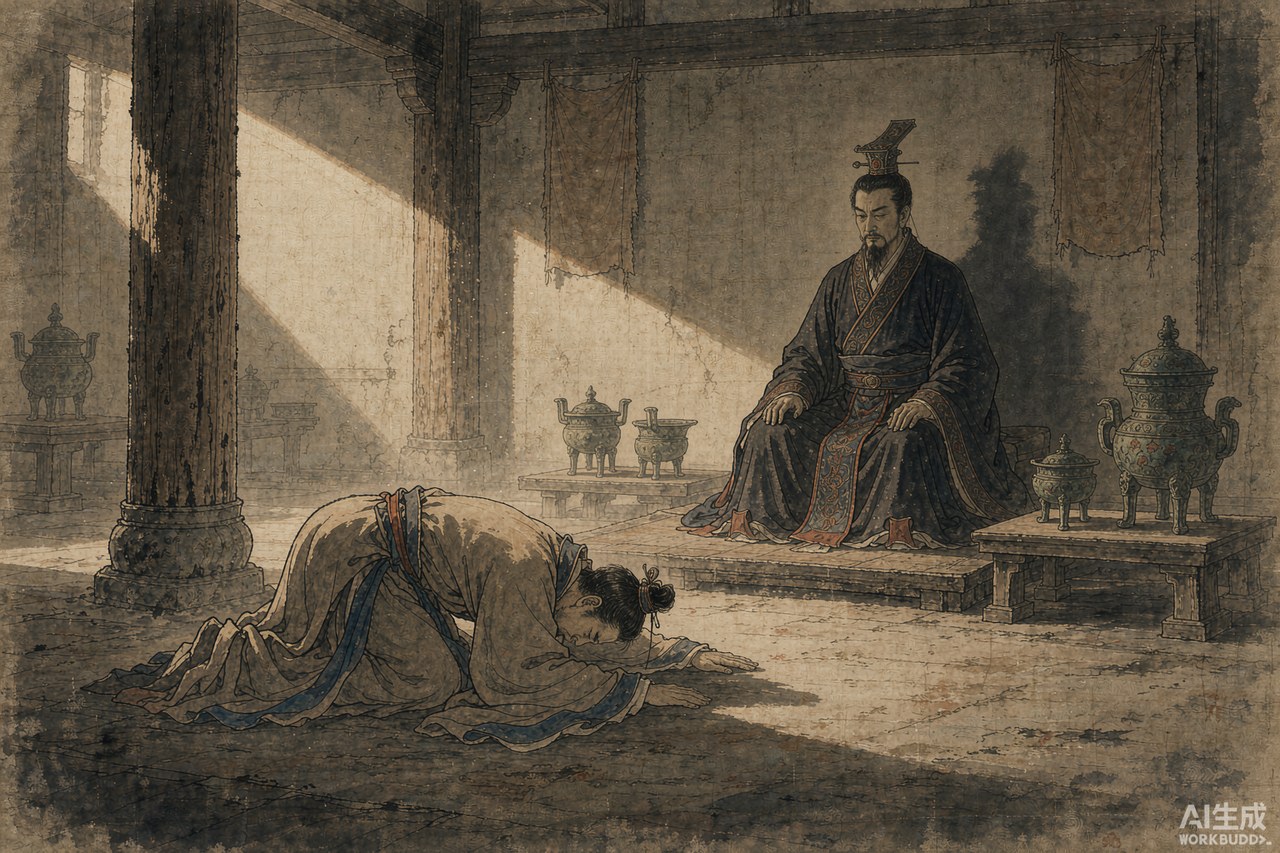
图03|同一模板下的人物场景:臣子跪谏(第 5 集)
图03|同一模板下的人物场景:臣子跪谏(第 5 集)
两个实战要点:
- 顺序生成,不要并发。图像生成工具用时间戳命名文件,同目录并发时同一秒的两张图会互相覆盖且不报错。我的做法是每批 3 张、批间确认数量,缺失立即补生成。
- 人物场景比风景难控。复杂人物动作容易出现肢体错误,提示词尽量写"姿态 + 光位 + 构图"而非动作细节,把动态留给图生视频阶段。
4.3 图生视频:只在"会动"的地方花钱
每张选中的关键帧配一段英文运动描述(镜头推拉方向、哪些元素动、动的幅度),生成约 5 秒片段:
The elderly historian stands almost still, his robe and sleeves sway
slightly as if in a faint breeze... Very slow camera push-in.
Subtle restrained motion, ink-wash painting texture preserved, no text.经验值:运动描述越克制,出片越稳。"slow push-in + 一两个元素微动"几乎不翻车;写"人物转身走动"这类大动作,崩坏率明显上升。90 秒的一集里,我会让 9 个镜头用 AI 动画,其余用静帧加 Ken Burns 式推拉(零成本),观感上依然是"动画",成本却只有全 AI 视频方案的约十分之一。
4.4 旁白与合成
旁白用 edge-tts,纪录片男声 zh-CN-YunjianNeural、语速 −12%,每句旁白对应一个镜头;合成阶段按旁白实际时长决定镜头时长(旁白 + 0.9 秒余量,下限 4.2 秒),保证音画严格对齐。字幕用 ASS 格式烧录,按标点自动切行、按字数分配显示时间。
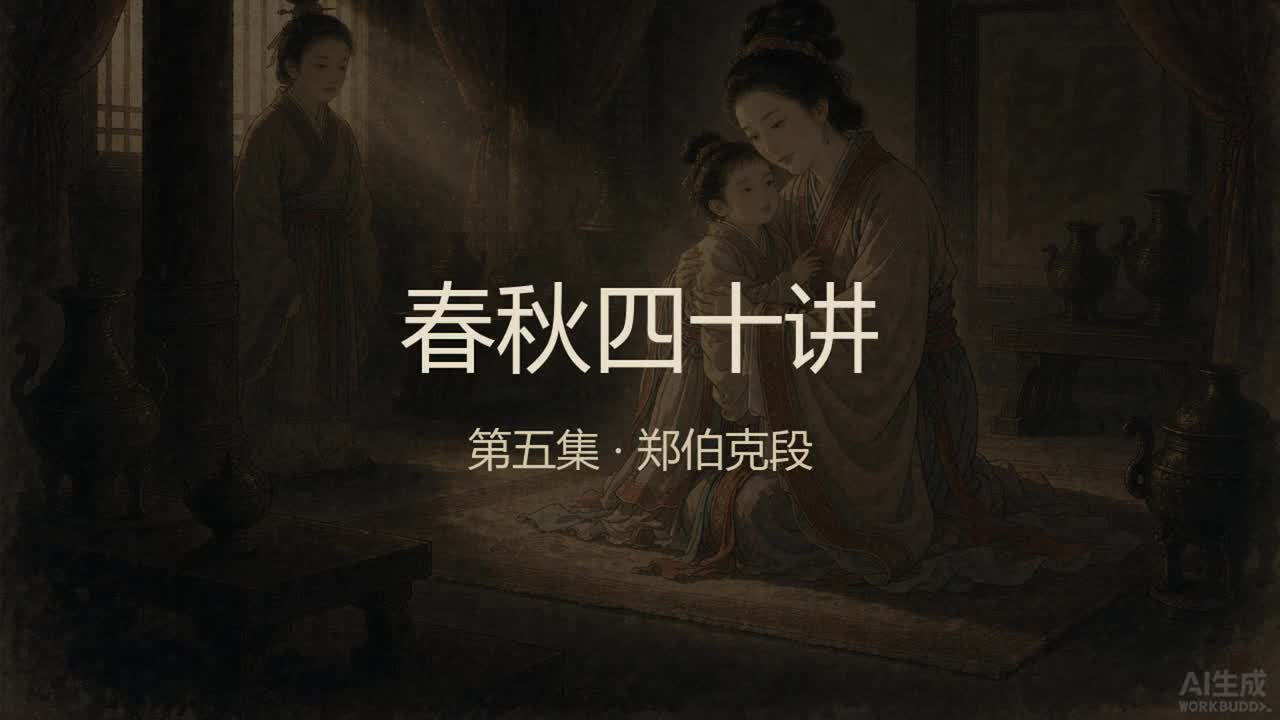
图04|成片标题卡(第 5 集)
图04|成片标题卡(第 5 集)
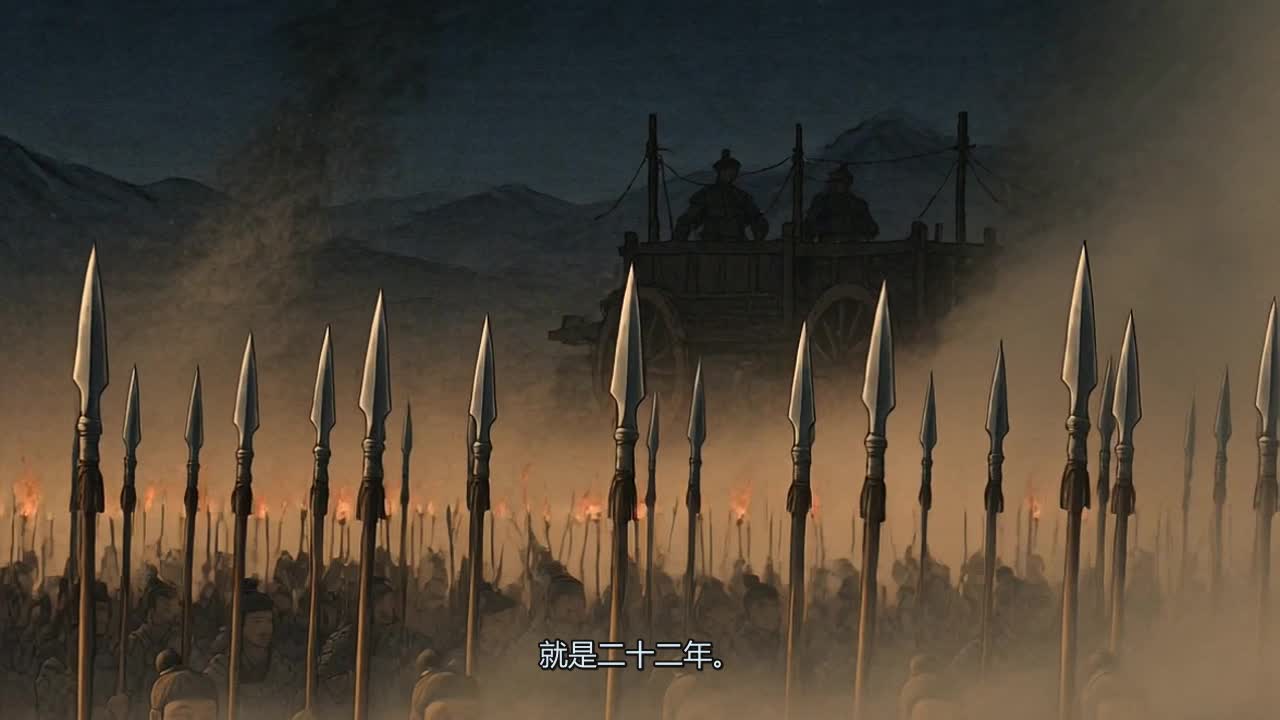
图05|成片中段:双行字幕与画面自动对齐(第 5 集)
图05|成片中段:双行字幕与画面自动对齐(第 5 集)
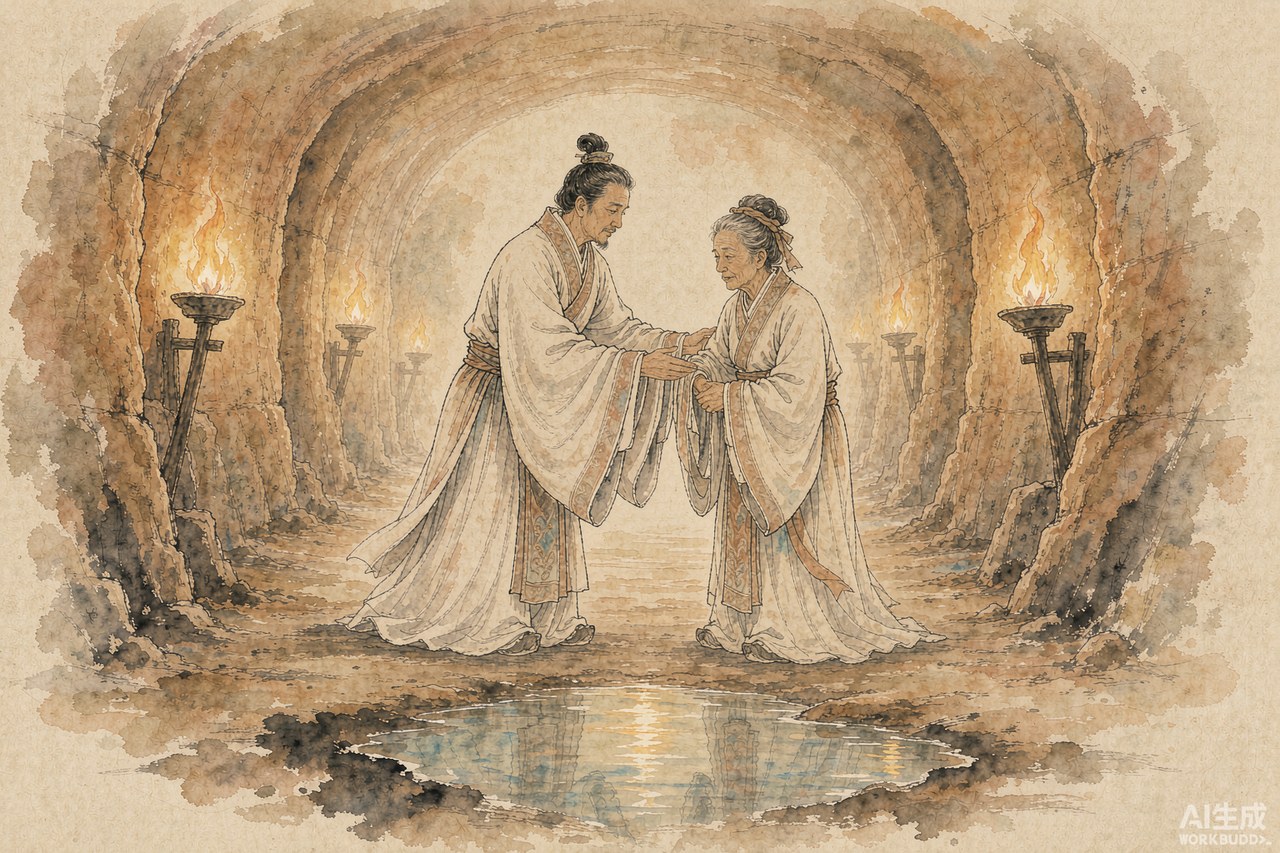
图06|图生视频的关键帧:地道相见(第 6 集)
图06|图生视频的关键帧:地道相见(第 6 集)
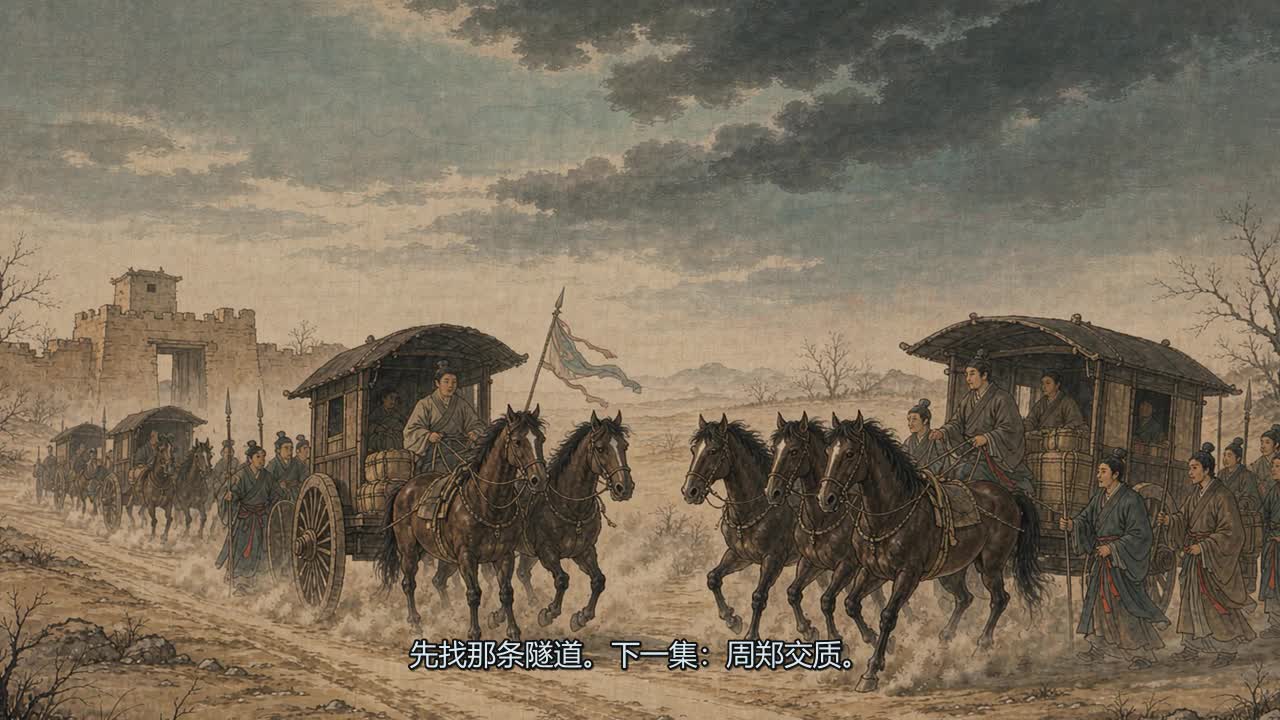
图07|成片结尾帧:字幕带下集预告(第 6 集)
图07|成片结尾帧:字幕带下集预告(第 6 集)
4.5 踩坑清单(最有价值的部分)
以下问题全部实测踩中,解法都验证过:
- ffmpeg
subtitles滤镜在 Windows 报路径错误——C:\的冒号被滤镜语法吞掉。解法:合成时把工作目录切到字幕文件所在目录,全部用相对路径。 tpad冻结帧延长视频"不生效"——对帧率不固定的输入,tpad 后时长不变。解法:滤镜链里先fps=24固定帧率,再tpad=stop_mode=clone。- 长旁白的单行字幕越界——超宽分辨率下被裁掉。解法:按标点切句、按字数比例分配显示时间,单行不超过 20 字。
- 图像生成并发文件名冲突——同秒写入互相覆盖。解法:同目录顺序生成,生成后核对数量。
- 图生视频的输出目录偶发不生效——文件落到图片所在目录而非指定目录。解法:生成后按文件名前缀归位。
- 生成服务偶发不可用——报 "model provider temporarily unavailable"。解法:等 20 秒重试即可,不值得换方案。
- 水印裁切方向写反——
crop((0,160,w,h))裁的是顶部;AI 图水印在右下角。解法:标题卡用crop((0,0,w,h-160)),静帧在缩放前先裁掉底部 160 像素。 - 黑场淡切显得拖沓——第一版镜头间都加淡入淡出,观感像 PPT。解法:改为直切,只保留片头淡入、片尾淡出,节奏立刻变快。
4.6 成本账单
项目 | v1 规范(第 1–4 集) | v2 规范(第 5 集起) |
|---|---|---|
关键帧 | 7–12 张 | 12–13 张 |
AI 动画段 | 3–6 段 | 8–10 段 |
单集合计 | 约 335–670 积分 | 约 570–1240 积分 |
TTS / 合成 | 0 | 0 |
v1 和 v2 的差别只在动画密度:把每集动画段从 3–6 段提到 8–10 段、镜头间黑场淡切改直切,观感从"图文配音"提升到"准动画短剧"。建议先用 v1 做一集样片确认风格,再切 v2 批量生产——改风格越早越便宜。
五、心得:三条反直觉的经验
- "内容资产"先于"内容产量"。拆书的 110 个结构化条目是最不被期待、却复用最多的资产:素材库、专家包、40 集动画脚本、每集文案全部从它派生。如果直接从"做视频"开始,每一集都要重新构思,成本反而更高。
- 约束要写在流程里,不靠自觉。证据分级、戏说黑名单、"每篇必带看点",这些规则全部固化进了专家包的提示词和素材格式定义,而不是靠某一次对话记得住。工具化约束是量产时质量不下滑的唯一保障。
- 对生成结果默认怀疑,抽查机制必须便宜。每批生成后抽帧看图、每次合成后抽 4 帧验字幕,这些检查加起来不到两分钟,但拦住了水印、字幕越界、风格漂移等几乎所有问题。便宜且高频的检查,好过昂贵且罕见的返工。
六、如果你也想跑一遍
最小可行动作只有四步,一晚上就能出样片:
- 选一本你真想读懂的书,先按 2.2 的七字段格式手写 3 篇故事,确认格式顺手。
- 用同一段风格提示词生成 6 张关键帧,确认画面风格能接受(这一步最省钱,也最影响后续)。
- 挑其中 2 张做图生视频,验证运动描述的"克制度"边界。
- 跑一次合成,把音画对齐和字幕这两件事解决掉——剩下的就是重复劳动。
跑通这四步,再决定要不要扩到 40 集。
---
目标读者:想用 AI 工具链做内容量产的开发者与创作者,无需专业剪辑与绘画基础。
前置知识:基本命令行操作;Python 虚拟环境(venv)的概念即可。
技术栈版本:Python 3.13.12;edge-tts(微软 Edge 在线语音合成接口);imageio-ffmpeg 0.5(内置 ffmpeg 7.1);Pillow 11。
预计阅读时间:12 分钟。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号