系统上线后的安全可证性:日志字段模型、鉴权边界与证据链的工程实现
原创
系统上线后的安全可证性:日志字段模型、鉴权边界与证据链的工程实现
原创
newlati
发布于 2026-11-03 10:02:28
发布于 2026-11-03 10:02:28
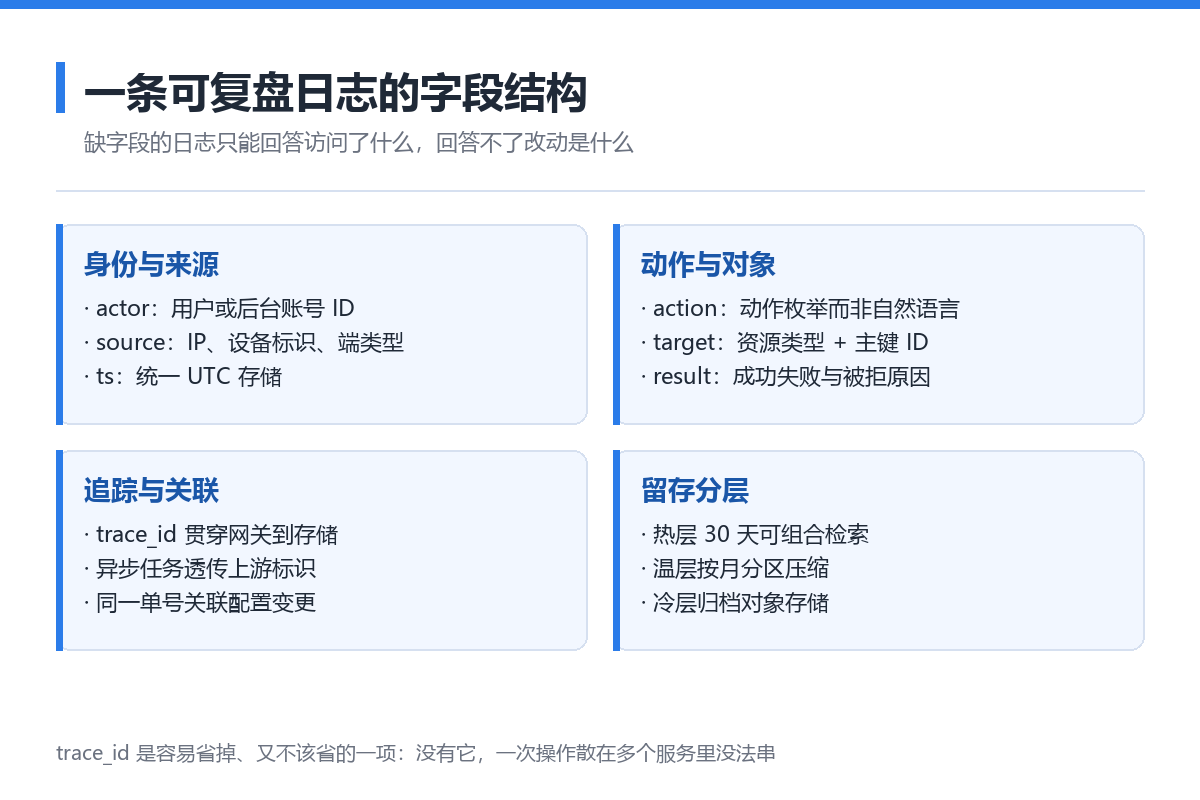
图 5:一条可复盘日志的字段结构(主体 / 来源 / 动作 / 对象 / 结果 / 追踪标识)
监管口径在 2026 年 10 月发生了一次结构性变化。《公安机关网络空间安全监督检查办法》施行后,监督检查的手段从翻阅制度台账扩展到线上巡查与远程漏洞探测、渗透性测试。对研发团队来说,这件事的技术含义很明确:系统能不能被"测",以及测完之后能不能拿出证据解释每一个动作,成了新的交付门槛。
过去交付一个系统,验收标准是功能跑通;现在多了一条隐含标准——系统在出事之后能不能自证。这篇文章不谈制度,只谈三件落在代码里的事:日志字段怎么设计、鉴权边界怎么切、证据链怎么串。
一、日志不是打印语句,是一张有结构的表
很多项目把日志当成调试手段,console.log 打完就完事,线上只留一条 Nginx access log。这种做法在需要复盘的场景里几乎无效,因为 access log 只能回答"谁访问了哪个 URL",回答不了"谁改了哪条数据、改成了什么"。
一条能用于复盘的操作日志,至少要有七个字段:
| 字段 | 含义 | 常见缺失后果 |
|---|---|---|
| ts | 发生时间,统一 UTC 存储、展示层转本地时区 | 跨时区部署后时间线错乱 |
| actor | 操作主体:用户 ID、后台账号 ID、服务账号 | 只记昵称,改名后无法追溯 |
| source | 来源:IP、设备标识、端类型(小程序/APP/H5/后台) | 无法区分同一账号的多端行为 |
| action | 动作枚举:login / query / create / update / delete / export | 用自然语言描述,无法聚合统计 |
| target | 操作对象:资源类型 + 主键 ID | 只记表名,定位不到具体记录 |
| result | 结果:success / fail / denied,附错误码 | 只记成功,攻击尝试全部丢失 |
| trace_id | 请求追踪标识,贯穿网关到存储 | 一次操作分散在多个服务,串不起来 |
其中 trace_id 是容易被省掉、也不该省的一项。它的作用是把「网关收到请求 → 鉴权通过 → 业务处理 → 写库 → 推送消息」这条链上的所有日志串成一条线。没有它,排查一次越权访问要在五个服务的日志里按时间戳人工对齐,误差几秒就对不上。
实现上不必引入全套链路追踪。网关生成一个请求 ID 写进上下文,各服务落日志时带上即可;异步任务与消息消费把上游的 trace_id 透传下去。改造开销集中在一处中间件,收益覆盖全部业务。
留存要分层,别把热数据当冷数据存
按《网络安全法》要求,网络日志留存不少于六个月。六个月全放可检索的存储,开销会随业务量线性上涨。可行的做法是三层:
- 热层(0—30 天):写入日志服务或时序库,支持按 trace_id、actor、action 组合检索,用于日常排障与实时告警。
- 温层(1—6 个月):按月分区压缩,保留索引键、正文压缩存储,查询走异步任务,秒级到分钟级返回可接受。
- 冷层(6—12 个月):归档到对象存储,按需解冻。这一层的作用是"留得住",不是"查得快"。
字段上也要做减法:只记关键操作(登录、权限变更、数据导出、金额相关写入、内容审核处置),不要把所有读接口都当日志存。日活一万量级的系统,全量接口日志一个月能到上百 GB,而真正具备复盘价值的部分不到一成。
二、鉴权要切三层,越权是常见的失分点
远程检测里命中率偏高的一类问题不是漏洞利用,而是接口鉴权缺失与越权访问。表现形式很朴素:拿未登录状态请求业务接口能拿到数据;把请求体里的用户 ID 换成别人的,能读到别人的订单。
三层切法:
其一,网关层做身份识别。 校验令牌有效性、签名、时间戳与重放防护,把匿名请求挡在业务之外。这一层只判断"你是谁",不判断"你能干什么"。
其二,服务层做权限判定。 每个受保护的接口声明所需权限点(如 order:read、order:export),由统一拦截器校验角色与权限点的映射。权限点要细到动作,不能只到模块——「能进订单模块」和「能导出全部订单」是两件事。
其三,数据层做归属校验。 这是越权拦截的关键,也是常被漏掉的一层。查询与修改必须带上归属条件:where user_id = :current_user,或对后台账号按数据范围(本人/本部门/全部)拼条件。不要相信前端传来的 owner_id,一律以服务端会话里的身份为准。
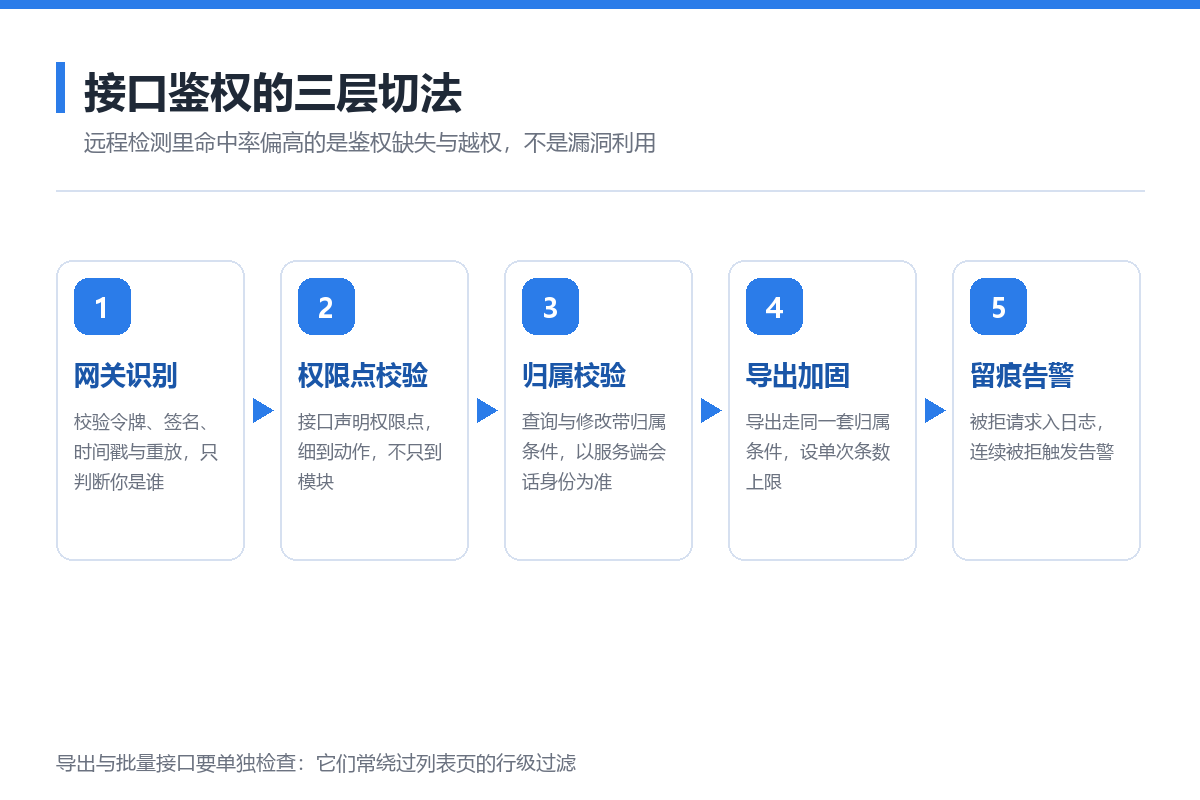
图 6:接口鉴权的三层切法(网关识别 / 权限点校验 / 归属校验 / 导出加固 / 留痕告警)
三层之外还有一个容易忽略的位置:导出与批量接口。批量导出往往绕过列表页的行级过滤,直接按条件全量捞数据,是数据外流的高发口。做法是把导出也走同一套归属条件,并对单次导出条数设上限、留操作日志。
三、证据链:把散落的记录串成可解释的时间线
检查与事后追责问的问题通常是同一个:这件事是谁在什么时候做的,系统当时是什么状态。
要回答它,需要三类记录同时在场:
- 业务变更记录:谁把订单状态从待付款改成已完成,改前改后的值是什么。做法是关键表加变更流水,或在应用层写审计表,记录 before/after 的字段级差异。
- 配置变更记录:权限矩阵、审核规则、推荐策略、开关项,这些改动往往比业务数据改动影响更大,却常常没有留痕。做法是把配置也当数据管,改一次落一条,带操作人与生效时间。
- 系统状态记录:部署版本、发布单号、开关状态。出问题时先要确认的就是"当时跑的是哪个版本"。
三类记录用同一个 trace_id 或同一个操作单号关联,就能还原出一条可解释的时间线。这条线在排查线上事故时的价值,往往超过任何一份事后补写的说明文档。
工程上有个小技巧:审计表按时间分区,写入走异步队列,失败进死信表重试,不让审计写入阻塞主流程,也不允许"审计失败就丢"。审计的可用性优先级要高于普通业务日志。
四、把安全能力做成可交付的构件
从交付角度看,可复盘的系统和不可复盘的系统的差别不在功能清单上,而在这些构件有没有随代码一起移交:
| 构件 | 内容 | 移交形态 |
|---|---|---|
| 鉴权中间件 | 令牌校验、权限点声明、归属条件拼装 | 代码 + 接入说明 |
| 审计写入器 | 七字段结构、异步队列、死信重试 | 代码 + 表结构 |
| 日志留存策略 | 分层规则、分区键、归档任务 | 配置 + 运维手册 |
| 权限矩阵 | 角色、权限点、数据范围的映射表 | 表格 + 初始化脚本 |
| 数据字典 | 敏感字段标注、加密与脱敏规则 | 文档 + 校验脚本 |
| 复测清单 | 漏洞分级、修复时限、复核记录模板 | 模板 + 历史记录 |
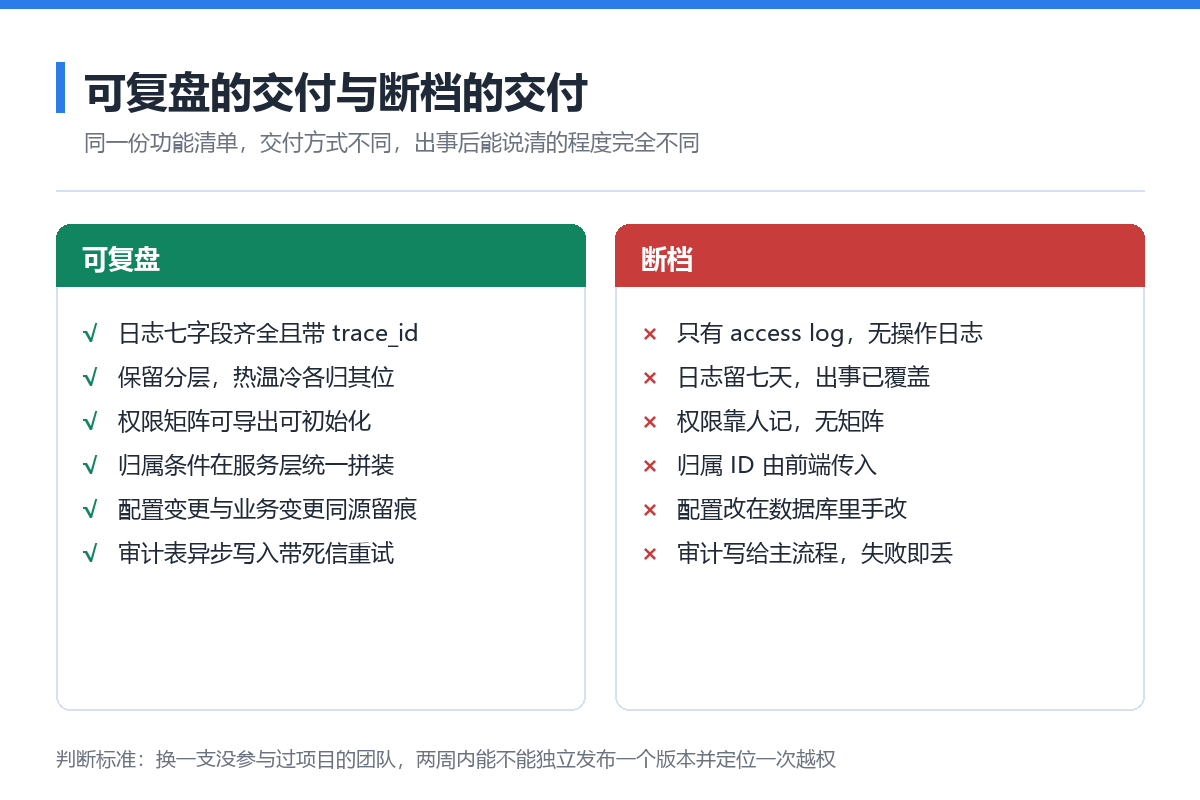
图 7:可复盘的交付与断档的交付对照(判断标准:换一支团队两周内能否独立发布版本)
这六样东西的共同点是:它们不是文档,是能跑的东西。 文档会过期,代码不会撒谎。换一支团队接手时,能不能在两周内独立发布一个版本,很大程度上取决于这六样在不在。
小结
安全可证性不是一个合规动作,而是一组工程约定:日志有结构、留存有分层、鉴权有三层、证据能互相印证、构件随代码移交。这些约定在项目初期加进去,工作量是几个中间件和几张表;等系统跑了两年再回头补,面对的是散落在几十个服务里的打印语句和一张对不上的权限表。
用一句话概括:让系统自己说清楚发生过什么,比事后写一份说明省事得多。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号