知识库问答系统的工程实现:条目模型、检索链路与人工接管的上下文接力
原创
知识库问答系统的工程实现:条目模型、检索链路与人工接管的上下文接力
原创
newlati
发布于 2026-11-04 09:58:59
发布于 2026-11-04 09:58:59
同一个大模型,接两套不同的知识库,答对率可以差三成以上。差别不在提示词,也不在模型参数,而在两件事:知识条目有没有结构,以及检索链路有没有定参数。本文按工程视角拆开讲这三层——条目模型、检索链路、人工接管时的上下文接力,文末给出评测集的组织方式。
一、先定问题边界:什么问题该由机器答
工程上先做分类,再谈模型。把近三个月的真实会话抽样三百到五百条,按「问题类型 × 复杂度 × 是否涉及资金或合同义务」三轴归类,会稳定得到三类:
- 可全自动:查进度、查地址、查营业时间、常规政策解释。答案固定、无分支、不涉钱。
- 可半自动:需要先查业务数据再回答,或需要收集材料后开工单。机器负责取数与收集,结论由规则产出。
- 必须人工:投诉、责任认定、退款与赔偿、合同变更。这类问题机器只能解释、收集材料、发起工单,不能给出结论。
这三类的边界一旦定下来,后面的链路参数、评测集构成、转接规则都从这里推导。跳过这一步直接调模型的团队,通常会在上线两周后收到一堆「它答应了赔钱」的工单。
二、条目模型:一条知识要带四个字段组
知识库不是文档仓库。把资料拆成条目,每条只讲一件事,长度控制在两百到五百字,并带上四组字段:
| 字段组 | 字段 | 作用 |
|---|---|---|
| 标识与溯源 | 条目 ID、来源文件名与版本、原文位置(页码或章节锚点) | 回答要附出处,日志要能回溯到原文 |
| 内容与结构 | 正文、表格块(保留表头)、同义词与别名 | 表格与层级必须保留,否则数值会串行 |
| 时效与责任 | 生效日期、失效日期、责任人、变更记录 | 过期条目是答错的头号来源 |
| 适用范围 | 适用渠道、适用用户类型、可见权限 | 同一条政策在不同渠道可能不同 |
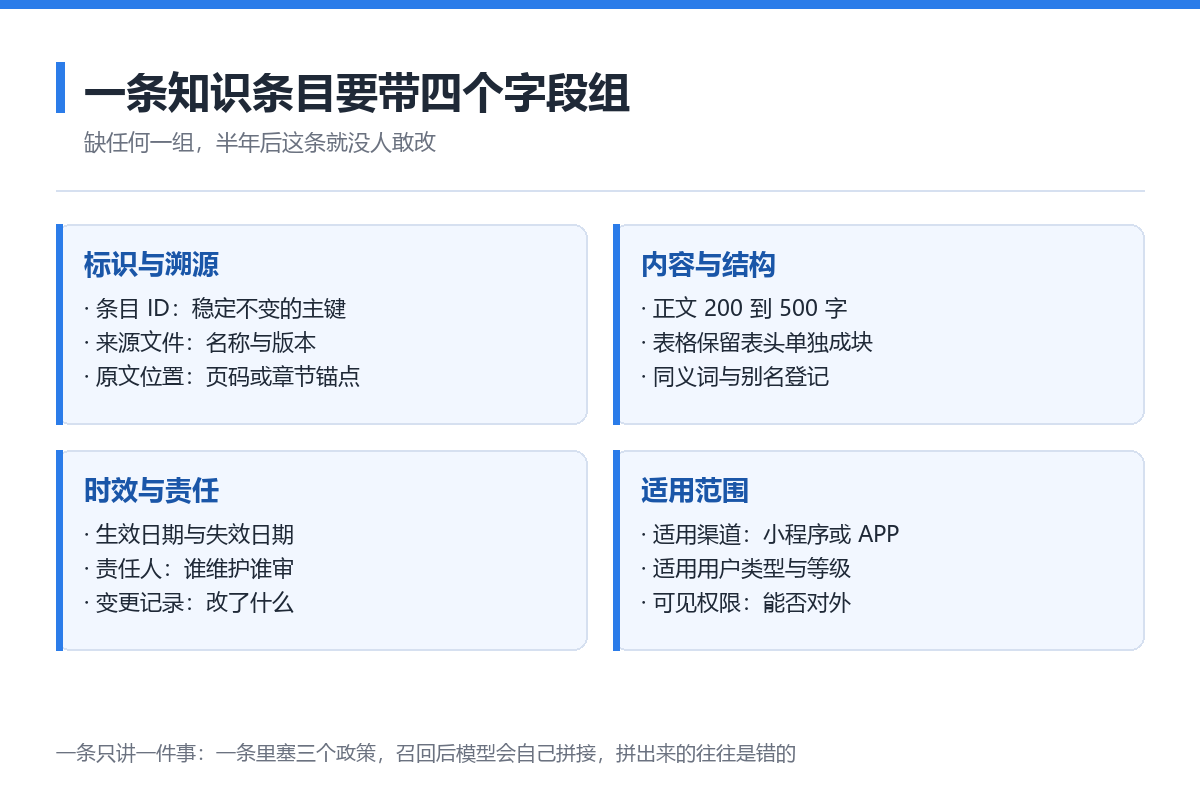
图 5:一条知识条目的四个字段组与基础字段集
三个工程细节值得单独说:
其一,表格必须单独成块并保留表头。 档位表、时效表这类资料,按段落切分后表头会落在别的块里,模型拿到的是「12 元 / 30 元 / 68 元」这种无列名的数字串,答出来的金额经常错列。
其二,一条只讲一件事。 一条里塞三个政策,召回后模型会自己拼接,拼出来的组合往往不存在。宁可拆成三条,也不要写一条大而全的。
其三,必须支持「一条多版本」。 促销、临时政策、地区差异这三类内容会并行存在,用生效日期与适用范围区分,而不是覆盖旧条目。覆盖掉的条目在客诉复盘时查不到依据。
三、检索链路:五道工序,每道都要定参数
| 工序 | 做法 | 参数取舍 |
|---|---|---|
| 问题改写 | 口语问题补全成检索友好句 | 只允许补全语义,不允许改掉地区、版本、时间等限定条件 |
| 混合召回 | 向量检索与关键词检索各取候选 | 候选池先取 20 条,关键词检索兜住型号、单号、专有名词 |
| 重排截断 | 按相关度重排后取前若干条进上下文 | 一般取 3 到 5 条;超长块按语义边界截断,保留表头 |
| 组装与生成 | 提示词约束只依据给定条目作答 | 条目之间冲突时,以生效日期较新者为准,并在回答里说明 |
| 引用与兜底 | 输出附条目 ID,无依据时明确拒答 | 拒答要走转人工,不要用一句「抱歉没理解」当兜底 |
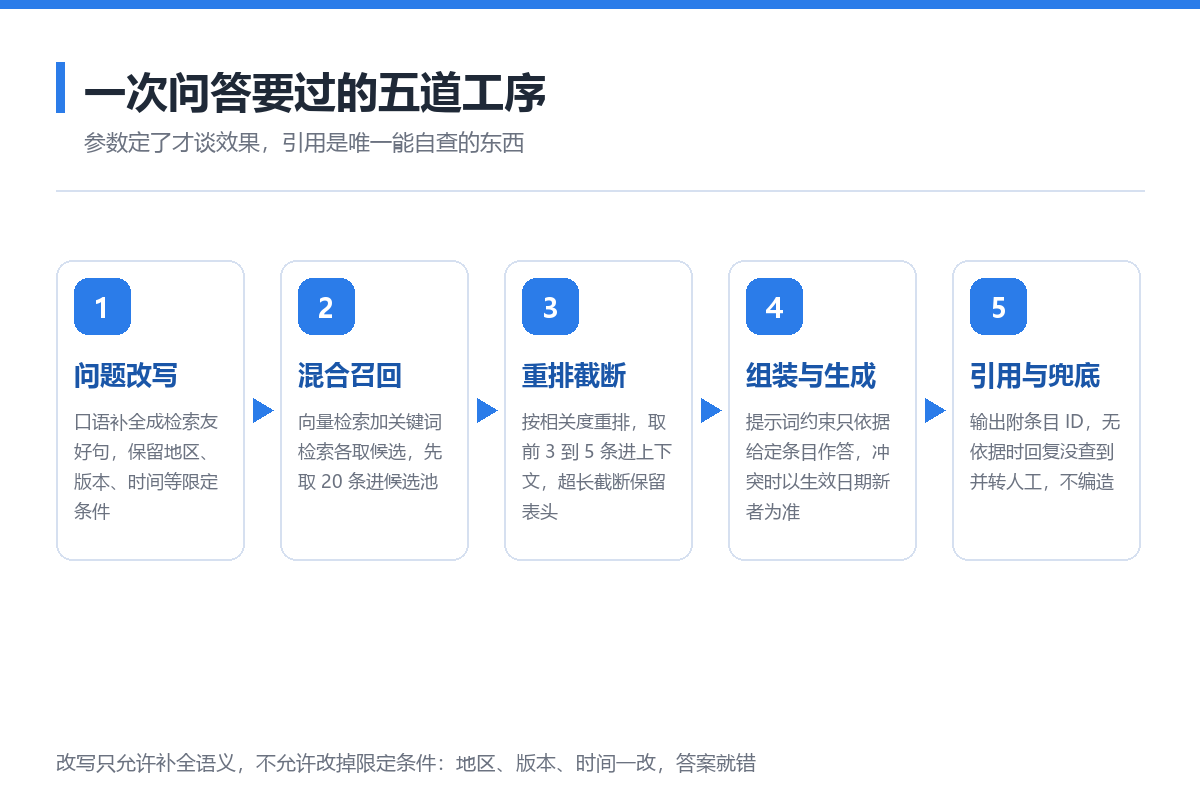
图 6:一次问答经过的五道工序与参数位
工程上容易踩的三个点:
改写环节丢掉限定条件。 「上个月买的能不能退」改写成「商品能否退货」之后,时间条件消失,召回到的是通用退货政策,答案看起来对、实际错。
召回数量当成越大越好。 候选条数增加会抬高召回率,但进上下文的条数增加会稀释注意力,模型开始混用不同条目的条款。重排后取三到五条,是实践中比较稳的区间。
引用做成装饰。 引用要能被点开、能看到原文位置,并且参与评测。只在前端显示一个来源名称、后台没有条目 ID 关联的,等于没有引用,出问题时无法定位是哪条知识错了。
四、人工接管的上下文接力:传什么、怎么传
从机器转人工,断的地方通常是上下文。断掉的表现是坐席开口就问「请问您遇到什么问题」——用户刚说完,还得再说一遍。
要传的是四类数据:用户身份(含等级、历史工单数)、本次会话的完整交互记录(含机器的每次回答与命中的条目 ID)、问题摘要(机器生成的一句话,加用户原话)、关联的工单状态(是否已有工单、当前节点、责任人)。
工程实现上,这四类数据要收敛到一个会话上下文对象,由会话服务统一维护,而不是各端各自传参。接口上建议两个动作:转接时创建「接管记录」,记录触发原因(失败阈值、超时、负面情绪、投诉意向、用户主动要求);接回机器时写「同意记录」,保留用户明确同意的时点与文案版本。
三个实现约束:
- 上下文对象要能按字段做权限裁剪。坐席看到的用户信息与机器看到的不一样,避免把敏感字段带进对话上下文。
- 机器的每次回答要落一条记录,含命中的条目 ID 与生成的原文。客诉复盘时,这是能还原当时依据的主要材料。
- 接管与接回都要留时间戳与操作人。没有这两个字段,事后无法判断是机器判断错还是坐席处理慢。
五、评测:用真实问题,不用文档里的句子
评测集的组织方式决定了分数有没有意义。用文档原文当问题去问,答案必然在库内,得分虚高;用真实会话取样,才能看出它在口语、错别字、多条件叠加下的表现。
建议按三类混编:真实会话取样约占六成(保留口语与省略主语)、长尾与边界约占两成半(多条件叠加,如跨月退款加改地址)、对抗问题约占一成半(库里没有答案的、两条知识冲突的、诱导它承诺赔偿的)。每条标注标准答案要点、应引用的条目 ID、期望动作(直接答 / 追问 / 转人工)。
四个指标与参考线:
| 指标 | 算法 | 参考线 |
|---|---|---|
| 答对率 | 要点覆盖且无事实错误 | 不低于 80%,低于则先收窄场景 |
| 引用命中率 | 引用条目与标注条目一致 | 不低于 90% |
| 拒答率 | 明确拒答并转人工的占比 | 5% 到 15%,过低说明在编 |
| 转接准确率 | 该转的都转了、不该转的没乱转 | 不低于 85% |
再补两个运行指标:首字响应时间 P90 控制在两秒内,单次回答的模型调用开销按轮统计。前者影响体验,后者决定链路能不能长期跑。
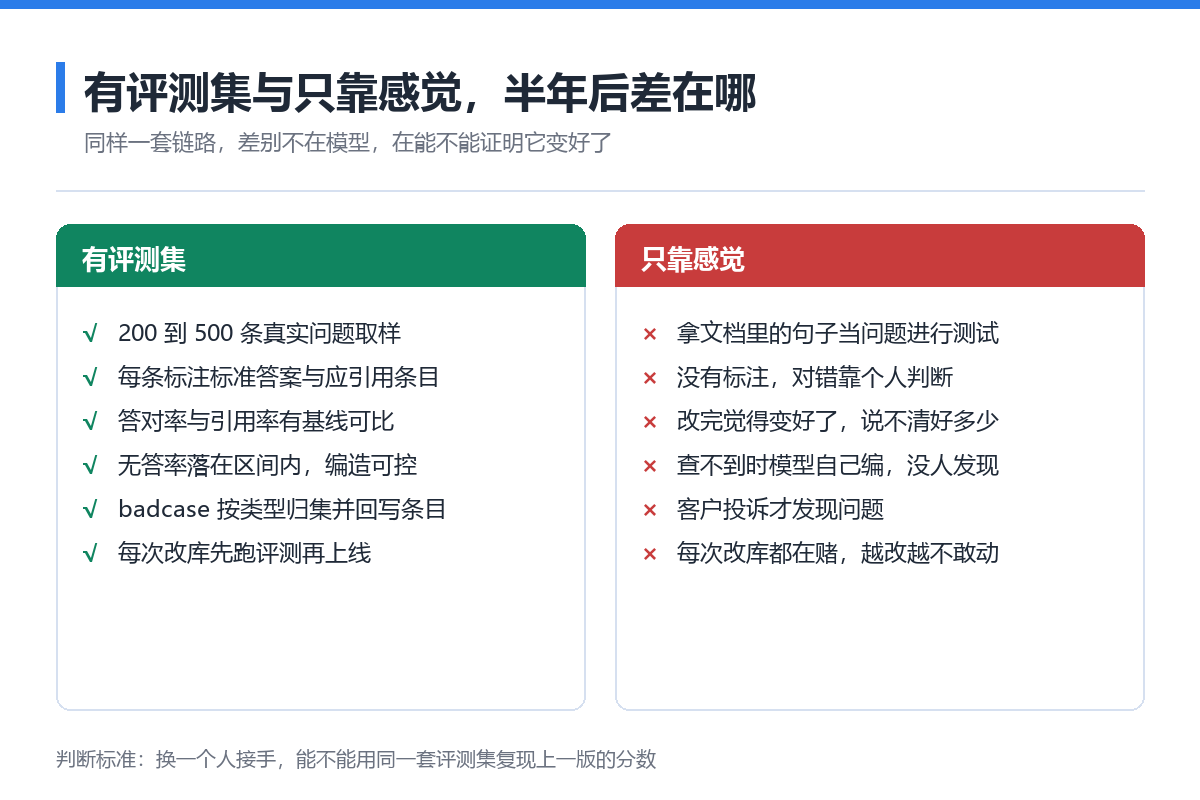
图 7:有评测集与只靠感觉两种做法在半年后的差别
六、上线后的运维:两件事决定它能活多久
过期条目治理。 每周跑一次失效扫描:已过失效日期的条目自动下线并生成待确认清单;同一问题命中两条相互冲突的条目时,按生效日期取新,同时把冲突写进告警。没有这一步,知识库会在三个月内自然腐化。
badcase 回写。 坐席在会话里一键标记「答错 / 答偏 / 该转没转」,标记进入待处理池;每周复盘时按类型归集,把高频错题回写成新条目或修订旧条目,并同步进评测集。评测集只增不减,才能确保每次改库都能跟上一版对比。
还有一个容易被忽略的指标:重复咨询率。同一用户在同一问题上七天内再次进线,说明上次没有真正解决。会话关闭不等于事项办结,这句话在工程上对应的是工单状态机——会话结束只是其中一个事件,工单必须走到终态才算完。
结语
这套系统的工程质量,八成落在模型之外:条目有没有结构、参数有没有定、上下文传不传得过去、评测能不能复现。模型换代是常态,这四件事做扎实了,换代只需要重跑一遍评测集;没做扎实,每换一次模型都要重新猜一遍它哪里会错。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号