4B 干翻 GPT-6 Astra!国产 grounding 基础模型把 34 个感知基准刷成 SOTA,还顺手登顶 HF 日榜第一
原创
4B 干翻 GPT-6 Astra!国产 grounding 基础模型把 34 个感知基准刷成 SOTA,还顺手登顶 HF 日榜第一
原创
AI小怪兽
发布于 2026-11-06 14:08:46
发布于 2026-11-06 14:08:46
4B 干翻 GPT-6 Astra!国产 grounding 基础模型把 34 个感知基准刷成 SOTA,还顺手登顶 HF 日榜第一
作者 | AI小怪兽(计算机视觉布道者 · 视觉检测领域创新者)
公众号「计算机视觉大作战」主理人 · 腾讯云年度影响力作者
博主简介
AI小怪兽 | 计算机视觉布道者 | 视觉检测领域创新者
添加描述
深耕计算机视觉与深度学习领域,专注于目标检测前沿技术的探索与突破。长期致力于YOLO系列算法的结构性创新、性能极限优化与工业级落地实践,旨在打通从学术研究到产业应用的最后一公里。
🚀 核心专长与技术创新
- YOLO算法结构性创新:于CSDN平台原创发布《YOLO26魔术师》、《YOLO11魔术师》等全系列深度专栏。系统性提出并开源了多项原创自研模块,在模型轻量化设计、多维度注意力机制融合、特征金字塔重构等关键方向完成了一系列突破性实践,为行业提供了具备高参考价值的技术路径与完整解决方案。
- 技术生态建设与知识传播:独立运营 “计算机视觉大作战” 公众号(粉丝2.3万),成功构建高质量的技术交流社群。致力于将复杂算法转化为通俗易懂的解读与可复现的工程代码,显著降低了计算机视觉的技术入门门槛。
🏆 行业影响力与商业实践
- 荣获腾讯云年度影响力作者与创作之星奖项,内容质量与专业性获行业权威平台认证。
- 全网累计拥有 8万+ 垂直领域技术受众,专栏文章总阅读量突破百万,在目标检测领域形成了广泛的学术与工业影响力。
- 具备丰富的企业级项目交付经验,曾为工业视觉检测、智慧城市安防等多个关键领域提供定制化的算法模型与解决方案,驱动业务智能化升级。
💡 未来方向与使命
秉持 “让每一行代码都有温度” 的技术理念,未来将持续聚焦于实时检测、语义分割及工业缺陷检测的商业化闭环等核心方向。愿与业界同仁协同创新,共同推动技术边界,以坚实的技术能力赋能实体经济与行业变革。
兄弟们,今天这篇必须收藏。
做目标检测这么多年,我一直有个判断:"看得准"比"懂得多"更稀缺。一个模型能跟你聊哲学,不代表它能在杂乱的产线图上准确框出那 200 个缺陷点。可偏偏现在的具身智能、VLA 大模型,主流做法是拿一个"通用 VLM"直接当感知底座,然后指望稀缺的动作数据顺带把感知也学会。
最近有篇论文把这个逻辑彻底掀了——GroundingPI(小鹏汽车、北大、港大等联合),一个只有 4B 参数的 grounding 基础模型,在 34 个感知基准、44 个基线上做到平均 73.68%,超过体量大得多的 GPT-6 Astra(71.54%);更狠的是,把它换到自动驾驶和机器人操作上,OOD 场景相对最强基线最高提升 24.8%,用 50% 的动作示教数据就能打赢别人用 75% 的效果。
论文一挂出来就拿下 Hugging Face Daily Papers 当日第一。今天小怪兽按老规矩,从原理 → 技术创新 → 应用案例与性能对标三层扒干净,案例和图表全部配齐。
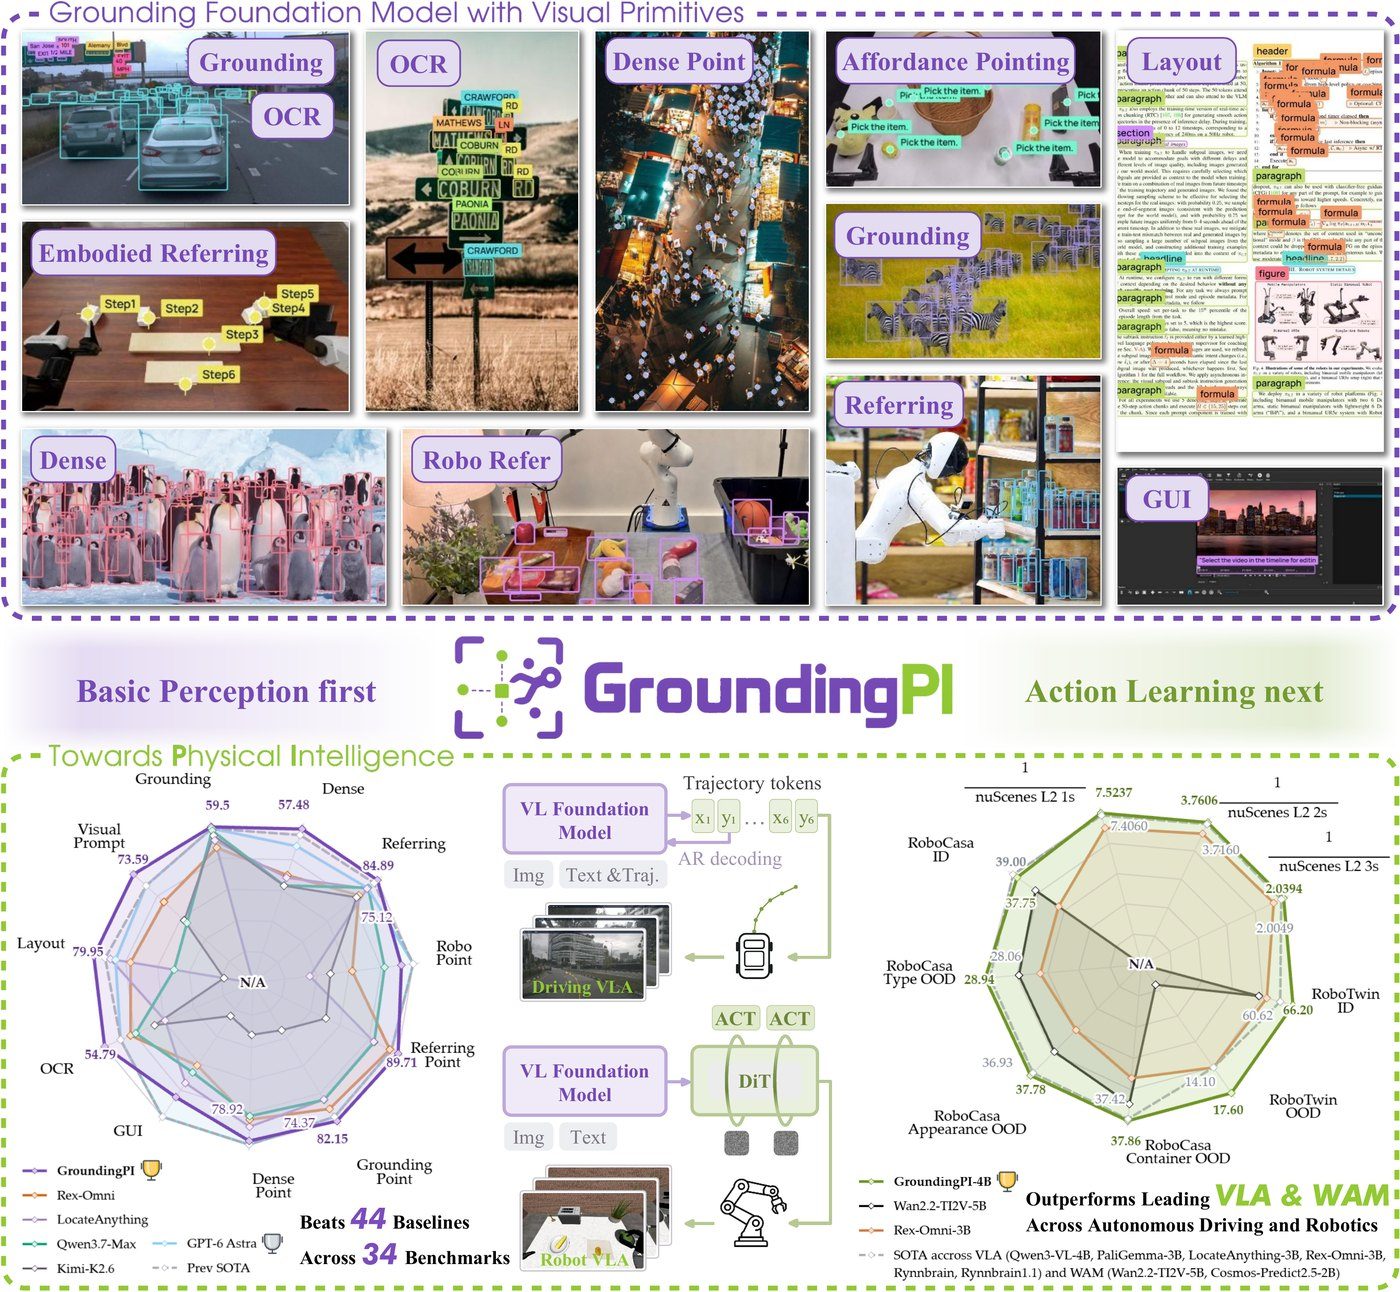
GroundingPI 能力总览:11 类感知、34 个基准、44 个基线,并迁移到自动驾驶与机器人
一、先上结论:一张表看懂它有多能打
维度 | GroundingPI 的成绩 |
|---|---|
模型规模 | 4B 参数(MoonViT-V2 + Qwen3-4B) |
感知覆盖 | 11 类能力:检测 / 指代 / 点定位 / OCR / GUI / 版面 / 视觉提示… |
基准评测 | 34 个 benchmark vs 44 个基线,平均 73.68%,SOTA |
对比旗舰 | 高于 GPT-6 Astra 71.54%、Kimi-K3、Qwen3.7-Max |
物理智能 | nuScenes 驾驶 + RoboTwin2.0 / RoboCasa-GR1 操作,6 项中 5 项第一 |
OOD 泛化 | 全部 4 个 OOD 设置第一,相对最强基线 最高 +24.8% |
数据效率 | RoboCasa-GR1 用 50% 示教 > 所有基线用 75% |
二、原理:把"定位"彻底变成"生成"
伪代码如下:
# -*- coding: utf-8 -*-
"""
GroundingPI 全流程伪代码
配套文章:《4B 打赢 GPT-6 Astra:小鹏 GroundingPI 把 34 项感知基准刷成 SOTA》

论文: GroundingPI: A Grounding Foundation Model towards Physical Intelligence
      with Visual Primitives (arXiv:2609.39601v2)
开发方: 小鹏集团 (XPeng Inc.) 联合北京大学、香港大学等高校团队

--------------------------------------------------------------------------
这个文件是「可执行的说明文档」,不是训练工程:

  * 建模 / 数据引擎 / 训练 / 评测 / 物理智能 各节用抽象接口 + 注释表达,
    函数体留空 (...),代表「这里应为真实实现」。
  * 只有第 2 节 GAM 空间词元协议是真实可运行的纯 Python,
    用来把全文最容易写错的一处协议讲清楚(相邻坐标词元之间不插空格)。
  * main() 不触发任何训练,只打印流程骨架 + 跑一遍协议自检。

运行: python3 groundingpi_pseudocode.py
--------------------------------------------------------------------------
"""

from __future__ import annotations

import re
from dataclasses import dataclass
from typing import Any


# ============================================================================
# 0. 全局配置:只写论文 / README 中可核对的数字,不补未披露的量
# ============================================================================

@dataclass(frozen=True)
class Config:
    # --- 模型 ---
    visual_encoder: str = "MoonViT-V2 (Kimi K3)"   # 上游组件,非开发方
    projector: str = "learnable multimodal projector"
    llm_backbone: str = "Qwen3-4B"                  # 上游组件,非开发方
    params: str = "~4B"

    # --- GAM 空间词元协议 ---
    coord_bins: int = 1000        # <0> ~ <999>,与语义标签共享同一输出词表
    coord_max: int = 999
    grid_w: int = 1920            # 演示用图像尺寸,仅用于坐标还原
    grid_h: int = 1080

    # --- 训练:三大阶段 / 四个 Stage ---
    stage1: str = "Projector 对齐(冻结 ViT 与 LLM,image-caption,8192)"
    stage2: str = "联合多模态预训练(全模块,text-only + 图文,8192)"
    stage3: str = "通用视觉与视频理解(全模块,32768)"
    stage4: str = "坐标对齐 / SFT(8 个空间任务组,8192)"
    stage5: str = "GRPO 强化后训练(G=8,eps=0.2,beta=0.02,冻结 SFT 参考,只更新语言参数)"
    grpo_group: int = 8

    # --- 推理服务(README 默认配置) ---
    serving: str = "vLLM 0.18.x / BF16 / TP=1 / 单图 / 16384 上下文 / eager(禁用 CUDA Graph)"
    decode_flags: str = "skip_special_tokens=False, spaces_between_special_tokens=False"

    # --- 评测口径(注意:三个数字口径不同,不要混用) ---
    n_benchmarks: int = 34        # 34 个感知基准
    n_baselines: int = 44         # 44 个对比基线
    n_capabilities: int = 11      # 11 类感知能力(等权平均)
    n_spatial_groups: int = 8     # 训练 Stage 4 的 8 个空间任务组,与上者不同
    avg_score: float = 73.68      # GroundingPI 11 类等权平均
    astra_score: float = 71.54    # GPT-6 Astra 同口径

    # --- 物理智能 ---
    ood_relative_gain: str = "最高 +24.8%(4 个 OOD 设置全部第一)"
    demo_efficiency: str = "50% 示教数据 SR 28.75% > 基线 75% 数据的 27.75%"
    robotwin_ood: str = "RoboTwin2.0 OOD 17.60%"
    manipulation: str = "6 项操作设置中 5 项成功率第一"

    # 论文按「11 类感知能力」等权平均后仍非第一的单项(沿用正文的如实标注)
    known_caveats: tuple[str, ...] = (
        "VisDrone 40.44 < SenseNova 42.35",
        "TotalText 49.32 < GPT-6 Astra 53.55",
        "Dense200 点定位 81.27 < 86.57",
        "RoboCasa-GR1 Full 37.75% < RynnBrain 39.00%",
    )


CFG = Config()


# ============================================================================
# 1. 模型架构:三段式,但只有「一个」自回归输出头
# ============================================================================
#
# [INSIGHT] 没有检测头 / 分割头 / OCR 头。所有任务都是同一个 next-token
# prediction:位置被量化成 1000 个坐标词元,和文字标签共用词表,
# 因此「定位」在模型眼里只是「继续写一段结构化文本」。

class GroundingPI:
    """视觉编码器 + 投影层 + 语言骨干;输出词表 = 文本词表 ∪ 1000 个坐标词元。"""

    def __init__(self, cfg: Config = CFG):
        self.visual_encoder = build_visual_encoder(cfg.visual_encoder)   # ...
        self.projector = build_projector(cfg.projector)                   # ...
        self.llm = build_llm(cfg.llm_backbone)                            # ...
        self.vocab = extend_vocab_with_coord_tokens(cfg.coord_bins)        # ...

    def forward(self, image: Any, prompt: str) -> Any:
        """图像 -> 视觉特征 -> 投影 -> 与 prompt 拼接 -> 自回归解码 logits。"""
        visual_tokens = self._encode_image(image)        # 1024 projected tokens(论文视觉预算)
        inputs = self._merge(visual_tokens, prompt)
        return self._autoregressive_decode(inputs)       # 一次性输出整段 GAM 串

    def _encode_image(self, image: Any) -> Any: ...
    def _merge(self, visual_tokens: Any, prompt: str) -> Any: ...
    def _autoregressive_decode(self, inputs: Any) -> str: ...


def build_visual_encoder(name: str) -> Any: ...
def build_projector(name: str) -> Any: ...
def build_llm(name: str) -> Any: ...
def extend_vocab_with_coord_tokens(n_bins: int) -> Any: ...


# ============================================================================
# 2. GAM 空间词元协议  —— 本节是真实可运行代码
# ============================================================================
#
# [INSIGHT] 官方 README / 论文 A.1 反复强调:相邻坐标词元之间「不插额外的
# 空格或逗号」(no additional spaces or commas)。服务侧必须设置
# skip_special_tokens=False 与 spaces_between_special_tokens=False,
# 否则解码时词元被拆开、协议作废。上一版文章的代码块就是在这里翻的车。

BOX_START, BOX_END = "<|box_start|>", "<|box_end|>"
REF_START, REF_END = "<|object_ref_start|>", "<|object_ref_end|>"


def quantize(value: float, size: int, bins: int = 1000) -> int:
    """像素坐标 -> 0~999 网格整数。"""
    return max(0, min(bins - 1, round(value / size * (bins - 1))))


def dequantize(token: int, size: int, bins: int = 1000) -> float:
    """0~999 网格整数 -> 像素坐标(线性映射;工程上也可取格子中心 (t+0.5)/bins)。"""
    return token / (bins - 1) * size


def encode_record(label: str, tokens: list[int] | None) -> str:
    """一条预测 -> 一段 GAM 串。tokens 为 None 表示目标不存在,输出 None 拒识。"""
    body = "None" if tokens is None else "".join(f"<{t}>" for t in tokens)
    return f"{REF_START}{label}{REF_END}{BOX_START}{body}{BOX_END}"


def assert_gam_valid(gam: str) -> None:
    """协议守卫:任意两个标记之间不得出现空白或逗号。"""
    if re.search(r">[\s,]+<", gam):
        raise ValueError(
            "GAM 协议被破坏:相邻词元之间插入了空格/逗号。"
            "请确认 skip_special_tokens=False 且 spaces_between_special_tokens=False"
        )


def parse_gam(gam: str) -> list[dict[str, Any]]:
    """GAM 串 -> 结构化预测。坐标个数决定任务粒度:4=框,2=点,None=拒识。"""
    assert_gam_valid(gam)
    pattern = re.escape(REF_START) + r"(.*?)" + re.escape(REF_END) \
              + re.escape(BOX_START) + r"(.*?)" + re.escape(BOX_END)
    out: list[dict[str, Any]] = []
    for label, body in re.findall(pattern, gam, flags=re.S):
        if body.strip() == "None":
            out.append({"label": label, "task": "absent", "coords": None})
            continue
        toks = [int(t) for t in re.findall(r"<(\d+)>", body)]
        if len(toks) == 4:
            task = "bbox"
        elif len(toks) == 2:
            task = "point"
        else:
            task = "invalid"
        out.append({"label": label, "task": task, "coords": toks})
    return out


def to_pixels(record: dict[str, Any], w: int, h: int) -> list[float]:
    """把网格坐标还原成图像像素,供可视化使用。"""
    c = record["coords"]
    if c is None:
        return []
    if record["task"] == "bbox":
        x1, y1, x2, y2 = c
        return [dequantize(x1, w), dequantize(y1, h),
                dequantize(x2, w), dequantize(y2, h)]
    x, y = c
    return [dequantize(x, w), dequantize(y, h)]


# ============================================================================
# 3. 统一任务接口:7 类提示词,塌缩成同一个 next-token 目标
# ============================================================================
#
# [INSIGHT] 换任务只换 prompt,不换 head、不换损失。
# 这也是「范式升级」的落点:一任务一模型 -> 一套生成逻辑通吃所有粒度。

PROMPTS: dict[str, str] = {
    "dense_grounding": "Locate all the instances that match the following categories: car</c>person.",
    "referring_box": "Locate the target referred to by the following description: the red car.",
    "object_point": "Point to: car</c>person.",
    "referring_point": "Point to the target referred to by the following description: the red car.",
    "ocr": "OCR task detect all the text in box format.",
    "layout": "Detect all document layout elements that match the following categories: title</c>text.",
    "gui": "Point to the UI element to click for the following instruction: open the settings menu.",
    "visual_prompt": (
        "Given reference boxes <|box_start|><100><200><500><650><|box_end|> "
        "indicating one or more objects, find all similar objects in the image "
        "and output their bounding boxes."
    ),
}


def build_prompt(task: str, *, phrase: str = "", categories: list[str] | None = None) -> str:
    """按任务拼提示词;视觉提示 / 指代类任务把 phrase 注入模板。"""
    ...


# ============================================================================
# 4. 数据引擎:多教师迭代标注,产出「纯感知」监督
# ============================================================================
#
# [INSIGHT] 由易到难的课程式流水线:先打框,再校验,再修订。
# 关键取舍:训练全程使用无动作标签的纯感知数据,不混带关节动作标签的机器人数据。
# 论文未披露标注图像总量,此处刻意不写具体数字(避免与另一项目串稿)。

SPATIAL_TASK_GROUPS_8 = (
    "detection", "GUI grounding", "referring-expression grounding",
    "referring-expression pointing", "OCR", "document layout",
    "dense pointing and counting", "visual prompting",
)


def data_engine(raw_images: list[Any]) -> list[dict[str, Any]]:
    """Discover -> Localize -> Validate -> Revise / Retire,迭代直到标签稳定。"""
    labels: list[dict[str, Any]] = []
    expert = UnifiedGroundingExpert()          # 被已接受标签持续更新的统一标注专家

    for image in raw_images:
        concepts = discover_concepts(image)                    # 概念发现
        candidates = complementary_teachers(image, concepts)   # 多互补专家定位
        verdict = validate(image, candidates)                  # Pass / Pending / Fail

        if verdict == "Pass":
            labels.append(finalize(candidates))
            expert.update(labels[-1])                          # 接受标签回流训练专家
        elif verdict == "Pending":
            resolved = resolve_by_local_observations(image, candidates, expert)
            labels.append(finalize(resolved))                  # 补监督 + 精化已有标签
        else:
            retire_invalid(candidates)                         # 修订或丢弃无效标签

    apply_field_validation_and_task_dependencies(labels)       # 论文 A.3
    return labels


def discover_concepts(image: Any) -> list[str]: ...
def complementary_teachers(image: Any, concepts: list[str]) -> list[Any]: ...
def validate(image: Any, candidates: list[Any]) -> str: ...
def resolve_by_local_observations(*args: Any) -> list[Any]: ...
def finalize(candidates: list[Any]) -> dict[str, Any]: ...
def retire_invalid(candidates: list[Any]) -> None: ...
def apply_field_validation_and_task_dependencies(labels: list[dict]) -> None: ...
class UnifiedGroundingExpert:
    def update(self, label: dict[str, Any]) -> None: ...


# ============================================================================
# 5. 训练:三大阶段(Pretrain 1 -> Pretrain 2/SFT -> GRPO)
# ============================================================================
#
# [INSIGHT] 量化坐标词元与普通文本词元共享同一 cross-entropy,
# 论文明确「不引入额外的 IoU 回归损失」——这是「一切皆 next-token」最硬的证据。
# SFT: L = -|S|^-1 * sum_{t in S} log p(y_t | I, P, y_<t),S 仅含 assistant 响应。
# GRPO: 每个 prompt 采 G=8 条响应,任务特定奖励(grounding 两个活跃分量 0.7/0.3,
#       OCR 单一复合奖励 1.0),冻结 SFT 参考策略,只更新语言参数。

def train(model: GroundingPI, labels: list[dict[str, Any]]) -> GroundingPI:
    model = pretrain_1_base_vlm(model)          # Stage 1-3
    model = pretrain_2_sft(model, labels)       # Stage 4,坐标对齐
    model = grpo(model)                         # 第三大阶段,强化后训练
    return model


def pretrain_1_base_vlm(model: GroundingPI) -> GroundingPI:
    # Stage 1: 冻结 ViT 与 LLM,只训 projector(image-caption,8192)
    # Stage 2: 全模块,text-only + 图文,LR: LLM 1e-5 / ViT+projector 1e-6
    # Stage 3: 全模块,通用视觉问答 / 指令 / 视频,32768
    # 工程:128 GPUs,BF16,ZeRO-1,FlashAttention,激活重计算,AdamW(0.9,0.95)
    ...


def sft_loss(logits: Any, targets: Any, assistant_mask: Any) -> float:
    """token-level cross-entropy,只在 assistant 响应位置计算(排除 prompt/视觉/pad)。
    语义标签、坐标词元、协议标记一视同仁,无额外 IoU / 回归项。"""
    ...


def pretrain_2_sft(model: GroundingPI, labels: list[dict]) -> GroundingPI:
    for group in SPATIAL_TASK_GROUPS_8:
        batch = sample_group(labels, group)
        loss = sft_loss(model(batch.image, batch.prompt), batch.gam, batch.mask)
        update(model, loss)                     # ...
    return model


def grounding_reward(pred: list[dict], gt: list[dict]) -> float:
    """严格定位 + 输出质量;惩罚重复框、过大框、无效输出。"""
    ...


def ocr_reward(pred: list[dict], gt: list[dict]) -> float:
    """文本-几何一致性复合奖励。"""
    ...


def grpo(model: GroundingPI, group_size: int = CFG.grpo_group) -> GroundingPI:
    """裁剪式 GRPO:eps=0.2,beta=0.02,冻结 SFT 参考,只更新语言参数。"""
    for prompt, gt in rl_prompts():
        samples = [model.generate(prompt) for _ in range(group_size)]   # G=8
        rewards = [composite_reward(s, gt) for s in samples]            # 0.7/0.3 或 1.0
        advantages = standardize_within_prompt(rewards)
        clipped_grpo_step(model, samples, advantages, eps=0.2, beta=0.02)  # ...
    return model


def sample_group(labels: list[dict], group: str) -> Any: ...
def update(model: GroundingPI, loss: float) -> None: ...
def rl_prompts() -> Any: ...
def composite_reward(sample: Any, gt: Any) -> float: ...
def standardize_within_prompt(rewards: list[float]) -> list[float]: ...
def clipped_grpo_step(*args: Any, **kwargs: Any) -> None: ...


# ============================================================================
# 6. 推理:vLLM 服务 + GAM 解析 + 可视化
# ============================================================================

def serve(cfg: Config = CFG) -> str:
    """hf download 权重 -> run.py setup serve -> run.py serve。
    默认 BF16 / TP=1 / 单图 / 16384 上下文 / eager(禁用 CUDA Graph)。"""
    ...


def predict(image: Any, prompt: str, task: str = "bbox", cfg: Config = CFG) -> dict[str, Any]:
    """一次请求 = 一张图 + 一条提示词;返回结构化结果与 valid 标志。"""
    gam = call_vllm(image, prompt, flags=cfg.decode_flags)  # 原始文本,保留特殊词元
    try:
        records = parse_gam(gam)
        valid = all(r["task"] != "invalid" for r in records)
        parse_error = None
    except ValueError as e:
        records, valid, parse_error = [], False, str(e)     # 截断/格式错误保留原始输出
    return {
        "task": task,
        "predictions": [
            {**r, "pixels": to_pixels(r, image.width, image.height)} for r in records
        ],
        "raw_output": gam,
        "valid": valid,
        "parse_error": parse_error,
    }


def call_vllm(image: Any, prompt: str, flags: str) -> str: ...
def visualize(image: Any, result: dict[str, Any]) -> Any: ...


# ============================================================================
# 7. 评测:34 基准 / 44 基线 / 11 类等权平均
# ============================================================================
#
# [INSIGHT] 指标本身也统一:框与 OCR 用 F1_mIoU,点定位用 F1@Point,
# 空间/机器人任务用各自 accuracy。11 类等权平均后 73.68 > 71.54,
# 但这是「综合平均 SOTA」,不是「逐项第一」——caveats 必须随文保留。

METRICS = {
    "bbox / OCR": "F1_mIoU",
    "point": "F1@Point",
    "spatial / robotic": "task-specific accuracy",
}


def evaluate(model: GroundingPI, cfg: Config = CFG) -> dict[str, Any]:
    scores = {name: run_benchmark(model, name) for name in list_34_benchmarks()}
    avg = sum(group_mean(scores, cap) for cap in list_11_capabilities()) / cfg.n_capabilities
    return {
        "groundingpi_avg": round(avg, 2),          # 73.68
        "gpt6_astra_avg": cfg.astra_score,         # 71.54
        "benchmarks": cfg.n_benchmarks,
        "baselines": cfg.n_baselines,
        "caveats": list(cfg.known_caveats),
    }


def list_34_benchmarks() -> list[str]: ...
def list_11_capabilities() -> list[str]: ...
def run_benchmark(model: GroundingPI, name: str) -> float: ...
def group_mean(scores: dict[str, float], capability: str) -> float: ...


# ============================================================================
# 8. 迁移:感知优先 -> 动作学习(物理智能)
# ============================================================================
#
# [INSIGHT] GroundingPI 定位为具身「快系统」的感知原生底座,
# 不替代负责任务规划的通用大模型;下游接 Driving VLA / Robot VLA 的主干对比,
# 论文只证明「更强的感知是更好的物理智能底座」,不是端到端动作策略。

def transfer_to_physical_intelligence(model: GroundingPI, cfg: Config = CFG) -> dict[str, Any]:
    # Driving VLA:图像 + 文本 -> 轨迹词元(x1 y1 ... x6 y6)自回归解码 -> ACT / DiT
    driving = evaluate_driving_vla(model)          # nuScenes 开环 L2 误差
    # Robot VLA:以 GroundingPI 作视觉主干 + 策略头,做 ID / OOD 与数据效率对比
    manipulation = evaluate_robot_vla(model)       # RoboCasa-GR1 / RoboTwin2.0
    return {
        "paradigm": "Basic perception first, action learning next",
        "ood": cfg.ood_relative_gain,
        "data_efficiency": cfg.demo_efficiency,
        "robotwin": cfg.robotwin_ood,
        "manipulation": cfg.manipulation,
        "driving": driving,
        "robot": manipulation,
    }


def evaluate_driving_vla(model: GroundingPI) -> Any: ...
def evaluate_robot_vla(model: GroundingPI) -> Any: ...


# ============================================================================
# 9. 入口:只跑协议自检 + 打印流程骨架,不触发训练
# ============================================================================

PIPELINE = [
    ("1. 架构", "MoonViT-V2 + Projector + Qwen3-4B,单一自回归输出头", "GroundingPI"),
    ("2. 协议", "GAM:1000 个量化坐标词元,相邻词元不插空格/逗号", "parse_gam"),
    ("3. 任务", "7 类提示词塌缩为同一 next-token 目标", "PROMPTS"),
    ("4. 数据", "多教师迭代标注,纯感知数据、无动作标签", "data_engine"),
    ("5. 训练", "Pretrain 1(Stages 1-3) -> SFT(Stage 4) -> GRPO", "train"),
    ("6. 推理", "vLLM 服务 + GAM 解析 + 像素还原", "predict"),
    ("7. 评测", "34 基准 / 44 基线 / 11 类等权平均", "evaluate"),
    ("8. 迁移", "感知优先 -> 动作学习,驱动与机器人 VLA", "transfer_to_physical_intelligence"),
]


def self_check_protocol() -> None:
    """用 README 的三行原始输出格式做一次端到端自检。"""
    print("[协议自检] 原始 GAM 串(严格无空格):")
    gam = "".join([
        encode_record("car", [100, 200, 500, 650]),           # 框 (x1,y1,x2,y2)
        encode_record("car center", [300, 425]),               # 点 (x,y)
        encode_record("absent object", None),                  # 目标缺失 -> None 拒识
    ])
    print("  " + gam)

    records = parse_gam(gam)
    print("\n[协议自检] 解析结果:")
    for r in records:
        print(f"  label={r['label']!r:18s} task={r['task']:8s} coords={r['coords']}")

    print(f"\n[协议自检] 还原到 {CFG.grid_w}x{CFG.grid_h} 像素:")
    for r in records:
        if r["coords"]:
            print(f"  {r['label']:16s} -> {[round(v, 1) for v in to_pixels(r, CFG.grid_w, CFG.grid_h)]}")

    # 反例:故意插入一个空格,确认守卫能拦住
    broken = gam.replace("<100><200>", "<100> <200>")
    try:
        assert_gam_valid(broken)
        print("\n[协议自检] 守卫失效(不应出现)")
    except ValueError as e:
        print(f"\n[协议自检] 反例被正确拦截: {e}")


def main() -> None:
    cfg = CFG
    print("=" * 78)
    print("GroundingPI 全流程伪代码 | 小鹏集团联合北大、港大等高校团队")
    print(f"架构: {cfg.visual_encoder} + {cfg.projector} + {cfg.llm_backbone} ({cfg.params})")
    print("=" * 78)

    print("\n[全流程骨架]")
    for step, desc, symbol in PIPELINE:
        print(f"  {step:10s} {desc:52s} -> {symbol}")

    print()
    self_check_protocol()

    print("\n[关键数字 / 口径核对]")
    print(f"  34 基准 / 44 基线 / 11 类等权平均: {cfg.avg_score} vs GPT-6 Astra {cfg.astra_score}")
    print(f"  Stage 4 训练用的是 {cfg.n_spatial_groups} 个空间任务组(与 11 类评测口径不同)")
    print(f"  物理智能: {cfg.ood_relative_gain}; {cfg.demo_efficiency}")
    print("\n[如实标注:综合平均 SOTA,但以下单项并非第一]")
    for c in cfg.known_caveats:
        print(f"  - {c}")

    print("\n注:建模/训练/评测各节为伪代码(函数体留空),可直接复制进专栏做逐行图解。")
    print("=" * 78)


if __name__ == "__main__":
    main()
2.1 一句话本质:视觉基元 = 语言词元
传统检测是"回归"——网络输出连续的坐标值;GroundingPI 是"生成"——把框和点变成词表里的离散 token,让语言模型一个一个"写"出来。
它把坐标量化成 0~999 共 1000 个整数词元(<0>…<999>),与语义标签、协议标记共用同一套词表。于是一次检测就变成一段结构化文本(下列为官方 README 的 GAM 输出格式,注意相邻词元之间不插入空格):
⚠️ 别小看"没有空格"这件事:这是 GAM 空间词元协议的硬要求。自定义服务请求时必须设
skip_special_tokens=false且spaces_between_special_tokens=false,否则分词器会在相邻坐标词元之间插空格、把协议打乱,模型输出直接作废。同一标签的多个框用逗号分隔且同样不留空格(见下方架构图右侧的 Output token sequence)。💡 原理点拨:这就是论文标题里 Visual Primitives(视觉基元) 的含义——点和框是最小的视觉"原子"。把原子离散成 token 后,检测、指代、计数、OCR、GUI 点击这些任务就被压扁成同一个 next-token prediction 目标,模型只学一套逻辑,而不是给每个任务接一个专用 head。目标不存在时直接输出
None,拒识是原生能力,不是后加的补丁——这点在安防、质检里值千金。
2.2 架构三段式:强视觉编码器 + 轻量对齐 + 自回归解码
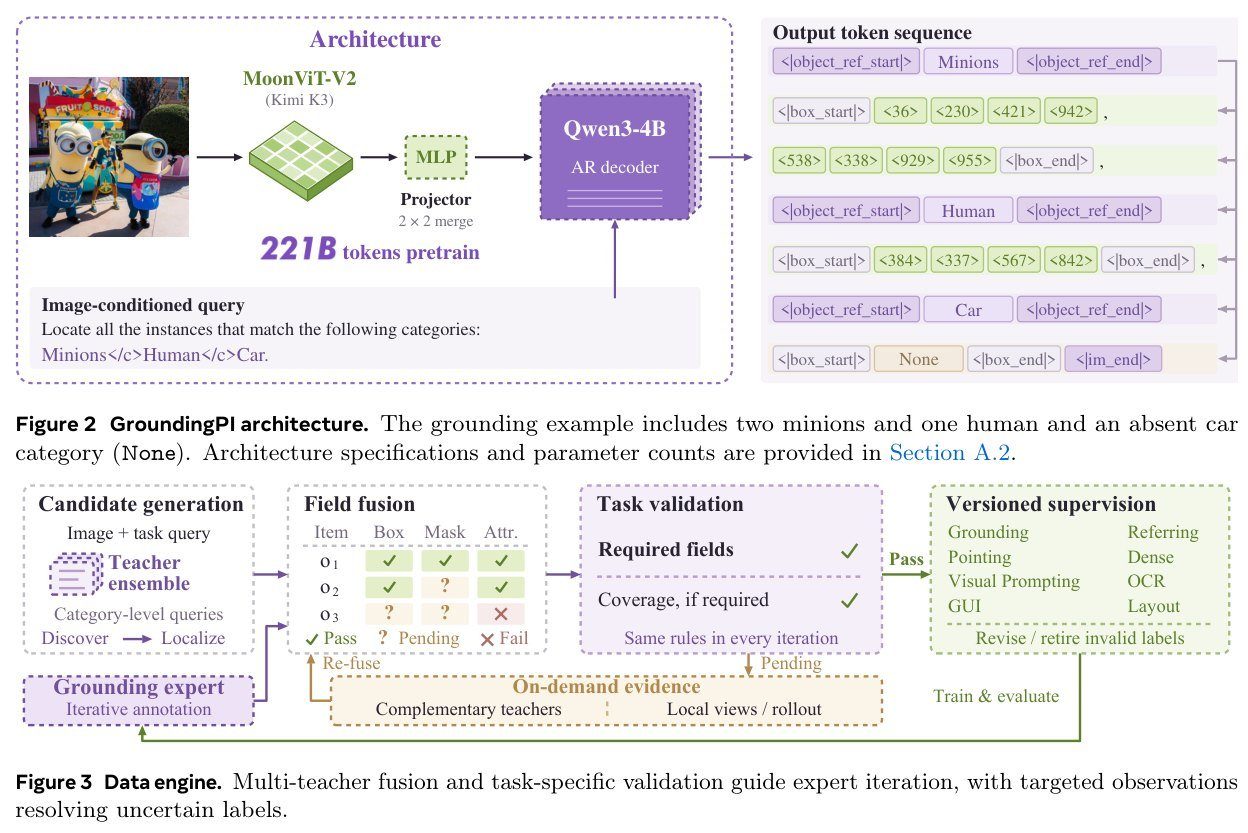
GroundingPI 架构(Figure 2)与数据引擎(Figure 3)
- MoonViT-V2(Kimi K3)视觉编码器:继承 Kimi K3 的强视觉表征,负责把图像吃成高质量视觉特征;
- 可学习 Projector:把相邻 2×2 视觉特征聚合,经两层 MLP(GELU + 输出归一化)映射到语言嵌入空间;
- Qwen3-4B 自回归解码器:以图像 + 文本指令为条件,逐 token 生成标签与坐标序列。
形式化地讲,编码器 E_\psi 与投影 C_\phi 产出视觉嵌入 V = C_\phi(E_\psi(I)),解码器按 $p_\theta(Y | I,P)=\prod_i p_\theta(y_i | V,P,y_{<i})$ 生成变长响应。 |
💡 原理点拨:整套架构没有检测头、没有 SAM、没有额外的分割/抠图分支,只有一个语言模型在"写坐标"。所以我一直说,轻量化不只是把卷积换成深度可分离,把任务头统一掉才是最大刀阔斧的结构性减负——这和我在《YOLO26魔术师》《YOLO11魔术师》里折腾特征金字塔重构、注意力融合,其实是同一个追求:用更少的结构干更多的活。
2.3 数据引擎:多教师融合 + 任务验证 + 专家迭代
覆盖 11 类感知能力的高质量标注,不可能靠人工硬堆。GroundingPI 的做法是:多教师集成产出候选 → 字段级融合(box / mask / 属性逐字段校验)→ 任务特定验证(必填字段、覆盖率)→ 通过的标签训练统一的 grounding 专家 → 专家再迭代标注,不确定样本用互补教师与局部视图补全,标签版本化管理、失效即修订或退役。
💡 原理点拨:关键是"同一套规则贯穿每一轮迭代"。这避免了自训练里最常见的"错误累积"——脏标签一旦进池子就越训越歪。工业质检做数据闭环时可以照抄这个思路。
2.4 两阶段训练:SFT 打底,GRPO 精修
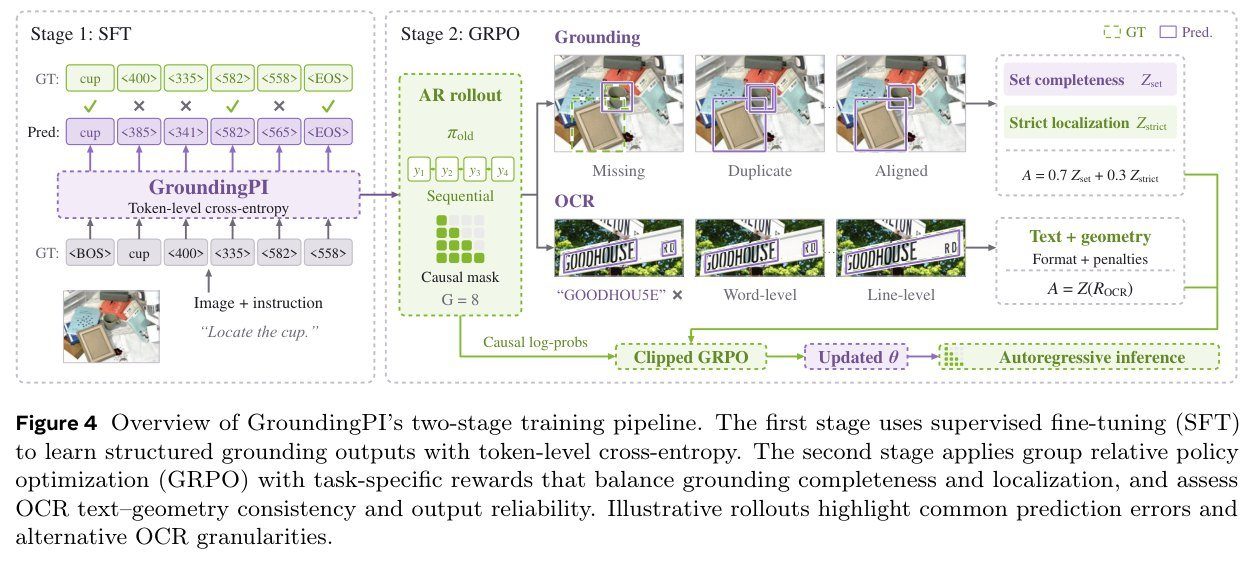
两阶段训练流程(Figure 4):Stage1 SFT + Stage2 GRPO
- Stage 1 · SFT:teacher forcing 下对响应 token(标签 + 协议 + 坐标)做逐 token 交叉熵,让模型学会"坐标对齐到视觉位置"。先更新全部模块,再冻结视觉编码器与 projector,只做语言侧精修。
- Stage 2 · GRPO 强化后训练:每个图文对采样 G=8 条自回归响应,用任务特定奖励直接优化定位质量:
R_set:参考框最大 IoU 匹配 + 类别校验,管覆盖度(漏检 / 重复);R_strict:多阈值 F1 + 定位 + 格式 + 数量 + 顺序,惩罚重复框与过大框,管定位精度;- 优势
A_i = 0.7\,Z(R_{set,i}) + 0.3\,Z(R_{strict,i});OCR 则改用匈牙利一对一匹配评估文本与几何一致性; - 冻结 SFT 参考模型,只更新语言参数。
💡 原理点拨:为什么 SFT 之后必须加 RL?因为交叉熵只教"逐 token 像不像",而检测真正在乎的是整组框的集合质量(漏一个、多一个、框大一圈)。GRPO 把 IoU、F1、数量、顺序这些不可微但真实存在的评价指标直接变成奖励——这一步是把"生成模型"炼成"检测模型"的关键,也是我认为最有工程参考价值的一招。
三、技术创新点:五个真正值得记的
# | 创新 | 为什么重要 |
|---|---|---|
1 | 视觉基元统一 11 类感知 | 点 / 框 + 量化坐标 token,一个自回归模型通吃检测、指代、计数、OCR、GUI、版面、视觉提示 |
2 | 4B 小模型做到综合 SOTA | 34 基准平均 73.68% > GPT-6 Astra 71.54%,证明"专而精"打得过"大而全" |
3 | Perception before Action | 把 grounding 做成独立基础模型,让动作策略站在感知肩膀上,而不是让稀缺动作数据同时承担感知学习 |
4 | 数据引擎 + GRPO 奖励设计 | 多教师字段级融合保证数据质量,集合级强化奖励对齐真实检测指标 |
5 | 原生拒识与物理提示 | 目标缺失输出 None;参考框可作空间提示(visual prompting),为"物理 prompting"留了接口 |
四、应用案例与性能对标(重点)
4.1 性能对标:四张主表,数字直接来自论文
说明:F1mIoU / accuracy / F1@Point 均为越高越好。下表为原表节选,保留代表性基线;GroundingPI 为综合平均 SOTA,个别单项并非第一,我照实标出,不做夸大。
Table 1 · 检测与指代 grounding(F1mIoU)
模型 | COCO | LVIS | Dense200 | VisDrone | HumanRef | RefCOCOg val | RefCOCOg test | RefCOCO avg |
|---|---|---|---|---|---|---|---|---|
GroundingDINO | 60.56 | 52.61 | 24.92 | 34.47 | 46.13 | 49.77 | 50.43 | 45.15 |
Qwen3-VL-4B | 46.53 | 49.86 | 14.02 | 31.14 | 70.06 | 75.27 | 75.88 | 75.24 |
Qwen3.5-9B | 51.99 | 48.87 | 30.02 | 32.84 | 73.51 | 76.20 | 76.28 | 76.08 |
Rex-Omni | 56.28 | 46.74 | 53.29 | 27.19 | 79.87 | 73.90 | 74.76 | 69.29 |
LocateAnything Hybrid | 59.12 | 49.56 | 50.07 | 28.57 | 78.52 | 76.43 | 77.67 | 78.06 |
SenseNova-Vision | 57.49 | 56.12 | 68.13 | 42.35 | 79.34 | 78.69 | 79.48 | 77.55 |
Qwen3.7-Max | 62.79 | 53.28 | 31.20 | 41.59 | 66.88 | 80.54 | 81.71 | 80.20 |
GPT-6 Astra | 62.75 | 54.97 | 65.04 | 37.12 | 83.01 | 74.98 | 78.91 | 77.81 |
GroundingPI | 62.98 | 56.02 | 74.53 | 40.44 | 88.56 | 85.62 | 84.36 | 83.92 |
小怪兽点评:COCO 62.98、LVIS 56.02、Dense200 74.53、HumanRef 88.56、RefCOCOg 85.62/84.36 全部第一;密集场景 Dense200 比 SenseNova-Vision 高出 6.4 个点,比 Qwen3-VL-4B 高出 60 个点,这才是"看得准"的硬证据。唯一例外是 VisDrone 40.44 略低于 SenseNova-Vision 42.35,如实标出。
Table 2 · 机器人 / 空间 / GUI grounding(accuracy)
模型 | RefSpatial avg | RefSpatial Unseen | RoboSpatial | ScreenSpot-Pro | ScreenSpot-V2 | OSWorld-G |
|---|---|---|---|---|---|---|
GroundingDINO | 14.25 | 4.33 | 4.92 | N/A | N/A | N/A |
Qwen3-VL-4B | 49.00 | 27.27 | 64.75 | 56.74 | 92.30 | 56.91 |
Qwen3.5-9B | 55.92 | 37.01 | 60.66 | 53.13 | 90.57 | 60.99 |
Rex-Omni | 51.75 | 37.01 | 59.02 | 36.75 | 88.29 | 46.10 |
Qwen3.7-Max | 68.75 | 57.14 | 69.67 | 55.06 | 81.13 | 49.29 |
GroundingPI | 75.50 | 75.32 | 73.77 | 65.78 | 96.15 | 74.82 |
小怪兽点评:这张表最能说明"感知基座"的价值——RefSpatial Unseen 75.32,比第二名 Qwen3.7-Max 的 57.14 高出 18 个点;GUI 上 ScreenSpot-V2 达 96.15。空间与交互级定位,正是操作机器人最需要、通用 VLM 最短板的一块。
Table 3 · OCR 与文档版面(F1mIoU)
模型 | HierText | ICDAR2015 | TotalText | SROIE | DocLayNet | M6Doc |
|---|---|---|---|---|---|---|
DocLayout-YOLO | – | – | – | – | 81.10 | – |
PaddleOCRv5 | 30.50 | 25.60 | 25.70 | 58.60 | – | – |
Rex-Omni | 34.46 | 45.65 | 52.35 | 48.35 | 68.06 | 54.95 |
SenseNova-Vision | 31.20 | 49.50 | 11.40 | 36.26 | 85.53 | 35.62 |
Qwen3.7-Max | 42.95 | 43.07 | 48.64 | 38.54 | 46.93 | 32.31 |
GPT-6 Astra | 39.58 | 48.87 | 53.55 | 53.57 | 77.54 | 60.59 |
GroundingPI | 41.70 | 55.68 | 49.32 | 72.47 | 85.08 | 74.82 |
小怪兽点评:ICDAR2015 55.68、SROIE 72.47、M6Doc 74.82 明显领先,连 PaddleOCRv5 这类专用 OCR 也被拉开。但 TotalText 49.32 低于 GPT-6 Astra 53.55、HierText 41.70 略低于 Qwen3.7-Max 42.95、DocLayNet 85.08 略低于 SenseNova-Vision 85.53——弯曲文本与超密版面仍是硬骨头,不吹。
Table 4 · 目标指点(F1@Point)
模型 | HumanRef | RefCOCOg val | RefCOCOg test | COCO | LVIS | Dense200 | VisDrone |
|---|---|---|---|---|---|---|---|
GroundingDINO | 46.85 | 49.34 | 49.97 | 70.41 | 55.07 | 32.93 | 39.45 |
Qwen3.5-9B | 78.21 | 77.59 | 77.85 | 72.21 | 64.00 | 65.35 | 44.73 |
Rex-Omni | 83.40 | 84.96 | 85.32 | 79.74 | 70.04 | 76.66 | 51.97 |
GPT-6 Astra | 83.83 | 87.80 | 84.90 | 82.17 | 77.14 | 86.57 | 65.62 |
GroundingPI | 88.79 | 90.26 | 90.06 | 84.79 | 79.51 | 81.27 | 67.47 |
小怪兽点评:指代点定位 90.26 / 90.06,是"点到可见表面"这种 affordance 级能力的体现;仅 Dense200 低于 GPT-6 Astra(81.27 vs 86.57)。
4.2 视觉案例:密集、遮挡、细小、艺术字,一个一个看
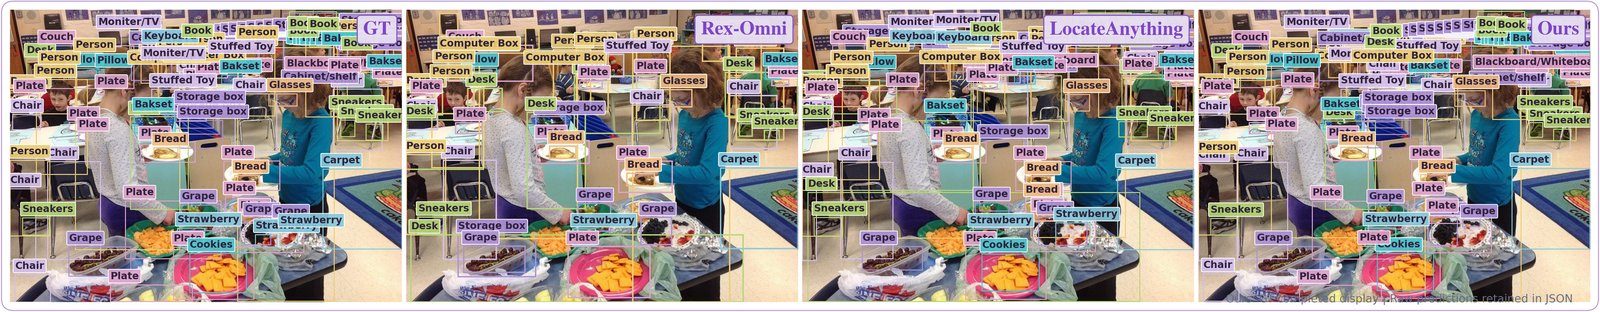
下面每张都是论文里的定性对比图,多数为 GT / Rex-Omni / LocateAnything / Ours 四列并排,最右列即 GroundingPI。
案例 1 · 密集长尾检测(杂乱早餐桌) 几十个类别、上百个框同屏:Couch、Monitor TV、Book、Person、Plate、Bread、Chair、Grape、Strawberry…基线要么漏、要么框错类,GroundingPI 逐一对齐。这正是 LVIS / Dense200 上 56.02 / 74.53 的直观来源。
密集长尾目标检测案例对比
案例 2 · 遮挡下的密集水果 骑车人果篮里密密麻麻的橘子:Rex-Omni 漏掉大半,LocateAnything 直接用一个大框糊弄,GroundingPI 逐果出框。密集小目标是工业瑕疵检测最常翻车的场景,这列的差距就是产线上的差距。
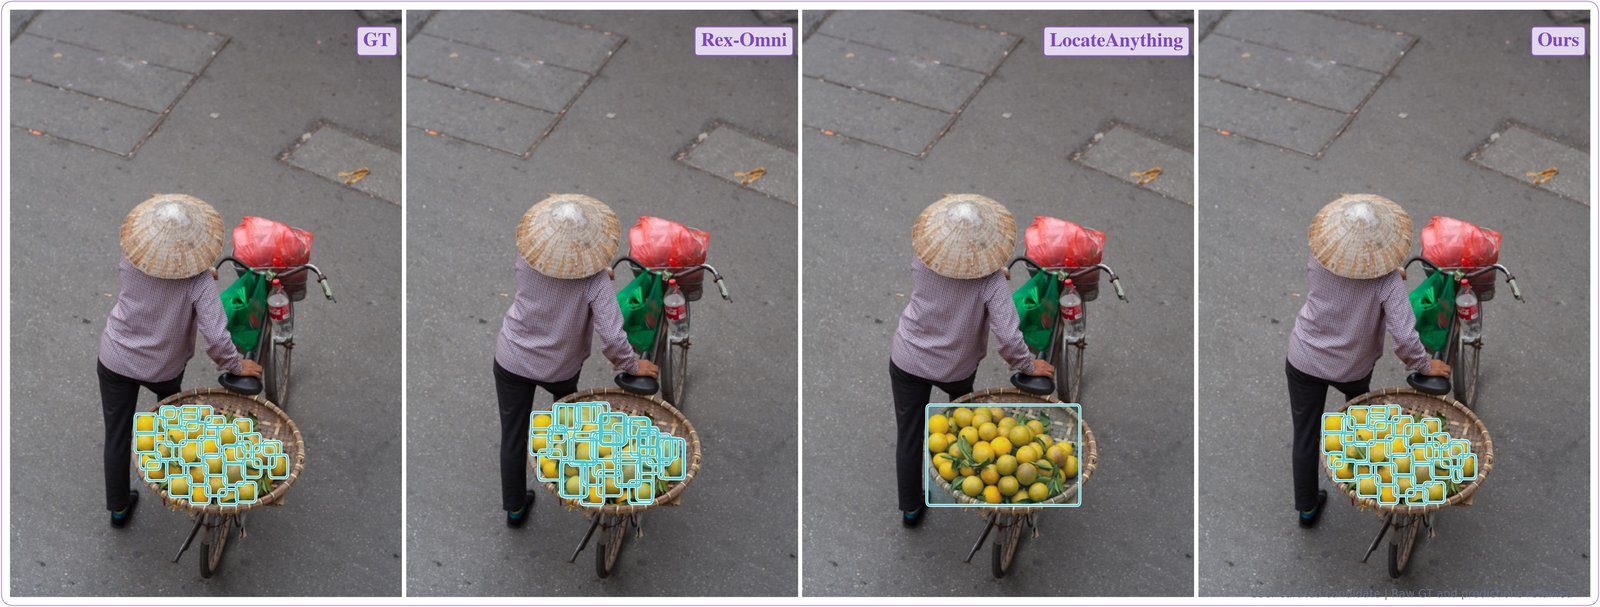
遮挡下密集水果 grounding 对比
案例 3 · 遮挡空间关系指代 查询 "the person who has their hand behind the other two people"——需要理解空间关系而非单纯匹配外观。GroundingPI 精准锁定,基线框错人或框不全。
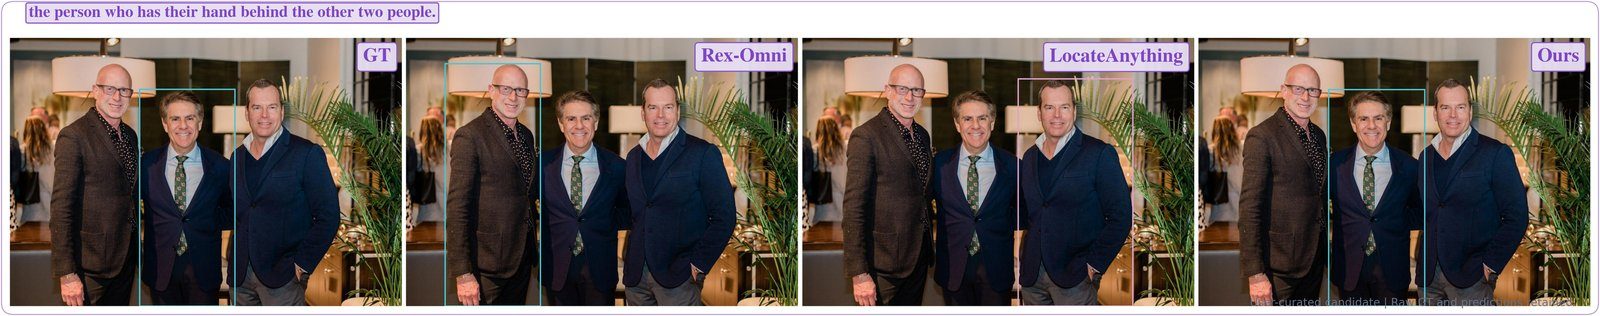
遮挡空间关系指代定位对比
案例 4 · 沙发可见表面点定位 给一段文字描述,要求在沙发可见表面上打点(不是整块沙发框)。这是机器人"往哪儿坐/往哪儿放"的 affordance 级感知,GT mask 与 Ours 高度吻合。
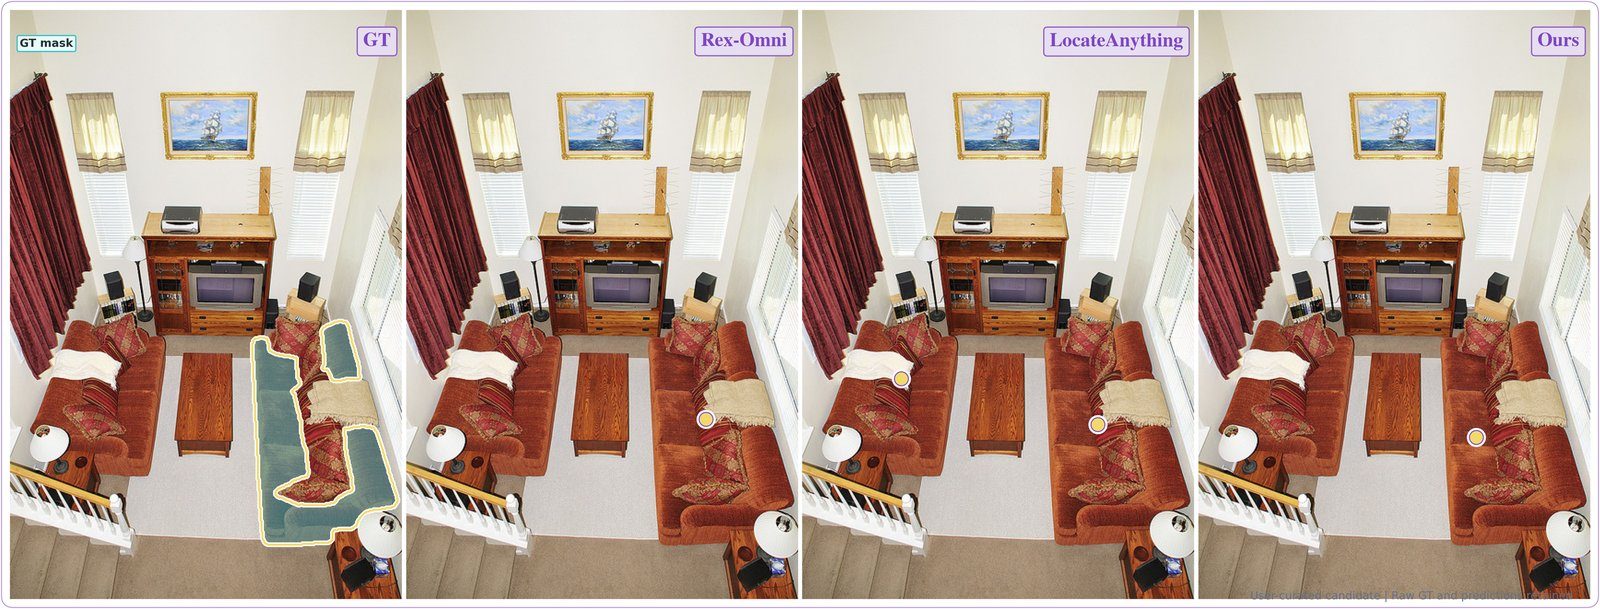
沙发可见表面点 grounding 对比
案例 5 · 航拍城市密集点 上百个屋顶目标要逐一点出,LocateAnything 出现成串误点,GroundingPI 分布与 GT 几乎一致。
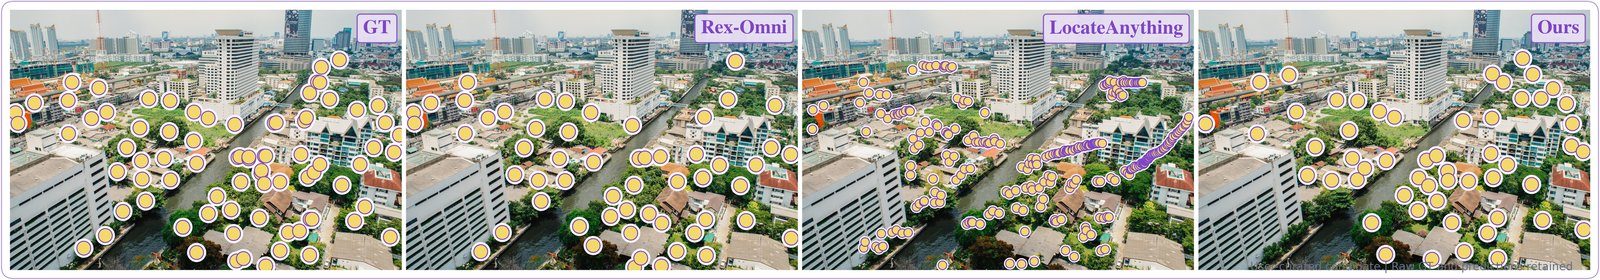
航拍城市密集点定位对比
案例 6 · 密集细管点定位 黑白图里密排的管材端点,LocateAnything 直接输出 N/A,GroundingPI 完整覆盖。密集点任务里"漏一个都不行"的严谨性,一目了然。
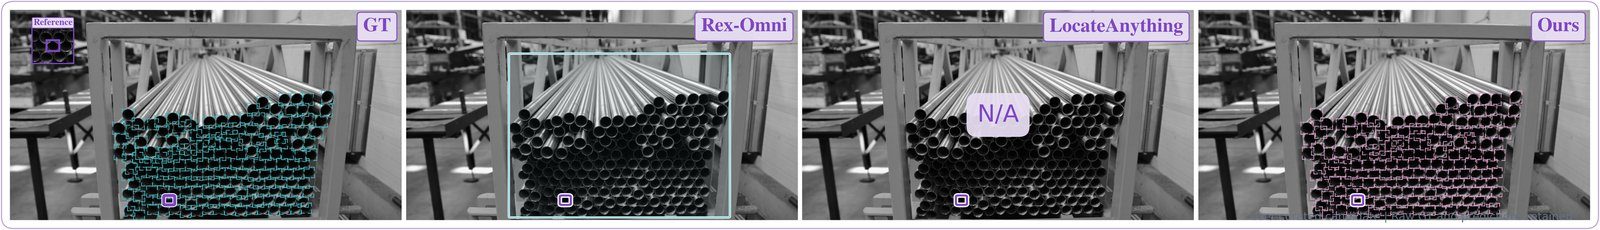
密集细管点定位对比
案例 7 · 艺术字 / 倾斜文本 OCR 彩色 Pride 海报,字体变形、倾斜、混排,GroundingPI 覆盖的文本区域明显更全。
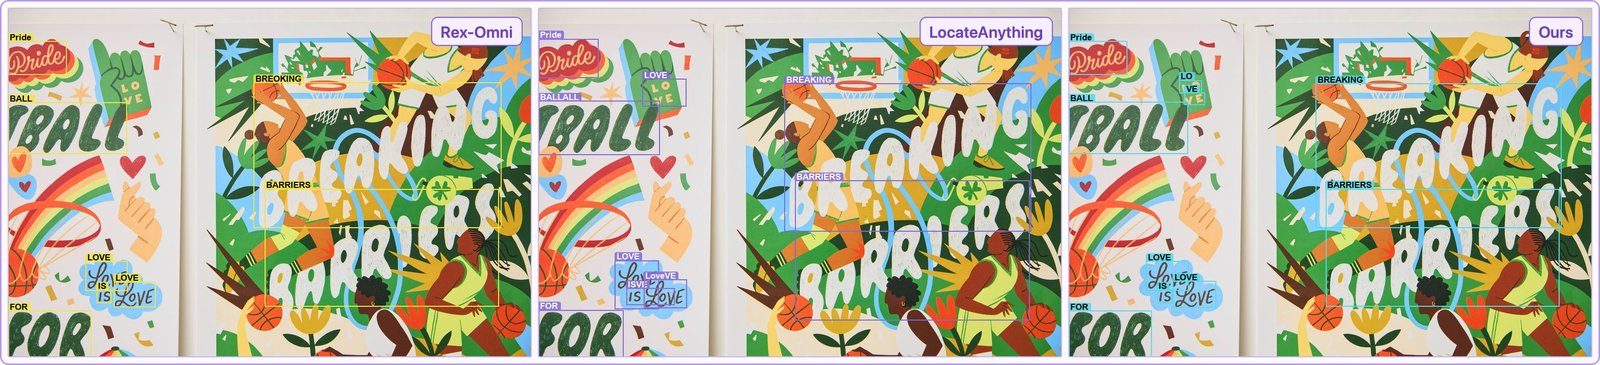
艺术字与倾斜文本 OCR 对比
案例 8 · 多语种包装与数字字段 OCR 荷兰语说明书 / 包装上的小字、数字、混合排版——小字密集是 OCR 的老大难。
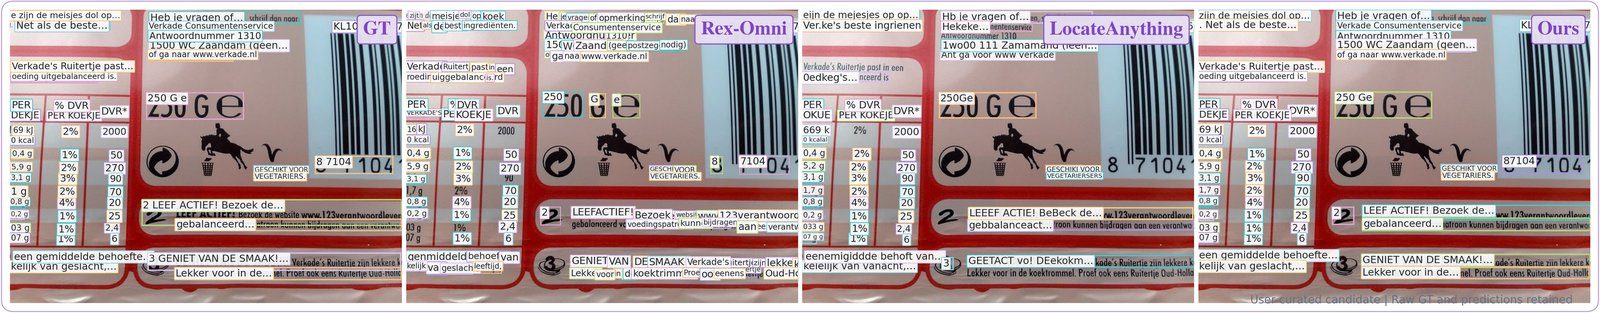
多语种包装与数字字段 OCR 对比
案例 9 · GUI 小侧栏控件 grounding 论文 Figure 18:在真实 GUI 里定位一个很小的侧栏控件。对应 Table 2 的 ScreenSpot / OSWorld-G,是 Agent 自动化的刚需能力。
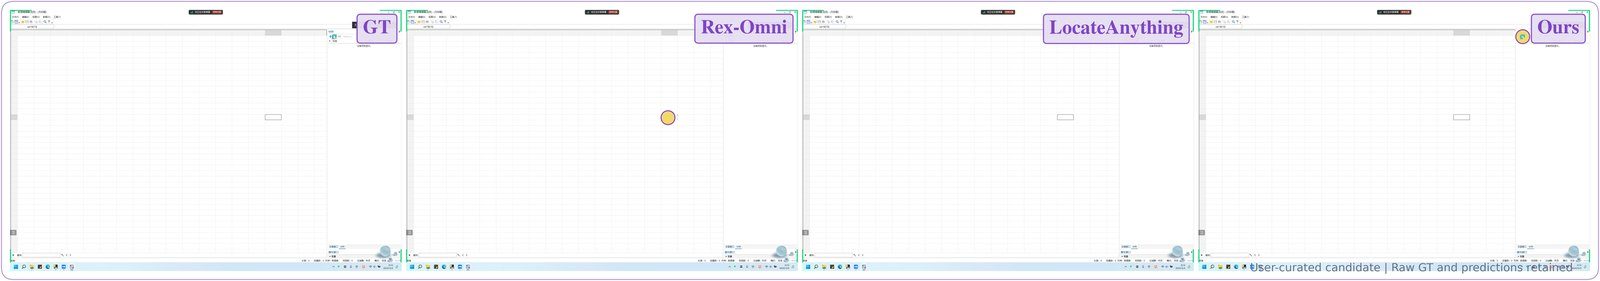
GUI 小控件 grounding 案例(Figure 18)
案例 10 · 复杂艺术海报的密集文本 OCR 黑白高对比艺术海报,超大变形标题与密集小字混排,最考验文本定位的"全不全、准不准"。
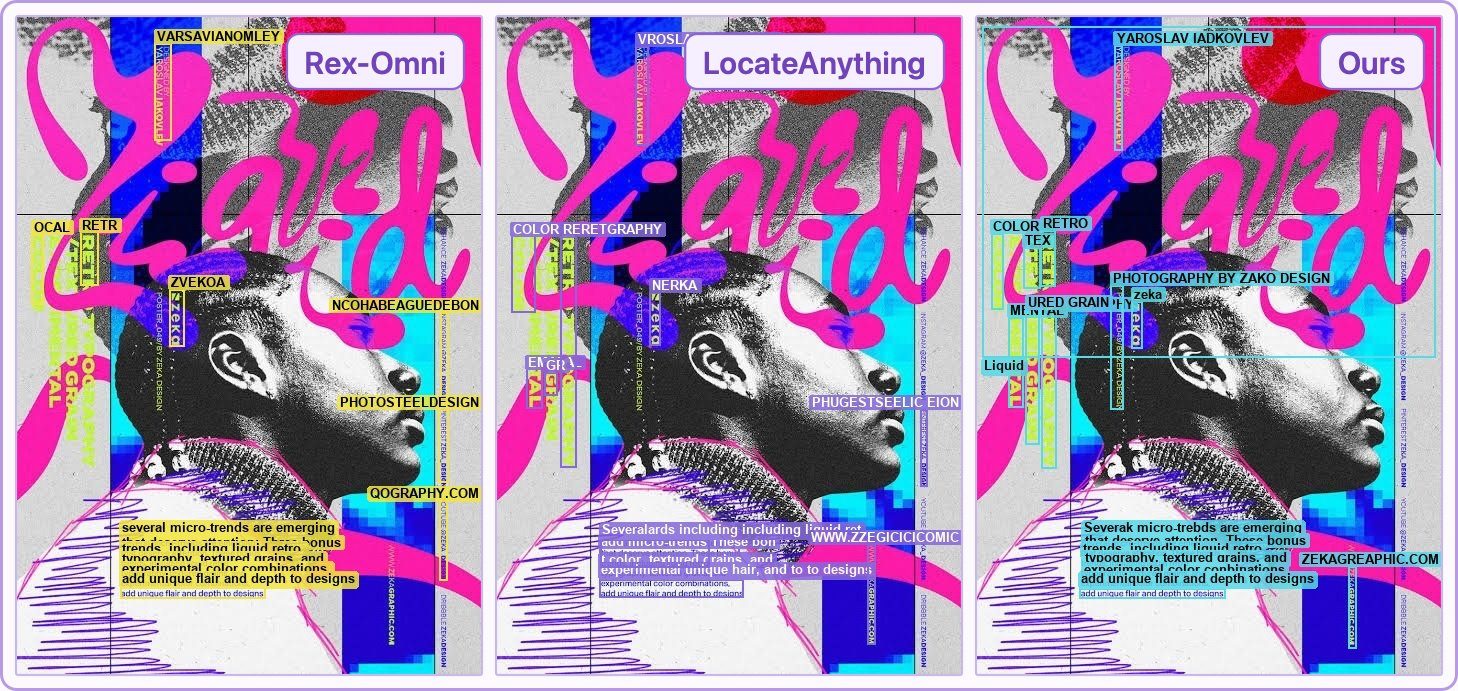
复杂艺术海报密集文本 OCR 对比
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号