向量索引上线前,先算清这三笔账
原创
向量索引上线前,先算清这三笔账
原创
数据库急诊室_阿哲
发布于 2026-11-13 09:39:50
发布于 2026-11-13 09:39:50
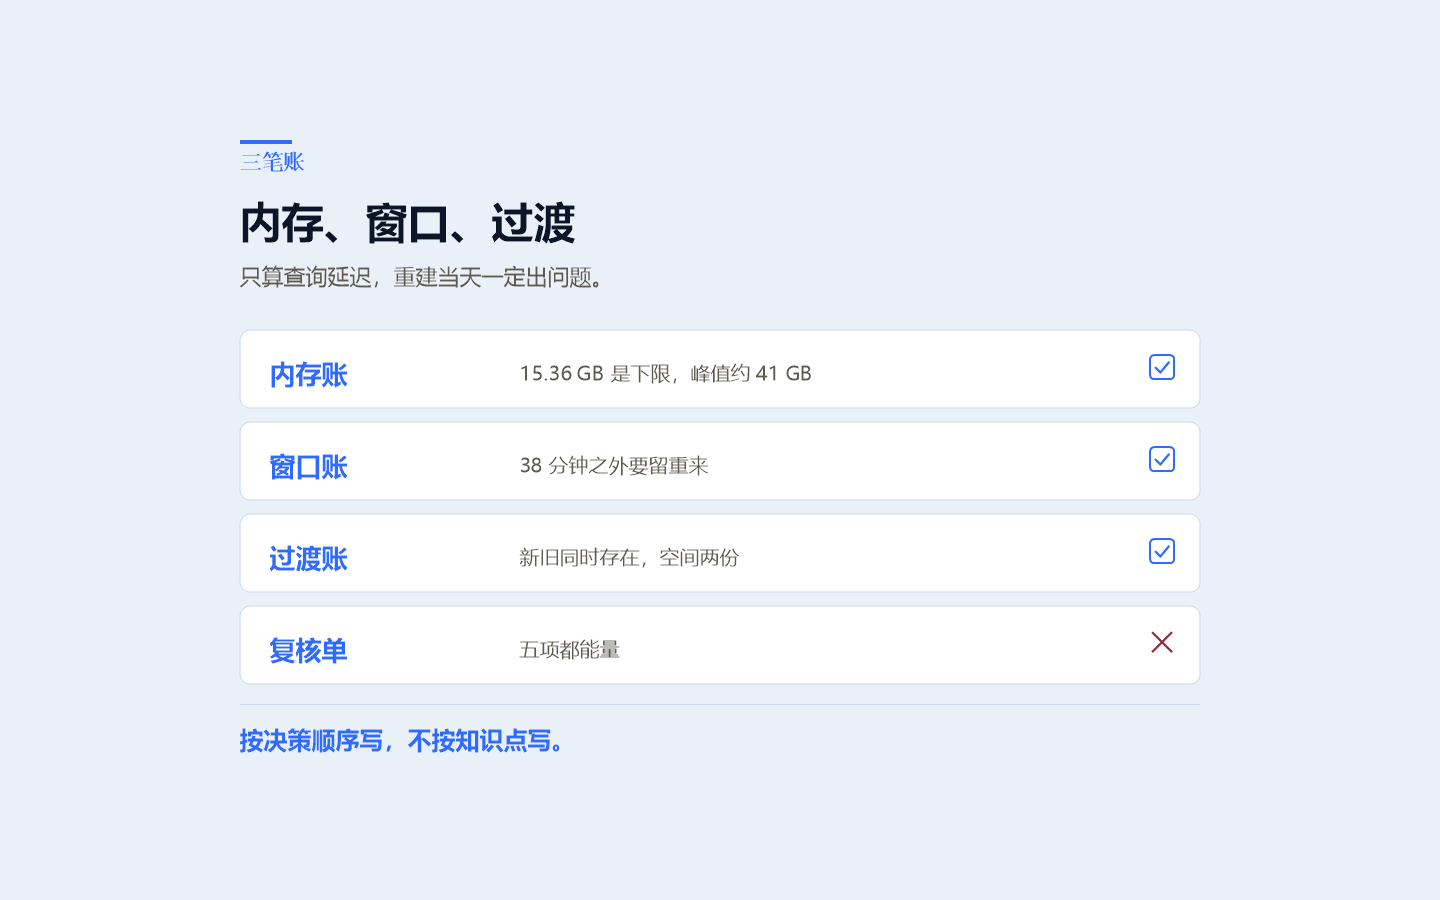
先给一个结论:向量索引的上线成本,等于内存常驻、重建窗口、双索引过渡三项之和。只算原始向量,扩容单一定被退回;只算查询延迟,重建当天一定出问题。
这篇按决策顺序写,不按知识点写。你可以拿它对照手上的扩容单,看哪一项还空着。
示例环境:5,000,000 条 chunk、768 维、原始向量约 15.36 GB、索引约 28 GB、内存高水位约 41 GB、全量重建约 38 分钟,HNSW 参数 m=16、ef_construction=64。均为脱敏教学假设,不是生产数字。
一、一张扩容单的两版
先看前后对比。左边是常见写法,右边是补完三笔账后的写法。
项目 | 退回版 | 补充版 |
|---|---|---|
容量依据 | 原始向量 15.36 GB | 原始向量、索引约 28 GB、峰值约 41 GB 分列 |
窗口依据 | “在线重建,影响不大” | 全量约 38 分钟,按 1.5 倍留 |
空间依据 | 只算一份索引 | 新旧两份同时存在 |
回滚依据 | “可回滚” | 旧索引保留时长、切回步骤、验证方法 |
观察依据 | 查询延迟 | recall、p95/p99、写入与复制延迟 |
两版的事实没变,变的是口径。退回版不是数字错,是数字不够用。
二、第一笔:内存账
原始向量算法很固定:
示例写法,语法因库而异
条数 × 维度 × 每个分量的字节数
5,000,000 × 768 × 4 ≈ 15.36 GB
但 15.36 GB 只是向量本身。HNSW 的图结构、索引页对齐、空闲空间、连接与排序内存、操作系统页缓存、副本进程,都不在这个数里。重建时新旧两份索引同时存在,峰值还要再抬。
查占用时至少分三列:表占用、索引占用、进程峰值。索引占用里通常混着普通字段索引,要单独拆出来,避免算重。
还有一个常见误差:把索引大小当成内存申请量。索引在磁盘上 28 GB,进程里不一定完整常驻,但查询热起来之后,页缓存会把常用部分带进内存;再叠加连接、排序和副本,峰值就会高于索引大小。申请内存看峰值,不是看索引文件。
m 和 ef_construction 也不是越大越好。m 提高,图更密,召回可能更好,索引更大、构建更慢;ef_construction 提高,构建质量更好,重建窗口更长。示例里的 m=16、ef_construction=64 只是教学参数,不是通用最优值,换参数要重算三笔账。
容量表还要有增长曲线。现在的 5,000,000 条不是一年后的条数;按业务增量估未来 6 个月,再乘索引膨胀系数。没有增长曲线的容量表,只能说明今天够用。
值班记录 现象:扩容单只写原始向量 15.36 GB,索引实际约 28 GB,内存高水位约 41 GB。 动作:按表、索引、峰值三列重算,并要求补增长曲线。 结论:原口径退回;内存申请按峰值加余量,不按原始向量。
三、第二笔:窗口账
重建要做四步:读全部向量、重算图结构、写新索引、切读路径。示例环境全量重建约 38 分钟,峰值内存约 41 GB,索引约 28 GB。
窗口不能按 38 分钟卡点,要按 1.5 倍留。多出来的时间不是浪费,是给失败重来、回滚和复制延迟恢复用的。
项目 | 示例值 | 决策含义 |
|---|---|---|
重建耗时 | 约 38 分钟 | 低峰窗口的下限 |
峰值内存 | 约 41 GB | 与查询、备份、跑批的叠加 |
索引大小 | 约 28 GB | 双份空间的基数 |
写入暂停 | 0 分钟(在线重建) | 不等于没有 I/O 代价 |
示例写法,语法因库而异
窗口前:确认长事务、磁盘余量、复制延迟基线
窗口中:盯复制延迟、I/O、查询 p95
窗口后:对比召回与延迟,保留旧索引观察
在线重建各库支持不同。不支持在线建的环境,就老老实实排停机窗口,不要为了“在线”两个字硬跑。长事务、复制延迟、磁盘不足,都会让重建失败或拖很久。
失败重来的成本要单独算。重建跑到一半失败,临时空间要清,旧索引要确认还能服务,窗口要重新排。如果只剩十几分钟就到业务高峰,正确动作是停,不是加速。
复制延迟是窗口里最容易被低估的一项。示例里从 0.6s 升到 2.4s,看起来还能接受,但如果业务对读一致性有要求,2.4s 已经足够让一部分查询读到旧数据。阈值要在窗口前定好,超过就暂停,不要边跑边商量。
值班记录 现象:重建期间复制延迟从 0.6s 升到 2.4s(示例值),查询 p95 抖动。 动作:窗口挪到跑批结束后,限制并发,复制延迟超过 3s 暂停。 结论:方案附条件通过;业务高峰不安排第二次重建。
四、第三笔:过渡账
重建不是“删旧建新”,而是“新旧并存、对比、切读、观察、再删旧”。这期间磁盘上要有两份索引的空间;如果换了维度或距离度量,可能还要多一列或一张表。
双份空间不只是磁盘问题。新索引建好后,备份体积、副本同步量、恢复时间都会跟着变。容量表上要写清楚观察期多长、旧索引什么时候删、删之前谁确认。
大批量导入另有一笔账:先建索引再灌数据,每插一行都要维护图结构,导入会被拖慢;先灌数据再建索引更快,但在线服务不能停,就要用 staging 表接增量,校验后再切。切表涉及权限、外键、序列、触发器、连接和备份,不是改一个表名。
切表前先做一次空跑:在 staging 上把建索引、校验、切表、回滚各走一遍,记录每步耗时。空跑不是多此一举,它能把“到时候再说”变成具体分钟数。
过渡期至少对比五项:
- 同一批问题的 recall@k;
- p95 / p99 延迟;
- 执行计划是否真的走索引;
- 写入延迟与复制延迟;
- 失败时能否切回旧路径。
切读路径建议灰度:先切一条低风险查询,观察一段时间,再扩大范围。保留切回开关,比在方案里写“可回滚”有用。
召回对比要用同一批问题、同一批期望结果,至少覆盖高频问题和边界问题。只看延迟下降,可能是索引参数变激进、召回变差换来的。
五、复核单
复核单不是让你打勾,是让你知道缺什么。每一项都要有证据,证据不在方案正文里,就在附件或监控记录里。
复核项 | 要看到的证据 | 通过 | 退回或不签 |
|---|---|---|---|
内存口径 | 表、索引、峰值三列 | 三列都有数 | 只写原始向量 |
窗口余量 | 重建耗时与 1.5 倍排期 | 覆盖失败重来 | 按平均值卡点 |
复制延迟 | 基线、阈值、暂停动作 | 有可执行阈值 | 只写“影响不大” |
双份空间 | 新旧索引大小与磁盘余量 | 能同时放下 | 建完再清盘 |
回滚 | 旧索引保留时长与切回步骤 | 演练过、可确认 | 只有“可回滚” |
观察期 | recall、p95/p99、写入延迟 | 覆盖业务日和跑批 | 只看查询延迟 |
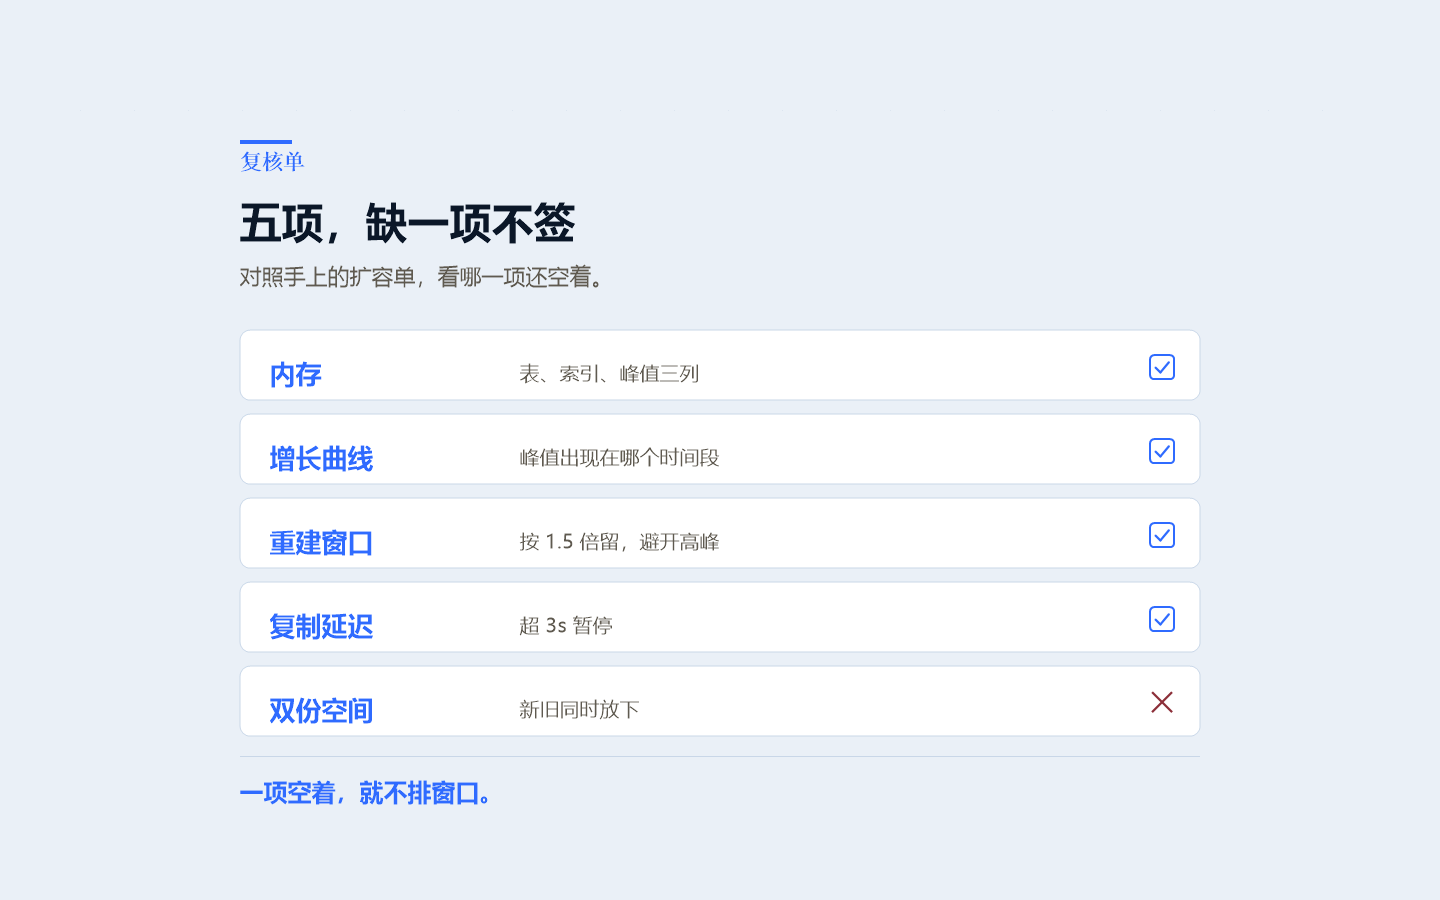
这张单子的适用条件是:有向量表、有监控基线、有可安排的低峰窗口。缺一项,先把基础补齐,再谈上线。每次重建前重走一遍,不要复用上一次的签字。
六、一条规则
三笔账都算完,再决定加不加内存、换不换参数、要不要延后上线。顺序反了,后面每一步都在补前一步的坑。
内存按峰值算,窗口按 1.5 倍留,过渡按两份算;三项缺一项,上线单不签。
同样的现象可能有别的根因,欢迎带数字来讨论。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号