MMAO怎样分配搜索资源?拆解收益、能量与角色反馈
原创
MMAO怎样分配搜索资源?拆解收益、能量与角色反馈
原创
用户4859102
发布于 2026-11-17 12:26:43
发布于 2026-11-17 12:26:43
两个搜索个体都找到了一次改进。一个把目标值从100降到90,另一个从1降到0.8。该怎样奖励它们?如果一个任务的目标值整体放大了1000倍,内部资源也跟着放大,控制过程就会受到数值尺度影响。
MMAO先处理进展尺度,再把反馈写入私有能量、公共资源池和角色。下面借助公开包0.2.0的连续实现,拆开一次资源更新,随后回到论文曲线观察它在整个搜索中的表现。
先确认反馈在评价什么
下文数值演算对应明确的配置,实际运行记录还应注明目标函数、随机种子以及软件版本。
当前目标值与近期改进分别提供位置信息和进展信息,可以用两个个体比较它们的含义。假设甲从100降到90,乙从2降到1.9,甲本轮改进10,乙本轮改进0.1,而乙当前方案更接近目标。这些信息分别描述位置质量和近期收益,控制规则需要明确使用哪一种。
公开连续实现会先计算当前个体这次接受动作的改进量,再将其转换成资源奖励。历史较好位置为动作提供参考,近期改进则进入收益更新。读源码时,可以分别标出这些信号的来源,避免把一个个体已经很好的位置误读为它每轮都在获得收益。
目标函数的方向也应先确定。最小化任务的正向改进来自旧值减去新值,最大化任务则需要相应转换。若方向写反,程序可能奖励较差候选,后续再精细的资源策略也会沿着错误反馈运行。手算两个位置的优劣,是接入前最直接的检查。
此外,目标变化可能受到噪声影响。一次模型训练的评分升高,既可能来自更好的配置,也可能来自训练随机性。使用噪声较大的业务评价时,可以先重复评价少量固定配置,估计正常波动,再考虑怎样定义有意义的进展。
用一个可以手算的例子拆开资源账目
假设某个个体的目标值从10降到8,本轮改进为2。再假设当前进展尺度为1,个体能量为6,角色为0.5,停滞次数为0。这是一组教学用输入,便于演算源码中的更新规则。
该实现把改进除以进展尺度,再取log1p并设置奖励上限。这个例子的奖励约为1.0986。默认共享比例为0.25,因此约0.2747进入公共资源池,约0.8240留给个体。
维持支出还与角色和停滞有关。按默认系数0.14计算,此时支出为0.154,个体能量更新为约6.6700。下面的独立代码可直接运行,复核这笔计算。
import math

energy = 6.0
role = 0.5
stagnation = 0
raw_gain = 10.0 - 8.0
progress_scale = 1.0
communal_share = 0.25

reward = min(4.0, math.log1p(raw_gain / progress_scale))
donation = communal_share * reward
maintenance = 0.14 * (0.9 + 0.4 * role + 0.1 * min(6, stagnation))
new_energy = min(16.0, max(0.0, energy + reward - donation - maintenance))

print(round(reward, 4), round(donation, 4), round(new_energy, 4))输出为1.0986 0.2747 6.67。读者可以把raw_gain改为0再算一次。此时奖励和捐赠均为0,维持支出仍然存在,能量会降到5.846。
这让持续没有收益的搜索方向承受资源压力。实际运行中,进展尺度来自近期改进记录并带有回退值,个体还可能受到分支、补充等规则影响,因此整轮账目需要结合完整日志。
为什么还要做进展尺度转换
设想把同一个误差函数整体乘以一千。方案之间的优劣顺序保持一致,原始改进却都放大了一千倍。如果直接把原始改进作为资源奖励,能量与公共池的变化就会明显受到数值单位影响。尺度转换让反馈更便于在不同数值范围中使用。
公开包的这项实现从近期正向改进中取统计尺度。它将正向值排序,组合中间位置与较高分位的值,同时设置很小的正数下界。近期没有正向改进时,则使用回退尺度。这样,搜索开始阶段与长期停滞阶段都能继续完成更新。
归一化后还要经过对数转换与奖励封顶。前面的改进2、尺度1得到约1.0986。如果把改进增到20、尺度仍为1,奖励约为3.0445,增长速度已受到压缩。更大的归一化改进继续受上限约束。读者可以在原代码中更改输入,观察原始改进与实际奖励怎样对应。
尺度本身也会随近期记录改变。同样大小的原始改进,发生在高收益阶段和低收益阶段,可能得到不同归一化结果。这是使用运行状态进行反馈的一部分。调试时,把原始改进、尺度和奖励同时打印,比只看最终能量更容易解释一次跳变。
成功和停滞会怎样积累成资源压力
假设前面教学个体下一轮没有得到改进,它会继续支付维持支出。若停滞持续,支出中的停滞项也会变化,角色还会根据能量压力更新。因此,多轮失败对状态的影响需要逐轮计算,直接把第一轮支出乘以停滞轮数容易漏掉这些变化。
能量上限也会改变账目。若个体已经接近上限,新增奖励可能在投影时被截取,公共池捐赠则按相应规则单独处理。核对一轮账目时,应注明奖励、捐赠、维持支出和投影的执行顺序。虚拟资源按照控制规则生成和支出,账目含义由实现定义。
可以给单个个体保存一条较细日志,包括更新前能量、奖励、捐赠、维持支出、更新后能量和停滞次数。连续看几轮,就能解释它为何保持活跃,或为何逐渐接近移除阈值。这种个体记录也能补充种群平均值没有展开的信息。
角色怎样把这次收益传到下一轮
同一个成功例子中,默认角色反馈率为0.12。归一化改进为2,更新中的截断项取1,角色增加0.09,从0.5变为0.59。
在这一连续实现中,较高角色会缩小感知半径和随机扰动幅度,同时改变记忆牵引等项的权重,推动局部细化。没有改进时,角色则根据能量压力向下调整,让后续尝试有更强的探索倾向。
这样就能顺着代码回答一个具体问题。这个方向为何在下一轮采取了更细的动作?因为本轮获得改进,改进改变了角色,角色参与下一轮动作生成。
角色更新与候选生成之间存在随机性,局部细化能否继续产生收益还取决于问题结构。记录多轮状态,可以查看反馈是否形成了预期的行为。
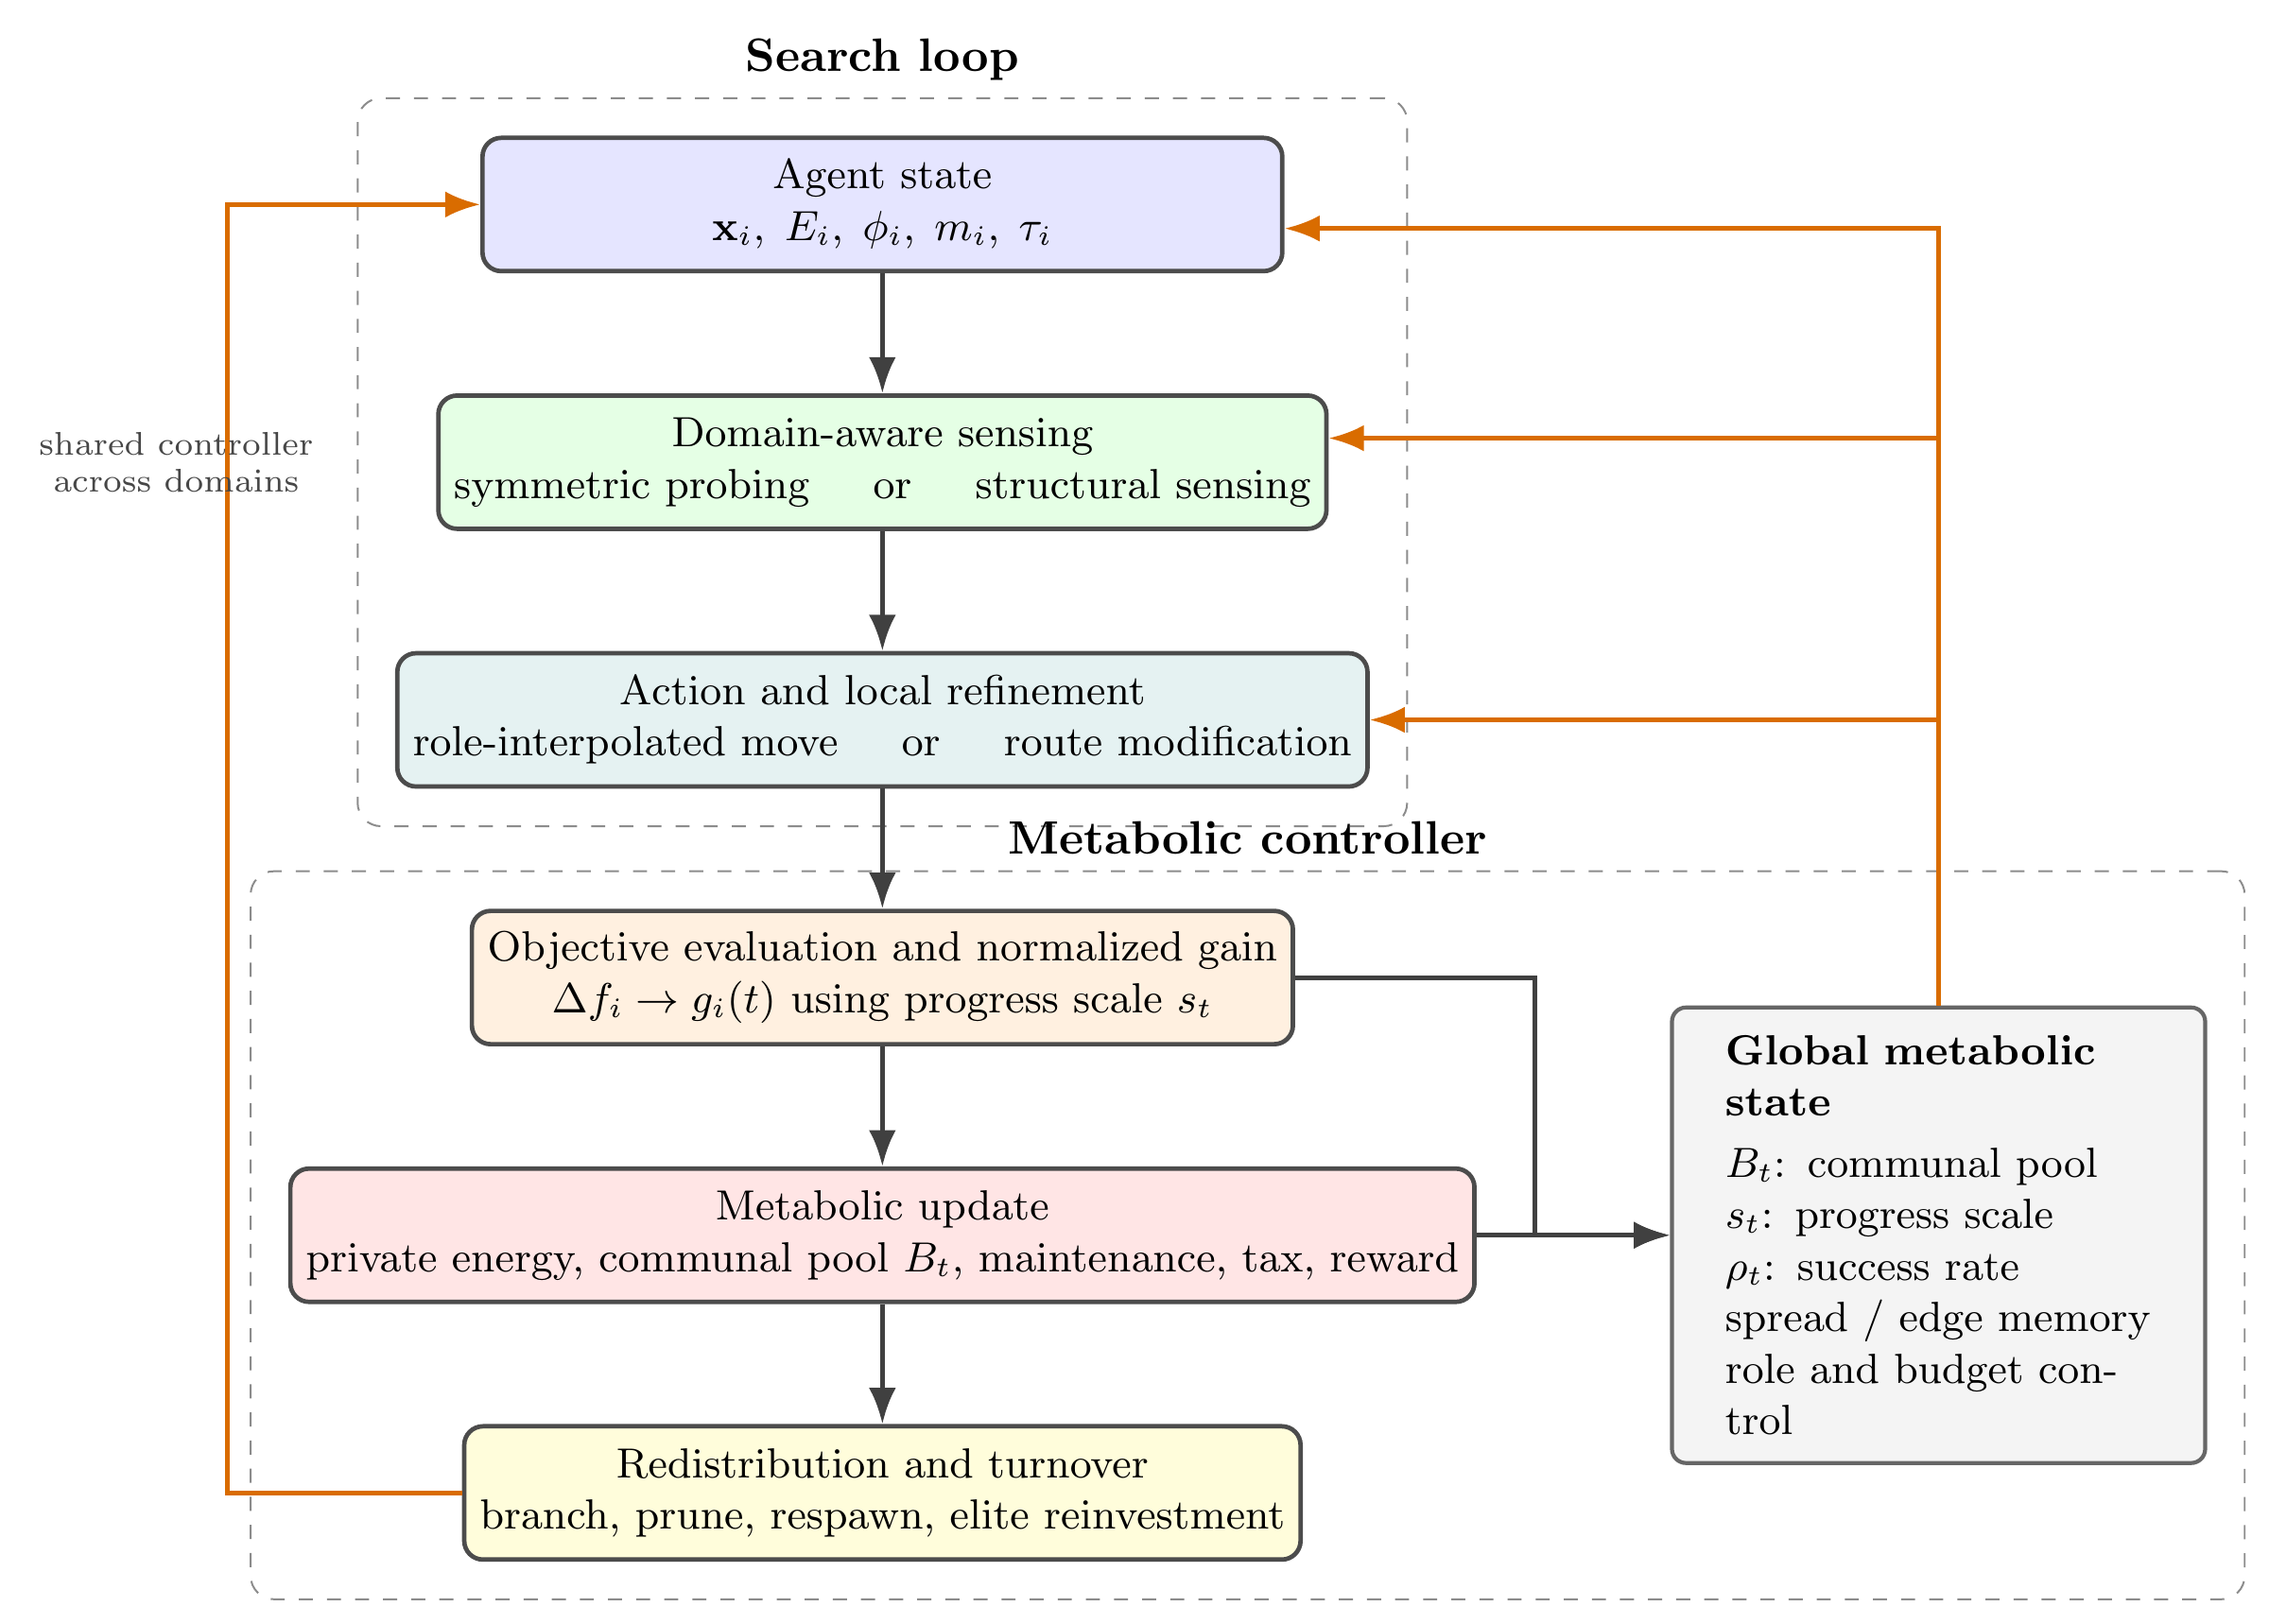
MMAO资源闭环与搜索循环
图1 框架论文对应项目中的搜索循环,保留原英文图面。
看图1时,重点沿着评价结果回到资源更新,再回到候选生成的路径。候选解提供反馈,资源和角色携带反馈,下一轮动作消费这些状态,三者组成连续循环。
角色数值怎样变成动作差异
角色的作用应到动作生成处检查。公开连续实现用角色参与感知半径、随机扰动和记忆牵引项的计算。较低角色会提高部分探索尺度,较高角色则加强相应的细化倾向。具体影响由多个项共同决定,单独读一个参数名称很难还原动作。
假设两个个体位于同一位置、拥有相近记忆,但角色分别为0.2和0.8。采用相同的随机方向,可以计算两者的试探位置和组合候选,查看角色到底改变了哪些分量。这是一项容易控制变量的小检查,也能帮助发现配置名称与实际实现之间的误读。
角色变化还具有速度。反馈率过大时,连续几次成功或失败就可能让角色靠近边界。反馈率较小时,状态保留更久,但对环境或收益变化的反应也可能较慢。选择反馈率时,可以查看动作改变用了多少轮,以及这种改变之后是否出现有效进展。
种群平均角色同样需要解释。平均值0.5可能来自所有个体都接近0.5,也可能来自两组分别偏探索与偏细化的个体。若研究分工,可以同时保存角色的最小值、最大值或分位数,观察平均值背后的分布。
公共资源的支出条件同样重要
一部分奖励进入公共池之后,程序仍要决定何时使用。公开连续实现会检查公共资源是否达到分支门槛、父个体能量是否足够,以及种群是否还有新增空间,再决定是否生成子个体。
是否增加种群还取决于父个体状态、分支门槛与剩余空间,公共池可以按这些条件继续保留储备。这也解释了为何读日志时应把公共资源、父个体状态和种群上限放在一起看。
用两组配置探索共享比例时,可以保持任务、种子和迭代数相同,只更改communal_share,比较私有能量、公共池和最终目标。共享比例增大,会同时减少个体保留的奖励,影响可能沿多条路径传递,仍需统计实际评价成本。
顺着一次分支检查公共池怎样被使用
公开连续实现的默认分支门槛包括公共池阈值和父个体能量阈值,种群还需低于上限。假设池中已有3个单位,父个体能量为5,当前种群仍有空位,就可以继续进入后续新增判断。若同样的池余额配上一个能量不足的父个体,则可能暂时保留资源。
进入分支后,程序按父个体较好位置附近的尺度生成子个体,给它分配初始能量,并扣除相应公共支出。子个体也要接受目标评价,这次调用应进入真实成本统计。若一轮有多个父个体满足条件,执行顺序和剩余余额还会影响后续新增。
因此,公共池从3降到某个数值,需要结合这轮产生了哪些子个体解释。只看余额下降,无法知道投入落在多少个位置,也无法确定这些位置后来是否取得了收益。进一步记录父子关系、生成位置和后续改进,才能评价再投入质量。
补充机制则处理种群保护与恢复覆盖等需求。它可能利用较好位置附近的信息,也可能从更分散的位置生成候选。分支和补充在触发条件上各有规定,读源码时可以分别跟踪,检查它们是否同时影响了某段轨迹。
共享比例改变的可能是一整条反馈路径
提高共享比例会增加进入公共池的奖励份额,同时减少个体留存部分。在其他条件相同的演算里,池更容易积累,父个体却可能更难维持足够能量。两条路径会共同影响新增、存活与后续收益,最终结果需要结合运行记录判断。
可以用同一问题和同一组种子,比较几种共享比例,保存最终目标、实际调用数、公共池和种群轨迹。先观察状态是否按预期变化,再判断额外支出是否换来质量改善。如果只报告最终分数,就难以解释共享机制到底通过哪个环节发生作用。
停滞怎样通过反馈链影响探索
在这里介绍的连续实现中,近期改进减少后,奖励会减少,维持支出继续发生,停滞次数也会累积。能量压力与失败反馈参与角色更新;较低角色又会增加部分试探与扰动尺度。于是,收益变化可以沿着状态更新传到下一轮动作。
个体更替提供另一条路径。长期低能量个体满足移除条件且种群允许时,可以被移除;随后按相应规则补充个体。若补充位置覆盖更分散区域,就可能恢复探索。程序达到种群下限后,移除保护会影响这条路径,仍需检查剩余个体的动作与补充条件。
公共资源的再投入位置同样重要。围绕当前精英生成候选,有利于继续细化已发现区域;跨区采样或较强扰动则有机会寻找其他区域。两类投入的作用应结合新增位置和后续收益判断。成功奖励也可能持续集中到同一局部低谷,因此共享比例、角色变化和新增策略需要共同观察。
可以给一次停滞事件串联四项记录,最近成功率何时下降,角色何时改变,候选覆盖随后怎样变化,以及哪个新候选再次改善目标。若链条停在资源或角色变化,就继续追踪动作生成与再投入条件。这能解释一项控制变化怎样转化为实际搜索机会。
从四个面板读出搜索在怎样变化
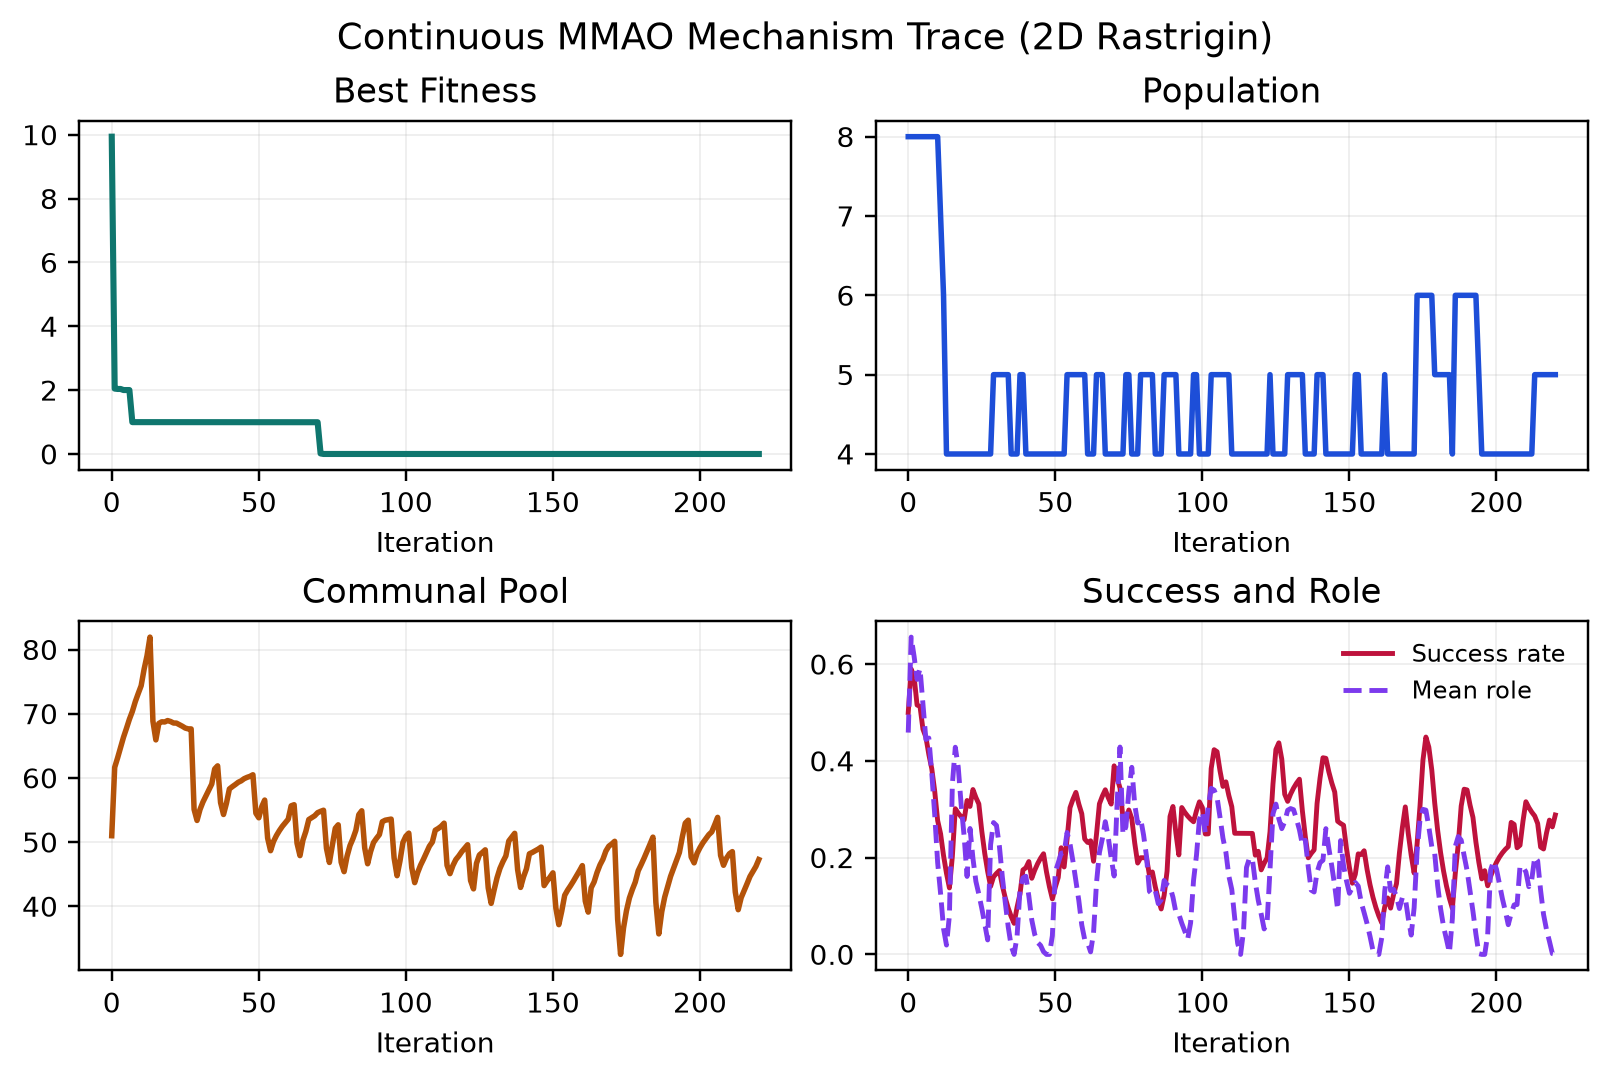
连续优化中的机制轨迹
图2 框架论文的二维Rastrigin代表性轨迹,记录目标值、种群规模、公共池、成功率和平均角色。
先找目标值明显下降的区间,再对照资源池与角色的同期变化。目标改善后出现资源积累,符合收益进入资源系统的设计。接着查看种群变化,判断资源是否伴随新增或替换动作。
最后关注目标值平台期。平台期仍可能发生资源消费、角色转移和种群变化。把这些变化与随后有没有再次改善联系起来,才能进一步分析投入是否有效。图2描述一次代表性过程,机制效果还应结合重复运行与消融结果。
调试时,先查哪一笔账
现象 | 先核对什么 | 可以尝试的小范围检查 |
|---|---|---|
一次改进让能量突然升高 | 进展尺度、奖励上限 | 打印原始改进、尺度和奖励 |
个体很快失去能量 | 奖励频率与维持支出 | 保持其他项不变,小幅调整维持系数 |
公共池积累却少有新增 | 分支条件、种群上限 | 记录每个门槛是否满足 |
角色长期接近边界 | 连续成功或停滞的记录 | 联合查看动作幅度和目标变化 |
这些检查可以从一条个体日志开始。把一次收益如何入账、一次支出为何发生、一次角色变化怎样影响动作说清楚,再扩大到整个种群,会更容易定位资源反馈中的问题。
给资源循环做一次逐项检查
准备排查异常时,可以从最短的一段日志开始。选一个发生明显改进的个体,手动复算收益转换,再核对捐赠与能量更新。随后查看角色变化,最后查看轮末有没有移除或新增。沿执行顺序检查,通常比同时改动多个系数更容易定位原因。
如果资源奖励突然变大,先检查目标值和尺度,尤其是近期正向记录是否接近零。如果能量长期偏低,则比较实际奖励频率与维持成本。如果角色总是很快到达边界,则检查更新速度和成功、停滞判据。这些检查都能从已有字段继续展开。
对公共池而言,一个值得追踪的事件是高余额持续存在。可以记录每一轮分支门槛、种群上限与父个体条件是否满足。高余额可能对应尚未消费的储备,也可能对应支出条件长期被阻挡。明确原因后,再决定调整哪条规则。
对真实业务而言,还应建立预算终止条件。目标评价次数、总耗时或外部调用额度达到限制时,需要明确怎样结束搜索、返回哪个已评价方案,以及保存哪些状态。内部资源可以帮助组织搜索,业务预算则直接约束可用计算。
一次完整记录还应说明何时停止。按迭代数停止、按评价次数停止和按目标容差停止,会产生不同的资源消费过程。比较两组配置时,把停止规则与调用统计一起保存,才能解释它们为何得到不同终点。
最后可以把一次运行分成几段,观察资源流入、支出和目标改善各集中在哪里。如果后期仍在频繁新增而目标已经稳定,下一步可以检查细化或新增策略。如果早期覆盖不足,则可以检查初始种群与探索动作。每一项调整都对应一个可以回到日志验证的问题。
还可以做一个很小的账目练习。保持尺度为1,把原始改进依次设成0、0.1、1和2,分别计算奖励、公共捐赠与个体净变化。再把停滞次数设成几个不同值,观察同样奖励在不同维持支出下如何影响能量。这里比较的是一次更新规则,可以手动核对每一步。
随后将这些固定输入换成实际日志中的一轮。若演算结果与程序不同,检查截断、默认参数、更新顺序和版本差异。若每一步都一致,仍然没有预期的搜索收益,就应继续追踪候选位置、动作质量与真实成本,判断资源安排是否适合该问题。
保存实验配置时,可以把共享比例、角色反馈率、维持成本以及分支门槛放在一起记录。它们共同影响闭环,任何一个默认值变化都可能改变轨迹。这样,几周后重新查看结果时,仍能根据同一组条件解释资源如何变化,并继续开展可重复的比较。
资料来源
- 《MMAO: A Metabolic Multi-Agent Optimizer with Endogenous Resource Allocation for Continuous and Discrete Optimization》。arXiv:2606.28109
- 《MMAO: A Unified Resource-Regulated Controller for Cross-Domain Optimization》。DOI:10.1109/ACCESS.2026.3752083
- 算法实现与使用说明。wolfbrother/mmao(GitHub) · mmao-opt(PyPI)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号