MMAO效果到底怎样?从结果表读懂优势、预算与证据
原创
MMAO效果到底怎样?从结果表读懂优势、预算与证据
原创
用户4859102
发布于 2026-11-17 12:31:13
发布于 2026-11-17 12:31:13
同一张MMAO结果表中,Berlin52的数值明显优于参照方法,Sphere-10D却明显落后于CMA-ES。究竟该怎样评价这个算法?
可以从论文中挑出三行,把比较对象、计算预算、波动和统计结果逐项读完。这样做,也能帮助准备复现实验的读者确定应该记录什么。
第一行,Berlin52的优势具体有多大
IEEE Access论文采用十个随机种子,给出如下主结果。表中的“±”为95%置信区间半宽,各任务指标均为越低越好。
任务与指标 | MMAO | 参照方法 | Holm校正后的p值 |
|---|---|---|---|
Berlin52最优差距 | 6.610% ± 1.470% | CI+2opt,15.360% ± 1.580% | 0.016 |
Sphere-10D目标值 | 9.650e-5 ± 4.120e-5 | CMA-ES,2.450e-10 ± 4.740e-10 | 0.008 |
Dynamic Sphere离线误差 | 40.670 ± 7.110 | Dynamic-PSO-lite,69.310 ± 5.610 | 0.016 |
Berlin52上的差距相差8.750个百分点,校正后的p值为0.016。结合指标方向,可以说在该配置与种子设置下,MMAO相对CI+2opt获得了有统计支持的改善。
继续翻表会看到,专门路线方法Elkai-LKH在该实例达到已知最优值,差距为0。这提供了另一个参照层次。评价一套资源控制设计时,轻量方法有助于检验基本收益,专门方法则展示同一任务上能够达到的求解水平。
比较对象为什么会改变结论的含义
同一个结果可以回答不同层次的问题。与随机搜索比较,能够观察有组织的搜索是否利用了反馈。与轻量进化或群智能方法比较,能够检查相近实现复杂度下的表现。与成熟领域方法比较,则更接近使用者关心的竞争力。
Berlin52的CI+2opt将路线构造与局部改进结合,为控制层比较提供一个可复现的参照。Elkai-LKH在同一任务上的结果则展示了专门路线方法的求解水平。引用结果时,把参照名称和配置写出来,读者才知道优势是在什么条件下得到的。
还可以查看比较方法是否采用推荐设置、是否经过调参,以及这些调参消耗是否被计入。一个方法使用大量任务专门调整,另一个使用默认配置,最终排名就同时反映了配置投入。公平比较需要说明这些投入,而具体口径应由实验目标确定。
对准备采用算法的人,可以先问自己的任务更接近哪类参照。如果已有成熟求解器,就需要比较质量与成本。如果目标是研究反馈机制,则需要更严格地固定领域算子。先明确要回答的问题,才容易选择有解释力的比较对象。
第二行,接近零也要看精度要求
Sphere-10D上,MMAO的目标值已经小于万分之一,但CMA-ES约为2.450e-10,精度明显更高,统计比较也支持CMA-ES。一个方法“看起来已经很好”,仍可能与另一方法存在实际差距。
这个差距是否重要,要联系使用要求。若工程任务只需达到某个容差,可以进一步比较达到容差时的评价次数。若研究关注高精度求解,则需要保留接近最优区域时的细化表现。
论文中这一连续比较还有一项重要设置,CMA-ES的调用上限与测得的MMAO评价次数对应,且上限不超过相应MMAO调用数。读取这行结果时,精度和调用预算应放在一起看。
把数值换成能够检查的使用要求
目标值小到什么程度才有意义,取决于问题。若某个任务要求误差低于万分之一,MMAO在Sphere-10D的平均值接近这条要求,但平均值达标仍需结合每次运行检查。若要求达到更高精度,就需要继续查看末期结果和调用成本。
可以为每次运行记录第一次达到阈值的评价次数。这样,最终都获得较小目标值的两种方法,也能在达到要求的速度上比较。若一部分运行始终没有达到阈值,则同时报告成功比例和未达标情况。
对于实际系统,质量容差还可能来自业务指标。例如一条路线允许增加多少路程,一套参数最多允许多大误差,一次变化后必须在多久内恢复。把这些条件事先写明,可以避免在看到结果后再挑选最有利的解释。
使用相对指标时,还要核对分母。路线差距常以已知最优长度为基准,连续任务的理论最优值则可能为零。接近零时,相对误差可能非常敏感,因此报告绝对残差往往更容易阅读。论文采用的指标定义,应和数字一起引用。
第三行,动态误差还包含恢复过程
Dynamic Sphere的40.670与69.310反映运行过程中的离线误差。环境变化后恢复较慢,会让误差持续累积,因此这个指标包含了跟踪和恢复表现。
同一张表里,静态目标值、路线差距和动态误差分别衡量不同内容。三行可以帮助了解跨任务表现,跨行数值的大小则各有尺度。准备业务实验时,也应先明确需要最终精度、全程误差,还是变化后的恢复时间。
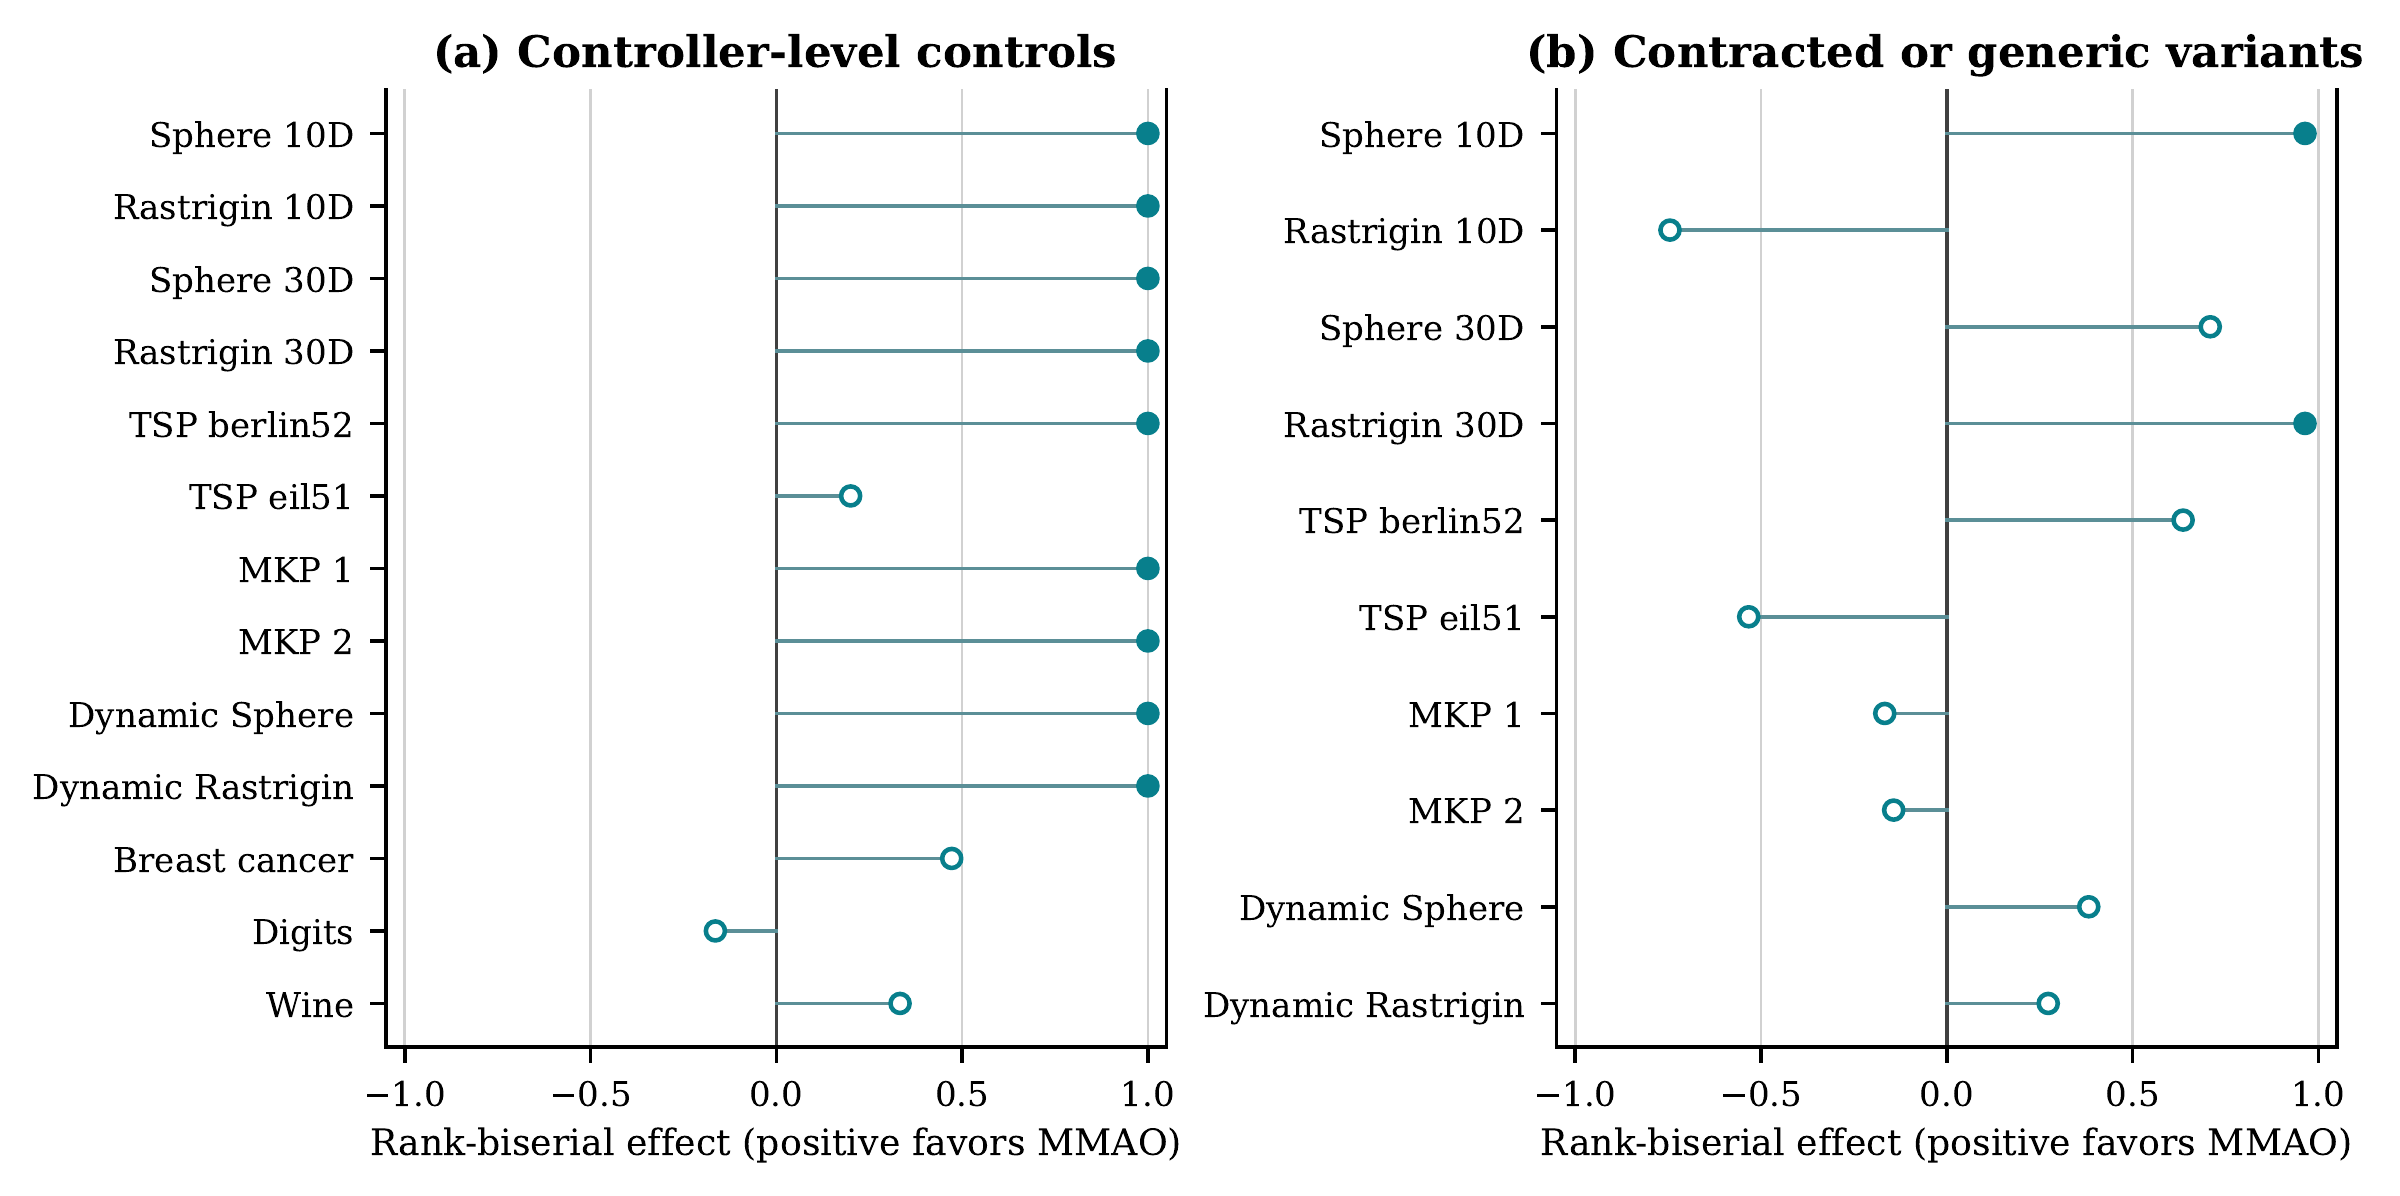
MMAO与控制方法和简化版本的效应比较
图1 期刊论文的配对效应量图。横轴正向有利于MMAO,实心点表示经Holm校正后p值小于0.05。
图1提供了更紧凑的读法。先看点落在零线哪一侧,确定方向,再看实心与空心,检查统计结果。左侧Berlin52为正向实心点,eil51为靠近零的正向空心点,二者支持的判断强度不同。
图中连接零线与圆点的细线用于展示效应方向和大小。原始结果的置信区间要回到论文表格中读取。右侧一些简化版本的比较接近零或落在负向,也说明完整配置的收益具有任务依赖性。
均值之外,还应该看见哪些运行
设想一组教学数据,方法甲五次误差为1、1、1、1、100,方法乙五次都是2。甲在四次运行中更好,中位数也更低,但均值为20.8,明显受到一次大误差影响。乙的均值为2,表现更集中。
这组例子说明,多种统计量可以呈现不同侧面。均值能够反映大误差带来的总体影响,中位数描述中间位置,分位数则能帮助观察尾部。对风险敏感的业务,少量严重失败可能非常重要,应单独展开这些运行。
MMAO的多任务结果同样需要逐任务和逐种子检查。如果把不同函数的原始残差直接放在一起,数值尺度较大的任务可能主导均值。研究可以同时报告任务排名、标准化结果或分组统计,但每一种汇总都应明确含义。
准备阅读一张聚合表时,可以先找到完整任务列表,再查看哪些任务贡献了主要差距。若同一方法在平滑函数与多峰函数上表现不同,分组结果会比一个总体数值更容易解释其适用条件。
表中的置信区间怎样理解
表格采用十种子均值和95%置信区间半宽。区间描述按相应统计方法估计均值时的不确定性,宽度与样本波动、运行次数及所用方法有关。它与某一次未来运行会落在哪个范围,是不同的统计问题。
因此,引用均值时最好连同区间一起保留。若两种方法均值差距很小、运行又很少,就要继续看配对差异与检验结果。若区间很宽,则可以检查是否存在少数异常运行,以及这些运行对应哪些任务状态。
配对比较利用相同任务和种子下的差异。相同种子用于按声明协议建立对齐记录,各算法仍按自身规则产生相应随机动作。统计解释应对应实际使用的配对单位,例如任务与种子的组合。
p值和效应量分别回答什么
显著性检验考察观察结果与所设统计假设的关系,结论依赖样本、检验方法和比较数量。p值本身无法描述算法节省了多少路程或评价,因此需要同时查看实际差距和效应量。
期刊图中的秩二列效应量描述配对差异的方向与秩结构,数值带有方向约定。它便于跨任务阅读比较方向,但业务收益仍应回到目标值、差距或时间指标。一个统计方向清楚的差异,实际大小仍可能很小。
当实验同时比较多项任务时,研究还需要处理多重比较。期刊采用Holm校正,并声明按领域家族处理。读表时,应确认报告的是原始p值还是校正后p值,以及显著性标记对应哪个比较集合。
未达到显著门槛时,可以继续观察差异估计和样本规模。十个种子对较小差异可能提供有限信息,接近的结果也可能需要更多运行才能进一步区分。结论可以明确描述当前数据支持的范围,同时保留后续检查方向。
一轮迭代到底消耗了什么
假设方法甲每轮让8个个体各评价3个新位置,方法乙每轮评价8个位置。在种群固定且忽略其他开销的教学例子中,40轮分别对应960次与320次评价。相同轮数已经产生三倍的调用差距。
MMAO还可能新增个体、进行局部细化、重评记忆,具体成本需要逐项统计。分类任务的一次评价包含模型训练与验证,路线任务则可能包含多次局部交换检查。真实任务中的单次成本也会变化。
准备复现时,可以在目标函数入口增加调用计数,同时记录总耗时。把初始化、试探、新个体和最终检查的调用都算进去,再说明停止条件。这样更容易解释相同轮数下的成本差异。
预算记录可以怎样具体落实
可以在最外层目标函数入口统一计数,再把候选生成、初始化和新增个体产生的调用汇总到同一记录中。若某个领域使用增量评价,还应说明一次增量检查与一次完整评价分别做了什么,避免计数名称相同而成本不同。
对于分类任务,一次候选评价可能包含多折训练。外层记录一次适应度调用,内部却拟合了多个模型。因此还可以另外记录拟合次数、训练样本量与总时间,帮助解释不同验证协议的成本。
对于路线任务,读取距离矩阵后的一次完整路线评分与一次2-opt边交换检查,所需计算不同。若某个方法使用较深局部搜索,最终质量可能受益于更多局部检查。实验说明应让读者知道这些机会是怎样分配的。
墙钟时间还受机器、并行度和库实现影响。报告耗时时,可以保存硬件、线程数与运行环境。调用预算适合观察搜索利用率,时间指标则反映实际完成任务的成本,二者可以互相补充。
若算法允许提前终止,还需要记录终止原因。有的运行达到容差,有的耗尽预算,有的因为外部评价失败停止。把这些情况区分清楚,最终汇总才更容易解释,也便于判断失败来自搜索还是接口。
消融表里的大变化,怎样继续追问
早期扩展评估中,去除精英再投入后,连续任务的聚合平均残差由5125.78上升到24107.74,约为原来的4.70倍。对应聚合检验的p值为0.0884,未达到常用的0.05门槛。
要理解这个结果,可以继续查看中位数、不同函数上的差异和各次运行。少量尺度很大的困难任务会明显影响总体均值,某个模块也可能集中帮助特定场景。将这些信息展开,比只保留均值变化更接近真实表现。
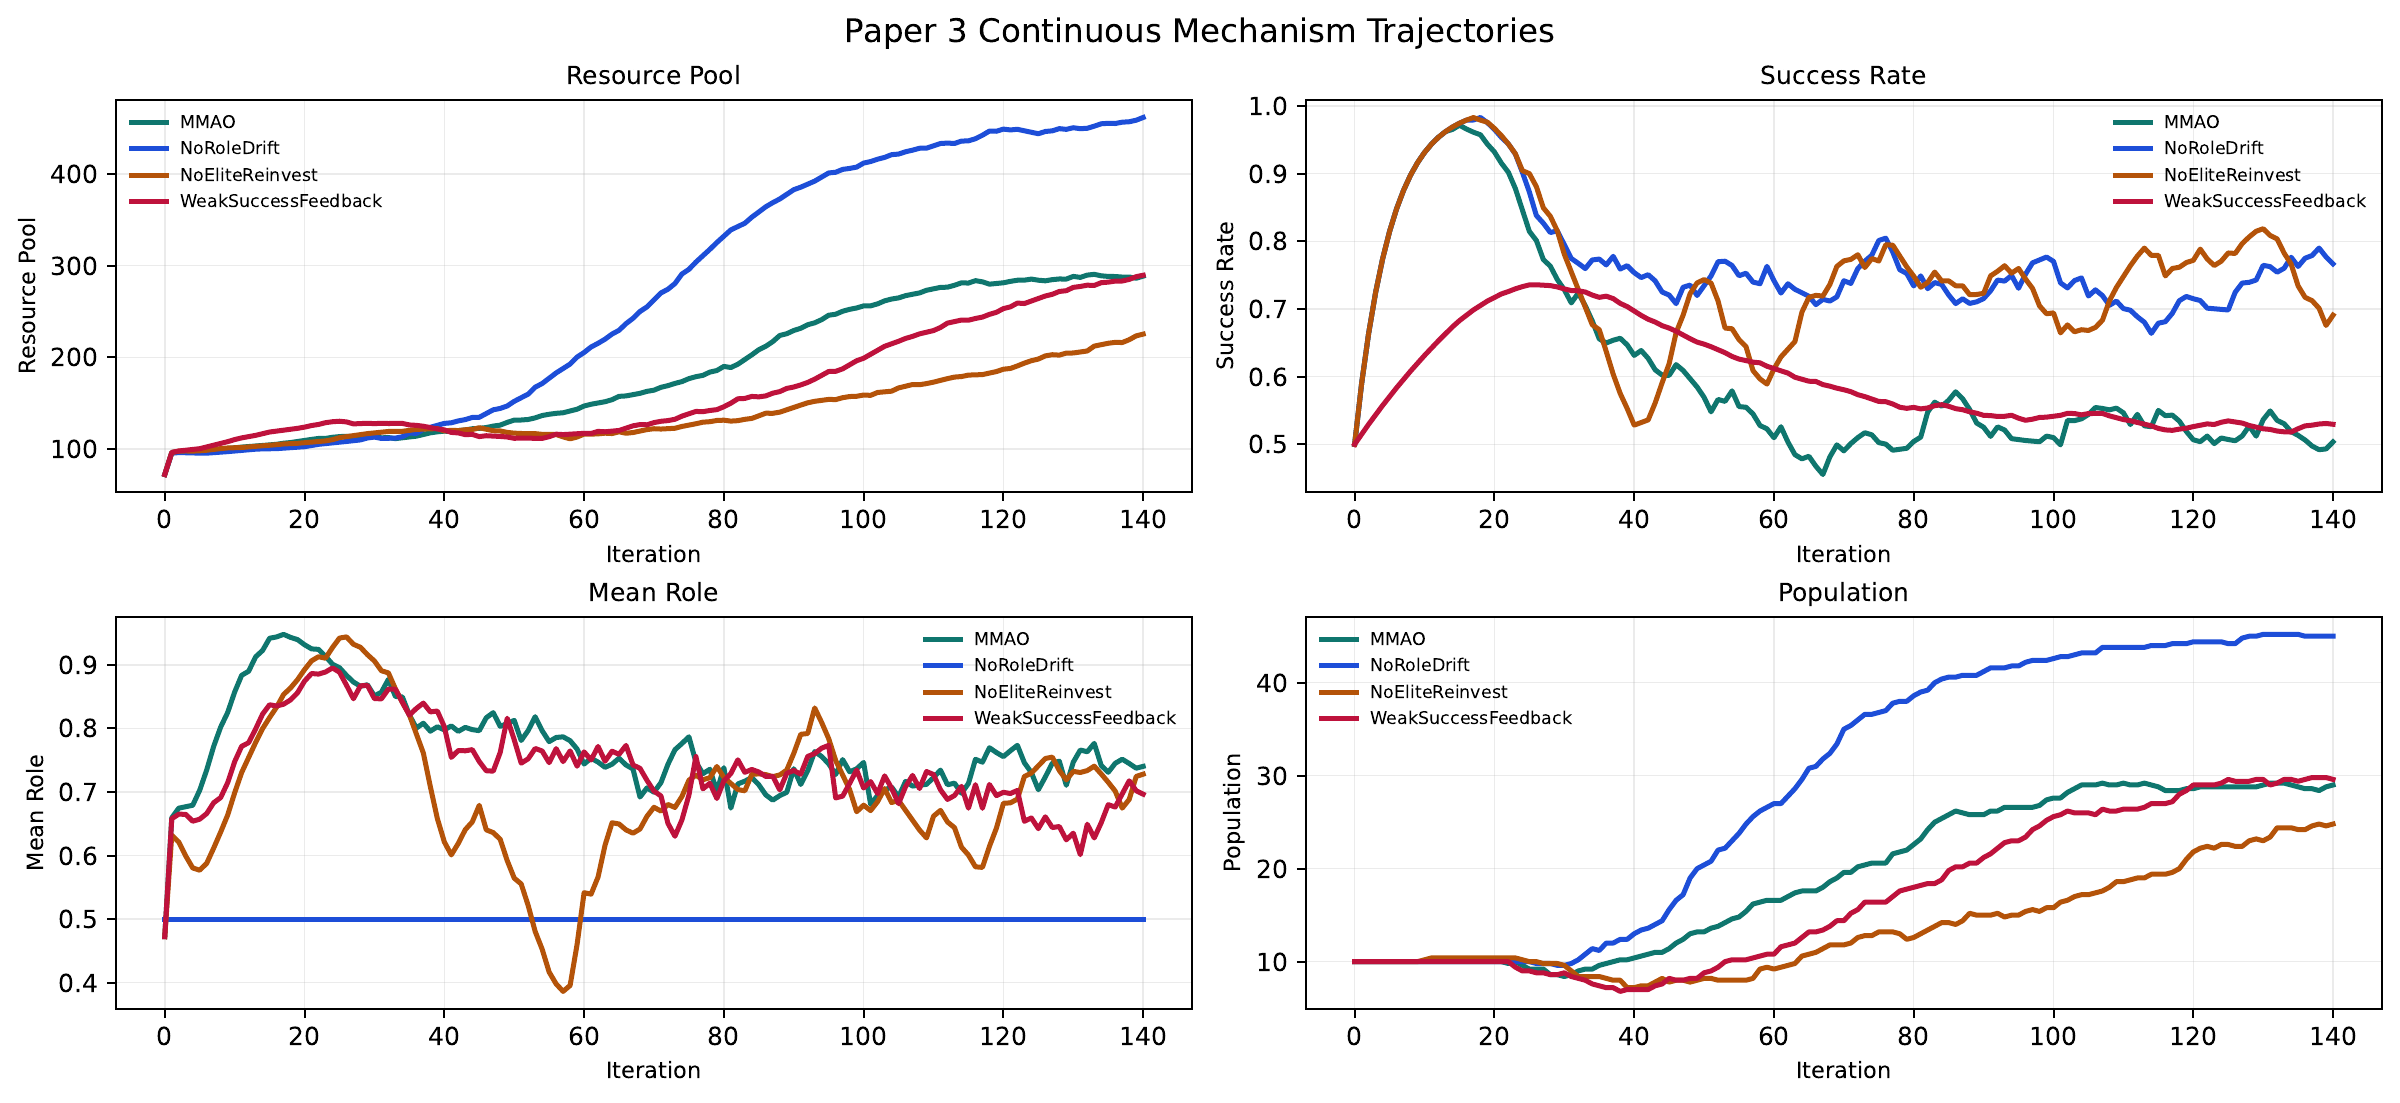
早期扩展评估中的机制轨迹
图2 扩展评估论文中的连续任务机制轨迹,记录公共资源池、成功率、角色与种群。
在图2中,可以沿着同一颜色对照各个面板,查看某个消融版本的角色状态是否按设计变化,公共资源是否积累,以及种群如何响应。轨迹帮助检查模块变化有没有进入预期的控制路径,最终质量仍要对应独立结果表。
一项机制变化,可以支持多强的解释
如果去掉一个模块同时改变候选生成、评价次数和种群规模,最终分数差异就包含多条影响路径。研究可以把它解释为一组配置变化的效果,再设计更细比较,逐步检查每条路径。
例如,关闭精英再投入后,既可能减少围绕较好解的尝试,也可能降低新增个体数量,进而改变资源消费与未来收益。若要判断新增机会本身的作用,可以考虑在明确预算条件下对齐候选数量,并保留其他领域动作。
机制轨迹则提供操作是否实际发生的证据。关闭角色漂移之后,角色曲线是否固定。关闭再投入之后,公共池是否按预期变化。种群约束是否仍被执行。这些检查能够确认实验配置与实现行为对应。
随后才是性能解释。一个模块确实改变了状态,也需要看这种改变是否带来目标改善。可能有更大的公共池却缺少有效消费,也可能有更大种群但新增评价收益很低。状态与结果一起保存,能让这类现象被继续分析。
怎样检验突破局部最优的能力
多峰任务上较低的最终值,可以支持整体求解表现的比较。若要进一步解释跨越局部最优的能力,还可以检查搜索是否离开指定盆地、花了多少评价,以及改善来自原个体的大尺度动作还是新增个体。
以期刊论文的Rastrigin-30D为例,MMAO平均目标约为78.83,CMA-ES约为121.01,两者经Holm校正后的p值为0.129。完整MMAO相对精简版本的均值约127.03则有显著改善,相应校正p值为0.023。前一项比较给出有利的均值方向,后一项支持整组实现细节在该设置中的收益。
若要定位收益是否来自逃离停滞,可以使用最优区域已知的多峰任务,从同一局部盆地附近开始,固定总评价预算,记录跨盆地成功率、首次到达更好区域的调用数和后续精度。定义区域与成功条件时,应在运行前写清楚,并把未成功运行纳入汇总。
随后再对照角色变化、种群更替和再投入位置。角色更偏探索之后,候选是否真的跨区;新增个体是否带来了更好区域;公共池支出是否降低了逃离所需成本。最终目标与这些过程指标一起报告,才能更细地解释机制优势。
给准备复现的读者留一张记录卡
选中一个任务后,先写下实例或数据集、源码版本、种子列表、停止条件和比较方法。运行后保存每次结果、评价次数、耗时及轨迹,再计算汇总指标。
若排名与论文不同,可以依次核对版本、领域算子、预算口径和种子。若只有少数运行差距很大,优先检查这些运行对应的轨迹。若方法均值接近,则需要结合波动与应用容差判断差别是否值得投入更多研究。
读完三行结果之后,MMAO的表现会变得具体。它在部分任务与轻量控制方法相比取得收益,在另一些任务上仍有强方法领先,而资源机制的贡献也需要逐项检查。这样的阅读结果能够直接转化成下一次实验的配置与记录要求。
读到结果之后,怎样形成一条完整判断
假设准备介绍MMAO在路线任务中的表现,可以先写明实例、方法配置、比较对象和指标,再给出均值与不确定性。随后说明检验口径,最后结合评价成本和专门方法结果,界定这项比较支持的实际判断。
若准备复现,就从其中一行开始。先获得相同实例,核对距离定义与最优值,再运行一个种子检查合法性。然后逐步恢复完整种子列表,汇总每次输出,最后复核统计程序。这样更容易发现差异发生在哪一步。
复现排名变化时,可以先看绝对结果是否接近。如果所有方法都明显变差,可能需要检查实例或评价定义。如果只某一种方法改变,则继续核对版本、参数与领域动作。如果波动集中在少数运行,则查看对应轨迹与终止原因。
阅读实验也可以留下一个小的审阅记录。当前结果最明确支持哪项判断,哪些结论依赖有限预算或轻量参照,以及下一步需要增加哪类比较。把问题写到具体任务上,后续研究就有可执行的入口。
用一项预算练习检查比较是否完整
这个练习可以先在便宜的小函数上完成,确认计数、停止和返回值一致,再迁移到真正昂贵的评价任务。
假设手中有一千次昂贵评价机会,要比较两种搜索方法。可以先把初始化评价纳入总数,再为所有后续试探统一计数。若某个方法在预算将尽时还计划生成一批候选,需要明确是逐个评价到上限,还是提前结束,并返回已完成评价的方案。
随后画出最好目标随累计调用数的变化,而横轴为迭代数的曲线则单独保存。前者展示每次评价机会的利用,后者展示外层控制的推进。若两种曲线给出不同印象,就能进一步检查每轮内部安排的差异。
假设一种方法前两百次调用改善很快,之后长期停滞,另一种前期较慢,但后期持续改善。固定一千次预算的终值与需要两百次内给出方案的使用要求,可能导向不同选择。实验需要呈现足够的过程信息,让读者依据自己的时限判断。
对于失败运行,也可以先保留原始原因再汇总。某次外部仿真返回异常,与算法在合法区域没有找到好解,在改进方向上各有对应。报告失败比例和处理方式,能够让最终均值的来源更清楚,也避免只统计顺利完成的运行造成偏差。
完成这个练习后,可以回到论文查看相同信息是否充分。若某项成本没有展开,就将它记为复现时需要测量的字段。这样的记录可以逐步补齐证据,而无需用一个总体评价覆盖所有任务。
对MMAO而言,已经公开的统一控制描述、任务协议和状态记录,使读者能够沿着这些细节继续检查。理解优势在哪里、付出了多少成本、还有哪些机制需要验证,会比孤立的一次排名更接近实际采用和研究时需要的信息。
资料来源
- IEEE Access期刊论文,三项均值摘录自主结果表。DOI:10.1109/ACCESS.2026.3752083
- 《A Large-Scale Empirical Evaluation of MMAO Under Fair-Budget Continuous and Discrete Benchmarks》,消融数值及图2来源。arXiv:2606.31584
- 公开软件和代码。mmao-opt(PyPI) · wolfbrother/mmao(GitHub)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号