环境变化后怎样重新找到好解?读懂MMAO-Dyn的恢复过程
原创
环境变化后怎样重新找到好解?读懂MMAO-Dyn的恢复过程
原创
用户4859102
发布于 2026-11-17 12:31:48
发布于 2026-11-17 12:31:48
一个优化程序刚找到满意的参数,目标却变了。继续细调旧参数,可能越来越偏离需求。完全放弃已有搜索,又会损失已经付出的计算。
MMAO-Dyn研究这个变化过程。它把旧解重评、角色调整、记忆处理和恢复投入放进MMAO的资源循环,尝试让搜索在环境变化后重新找到有效方向。
变化发生的那一刻,旧的“最好”还可靠吗
用一个单参数教学例子理解。变化前,参数越接近1.5越好,以偏差平方作为目标值。程序已经找到1.5,目标值为0。随后目标位置移到3.5,同一个参数1.5的新目标值立刻变成4。
如果程序仍然保留旧评分0,就会以为已经找到最优位置。后续真实得到的较好候选也可能被这个过时评分挡住。因此,动态搜索首先要检查历史记录是否仍与当前环境一致。
在公开动态实现中,环境变化后会重新评价当前位置和记忆位置,再更新当前环境下的较好解。读者可以把“方案本身”和“方案在某个环境中的评分”分开保存,检查评分对应的环境编号。
这个例子中的目标移动由外部明确给定。MMAO-Dyn论文的合成测试同样按设定节奏制造变化,便于重复观察恢复过程。若接入业务,还要定义变化怎样被观测,例如需求更新事件或服务性能变化。
旧位置与旧评分,应该怎样一起处理
一个位置曾经取得好结果,环境变化后仍可能有利用价值。因此可以保留方案结构,再用新环境重新计算评分。这样,历史信息经过当前条件检验后,才能继续参与后续动作和方案选择。
在单参数例子中,旧位置1.5可以继续保存,但应记录它在新目标下的误差4。若另一个记忆位置为3.0,其新误差为0.25,就应按新评分比较。直接沿用变化前的最好值,会妨碍程序识别新环境中的有效改进。
还要检查全局记录。若程序始终保存从运行开始以来最低的数字0,新环境中得到的0.25也无法改善这个历史值。动态日志因此需要包含环境编号,并在环境切换后重新建立当期比较基准。跨环境的统计则按照所选动态指标汇总。
当变量或约束也改变时,重评前还要检查可行性。新增订单会改变路线所需客户集合,设备失效会改变可用资源,某些旧方案可能需要修复才能评价。环境更新、方案修复、重新评分和恢复搜索,应该按明确顺序衔接。
变化信号来自哪里
论文中的受控测试按设定节奏改变函数位置,可以准确知道每次变化何时发生。这种安排便于对齐恢复窗口,比较不同方法在同一类变化下的行为。业务系统则需要定义事件或监测机制,才能把变化送入优化流程。
订单到达、任务取消和设备状态更新通常有明确事件。负载变动或数据分布变化则可能连续发生,需要根据观测建立触发条件。触发过于频繁会让搜索长期处于恢复状态,触发过慢则可能持续利用过时信息。
可以先记录业务事件的时间与实际影响,再判断是否每一次事件都值得启动完整恢复。少量变化可能适合局部重评,大范围变化则需要重新检查更多候选。选择应依据任务结构与响应成本,并通过日志观察效果。
接下来的几轮,搜索需要重新分工
完成重评之后,旧有局部信息的价值发生变化,搜索会面临几项相互联系的调整。
公共资源得到变化响应注入,有限长度的恢复窗口打开,为重新探索和再投入提供支持。角色状态向探索方向调整,使部分动作能够离开原有区域。记忆刷新与新个体补充则提供额外候选,同时保留可继续利用的信息。
仍以1.5移到3.5的例子看,围绕1.5做极小扰动可能恢复较慢。更宽的试探有机会接近新的目标区域,但过度扩大扰动也可能损失精细定位。恢复窗口的作用之一,就是让这段额外探索具有时间范围。
这一过程中,旧记忆重评与额外记忆刷新各有用途。前者让评分跟上环境,后者尝试通过刷新采样获得新的有效信息。实验中的NoMemoryRefresh比较针对相应刷新机制,阅读时应结合实现说明。
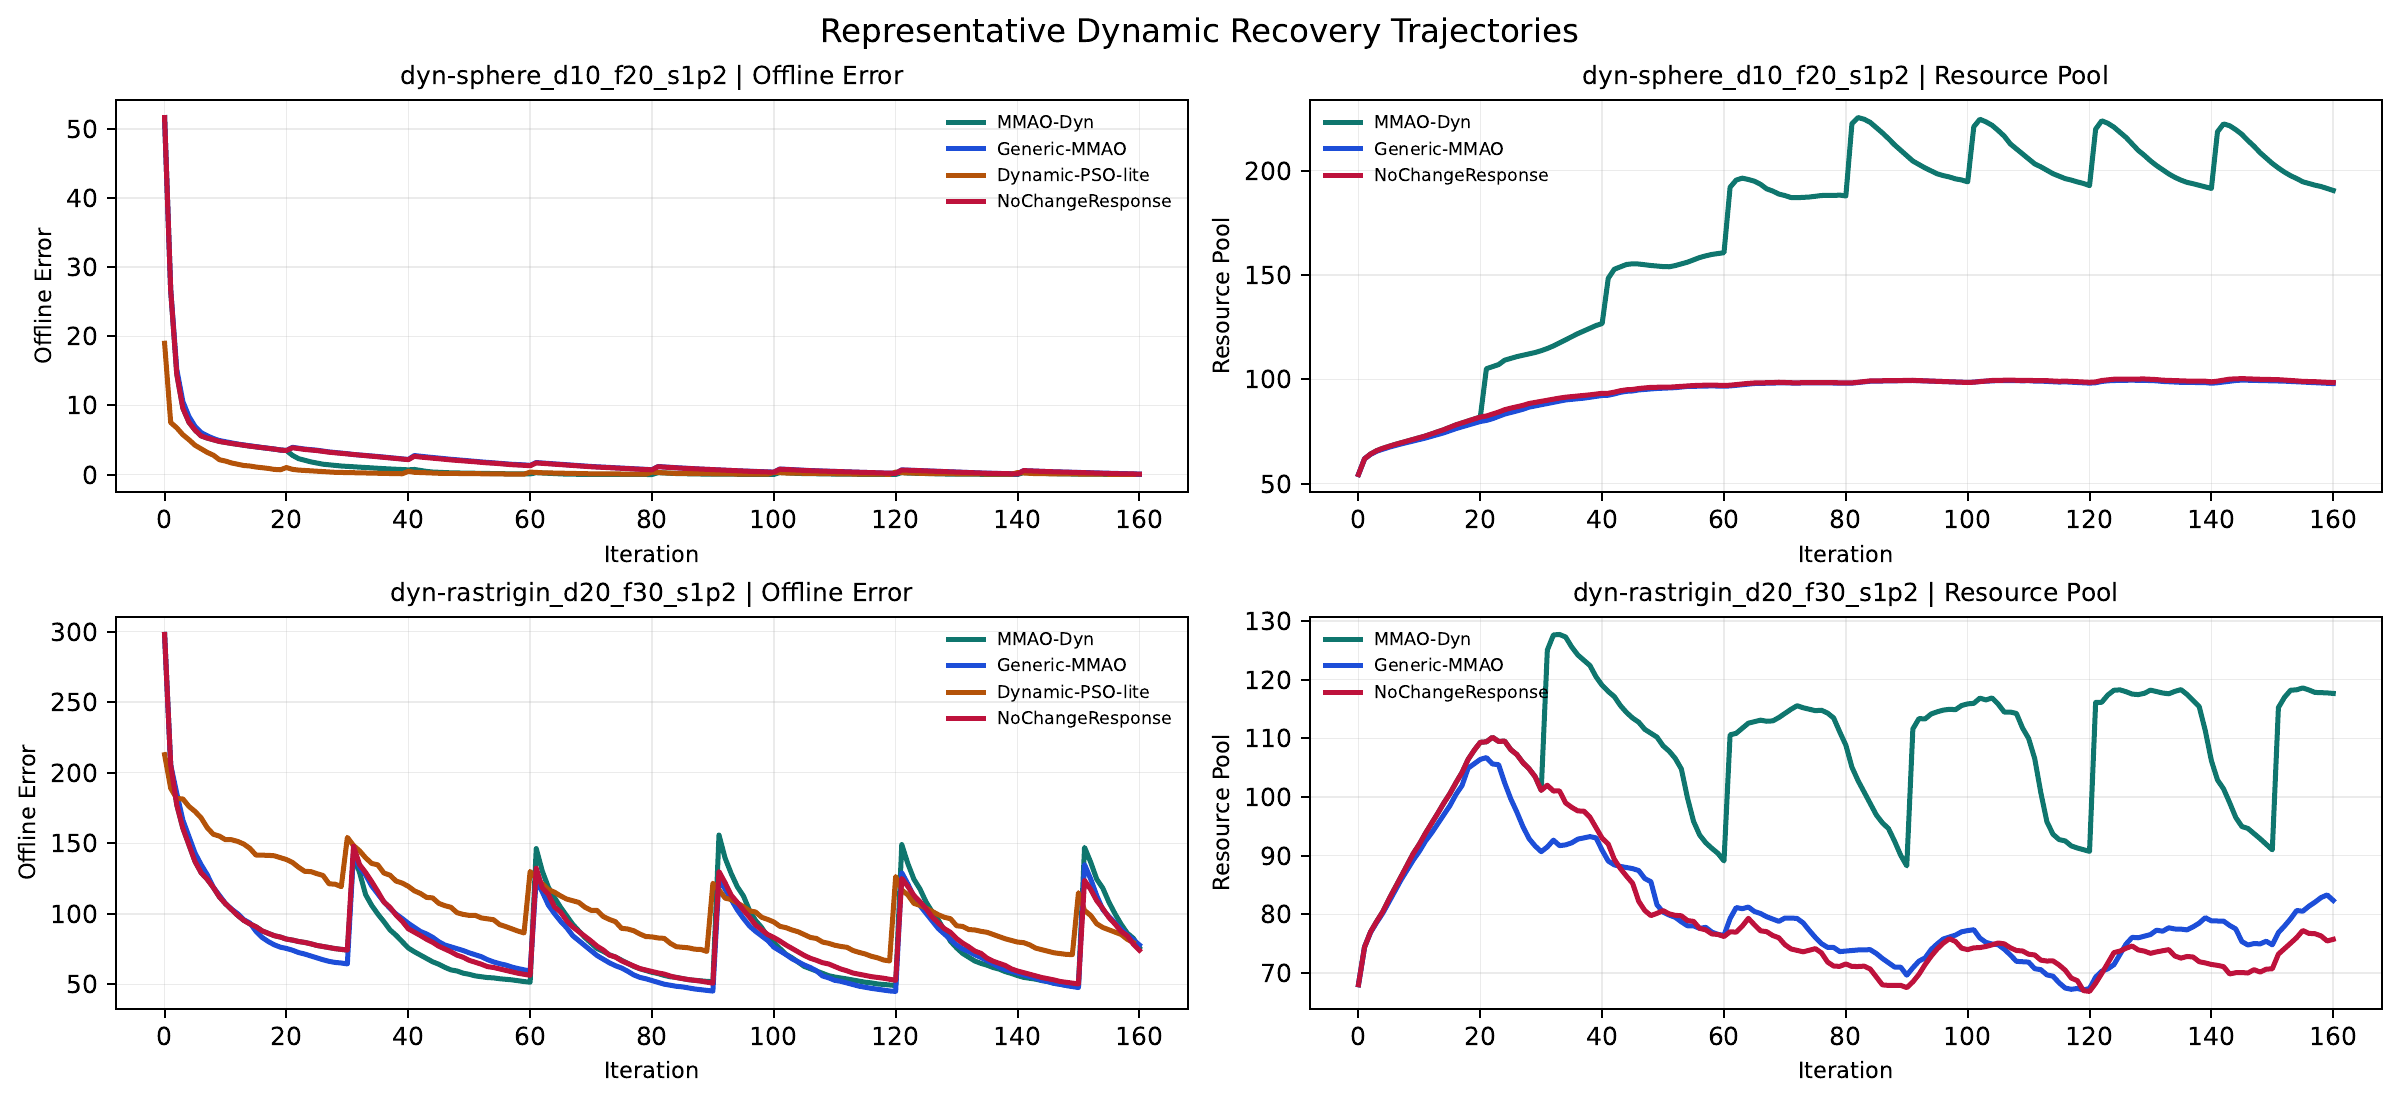
变化后的误差与资源池轨迹
图1 MMAO-Dyn论文的代表性恢复轨迹,上排为平移Sphere,下排为平移Rastrigin,左列为误差,右列为公共资源池。
先看上排。环境按约20轮的节奏发生变化,完整方法的资源池在变化附近明显抬升,随后逐步支出。左侧误差重新下降,显示算法正在恢复。Dynamic-PSO-lite在这个较平滑场景中也有很好的表现。
再看下排。Rastrigin含有更多局部结构,误差在变化处反复跳升,随后回落。完整方法有时起跳更高,后续却下降更快。右侧资源池也呈现与恢复阶段相关的起伏。比较这组曲线,需要同时观察跳升幅度和之后一段时间的误差。
资源注入为什么需要与真实预算一起记录
动态实现中的资源注入会提高内部可用于恢复的储备,但实际计算仍受评价次数和时间约束。新增个体、刷新记忆或加大探索都会带来调用。若一个系统只有固定的外部预算,就需要把这些恢复动作的成本计入总量。
例如,变化后重评十个当前位置和十个记忆位置,就可能先花掉二十次评价,随后才开始产生新候选。若评价每次耗时很长,这段准备过程就会影响业务响应。实现时可以单独记录重评、恢复搜索和普通搜索各自的开销。
公共池较大也需要可执行的支出规则。若种群已到上限,或者父个体条件不满足,恢复资源可能无法立即转化为新增候选。另一方面,允许过多新增也可能把有限预算分散到大量初始探索上。状态与成本应一起观察。
这些记录能够让资源注入具有可检验的含义。某次变化后,程序增加了多少内部储备,实际多进行了哪些尝试,这些尝试是否加快恢复,都可以逐项核对。
恢复窗口结束时,还应该发生什么
恢复窗口提供了暂时扩大探索或加强再投入的阶段。窗口越长,额外探索持续越久,但后期精细定位的安排也可能受到影响。窗口太短,则可能在尚未重新覆盖有效区域时就回到普通搜索。
可以比较变化后若干轮的误差,而同时查看窗口结束前后动作尺度与角色。若误差已明显下降,探索仍长期保持很大幅度,就可以检查恢复持续时间。若变化后还没找到有效方向就迅速转向细化,则可以检查窗口是否足够。
窗口长度还应与变化频率联系。如果每隔较短时间就再次变化,长恢复窗口可能让算法一直处于响应期。若环境很久才变化一次,短暂恢复之后还有较长细化时间。合适设置取决于任务节奏,应该保留对应事件序列。
记忆处理也可以在窗口内观察。哪些历史位置重新取得较好评分,哪些刷新采样改善了目标,哪些新增个体后来贡献了收益,都能帮助判断恢复投入应该落在哪些对象上。
原地停滞与环境变化后恢复,怎样联系
在固定目标上,长期微调缺少收益,可能说明当前搜索需要扩大覆盖。环境变化后,旧有好区域的价值也可能下降,需要重新评价并寻找有效方向。MMAO-Dyn利用资源、角色和个体更新组织后一类恢复,延续了根据收益变化调整投入的机制。
两类情况的触发信息各有重点。静态停滞主要观察当前目标下的改进记录,动态恢复还要确认环境已切换、旧评分已更新。完成重评之后,探索偏置、恢复窗口与新增候选才有正确的评价基准。
若旧记忆一直把候选引回过时区域,可以检查刷新与重新评分;若探索范围扩大却迟迟没有恢复,则检查新候选落点与领域动作。变化后的目标也可能仍有多个局部盆地,因此恢复质量同时依赖重新定位与后续细化。
公共资源注入为这些动作提供内部储备,实际效果则体现在恢复误差、响应时间与评价成本中。将这几项与状态轨迹对应,可以判断算法是否利用额外投入找到了新的有效区域。
为什么最后都接近目标,体验仍可能不同
假设变化后的连续三个时刻,方法甲的误差依次为4、2、0,方法乙为4、0、0。两者最终误差都是0,但这三个时刻的平均误差分别为2和约1.33。乙更早恢复,运行期间付出的偏差更小。
这组手算例子帮助理解离线误差的用途。论文在整个动态运行期间累计当前环境下的最优误差,评价长期跟踪,同时另外分析变化后5轮和10轮的恢复窗口。
因此,接入真实任务时,可以同时记录全程误差、变化后的恢复时间和额外评价成本。业务允许的响应时限,往往会直接影响选择多长的恢复窗口。
评价全程误差之前,先把时间轴对齐
教学例子用三个时刻说明恢复速度,正式实验则需要说明记录频率。一轮记录一次与每次评价记录一次,会赋予不同阶段不同权重。若每轮调用数变化很大,就可以同时报告按轮次与按实际时间观察的恢复表现。
计算离线误差时,还要知道当前环境的参照最优值。合成函数通常可以给出这一信息,真实业务则可能只知道较好基准或服务目标。此时,可以选择相对基准的成本、约束违反量或达到服务要求的时间,并明确指标来源。
恢复时间也需要定义终点。可以规定误差降到阈值以内,或者恢复到某个可接受水平。如果环境变化使目标尺度改变,沿用变化前的绝对分数可能不合适,需要采用与业务含义一致的目标。
对于周期性变化,还可以把每次变化后的短窗口放在一起,观察不同周期是否具有相近恢复形态。若只有第一次恢复较慢,后续可能受益于已积累信息。若某一类变化特别困难,则可以继续检查它改变了哪些局部结构。
均值更低与胜负次数较少,怎样同时出现
设想一个教学比较,方法甲在三个场景的误差为2、2、20,方法乙为1、1、50。甲只在最后一个场景获胜,但平均误差为8,低于乙约17.33。一个困难场景中的大幅改善,足以影响总体均值。
MMAO-Dyn论文同样分别报告聚合均值和配对比较。对PSO-lite的胜负次数反映多少次对齐运行更好,聚合均值则反映全部误差值的平均。分函数家族与维度继续阅读,能够看见差别集中在哪些场景。
实际选择方法时,可以让这些场景权重贴近需求。若大多数业务变化平缓、少量剧变损失很大,两类表现都需要报告。若任务只涉及某一种变化类型,则更应该查看对应子集,避免用总体数值代替具体适用性。
去除记忆刷新的结果接近完整方法,也值得这样分析。可以先检查哪些场景中刷新带来收益,哪些场景中增加了成本或扰动,再研究更加有选择的刷新规则。聚合均值为后续定位问题提供入口。
把216次运行的结果与曲线放在一起
动态预印本覆盖Sphere、Ackley、Rastrigin三个函数家族,10维、20维、30维及两档变化强度,共18个场景,每个场景12个种子。以下为216次运行的聚合平均离线误差。
方法 | 平均离线误差 |
|---|---|
MMAO-Dyn | 28.07 |
Generic-MMAO | 29.36 |
Dynamic-PSO-lite | 34.65 |
Dynamic-DE-lite | 67.09 |
Dynamic-RandomSearch | 111.37 |
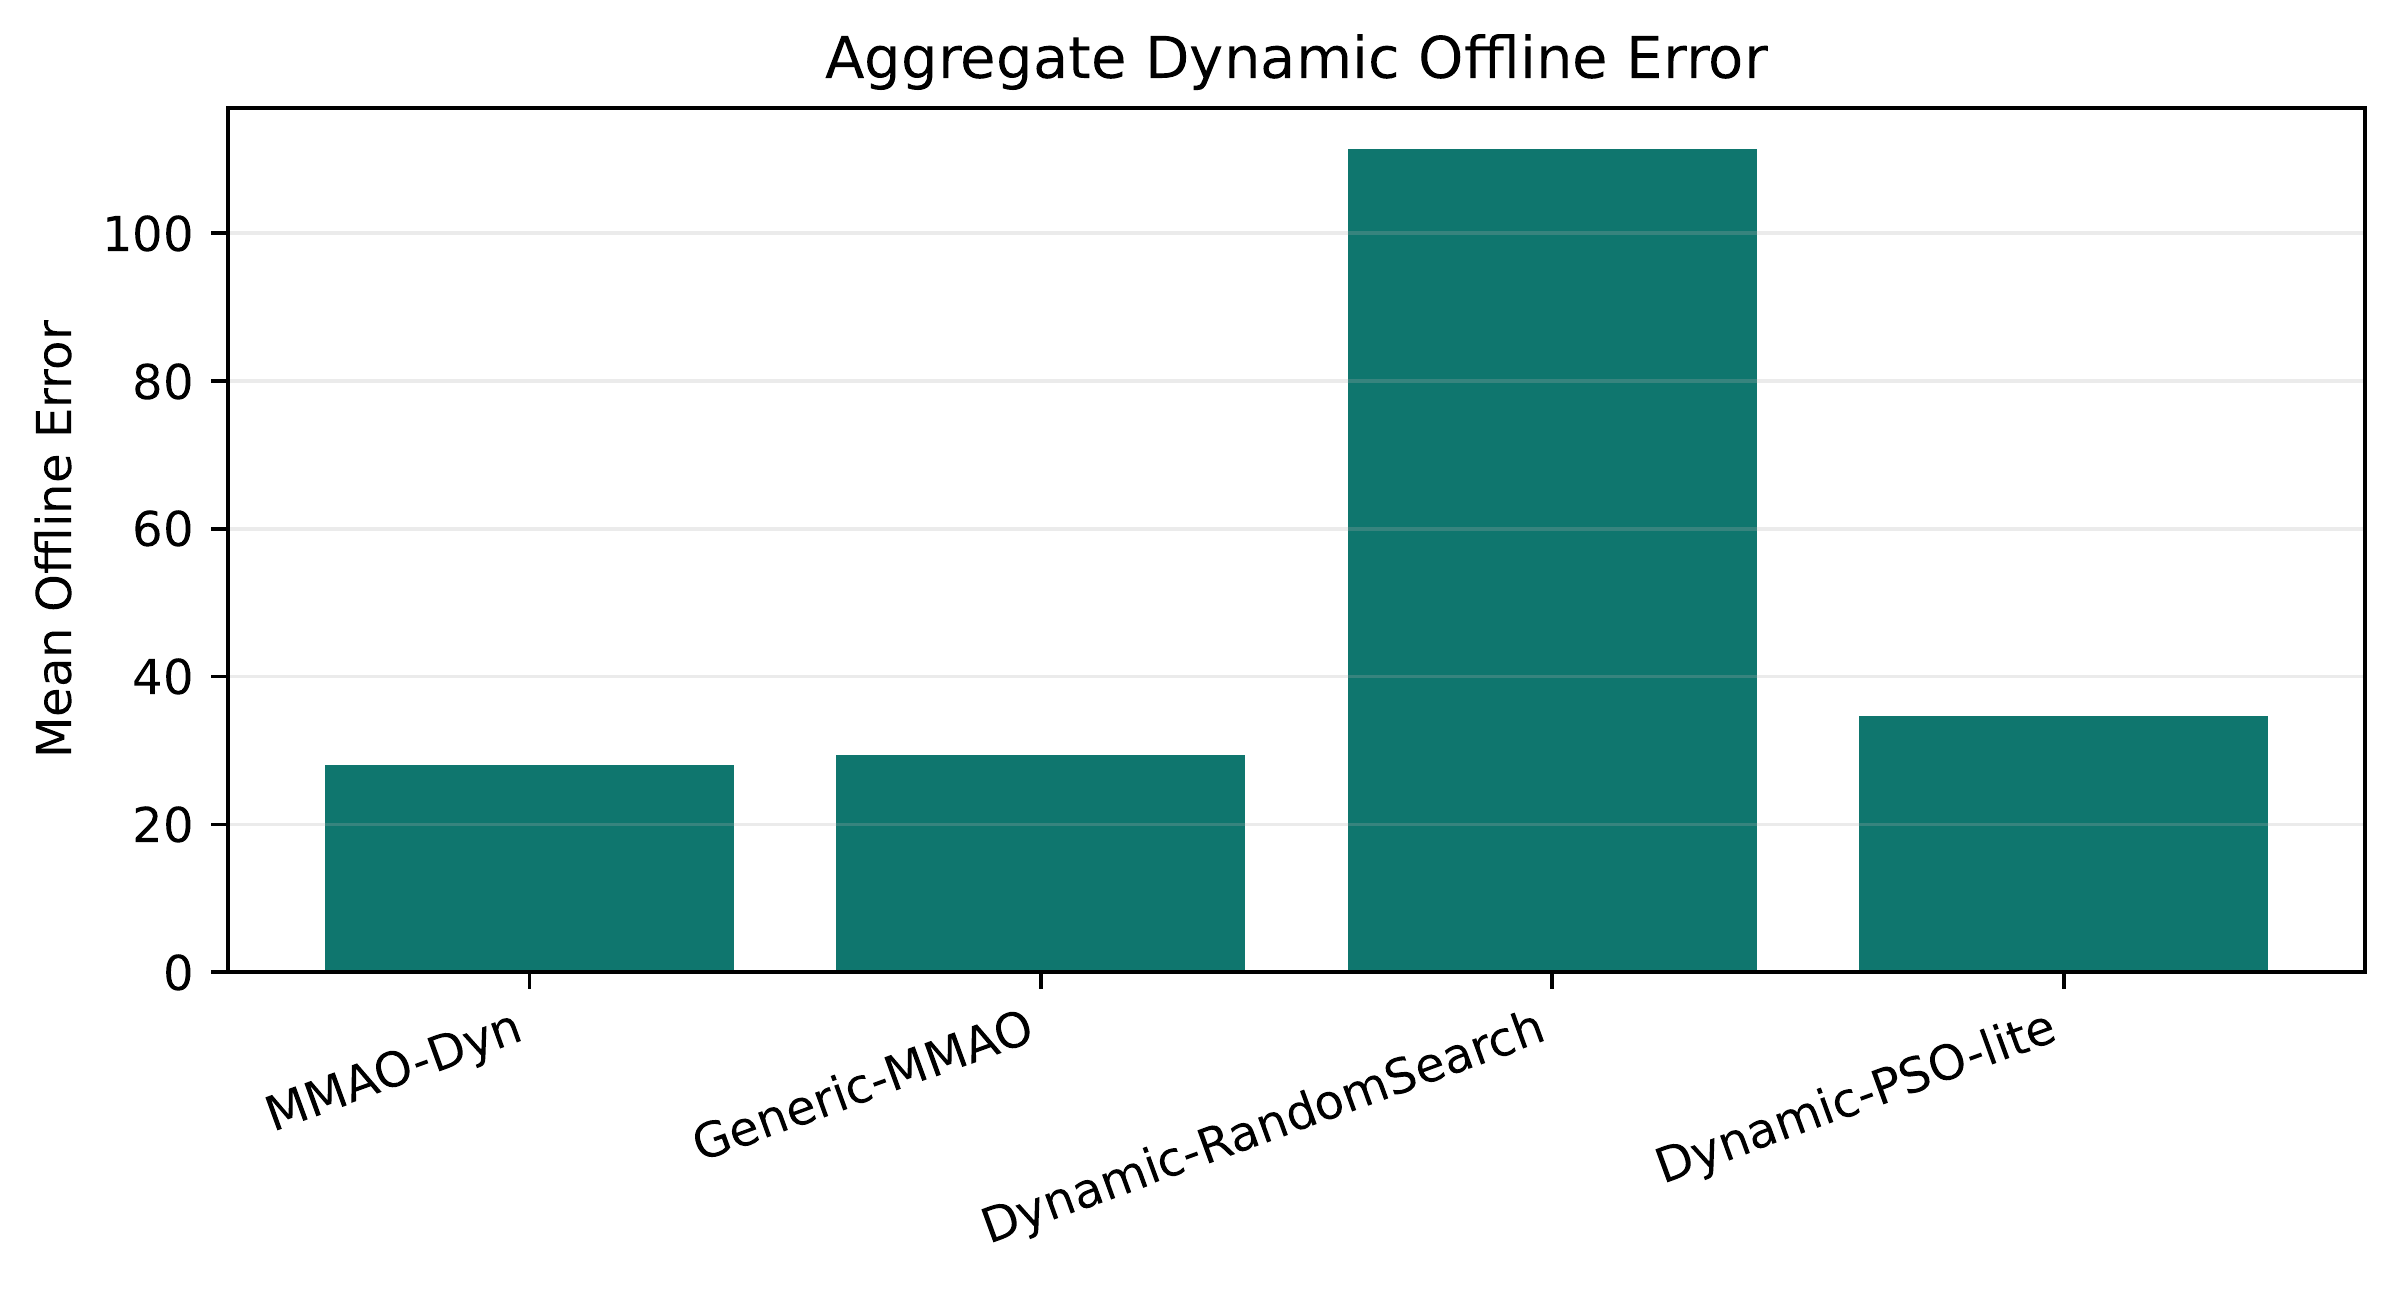
MMAO-Dyn的总体离线误差比较
图2 同一动态研究的聚合结果图,数值越低越好。
MMAO-Dyn的聚合均值较低,尤其在一些困难场景中保持了较好的误差水平。但与Dynamic-PSO-lite的种子配对比较为65胜、151负。胜负次数和平均误差分别反映不同信息,大幅减少困难场景误差,也可能拉低总体均值。
相对Generic-MMAO,完整方法的变化后10轮平均误差由30.02降到29.02,提供了观察恢复投入价值的依据。去除记忆刷新的版本全程聚合均值为28.03,略低于完整方法,说明当前刷新设计仍有继续改进的空间。
这些比较采用对齐的迭代安排与大致相近的每轮投入,实际评价次数仍与方法有关。期刊论文另有一组动态实验配置,其数值应按该配置单独读取。
怎样设计一组可以比较的动态场景
可以从最简单的固定周期平移开始。先规定初始目标位置、变化时点和每次平移量,把同一序列交给所有方法。随后再增加变化幅度或调整变化频率,观察恢复难度怎样变化。
维度和函数形态可以分开调整。增加维度扩展了需要搜索的方向,多峰结构则增加局部区域的干扰。若同时改变很多因素,就较难解释某次恢复变差来自哪里。分组比较可以让问题保持清楚。
对于随机变化,需要保存实际生成的事件序列。单独给不同方法各自生成环境,可能让它们面对不同难度。使用同一环境序列,再按各自种子运行搜索,有助于保持任务条件可追溯。
基线也要拥有明确的变化处理。简单重启、保留种群重评、带记忆恢复和动态专门方法,可以回答不同问题。比较时,应注明每种方法在变化后获得哪些信息、进行了多少次重评,以及怎样恢复。
如果迁移到服务调度,可以先使用离线回放日志,重放相同负载和故障事件。这样可以逐次检查每个恢复动作,再决定是否接入在线系统。资源、时延与方案可行性在这个阶段都可以得到具体测量。
想继续试验,可以先盯住恢复窗口
在同一动态问题上,保持变化序列、初始配置和种子不变,只调整recovery_window,记录每次变化前后10轮的误差与资源池。这能帮助观察额外探索持续得太短或太长时,搜索发生了什么。
若恢复很慢,先检查环境更新后是否完成重评,以及新候选能否离开旧区域。若误差反复大幅振荡,则检查恢复动作幅度和持续时间。若资源池增加却没有带来有效尝试,需要查看新增、再投入与种群上限条件。
从这个角度使用MMAO-Dyn,关注点会落到一段可以复查的过程。环境何时改变,旧信息如何重评,资源何时投入,搜索用多久恢复,这些记录能够帮助判断动态适配是否真正满足任务需求。
用一份变化日志检查恢复是否有效
每次变化可以保存一个独立记录,包括事件编号、触发时间、变化前候选、重评后的评分、额外注入、恢复窗口和最终恢复结果。将这些字段串起来,就能还原程序在该次变化中做了什么。
若误差没有明显跳升,也应检查原因。可能是变化幅度较小,旧方案依然可用,也可能是日志仍沿用旧环境评分。可以取同一个位置,在变化前后分别计算一次目标,确认环境确实进入了评价过程。
若误差跳升后迟迟不恢复,可以查看新增候选的分布。它们是否离开旧区域,边界是否限制了移动,记忆牵引是否持续把搜索拉回过时位置。若误差快速下降后再次波动,则可以检查恢复动作是否持续过强。
还可以追踪公共资源支出后的收益。一次新增或刷新没有立刻改善很常见,后续几轮是否带来有效信息同样值得观察。把动作与后续轨迹联系起来,可以更准确地判断资源该投向哪里。
最终报告时,将全程表现、恢复窗口表现与真实成本放在一起。一个方法可能具有较低总体误差,却在某次业务关键变化后恢复较慢。另一个方法可能恢复快,但需要更多调用。任务的质量要求与响应时限,会决定怎样评价这种取舍。
再把一个恢复窗口手动走完
实际复核时,可以先固定所有随机输入,逐轮打印候选、评分和参考位置,待流程符合预期后,再打开完整随机搜索。
仍用目标从1.5移动到3.5的教学例子。旧位置1.5重评后误差为4。假设接下来依次产生2.0、3.0和3.4三个候选,它们的误差分别为2.25、0.25和0.01。把这些位置与时间放在一起,就能直观看到搜索重新接近目标的过程。
如果将可接受误差定为0.04,那么3.4已经达到要求,3.0还需要继续改进。恢复时间可以记录到第一次达到这个阈值的时刻。不同方法最终都得到很小误差,也可以通过这个过程指标比较谁更早满足服务要求。
这段演算还可以用来检查记忆。若旧记忆仍带着评分0,程序可能持续选择1.5作为最好参考。若已按新环境重评,它就会根据新候选逐步更新参考位置。打印每次使用的记忆位置和对应环境编号,可以直接核对这条路径。
再加入评价成本,假设每次调用需要一秒,而变化后先进行十次重评。即使后续只用三次尝试就恢复,实际响应时间也包含前面的重评开销。业务指标通常需要从事件发生时计时,因此准备阶段也应进入记录。
对于多维问题,同样可以保存少量代表性候选,查看它们是否沿着新目标附近的有效方向变化。二维例子还可以画出位置轨迹,高维则可以查看到目标或参考位置的距离、分量变化和候选分散程度。
这些手动检查适合在正式大规模比较前完成。它们让环境、记忆、评价和资源更新各有可核对的输入输出,之后再分析复杂误差曲线时,就更容易定位异常来自哪个环节。
从单参数平移开始,可以逐步走到更复杂的动态任务。每增加一种变化,都检查旧解怎样重评、资源怎样投入、候选怎样恢复合法与有效,MMAO-Dyn的动态机制就能接受更加具体的应用检验。
资料来源
- 《MMAO-Dyn: A Metabolic Multi-Agent Optimizer for Dynamic Optimization》,本文图表及18场景结果来源。arXiv:2607.00846
- 后续期刊论文也包含动态任务,采用另一组明确声明的配置。DOI:10.1109/ACCESS.2026.3752083
- 动态优化软件入口。mmao-opt(PyPI) · wolfbrother/mmao(GitHub)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号