
如何监控gcloud k8s HTTP的故障率?
我正在使用基于HTTP的应用程序开发一个生产K8s集群,我希望设置监视和警告HTTP错误。很清楚如何检查服务的正常运行时间(使用监视(例如堆栈驱动程序)),但绝对不考虑HTTP的故障率。
我有一个nginx-ingress-controller作为端点(与外部负载均衡器)。
如何从这个负载均衡器收集和查看诸如延迟、HTTP故障等指标?
尤其是现在,当HTTP响应错误率超过某个百分比时,我需要这样做。
回答 1
Stack Overflow用户
发布于 2020-06-15 22:23:26
例如,如果您正在监视HTTP4xx和5XX错误,我认为最好的方法是在某些日志工具中聚合负载均衡器和nginx入口控制器日志。如果您正在研究开源解决方案,您可以使用类似弹性搜索和基巴纳这样的工具来在一个时间框架内可视化错误。要发送日志,可以使用像流利位或弗伦特这样的转发器。
如果您有付费工具的预算,您可以使用商业上可用的解决方案,如:
然后您可以使用这些工具中的任何一个来设置警报。对于Elasticsearch,您可以使用类似于弹性警报的
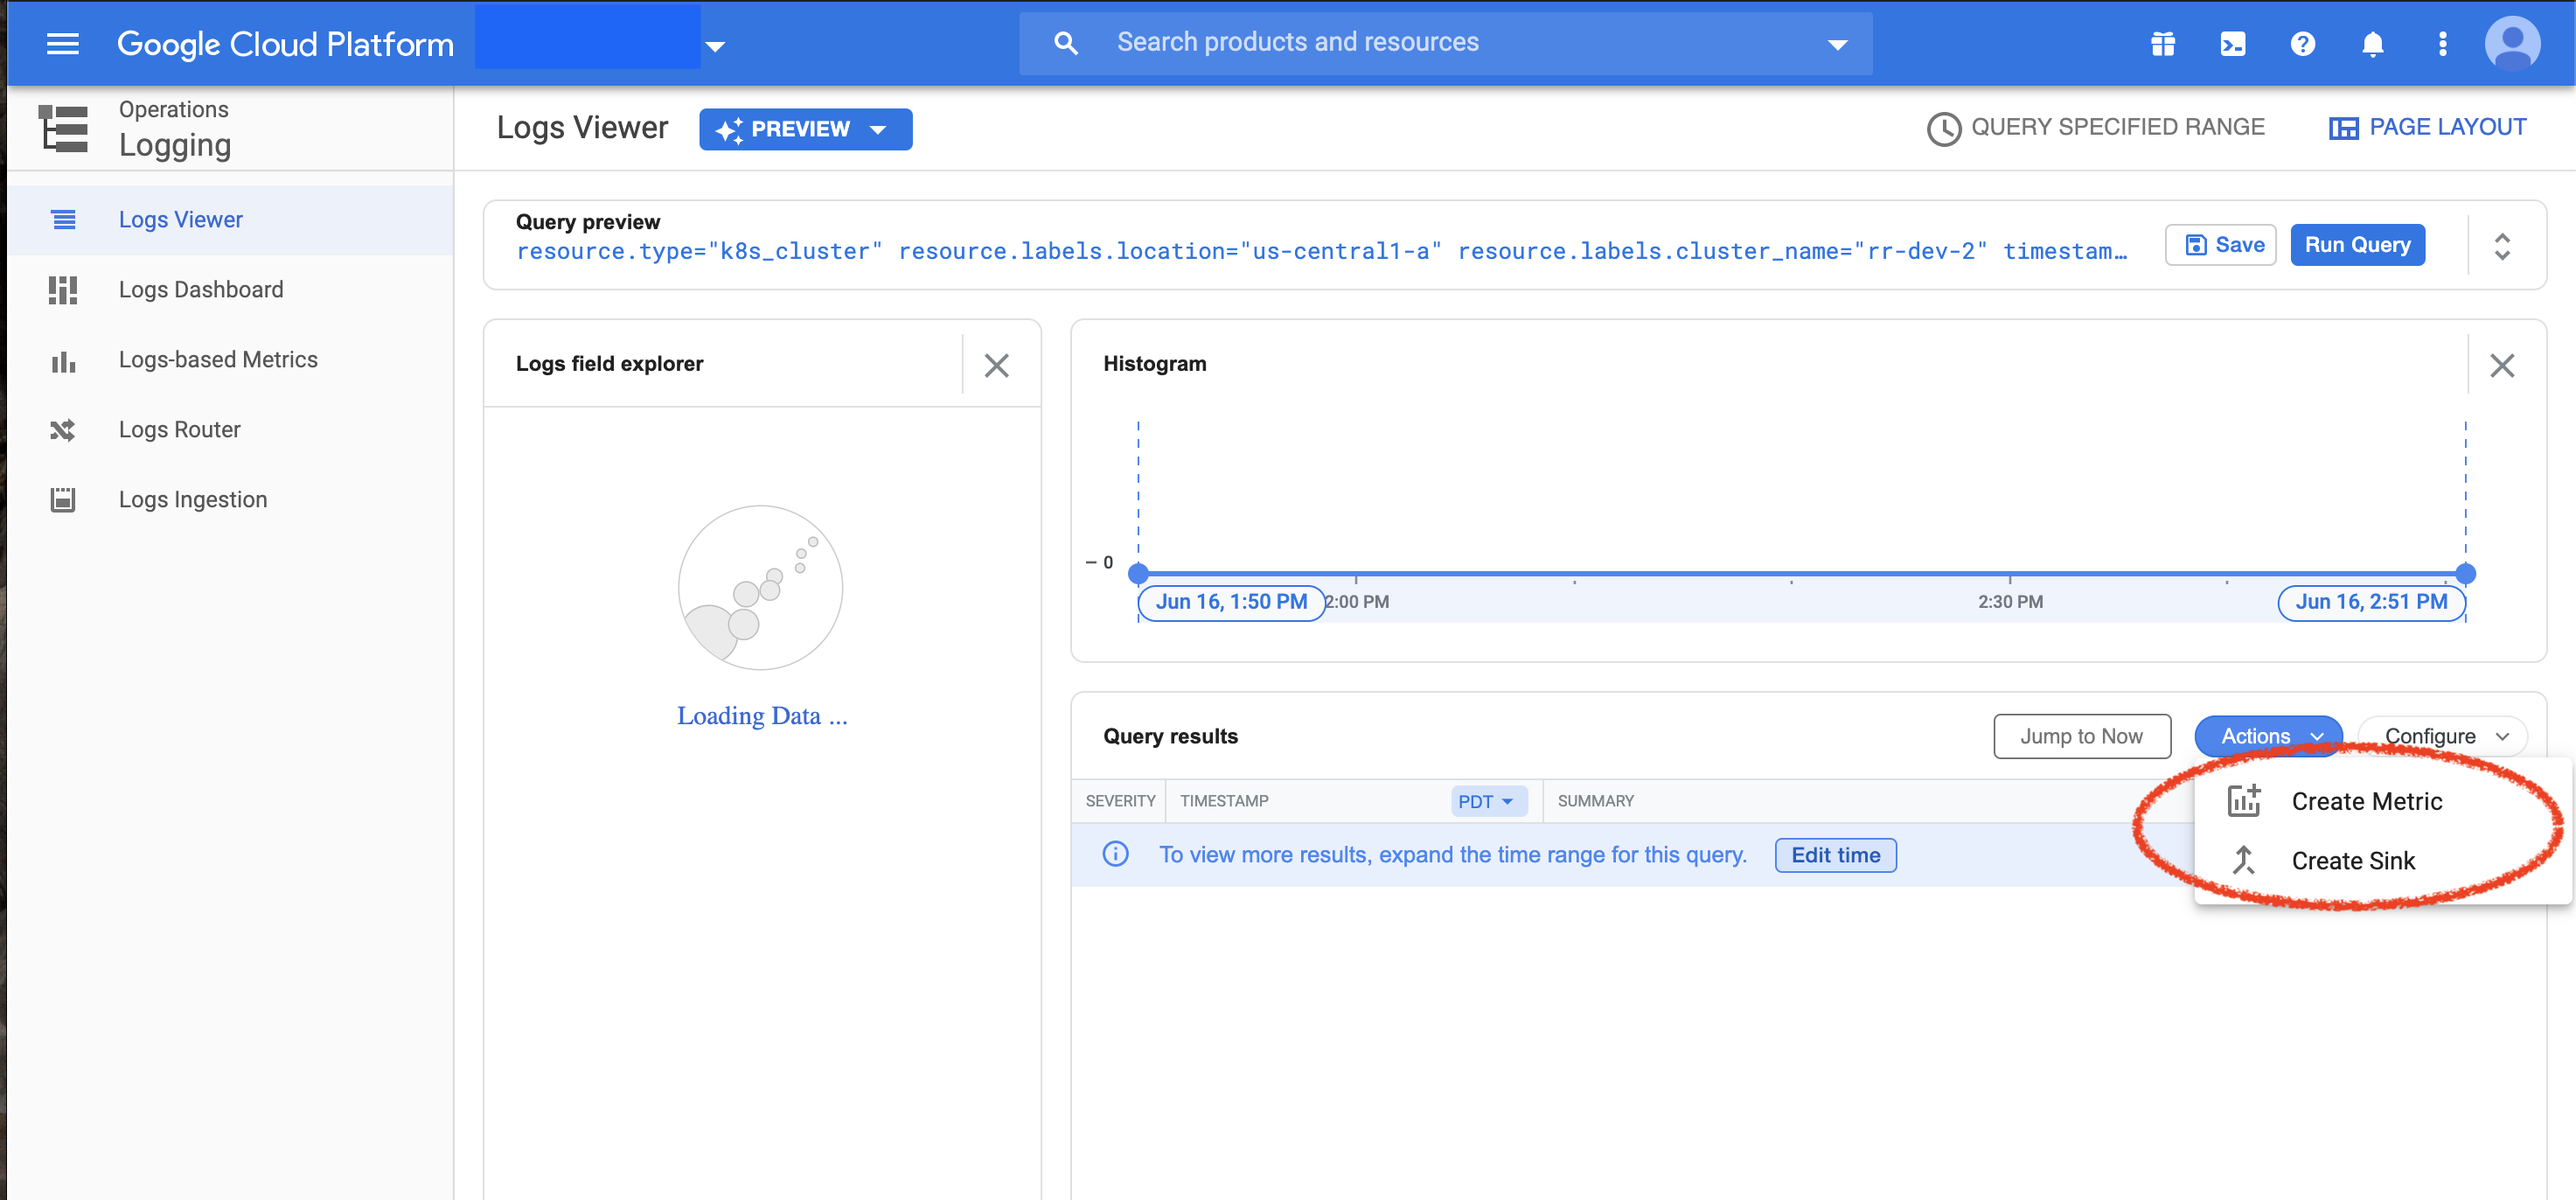
如果您正在使用GCP,您还可以使用他们的测井仪器,创建一个自定义度量,并对该度量发出警报。
另一种选择,但可能没有您正在寻找的指标是使用普罗米修斯与Nginx进口Prometheus出口商一起监视nginx度量(这取决于您想要监视的指标)。
https://stackoverflow.com/questions/62397731
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号