
解释查询- MySQL不使用表中的索引
我试图在explain中学习MySQL语句,但却碰壁了。
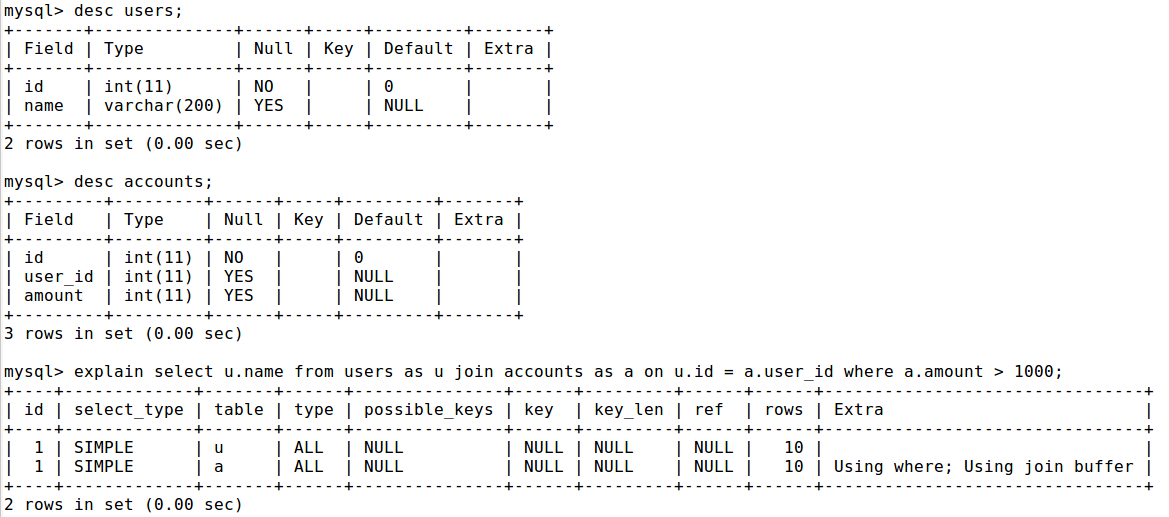
在我的实验中,我创建了两个表(每个表有10行),并通过一个简单的join运行explain。自然,不使用索引,扫描10*10 = 100行(我在图像中添加了输出,因为EXPLAIN的很长的输出被包装在自己身上。代码也在这个巴斯泰尔中):
然后添加主键和索引并重新发出explain命令:
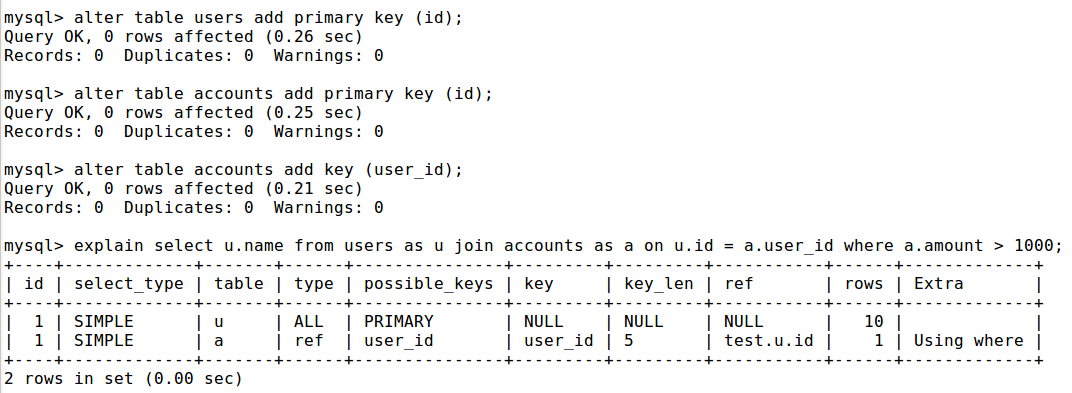
但是如您所见,用户表仍然被MySQL完全扫描,就好像没有主键一样。出什么问题了?
回答 3
Stack Overflow用户
发布于 2015-07-02 20:14:49
您似乎在询问有关EXPLAIN、INDEXing和优化特定SELECTs的内容。
为此:
select  u.name
    from  users as u
    join  accounts as a on u.id = a.user_id
where a.amount > 1000;优化器将在users和accounts之间选择首先查看哪个表。然后,它会反复延伸到另一张桌子上。
- 因为您说的是
a.amount > ...,而不是u,所以优化器很可能首先选择a。 - 如果
a.amount > 1000具有足够的选择性(例如,少于行的20% ),并且存在INDEX(amount),那么它将使用该索引。否则,它将对a进行表格扫描。 - 要进入
u,需要一些以id开头的索引。请记住,PRIMARY KEY是一个索引。
这一点,以及更多的基础知识,在我的索引食谱中都有介绍。
有关黏液痛的讨论,请参见EXPLAIN。
请使用SHOW CREATE TABLE;它比DESCRIBE更具描述性。
EXPLAIN FORMAT=JSON SELECT...也有点神秘,但它确实比普通的EXPLAIN有更多的细节。
Stack Overflow用户
发布于 2015-07-02 11:24:49
这是一个有点长的评论。
基本上,你的桌子太小了。对于如此小的数据,您无法获得合理的性能指示--查询只需要将两个数据页加载到查询的内存中。嵌套循环联接需要100个比较。相比之下,加载索引和执行二进制搜索可能是相同的工作量,如果不是更多的话。
如果您想了解explain,那么使用几行数千万行的表。
Stack Overflow用户
发布于 2015-07-02 11:39:22
由于主过滤器有Because >‘>比较运算符,所以它会进行全表扫描,因为它可能返回或不返回所有行.
当您用'user_id‘列加入'accounts’表时,它会在可能的键中显示'user_id‘索引,但由于整个表扫描过程,它不会使用它。
https://stackoverflow.com/questions/31183047
复制相似问题
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号