75% 成本和时间削减:优化微软 GraphRAG 索引的秘密

75% 成本和时间削减:优化微软 GraphRAG 索引的秘密
AgenticAI
发布于 2025-03-18 14:23:20
发布于 2025-03-18 14:23:20
书接上回《实战微软新一代RAG:GraphRAG强大的全局理解能力,碾压朴素RAG?》,想必大家都知道我最近在测试GraphRAG,由于其惊人的理解能力,我一直在探索。当然遇到的问题也比较多,比如community_reports不生效,tokens per minute和requests per minute不生效,全局搜索经常JSONDecodeError,以及高昂的成本和时间。这4个问题,我提交了4个PR去修复。本篇将围绕这4个问题和PR说明,最主要的是如何大幅降低成本和时间进行说明,修改很简单,但是精度上升了。
1. 社区报告配置失效
因为社区报告通常总结内容较大,如果配置的全局llm的context windows较小的话,在community reports阶段可能会失败。因此我在settings.yaml中尝试配置覆盖全局llm。
community_report:
  llm:
    api_key: ${GROQ_API_KEY}
    type: openai_chat # or azure_openai_chat
    model: qwen2:72b
    model_supports_json: false # recommended if this is available for your model.
    api_base: http://localhost:11434/v1
    max_tokens: 32768
    concurrent_requests: 1 # the number of parallel inflight requests that may be made
    tokens_per_minute: 15000 # set a leaky bucket throttle
    requests_per_minute: 30 # set a leaky bucket throttle
    top_p: 0.99
  ## parallelization: override the global parallelization settings for this task
  ## async_mode: override the global async_mode settings for this task
  prompt: "prompts/community_report.txt"
  max_length: 2000
  max_input_length: 8000
这个配置之所以不生效是因为代码中其实采用的community_reports,而配置中缺少s。因此修改生成模板的代码,即可通过PR[1],此PR已经被合并,拉取主分支使用即可。
2. TPM和RPM失效
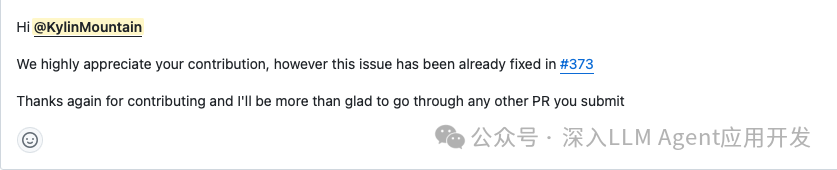
当你如上面文档配置全局每秒的每分钟最大Token数量和每分钟最大请求时候,也会发现不生效。原因是代码中其实读取的变量是tpm和rpm,通过PR[2]可以修复,但是这个被其他人提前修复,因此被关闭了,拉取主分支使用即可。
3. 全局搜索JSONDecoderError
当我使用gemma-9b-it模型的时候,我使用全局查询询问整个故事在讲什么的时候,我发现它经常报JSONDecodeError,但是结果也能输出,只是缺少一半,因为那一半返回的不是JSON格式,因此直接被忽略了。
poetry run poe query --root . --method global "What is this story mainly tell"
如果你看代码,你会发现全局查询调用的graphrag/query/structured_search/global_search/search.py中的search方法,其中它会使用文件同目录下map_system_prompt.py的MAP_SYSTEM_PROMPT这个Prompt提示词。这个Prompt非常长,而且我发现GraphRAG里的Prompt提示词好多都有重复。以下面MAP_SYSTEM_PROMPT为例,它设定了
- 角色说明Role
- 任务目标Goal,包含对如何解决任务、输入是什么、输出是什么、以及一系列输出的JSON字段解释和小的示例,这个example不是整个任务的示例,而是输出中某个description的示例。
- 输入的数据表
- 任务目标Goal,重复一遍
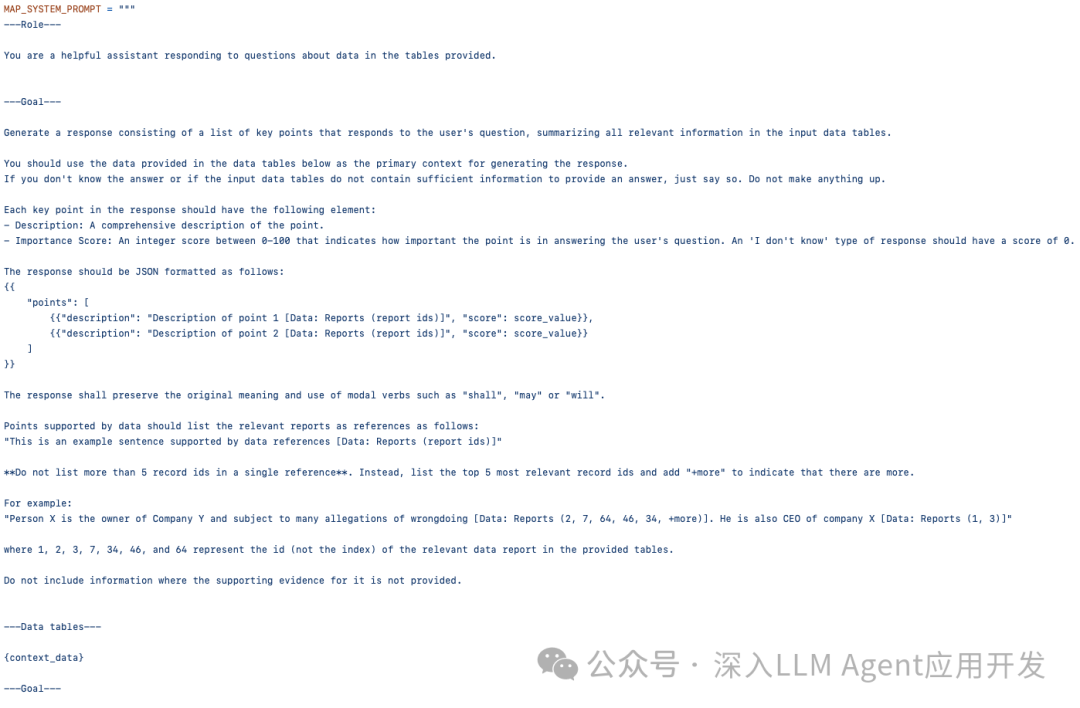
看过文章《敲黑板!吴恩达LLM Agent工作流Prompt精华全解析》的朋友们都知道,一个Prompt基本上包含五要素。GraphRAG中的Prompt中已经包含了任务的方法、任务的输入和输出、没有示例、用户输入,但是没有示例,而且重复任务目标。
- 解决任务的方法
- 任务的输入和输出
- 任务的Example,3到5个左右。
- 任务的历史纪录,如果有的话
- 用户输入的问题。
我们按照这个提示词优化这个Prompt来尝试稳定地输出JSON结果。为了加入示例,我将这个Prompt拆为System Prompt和User Prompt,系统Prompt就是设定一下角色,然后在User Prompt中加入示例。
MAP_SYSTEM_PROMPT = """
You are a helpful assistant responding to questions about data in the tables provided.
"""
User Prompt设定还是按照上述Prompt的5个要素来设定,任务设定和输入输出说明和上面截图一致,然后加入完整示例,从用户问题、输入的数据表到输出。然后再次按照这个格式,组织用户的问题和数据表给到LLM,使之能够模仿输出。通过这次修改,我发现我的全局查询稳定多了,可以稳定输出JSON。其中也有遇到生成的JSON回复有问题的情况,但是JSON中多了一个引号导致解析错误,看起来是模型过小。具体的PR[3]尚未合并,但对于我个人测试来说效果好多了,你如果遇到此类可以尝试一下。此外这个PR我删除了冗余的Goal设定,其实局部搜索中也有类似的Prompt我觉得都是需要优化的。
MAP_USER_PROMPT = """
Generate a response consisting of a list of key points that responds to the user's question, summarizing all relevant information in the input data tables.
...
**Do not list more than 5 record ids in a single reference**. Instead, list the top 5 most relevant record ids and add "+more" to indicate that there are more.

===============
For example:
user question: Is Person X currently under investigation for alleged illegal activities or unethical behavior?
---Data Tables---
| id | title                                | occurrence weight | content | rank |
|----|--------------------------------------|-------------------|---------|------|
| 1  | Allegations against Person X   | 1                 | Allegations of financial misconduct           |   4.0   |
| 2  | Allegations against Person X   | 0.3                 | Allegations of unethical business practices   |   4.0   |
| 3  | Allegations against Person X   | 0.8               | Allegations of workplace harassment          |   3.0   |
| 4  | CEO of company X               | 1                 | Person X is CEO of Company X             |   3.0   |
| 5  | owner of company Y              | 1                 | Person X is the owner of Company Y     |   3.0   |

answer:
{{
    "points": [
        {{"description": "Person X is the owner of Company Y and subject to many allegations of wrongdoing [Data: Reports (1, 2, 3, 4)].", "score": 85}},
        {{"description": "He is also CEO of company X [Data: Reports (6)]", "score": 75}}
    ]
}}

==============
user question: {user_question}

---Data tables---
{context_data}

answer:
"""
4. 大幅缩短索引时间和成本
有很多朋友在我的文章《实战微软新一代RAG:GraphRAG强大的全局理解能力,碾压朴素RAG?》中评论索引时间过长,动辄几十分钟到几个小时。我在尝试优化Prompt时候我发现,实体关系提取的Prompt非常大,大约2224 tokens,位于prompts/entity_extraction.txt。它的调用次数和文本分割的大小有关系。每个分割的文本,都需要使用entity_extraction提取一次实体关系。而GraphRAG设定的默认chunk size为300,overlap是100,这意味着什么?《仙逆》前10章大约26000个字符,按照这种方式分割,大约在实体提取阶段就需要65万Tokens,当然这只是一个粗略的估算,实际没有那么多,但也不会相差太远。
26000/(300-2*100)=260 chunks
260 * (2224+300) = 656240 tokens
所以两个思路,一是精简实体提取的Prompt,二是增加chunk size。前者可以考虑缩减Prompt的示例为一个,删除其他几个。后者可以参考LLamaIndex,它的默认分割大小为1024,overlap为20,因此我改变settings.yaml中这项参数,重新进行index。
chunks:
  size: 1024
  overlap: 20
  group_by_columns: [id] # by default, we don't allow chunks to cross documents
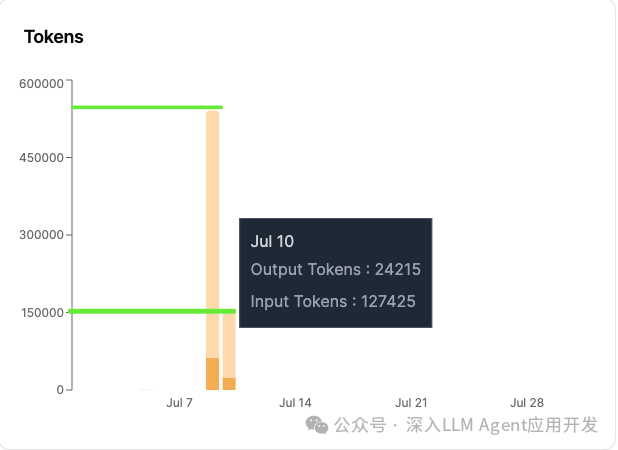
我只等待了大约5分-7分左右就全部完成了,而这在此之前起码半小时起步。我再次查看Groq上我消耗的Token数量,惊喜的发现Token消耗大幅下降,之前所需54万Token,而现在只需要151640,大约下降了3/4,时间也变得可以接受。请求数量从283到106,下降了大约63%。你或许会问,精度牺牲了吗?我们仍然以《实战微软新一代RAG:GraphRAG强大的全局理解能力,碾压朴素RAG?》中使用的问题为例进行说明。
问题1:这个故事主要讲述了什么?
SUCCESS: Global Search Response: 这个故事主要讲述了王家内部的复杂冲突。 冲突的核心是继承争端、个人恩怨以及不同成员的抱负。王卓表现出一种优越感,与铁柱存在冲突,因为他对铁柱的评价很低,并渴望被认可为更强大的修炼者 [Data: Reports (2)]. 王天山与王卓站在同一阵营,对抗铁柱,这表明他们之间存在着共同的敌意或策略联盟 [Data: Reports (2)]. 铁柱的家庭也面临着内部矛盾和外部压力。他的父亲与王天山有冲突,而他的叔叔则试图缓和局势 [Data: Reports (1)]. 总的来说,这个故事展现了家族内部的权力斗争、个人野心以及利益冲突,最终导致了复杂的人际关系和紧张的局势。
使用局部查询:王林的主要经历
SUCCESS: Local Search Response: # 王林的主要经历 1 出生与成长 [Data: 第一卷 平庸少年 (1)]
- 出生背景:王林,小名铁柱,出生于一个木匠家庭,在周围几个村落中属于大姓“王”氏。他的父亲是家族庶出次子,定居在一个村庄,以精湛的木匠手艺维持小康生活。
2 教育与梦想 [Data: 第一卷 平庸少年 (1)]
- 教育经历:从小聪明好学,喜欢读书,被村里人誉为神童。父母对他的期望很高,让他在家专心读书,而不是像其他孩子一样下地干活。
3 离家出走 [Data: 第一卷 平庸少年 (1)]
- 离乡原因:王林对山村外的世界充满向往,但因未能被恒岳派选中成为弟子而感到失望。他渴望改变命运,追求更高的学识和更广阔的世界。
4 恒岳派的遭遇 [Data: 第一卷 平庸少年 (1)]
- 测试失败:王林参加了恒岳派的入门测试,但因灵根不足未能被选中,这让他深感挫败。
5 家人的寻找与回归 [Data: 第一卷 平庸少年 (1)]
- 家人的担忧:离家出走后,家人非常担心他的安危。通过家族联名上访恒岳派,最终在附近的一处洞穴中被找到。
6 重返恒岳派 [Data: 第一卷 平庸少年 (1)]
- 意外的转机:虽然最初测试失败,但王林因一次意外被再次带到恒岳派。这次经历可能为他提供了重新评估的机会。
通过这些主要经历,我们可以看到王林从一个渴望知识和改变命运的孩子成长为面对挫折、家庭责任与个人梦想之间挣扎的年轻人。他的故事反映了追求理想与现实之间的冲突,以及在逆境中寻找希望的勇气。 7 结论 王林的故事是关于成长、失望与希望的交织。尽管面临挑战,他仍然保持着对更广阔世界的渴望和探索精神。
- 问题2:谁是王林 他的主要人际关系是什么样
SUCCESS: Local Search Response: ## 王林的身份与背景 王林,本名铁柱,是中国网络小说《仙逆》中的主角。他出生于一个平凡的山村家庭,自幼便对修仙充满了向往和渴望[Data: Characters (1)]。 1 主要人际关系 1.1 家庭成员
- 父母:王林的父母是普通的农民,他们深爱着自己的儿子,尽管生活贫困,但他们支持铁柱的梦想。在铁柱改名王林并加入恒岳派后,他的父母为他感到骄傲[Data: Characters (1)]。
1.2 恒岳派
- 张姓青年:在王林初次尝试加入恒岳派失败后,是这位张姓青年将他送回家,并鼓励了他。后来,正是通过这个人的帮助,王林才得以成为恒岳派的记名弟子[Data: Characters (1)]。
- 中年人(未命名):一位在恒岳派内地位较高的修士,他在得知王林四叔提供的精铁后,决定收王林为记名弟子。这位中年修士对王林的成长起到了关键作用[Data: Characters (1)]。
1.3 记名弟子工作安排
- 贼眉鼠眼的黄衣青年:负责管理记名弟子的工作分配。他对王林的态度轻蔑,给王林安排了挑水的任务,并设定了严格的完成标准和惩罚措施[Data: Characters (1)]。
2 王林的人际关系特点 王林的人际关系反映了他从一个山村少年成长为修仙者的过程中的挑战与机遇。家庭的爱和支持是他前进的动力;恒岳派内的人物则构成了他的成长环境,既有帮助也有考验。通过这些人际关系,王林的性格和能力得到了塑造和发展[Data: Characters (1)]。 3 结论 王林的人际关系网络复杂而多变,从家庭到修仙门派,每一段关系都对他的命运产生了深远的影响。正是这些关系的交织,构成了《仙逆》中王林成长故事的重要组成部分[Data: Characters (1)]。
- 问题3:王林和铁柱是什么关系?
SUCCESS: Local Search Response: # 王林与铁柱的关系 在《仙逆》这部小说中,王林实际上是铁柱的另一个名字。故事开始时,主角被称作“铁柱”,这是他在家乡的名字。然而,在他踏上修真之路后,逐渐以“王林”这一名字为人所知。 背景与转变
- 家庭背景: 铁柱出生在一个普通农家,他的父亲是一个务实的农民,对儿子寄予厚望。
- 仙缘测试: 当恒岳派来村中挑选弟子时,铁柱(王林)参加了选拔。尽管最初并不被看好,尤其是受到同村少年王卓,.01 2,3
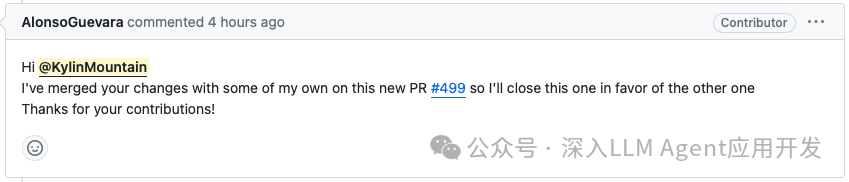
因此我提了PR[4]修改默认的chunk 和overlap大小,这个修改被认可,但被作者合并到他自己PR中了,QAQ。作者自己的PR尚未合并,但是大家可以自己尝试修改settings.yaml中的配置。这样修改之后,我看到唯一的问题是查询时候的输入变大了。
5. 总结
本文通过在实操GraphRAG中遇到的一些问题为例,介绍了如何修复的一些逻辑和PR,并由此提出了大幅缩减索引时间和成本的PR,希望本文对你有所帮助。如果你遇到其他问题,也欢迎在评论区提出。
若您意犹未尽,渴望亲自操刀,将理论付诸实践,那么这本《大模型应用开发:动手做AI Agent》和这本火热的蛇尾书《大模型应用开发极简入门》将是您理想的选择。 参考资料
[1]
PR: https://github.com/microsoft/graphrag/pull/405
[2]
PR: https://github.com/microsoft/graphrag/pull/382
[3]
PR: https://github.com/microsoft/graphrag/pull/473
[4]
PR: https://github.com/microsoft/graphrag/pull/487
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-07-11,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号