批量插入技巧:减少事务提交次数的性能提升
原创
引言
在数据库操作中,频繁提交事务是常见的性能瓶颈。想象一个场景:需要向数据库插入10万条用户数据。如果每条记录都独立提交事务,数据库将承受巨大的I/O压力和锁竞争。而通过批量插入技术,将多次插入合并为单次事务提交,可显著提升性能。
为什么减少事务提交次数能提升性能?
事务开销的本质
每次事务提交涉及:
- 日志写入(WAL机制)
- 磁盘I/O同步
- 锁资源的获取与释放 这些操作的成本远高于内存计算。实验表明,MySQL提交1万次单条插入比单次批量插入慢20倍以上。
锁竞争的连锁反应
高频提交会导致:
- 行锁/表锁竞争加剧
- 事务等待队列膨胀
- 死锁概率上升 例如,当多个线程同时插入时,独立提交可能引发锁超时错误,而批量操作通过减少锁持有时间缓解此问题。
基础示例:低效 vs 高效方案
假设用Node.js向MySQL插入用户数据:
// ❌ 低效方案:逐条提交
for (const user of userList) {
await db.query('INSERT INTO users SET ?', user);
// 每次循环都触发事务提交
}// ✅ 高效方案:批量提交
const batchSize = 1000;
for (let i = 0; i < userList.length; i += batchSize) {
const batch = userList.slice(i, i + batchSize);
// 开启事务
await db.beginTransaction();
try {
for (const user of batch) {
await db.query('INSERT INTO users SET ?', user);
}
// 整批完成后提交
await db.commit();
} catch (err) {
await db.rollback();
throw err;
}
}性能对比(测试环境:MySQL 8.0,10万条数据):
方案 | 耗时 | 磁盘I/O次数 |
|---|---|---|
逐条提交 | 98秒 | 100,000 |
批量提交(1000) | 4.2秒 | 100 |
关键优化点解析
- 批大小的权衡
- 过小:仍存在频繁提交开销
- 过大:内存压力增高,失败回滚成本高
建议:根据数据库配置(如
max_allowed_packet)动态调整批大小,通常500-5000是安全区间。 - 事务隔离性的代价undefined长时间事务可能阻塞查询,需结合业务场景:
- 关键业务:用小批次减少锁持有时间
- 离线任务:用大批次最大化吞吐
进阶挑战:生产环境的实战陷阱
- 死锁预防策略
当批量操作涉及多表关联时,超大事务可能引发死锁:
// 风险场景:跨表更新
await db.beginTransaction();
await updateAccount(batch); // 锁定账户表
await insertLogs(batch);    // 锁定日志表
await db.commit();解决方案:
- 按固定顺序访问表资源(如先账户后日志)
- 设置事务超时:
SET innodb_lock_wait_timeout=3 - 使用
FOR UPDATE NOWAIT快速失败
- 分库分表下的特殊处理
在Sharding场景中,批量插入需注意:
- 路由热点:避免批量数据全部分配到同一分片
- 批次分裂:当数据跨分片时自动拆分批次
// 分片感知的批量插入
const shardMap = new Map();
userList.forEach(user => {
    const shardId = getShardId(user.id);
    if (!shardMap.has(shardId)) shardMap.set(shardId, []);
    shardMap.get(shardId).push(user);
});

for (const [shardId, batch] of shardMap) {
    await shardDB[shardId].batchInsert(batch);
}
多数据库适配指南
数据库 | 批量插入方案 | 注意事项 |
|---|---|---|
MySQL |
| 单语句最多1000行 |
PostgreSQL | 使用 | 比INSERT快10倍 |
MongoDB |
| 需设置 |
Redis | Pipeline管道 | 单管道命令不超过10MB |
Node.js多数据库示例:
// PostgreSQL COPY流写入
const { Client } = require('pg');
const client = new Client();
await client.connect();
const stream = client.query.copyFrom('COPY users FROM STDIN');
batch.forEach(user => stream.write(`${user.id},${user.name}\n`));
stream.end();

// MongoDB无序批量插入
await db.collection('users').insertMany(batch, {
ordered: false, // 忽略单条错误
writeConcern: { w: 'majority' }
});
高并发场景优化组合拳
- 连接池精细化配置
// 关键参数优化
const pool = mysql.createPool({
    connectionLimit: 50,       // 避免连接风暴
    queueLimit: 1000,          // 防止内存溢出
    waitForConnections: true,  // 队列等待代替直接报错
    acquireTimeout: 3000       // 获取连接超时时间
});- 智能重试机制
const retryInsert = async (batch, retries = 3) => {
    try {
    await db.batchInsert(batch);
    } catch (err) {
    if (isRetryableError(err) && retries > 0) {
        await delay(2 ** (4 - retries) * 100); // 指数退避
        return retryInsert(batch, retries - 1);
    }
    throw err;
    }
};- 压力测试指标参考
并发数 | 批大小 | QPS | 95%延迟 | 错误率 |
|---|---|---|---|---|
50 | 500 | 3200 | 38ms | 0.01% |
100 | 1000 | 5800 | 72ms | 0.12% |
200 | 2000 | 9200 | 215ms | 1.7% |
终极实践:全链路优化方案
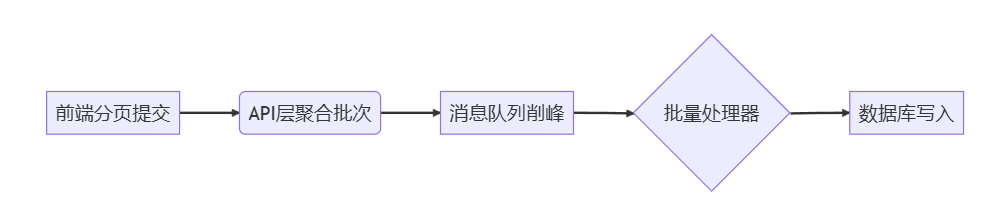
- 前端到数据库的协同
- 监控关键指标
- 数据库:
Innodb_row_lock_time_avg - 应用层:批处理队列积压量
- OS:
await%磁盘等待时间
结语:性能与稳定性的平衡
通过减少事务提交次数,我们实现了从线性处理到批量流水线的质变。但切记:
"优化不是追求理论峰值,而是在业务约束下找到最佳平衡点"
最终建议:
- 核心业务优先保障稳定性(小批次+强事务)
- 数据分析类任务追求吞吐量(大批次+异步提交)
- 始终通过压测校准参数,警惕"纸上优化"
批量插入如同数据库世界的加速齿轮,只有精准咬合业务场景,才能释放真正的性能潜力。
🌟 让技术经验流动起来
▌▍▎▏ 你的每个互动都在为技术社区蓄能 ▏▎▍▌
✅ 点赞 → 让优质经验被更多人看见
📥 收藏 → 构建你的专属知识库
🔄 转发 → 与技术伙伴共享避坑指南
点赞 ➕ 收藏 ➕ 转发,助力更多小伙伴一起成长!💪
💌 深度连接:
点击 「头像」→「+关注」
每周解锁:
🔥 一线架构实录 | 💡 故障排查手册 | 🚀 效能提升秘籍
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号