构建AI智能体:模型的成绩单:一文读懂损失函数,看懂AI如何学习
原创
构建AI智能体:模型的成绩单:一文读懂损失函数,看懂AI如何学习
原创
未闻花名
发布于 2026-01-03 11:06:56
发布于 2026-01-03 11:06:56
一. 前言
在我们与大语言模型的每一次对话背后,都隐藏着一个至关重要的学习机制就是损失函数。这个看似抽象的概念,实则是所有大模型实现智能进化的核心引擎。它如同一位严格的导师,通过精确的数学计算,持续评估模型输出的质量,并指引其调整方向。无论是简单的文本分类,还是复杂的对话生成,模型正是通过不断降低损失值来完成学习过程。理解损失函数,就等于掌握了开启大模型学习黑箱的钥匙。
想象一下教孩子认字:他每写错一笔,你指出错误;每写对一个,你给予鼓励。损失函数就是大模型的老师,它不厌其烦地告诉模型:“这个回答离完美还差多远。”正是通过计算理想答案与当前回答之间的差距,模型才能在上万亿次的调整中,从胡言乱语进步到对答如流。今天我们将从基础概念出发,用生活中的类比解释损失函数如何工作,并通过具体示例展示不同损失函数的特点,深入的了解损失函数是如何成为塑造大模型智能的核心推手。
二、什么是损失函数
定义:损失函数是一个数学工具,用来衡量机器学习模型的“预测值”和真实的“答案”之间差距有多大。这个差距用一个数字来表示,叫做“损失值”或“成本”。
核心思想:机器学习的整个过程,就是模型通过不断尝试,想方设法让这个损失值越来越小的过程。损失值降到最低,就意味着模型预测得最准。
核心三要素:
- 预测值:模型猜的结果,反映了模型当前能力。
- 真实值:标准答案,确保了学习方向的正确性。
- 损失值:一个数字,表示预测和真实差多远,提供了明确的优化目标。
通俗的理解:想象一下,我们和朋友在玩一个默契游戏,指导朋友闭眼投掷飞镖,我们能看见靶心,朋友看不见。
- 第一次投掷:他扔出去了,飞镖扎在了墙上,离靶心非常远。我们告诉他:“偏得太多了,往右下方调整!”
- 第二次投掷:他根据我们的提示调整,飞镖扎在了靶子的最边缘。我们告诉他:“好一点了,但还是有点远,继续往右下方微调!”
- 第三次投掷:飞镖扎在了3环的位置。再告诉他:“非常接近了!只需要再往上一点点!”
- 第四次投掷:正中红心!于是我们告诉他:“完美!记住这个感觉!”
在这个游戏里,我们每次对他投掷结果的评价和指导,就扮演了损失函数的角色。
三、回归任务损失函数
任务目标:预测一个连续的数值(如房价、温度、销量)。
核心思想:衡量预测值与真实值在数值上的“距离”。
1. 均方误差
公式:MSE = (1/N) * Σ (y_true_i - y_pred_i)²
- MSE:均方误差,是整个模型的总损失值。
- N:数据集中样本的总数量。
- Σ:求和符号,表示对所有样本(i从1到N)的计算结果进行累加。
- y_pred_i:模型对第 i 个样本的预测值。
- y_true_i:第 i 个样本的真实值。
直观理解:计算误差的平方,平方项会放大较大误差的惩罚。一个两倍的误差会产生四倍的损失。这使得模型对异常值(离群点)非常敏感,会极力避免出现大的错误。好比最常用的“严厉考官”。
1.1 示例场景:房价预测
目标:通过房子大小预测售价。
训练数据:
房子大小 (平米) | 真实售价 (万元) |
|---|---|
50 | 100 |
80 | 160 |
120 | 240 |
初始模型规则:预测售价 = 房子大小 × 2(即认为房价是2万元/平米)
先逐步计算单个样本的损失:(预测值 - 真实值)²
第一轮评估(使用训练数据):
- 50平米房子:
- 预测值:50 × 2 = 100万元,真实值:100万元,损失:(100 - 100)² = 0
- 80平米房子:
- 预测值:80 × 2 = 160万元,真实值:160万元,损失:(160 - 160)² = 0
- 120平米房子:
- 预测值:120 × 2 = 240万元,真实值:240万元,损失:(240 - 240)² = 0
总损失 = (0 + 0 + 0) / 3 = 0
- 损失为0通常要考虑是否出现了问题,并不代表模型完美,而是数据过于规整,掩盖了真实情况。
第二轮评估(使用真实数据):
现在我们换一个更真实的数据,假设第三套房子的真实售价是 250万
- 50平米房子:损失 = 0
- 80平米房子:损失 = 0
- 120平米房子:
- 预测值:120 × 2 = 240万元,真实值:250万元,损失:(240 - 250)² = 100
总损失 = (0 + 0 + 100) / 3 ≈ 33.3
由此示例可以总结:
- 损失值100量化了模型对第三套房的预测错误程度
- 均方误差通过平方计算,放大较大误差的影响(10万元的误差产生100的损失值)
- 模型的目标就是在训练过程中不断调整参数,最小化这个损失值
为了让这个过程更直观,我们画一张图。假设真实的关系是 售价 = 大小 × 2.1,我们看看模型如果用 预测售价 = 大小 × w 中的 w (权重) 取不同值时,损失会如何变化。
import matplotlib.pyplot as plt
import numpy as np

# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']  # 用黑体
plt.rcParams['axes.unicode_minus'] = False   # 正常显示负号

# 假设真实的数据关系:y = 2.1 * x
x = np.array([50, 80, 120])  # 房子大小
y_true = np.array([105, 168, 252])  # 真实售价 (50*2.1, 80*2.1, 120*2.1)

# 让权重w在1.5到2.5之间变化,计算每个w对应的总损失
w_values = np.linspace(1.5, 2.5, 100) # 生成100个候选的w值
total_losses = [] # 记录每个w的总损失

for w in w_values:
    y_pred = w * x  # 模型的预测
    loss = np.mean((y_pred - y_true)     ** 2)  # 计算均方误差损失
    total_losses.append(loss)

# 找到损失最小的点
min_index = np.argmin(total_losses)
min_w = w_values[min_index]
min_loss = total_losses[min_index]

# 绘制图像
plt.figure(figsize=(10, 6))
plt.plot(w_values, total_losses, linewidth=2, label='总损失函数曲线')
plt.axvline(x=2.1, color='green', linestyle='--', label='真实权重 w=2.1')
plt.plot(min_w, min_loss, 'ro', markersize=8, label=f'最小损失点 (w≈{min_w:.2f})')
plt.xlabel('模型的权重 (w)')
plt.ylabel('总损失 (Loss)')
plt.title('损失函数可视化:寻找最优秀的模型权重')
plt.legend()
plt.grid(True)
plt.show()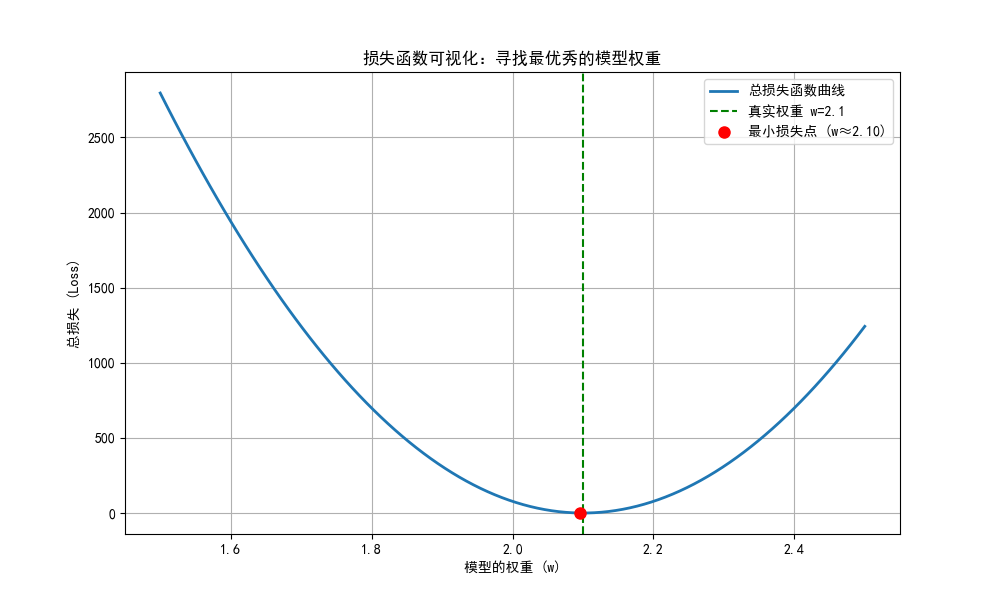
图表说明:这张图就是损失函数的样貌。它清楚地告诉我们:
- 当模型的权重 w 等于2.1时,总损失最小(红点处)。
- 当 w 偏离2.1时,无论偏左还是偏右,总损失都会上升。
- 模型的目标就是找到这个红点!
2. 平均绝对误差
公式:MAE = (1/N) * Σ |y_true_i - y_pred_i |
直观理解:计算误差的绝对值,它对所有误差一视同仁,惩罚与误差大小成线性关系。因此它对异常值不那么敏感,更加稳健。
示例数据:同房价预测。
- 50平米房子:损失 = 0
- 80平米房子:损失 = 0
- 120平米房子:
- 预测值:120 × 2 = 240万元,真实值:250万元,损失:(240 - 250)² = 100
MAE = [|100-100| + |160-160| + |240-250|] / 3 = (0 + 0 + 10) / 3 ≈ 3.33
MSE vs. MAE:MSE(33.3) > MAE(3.33),因为MSE被那个10的误差平方(100)放大了。
import matplotlib.pyplot as plt
import numpy as np

# 防止中文乱码
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 使用您提供的实际数据
y_pred = np.array([100, 160, 240])  # 预测值 (万元)
y_true = np.array([100, 160, 250])  # 真实值 (万元)

# 计算每个样本的误差
errors = y_pred - y_true
print("每个样本的误差:", errors)

# 计算MSE和MAE损失
mse_per_sample = errors ** 2
mae_per_sample = np.abs(errors)

mse_total = np.mean(mse_per_sample)
mae_total = np.mean(mae_per_sample)

print("\n各样本MSE损失:", mse_per_sample)
print("各样本MAE损失:", mae_per_sample)
print(f"\n总MSE损失: {mse_total:.2f}")
print(f"总MAE损失: {mae_total:.2f}")

# 可视化对比
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 5))

# 子图1:各样本损失对比
samples = ['50平米', '80平米', '120平米']
x_pos = np.arange(len(samples))

ax1.bar(x_pos - 0.2, mse_per_sample, 0.4, label='MSE损失', color='red', alpha=0.7)
ax1.bar(x_pos + 0.2, mae_per_sample, 0.4, label='MAE损失', color='blue', alpha=0.7)

ax1.set_xlabel('样本')
ax1.set_ylabel('损失值')
ax1.set_title('各样本损失值对比')
ax1.set_xticks(x_pos)
ax1.set_xticklabels(samples)
ax1.legend()
ax1.grid(True, alpha=0.3)

# 在柱状图上显示数值
for i, (mse_val, mae_val) in enumerate(zip(mse_per_sample, mae_per_sample)):
    ax1.text(i - 0.2, mse_val + 5, f'{mse_val:.0f}', ha='center', va='bottom')
    ax1.text(i + 0.2, mae_val + 5, f'{mae_val:.0f}', ha='center', va='bottom')

# 子图2:损失函数曲线对比(理论曲线)
theory_errors = np.linspace(-150, 150, 300)  # 扩大范围以包含实际误差
theory_mse = theory_errors ** 2
theory_mae = np.abs(theory_errors)

ax2.plot(theory_errors, theory_mse, 'r-', label='MSE损失曲线', linewidth=2)
ax2.plot(theory_errors, theory_mae, 'b-', label='MAE损失曲线', linewidth=2)

# 标记实际数据点
actual_errors = errors
actual_mse = mse_per_sample
actual_mae = mae_per_sample

colors = ['green', 'orange', 'purple']
for i, (err, mse_val, mae_val) in enumerate(zip(actual_errors, actual_mse, actual_mae)):
    ax2.plot(err, mse_val, 'o', color=colors[i], markersize=8,
             label=f'样本{i+1} MSE (误差={err})')
    ax2.plot(err, mae_val, 's', color=colors[i], markersize=8,
             label=f'样本{i+1} MAE (误差={err})')

ax2.set_xlabel('误差 (y_pred - y_true) 万元')
ax2.set_ylabel('损失 (Loss)')
ax2.set_title('损失函数曲线与实际数据点')
ax2.legend()
ax2.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()

# 打印详细分析
print("\n" + "="*50)
print("详细分析")
print("="*50)
print("样本详情:")
for i, (size, pred, true, error) in enumerate(zip([50, 80, 120], y_pred, y_true, errors)):
    print(f"  样本{i+1} ({size}平米): 预测={pred}万, 真实={true}万, 误差={error}万")

print(f"\n关键观察:")
print(f"  - 样本1和2: 误差为0,MSE和MAE损失都为0")
print(f"  - 样本3: 误差为-10万")
print(f"    * MSE损失: (-10)² = 100")
print(f"    * MAE损失: |-10| = 10")
print(f"  - MSE对较大误差的惩罚更严厉 (100 vs 10)")
print(f"  - 总MSE损失: (0 + 0 + 100)/3 = {mse_total:.2f}")
print(f"  - 总MAE损失: (0 + 0 + 10)/3 = {mae_total:.2f}")
输出结果:
每个样本的误差: [ 0 0 -10] 各样本MSE损失: [ 0 0 100] 各样本MAE损失: [ 0 0 10] 总MSE损失: 33.33 总MAE损失: 3.33 ================================================== 详细分析 ================================================== 样本详情: 样本1 (50平米): 预测=100万, 真实=100万, 误差=0万 样本2 (80平米): 预测=160万, 真实=160万, 误差=0万 样本3 (120平米): 预测=240万, 真实=250万, 误差=-10万 关键观察: - 样本1和2: 误差为0,MSE和MAE损失都为0 - 样本3: 误差为-10万 * MSE损失: (-10)² = 100 * MAE损失: |-10| = 10 - MSE对较大误差的惩罚更严厉 (100 vs 10) - 总MSE损失: (0 + 0 + 100)/3 = 33.33 - 总MAE损失: (0 + 0 + 10)/3 = 3.33
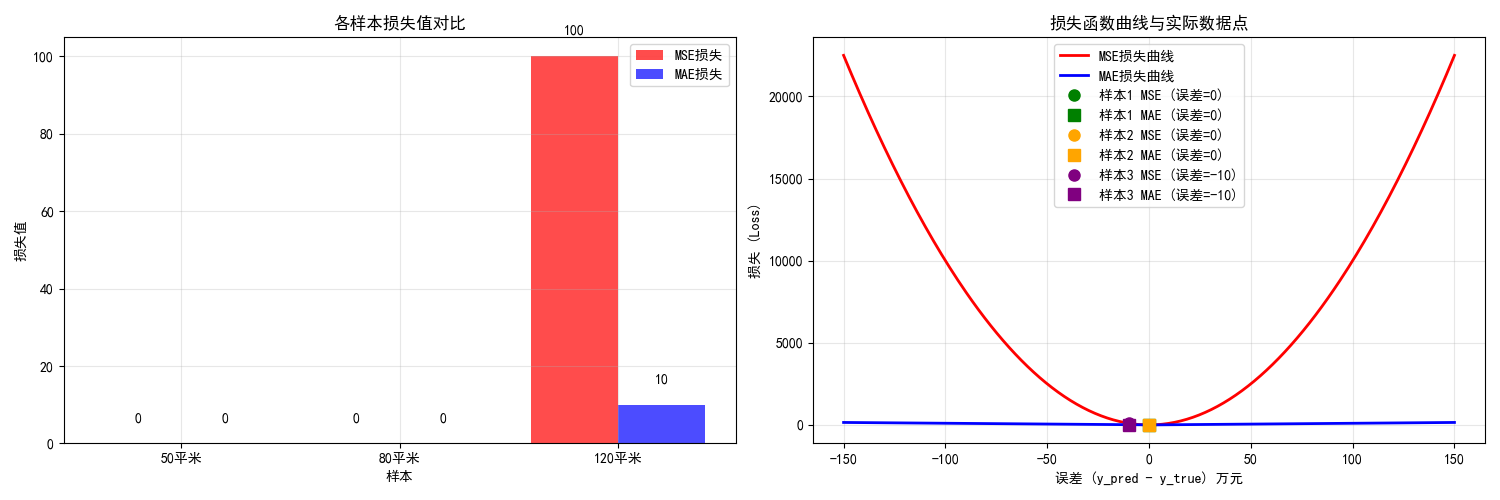
图示说明:
- 左图:柱状图清晰显示各样本的MSE和MAE损失值
- 右图:理论曲线上的实际数据点,直观展示:
- MSE(红色曲线)对误差的惩罚呈平方增长
- MAE(蓝色直线)对误差的惩罚呈线性增长
- 样本3的误差-10万在MSE上产生100的损失,在MAE上只产生10的损失
这完美验证了MSE对较大误差的惩罚远比MAE严厉的特性。
四、分类任务损失函数
任务目标:预测一个离散的类别标签(如猫/狗/兔,垃圾邮件/正常邮件)。
核心思想:衡量预测的概率分布与真实的概率分布之间的差异。
前提:交叉熵
在讲解下面的内容之前,先简单了解一下交叉熵,在我们信息论的文章中详细讲解过,详情可以参考《信息论完全指南:从基础概念到在大模型中的实际应用》
简单来说交叉熵就是衡量你“有多惊讶”,预测得越准,你就越不惊讶,交叉熵越低;预测得越离谱,你就越震惊,交叉熵越高。
一个通俗的例子,想象你的朋友手里拿着一瓶被遮挡的饮料,让你猜是什么。有四种可能:矿泉水、可乐、果汁、咖啡。
- 场景一:朋友给你一个超强提示
- 真实答案:可乐
- 你的预测:可乐的概率:90%,其他三种饮料的概率:10%
- 结果:他果然拿出了可乐。
- 你的惊讶程度:很低。“果然和我想的差不多,一点都不意外!”
- 交叉熵很低
- 场景二:朋友给的提示很模糊
- 真实答案:可乐
- 你的预测:可乐的概率:30%,矿泉水的概率:30%,果汁的概率:20%,咖啡的概率:20%
- 结果:他拿出了可乐。
- 你的惊讶程度:中等。“哦,是可乐啊,也有可能吧。”
- 交叉熵中等
- 场景三:朋友误导了你
- 真实答案:可乐
- 你的预测:咖啡的概率:90%,可乐的概率:2%(你几乎排除了这个选项)
- 结果:他居然拿出了可乐!
- 你的惊讶程度:爆表!“什么?!居然是可乐!这太出乎意料了!”
- 交叉熵非常高
把这个例子对应到数学上:
- 你的预测 = 模型输出的概率分布(比如 [0.9, 0.1, 0.0, 0.0])
- 真实答案 = 一个确定的标签(比如 [1, 0, 0, 0],代表“可乐”)
- 你的惊讶程度(交叉熵) = -log(你给“真实答案”分配的概率)
计算一下第三个场景的“惊讶度”:
- 你给“可乐”(真实答案)分配的概率是 0.02
- 交叉熵 = -log(0.02) ≈ 3.9 (这是一个很高的值)
计算第一个场景的“惊讶度”:
- 你给“可乐”(真实答案)分配的概率是 0.9
- 交叉熵 = -log(0.9) ≈ 0.1 (这是一个很低的值)
核心思想:
- 交叉熵函数 -log(x) 有一个特点:当x接近0时,函数值会急剧变大。
- 这完美地对应了我们的直觉:
- 自信地犯错(你认为概率只有2%的事情居然发生了):极度震惊! -> 损失值巨大
- 自信地猜对(你认为概率90%的事情发生了):毫不意外 -> 损失值很小
所以,交叉熵就是在衡量模型的惊讶度。机器学习的目标就是通过调整参数,让模型对真实结果感到毫不意外,也就是把交叉熵这个惊讶度降到最低,当模型对所有训练数据都感到习以为常、毫不惊讶时,那么它就训练的很优秀了。
1. 二分类交叉熵
1.1 使用场景
二分类,顾名思义,就是结果只有两种可能性的问题。就像回答“是”或“否”。
典型例子:
- 判断一封邮件是否是垃圾邮件(是/否)。
- 判断一张医疗影像是否有肿瘤(有/无)。
- 判断一个客户是否会流失(会/不会)。
在这种问题中,我们通常将其中一类标记为 “正类” (如“是垃圾邮件”),另一类标记为 “负类” (如“不是垃圾邮件”)。
1.2 数学公式与解释
二分类交叉熵损失的公式如下:
Loss = - [ y * log(p) + (1 - y) * log(1 - p) ]
这个公式看起来有点复杂,但我们把它拆开看,其实非常简单:
- y:真实标签。由于只有两类,我们通常用 1 代表正类,0 代表负类。
- p:模型预测的概率。它特指模型预测为 正类 的概率。因此,预测为负类的概率自然就是 1 - p。
- log:自然对数。它是实现“惩罚放大”的关键函数。
这个公式的精妙之处在于,它其实是一个“开关函数”。
- 情况一:当真实标签 y = 1 (属于正类)
- 公式变成了: Loss = - [ 1 * log(p) + (1 - 1) * log(1 - p) ] = - log(p)
- 解读:损失只与模型预测为正类的概率 p 有关。p 越大(越接近1),-log(p) 越小,损失越小。
- 目标:鼓励模型为真实的正类样本输出一个大的 p。
- 情况二:当真实标签 y = 0 (属于负类)
- 公式变成了: Loss = - [ 0 * log(p) + (1 - 0) * log(1 - p) ] = - log(1 - p)
- 解读:损失只与模型预测为负类的概率 (1 - p) 有关。(1 - p) 越大(即 p 越小),-log(1 - p) 越小,损失越小。
- 目标:鼓励模型为真实的负类样本输出一个小的 p。
总结:二分类交叉熵公式,本质上是一个根据真实标签 y 的值,自动选择计算 -log(p) 还是 -log(1 - p) 的智能公式。
1.3 详细计算示例
任务:判断邮件是否为垃圾邮件(是/否)。
- 正类 (y=1):是垃圾邮件。
- 负类 (y=0):不是垃圾邮件。
假设有一封邮件,它确实是垃圾邮件(y=1),我们来看三个模型的预测(p = 模型认为它是垃圾邮件的概率):
- 好模型:p = 0.95 (很有把握地判断正确)
- 损失 = - log(0.95) ≈ - (-0.051) ≈ 0.051
- 差模型:p = 0.6 (不太确定,但猜对了)
- 损失 = - log(0.6) ≈ - (-0.511) ≈ 0.511
- 烂模型:p = 0.05 (很有把握地判断错误!)
- 损失 = - log(0.05) ≈ - (-3.00) ≈ 3.00
可以看到,烂模型因为“自信地犯错”,受到了巨大的惩罚(损失=3.00),而好模型的惩罚微乎其微。
示例演示:
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn

# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

def binary_cross_entropy_demo():
    """二分类交叉熵损失演示"""

    # 1. 数学公式实现
    def binary_cross_entropy(y_true, y_pred):
        """手动实现二分类交叉熵损失"""
        return - (y_true * np.log(y_pred) + (1 - y_true) * np.log(1 - y_pred))

    # 2. 示例数据
    y_true_positive = 1  # 正样本真实标签
    y_true_negative = 0  # 负样本真实标签

    # 模型预测的概率(正类概率)
    predictions = np.linspace(0.01, 0.99, 100)

    # 3. 计算损失
    loss_positive = binary_cross_entropy(y_true_positive, predictions)
    loss_negative = binary_cross_entropy(y_true_negative, predictions)

    # 4. 可视化
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 6))

    # 正样本的损失曲线
    ax1.plot(predictions, loss_positive, 'b-', linewidth=2, label='正样本损失 (y=1)')
    ax1.set_xlabel('模型预测概率 p')
    ax1.set_ylabel('损失值')
    ax1.set_title('二分类交叉熵 - 正样本 (y=1)\nLoss = -log(p)')
    ax1.grid(True, alpha=0.3)
    ax1.legend()

    # 标记几个关键点
    key_points = [0.1, 0.5, 0.9]
    for p in key_points:
        loss = -np.log(p)
        ax1.plot(p, loss, 'ro', markersize=8)
        ax1.annotate(f'p={p}\nloss={loss:.2f}',
                    xy=(p, loss), xytext=(10, 10),
                    textcoords='offset points', fontsize=9)

    # 负样本的损失曲线
    ax2.plot(predictions, loss_negative, 'r-', linewidth=2, label='负样本损失 (y=0)')
    ax2.set_xlabel('模型预测概率 p')
    ax2.set_ylabel('损失值')
    ax2.set_title('二分类交叉熵 - 负样本 (y=0)\nLoss = -log(1-p)')
    ax2.grid(True, alpha=0.3)
    ax2.legend()

    # 标记几个关键点
    for p in key_points:
        loss = -np.log(1-p)
        ax2.plot(p, loss, 'bo', markersize=8)
        ax2.annotate(f'p={p}\nloss={loss:.2f}',
                    xy=(p, loss), xytext=(10, 10),
                    textcoords='offset points', fontsize=9)

    plt.tight_layout()
    plt.show()
输出结果:
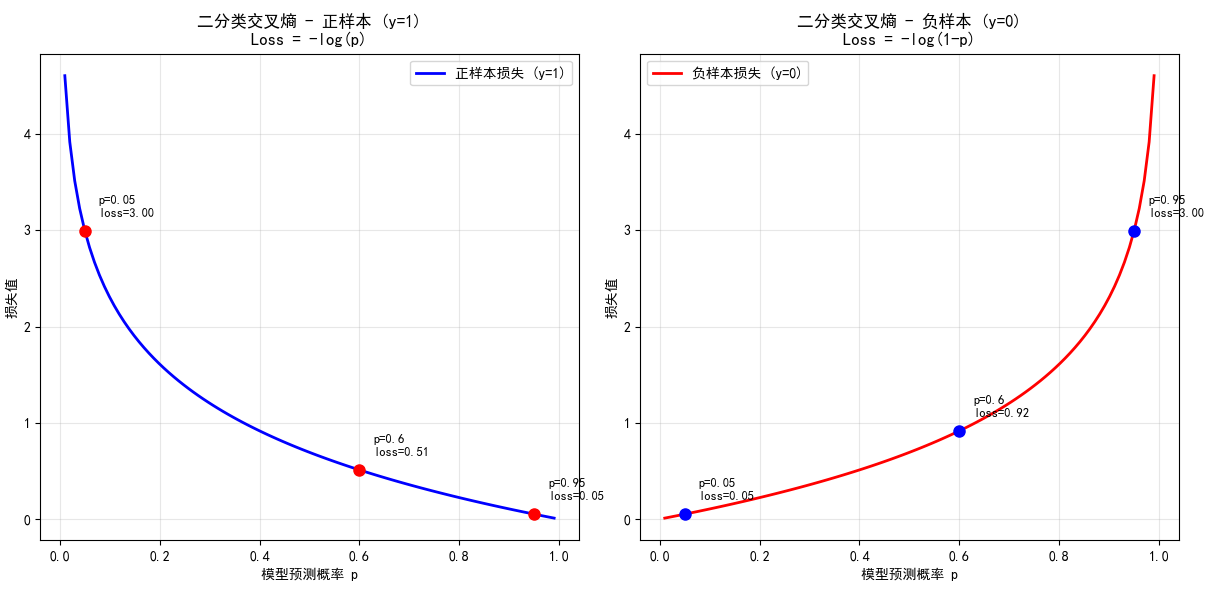
2. 多分类交叉熵损失
2.1 使用场景
多分类是指类别数量超过两个的问题。
典型例子:
- 手写数字识别(0~9,共10类)。
- 图像识别(猫、狗、鸟、汽车...共1000类)。
- 大语言模型预测下一个词(词汇表里50000个词,就是50000类)。
对于多分类问题,我们使用 One-hot编码 来表示真实标签。
- 例如,对于一个三分类问题(猫、狗、兔子):
- “猫”的标签是 [1, 0, 0]
- “狗”的标签是 [0, 1, 0]
- “兔子”的标签是 [0, 0, 1]
2.2 数学公式与解释
多分类交叉熵损失的公式如下:
Loss = - Σ (y_i * log(p_i))
- y_i:真实标签在第 i 个类别上的值。由于是 One-hot 编码,只有真实类别那个位置是1,其他都是0。
- p_i:模型预测的样本属于第 i 个类别的概率。
- Σ:求和符号,表示对所有类别 i 进行求和。
这个公式的精妙之处在于,由于 One-hot 编码的特性,求和后实际上只剩下了一项!
- 假设真实类别是 k,那么只有 y_k = 1,其他的 y_i 都等于0。
- 所以公式简化为: Loss = - [0*log(p_1) + ... + 1*log(p_k) + ... + 0*log(p_n)] = - log(p_k)
总结:多分类交叉熵损失,最终只关心模型对于真实那个类别的预测概率 p_k。p_k 越高,损失就越低。
2.3 详细计算示例
任务:识别图片是猫、狗还是兔子。
真实情况:图片是猫,所以真实标签 y = [1, 0, 0]。
我们来看四个模型的预测(输出三个概率,分别对应 [猫, 狗, 兔子]):
- 好模型:预测 p = [0.9, 0.08, 0.02]
- 损失 = - log(0.9) ≈ 0.105 (只计算猫的概率)
- 一般模型:预测 p = [0.60, 0.25, 0.15]
- 损失 = - log(0.6) ≈ 0.511 (只计算猫的概率)
- 差模型:预测 p = [0.4, 0.3, 0.3]
- 损失 = - log(0.4) ≈ 0.916
- 烂模型:预测 p = [0.05, 0.25, 0.7] (非常确信是兔子)
- 损失 = - log(0.05) ≈ 3.00
结论与二分类一致:模型必须为正确的类别分配高概率,才能获得低损失。
示例演示:
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn

# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

def categorical_cross_entropy_demo():
    """多分类交叉熵损失演示"""

    # 1. 数学公式实现
    def categorical_cross_entropy(y_true, y_pred):
        """手动实现多分类交叉熵损失"""
        return -np.sum(y_true * np.log(y_pred))

    # 2. 三分类示例
    classes = ['猫', '狗', '兔子']

    # 真实标签:one-hot编码,真实类别是猫
    y_true = np.array([1, 0, 0])

    # 3. 不同模型的预测概率
    predictions = {
        '好模型': np.array([0.9, 0.08, 0.02]),
        '一般模型': np.array([0.60, 0.25, 0.15]),
        '差模型': np.array([0.4, 0.3, 0.3]),
        '烂模型': np.array([0.05, 0.25, 0.70])
    }

    # 4. 计算各模型的损失
    print("多分类交叉熵损失计算示例")
    print("真实标签: 猫 [1, 0, 0]")
    print("-" * 50)

    results = {}
    for name, pred in predictions.items():
        loss = categorical_cross_entropy(y_true, pred)
        results[name] = loss
        print(f"{name}:")
        print(f"  预测概率: {pred}")
        print(f"  损失值: {loss:.4f}")
        print(f"  对真实类别'猫'的预测概率: {pred[0]:.2f}")
        print()

    # 5. 可视化不同预测的损失
    plt.figure(figsize=(12, 8))

    # 子图1:各模型损失对比
    plt.subplot(2, 2, 1)
    names = list(results.keys())
    losses = list(results.values())
    bars = plt.bar(names, losses, color=['green', 'orange', 'red', 'darkred'])
    plt.ylabel('交叉熵损失')
    plt.title('不同模型预测的损失对比')

    # 在柱状图上显示数值
    for bar, loss in zip(bars, losses):
        plt.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.05,
                f'{loss:.3f}', ha='center', va='bottom')

    # 子图2:预测概率分布
    plt.subplot(2, 2, 2)
    x = np.arange(len(classes))
    width = 0.2

    for i, (name, pred) in enumerate(predictions.items()):
        plt.bar(x + i*width, pred, width, label=name)

    plt.xlabel('类别')
    plt.ylabel('预测概率')
    plt.title('各模型的预测概率分布')
    plt.xticks(x + width*1.5, classes)
    plt.legend()
    plt.ylim(0, 1)

    # 子图3:真实类别预测概率与损失的关系
    plt.subplot(2, 2, 3)
    true_class_probs = [pred[0] for pred in predictions.values()]
    plt.scatter(true_class_probs, losses, s=100, c=losses, cmap='Reds_r')

    for i, (name, prob, loss) in enumerate(zip(names, true_class_probs, losses)):
        plt.annotate(name, (prob, loss), xytext=(5, 5),
                    textcoords='offset points', fontsize=9)

    plt.xlabel("对真实类别'猫'的预测概率")
    plt.ylabel('交叉熵损失')
    plt.title('真实类别概率 vs 损失')
    plt.grid(True, alpha=0.3)

    # 子图4:损失函数曲线(针对真实类别)
    plt.subplot(2, 2, 4)
    p_cat = np.linspace(0.01, 0.99, 100)
    loss_curve = -np.log(p_cat)
    plt.plot(p_cat, loss_curve, 'purple', linewidth=2)
    plt.xlabel("对真实类别'猫'的预测概率")
    plt.ylabel('交叉熵损失')
    plt.title('多分类交叉熵损失曲线\nLoss = -log(p_true_class)')
    plt.grid(True, alpha=0.3)

    # 标记示例点
    for name, prob, loss in zip(names, true_class_probs, losses):
        plt.plot(prob, loss, 'o', markersize=8, label=name)

    plt.legend()

    plt.tight_layout()
    plt.show()
输出结果:
多分类交叉熵损失计算示例 真实标签: 猫 [1, 0, 0] -------------------------------------------------- 好模型: 预测概率: [0.9 0.08 0.02] 损失值: 0.1054 对真实类别'猫'的预测概率: 0.90 一般模型: 预测概率: [0.6 0.25 0.15] 损失值: 0.5108 对真实类别'猫'的预测概率: 0.60 差模型: 预测概率: [0.4 0.3 0.3] 损失值: 0.9163 对真实类别'猫'的预测概率: 0.40 烂模型: 预测概率: [0.05 0.25 0.7 ] 损失值: 2.9957 对真实类别'猫'的预测概率: 0.05
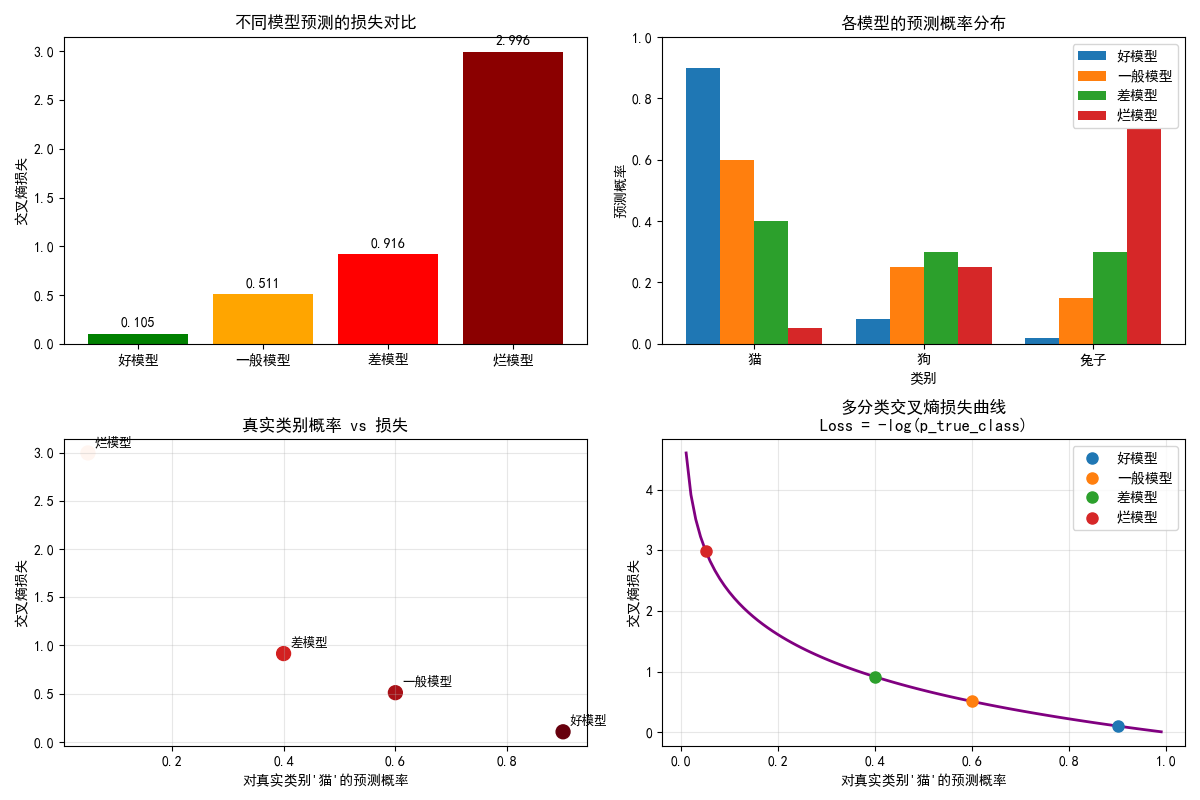
3. 对比总结
特性 | 二分类交叉熵损失 | 多分类交叉熵损失 |
|---|---|---|
适用问题 | 只有两个互斥类别的问题 | 两个及以上类别的问题 |
真实标签 y | 一个标量,0 或 1 | 一个向量,One-hot 编码(如 [1,0,0]) |
模型输出 p | 一个标量,表示正类的概率 | 一个向量,表示每个类别的概率,所有概率之和为1 |
核心公式 | - [y*log(p) + (1-y)*log(1-p)] | - Σ (y_i * log(p_i)) |
计算本质 | 一个开关公式,根据y选择计算 -log(p) 或 -log(1-p) | 一个求和公式,因One-hot编码,简化为 -log(p_k) |
惩罚对象 | 当y=1时,惩罚低的 p;当y=0时,惩罚高的 p | 只惩罚低的 p_k(k是真实类别) |
一个形象比喻:选择题考试
- 二分类:一道判断题。
- 我们知道模型只输出了一个概率,比如0.9,我们理解为“它90%认为答案是√”,损失函数会同时检查它对于“√”和“×”的判断是否合理。
- 多分类:一道单选题。
- 模型会为A、B、C、D四个选项都输出一个概率。
- 损失函数只看正确选项的概率是多少。如果正确选项的概率高,就给高分(低损失);如果正确选项的概率低,甚至错误选项的概率很高,就给低分(高损失)。
对比示例:
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn

# 设置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

def compare_binary_multiclass():
    """对比二分类和多分类交叉熵"""

    plt.figure(figsize=(14, 6))

    # 二分类损失曲线
    plt.subplot(1, 2, 1)
    p = np.linspace(0.01, 0.99, 100)
    loss_positive = -np.log(p)
    loss_negative = -np.log(1-p)

    plt.plot(p, loss_positive, 'b-', linewidth=2, label='正样本 (y=1): -log(p)')
    plt.plot(p, loss_negative, 'r-', linewidth=2, label='负样本 (y=0): -log(1-p)')
    plt.xlabel('预测概率 p')
    plt.ylabel('损失值')
    plt.title('二分类交叉熵损失\n自动选择计算路径')
    plt.legend()
    plt.grid(True, alpha=0.3)

    # 多分类损失曲线(针对真实类别)
    plt.subplot(1, 2, 2)
    p_true = np.linspace(0.01, 0.99, 100)
    loss_multiclass = -np.log(p_true)

    plt.plot(p_true, loss_multiclass, 'purple', linewidth=2)
    plt.xlabel('对真实类别的预测概率')
    plt.ylabel('损失值')
    plt.title('多分类交叉熵损失\nLoss = -log(p_true_class)')
    plt.grid(True, alpha=0.3)

    # 添加说明文本
    plt.figtext(0.1, 0.02,
                "二分类特点: 根据真实标签自动选择计算 -log(p) 或 -log(1-p)\n"
                "多分类特点: 由于one-hot编码,只计算真实类别的 -log(p_true_class)",
                fontsize=11, ha='left')

    plt.tight_layout(rect=[0, 0.1, 1, 0.99])
    plt.show()

# 运行对比演示
compare_binary_multiclass()
输出图片:
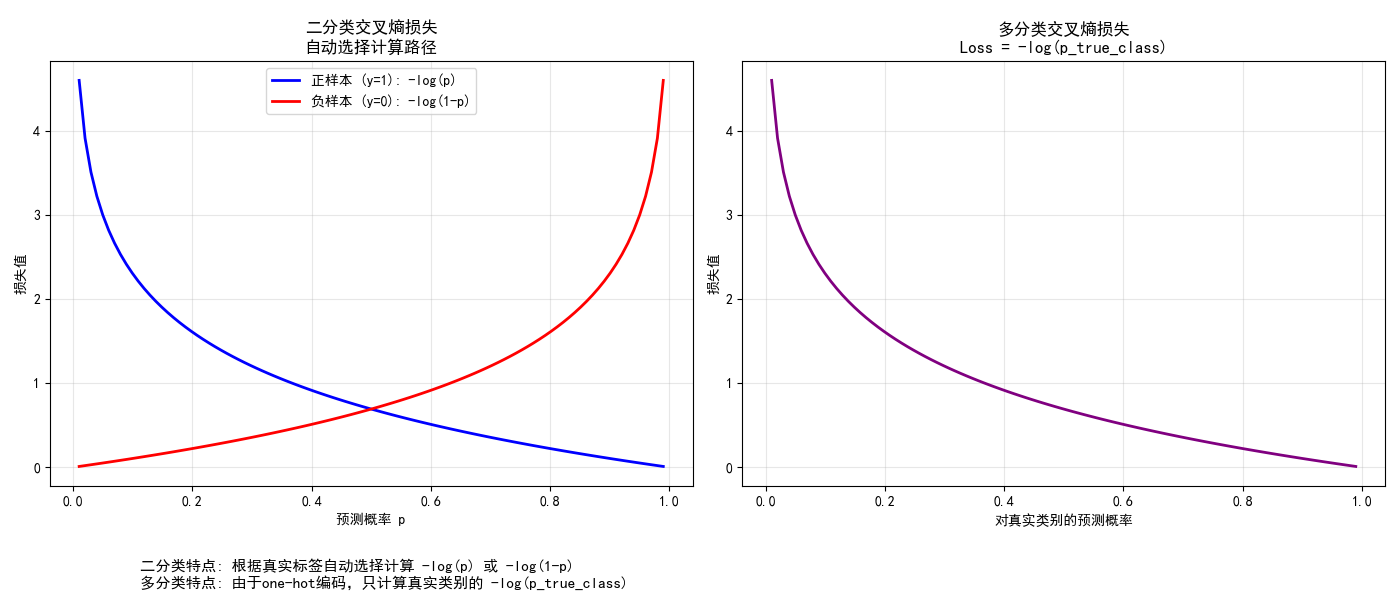
五、总结
损失函数是模型的评判官和指南针,它用一个数字来量化模型的错误程度。它为模型的自我优化提供了唯一可量化的目标。没有损失函数,模型就无法学习,就像轮船在海上失去了罗盘。它的设计直接决定了模型学习的方向和最终效果。一个好的损失函数,能让模型快速、稳定地学到真本事;一个糟糕的损失函数,则会引导模型误入歧途。
经过多阶段的接触,深刻的意识到,训练一个AI模型,就像雕刻一块大理石胚,损失函数像一个测量工具,越大的石头,越是精雕细琢,慢工出细活,逐步调优,凿掉不需要的部分,经过千锤百炼,最终,一个精美的雕像就诞生了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号