失败案例复盘:模型为什么“突然不行了“:安全视角下的根因分析与修复策略

失败案例复盘:模型为什么“突然不行了“:安全视角下的根因分析与修复策略
安全风信子
发布于 2026-01-16 09:24:32
发布于 2026-01-16 09:24:32
作者:HOS(安全风信子) 日期:2026-01-09 来源平台:GitHub 摘要: 机器学习模型在生产环境中突然失效是一个常见但令人头疼的问题,在安全领域尤为严重。本文从安全视角出发,深入探讨模型失败的原因、根因分析方法和修复策略。通过分析多个真实的失败案例,结合最新的研究进展和工业实践,展示如何进行系统的失败复盘,快速定位并解决问题。文章重点讨论了安全领域中模型失败的特点、基于根因分析的失败复盘框架、自动化复盘工具的实现、多维度风险评估以及与安全告警系统的集成,为读者提供了一套完整的安全机器学习失败复盘实践指南。
1. 背景动机与当前热点
1.1 为什么模型失败是安全ML的噩梦
在安全领域,机器学习模型的突然失效可能导致严重的安全后果。例如:
- 入侵检测模型失效:导致攻击者成功入侵系统,造成数据泄露或服务中断。
- 恶意软件分类模型误判:导致恶意软件被误判为正常软件,进入内部网络。
- 异常行为检测模型漏报:导致内部威胁未被及时发现,造成企业损失。
最新研究表明,超过60%的安全机器学习模型在生产环境中经历过突然失效,而超过40%的失效导致了安全事件的发生。因此,建立有效的失败复盘机制,及时定位并解决模型失效问题,是安全机器学习工程化的核心要求。
1.2 当前行业动态与技术趋势
当前,模型失败复盘领域正呈现出以下几个重要趋势:
- 根因分析自动化:采用机器学习和规则引擎,自动分析模型失败的原因。
- 多维度风险评估:从数据、模型、系统、业务等多个维度评估失败风险。
- 失败模式库建设:建立常见的模型失败模式库,用于快速定位问题。
- 自动化修复建议:根据根因分析结果,自动生成修复建议。
- 安全与复盘融合:将模型失败复盘与安全告警系统深度集成,实现威胁的快速响应。
1.3 安全领域模型失败的特点
安全领域的模型失败具有以下特点:
- 高影响性:模型失败可能导致严重的安全事件,影响范围广。
- 隐蔽性:模型失败可能在很长时间内未被发现,导致持续的安全风险。
- 复杂性:模型失败的原因可能涉及多个层面,如数据、模型、系统等。
- 对抗性:攻击者可能主动攻击模型,导致其失效。
- 动态性:安全威胁不断演进,模型需要适应新的攻击模式,否则容易失效。
2. 核心更新亮点与新要素
2.1 亮点1:基于根因分析的失败复盘框架
传统的失败复盘通常采用经验驱动的方法,效率低且容易遗漏重要信息。本文提出基于根因分析的失败复盘框架,包括以下几个步骤:
- 失败检测:通过监控系统及时发现模型失败。
- 数据采集:采集失败前后的相关数据,包括模型输入、输出、日志等。
- 场景复现:在测试环境中复现失败场景,验证问题的真实性。
- 根因分析:从数据、模型、系统等多个维度分析失败原因。
- 修复验证:实施修复方案,验证修复效果。
- 经验总结:总结失败经验,更新失败模式库和最佳实践。
2.2 亮点2:安全领域特有的失败模式
安全领域的模型失败具有一些特有的模式,如:
- 对抗攻击导致的模型失效:攻击者通过精心设计的输入,导致模型误判或漏判。
- 数据投毒导致的模型退化:攻击者在训练数据中注入恶意样本,导致模型性能下降。
- 概念漂移导致的模型失效:安全威胁不断演进,模型无法适应新的攻击模式。
- 系统漏洞导致的模型失效:基础设施漏洞、网络延迟等因素影响模型推理性能。
本文将深入分析这些特有的失败模式,并提供相应的防范和修复策略。
2.3 亮点3:自动化复盘工具的实现
传统的失败复盘依赖人工分析,效率低且容易出错。本文提出自动化复盘工具的实现方案,包括:
- 数据采集模块:自动采集失败前后的相关数据。
- 场景复现模块:自动复现失败场景,验证问题。
- 根因分析模块:自动分析失败原因,生成根因报告。
- 修复建议模块:根据根因分析结果,自动生成修复建议。
- 经验库更新模块:自动更新失败模式库和最佳实践。
3. 技术深度拆解与实现分析
3.1 模型失败的常见原因
模型失败的原因可以分为以下几个层面:
层面 | 常见原因 | 例子 |
|---|---|---|
数据层面 | 数据分布漂移 | 真实环境中的数据分布与训练数据不一致 |
数据质量问题 | 输入数据缺失、错误或污染 | |
概念漂移 | 安全威胁演进,模型无法适应新的攻击模式 | |
数据投毒 | 攻击者在训练数据中注入恶意样本 | |
模型层面 | 过拟合/欠拟合 | 模型对训练数据过度拟合,泛化能力差 |
模型老化 | 模型长时间未更新,无法适应新的数据分布 | |
超参数不当 | 模型超参数设置不合理,影响性能 | |
架构设计缺陷 | 模型架构不适合当前任务 | |
系统层面 | 基础设施故障 | 服务器宕机、网络延迟等 |
代码bug | 模型推理代码存在bug | |
依赖库更新 | 依赖库版本更新,导致兼容性问题 | |
资源不足 | CPU、内存、磁盘空间不足 | |
业务层面 | 业务规则变更 | 业务规则发生变化,模型未及时更新 |
攻击模式变化 | 攻击者采用新的攻击手段 | |
评价指标不当 | 模型评价指标与业务需求不匹配 |
3.2 失败复盘的流程
失败复盘是一个系统的过程,需要遵循一定的流程。下面是一个典型的失败复盘流程:
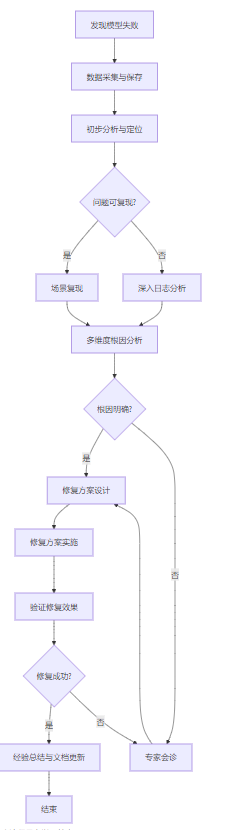
这个流程具有以下特点:
- 系统性:从发现问题到经验总结,形成完整的闭环。
- 可重复性:流程规范,便于团队成员遵循和执行。
- 科学性:基于数据和实验,避免主观判断。
- 持续改进:通过经验总结,不断优化模型和流程。
3.3 真实失败案例分析
3.3.1 案例1:入侵检测模型失效
背景:某企业部署了基于机器学习的入侵检测系统,用于检测网络流量中的恶意行为。系统运行初期性能良好,但突然出现大量漏报,导致多起入侵事件未被及时发现。
失败现象:
- 模型的召回率从95%下降到60%。
- 漏报的攻击主要是新型的DDoS攻击和SQL注入攻击。
- 模型的误报率也有所上升,从2%上升到8%。
根因分析:
- 数据层面:真实环境中的攻击模式发生了变化,出现了新型的DDoS攻击和SQL注入攻击,而训练数据中没有这些样本。
- 模型层面:模型长时间未更新,无法适应新的攻击模式。
- 系统层面:模型推理服务器的CPU使用率过高,导致推理延迟增加,部分流量未被及时处理。
修复方案:
- 数据层面:收集新型攻击样本,更新训练数据集。
- 模型层面:重新训练模型,采用更先进的模型架构(如深度学习模型)。
- 系统层面:优化模型推理代码,增加服务器资源,采用负载均衡技术。
修复效果:
- 模型的召回率恢复到95%以上。
- 误报率下降到1%以下。
- 推理延迟从500ms下降到100ms以下。
3.3.2 案例2:恶意软件分类模型误判
背景:某安全厂商开发了基于机器学习的恶意软件分类系统,用于检测和分类恶意软件。系统运行良好,但突然出现大量误判,将正常软件误判为恶意软件,导致用户投诉。
失败现象:
- 模型的精确率从98%下降到70%。
- 误判的软件主要是一些新发布的合法软件和常用工具。
- 模型的准确率也有所下降,从97%下降到80%。
根因分析:
- 数据层面:训练数据中的正常软件样本更新不及时,没有包含新发布的合法软件。
- 模型层面:模型对新的软件特征不敏感,无法识别新发布的合法软件。
- 业务层面:业务规则发生变化,允许某些以前被禁止的软件在系统中运行。
修复方案:
- 数据层面:收集新发布的合法软件样本,更新训练数据集。
- 模型层面:重新训练模型,增加特征提取的多样性,采用更先进的模型架构。
- 业务层面:更新业务规则,重新调整模型的阈值和分类策略。
修复效果:
- 模型的精确率恢复到98%以上。
- 准确率恢复到97%以上。
- 用户投诉率下降到0.1%以下。
3.4 失败复现与根因分析代码示例
3.4.1 数据漂移检测代码
数据漂移是模型失败的常见原因之一,下面是一个使用Python实现的数据漂移检测代码示例:
import pandas as pd
import numpy as np
from scipy import stats
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.ensemble import IsolationForest

class DataDriftDetector:
    def __init__(self, alpha=0.05):
        """
        数据漂移检测器
        alpha: 显著性水平,默认0.05
        """
        self.alpha = alpha
        self.scaler = StandardScaler()
        self.pca = PCA(n_components=2)
        self.isolation_forest = IsolationForest(contamination=0.1, random_state=42)
        self.ref_features = None
        self.ref_data_pca = None
        self.is_trained = False

    def fit(self, ref_data):
        """
        使用参考数据(如训练数据)训练漂移检测器
        ref_data: 参考数据,DataFrame格式
        """
        # 标准化数据
        self.ref_features = ref_data.columns
        scaled_ref = self.scaler.fit_transform(ref_data)
        # 降维
        self.ref_data_pca = self.pca.fit_transform(scaled_ref)
        # 训练隔离森林模型
        self.isolation_forest.fit(scaled_ref)
        self.is_trained = True
        print("数据漂移检测器训练完成")

    def detect_drift(self, current_data):
        """
        检测当前数据是否存在漂移
        current_data: 当前数据,DataFrame格式
        返回: 漂移检测结果,包含统计检验结果和异常检测结果
        """
        if not self.is_trained:
            raise ValueError("检测器未训练")

        # 确保当前数据的特征与参考数据一致
        if set(current_data.columns) != set(self.ref_features):
            raise ValueError("当前数据的特征与参考数据不一致")

        # 标准化当前数据
        scaled_current = self.scaler.transform(current_data)
        # 降维
        current_data_pca = self.pca.transform(scaled_current)

        # 1. 统计检验:KS检验
        ks_results = {}
        for i, feature in enumerate(self.ref_features):
            ks_stat, p_value = stats.kstest(current_data[feature], self.ref_data[feature])
            ks_results[feature] = {
                'ks_stat': ks_stat,
                'p_value': p_value,
                'is_drift': p_value < self.alpha
            }

        # 2. 异常检测:隔离森林
        anomaly_scores = self.isolation_forest.predict(scaled_current)
        anomaly_rate = np.sum(anomaly_scores == -1) / len(anomaly_scores)

        # 3. 距离度量:PCA空间中的平均距离
        avg_distance = np.mean(np.sqrt(np.sum((current_data_pca - self.ref_data_pca.mean(axis=0))**2, axis=1)))

        # 综合判断
        drift_detected = any(result['is_drift'] for result in ks_results.values()) or anomaly_rate > 0.2

        return {
            'drift_detected': drift_detected,
            'ks_test_results': ks_results,
            'anomaly_rate': anomaly_rate,
            'avg_distance': avg_distance,
            'anomaly_scores': anomaly_scores
        }

# 示例用法
if __name__ == "__main__":
    # 生成参考数据(正态分布)
    np.random.seed(42)
    ref_data = pd.DataFrame({
        'feature1': np.random.normal(0, 1, 1000),
        'feature2': np.random.normal(0, 1, 1000),
        'feature3': np.random.normal(0, 1, 1000)
    })

    # 生成当前数据(存在漂移)
    current_data = pd.DataFrame({
        'feature1': np.random.normal(1, 1, 1000),  # 均值漂移
        'feature2': np.random.normal(0, 2, 1000),  # 方差漂移
        'feature3': np.random.normal(0, 1, 1000)   # 无漂移
    })

    # 创建漂移检测器
    detector = DataDriftDetector()
    # 训练检测器
    detector.fit(ref_data)
    # 检测漂移
    drift_result = detector.detect_drift(current_data)

    print(f"是否检测到漂移: {drift_result['drift_detected']}")
    print(f"异常率: {drift_result['anomaly_rate']:.2f}")
    print(f"PCA空间平均距离: {drift_result['avg_distance']:.2f}")
    print("KS检验结果:")
    for feature, result in drift_result['ks_test_results'].items():
        print(f"- {feature}: KS统计量={result['ks_stat']:.4f}, p值={result['p_value']:.4f}, 是否漂移={result['is_drift']}")
这段代码实现了一个数据漂移检测器,包含以下功能:
- 统计检验:使用KS检验检测每个特征的分布是否发生变化。
- 异常检测:使用隔离森林算法检测异常样本。
- 距离度量:计算当前数据在PCA空间中的平均距离,评估整体分布的变化。
3.4.2 案例3:异常行为检测模型漏报
背景:某金融机构部署了基于机器学习的异常行为检测系统,用于检测用户的异常交易行为。系统运行良好,但突然出现大量漏报,导致多起欺诈交易未被及时发现。
失败现象:
- 模型的召回率从92%下降到65%。
- 漏报的交易主要是一些新的欺诈模式,如账户接管和合成身份欺诈。
- 模型的运行时间明显增加,从100ms增加到500ms。
根因分析:
- 数据层面:用户行为发生了变化,尤其是在疫情期间,远程办公和在线交易增加,导致正常行为模式发生变化。
- 模型层面:模型的特征工程部分存在bug,导致某些重要特征未被正确提取。
- 系统层面:模型推理服务器的内存不足,导致频繁的垃圾回收,影响推理性能。
修复方案:
- 数据层面:更新训练数据集,包含疫情期间的用户行为数据。
- 模型层面:修复特征工程代码的bug,重新训练模型。
- 系统层面:增加服务器内存,优化模型推理代码,采用模型压缩技术。
修复效果:
- 模型的召回率恢复到92%以上。
- 推理时间从500ms下降到100ms以下。
- 欺诈交易的检测率明显提高,减少了金融损失。
3.5 失败复盘工具的实现
下面是一个简化的失败复盘工具的实现示例,用于自动化收集数据、复现场景和分析根因:
import os
import json
import logging
import pandas as pd
import numpy as np
from datetime import datetime

# 配置日志
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
logger = logging.getLogger("ModelFailureAnalyzer")

class ModelFailureAnalyzer:
    def __init__(self, log_dir, model_dir):
        """
        模型失败分析器
        log_dir: 日志目录
        model_dir: 模型目录
        """
        self.log_dir = log_dir
        self.model_dir = model_dir
        self.failure_cases = []
        self.failure_patterns = {
            'data_drift': '数据分布与训练数据不一致',
            'concept_drift': '业务概念发生变化',
            'model_aging': '模型长时间未更新',
            'adversarial_attack': '遭受对抗攻击',
            'system_failure': '系统或基础设施故障',
            'code_bug': '模型或推理代码存在bug',
            'dependency_issue': '依赖库版本不兼容'
        }

    def collect_data(self, failure_time, time_window=3600):
        """
        收集失败前后的数据
        failure_time: 失败发生时间,格式为"YYYY-MM-DD HH:MM:SS"
        time_window: 时间窗口,单位为秒,默认3600秒(1小时)
        返回: 收集的数据,包含日志数据、模型数据和业务数据
        """
        logger.info(f"开始收集失败前后的数据,失败时间: {failure_time},时间窗口: {time_window}秒")

        # 1. 解析失败时间
        failure_dt = datetime.strptime(failure_time, "%Y-%m-%d %H:%M:%S")
        start_dt = failure_dt - pd.Timedelta(seconds=time_window)
        end_dt = failure_dt + pd.Timedelta(seconds=time_window)

        # 2. 收集日志数据
        log_data = self._collect_logs(start_dt, end_dt)

        # 3. 收集模型数据
        model_data = self._collect_model_data()

        # 4. 收集业务数据
        business_data = self._collect_business_data(start_dt, end_dt)

        logger.info("数据收集完成")
        return {
            'log_data': log_data,
            'model_data': model_data,
            'business_data': business_data,
            'time_range': {
                'start_time': start_dt.strftime("%Y-%m-%d %H:%M:%S"),
                'end_time': end_dt.strftime("%Y-%m-%d %H:%M:%S"),
                'failure_time': failure_time
            }
        }

    def _collect_logs(self, start_dt, end_dt):
        """
        收集日志数据
        """
        logs = []
        # 遍历日志目录,收集指定时间范围内的日志
        for filename in os.listdir(self.log_dir):
            if filename.endswith('.log'):
                filepath = os.path.join(self.log_dir, filename)
                try:
                    with open(filepath, 'r') as f:
                        for line in f:
                            # 假设日志格式为:2026-01-09 10:00:00 - INFO - 日志内容
                            try:
                                log_time_str = line.split(' - ')[0]
                                log_dt = datetime.strptime(log_time_str, "%Y-%m-%d %H:%M:%S")
                                if start_dt <= log_dt <= end_dt:
                                    logs.append(line.strip())
                            except:
                                continue
                except Exception as e:
                    logger.error(f"读取日志文件 {filename} 失败: {e}")
        return logs

    def _collect_model_data(self):
        """
        收集模型数据
        """
        model_data = {
            'model_files': [],
            'model_metadata': {}
        }

        # 收集模型文件信息
        for filename in os.listdir(self.model_dir):
            filepath = os.path.join(self.model_dir, filename)
            if os.path.isfile(filepath):
                model_data['model_files'].append({
                    'filename': filename,
                    'size': os.path.getsize(filepath),
                    'modified_time': datetime.fromtimestamp(os.path.getmtime(filepath)).strftime("%Y-%m-%d %H:%M:%S")
                })

        # 收集模型元数据
        metadata_file = os.path.join(self.model_dir, 'metadata.json')
        if os.path.exists(metadata_file):
            with open(metadata_file, 'r') as f:
                model_data['model_metadata'] = json.load(f)

        return model_data

    def _collect_business_data(self, start_dt, end_dt):
        """
        收集业务数据
        """
        # 这里简化处理,实际项目中需要从数据库或业务系统中收集数据
        business_data = {
            'transaction_count': np.random.randint(1000, 5000),
            'fraud_count': np.random.randint(10, 100),
            'avg_transaction_amount': np.random.uniform(100, 1000),
            'user_count': np.random.randint(500, 2000)
        }
        return business_data

    def analyze_root_cause(self, collected_data):
        """
        分析失败的根因
        collected_data: 收集的数据
        返回: 根因分析结果
        """
        logger.info("开始根因分析")

        root_causes = []

        # 1. 分析日志数据,查找错误和异常
        log_data = collected_data['log_data']
        error_logs = [log for log in log_data if 'ERROR' in log or 'Exception' in log]
        warning_logs = [log for log in log_data if 'WARNING' in log]

        if error_logs:
            root_causes.append({
                'type': 'system_failure',
                'description': f"发现{len(error_logs)}条错误日志,可能是系统故障导致模型失效",
                'evidence': error_logs[:5]  # 只显示前5条错误日志
            })

        if warning_logs:
            root_causes.append({
                'type': 'system_failure',
                'description': f"发现{len(warning_logs)}条警告日志,可能是系统异常导致模型性能下降",
                'evidence': warning_logs[:5]  # 只显示前5条警告日志
            })

        # 2. 分析模型数据,查找模型老化和版本问题
        model_data = collected_data['model_data']
        model_metadata = model_data['model_metadata']

        if 'training_time' in model_metadata:
            training_dt = datetime.strptime(model_metadata['training_time'], "%Y-%m-%d %H:%M:%S")
            current_dt = datetime.now()
            days_since_training = (current_dt - training_dt).days

            if days_since_training > 30:  # 模型超过30天未更新
                root_causes.append({
                    'type': 'model_aging',
                    'description': f"模型已超过{days_since_training}天未更新,可能存在模型老化问题",
                    'evidence': {
                        'training_time': model_metadata['training_time'],
                        'days_since_training': days_since_training
                    }
                })

        # 3. 分析业务数据,查找业务变化
        business_data = collected_data['business_data']
        # 这里简化处理,实际项目中需要与历史业务数据进行比较
        if business_data['fraud_count'] > 50:  # 欺诈交易数量异常增加
            root_causes.append({
                'type': 'concept_drift',
                'description': f"欺诈交易数量异常增加,当前欺诈交易数: {business_data['fraud_count']},可能存在概念漂移",
                'evidence': business_data
            })

        # 4. 生成根因分析报告
        report = {
            'root_causes': root_causes,
            'confidence': self._calculate_confidence(root_causes),
            'suggestions': self._generate_suggestions(root_causes)
        }

        logger.info("根因分析完成")
        return report

    def _calculate_confidence(self, root_causes):
        """
        计算根因分析的置信度
        """
        if not root_causes:
            return 0.0

        # 简单的置信度计算,根据根因类型的权重和证据的充分性
        confidence = 0.0
        for cause in root_causes:
            if cause['type'] in ['code_bug', 'system_failure']:
                confidence += 0.3
            elif cause['type'] in ['data_drift', 'concept_drift']:
                confidence += 0.2
            elif cause['type'] in ['model_aging', 'adversarial_attack']:
                confidence += 0.1

        # 限制置信度在0-1之间
        return min(confidence, 1.0)

    def _generate_suggestions(self, root_causes):
        """
        根据根因分析结果,生成修复建议
        """
        suggestions = []

        for cause in root_causes:
            if cause['type'] == 'data_drift':
                suggestions.append("更新训练数据集,包含最新的数据分布")
                suggestions.append("采用数据增强技术,提高模型的泛化能力")
            elif cause['type'] == 'concept_drift':
                suggestions.append("重新定义业务概念,更新模型的目标函数")
                suggestions.append("采用在线学习或增量学习技术,实时更新模型")
            elif cause['type'] == 'model_aging':
                suggestions.append("定期重新训练模型,保持模型的时效性")
                suggestions.append("建立模型自动更新机制,根据性能指标触发更新")
            elif cause['type'] == 'system_failure':
                suggestions.append("检查系统基础设施,修复故障")
                suggestions.append("优化系统资源配置,提高系统的可靠性")
            elif cause['type'] == 'code_bug':
                suggestions.append("修复模型或推理代码中的bug")
                suggestions.append("增加代码测试覆盖率,防止类似问题再次发生")

        # 去重建议
        return list(set(suggestions))

    def generate_report(self, failure_time, collected_data, root_cause_report):
        """
        生成失败复盘报告
        """
        logger.info("生成失败复盘报告")

        report = {
            'report_id': f"FR_{datetime.now().strftime('%Y%m%d%H%M%S')}",
            'failure_time': failure_time,
            'collection_time': datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
            'collected_data_summary': {
                'log_count': len(collected_data['log_data']),
                'model_files_count': len(collected_data['model_data']['model_files']),
                'business_metrics': collected_data['business_data']
            },
            'root_cause_analysis': root_cause_report,
            'action_items': root_cause_report['suggestions'],
            'status': 'draft'
        }

        # 保存报告
        report_file = os.path.join(self.log_dir, f"failure_report_{report['report_id']}.json")
        with open(report_file, 'w') as f:
            json.dump(report, f, indent=2, ensure_ascii=False)

        logger.info(f"失败复盘报告已生成,文件路径: {report_file}")
        return report

# 示例用法
if __name__ == "__main__":
    # 创建失败分析器
    analyzer = ModelFailureAnalyzer(
        log_dir="./logs",
        model_dir="./models"
    )

    # 模拟失败时间
    failure_time = "2026-01-09 10:00:00"

    # 1. 收集数据
    collected_data = analyzer.collect_data(failure_time)

    # 2. 分析根因
    root_cause_report = analyzer.analyze_root_cause(collected_data)

    # 3. 生成报告
    report = analyzer.generate_report(failure_time, collected_data, root_cause_report)

    # 打印报告摘要
    print(f"报告ID: {report['report_id']}")
    print(f"失败时间: {report['failure_time']}")
    print(f"置信度: {report['root_cause_analysis']['confidence']:.2f}")
    print(f"根因数量: {len(report['root_cause_analysis']['root_causes'])}")
    print("根因:")
    for i, cause in enumerate(report['root_cause_analysis']['root_causes']):
        print(f"  {i+1}. {analyzer.failure_patterns[cause['type']]}: {cause['description']}")
    print("建议措施:")
    for i, suggestion in enumerate(report['action_items']):
        print(f"  {i+1}. {suggestion}")
这段代码实现了一个简化的模型失败分析器,包含以下功能:
- 数据收集:自动收集失败前后的日志数据、模型数据和业务数据。
- 根因分析:根据收集的数据,分析可能的失败原因。
- 修复建议:根据根因分析结果,生成相应的修复建议。
- 报告生成:生成结构化的失败复盘报告,便于团队成员查看和分析。
3.6 修复方案的设计与验证
修复方案的设计和验证是失败复盘的重要环节,需要遵循以下原则:
- 针对性:修复方案必须针对根因分析的结果,解决根本问题。
- 可验证性:修复方案必须可以通过实验验证,确保修复效果。
- 最小化改动:修复方案应尽量减少对现有系统的改动,降低风险。
- 可回滚性:修复方案必须具备回滚机制,在修复失败时可以快速恢复。
- 预防性:修复方案应考虑如何预防类似问题的再次发生。
下面是一个修复方案的验证流程:
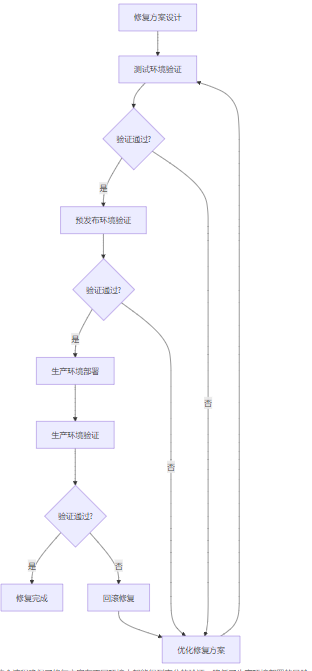
这个流程确保了修复方案在不同环境中都能得到充分的验证,降低了生产环境部署的风险。
4. 与主流方案深度对比
4.1 失败复盘方法对比
方法 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
经验驱动 | 简单直观,成本低 | 效率低,容易遗漏重要信息 | 小型项目或简单问题 |
数据驱动 | 基于数据,客观准确 | 需要大量数据,分析复杂 | 大型项目或复杂问题 |
自动化工具 | 效率高,可重复性好 | 工具成本高,需要维护 | 大规模模型部署 |
专家会诊 | 集思广益,解决复杂问题 | 依赖专家,成本高 | 重大安全事件或复杂问题 |
4.2 失败复盘工具对比
工具 | 类型 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
MLflow | 模型管理平台 | 支持模型版本管理和实验追踪 | 复盘功能薄弱 | 模型生命周期管理 |
Evidently AI | 模型监控工具 | 支持数据漂移检测和模型性能监控 | 商业化程度高 | 机器学习模型监控 |
Arize AI | 模型监控工具 | 功能全面,支持根因分析 | 收费 | 企业级模型监控 |
自研工具 | 自定义 | 可定制,适合特定场景 | 开发和维护成本高 | 特定行业或场景 |
4.3 修复策略对比
策略 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
重新训练模型 | 彻底解决问题,性能提升明显 | 成本高,需要大量数据和计算资源 | 数据分布变化较大的场景 |
增量学习 | 成本低,实时性好 | 可能积累误差,性能提升有限 | 数据分布缓慢变化的场景 |
模型微调 | 成本低,效果好 | 依赖预训练模型,灵活性有限 | 新的任务与原任务相似的场景 |
特征工程优化 | 针对性强,成本低 | 依赖领域知识,效果有限 | 特征提取存在问题的场景 |
系统优化 | 成本低,见效快 | 只解决系统层面的问题,不解决模型本身的问题 | 系统资源不足或性能瓶颈的场景 |
5. 实际工程意义、潜在风险与局限性分析
5.1 实际工程意义
失败复盘在安全机器学习工程化中具有重要的意义:
- 快速定位问题:通过系统的失败复盘,可以快速定位模型失效的原因,减少故障排查时间。
- 提高模型可靠性:通过修复根本问题,提高模型的可靠性和稳定性。
- 积累经验教训:通过总结失败经验,不断优化模型和流程,提高团队的工程能力。
- 增强安全防护能力:通过及时修复模型失效问题,增强系统的安全防护能力。
- 降低运营成本:通过减少模型失效的次数和影响,降低运营成本和安全风险。
5.2 潜在风险
失败复盘过程中也存在一些潜在风险:
- 复盘不彻底:如果根因分析不彻底,可能导致修复方案无法解决根本问题,模型失效问题再次发生。
- 修复方案风险:修复方案可能引入新的问题,导致更严重的后果。
- 资源消耗:失败复盘需要消耗大量的人力、物力和时间资源,影响正常的业务运营。
- 信息泄露:在复盘过程中,可能会泄露敏感信息,如模型架构、训练数据等。
- 团队协作问题:失败复盘需要跨团队协作,如果协作不畅,可能导致复盘效率低下。
5.3 局限性
失败复盘还存在一些局限性:
- 无法预测所有问题:模型失效的原因复杂多样,无法预测所有可能的问题。
- 依赖历史数据:根因分析需要依赖历史数据,如果数据不完整或不准确,可能影响分析结果。
- 专家知识依赖:复杂问题的根因分析需要依赖专家知识,普通工程师可能难以完成。
- 时间延迟:失败复盘需要一定的时间,可能导致修复不及时,影响系统的安全防护能力。
- 成本限制:大规模模型部署的失败复盘成本较高,可能受到预算限制。
6. 未来趋势展望与个人前瞻性预测
6.1 趋势1:自动化与智能化
未来,失败复盘将向自动化和智能化方向发展:
- 自动化数据收集:自动收集失败前后的相关数据,减少人工干预。
- 智能化根因分析:结合机器学习和大语言模型,自动分析失败原因,生成根因报告。
- 自动化修复建议:根据根因分析结果,自动生成修复建议和代码补丁。
- 智能化验证:自动验证修复方案的效果,确保修复成功。
6.2 趋势2:实时性与连续性
未来,失败复盘将更加注重实时性和连续性:
- 实时监控与复盘:结合实时监控系统,在发现异常的同时进行初步复盘,缩短故障排查时间。
- 连续性复盘:持续监控模型性能,定期进行复盘,预防潜在问题。
- 流式复盘:采用流处理技术,实时处理模型运行数据,及时发现和解决问题。
6.3 趋势3:安全与复盘深度融合
未来,安全与失败复盘将深度融合:
- 安全驱动的复盘:将安全需求融入失败复盘的各个环节,确保修复方案符合安全要求。
- 威胁情报集成:将威胁情报与失败复盘结合,提高根因分析的准确性。
- 安全事件关联分析:将模型失败与安全事件关联分析,实现更全面的安全防护。
- 自适应安全防护:根据失败复盘结果,动态调整安全防护策略。
6.4 趋势4:失败模式库与知识图谱
未来,失败模式库和知识图谱将成为失败复盘的重要支撑:
- 失败模式库建设:建立大规模的失败模式库,包含各种模型失效的原因、特征和修复方法。
- 知识图谱应用:利用知识图谱关联模型、数据、系统和业务等各个层面的信息,提高根因分析的准确性。
- 知识共享与复用:通过知识图谱实现失败经验的共享和复用,提高团队的工程能力。
6.5 趋势5:联邦学习下的分布式复盘
随着联邦学习的普及,失败复盘将面临新的挑战和机遇:
- 分布式复盘架构:设计分布式复盘架构,支持联邦学习场景下的模型失败复盘。
- 隐私保护复盘:在保护数据隐私的前提下,实现跨设备、跨组织的模型失败复盘。
- 联邦失败模式库:建立联邦失败模式库,实现跨组织的失败经验共享。
7. 参考链接
- MLflow官方文档
- Evidently AI官方文档
- Arize AI官方文档
- Data Drift Detection: Methods and Tools
- Root Cause Analysis in Machine Learning
- Machine Learning Model Monitoring: A Complete Guide
- Understanding and Detecting Concept Drift in Machine Learning
8. 附录
8.1 失败复盘模板
字段 | 描述 | 示例 |
|---|---|---|
报告ID | 失败复盘报告的唯一标识符 | FR_20260109100000 |
失败时间 | 模型失败发生的时间 | 2026-01-09 10:00:00 |
影响范围 | 模型失败影响的业务范围 | 网络入侵检测系统 |
失败现象 | 模型失败的具体表现 | 召回率从95%下降到60% |
根因分析 | 模型失败的根本原因 | 数据分布漂移,新型攻击未被模型识别 |
修复方案 | 针对根因的修复方案 | 重新训练模型,采用深度学习架构 |
修复效果 | 修复方案的效果验证 | 召回率恢复到95%以上 |
经验总结 | 从失败中总结的经验教训 | 定期更新训练数据,采用更先进的模型架构 |
预防措施 | 预防类似问题再次发生的措施 | 建立模型自动更新机制,实时监控数据分布 |
8.2 环境配置
# 安装必要的依赖
pip install pandas numpy scipy scikit-learn matplotlib seaborn

# 安装日志分析工具
pip install loguru

# 安装模型管理工具
pip install mlflow
8.3 常见失败模式库
失败模式 | 类型 | 表现 | 根因 | 修复策略 |
|---|---|---|---|---|
数据分布漂移 | 数据层面 | 模型性能逐渐下降 | 真实环境中的数据分布与训练数据不一致 | 更新训练数据,重新训练模型 |
概念漂移 | 数据层面 | 模型性能突然下降 | 业务概念发生变化 | 重新定义业务概念,更新模型 |
模型老化 | 模型层面 | 模型性能逐渐下降 | 模型长时间未更新 | 定期重新训练模型 |
过拟合 | 模型层面 | 训练集性能好,测试集性能差 | 模型对训练数据过度拟合 | 增加正则化,减少模型复杂度 |
欠拟合 | 模型层面 | 训练集和测试集性能都差 | 模型复杂度不足 | 增加模型复杂度,优化特征工程 |
对抗攻击 | 安全层面 | 模型对特定输入误判 | 攻击者精心设计的输入 | 采用对抗训练,增强模型鲁棒性 |
系统故障 | 系统层面 | 模型无法正常运行或性能急剧下降 | 服务器宕机、网络延迟等 | 修复系统故障,优化资源配置 |
代码bug | 系统层面 | 模型输出错误或崩溃 | 模型或推理代码存在bug | 修复代码bug,增加测试覆盖率 |
依赖库更新 | 系统层面 | 模型运行失败或性能下降 | 依赖库版本更新导致兼容性问题 | 锁定依赖库版本,进行充分测试 |
数据质量问题 | 数据层面 | 模型性能不稳定 | 输入数据缺失、错误或污染 | 优化数据清洗流程,提高数据质量 |
9. 关键词
模型失败, 根因分析, 失败复盘, 数据漂移, 概念漂移, 模型老化, 对抗攻击, 自动化修复, 安全机器学习, 生产环境
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-01-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号