从“写完就发”到发布前诊断:AI如何辅助小红书笔记决策
原创
从“写完就发”到发布前诊断:AI如何辅助小红书笔记决策
原创
用户11746101
修改于 2026-09-29 16:27:57
修改于 2026-09-29 16:27:57
一篇 UGC/PUGC/PGC 笔记完成后,创作者还要判断:内容是否清晰、是否适合当前账号、与同类内容相比有哪些差距,以及现在是否适合发布。这不是单纯的文案润色,而是同时处理内容、样本和时效性数据的决策问题。
热点和同类内容的表现会随时间变化,因此发布 `时间、标题、内容、话题` 都有可能影响笔记所处的竞争环境。
1. 问题定义:创作者难以客观看见自己的笔记
作者熟悉内容背景、重点和结论,阅读时会自动补齐文中没写出的信息;第一次看到笔记的用户却没有这些上下文。标题是否准确传达价值、封面能否让人理解主题、正文是否过早跳到结论,仅靠作者自检容易遗漏。
2. 为什么人工诊断成本高
完整的发布前检查,至少涉及四类信息:
- **相关热点检索**:搜索与笔记主题相关的近期话题,确认需求是否仍在发生。
- **当日榜单观察**:查看当天热搜或话题榜的变化,判断内容与当前讨论的关联,而不是机械追榜。
- **同类内容增量比较**:观察同主题笔记的新增数量及公开互动变化,识别竞争是否正在加剧。
- **账号适配检查**:比较笔记主题、表达方式与账号定位,避免只因话题热门就发布不匹配的内容。
人工逐篇搜索、筛选、记录和比较,耗时且难以保持一致口径。对于中小创作者和小团队,问题不只是“数据不够多”,还包括样本选择偏差、跨时间比较困难,以及无法把多个信号合成为可解释的决策依据。
3. 通过AI、量化、大数据技术处理流程
创作某书笔记并不是一件困难的事,难的还是流程化算法分析;AI可以代写笔记,但没有数据支持分析;基于这个痛点我创作了题火分析引擎🔥。其处理流程可概括为:
公开笔记与榜单信息 → 采集、去重、清洗与持续更新
↓
待发布笔记 → 内容解析与主题识别 → 同类样本检索
↓
指标比较与规则化分析
↓
AI 解释结果与发布建议
🔴数据层:建立可比较的样本
后台持续采集公开可见的笔记信息,包括标题、正文、话题和公开互动数据,并记录部分样本随时间变化的情况;相关热搜及榜单信息按可获得的更新周期维护。
🔴分析层:先找同类,再做量化比较
待诊断内容进入系统后,先识别主题与内容形式,再检索相关样本。题火将标题、正文结构、阅读体验、互动空间和内容辨识度等维度与同类样本进行比较,并结合热点、同类内容增量及账号定位分析发布条件。部分可直接计算的特征,例如标题或正文长度,可以与样本分布比较;语义和表达问题则由 AI 辅助解释。
🔴决策层:给出依据,而不是“爆款保证”
输出应回答三个问题:当前有哪些可观察的优势和风险、这些判断分别基于哪些样本或指标、发布前优先调整什么。建议可以是“先修改标题”“补充正文关键背景”“当前话题相关性较低,可观察后再发”,也可以是“现有证据不足,无法判断时机”。当账号信息、榜单或同类样本缺失时,系统应降低结论强度,不把缺失值当作零。
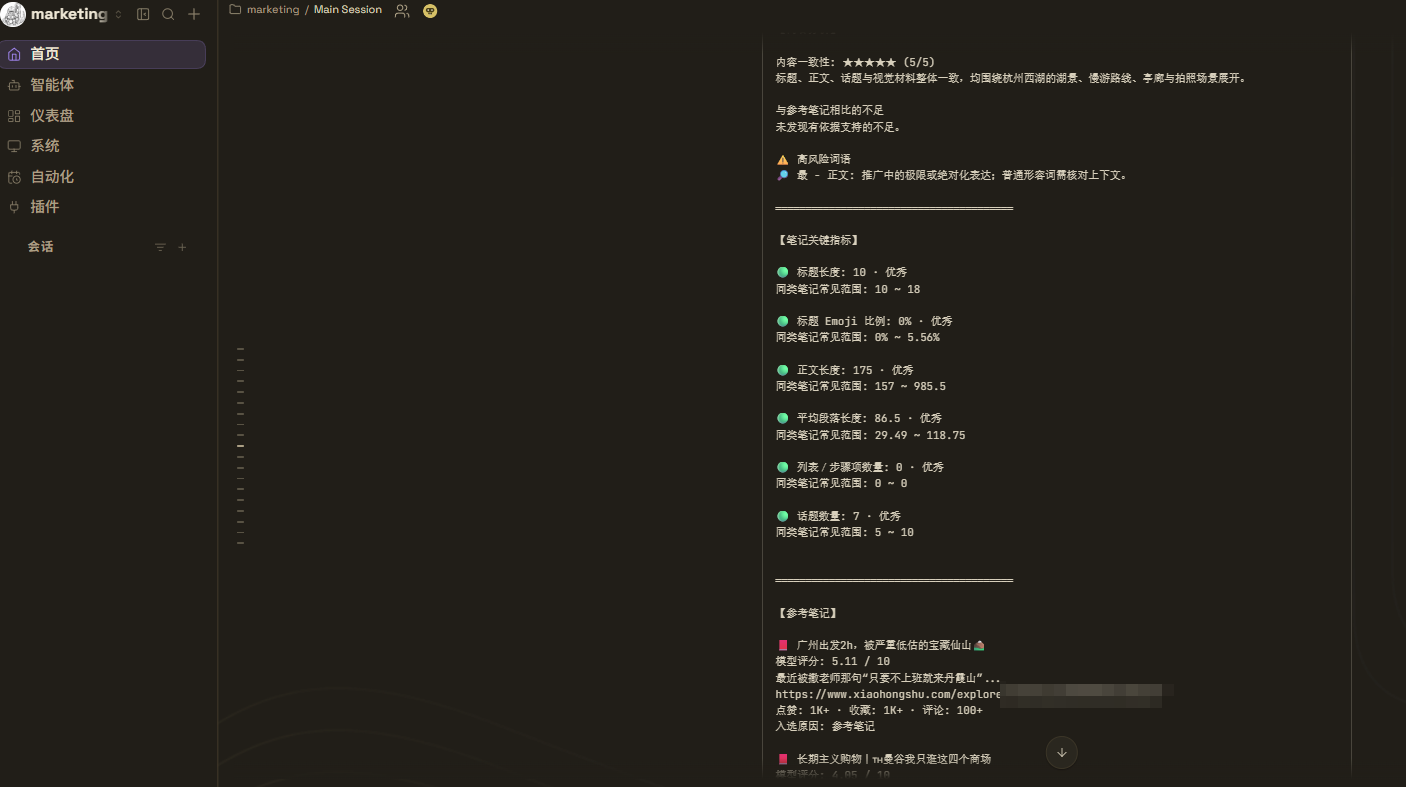
给出同类笔记实际URL,而不是AI不切实际地分析
4. 最后一点是易用性
- 我们希望能将诊断功能整合进我们自己的agent,目前题火完全可以做到这一点,一句话便可实现Skill安装🚀 。
- 如果没有agent,我能在线使用,题火同样可以做到这一点。
🔥题火已经开源到了github
https://github.com/mingzhizhiren/teeho
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号