别再手动整理工作台账了,这套 AI 流水线让我每天多出 2 小时
原创
别再手动整理工作台账了,这套 AI 流水线让我每天多出 2 小时
原创
大盘鸡拌面
发布于 2026-09-07 12:02:54
发布于 2026-09-07 12:02:54
先说个真事。上个月有天晚上七点多,我还在工位上对着三个 Excel 拖滚动条,旁边的钉钉还闪着——领导在群里问"这个月的台账什么时候能发我"。我当时脑子里只有一个念头:我今天一整天活儿干了七八件,结果全花在"把干过的活抄进表格"这件事上了。
我们部门有个规矩,工作台账每天一更新,月底汇总。听起来挺合理对吧?问题是这活儿落到实际操作上,就变成了每天下班前那四十分钟的酷刑——微信群里扒两条,钉钉审批里翻三条,邮箱里捞一条,再打开昨天的台账文件,看看格式是怎么写的,然后一行行敲进去。周末补台账更狠,一次性能搞掉我一个上午。
后来我实在受不了了,花了大概两个周末,把这套东西改成了一条半自动的流水线。现在的状态是:我每天只需要在随手记的地方敲一句话,剩下的归集、清洗、分类、出表全自动跑完,早上到工位打开文件夹,台账已经躺在那儿了。
省下来的时间我粗算过,一天差不多两小时——包括那四十分钟的填表,加上以前"回忆今天到底干了啥"的脑子空转,还有月底汇总那一整天的活儿摊到每个工作日。
这篇就把我这套东西从头到尾讲一遍,代码都给你,能直接抄。
一、先想清楚:台账这活儿,累在哪儿
我一开始也是直接上 AI,想着"让 AI 帮我整理台账不就完了",结果第一次试就废了——我丢给 AI 一堆乱七八糟的原文,它给我回了一份格式漂亮但内容全是废话的东西。
后来我坐下来把这件事拆了一遍,才发现台账压根不是"写"的问题,是三个更前面环节的问题:
第一,素材散。 我一天的工作痕迹散在至少五个地方:微信工作群、钉钉的审批和日程、邮件、本地那几个 Excel、还有我自己的备忘录。整理台账的第一步根本不是写,是"找"。我统计过,四十分钟里有差不多二十五分钟花在翻记录上。
第二,口径乱。 同一个事儿,我在微信里写"跟王哥说了一下发货的事",在 Excel 里又写"跟进供应商发货"。到月底汇总的时候,我得靠脑子判断这俩是不是一件事。三个来源一交叉,光对齐口径就够呛。
第三,分类烦。 台账要求每条都标分类(商品、供应链、售后、数据……)和重要度。这活儿不难,但特别耗神,因为它逼着你给每条琐事做一次判断。一天十几条,做十几判断,做着做着人就开始瞎标了——反正领导也不细看。
想明白这三点,我就有了方向:前两件事交给脚本,第三件事交给 AI,我只需要负责"记录"和"最后扫一眼"。
二、整条链路长什么样
先看全貌,这是我现在跑的流程:
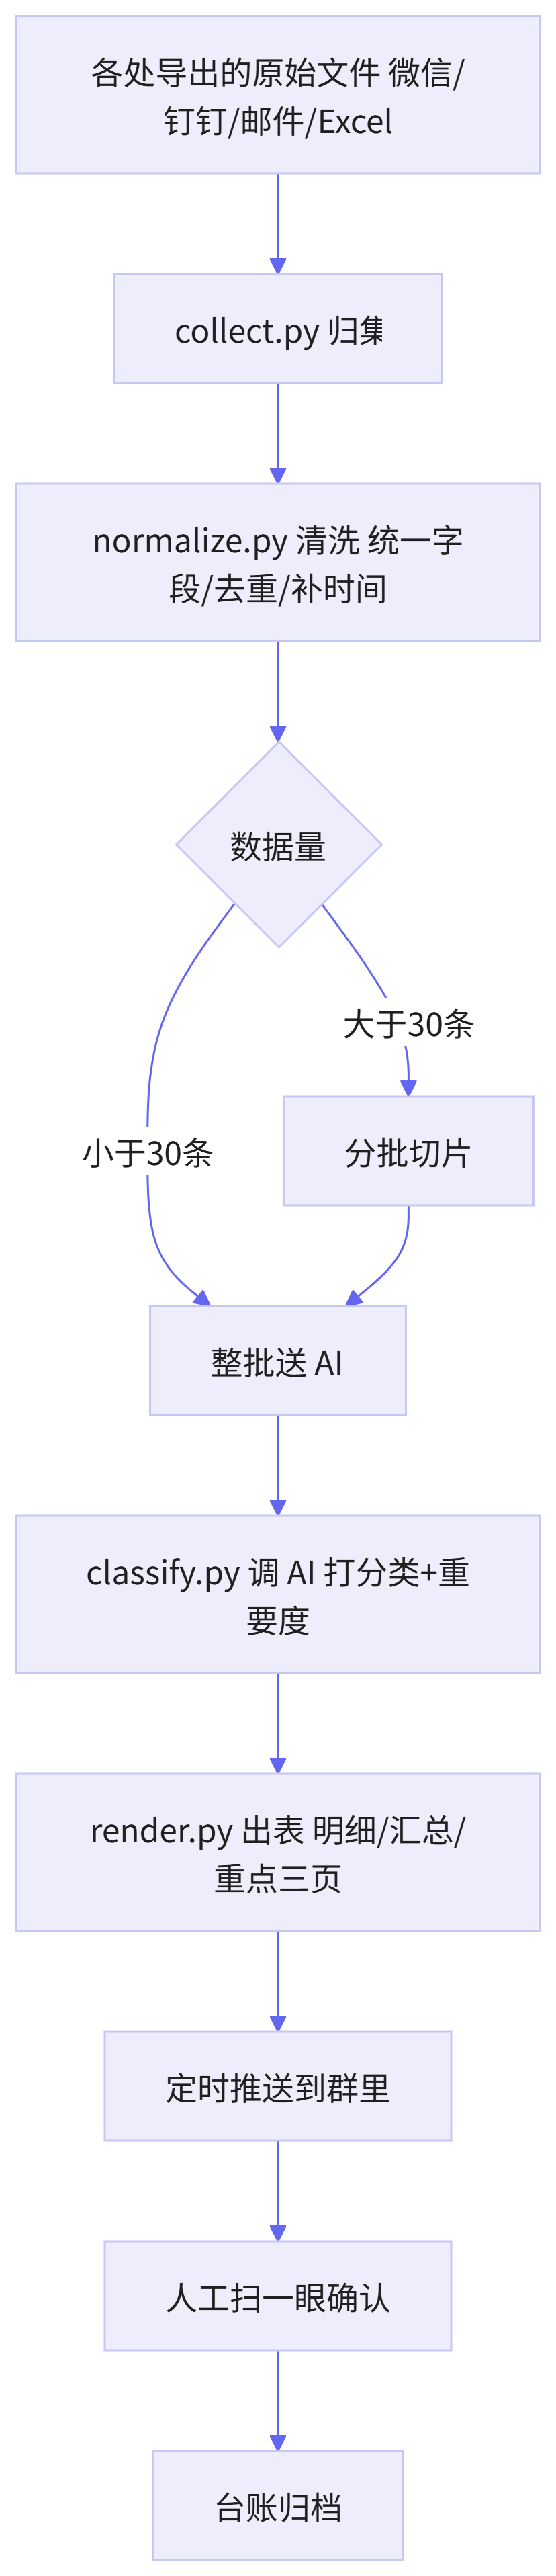
核心思路一句话:脚本负责脏活(搬运、对齐、去重),AI 负责需要"理解"的活(分类、判断重要度),人负责判断和兜底。
这里面有个我后来才体会到、但特别关键的点——不要让 AI 干它不擅长的事。让 AI 去重、对时间格式、匹配字段,它经常出错还慢;这些用 pandas 几行就完事了,而且百分之百准。反过来,让脚本去判断"这件事算不算重要",那基本没法写规则。各干各的,效率才上得去。
三、第一步:把散落的数据归到一块
我建了个文件夹叫 raw,规定自己——所有来源的文件,导出来直接扔进去,不用管格式、不用改名。这一步必须是零门槛的,因为只要有一点门槛,我就会偷懒,一偷懒数据就断了。
归集脚本很简单,就是遍历目录,按后缀读:
# collect.py —— 把 raw 目录下的所有表读成一个 DataFrame
import pandas as pd
from pathlib import Path

SOURCE_DIR = Path("./raw")

def load_all() -> pd.DataFrame:
    frames = []
    for f in SOURCE_DIR.iterdir():
        try:
            if f.suffix.lower() in (".xlsx", ".xls"):
                df = pd.read_excel(f)
            elif f.suffix.lower() == ".csv":
                df = pd.read_csv(f, encoding="utf-8-sig")
            else:
                continue
        except Exception as e:
            print(f"[跳过] {f.name} 读不了:{e}")
            continue
        df["__来源"] = f.name   # 留个来源标记,后面排查问题靠它
        frames.append(df)
        print(f"[读取] {f.name}  {len(df)} 行")

    if not frames:
        raise SystemExit("raw 目录里没有可用文件")
    return pd.concat(frames, ignore_index=True)

if __name__ == "__main__":
    raw = load_all()
    print(f"合计 {len(raw)} 条原始记录")
    raw.to_pickle("./cache/raw.pkl")
这里我特意加了 try/except 和来源标记。不是为了工程规范,是因为现实中导出的文件经常有合并单元格、有隐藏表、有奇奇怪怪的编码,你不拦住它,一个坏文件就能让整条流程挂掉,然后你就会觉得"这玩意不靠谱",然后就弃坑了。这种自己用的小工具,抗造比优雅重要。
四、第二步:清洗,这步最能省时间
清洗这块是我省时间最狠的地方。以前我对齐口径纯靠眼睛,现在一段脚本就干完了。
要处理的事情其实就四件:字段名各家不一样("事项"/"工作内容"/"描述"其实是一回事)、时间格式五花八门、有空行、有重复。
# normalize.py —— 统一口径、去重、排序
import re
import pandas as pd

def normalize(df: pd.DataFrame) -> pd.DataFrame:
    # 1. 字段名先统一:按关键字模糊映射到一套标准列名
    df = df.rename(columns=lambda c: str(c).strip())
    col_map = {}
    for c in df.columns:
        key = re.sub(r"[\s()()【】::]", "", c)
        if any(k in key for k in ("时间", "日期")):
            col_map[c] = "时间"
        elif any(k in key for k in ("事项", "内容", "描述", "摘要")):
            col_map[c] = "事项"
        elif "负责人" in key or ("人" in key and "创建" not in key):
            col_map[c] = "负责人"
        elif any(k in key for k in ("状态", "进度", "结果")):
            col_map[c] = "状态"
    df = df.rename(columns=col_map)

    # 2. 缺的列补空,保证后面不会 KeyError
    for c in ["时间", "事项", "负责人", "状态"]:
        if c not in df.columns:
            df[c] = ""

    # 3. 时间统一成 datetime,解析不了的(比如"上周")直接丢掉
    df["时间"] = pd.to_datetime(df["时间"], errors="coerce")
    before = len(df)
    df = df.dropna(subset=["时间"])
    print(f"时间解析失败丢掉 {before - len(df)} 条")

    # 4. 事项去空白、扔掉空行
    df["事项"] = df["事项"].astype(str).str.strip()
    df = df[df["事项"].str.len() > 1]

    # 5. 去重:同一时间同一件事同一个人,只留一条
    df = df.drop_duplicates(subset=["时间", "事项", "负责人"])

    return df[["时间", "事项", "负责人", "状态", "__来源"]] \
             .sort_values("时间").reset_index(drop=True)
第 5 步那个去重,直接把我月底汇总时最烦的一件事解决了。以前三个来源导出的东西,得靠肉眼找重复,现在一行搞定。
这里提醒一句:pd.to_datetime 那步可能会误伤。我们钉钉导出的表里有些时间写的是"昨天""上周五",这种解析出来是 NaT,会被丢掉。我现在的做法是导出的原始表里如果有这种口语化的时间,就在源头改成具体日期,别指望脚本救你。
五、第三步:让 AI 干它擅长的活
清洗完之后,数据已经很干净了,但还缺两个字段:分类和重要度。这俩就是 AI 的活。
先说提示词,这块我改了不下十版。最大的教训是——一定要给 AI 判断标准,不能只给分类列表。我最早写的提示词是"请给下面的工作记录分类",结果 AI 给我的重要度全是"中",等于没标。后来我把判断标准写进去,输出立刻就正常了。
# classify.py —— 调 AI 打分类和重要度
import os, json, time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("AI_API_KEY"),
    base_url=os.getenv("AI_BASE_URL"),   # 换成你自己用的服务地址
)

CATEGORIES = ["商品运营", "供应链", "客户与售后", "数据与报表", "会议与协同", "临时事务"]

PROMPT = """你是公司运营岗的老同事,熟悉业务口径。
下面是一批一天内的工作流水,请逐条打上分类和重要度。

【分类】只能从这几个里选:{cats}
【重要度】只能是三个值之一:高 / 中 / 低

判断重要度的标准:
- 高:涉及钱、客户、交付时间,或者领导大概率会追问的事
- 中:常规推进中的事项,做完了但还没结果
- 低:行政、通知、搬运、例行动作,丢了也没人问

注意:
- 宁可标中,不要乱标高。全是高的台账没有意义。
- 看不懂在说什么的,分类给"临时事务",重要度给"低"。

只输出 JSON 数组,不要任何解释文字,不要 markdown 代码块:
[{{"i": 0, "cat": "商品运营", "level": "高"}}]

流水:
{items}
"""

def classify_batch(items: list[str]) -> list[dict]:
    payload = "\n".join(f"{i}. {t}" for i, t in enumerate(items))
    resp = client.chat.completions.create(
        model=os.getenv("AI_MODEL", "gpt-4o-mini"),
        messages=[{"role": "user",
                   "content": PROMPT.format(cats="、".join(CATEGORIES), items=payload)}],
        temperature=0,
    )
    txt = resp.choices[0].message.content.strip()
    txt = txt.replace("```json", "").replace("```", "").strip()
    return json.loads(txt)
几个细节说一下:
temperature=0 是必须的。分类这活儿要的是稳定,不是创意。我一开始没设,同一批数据跑两次结果不一样,排查了半天。
输出格式我强制要求纯 JSON 数组,并且明确说了"不要 markdown 代码块"。但 AI 有时候还是会包一层 ```json,所以我又做了个字符串替换兜底。这种事不要相信它百分百听话,兜底一定要写。
还有一条,我在提示词里写了"宁可标中,不要乱标高"。这条是踩坑踩出来的——AI 天生倾向于"讨好"你,你不加限制,它会把一半的条目都标高,显得它很认真。台账要是全标"高",那这个字段就废了。
六、第四步:出表,三页搞定
输出的台账我做成三个 sheet:明细给归档,分类汇总给月底汇报,重点事项给领导看。以前这三页我是手工做的,现在一次性生成。
# render.py —— 生成最终台账 Excel
import pandas as pd

def render(df: pd.DataFrame, out_path: str):
    with pd.ExcelWriter(out_path, engine="openpyxl") as w:
        df.to_excel(w, sheet_name="明细", index=False)

        # 分类 × 重要度 的交叉汇总
        pivot = (df.pivot_table(index="分类", columns="重要度",
                                values="事项", aggfunc="count", fill_value=0)
                   .reset_index())
        pivot.to_excel(w, sheet_name="分类汇总", index=False)

        # 只留重点,按时间倒序,领导只看这页
        key = (df[df["重要度"] == "高"]
               .sort_values("时间", ascending=False))
        key.to_excel(w, sheet_name="重点事项", index=False)

    # 控制台也打一份摘要,方便直接复制到群里
    print(f"台账已生成:{out_path}(共 {len(df)} 条,重点 {len(key)} 条)")
    print("\n".join(f"  [{r.重要度}] {r.时间:%m-%d} {r.事项}"
                    for r in key.itertuples()))
那个控制台摘要是后来加的。我发现领导其实很少打开 Excel,他更习惯在群里看文字。所以干脆让脚本顺手打一段可以直接复制粘贴的东西出来,这一步又省了我五分钟。
七、串起来,再挂个定时
主流程就是把上面几步连起来,重点在分批和容错:
# main.py
import time
from datetime import datetime
from collect import load_all
from normalize import normalize
from classify import classify_batch
from render import render

BATCH = 30   # 每批最多30条,太多 AI 容易串行号

def main():
    df = normalize(load_all())
    print(f"清洗后有效记录 {len(df)} 条")

    items = df["事项"].tolist()
    cats   = ["未分类"] * len(items)
    levels = ["中"]     * len(items)

    for s in range(0, len(items), BATCH):
        batch = items[s:s + BATCH]
        try:
            for r in classify_batch(batch):
                idx = s + int(r["i"])
                cats[idx]   = r.get("cat", "临时事务")
                levels[idx] = r.get("level", "中")
        except Exception as e:
            # 失败了不要让整条流程挂掉,标记出来人工补
            print(f"[警告] 第 {s // BATCH + 1} 批处理失败:{e}")
        time.sleep(1)   # 简单限流,别把接口打爆

    df["分类"], df["重要度"] = cats, levels
    out = f"./out/工作台账_{datetime.now():%Y%m%d}.xlsx"
    render(df, out)

if __name__ == "__main__":
    main()
两个点值得说:
为什么要分批? 我一开始图省事,一天的量一次全塞进去,一百多条。结果 AI 返回的下标经常对不上,两条记录的分类会串。切成三十条一批之后,准确率肉眼可见地上去了。长上下文不等于效果好,这种结构化的活儿,小批量反而更准。
为什么失败要吞掉? 因为我这是每天要跑的东西,它必须"就算出点问题也能给我一份能用的东西"。某一批 AI 挂了,大不了那三十条是"未分类",我自己补两分钟就行。要是整个脚本崩了,我那天就得回头手工整理——那我搭这套东西就白搭了。
定时的话,Windows 用任务计划程序,跑一个 bat:
@echo off
cd /d D:\workspace\ledger
python main.py >> run.log 2>&1
我设在每天早上 7:40,比我到公司早二十分钟。到工位打开就是现成的。
八、跑一遍真实数据看看效果
光说没意思,我放一组真跑出来的结果。
喂进去的原始数据(三个来源,字段名都不一样):
微信导出:7月18日 | 跟B供应商确认发货时间 | 我 | 已沟通
钉钉审批:2026-07-18 15:20 | 申请E款补货300件 | 我 | 审批通过
邮件摘要:7.18 | 回复客户张总关于交期的询问 | 我 | 已回复
微信导出:7月18日 | 在群里同步了本周数据 | 我 | 已发
备忘录:7-18 | 帮同事导了一份历史订单表 | 我 | 完成
清洗+AI 打标之后:
时间 | 事项 | 分类 | 重要度 |
|---|---|---|---|
07-18 | 跟B供应商确认发货时间 | 供应链 | 高 |
07-18 15:20 | 申请E款补货300件 | 供应链 | 高 |
07-18 | 回复客户张总关于交期的询问 | 客户与售后 | 高 |
07-18 | 在群里同步了本周数据 | 数据与报表 | 中 |
07-18 | 帮同事导了一份历史订单表 | 临时事务 | 低 |
你看那个"帮同事导表"被标成了临时事务 + 低——这种判断我以前自己都懒得想,随手就标个"中"。AI 反而比我诚实。
整个链路跑一通的时序是这样的:
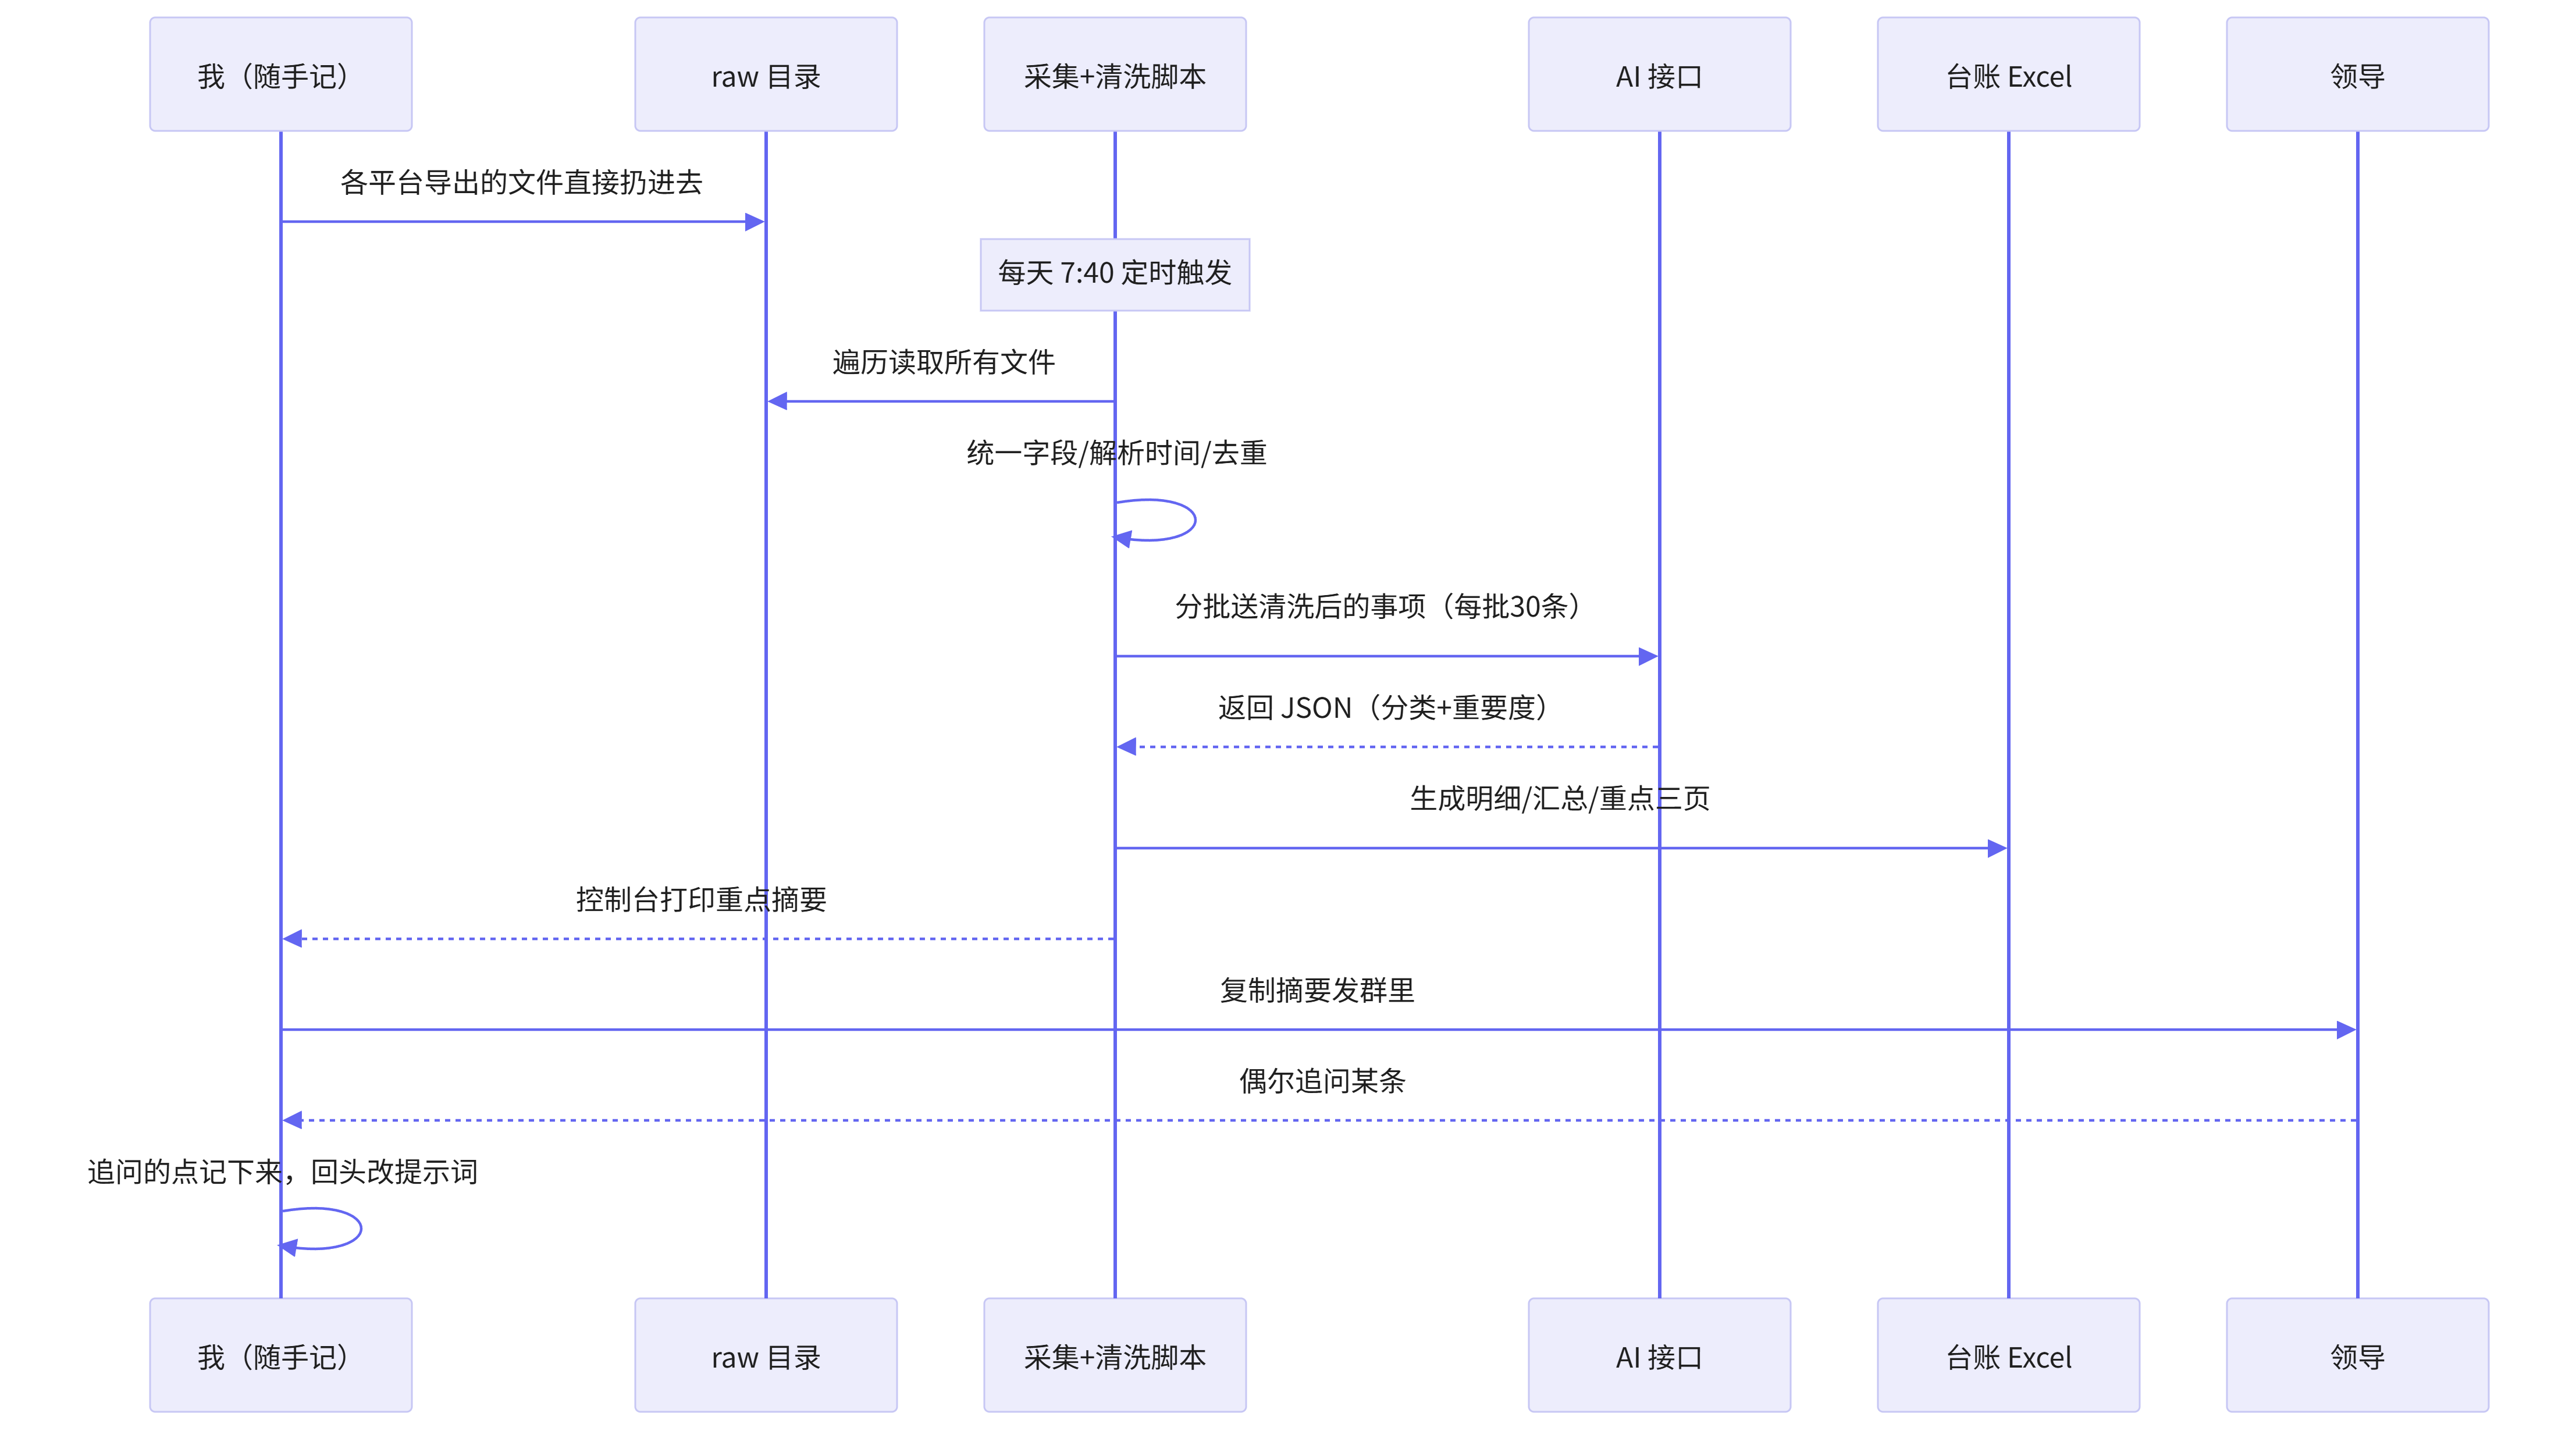
最后那个"回头改提示词"是我觉得整套东西里最有价值的一环。AI 标错了不要紧,你要把错的点攒下来,下一次写进提示词里。我现在的提示词里大概有一半的条款,都是被领导追问之后补上去的。这套东西不是搭完就完了,它是越用越准的。
九、踩过的坑,提前跟你说
坑一:AI 会"编造"你没做过的事。
有一次我原始记录里写了句"处理C店铺差评",AI 给我生成台账的时候,状态栏里自动补了"已协商改评"。实际上那天我根本没联系上客户。这种"善意的补全"在台账里特别危险,因为它是要归档的。我现在的铁律是:AI 只能填"分类"和"重要度"这两个推断字段,"状态""结果"这类事实字段,一律来自原始记录,不准它碰。
坑二:字段映射会认错人。
我的 normalize 里有个规则是"人"字就映射到负责人。结果有次导出的表里有一列叫"参与人",还有一列叫"创建人",两列都带"人",映射的时候后写的把前面的覆盖了,负责人全乱了。后来我才改成现在这种带排除条件的写法。模糊匹配很香,但也容易咬到你,写完一定要拿真数据验一遍。
坑三:一开始就想搞全自动,差点把自己劝退。
我第一版想做的是"自动登录各个平台抓数据"。做了两天,光微信导出就卡了我一整天,最后放弃了。后来我退一步,就手动导出扔文件夹,反而跑起来了。自己用的工具,能用八十分就别追求一百分,先跑起来再优化。 现在这个手动导出的动作,我一天也就花两分钟。
最后算笔账,不然显得我在吹牛:
- 翻记录找素材:约 25 分钟 → 2 分钟(只剩"从各平台导出文件"这一个动作)
- 对齐口径和去重:约 10 分钟 → 0(脚本跑完)
- 给每条判断分类和重要度:约 8 分钟 → 1 分钟(只剩扫一眼有没有明显标错的)
- 月底汇总那半天:摊到每个工作日大概 40 多分钟,现在汇总页是自动生成,基本归零
加起来一天差不多一个半小时到两小时。数字不算夸张,但重点是它稳定的。以前台账这活儿,我的耗时全看那天忙不忙、累不累——越累越写不动,越写不动越拖,越拖越要回忆,陷入恶性循环。现在不管我多累,早上台账都在那儿。
我觉得这套东西给我最大的改变,其实不是省时间。是我不用再每天下班前,被逼着花四十分钟去"证明我今天干活了"。这件事以前让我特别烦,因为它消耗的不是体力,是那种"我明明在做事,却还要花力气证明"的憋屈感。
现在这笔账,脚本替我记了。
如果你想照着搭一个,我建议别一口气全抄。 先只做 collect + normalize 这两步,跑一周,光是把素材归集和去重自动化,你就能感觉到明显轻松了。跑顺了再加 AI 分类,最后再上定时。
顺序反了,很容易中途弃坑——别问我怎么知道的。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号