从原型到通用框架:7 小时打造 AI 智能体的实战

从原型到通用框架:7 小时打造 AI 智能体的实战
用户12724357
发布于 2026-09-15 15:23:21
发布于 2026-09-15 15:23:21
AI 时代的开发,早已不是 “从零到一死磕技术细节” 的单打独斗。当大模型对技术细节的掌握深度远超普通人,真正决定开发效率和成果的,是创意思路、方法论,以及 “先搭原型,再逐步打磨” 的落地节奏。
昨天,我基于 Harness Engineering 规范,用 GLM 5.1(累计消耗约 1400 万词元)完成了一个从原型到通用框架的 Simple-Agent 智能体开发。
整个过程从下午 17:27 启动,到凌晨 00:43 收尾,历时7 小时 16 分钟,完整走过了 “原型验证→结构重构→能力扩充→实战试错→流程管控→通用化” 六个阶段。这个过程里的思考和落地经验,记录一下。
第一步:22 分钟,先跑通 “能用” 的原型
开发的起点从不是完美的架构,而是 “能跑起来的最小闭环”。原型我是从一个微信视频看到的内容,我用之前公众号里提到的内容提炼法生成一个简单的PRD:
Agent本质是"观察-决策-执行"三步循环,30行代码可实现。核心是三大组件:大脑(LLM)、工具集、历史记录。
- 决策循环 三步循环为核心,for实现。极简结构,高效清晰。
- 三大组件 大脑(LLM决策)、工具(执行)、记事本(记录)。三位一体。
- 工具系统 字典管理,名作key,函数+描述作value。描述是LLM的"说明书"。
- 控制平衡 LLM自主选工具/停步,代码控步数/流程。灵活可靠兼得。
- 最大步数 5-10步上限防死循环。多数任务3步内完成。
行动指南:
- 从30行核心入手,掌握本质
- 开发实用工具集扩展能力
- 重视工具描述准确性
- 设定合理步数限制
- 尝试多步推理问题
金句:大道至简,Agent精髓在循环:观察、决策、执行。30行见本质,万变不离宗。 30行代码截图,OCR提取文本内容,和上面内容保存到一个文件里, 作为新项目的PRD。
打开Claude Code,输入提示词:
> read @simple-agent.prd, I plan to create one simple agent based on simple-agent.prd, The code is not entirely correct in prd. You can refer to it, perform corrections and tests
开始干活
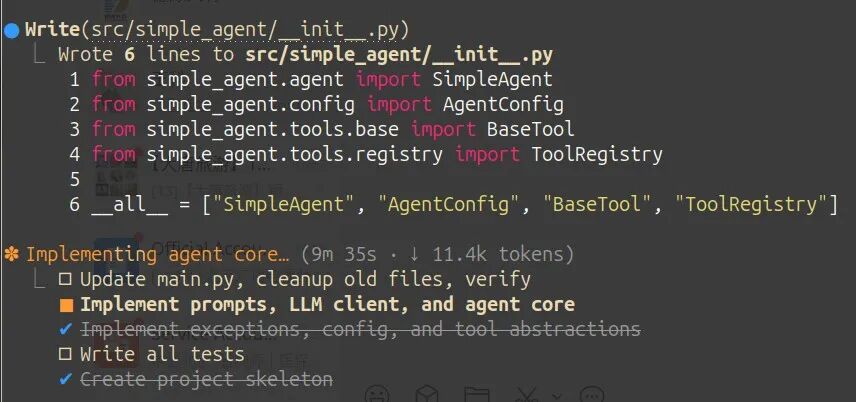
我从 17:27 开始,用 22 分钟完成了 Simple-Agent 的原型验证:吃透中文 PRD 后,搭建了agent.py、main.py、test_agent.py三个扁平文件,用最朴素的 JSON 文本解析实现 LLM 工具调用,仅靠两个 Lambda 工具(天气查询、计算器)完成核心逻辑,通过模拟 LLM 响应跑通测试(17:49 完成)。
这个阶段的核心是 “放弃完美主义”—— 不用纠结代码规范、不用考虑扩展性,只要验证 “核心思路可行”:LLM 能调用工具,工具能返回结果,整个链路能闭环。毕竟 AI 时代,技术细节可以后续优化,但 “思路是否成立” 必须第一时间验证。
第二步:11 分钟,从 “能用” 到 “能维护”
原型跑通后,接下来要解决 “可维护性” 问题。我从 17:49 到 18:00,用 11 分钟完成了从扁平文件到标准 Python 包的重构:将代码规整到src/simple_agent/目录,补充pyproject.toml配置,引入BaseTool抽象类、ToolRegistry工具注册器、AgentConfig配置类等工程化组件,添加自定义异常处理,并用pip install -e .安装为可编辑包。
这一步的关键是:AI 能写代码,但 “工程化思维” 是人类的核心优势。大模型可以补全技术细节,但 “如何让代码适配团队协作、长期迭代”,需要我们用软件工程的方法论兜底。
第三步:52 分钟,补齐核心能力,让智能体 “有活可干”
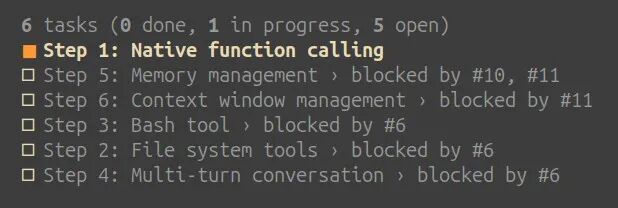
短暂休整后,18:25 重启开发,到 19:17 的 52 分钟里,我按 PRD 补齐 6 大核心能力,这是从 “玩具” 到 “工具” 的关键:是方法论层面的设计,而非单纯的技术细。
抛弃 JSON 文本解析,切换到 Anthropic 原生tool_use API,用结构化调用替代模糊的文本解析;新增文件操作、Bash 命令(带危险指令黑名单)、多轮对话记忆、上下文压缩等 8 类工具,覆盖文件交互、命令执行、长对话管理等核心场景;每一个能力落地都围绕 “解决实际问题”:比如上下文压缩是为了突破 token 限制,Bash 指令黑名单是为了规避安全风险。
此时发现,大模型确实能快速实现单个工具的功能,但 “能力之间的协同逻辑” 需要我们把控 —— 比如如何让多轮对话的记忆和上下文压缩配合,如何让文件工具的路径沙箱不被突破,这些是方法论层面的设计,而非单纯的技术细节。
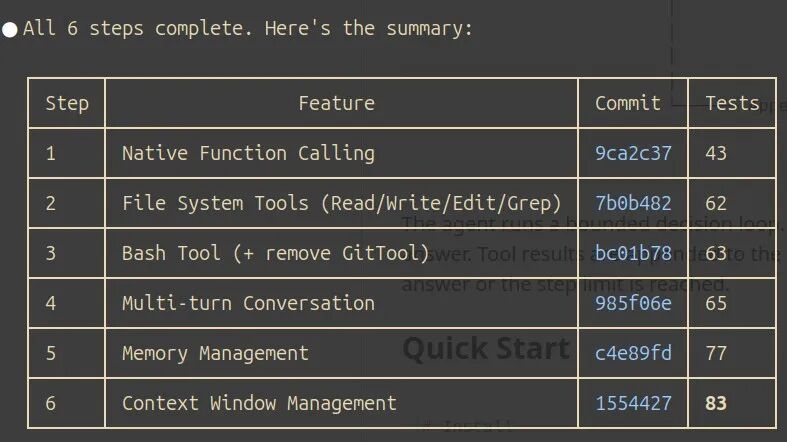
第四步:实战试错,暴露 “看不见的问题”
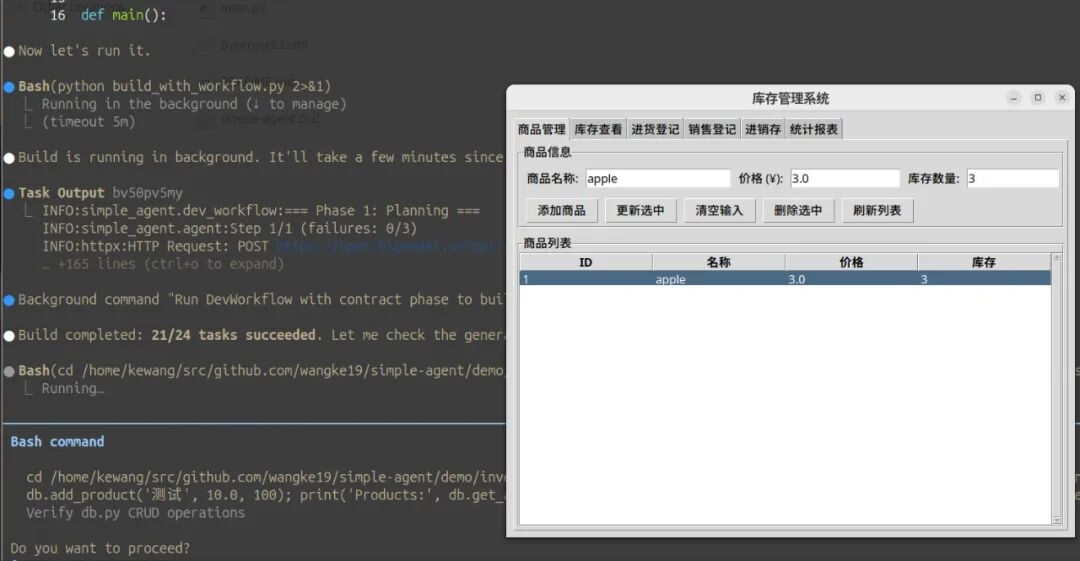
再好的单元测试,也抵不过一次真实任务的检验。19:17 到 20:03 的 46 分钟里,我让智能体尝试开发一个进销存管理 APP(tkinter+SQLite),结果代码能编译却跑不起来:不同文件里的方法名不统一get_purchases()vs get_all_purchases())、函数参数缺失、方法名完全错误……
这让我意识到:AI 能生成单文件代码,但缺乏 “跨文件的一致性认知”—— 每一次 LLM 调用都是独立的,没有共享上下文,自然会出现 “各写各的” 的问题。这也是 AI 开发的核心痛点之一:技术细节 AI 能搞定,但 “全局一致性” 需要人类设计流程来约束。
第五步:54 分钟,流程管控,用 “契约” 解决一致性问题
针对实战暴露的问题,20:03 到 20:57 的 54 分钟里,我设计了 DevWorkflow 工作流,核心是 “用流程和契约约束 AI 的输出”:
拆解任务流程:plan_task()(规划)→ decompose()(拆解)→ define_contracts()(定义接口契约)→ execute()(执行);加入质量管控:设置最大失败次数、生成 Markdown 格式的 TaskReport 执行日志、支持人工介入的暂停 / 续跑功能;关键创新是 “接口契约”:让 LLM 先生成接口规范,再将规范注入每一个子任务 —— 这相当于给 AI 划定了 “统一的说话方式”,解决了跨文件、跨任务的一致性问题。
重新跑进销存任务时,24 个任务里 21 个一次性通过,再也没有出现方法名、参数不匹配的问题。这印证了:AI 时代,开发的核心是 “设计规则和流程”,让 AI 在框架内发挥细节优势。
第六步:3 小时 46 分钟,通用化改造,从 “专属工具” 到 “通用框架”
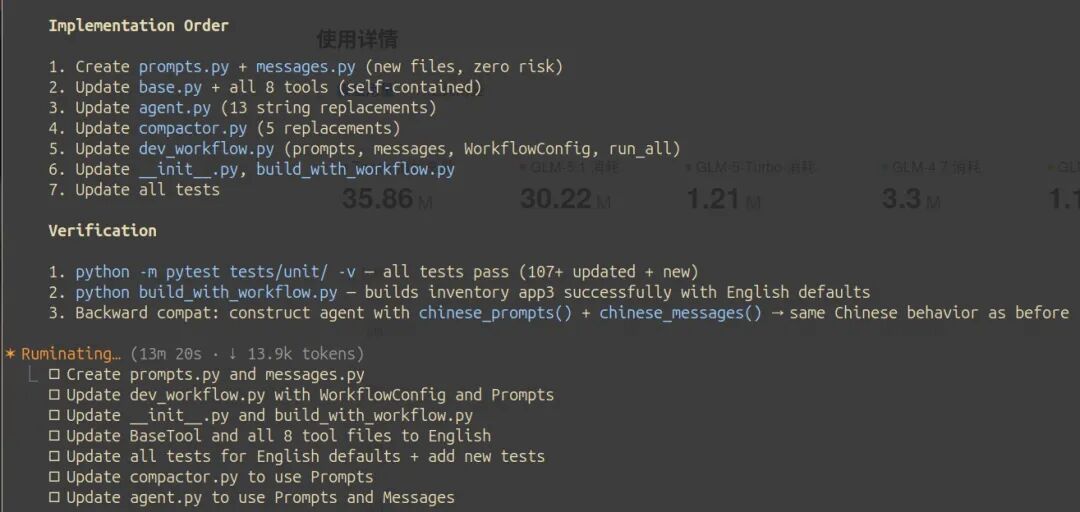
最后阶段(20:57 到 00:43),我用 3 小时 46 分钟完成通用化改造,让智能体摆脱 “中文进销存专属” 的局限,成为通用化框架:
配置化所有提示词和消息:默认英文,支持chinese_prompts()/chinese_messages()快速切换语言;新增 WorkflowConfig 配置项:可开关规划、拆解、契约等流程,适配不同任务场景;优化失败重试逻辑:仅重新执行失败任务,且重试前读取已有文件上下文;补充到 121 个测试用例,覆盖所有新特性,支持从外部需求文件(如my_task.md)驱动任务。
至此,Simple-Agent 从一个针对特定场景的中文智能体,变成了 “任意任务、任意语言、任意流程配置” 的通用框架。
核心数据:7 小时的进化之路
维度 | 初始(Stage 1) | 最终(Stage 6) |
|---|---|---|
源码文件数 | 3 个 | 17 个 |
代码行数 | ~200 行 | ~1700 行 |
工具数量 | 2 个(Lambda) | 8 个(标准化类) |
测试用例数 | 3 个 | 121 个 |
支持语言 | 仅中文 | 可配置(英 / 中) |
工作流 无 | 4 | 阶段契约化流程 |
异常处理 | 无 | 失败次数限制、暂停 / 续跑、执行日志 |
AI 时代开发的核心启示
这次 7 小时的高密度开发,让我对 AI 时代的开发逻辑有了更清晰的认知:
原型优先:先跑通最小闭环,再谈优化 —— AI 能快速补全细节,不用在一开始就纠结技术完美;方法论>技术细节:大模型掌握着海量技术细节,但 “如何拆解任务、设计流程、制定契约” 是人类的核心价值。
实战验错比单元测试更重要:AI 生成的代码在单元测试里可能全过,但真实任务会暴露全局一致性问题。
硬编码适合原型,配置化适配通用:初期硬编码特定场景能加速验证,但通用化必须抽离配置项。
人类的角色是 “框架设计者”:我们不用再死磕 “怎么写一个工具函数”,而是思考 “怎么让 AI 协同工作、怎么管控 AI 的输出质量”。
AI正在把开发者从重复的技术细节中解放出来,我们终于可以把精力放在更有价值的地方:创意、思路、流程设计、质量管控。从一个简陋的原型开始,用方法论引导方向,让 AI 补齐细节,逐步打磨成通用框架 —— 这或许就是 AI 时代最高效的开发范式。
未来,我还会基于这个框架继续探索智能体的自动化测试、多智能体协作等能力。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-04-24,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号