光子互连如何撑起百万 Token 大模型推理?| Lightmatter HotI报告

光子互连如何撑起百万 Token 大模型推理?| Lightmatter HotI报告
光芯
发布于 2026-09-16 20:55:48
发布于 2026-09-16 20:55:48
该文档是 Lightmatter 在 Hot Interconnects 2026 会议上发布的另外一份技术报告,聚焦高基数光子互连(CPO 共封装光学)如何解决大模型推理 Prefill阶段的通信瓶颈。报告分为三大部分:ML 推理系统现状、光子互连技术能力、光子互连对 Prefill 推理的建模评估。
第一部分:推理与机器学习系统现状
一、推理成为AI主要负载
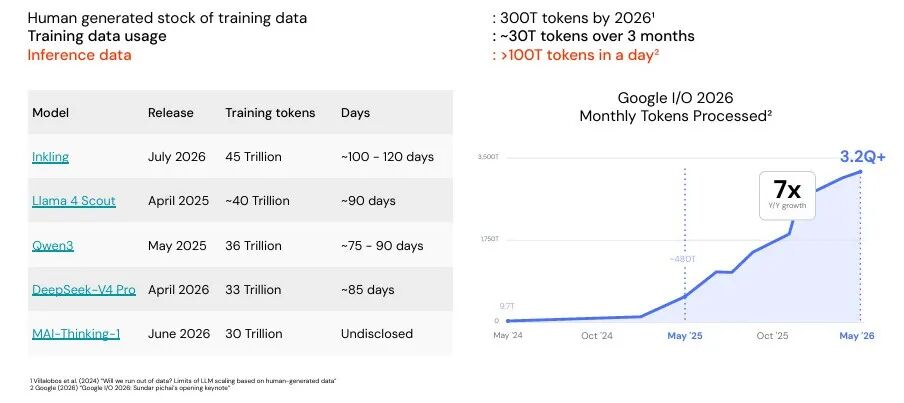
- 人类生成的训练数据总量预计 2026 年达 300T token;主流模型(Inkling、Llama4 Scout、Qwen3、DeepSeek‑V4 Pro)三个月内训练 token 约 30T 级别;
- 而推理侧日处理 token 已超 100T,Google数据显示 2024‑2026 月处理 token 实现7 倍同比增长,达到 3.2Q+。
二、硬件与模型架构的分化趋势
1. 专用硬件分化
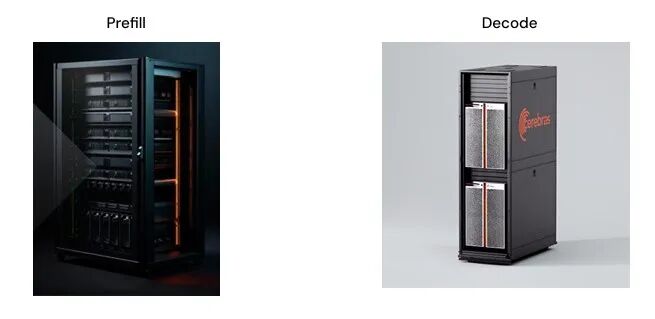
- 预填充(Prefill)阶段:侧重吞吐量,代表硬件为 AMD Helios、AWS Trainium
- 解码(Decode)阶段:侧重低延迟,代表硬件为 Cerebras WSE(CS-3)
2. 三大瓶颈迫使大模型无法单卡承载,必须采用并行分片策略
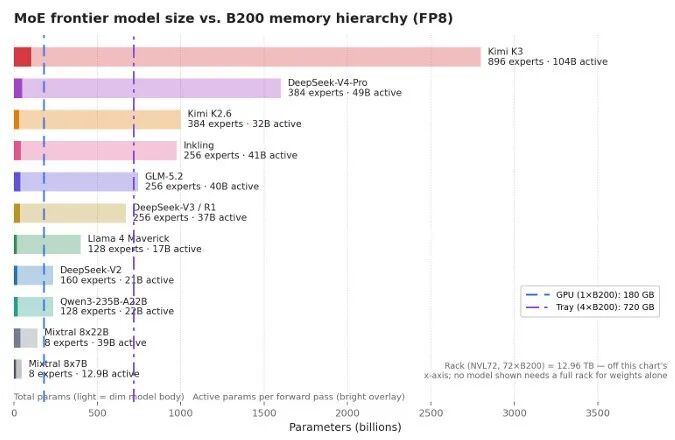
- 权重(Weights)瓶颈:FP8 精度下,前沿 MoE 模型权重已经超过单张 B200 GPU 的 HBM 容量,需要跨 GPU、跨 Tray、跨机架切分权重。部分超大模型甚至需要一整个机架(72×B200)才能放下全部权重。
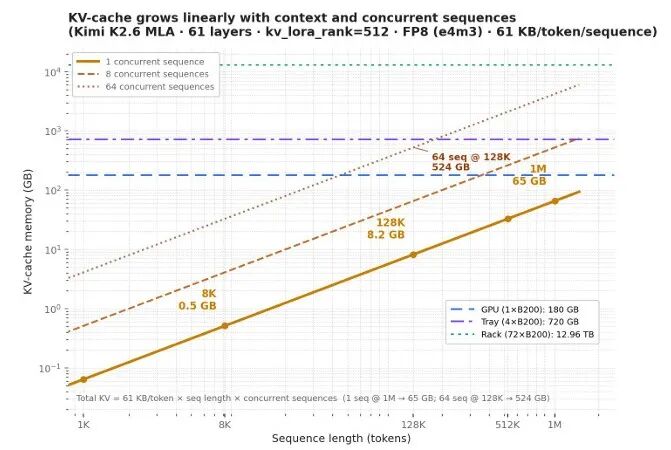
- KV-Cache瓶颈:KV 缓存随序列长度和并发数线性增长,以 Kimi K2.6 为例,单序列 1M 上下文 FP8 精度下 KV 缓存超 165GB,64 并发序列下可达 524GB,远超单卡容量。
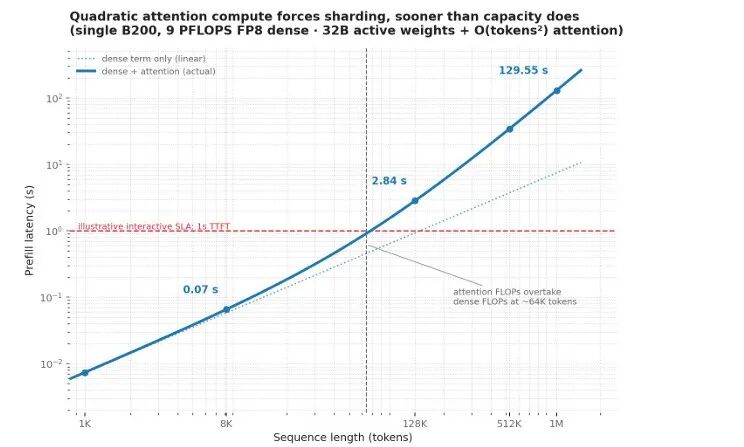
- 预填充计算瓶颈:Prefill 的注意力计算量随序列长度呈二次增长,计算压力比内存容量更早迫使模型分片。在 64K token 时,注意力算力开销就超过稠密层算力;长序列下 Prefill 时延急剧恶化,远高于交互式 1s 的 TTFT 服务 SLA。
三、主流并行分片架构
报告梳理了从机架内到多机架的三级并行体系:
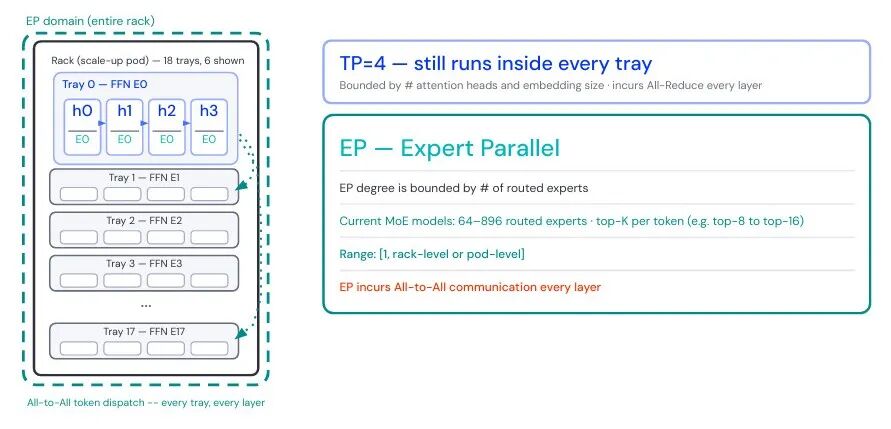
- 张量并行(TP):机架内最内层分片,将张量拆分到多个计算单元,每层需执行 All-Reduce 通信;并行度受注意力头数、嵌入维度限制,通常为节点级(如单 tray 内 TP=4)。
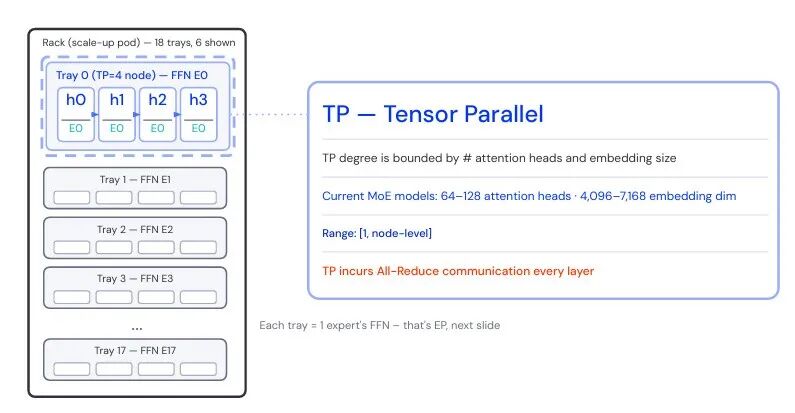
- 专家并行(EP):覆盖整个机架的 MoE 分片方式,将不同专家 FFN 部署到不同 trays,每层需执行 All-to-All token 调度;并行度由专家数量决定,当前 MoE 模型支持 64~896 个路由专家,可铺满整个机架(如 18 个 tray 对应 18 个专家)。
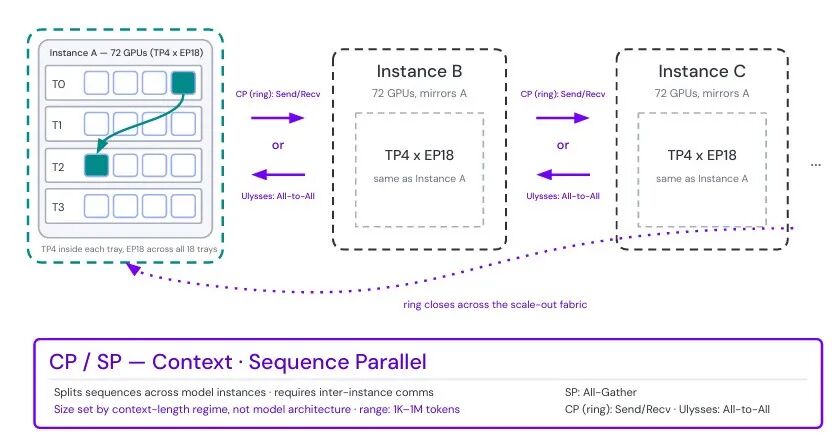
- 上下文 / 序列并行(CP/SP):跨机架的长上下文扩展方案,将单条长序列拆分到多个完整模型实例,包含 Ring(Send/Recv)、Ulysses(All-to-All)等实现;并行度由上下文长度决定,支持 1K~1M token 的超长场景。
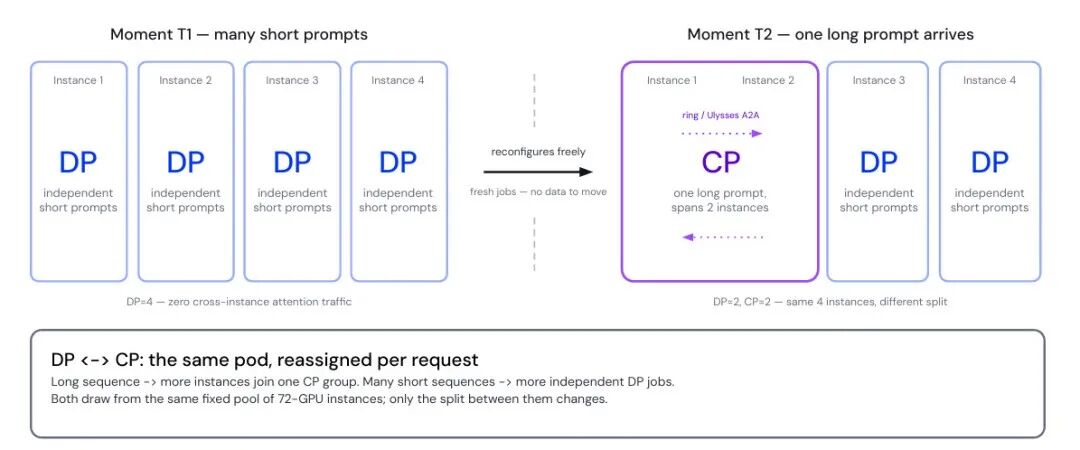
- 灵活调度机制:同一集群可根据请求类型动态切换模式 —— 短请求多时采用数据并行(DP)提升并发,长请求到达时切换为上下文并行(CP)拆分序列,无需迁移数据,资源利用率更高。
四、纵向扩展的带宽墙困境
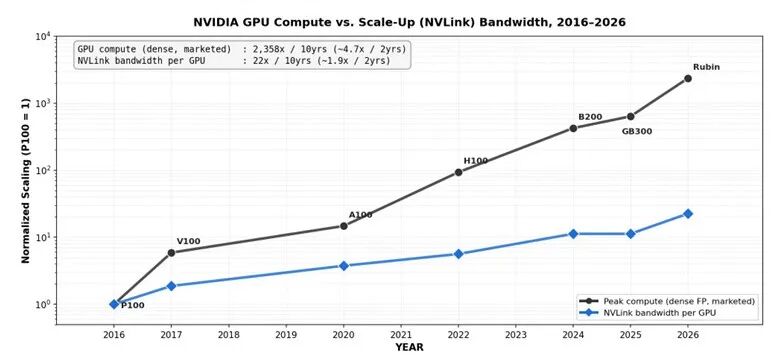
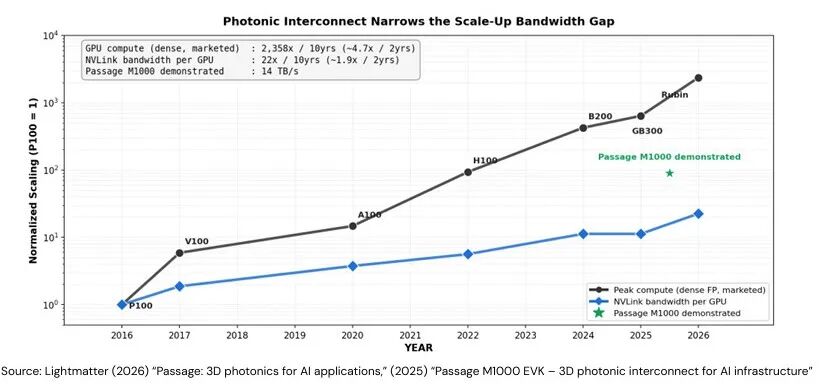
过去 10 年 GPU 稠密算力增长了 2358 倍(约每 2 年 4.7 倍),但 NVLink 单卡带宽仅增长 22 倍(约每 2 年 1.9 倍),带宽增长速度远滞后于算力,成为制约模型纵向扩展(Scale-Up)的核心瓶颈。
第二部分:光子互连可以带来什么
一、光互联相对铜缆的核心优势
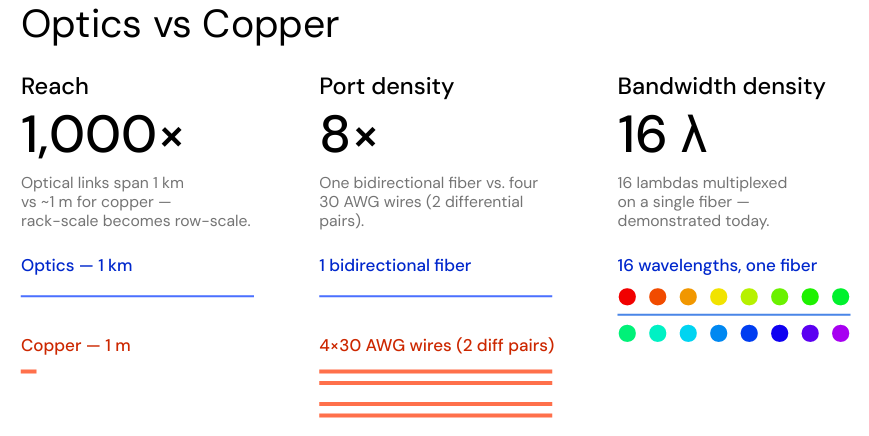
光子互联从三个维度突破了电互联的物理极限:
- 传输距离:光链路可达 1km,是铜缆(约 1m)的 1000 倍,支持机架级扩展到机房行级。
- 端口密度:单根双向光纤等效于 4 根 30AWG 铜线(2 对差分线),端口密度提升 8 倍。
- 带宽密度:单根光纤可通过波分复用(WDM)承载 16 个波长信号,单纤带宽大幅提升,该技术已实现商业化验证。
二、典型实现:3D 共封装光学(3D CPO)
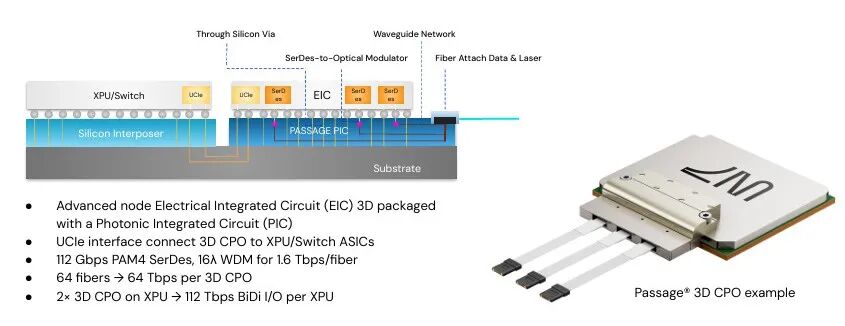
报告以 Lightmatter Passage 3D CPO 方案为例介绍了落地形态:
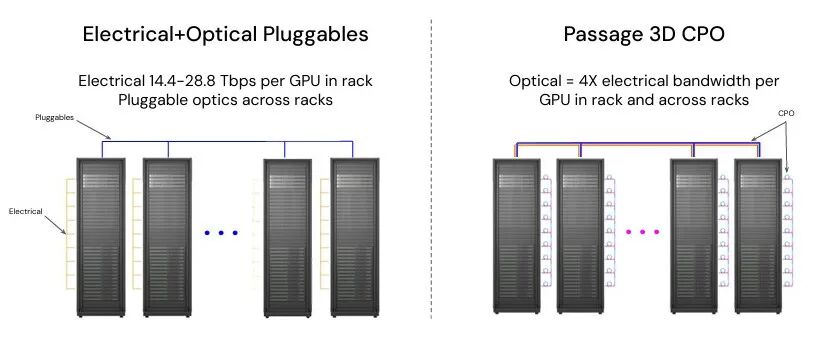
- 架构上:采用 3D 封装,将电集成电路(EIC)与光子集成电路(PIC)通过硅中介层堆叠,通过 UCIe 接口对接 XPU / 交换 ASIC。
- 规格层面:采用 112Gbps PAM4 SerDes + 16λ WDM 技术,单根光纤双向带宽 1.6Tbps;单块 3D CPO 集成 64 根光纤,总带宽 64Tbps;单颗 XPU 搭配 2 块 CPO 可实现 112Tbps 双向 I/O。
三、扩大纵向扩展边界
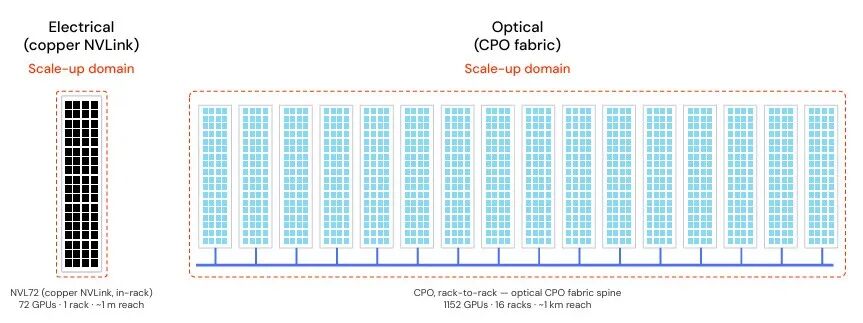
- 传统电方案(铜缆 NVLink)的纵向扩展域仅为单机架 72GPU,传输距离约 1m;
- 光子 CPO 方案将纵向扩展域扩大到 16 机架、1152GPU,传输距离可达 1km,scale-up 规模直接提升 16 倍。
- 光子互联大幅提升了单 GPU 可用带宽,显著收窄了 “算力增长快、带宽增长慢” 的剪刀差。
第三部分:光子互连对推理 Prefill 的建模评估
一、建模方法与测试设定
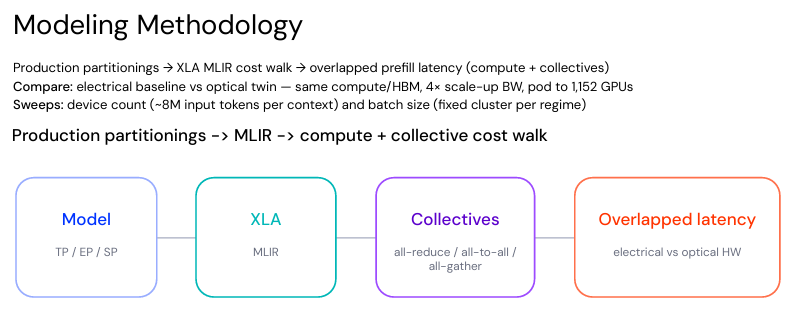
- 测试模型:DeepSeek R1 变体 MoE 模型,42B active / 840B total parameters, FP4。
- 测试场景:覆盖三档典型上下文长度,总 token 量均为 8M:
- 低上下文:8K 序列长度,1024 并发用户
- 中上下文:128K 序列长度,64 并发用户
- 大上下文:1M 序列长度,8 并发用户
- 硬件参数:
- 电基线:14 PFLOPS/GPU 算力、7.9TB/s HBM 带宽、900GB/s scale-up 带宽,72GPU 机架
- 光方案:scale-up 带宽为电基线的 4 倍,pod 规模扩展至 1152GPU,其余硬件规格一致
- 流程:生产级分片配置→XLA/MLIR 开销分析→叠加计算与集合通信时延,对比电气、光互连两套硬件
二、三大场景关键结果
场景1: 低上下文 8K
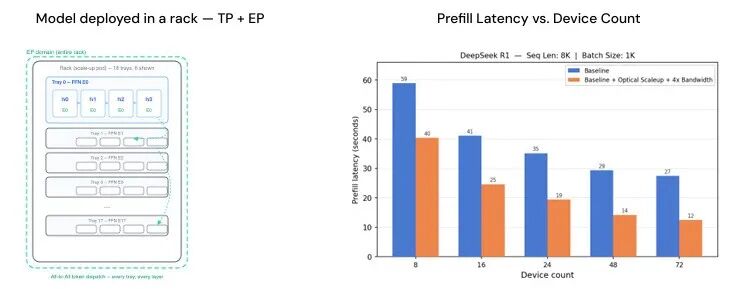
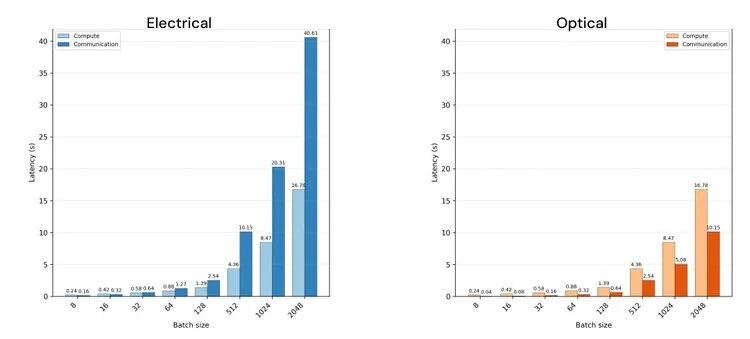
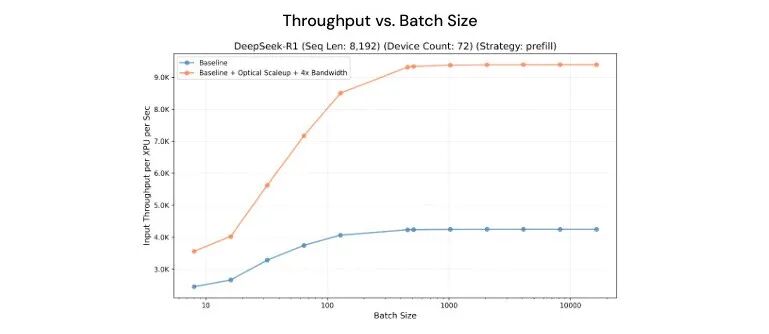
- 最大时延降低 2.2×
- 通信成为电基线主要开销;光互连把通信时延大幅压低,系统瓶颈转向计算
- 单 XPU 吞吐从约 4k token/s 提升到 9k token/s
场景2:中上下文 128K
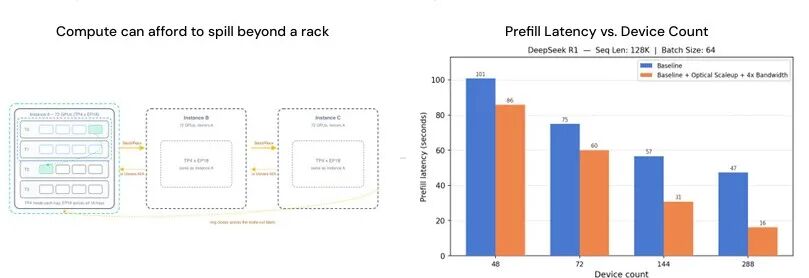
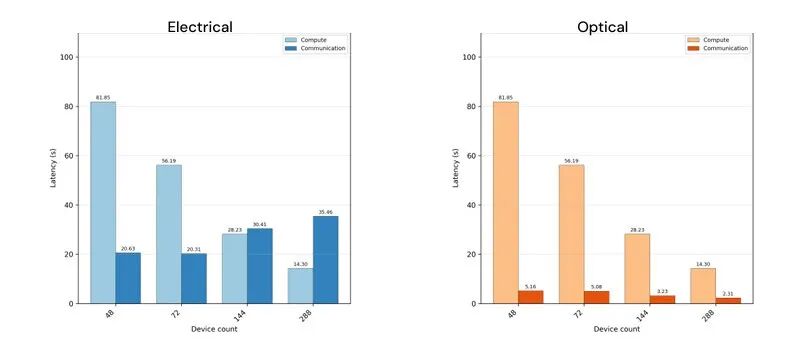
- 最大延迟降低: 2.9 ×
- 当设备数增加,光互连极大压制 All‑to‑All 跨机架通信开销
场景3:长上下文场景 1M
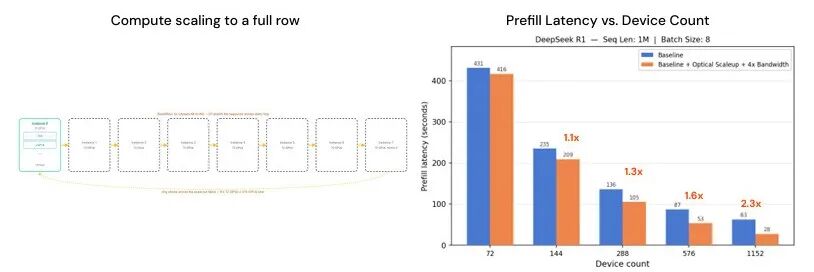
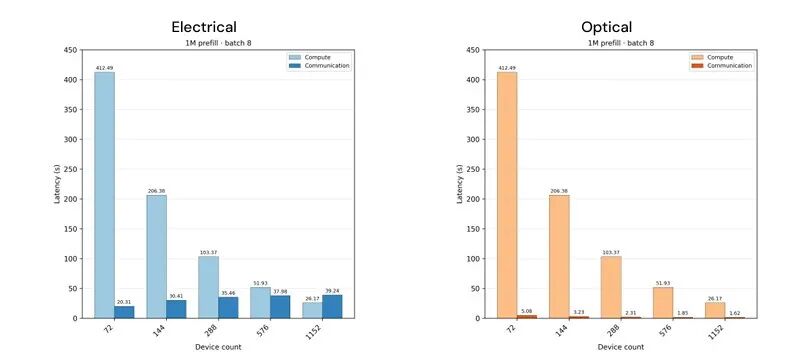
- 可扩展至整行 1152GPU 规模,最高实现 2.3 ×时延降低。
- 电气基线跨机架 scale‑out 时通信开销爆炸;光互连把通信时延压到极低,计算成为主要耗时。
三、当前硬件与未来硬件综合对比
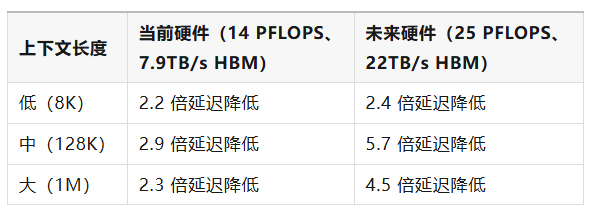
整体来看,通过 4 倍带宽扩展与 16 倍 scale-up 域扩大,光子互联在 16 机架、1152GPU 的 pod 架构中,最高可实现5.7 倍的预填充延迟降低,是支撑长上下文大模型规模化推理的核心技术路径。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-28,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号