CPO/NPO/可插拔怎么选?从OCP短距光互联SROI白皮书看AI光互联落地路径(上)

CPO/NPO/可插拔怎么选?从OCP短距光互联SROI白皮书看AI光互联落地路径(上)
光芯
发布于 2026-09-16 20:56:42
发布于 2026-09-16 20:56:42
白皮书首次定义SROI为≤30米的全新光物理层应用域,该场景下光纤色散、衰减可忽略,系统约束转为功耗、成本、可靠性、端口基数、带宽密度;文中对比铜缆与多种光互联架构(可插拔LPO/RTLR、NPO近封装光学、CPO共封装光学、OCS光电路交换),给出功耗(单链路端pJ/b个位数)、FIT故障率、时延、带宽密度等量化系统指标,同时分析200G向400G演进中IMDD光传输、铜传输的技术边界。该文档并非硬件规格标准,旨在为IEEE 802.3、OIF、JEDEC等标准化组织以及产业链提供AI规模扩展互联的系统输入,推动面向多协议(UALink、ESUN、CXL、PCIe)统一短距光互联底座,缓解AI集群scale‑up互联瓶颈。
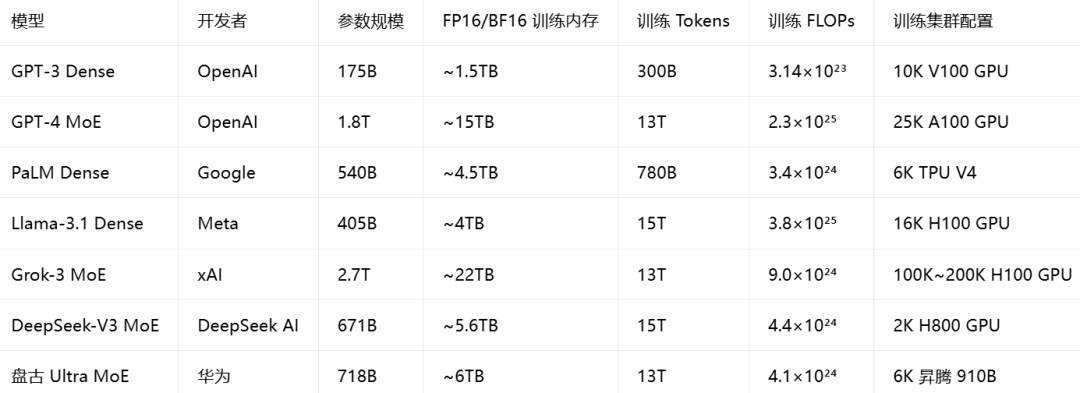
一、AI算力扩张的底层困局:互连成了第一性能瓶颈 前沿AI模型的训练算力需求正以每年4.5倍的速度爆发式增长,模型参数从百亿级跃升至万亿级,单加速器的算力与内存容量已完全无法支撑。行业被迫通过大规模分布式并行训练突破物理极限,而互连网络也从辅助组件升级为AI集群的核心性能瓶颈——任何带宽与时延的损耗,都会直接导致高价XPU闲置,拉长训练周期并推高基础设施成本。 从当前主流前沿大模型的训练配置来看,单设备的算力与内存容量与训练需求之间的缺口已达数量级:
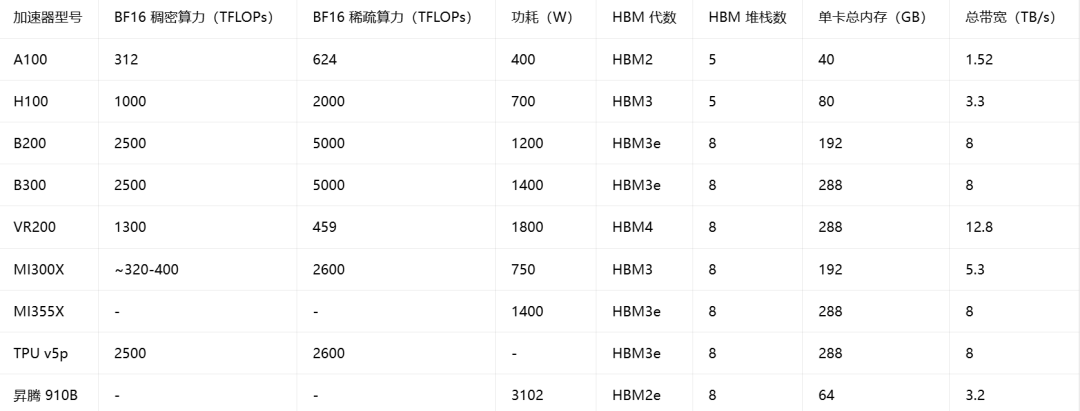
与此同时,AI加速器本身也面临着严峻的“内存墙”与“带宽墙”双重约束。一方面,万亿参数模型的训练内存需求远超单卡HBM容量;另一方面,计算核心的算力增长远快于内存带宽增长,导致核心经常处于等待数据的空闲状态,实际算力利用率远低于理论峰值。 主流AI加速器的核心算力与内存配置对比如下:
现代AI训练通过多维度并行策略实现算力拆解,每一种并行模式都对底层网络提出了严苛要求:
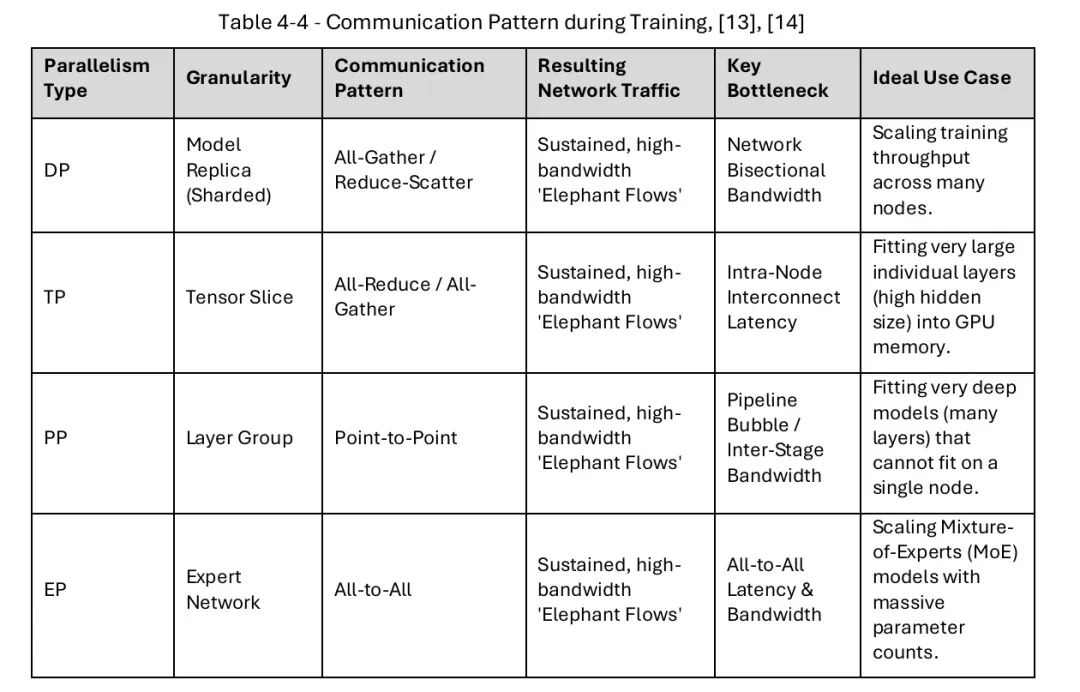
- 数据并行(DP):产生持续高带宽的All-Gather/Reduce-Scatter流量,依赖网络二分带宽; - 张量并行(TP):要求极低时延的All-Reduce通信,瓶颈在于节点内互连时延; - 流水线并行(PP):形成点到点的串行数据流,瓶颈在于跨阶段带宽; - 专家并行(EP):生成稀疏的All-to-All流量,对全连接时延与带宽要求极高。
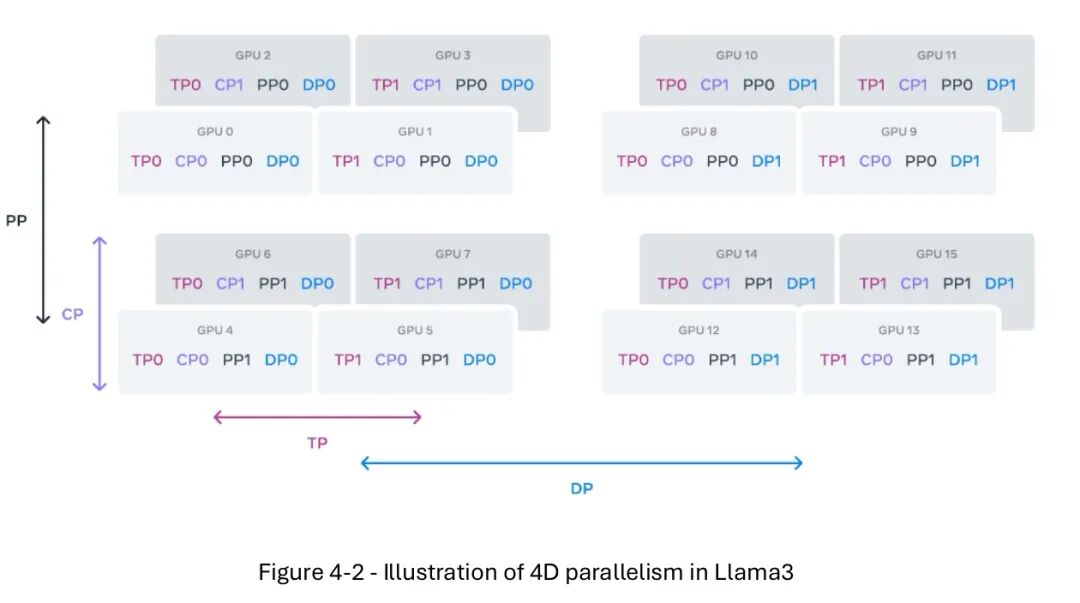
这些并行策略共同催生了大规模、长持续时间的“大象流”,且以RDMA内存语义流量为主。与传统数据中心“南北向”流量不同,AI集群90%以上是“东西向”的XPU间通信,低熵特性导致传统负载均衡机制失效,倒逼网络架构向专用化方向演进。 二、SROI:定义一个全新的光互连距离域 传统光通信标准(如IEEE 802.3定义的DR、FR等级)均针对500米以上的中长距场景优化,核心解决光纤衰减、色度色散、光信噪比等信道损伤问题。但在AI集群的机架内/跨机架场景(距离≤30米),单模光纤的插入损耗与色散几乎可以忽略,传统光模块的信道补偿设计完全冗余,反而带来不必要的功耗、成本与复杂度。 SROI(Short Reach Optical Interconnect,短距光互连)正是针对这一场景定义的全新光互连距离域,其核心设计目标从“信道补偿”转向“端点集成效率”,核心优化方向包括: 1. 封装/面板处的光通道密度; 2. 超大聚合带宽下的单位比特能效; 3. 机架级海量通道下的单通道成本; 4. 匹配内存语义计算的高可靠性。 SROI的定位可类比电互连领域的XSR/VSR等级,是一种协议无关的通用光物理层,可同时承载UALink、ESUN、PCIe Gen6/7、CXL等多种协议,通过跨协议的体量聚合驱动成本下降与可靠性成熟,避免碎片化的协议专用光方案。 三、AI Scale-Up光网络的三大核心挑战 AI Scale-Up网络与传统前端以太网在设计目标上存在本质差异,面临三大独特挑战: 1. 高Radix(基数)需求
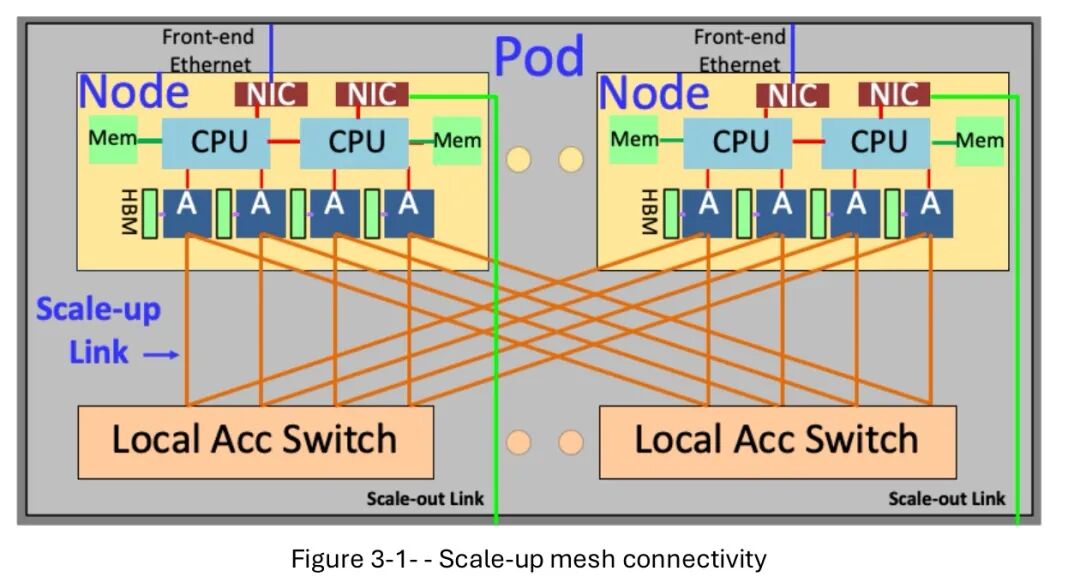
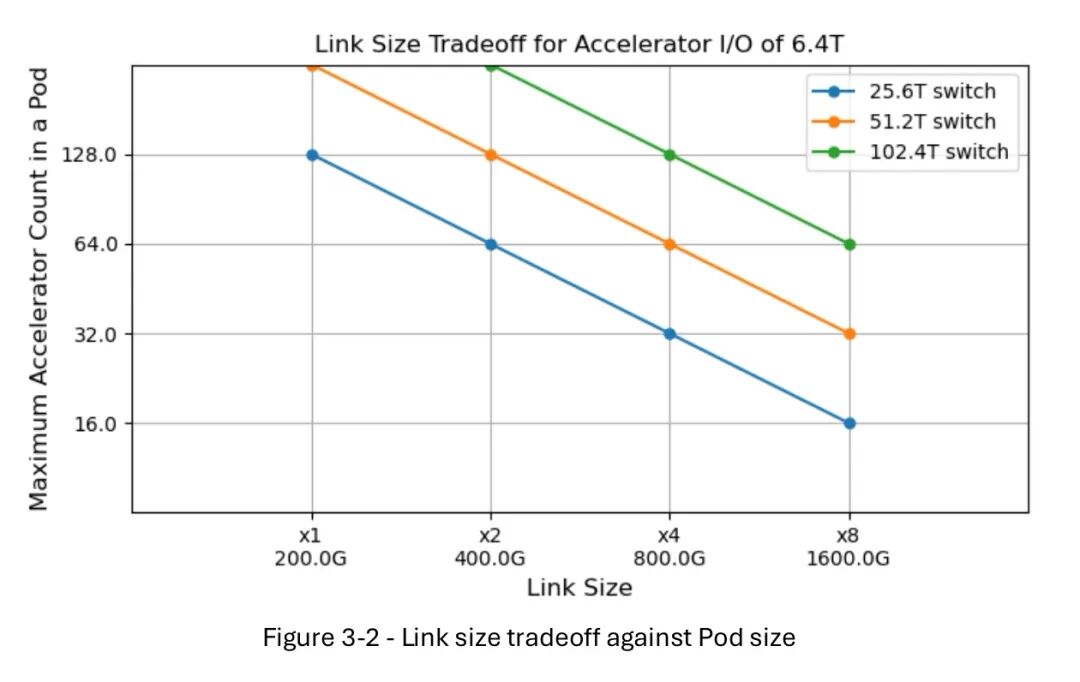
Scale-Up网络采用全连接Mesh架构,每台加速器都需要与所有交换机直接相连,交换机的Radix(端口数)直接决定了Pod可容纳的加速器数量。其核心关系为: Pod内加速器数量 = 交换机总I/O带宽÷单链路带宽
链路带宽与Pod规模存在天然权衡:小带宽链路可支撑更大规模的集群,但单加速器通信带宽更低;大带宽链路性能更强,但会限制集群规模。以单加速器6.4Tbps I/O带宽为例,交换机总带宽从25.6T提升至102.4T时,可支撑的加速器数量将实现4倍增长。
2. 互操作性约束 Scale-Up链路要求两端接口严格匹配,既可以采用IEEE 802.3标准光接口(如800GBASE-FR4/DR4),也可以采用定制化非标准接口。由于机架内光纤数量庞大,非标准方案可通过优化设计实现更低功耗与更少光纤数量,但会牺牲多厂商互通性,系统架构师需要在性能与生态之间做权衡。
3. 功耗主导效应 光收发器的重定时架构分为三类:无重定时(non-retimed)、发送端重定时(tx-retimed)、全重定时(fully-retimed),重定时能力越强,功耗越高。
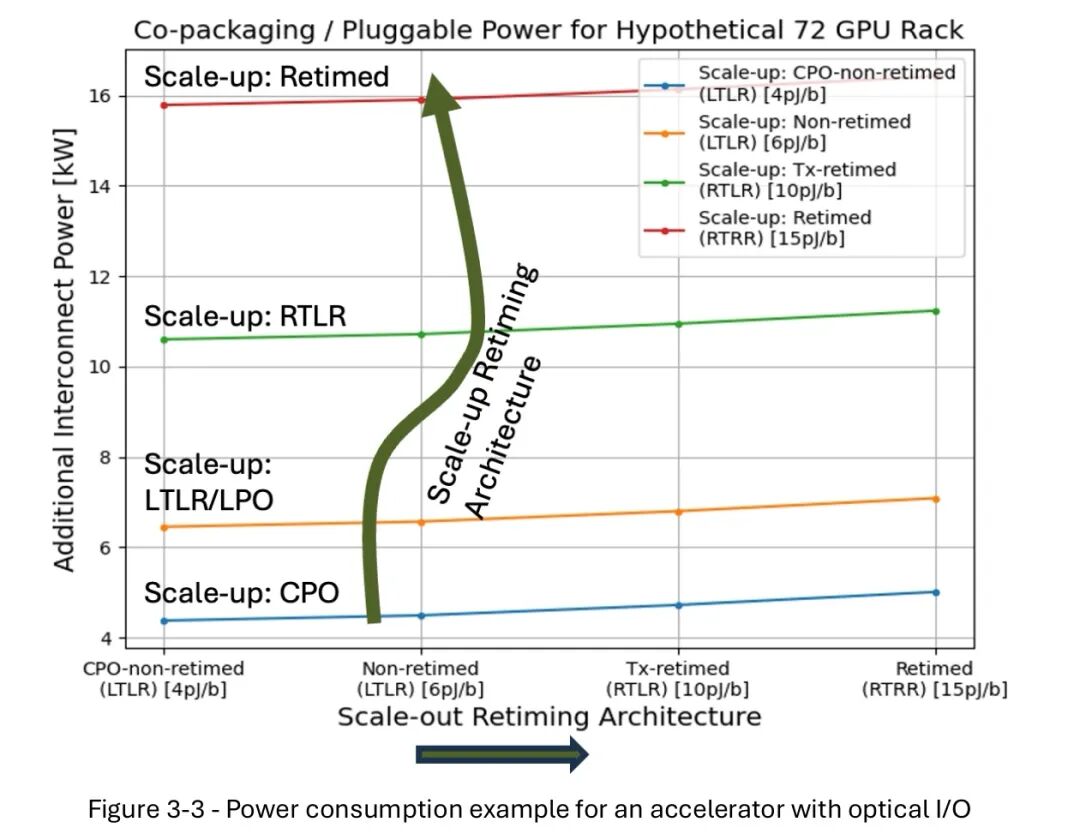
对72加速器的典型机架系统测算显示:Scale-Up侧的重定时架构选择对总功耗的影响远大于Scale-Out侧——Scale-Up侧不同方案的功耗差距可达数倍,而Scale-Out侧从重定时到无重定时的变化对总功耗影响很小。因此,Scale-Up场景的光架构选择是整个集群功耗的核心决定因素。
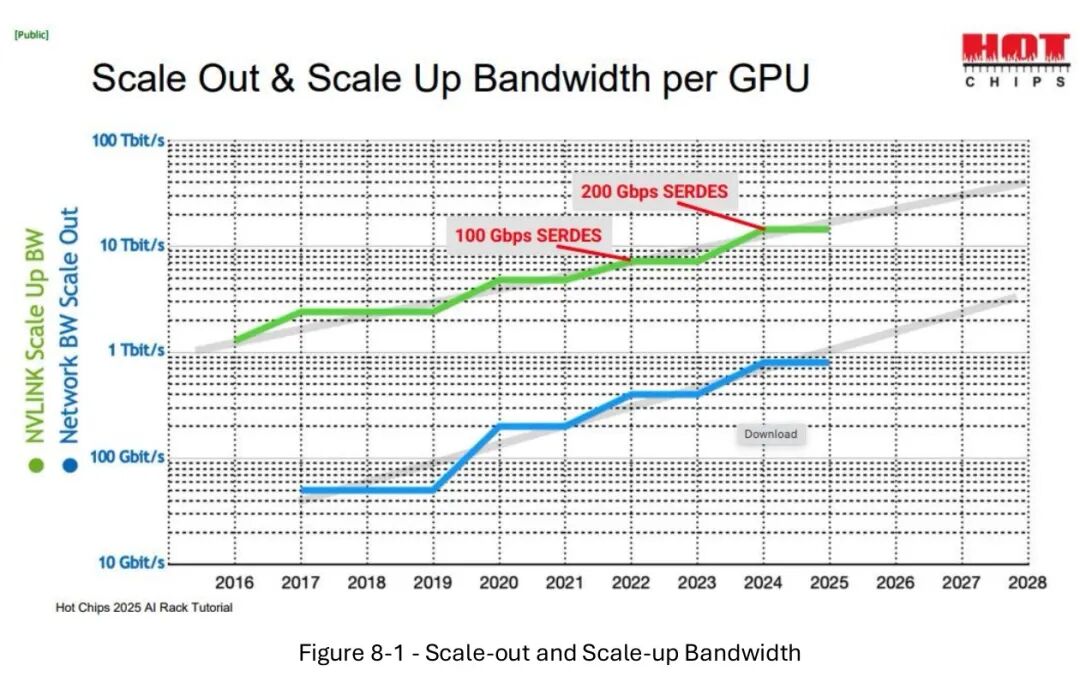
四、现代AI Fabric的网络分层:Scale-Up与Scale-Out的本质差异
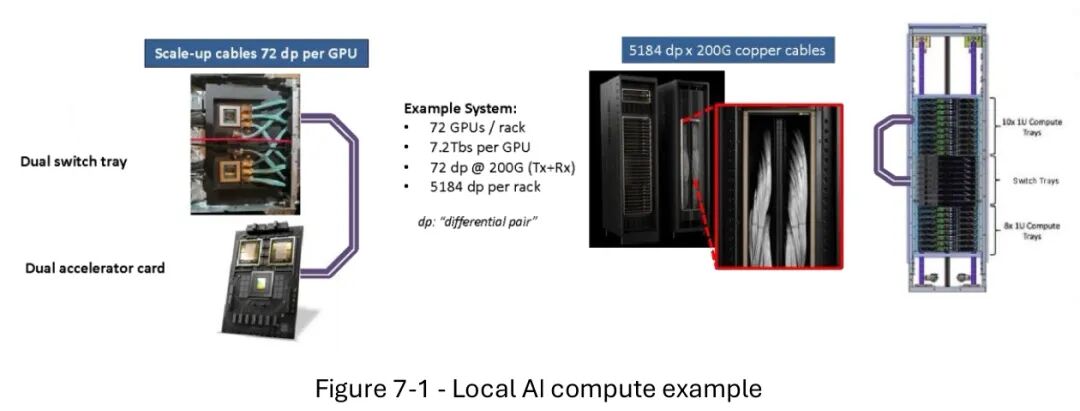
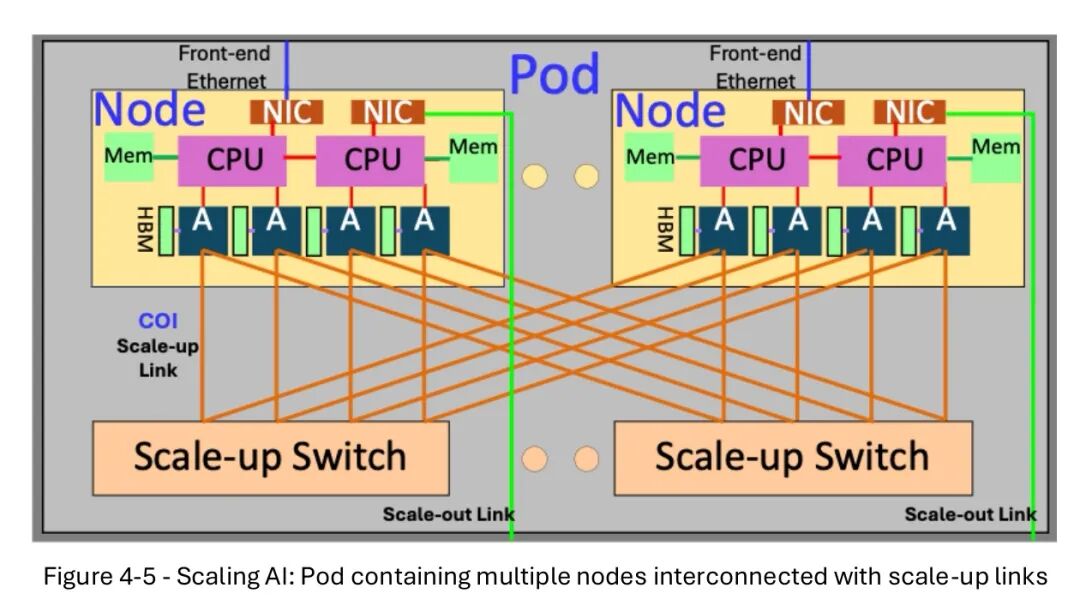
现代AI集群的网络分为两个层级,二者在设计哲学与性能指标上存在数量级差异:
特性 | Scale-Up 网络 | Scale-Out 网络 | 主数据中心网络 |
|---|---|---|---|
核心用途 | Pod 内 XPU 紧耦合通信 | 跨 Pod 集群间通信 | 通用连接、存储访问 |
典型规模 | 最多 256 个 XPU | 最多 10000 个节点 | 10 万~100 万端点 |
传输距离 | <30 米 | <2 千米 | ≥2 千米 |
往返时延 | <1 微秒 | <10 微秒 | >100 微秒 |
单 XPU 带宽 | ~8000Gb/s | ~400Gb/s | ~100–200Gb/s |
通信语义 | 内存一致性 Load/Store | 消息传递 RDMA | 网络转发 |
核心目标 | 超低时延、超大带宽 | 高吞吐量、成本优化 | 可扩展性、可靠性 |
从当前主流AI加速器的实际网络配置来看,Scale-Up与Scale-Out两层网络的规格差异更为直观:
主流加速器Scale-Up网络规格对比
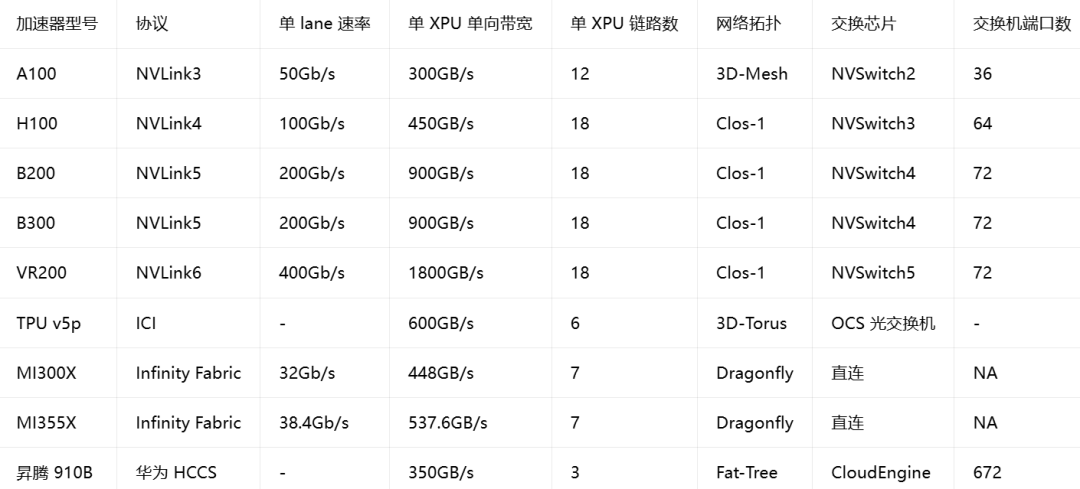
主流加速器Scale-Out网络规格对比
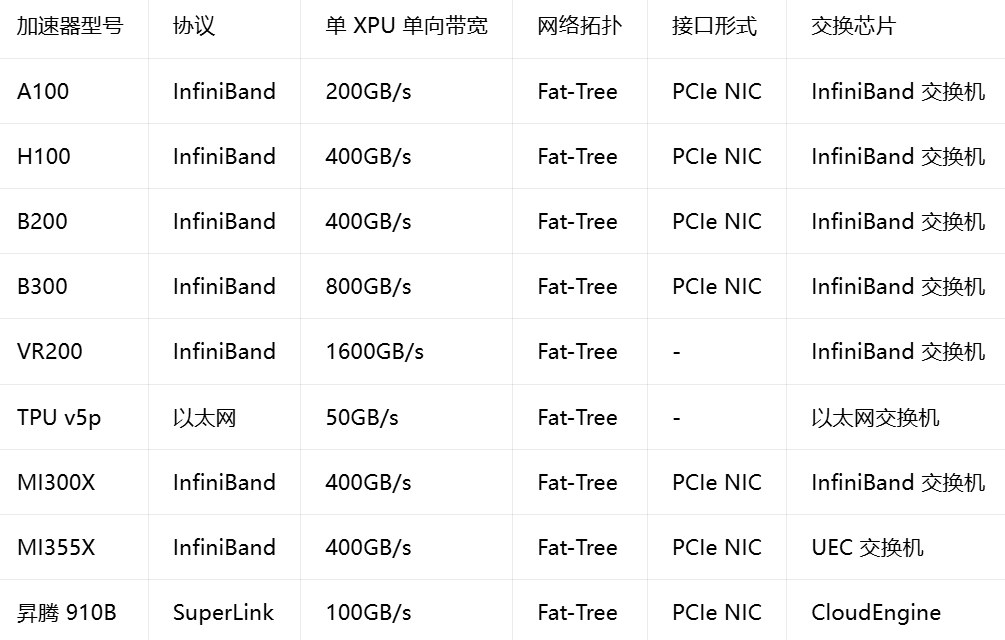
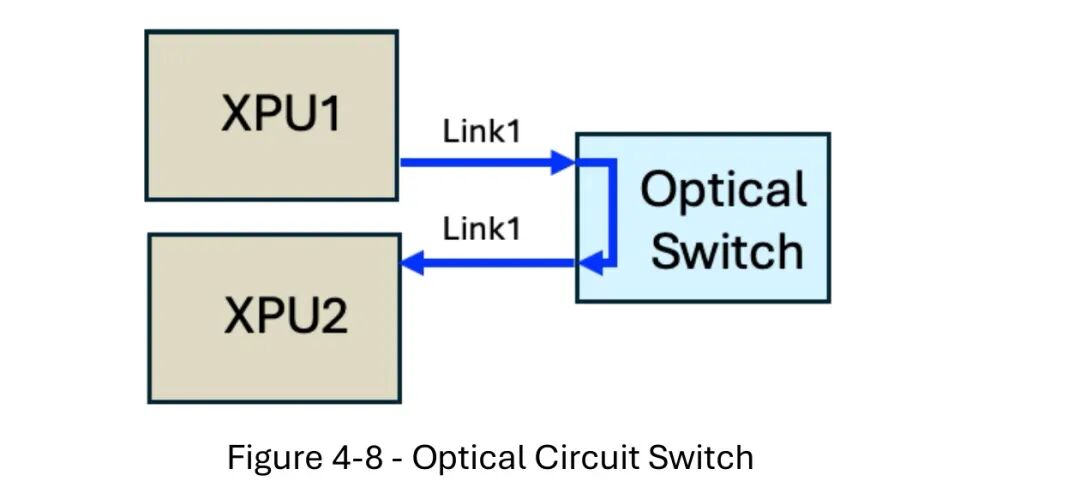
Scale-Up网络的终极目标是构建“虚拟单GPU”,让整个集群的内存与算力对上层软件透明,因此其性能直接决定了AI集群的实际算力利用率。 在交换技术层面,Scale-Up场景存在两条技术路线: - 电交换:将光链路在交换机处终结为电信号,通过交换芯片转发,技术成熟但会引入额外功耗与时延;
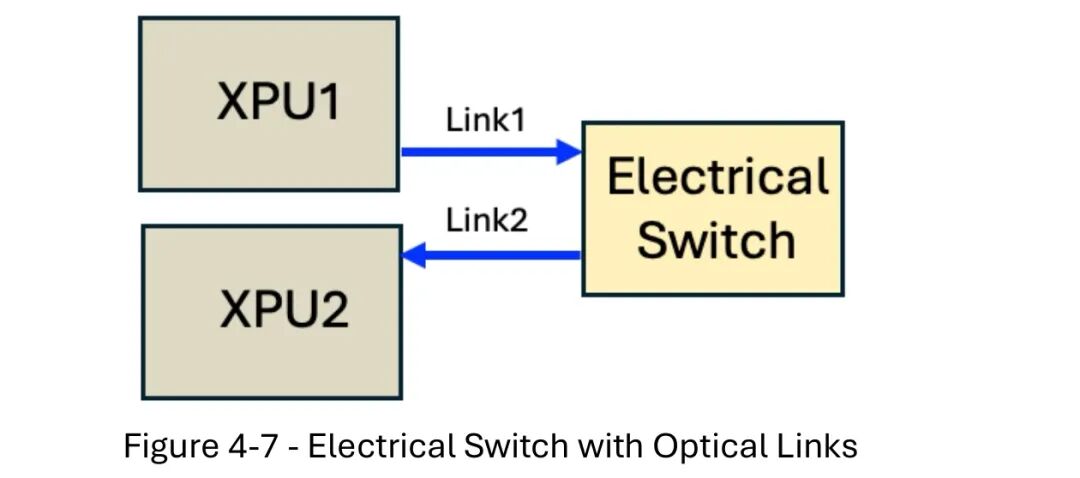
- 光交换(OCS):光信号直接通过光开关完成路径切换,无需光电转换,天生具备低时延、零交换功耗的优势,可实现动态光纤级拓扑重构。
白皮书对比了五类OCS技术的核心参数:
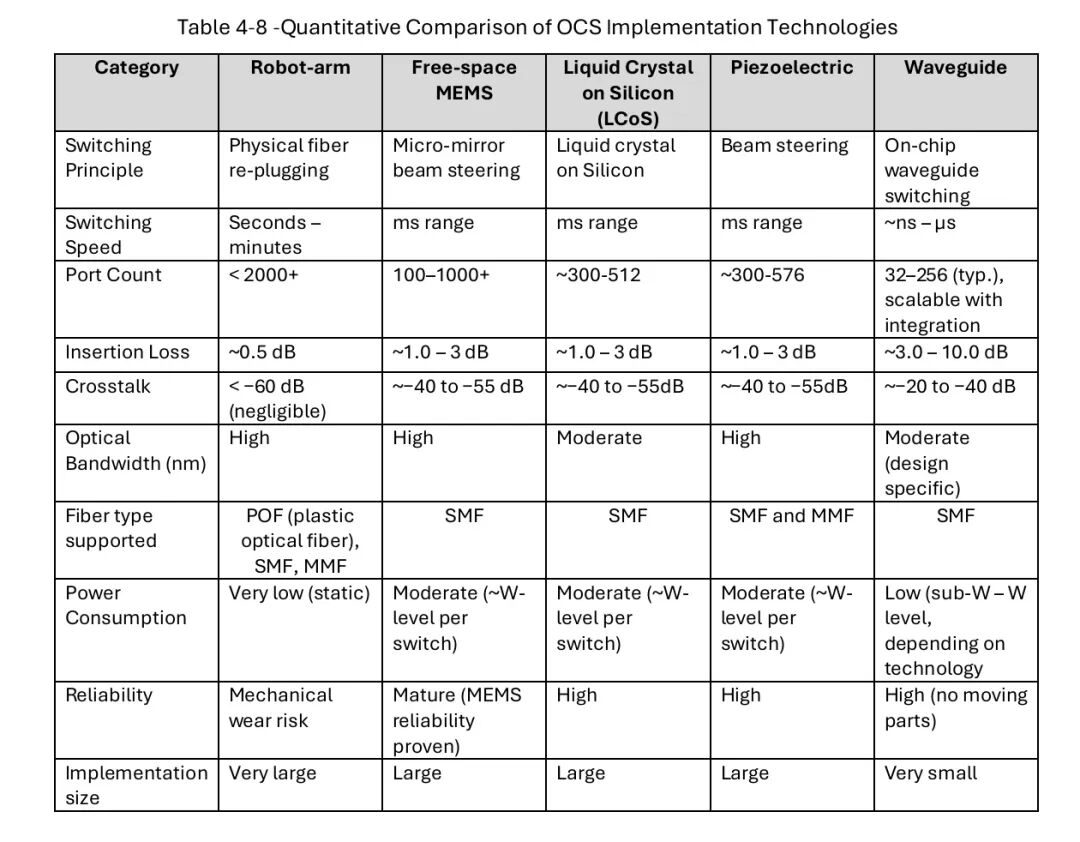
- 机械臂式:秒级切换,插入损耗 < 0.5dB,串扰 <-60dB,体积大;
- 自由空间 MEMS:毫秒级切换,插入损耗 1~3dB,串扰 - 40~-55dB,技术成熟;
- 硅基液晶(LCoS):毫秒级切换,插入损耗 1~3dB,支持多波长;
- 压电式:毫秒级切换,串扰可达 - 50dB;
- 波导型:纳秒~微秒级切换,插入损耗 3~10dB,体积最小,适合细粒度动态重构。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-31,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号