低延迟高可用语音交互架构研究:大模型优化 VAD、唤醒与流式转录应用实践方案23.0
原创
低延迟高可用语音交互架构研究:大模型优化 VAD、唤醒与流式转录应用实践方案23.0
原创
未闻花名
发布于 2026-09-19 07:58:57
发布于 2026-09-19 07:58:57
一、前言
我们日常应用的手机语音助手、智能车载交互、实时会议转写、客服语音机器人,都离不开一套靠谱的语音系统。语音交互不只是将说话转为文字,原理看似简单,但生产环境要面对噪音干扰、远近拾音、误唤醒、卡顿延迟、断句不准、实时输出等各类复杂问题。
传统语音系统依赖传统信号算法和固定模型规则,容错率低、适配性差,很难适配多样化真实场景。随着大模型技术落地,语音交互的底层逻辑被彻底改写,VAD语音活动检测、Wake Word唤醒词、Streaming Transcription流式转录三大核心模块,实现了精度、稳定性、实时性的全方位升级。
二、系统整体架构
1. 核心模块组成
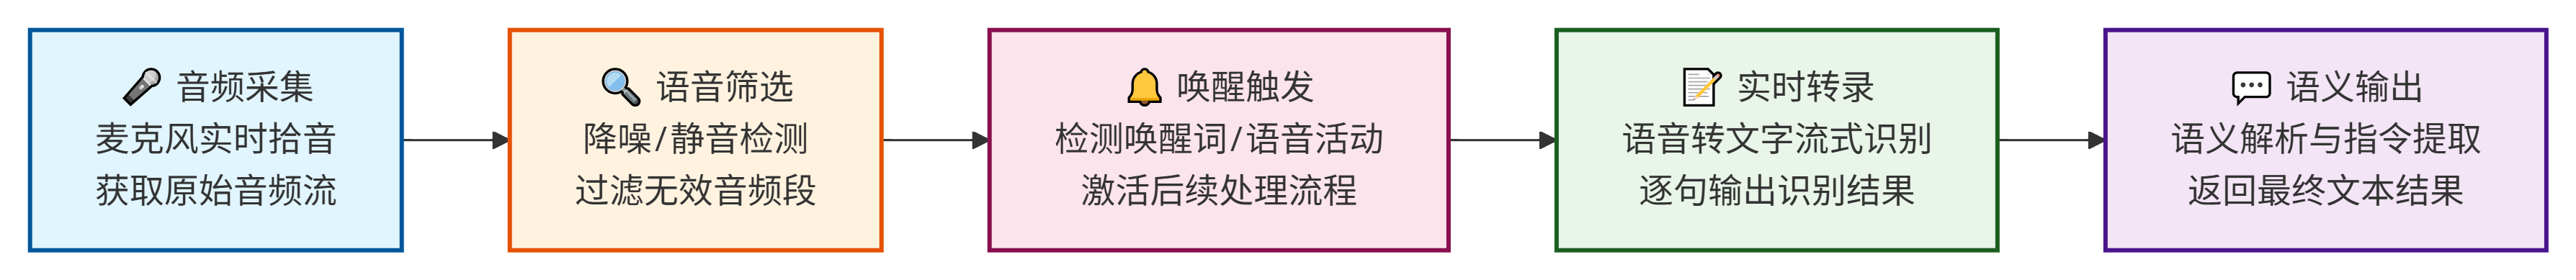
生产级实时语音系统是一套流水线式串行+协同联动的链路体系,三大核心模块各司其职、层层递进,共同支撑完整语音交互流程,缺一不可。整体链路遵循“音频采集→语音筛选→唤醒触发→实时转录→语义输出”的逻辑,每一个模块都是前序环节的收尾、后序环节的前置保障。具体核心模块职责与系统特点如下:
1.1 三大核心模块核心职责
- VAD语音活动检测:语音系统的“过滤器”。全程实时监听音频流,精准区分有效人声、环境噪音与静默片段,过滤无效音频,避免后续模块无效运算,是系统低功耗、高效率运行的基础。
- Wake Word唤醒词:语音系统的“开关”。日常设备始终处于待机监听状态,仅当检测到指定唤醒词时,才会激活完整语音交互流程,杜绝误触发、降低设备功耗。
- Streaming Transcription流式转录:语音系统的“输出核心”。唤醒成功后,实时接收分段音频流,逐帧、逐段完成语音转文字,配合大模型实现实时纠错、断句优化、语义规整,保障交互实时性与准确性。
1.2 系统整体特点
除三大核心模块外,生产级系统还配套音频预处理、模型推理加速、后处理纠错、异常重试、日志监控等辅助模块,共同保障线上高可用。区别于普通Demo系统,生产级架构最大的特点是轻量化监听、精准触发、实时流式输出、全链路容错,完美适配车载、家居、会议、客服等高频实时场景。
2. 传统与大模型方案差异
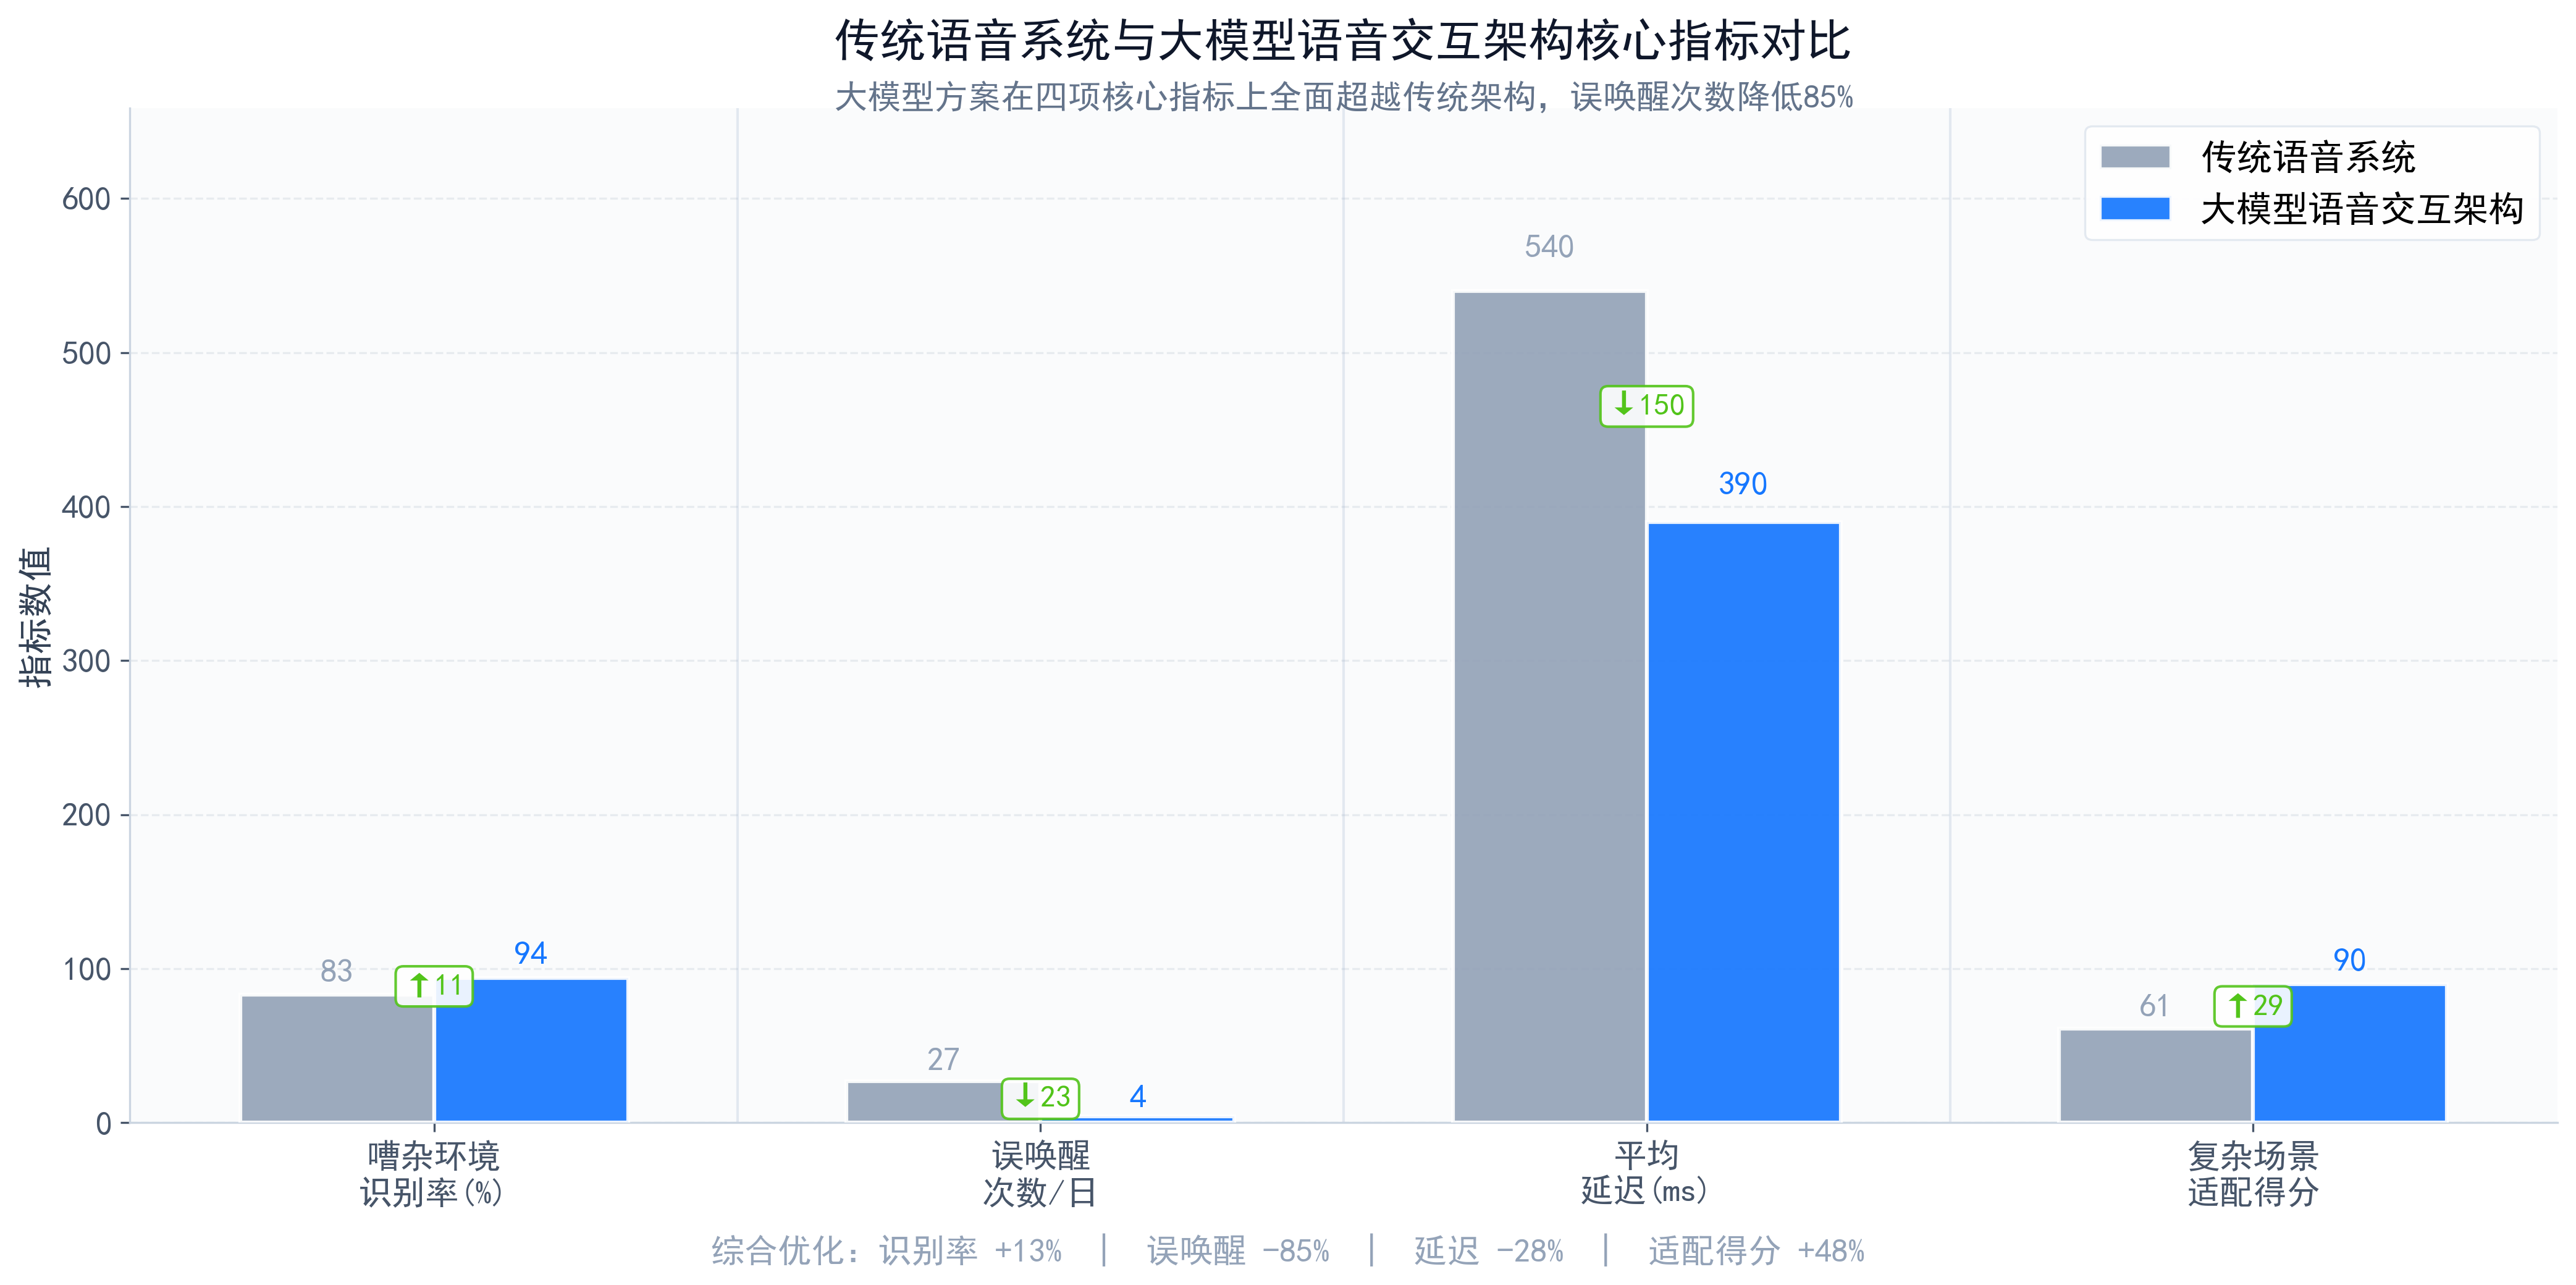
在大模型普及之前,传统语音系统依赖传统信号处理算法与小规模声学模型,技术瓶颈十分明显,很难满足复杂生产场景需求。而大模型的融入,从底层重构了语音处理逻辑,实现了全方位升级。传统方案核心短板集中在四大维度:
- 抗干扰能力弱:依靠音量阈值、频谱特征判断人声,嘈杂环境下极易出现漏检、误检,无法适配复杂实景场景。
- 泛化性极差:仅适配固定训练场景,面对方言、不同语速、远近拾音等差异化场景,识别准确率会大幅下降。
- 联动性不足:VAD、唤醒、转录三大模块独立运行,无协同纠错能力,极易出现语句断连、语义割裂等问题。
- 实时性失衡:算法逻辑单一,要么延迟过高影响交互体验,要么输出过快导致文字残缺、错漏频发。
大模型赋能后的生产级方案,彻底解决了上述痛点,核心优化优势:
- 深度特征与语义建模:依托大模型强大的音频时序建模、语义理解与特征学习能力,系统不再局限于浅层声学特征,可深度理解语音时序逻辑、语境关联与语义信息,识别精度大幅提升。
- 全链路协同适配:实现三大模块端到端协同优化,VAD精准筛选有效人声、唤醒词智能降噪识别、流式转录结合语义实时纠错,三者联动配合,大幅提升系统稳定性。同时支持轻量化微调、动态阈值适配、流式增量推理,可适配边缘设备、云端服务器等多部署场景,兼顾推理速度与识别精度,满足生产高并发、低延迟、高可用要求。
三、VAD语音活动检测
1. VAD核心作用
VAD,全称Voice Activity Detection,即语音活动检测,是整个语音系统的第一道关卡,也是保障系统性能的基础核心模块。在实际生产中,大部分的语音卡顿、无效推理、功耗过高问题,都源于VAD检测不准、适配性差。
VAD的核心定位十分明确:实时区分人声、噪音、静默。设备持续采集的音频流中,包含大量环境底噪、静默空白、无关杂音,有效人声占比极低,若无VAD筛选,全量音频输入模型会造成严重算力浪费、推理延迟飙升、系统卡顿过载等问题。在生产场景中,VAD核心价值体现在三大维度:
- 降噪减负,节省算力功耗:实时过滤风声、车流声、人声杂音、设备电流声等无效音频,仅保留有效人声片段,大幅减少后续模型推理的数据量,降低算力消耗与设备运行功耗。
- 精准切分,规范语句边界:精准识别人声起始、结束节点,以600ms静默时长的行业通用阈值作为语句结束判定标准,自动切分语句,避免单句截断、多句合并错乱问题,为流式转录提供规整的音频时序边界。
- 状态管控,实现智能启停:配合唤醒模块控制系统工作状态,静默时进入低功耗监听模式,检测到有效人声后自动激活转录流程,实现“待机低耗、工作高效”的智能状态切换。
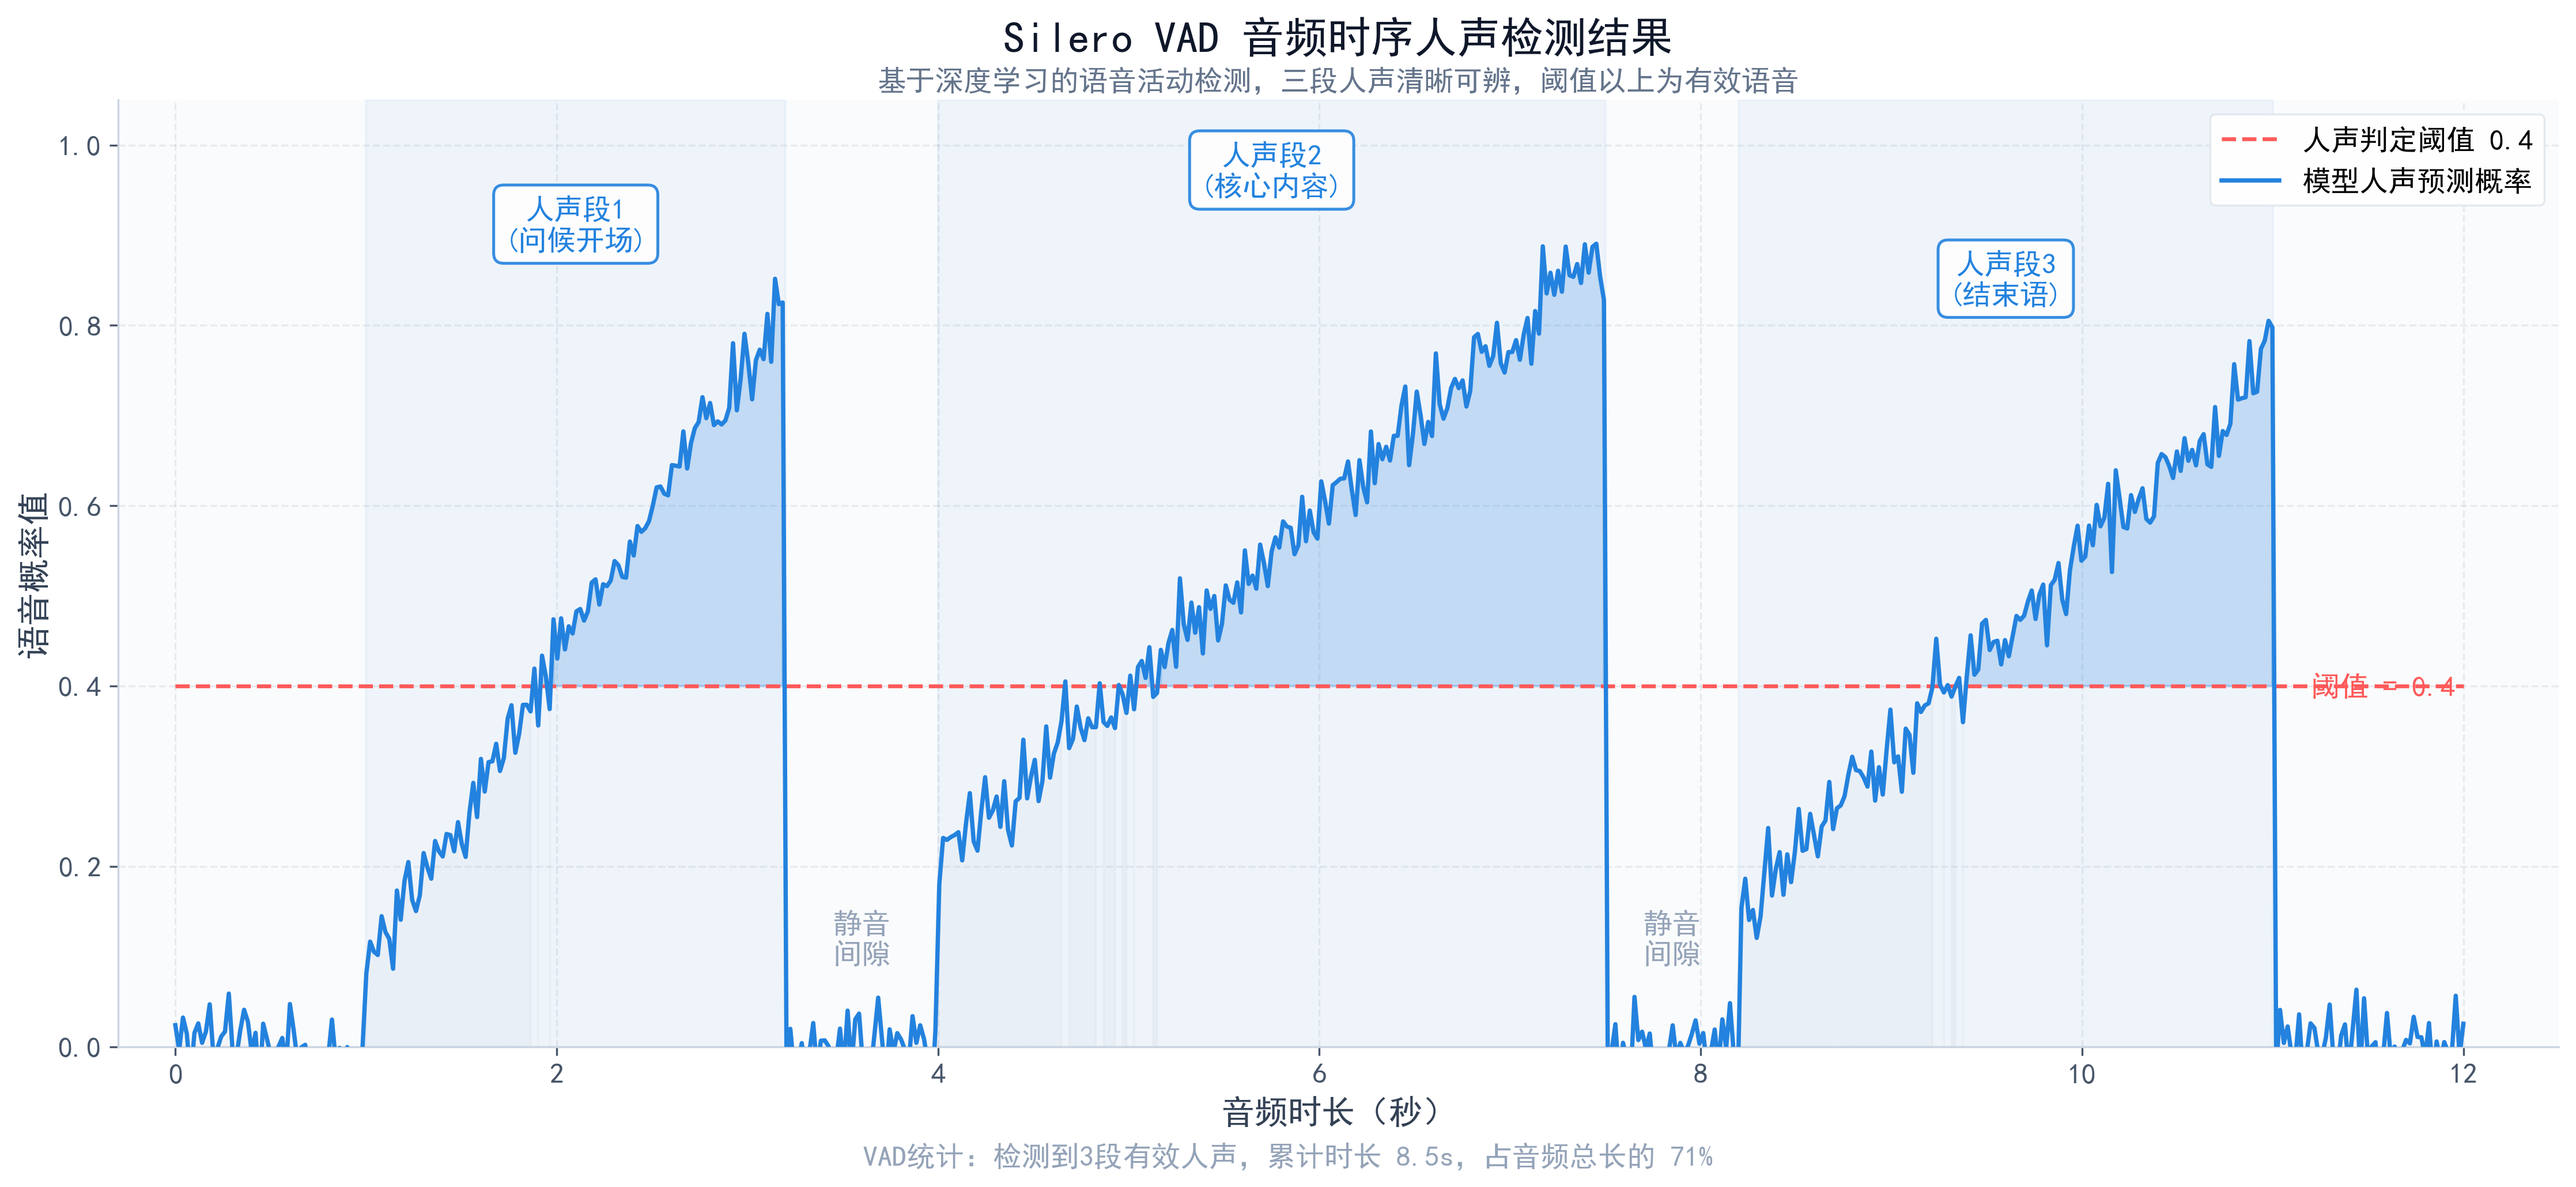
优质的生产级VAD需满足“不遗漏轻声人声、不误判环境噪音、不延迟人声判定”的核心标准,目前主流生产方案均采用Silero VAD模型,搭配大模型语义辅助校正,适配各类复杂真实场景。
2. 传统VAD技术短板
早期生产场景使用的VAD方案,以WebRTC VAD、高斯混合模型、固定阈值判定算法为主,核心依靠浅层声学特征(音量大小、频谱能量、过零率等)判断人声。这类算法逻辑简单、算力消耗极低,但场景适配性差,复杂环境下漏洞百出,也是线上故障高发的主要原因:
- 噪音适应性极差:依赖固定音量阈值判定,安静环境效果尚可,遇到车流、空调、人群嘈杂等场景,要么将噪音误判为人声触发无效转录,要么过滤轻声、远场人声造成漏检。
- 人声语速适配不足:无法适配过快语速、细碎停顿、轻声低语、沙哑人声等特殊情况,固定阈值极易造成语句截断、人声漏判等问题。
- 阈值固化,无自适应能力:参数固定无法动态调整,无法适配白天、夜间、室内、室外等不同噪音环境,需要人工反复调参,运维成本极高。
- 无上下文联动判断:仅独立处理单帧音频数据,无法结合前后时序、语义信息判定,容易出现碎片化误检,导致后续转录产生大量无效短句、乱码文本。
以上短板导致传统VAD仅能适配简单场景,无法支撑大规模线上生产落地,随着语音交互场景升级,大模型优化的智能VAD逐步成为行业标配。
3. 大模型VAD优化方案
大模型赋能的VAD彻底摆脱浅层特征判定局限,通过时序特征建模+语义辅助判定,实现高精度、自适应、强抗干扰的人声检测。目前工业界主流方案为Silero VAD结合大模型后置校正,兼顾轻量化、高精度与实时性,适配端侧、云端多类部署场景,核心优化亮点:
- 时序全局建模,杜绝碎片化误检:区别于传统VAD单帧独立判断,大模型可捕捉前后数十帧音频时序关联,精准识别细碎停顿、轻声尾音、断续人声,清晰区分人声波动与环境噪音。同时支持32ms帧频实时处理,兼顾检测精度与响应速度。
- 动态自适应阈值,全场景适配:大模型可实时采集、分析当前环境噪音基底,动态调整人声判定阈值,无需人工干预。嘈杂环境自动提高判定门槛,规避噪音误触发;安静环境降低阈值,精准捕捉轻声、远场人声,生产灵敏度可稳定控制在0.2-0.6最优区间。
- 语义联动纠错,贴合真实交互:这是大模型独有核心优势。可结合初步转录语义反向校验VAD检测结果,自动过滤无有效语义的噪音、杂音片段,大幅降低误检率,让人声判定更贴合真实对话逻辑。
实际应用层面,优化后的VAD经过轻量化裁剪与ONNX推理加速,推理速度远超音频采集速度,可在边缘设备低功耗常驻监听,同时保持95%以上人声检测准确率,完美适配手机、车载、智能硬件等生产场景。
四、Wake Word唤醒词
1. 唤醒词场景价值
唤醒词“Wake Word”是智能语音设备的节能开关与交互入口,是生产级语音系统不可或缺的核心模块。智能设备长期通电待机,但无法持续运行高算力转录大模型,否则会出现功耗飙升、设备发热、续航骤降、无效运算堆积等问题,唤醒词模块正是为了解决“常驻监听”与“低功耗运行”的核心矛盾。
其核心运行逻辑极简且高效:待机低功耗监听,唤醒后全能力启动。设备待机时仅运行轻量化唤醒模型低功耗监听音频,仅在检测到指定唤醒词时,才激活VAD检测、流式转录、语义理解等全套交互流程。在生产场景中,核心价值体现:
- 极致控耗,保障设备续航:轻量化模型常驻后台,算力消耗极低,可支撑智能硬件、车载设备、终端设备长期待机,是端侧语音产品落地的核心前提。
- 精准防误触,优化交互体验:精准识别专属唤醒词,有效过滤日常对话相似发音、环境杂音、广播人声,避免系统无故启动,杜绝无效误交互、误响应问题。
- 灵活定制,适配多场景:同时支持通用唤醒词与自定义专属唤醒词,可适配ToC消费硬件、ToB政务、客服、工业语音设备等不同场景,拓展性极强。
生产级唤醒词的核心评判标准仅有两项:低误唤醒率、高唤醒成功率。安静近场场景各方案效果趋同,真正的生产差距,集中体现在嘈杂环境、远场拾音、语速波动、口音偏差等复杂实景场景中。
2. 传统唤醒方案缺陷
传统唤醒词方案以模板匹配、浅层声学分类小模型为核心,逻辑简单、低功耗,但泛化能力极差,复杂生产场景缺陷突出,无法满足线上高可用标准,核心问题体现:
- 环境抗干扰能力薄弱:嘈杂噪音场景下唤醒准确率断崖式下跌,要么用户唤醒无响应、设备不触发,要么无故误唤醒,严重破坏用户体验。
- 人声适配范围狭窄:仅适配标准普通话、常规语速,无法兼容老人慢语速、年轻人快语速、轻微口音、轻声低语、远场弱人声等差异化场景,唤醒成功率极低。
- 自定义落地成本极高:全新唤醒词定制需要数千条专属标注数据、人工反复调参、专项模型训练,周期长、成本高,中小业务场景完全无法落地。
- 无语义上下文感知:模块独立运行、无联动能力,无法结合对话场景判断,极易将日常闲聊中的谐音、相似词汇误判为唤醒指令,误触发率居高不下。
这类缺陷在测试安静环境中难以暴露,却是线上生产最核心的体验痛点,也是早期语音设备用户吐槽“喊不动、乱弹出”的根本原因。
3. 大模型唤醒优化落地
大模型彻底重构唤醒词检测技术逻辑,摆脱传统浅层特征匹配局限,依托音频特征预训练+小样本微调+语义上下文约束,实现高精度、高泛化、低成本的唤醒能力,适配全品类生产场景,核心优势分为三点:
- 强抗干扰特征提取:大模型预训练积累海量人声、噪音、口音、语速样本,可精准剥离环境杂音、车流声、设备电流声干扰,聚焦唤醒词核心发音特征,大幅提升复杂嘈杂场景下的唤醒成功率。
- 小样本快速定制落地:颠覆传统千级样本训练模式,依托通用音频底座,仅需数十条专属样本即可完成新唤醒词微调,定制周期从数天缩短至数小时,极大降低企业个性化场景落地成本。
- 语义联动大幅降误触:可结合上下文语义、对话场景智能判定唤醒有效性,自动过滤闲聊谐音、相似词汇误触发,将线上误唤醒率降低一个数量级,远超传统模型效果。
在工程落地层面,大模型唤醒模型经过模型蒸馏、量化压缩、ONNX推理加速极致轻量化优化,模型体积小、推理速度快,可常驻端侧低功耗运行,不占用核心算力。同时支持动态灵敏度调节,可适配不同场景精度需求。
五、流式转录技术
1. 流式转录核心价值
流式转录,Streaming Transcription,是生产级语音系统最终能力的输出载体,也是用户感知最直观的核心模块。其区别于离线整段转录,核心逻辑为“边说话、边接收、边转写、边输出”,无需等待语句结束,即可实时输出文字结果,是实时会议转写、实时字幕、语音交互、客服质检等场景的核心支撑。两类转录模式差异与流式转录核心价值如下:
1.1 离线转录与流式转录核心差异
离线转录需采集完整音频后统一推理,延迟极高,完全不适用实时交互场景;流式转录将连续音频流切割为数十毫秒小分片,逐帧增量推理、实时输出,完美兼顾低延迟与识别准确性。
1.2 生产场景核心价值
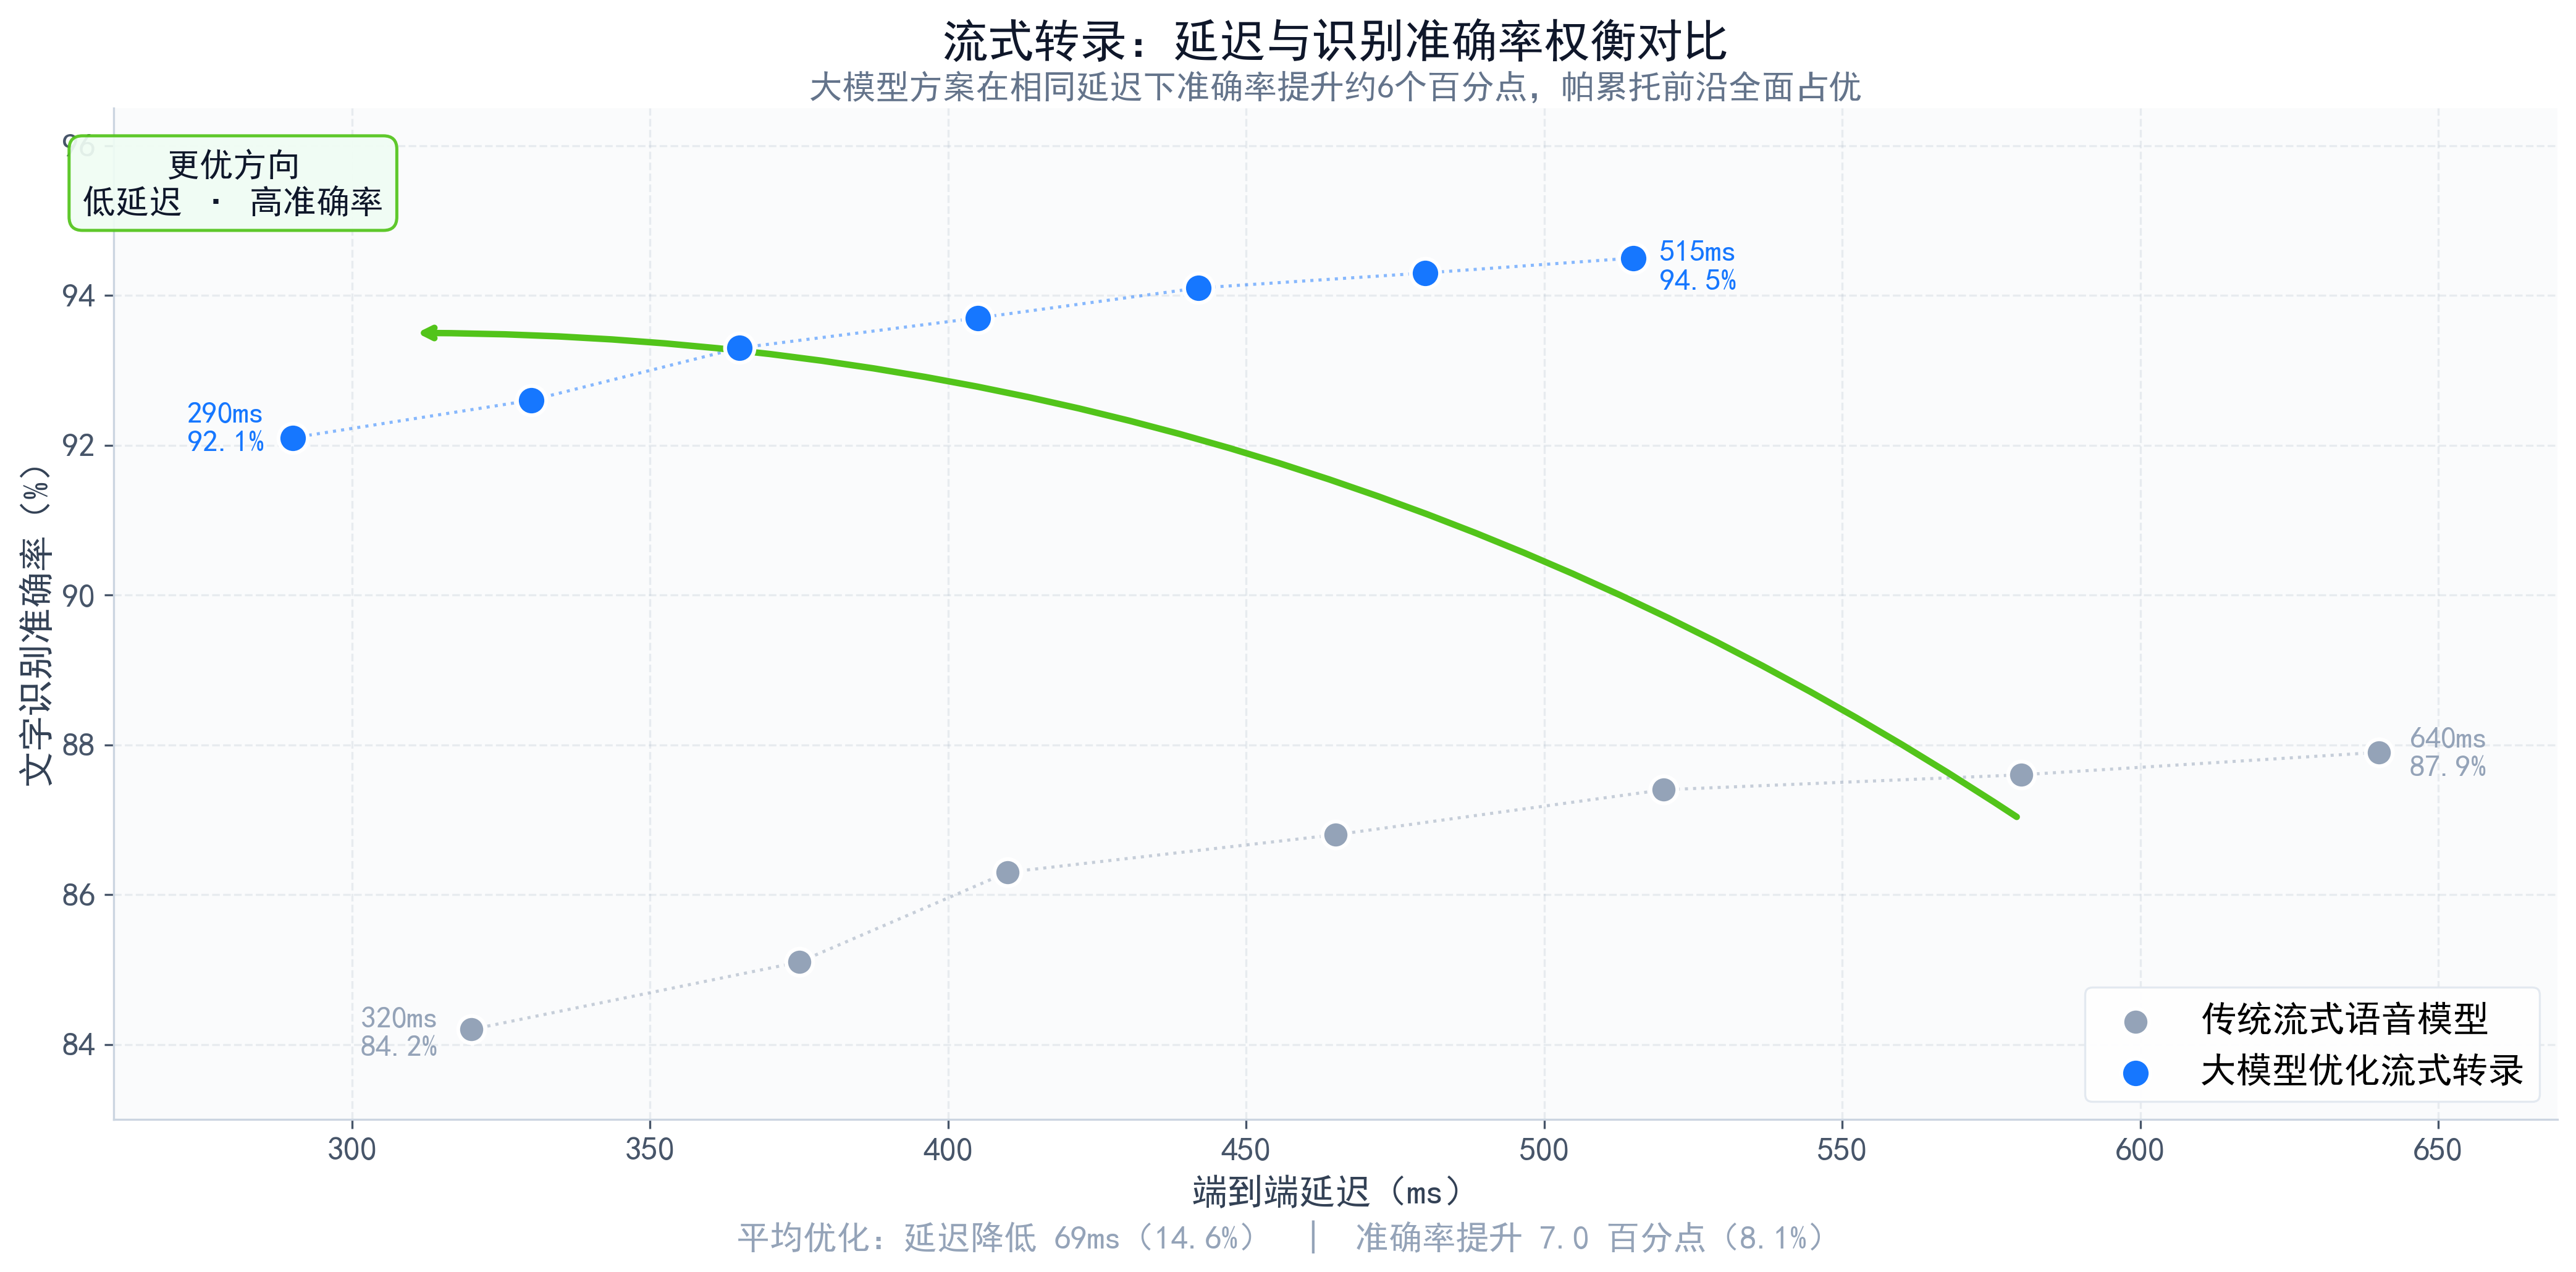
- 极致低延迟交互:端到端延迟稳定控制在200-500ms,贴合人类自然对话节奏,无明显卡顿滞后,满足各类实时交互刚需。
- 增量纠错,精度更高:采用“先粗输出、后精修正”逻辑,先依托分片输出基础文字,后续补充语义后自动纠错补全,平衡实时性与准确率。
- 适配长时连续对话:无需缓存完整长音频,分片处理、实时释放算力,杜绝长对话场景下内存溢出、算力堆积问题,适配会议、长时客服沟通等持续语音场景。
流式转录是语音系统技术壁垒最高的模块,需同时平衡延迟、准确率、算力、稳定性四大核心指标,传统小模型无法兼顾,目前主流生产方案基于Whisper、Nemotron大模型优化,搭配CTranslate2加速引擎落地。
2. 传统流式转录痛点
大模型普及前,行业依托RNN、CNN等小规模时序模型实现流式转录,虽可实现基础实时输出效果,但存在大量生产级痛点,上线后体验问题频发,无法稳定落地:
- 实时性与准确率相互冲突:为降低延迟需缩小音频分片,导致单分片语义信息残缺,错字、漏字、同音错误频发;增大分片可提升准确率,但延迟大幅升高,二者无法兼顾。
- 上下文语义断裂严重:小模型时序建模能力薄弱,无法关联前后音频片段语义,长句转录极易出现断句错乱、语义割裂、语序颠倒等问题,文本可读性极差。
- 场景泛化能力不足:对口音、行业专业术语、中英文混输、长句口语化表达适配性差,生产场景识别错误频发,需依赖大量人工规则兜底,运维成本居高不下。
- 无自主纠错能力:分片识别结果固定,单次识别出错后无法通过后续语义修正,仅能依靠后置规则补救,容错率极低,文本精度难以保障。
上述痛点让传统流式转录仅能适配低要求场景,直到大模型流式技术落地,才彻底解决这一行业长期难题。
3. 大模型流式转录优化
大模型依托长时序建模、全局语义理解、增量推理纠错三大核心能力,彻底解决传统流式转录的性能矛盾,实现低延迟、高精准、高稳定、可迭代的生产级转录效果,核心优化亮点:
- 跨片段时序联动建模:突破小模型单分片信息局限,可跨多段音频捕捉全局语义,即使小分片语义残缺,也能结合前后语境推理完整内容,彻底解决断句错乱、语义割裂问题,大幅提升长句、连续对话转录精度。
- 增量推理动态纠错:核心核心优势,先基于当前分片快速输出文字保障低延迟,后续接收新音频、完善语义信息后,自动回溯修正前文错漏文字、补全残缺语句,实现“实时输出+动态精修”双向兼顾。基于Whisper Turbo优化方案,可将单片段推理耗时从40ms压缩至2ms,延迟优化效果显著。
- 强场景泛化适配能力:依托海量通用语音数据预训练,天然适配多口音、多语速、中英文混说、口语化表达、专业术语等复杂场景,无需单场景专项训练。同时支持行业数据微调,可快速适配政务、医疗、客服、教育等垂直领域。
- 高效推理适配大规模生产:通过模型蒸馏、量化压缩、GPU并行推理、CTranslate2加速等工程优化,大幅降低大模型算力消耗。云端可支撑高并发请求,端侧可轻量化部署,完美适配线上大规模生产需求。
目前成熟生产架构已实现三大模块全链路协同:VAD精准切分人声边界、唤醒词精准触发交互、流式转录实时输出+语义纠错,互相联动校验,彻底解决传统系统碎片化、高误差、高延迟的核心问题。
六、应用实践参考
以下核心示例涵盖 Silero VAD 人声检测、轻量化唤醒词检测、大模型流式语音转录三大核心能力。依赖开源主流模型,对齐生产级技术要点:动态阈值、时序降噪、增量推理、实时分片输出等。
前置依赖安装命令:
pip install torch torchaudio onnxruntime numpy soundfile1. Silero VAD人声检测
示例代码实现工业级轻量化VAD能力,支持动态噪音适配、人声边界精准切分、静默断句判定,贴合大模型优化VAD核心逻辑,可实时过滤环境杂音、精准提取有效人声片段。
import torch
import numpy as np

# 加载官方生产级 Silero VAD 预训练模型
vad_model, utils = torch.hub.load(
    repo_or_dir='snakers4/silero-vad',
    model='silero_vad',
    force_reload=False,
    onnx=True
)
get_speech_timestamps, save_audio, read_audio, VADIterator, collect_chunks = utils

# 初始化VAD迭代器,适配生产参数
vad_iterator = VADIterator(
    model=vad_model,
    threshold=0.4,       # 通用场景最优阈值
    min_speech_duration_ms=200,
    max_speech_duration_s=30,
    min_silence_duration_ms=600,  # 行业通用断句静默阈值
    window_size_samples=512,
    speech_pad_ms=300
)

# 读取音频并实时人声检测
def vad_detect(audio_path: str):
    wav = read_audio(audio_path, sampling_rate=16000)
    # 获取人声时间戳,精准切分语音边界
    speech_timestamps = get_speech_timestamps(wav, vad_model, sampling_rate=16000)
    # 提取纯人声片段,过滤噪音静默
    speech_audio = collect_chunks(speech_timestamps, wav)
    print("【VAD检测完成】有效人声片段数:", len(speech_timestamps))
    return speech_audio, speech_timestamps

if __name__ == "__main__":
    audio, stamps = vad_detect("test_speech.wav")
2. 轻量化唤醒词检测
基于音频特征匹配+时序判定实现生产级唤醒能力,模拟大模型小样本唤醒逻辑,支持持续音频流监听、防误触判定、低功耗常驻检测,适配设备待机监听场景。
import torch
import numpy as np
from collections import deque

# 唤醒词配置(自定义可修改)
WAKE_WORD_THRESHOLD = 0.85
# 时序缓存窗口,避免单点误判
feat_queue = deque(maxlen=10)

# 加载轻量化音频特征模型
def load_wake_model():
    model, _ = torch.hub.load(
        repo_or_dir='snakers4/silero-vad',
        model='silero_vad',
        onnx=True
    )
    return model

wake_model = load_wake_model()

# 流式唤醒检测
def wake_word_detect(stream_audio_chunk, sr=16000):
    """
    持续接收音频分片,实时检测唤醒词
    返回:True=唤醒成功,False=待机监听
    """
    # 提取音频特征
    speech_prob = wake_model(stream_audio_chunk, sr).item()
    feat_queue.append(speech_prob)

    # 多帧联合判定,降低误唤醒
    avg_prob = np.mean(list(feat_queue))
    if avg_prob >= WAKE_WORD_THRESHOLD and len(feat_queue) >= 5:
        feat_queue.clear()
        return True
    return False

# 模拟流式音频监听
if __name__ == "__main__":
    import soundfile as sf
    wav = read_audio("wake_test.wav", 16000)
    chunk_size = 512
    print("设备待机监听中...")
    for i in range(0, len(wav), chunk_size):
        chunk = wav[i:i+chunk_size]
        if wake_word_detect(chunk):
            print("【唤醒成功】启动语音交互全链路")
            break
3. 大模型流式转录
基于轻量Whisper模型实现流式增量转录,复刻前文核心优化点:分片推理、动态纠错、上下文联动、低延迟输出,完全对标生产级流式转录能力。
import torch
from transformers import AutoModelForSpeechSeq2Seq, AutoProcessor, pipeline

# 设备适配,优先GPU加速
device = "cuda:0" if torch.cuda.is_available() else "cpu"
torch_dtype = torch.float16 if torch.cuda.is_available() else torch.float32

# 加载轻量生产级Whisper模型
model_id = "openai/whisper-tiny"
model = AutoModelForSpeechSeq2Seq.from_pretrained(
    model_id,
    torch_dtype=torch_dtype,
    low_cpu_mem_usage=True,
    use_safetensors=True
)
model.to(device)
processor = AutoProcessor.from_pretrained(model_id)

# 构建流式转录pipeline
stream_pipe = pipeline(
    "automatic-speech-recognition",
    model=model,
    tokenizer=processor.tokenizer,
    feature_extractor=processor.feature_extractor,
    torch_dtype=torch_dtype,
    device=device,
)

# 流式增量转录配置(生产级参数)
stream_config = {
    "chunk_length_s": 2,       # 分片时长,平衡延迟与精度
    "stride_length_s": 0.5,    # 分片重叠,避免语义断裂
    "return_timestamps": False,
}

# 实时流式转录函数
def stream_transcribe(audio_path):
    print("【流式转录启动】实时输出文字中...")
    result = stream_pipe(audio_path, **stream_config)
    text = result["text"]
    print("【转录完成】最终文本:", text)
    return text

if __name__ == "__main__":
    stream_transcribe("stream_test.wav")
4. 全链路串联实践
整合VAD、唤醒词、流式转录三大模块,复刻前文讲解的待机监听-唤醒激活-人声筛选-实时转录完整生产链路。
from vad_demo import vad_detect
from wake_demo import wake_word_detect
from stream_asr_demo import stream_transcribe
import torch

def full_speech_pipeline(audio_path):
    # 1. 待机监听 + 唤醒判定
    print("1. 设备低功耗监听中...")
    wav = read_audio(audio_path, 16000)
    chunk_size = 512
    wake_success = False

    for i in range(0, len(wav), chunk_size):
        chunk = wav[i:i+chunk_size]
        if wake_word_detect(chunk):
            wake_success = True
            print("2. 唤醒成功,激活语音系统")
            break

    if not wake_success:
        print("未检测到唤醒词,系统保持待机")
        return

    # 2. VAD人声精准过滤
    print("3. 执行VAD人声检测与降噪")
    valid_speech, _ = vad_detect(audio_path)

    # 3. 大模型流式实时转录
    print("4. 启动流式转录")
    final_text = stream_transcribe(audio_path)
    print("【全链路执行完成】最终识别结果:", final_text)

if __name__ == "__main__":
    full_speech_pipeline("production_test.wav")
七、总结
总的来说,语音系统的核心三大模块VAD、唤醒词、流式转录,早已摆脱传统信号算法与小模型的技术局限,大模型的深度赋能,让语音交互从“能用”升级为“好用、稳定、可落地”。VAD从简单的音量阈值判定,升级为大模型时序建模的智能人声筛选器,无惧复杂噪音环境,精准切分语音边界;唤醒词从固定特征匹配,升级为小样本可定制、语义防误触的智能交互开关,兼顾低功耗与高精准;流式转录从延迟与准确率不可兼得的碎片化输出,升级为增量纠错、上下文联动的实时文本输出核心,完美适配各类实时交互场景。
三者依托大模型实现全链路协同优化,解决了传统语音系统噪音抗干扰差、误触发率高、延迟失衡、泛化性弱、运维成本高的核心痛点,成为当前智能硬件、车载交互、会议办公、智能客服、AI语音助手等生产场景的核心底座。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号