CrewAI 实战手记:我给 AI 排了个"值班班组",故障诊断和写周报都不用我操心
原创
CrewAI 实战手记:我给 AI 排了个"值班班组",故障诊断和写周报都不用我操心
原创
大盘鸡拌面
发布于 2026-09-19 21:24:22
发布于 2026-09-19 21:24:22
前一阵子的一个深夜,我盯着屏幕上一条 5xx 告警,突然冒出一个念头:要是我能像排班一样,给 AI 也排一个"值班班组"——班长负责调度,日志员负责翻日志,监控员负责看曲线,最后还有个文书负责写报告——那我不就能睡觉去了吗?后来我试了下 CrewAI,发现这事儿真能干,但坑也不少。这篇就把我的实战过程和踩的坑全摊开讲。
一、先搞清楚 CrewAI 是个啥,跟 AutoGen 有啥不一样
CrewAI 是一个开源的多智能体协作框架,GitHub 上 star 数一直很靠前。它的核心思路说白了就一句话:模拟一个真实公司的团队分工。
你给每个 AI 角色设定三样东西——职位(role)、目标(goal)、背景故事(backstory),然后把任务像派工单一样分配下去,最后由"班长"(Crew)来统筹执行顺序。
市面上同类的框架我基本都用过一轮,说说我的直观感受:
框架 | 核心思路 | 上手难度 | 适合场景 |
|---|---|---|---|
AutoGen | 多 agent 对话,聊着聊着把事办了 | 中 | 需要多个 agent 辩论、交叉验证的场景 |
LangGraph | 状态图 + 节点流转,像画流程图写代码 | 高 | 流程复杂、需要精细控制分支的场景 |
CrewAI | 角色扮演 + 任务流水线 | 低 | 有明确分工、按步骤执行的任务 |
我的结论是:如果你要干的事能描述成"谁负责什么、按什么顺序干",CrewAI 是三者里最省心的。它不追求花哨的对话机制,就是把"角色分工 + 任务编排"这件事做到顺手。
一个 CrewAI 项目的骨架长这样:
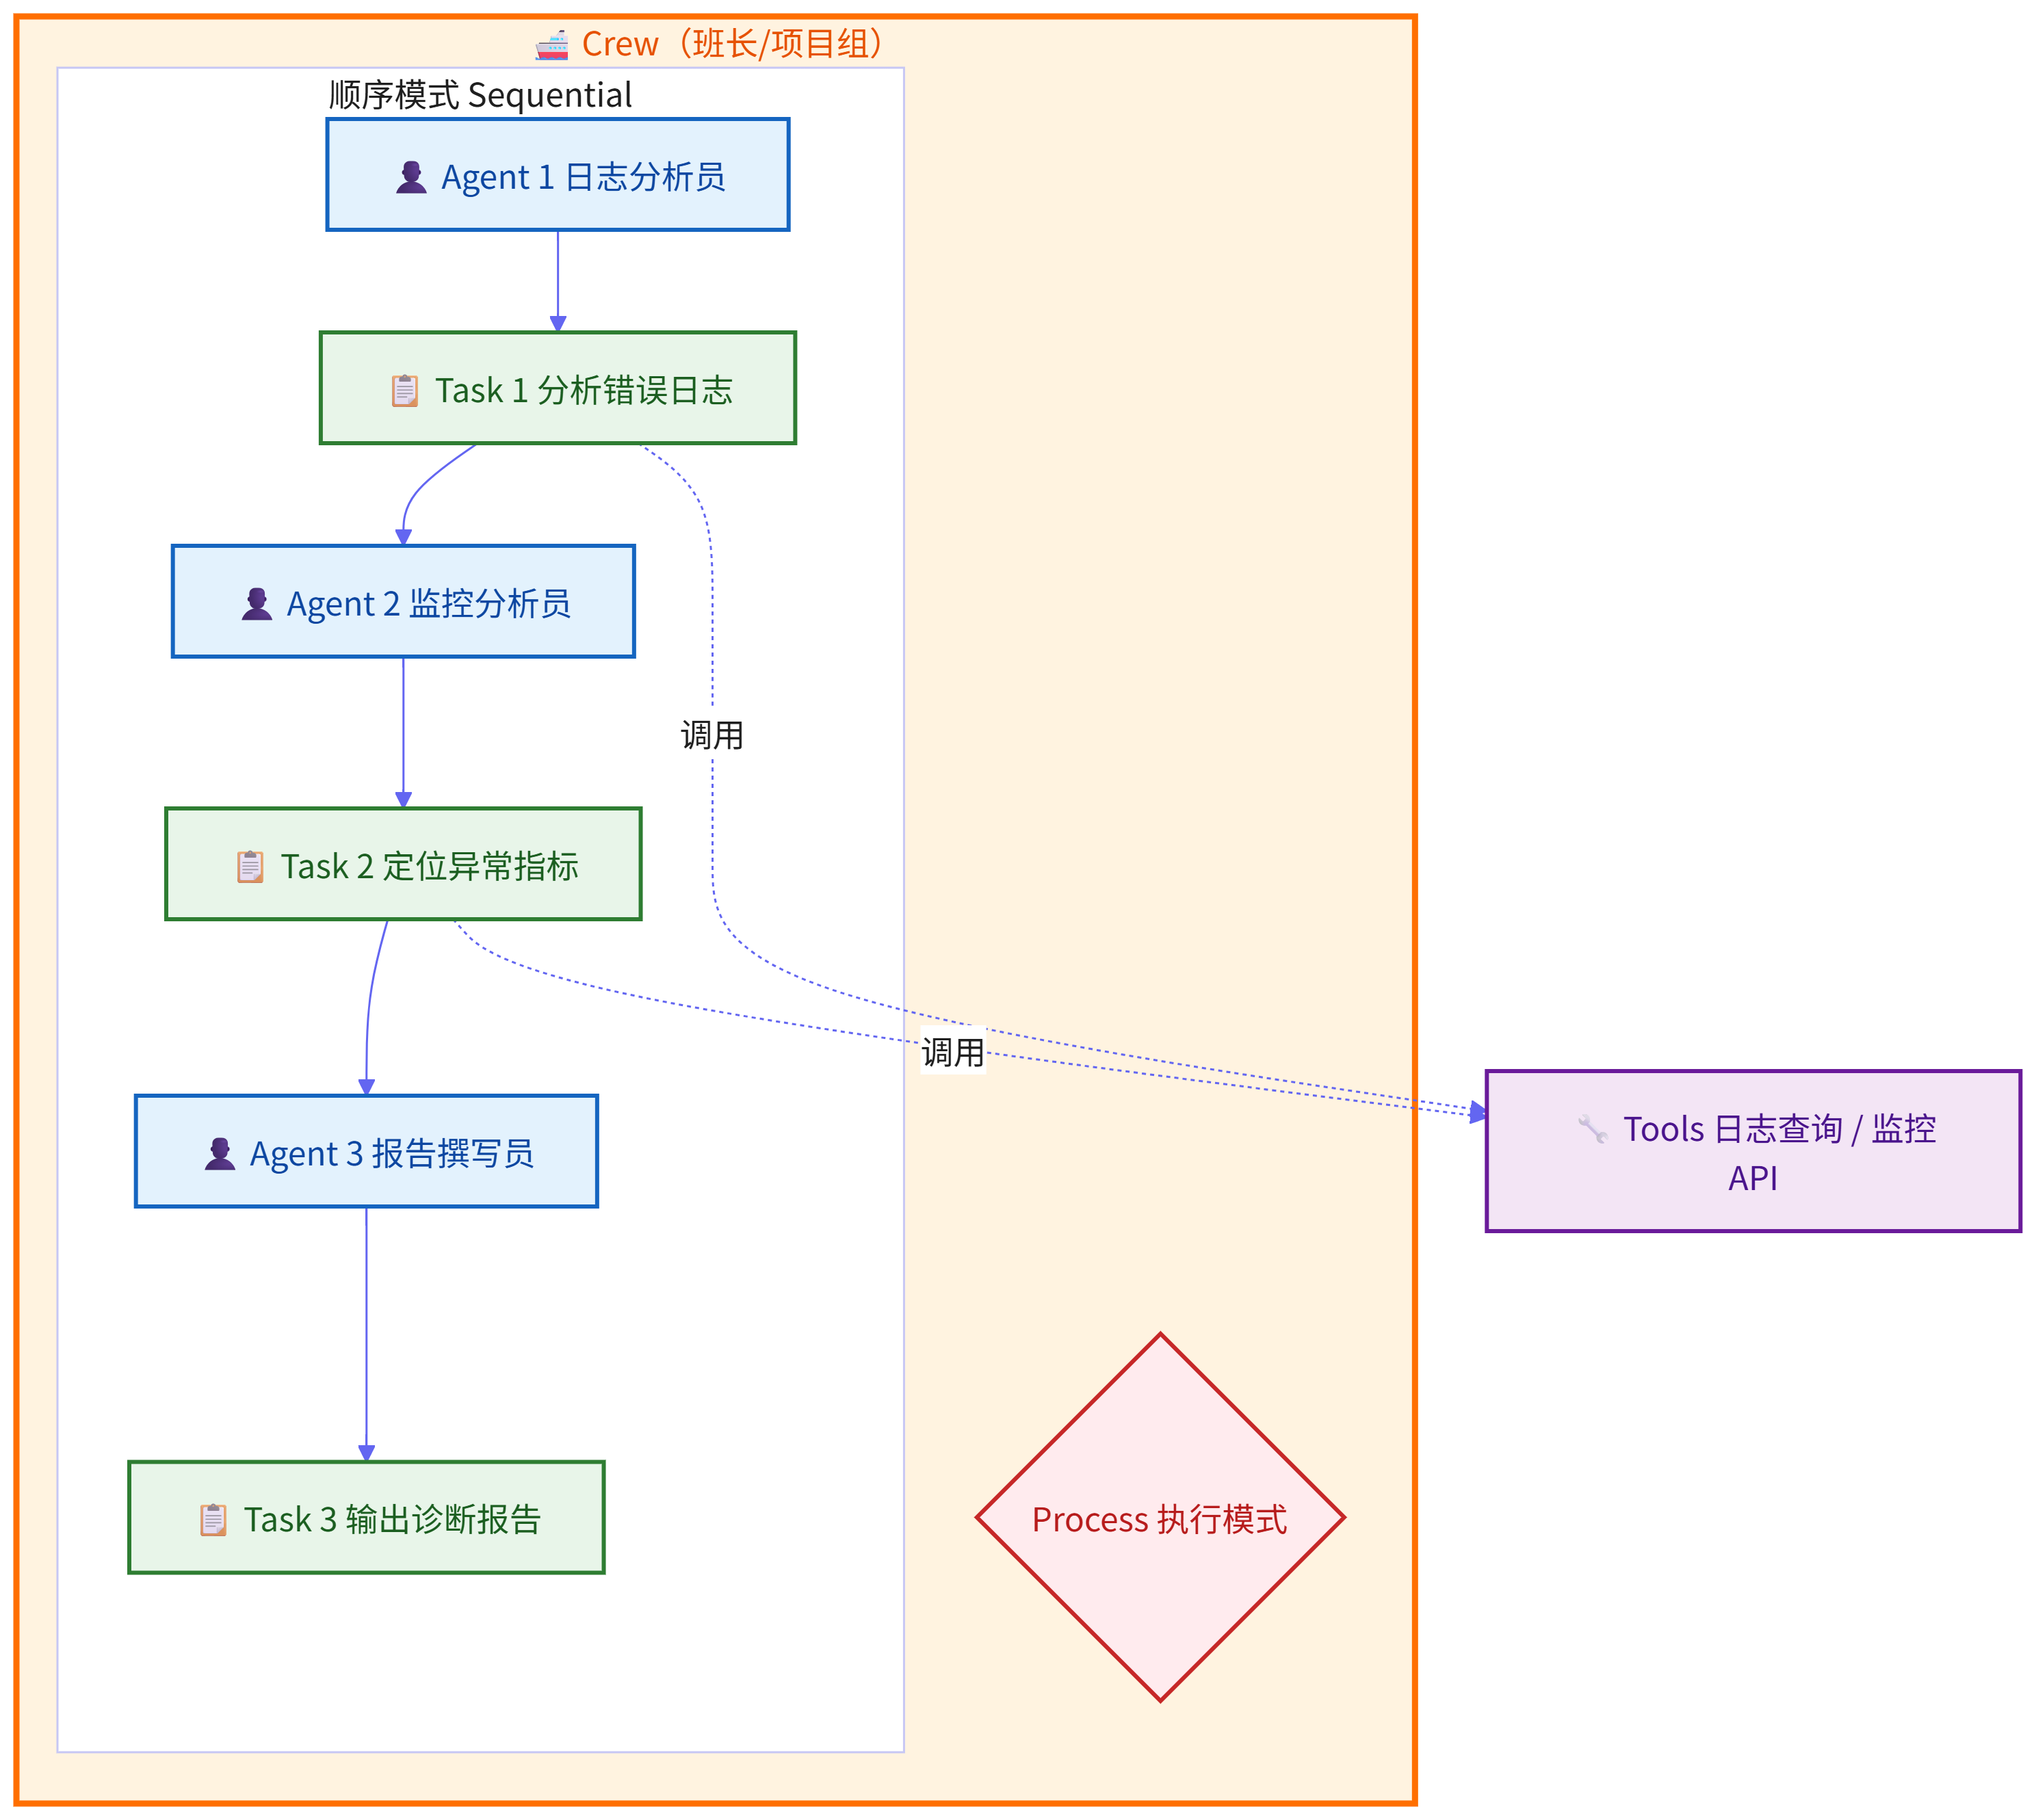
看明白了吧,Agent 是"人",Task 是"活",Tool 是"家伙什",Crew 是"项目组",Process 是"干活的路数"。下面我们直接上实战。
二、实战案例一:线上故障应急诊断班组
这是我真实在用的场景。背景是:我们的业务系统出 5xx 告警时,值班同学要手工做三件事——翻错误日志、看监控曲线、写初步诊断。整个过程快则十分钟慢则半小时,而且深夜值班的人经常是迷迷糊糊地下结论。
我的目标:告警一响,AI 班组自动跑一遍诊断,值班人睡醒看报告就行。
2.1 先定义两个"专业工具"
CrewAI 的 agent 自己不会查日志看监控,你得给它配工具。工具就是一个 Python 函数,你告诉 AI"这个工具是干嘛的、怎么用",它自己决定什么时候调。
from crewai_tools import tool
import requests
import json

@tool("错误日志检索工具")
def search_error_logs(keyword: str, minutes: int = 15) -> str:
    """根据关键词检索最近 N 分钟内的错误日志。
    输入参数:keyword 是检索关键词(如接口路径、异常类名),minutes 是时间范围(分钟)。
    返回格式化的日志摘要列表,包含时间戳、服务名、错误信息。"""
    # 实际生产中对接 ELK / Loki,这里是简化示例
    resp = requests.get(
        "http://loki.internal:3100/loki/api/v1/query_range",
        params={
            "query": f'{{job="app-logs"}} |= "{keyword}" |= "ERROR"',
            "limit": 50,
            "since": minutes * 60,
        },
        timeout=10
    )
    logs = resp.json().get("data", {}).get("result", [])

    summaries = []
    for stream in logs:
        service = stream["stream"].get("service", "unknown")
        for ts, line in stream.get("values", [])[-20:]:
            summaries.append(f"[{service}] {line[:200]}")

    if not summaries:
        return f"最近 {minutes} 分钟内未检索到包含 '{keyword}' 的错误日志"

    return f"共找到 {len(summaries)} 条相关错误日志:\n" + "\n".join(summaries[:30])


@tool("监控指标查询工具")
def query_metrics(service: str, metric: str, minutes: int = 30) -> str:
    """查询指定服务近 N 分钟的监控指标。
    参数:service 是服务名,metric 支持 qps/latency_p99/error_rate/cpu/memory。
    返回指标的当前值、峰值和趋势描述。"""
    # PromQL 查询映射
    promql_map = {
        "qps": f'sum(rate(http_requests_total{{service="{service}"}}[5m]))',
        "latency_p99": f'histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket{{service="{service}"}}[5m])) by (le))',
        "error_rate": f'sum(rate(http_requests_total{{service="{service}",code=~"5.."}}[5m])) / sum(rate(http_requests_total{{service="{service}"}}[5m]))',
        "cpu": f'avg(cpu_usage_percent{{service="{service}"}})',
        "memory": f'avg(memory_usage_percent{{service="{service}"}})',
    }

    if metric not in promql_map:
        return f"不支持的指标类型:{metric},可选:{list(promql_map.keys())}"

    resp = requests.get(
        "http://prometheus.internal:9090/api/v1/query",
        params={"query": promql_map[metric]},
        timeout=10
    )
    data = resp.json().get("data", {}).get("result", [])

    if not data:
        return f"未查询到 {service} 的 {metric} 数据"

    value = float(data[0]["value"][1])
    return (f"服务 {service} 的 {metric}:当前值 {value:.4f}。"
            f"(生产环境建议再补充同比/环比数据辅助判断)")
2.2 组建"诊断班组"
工具有了,接下来排班。我设了三个角色,按顺序执行(sequential 模式):
from crewai import Agent, Task, Crew, Process, LLM

# 用内网部署的开源模型,数据不出内网
local_llm = LLM(
    model="openai/qwen2.5-32b-instruct",
    base_url="http://gpu-server.internal:8000/v1",
    api_key="dummy-key",  # vLLM 不校验,随便填
    temperature=0.2,
)

# ===== 角色 1:日志分析员 =====
log_analyst = Agent(
    role="资深日志分析工程师",
    goal="从错误日志中快速定位故障的第一现场,找出最关键的报错模式和首次出现时间",
    backstory=(
        "你有 10 年的后端排障经验,特别擅长从海量日志里发现规律。"
        "你坚持一个原则:结论必须引用具体的日志证据,绝不凭感觉猜。"
        "你分析日志时总是先看报错最集中的时间窗口,再找异常堆栈的关键字。"
    ),
    tools=[search_error_logs],
    llm=local_llm,
    verbose=True,
    max_iter=5,  # 关键!限制工具调用次数,防止死循环
)

# ===== 角色 2:监控分析员 =====
metrics_analyst = Agent(
    role="SRE 监控数据分析专家",
    goal="结合日志分析员的结论,从监控指标中验证故障的影响范围和可能的根因方向",
    backstory=(
        "你是 SRE 团队的老兵,对各类监控指标的含义了如指掌。"
        "你的习惯是:拿到日志侧的线索后,一定要用指标数据交叉验证,"
        "比如日志说数据库连接超时,你就会去看连接池使用率和 DB 的 CPU。"
        "你只陈述数据支持的事实,数据不支持的说法你会明确标注'待验证'。"
    ),
    tools=[query_metrics],
    llm=local_llm,
    verbose=True,
    max_iter=5,
)

# ===== 角色 3:诊断报告撰写员 =====
report_writer = Agent(
    role="故障诊断报告撰写员",
    goal="把日志分析和监控验证的结论整合成一份值班领导 30 秒能看懂的诊断报告",
    backstory=(
        "你原来是个技术文档工程师,后来转做故障复盘。"
        "你写报告有三大铁律:先说结论再说过程、每条结论标注置信度、"
        "给出明确的下一步动作建议。你不写废话,不用'可能大概也许'糊弄人,"
        "不确定的地方就直说'信息不足,建议补充排查'。"
    ),
    llm=local_llm,
    verbose=True,
)

# ===== 任务编排 =====
task1 = Task(
    description=(
        "线上突发 5xx 告警,告警服务是 {service_name},"
        "疑似相关接口是 {api_path}。"
        "请用错误日志检索工具,分别用接口路径和常见异常关键字检索"
        "最近 15 分钟的错误日志,总结出:1) 报错最集中的时间点;"
        "2) 最主要的异常类型和堆栈关键行;3) 涉及哪些下游服务。"
    ),
    expected_output=(
        "一段结构化的日志分析结论,包含:告警时间线、Top 异常类型(带出现次数)、"
        "涉及的下游服务清单、以及 3 条最关键的原始日志摘录。"
    ),
    agent=log_analyst,
)

task2 = Task(
    description=(
        "基于上一步日志分析员的结论:{log_findings},"
        "用监控指标查询工具验证以下假设:"
        "1) {service_name} 的错误率和 P99 延迟走势;"
        "2) 日志中涉及的下游服务的 CPU 和内存是否有异常;"
        "3) 判断故障是应用层问题还是资源层问题。"
    ),
    expected_output=(
        "监控验证结论:各指标的当前值和趋势、每个假设的验证结果"
        "(证实/证伪/数据不足)、以及初步的根因方向判断。"
    ),
    agent=metrics_analyst,
    context=[task1],  # 关键:task2 能看到 task1 的输出
)

task3 = Task(
    description=(
        "整合日志分析结论和监控验证结论,输出一份《故障初步诊断报告》。"
        "报告结构:一、结论摘要(3 句话以内);二、故障时间线;"
        "三、根因分析(标注置信度:高/中/低);四、影响范围;"
        "五、建议的处置动作(按优先级排序)。"
    ),
    expected_output=(
        "一份 Markdown 格式的故障诊断报告,领导读完能在 30 秒内知道"
        "发生了什么、影响多大、该派谁去处理。"
    ),
    agent=report_writer,
    context=[task1, task2],
)

# ===== 组建班组并开工 =====
diagnosis_crew = Crew(
    agents=[log_analyst, metrics_analyst, report_writer],
    tasks=[task1, task2, task3],
    process=Process.sequential,
    verbose=True,
    memory=True,  # 开启记忆,重复故障能参考历史结论
)

# 告警触发入口
def on_alert_fired(alert):
    result = diagnosis_crew.kickoff(inputs={
        "service_name": alert["service"],
        "api_path": alert["api_path"],
        "log_findings": "",  # 占位,task1 的输出会自动传给 task2
    })
    print(result)

# 模拟一次告警
on_alert_fired({
    "service": "order-service",
    "api_path": "/api/order/create",
})
跑起来的交互过程长这样:
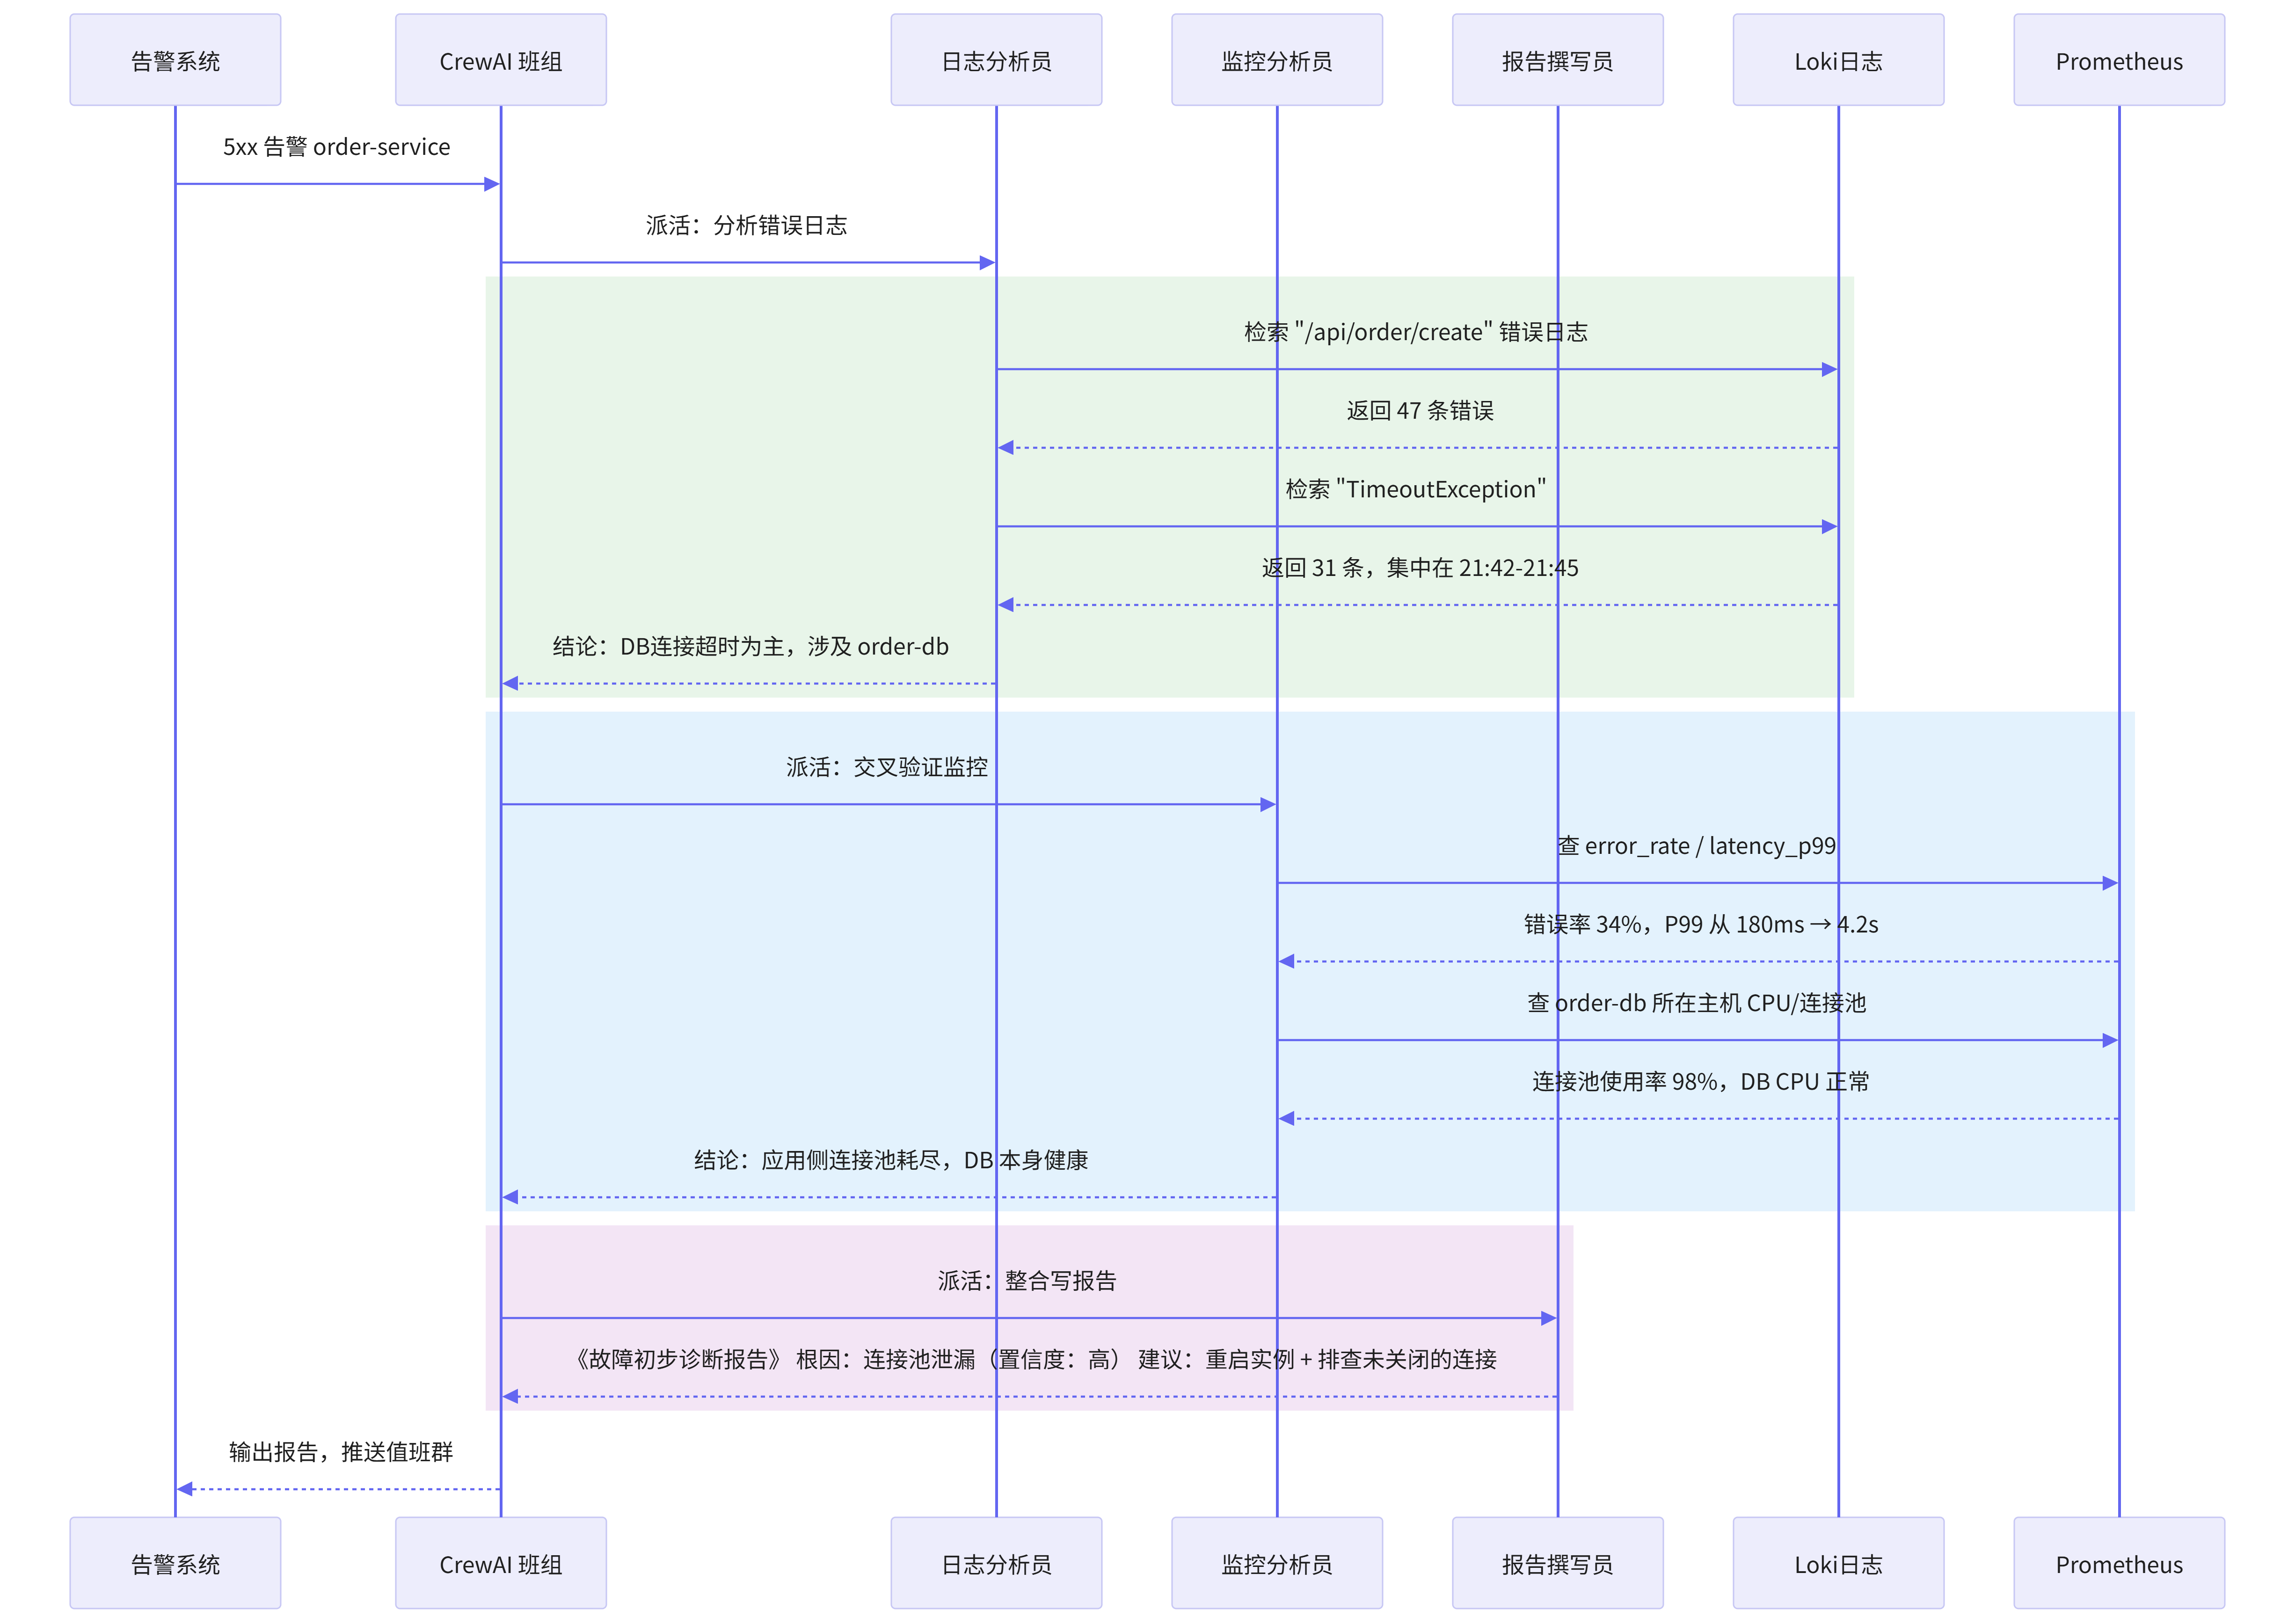
真实效果:整套流程跑下来大约 2 分钟(内网 32B 模型),值班群里直接收到一份带置信度的诊断报告。上线一个多月,十几起告警里 AI 给出的根因方向和人工最终结论一致的有 80% 以上。剩下那 20% 也提供了有价值的排查线索,没有一次是纯瞎编的。
三、实战案例二:用层级模式生成"运维周报"
第二个场景换个玩法。周报这活儿最烦的不是写,是收集素材——要翻一周的告警、变更、容量、工单数据,然后组织成文字。这活儿特别适合 CrewAI 的层级模式(hierarchical):设一个"主编",让它自己决定派活顺序。
from crewai import Agent, Task, Crew, Process, LLM

llm = LLM(
    model="openai/qwen2.5-32b-instruct",
    base_url="http://gpu-server.internal:8000/v1",
    api_key="dummy-key",
    temperature=0.3,
)

# ===== 三个"专员" =====
alert_specialist = Agent(
    role="告警数据专员",
    goal="从告警系统中提取本周所有告警,按严重程度和服务维度归类统计",
    backstory="你管理公司告警平台三年,对告警数据的口径烂熟于心。你统计的数据从不出错,因为你总是先核对时间范围再统计。",
    tools=[query_alerts_tool],   # 省略:查询告警平台的工具
    llm=llm,
)

change_specialist = Agent(
    role="变更记录专员",
    goal="整理本周所有上线变更,标注每次变更和后续告警的关联性",
    backstory="你在发布系统团队干了四年,深知'十次故障九次变更'。你最大的本事是把变更时间和告警时间做关联分析。",
    tools=[query_changes_tool],  # 省略:查询发布系统的工具
    llm=llm,
)

capacity_specialist = Agent(
    role="容量规划专员",
    goal="评估核心服务的资源使用趋势,识别未来两周内可能触顶的资源",
    backstory="你是做容量规划出身的,习惯用增长趋势外推而不是拍脑袋。你的报告里总有数据支撑的预警。",
    tools=[query_metrics],
    llm=llm,
)

editor = Agent(
    role="运维周报主编",
    goal="审核各专员的素材,去重合并,输出一份老板视角的运维周报",
    backstory=(
        "你是运维总监的笔杆子。老板只关心三件事:这周稳不稳、"
        "有什么风险、需要我拍板什么。你写的周报永远围绕这三件事组织,"
        "数据只保留关键的,过程细节一律砍掉。"
    ),
    llm=llm,
)

# 注意:层级模式下任务不用指定 agent,主编会自己分配
tasks = [
    Task(
        description="统计本周({week_range})的告警数据,按服务和严重程度归类",
        expected_output="告警统计表:各服务的告警次数、严重分布、Top 3 告警详情",
    ),
    Task(
        description="整理本周的变更记录,分析变更与告警的关联",
        expected_output="变更清单及关联分析:哪些告警疑似由变更引发",
    ),
    Task(
        description="评估核心服务容量趋势,输出风险预警",
        expected_output="容量评估结论:未来两周有触顶风险的资源清单",
    ),
    Task(
        description="汇总所有素材,撰写《运维周报》",
        expected_output="Markdown 周报:本周稳定性总结、风险与预警、需要决策的事项",
    ),
]

weekly_crew = Crew(
    agents=[alert_specialist, change_specialist, capacity_specialist, editor],
    tasks=tasks,
    process=Process.hierarchical,
    manager_llm=llm,      # 层级模式必须指定"主编"用的模型
    verbose=True,
)

result = weekly_crew.kickoff(inputs={
    "week_range": "2026-09-07 至 2026-09-13"
})
层级模式和顺序模式的差别,一张图说清楚:
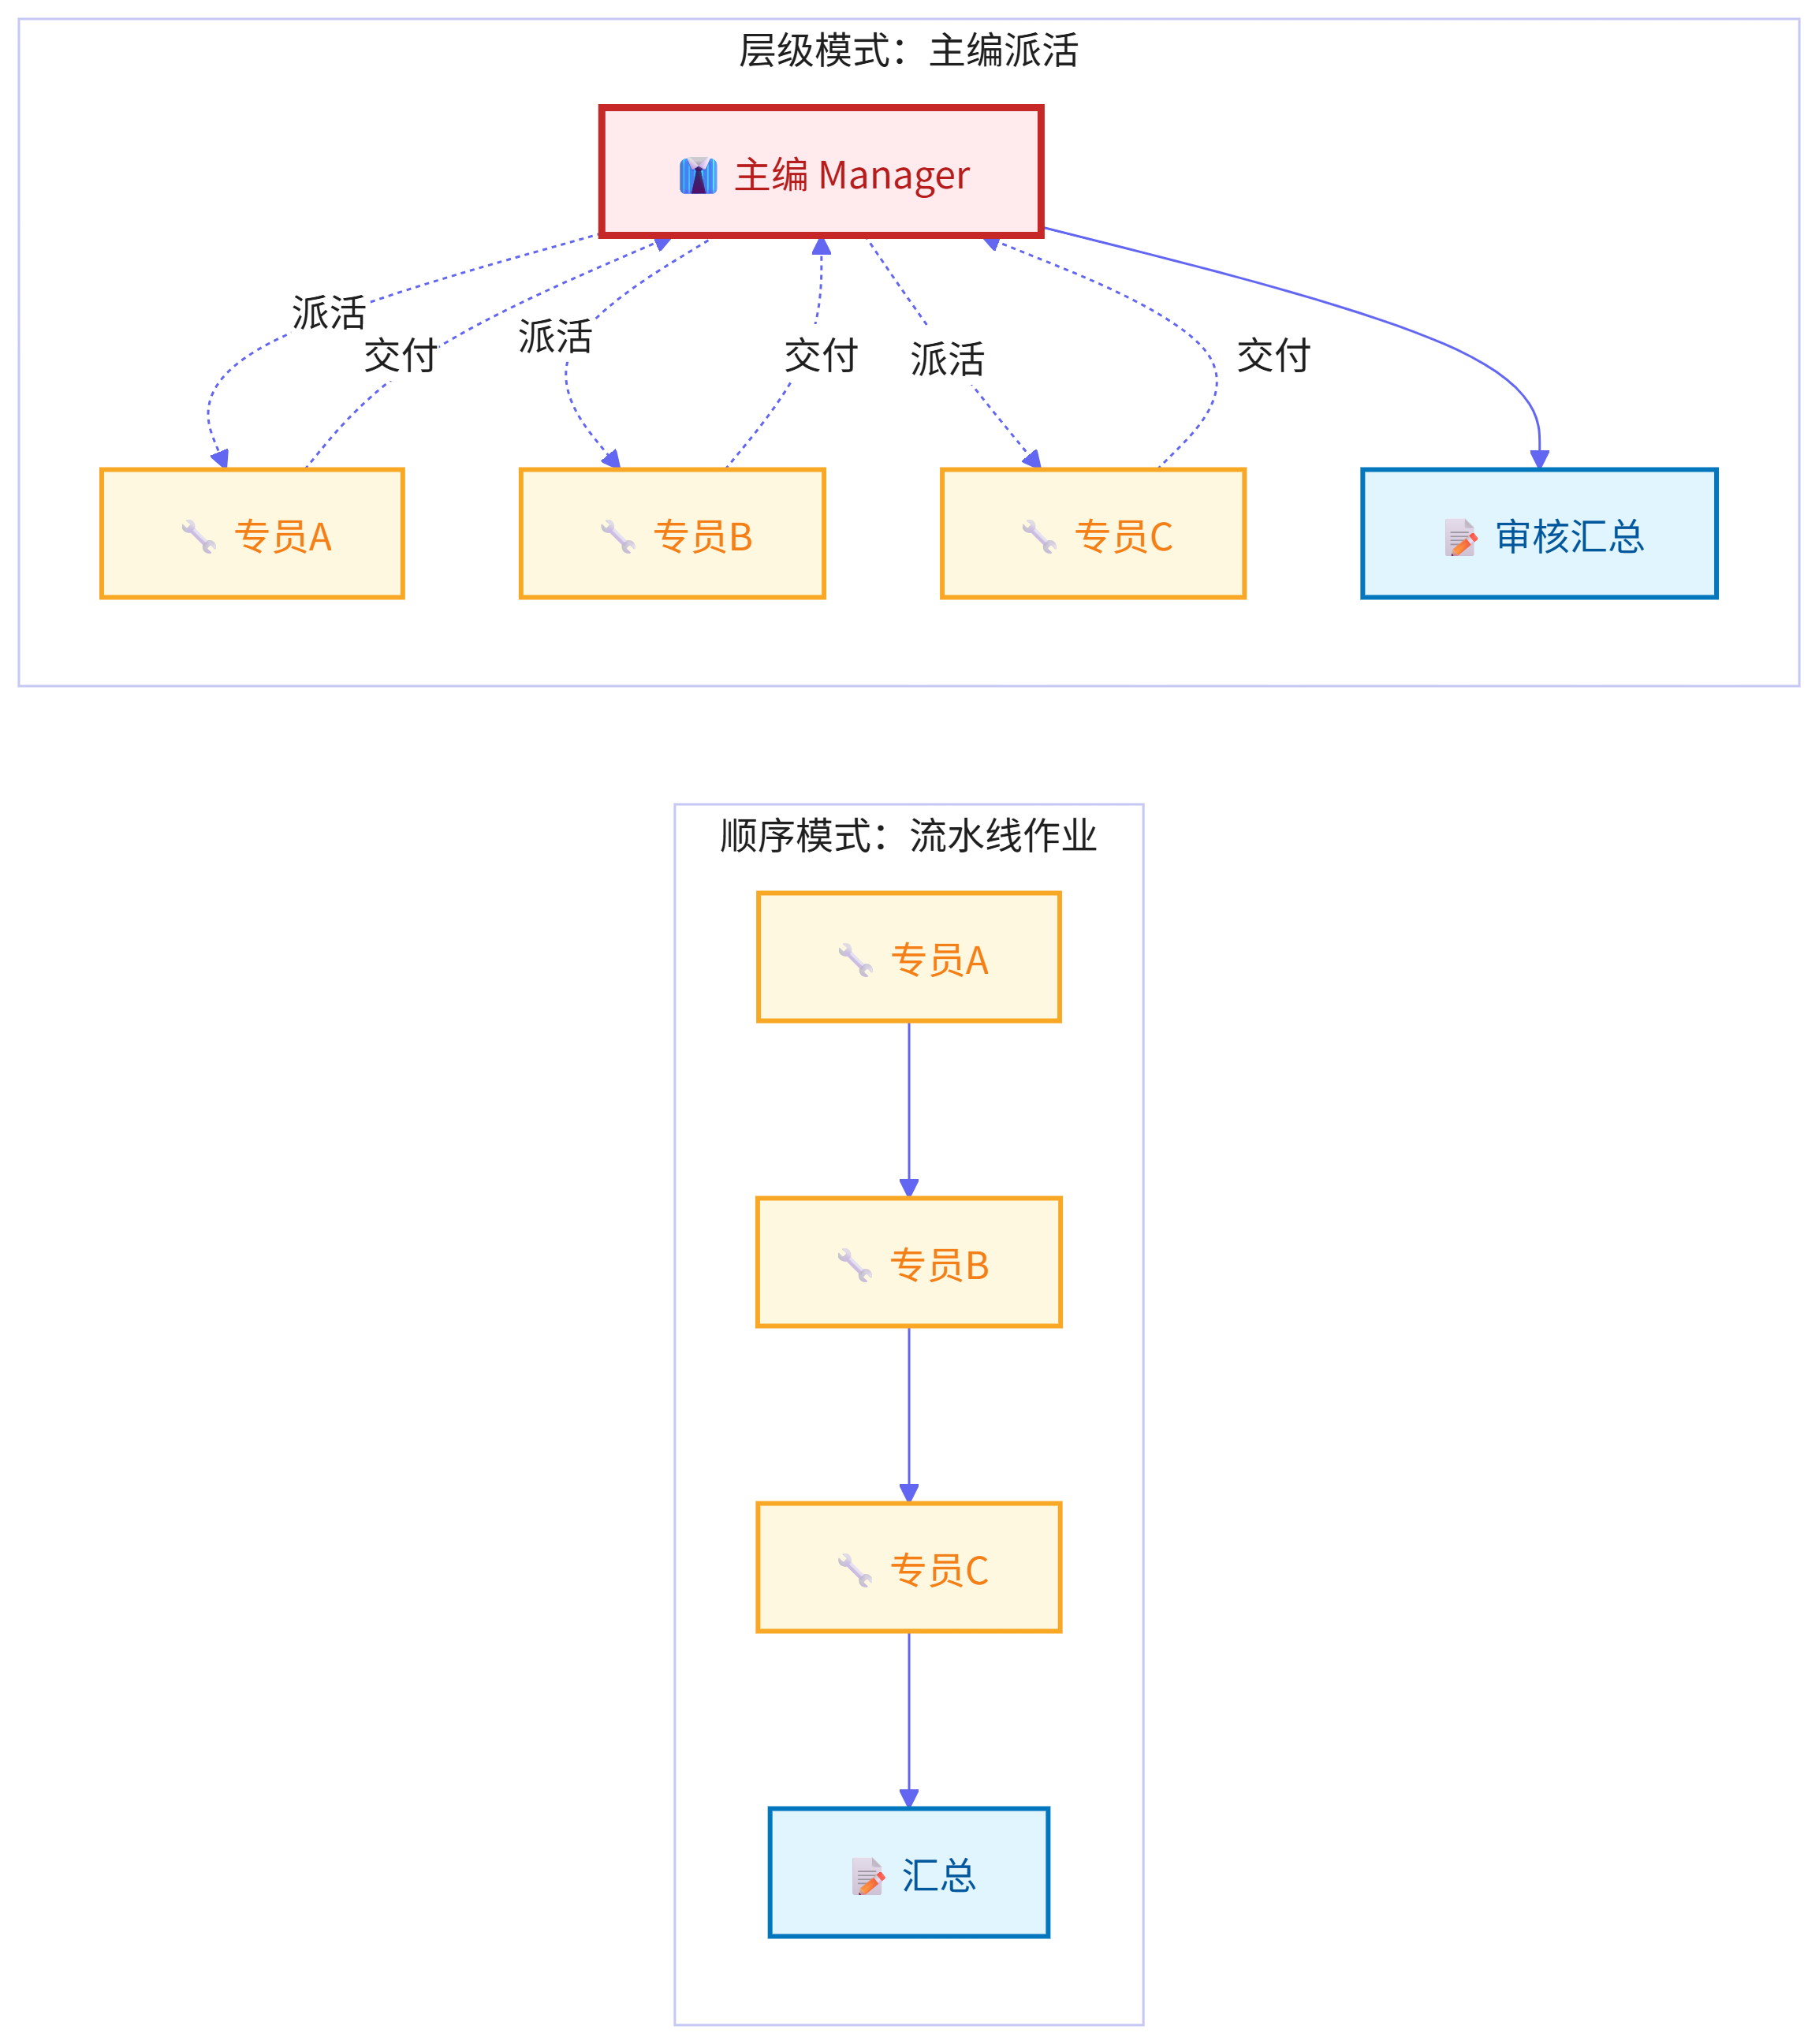
层级模式的好处是主编会根据前一步的结果动态调整后面的安排——比如告警专员发现某服务告警暴涨,主编可能会让容量专员重点看这个服务的资源。代价是多一层 LLM 调用,token 消耗和耗时都会上去。我的经验:流程固定用顺序模式,流程需要临场判断用层级模式。
四、踩坑记录:这几个坑我全都踩过
坑 1:Token 消耗像个无底洞
CrewAI 多 agent 协作的本质是"多个 LLM 会话互相传递中间结果"。我第一次跑三任务班组,一个流程下来 LLM 被调了 47 次,token 花了单 agent 模式的十几倍。尤其是 verbose=True 的时候,看着屏幕哗哗刷字,你就知道钱在燃烧。
对策: 给每个 agent 设 max_iter(我一般设 3-5);任务描述写清楚"用几次工具、输出多长";能用顺序模式就别用层级模式。
坑 2:Agent 死循环调工具
有个 agent 查完日志觉得"数据不够",又查了一遍,还觉得不够,又查……工具调了十几次还在转。
对策: max_iter 必须设;工具返回值里写清楚"数据到此为止",并且在 backstory 里明确告诉它"查一次没有就基于现有信息下结论"。
坑 3:幻觉接力赛
最隐蔽的一个坑。日志分析员"总结"出一条日志里根本没有的信息,监控分析员把这个错误结论当事实去验证,报告撰写员再把它写得言之凿凿。一个幻觉经过两个 agent 的接力,最后出现在报告里的时候已经"有鼻子有眼"了。
对策: 每个 agent 的 backstory 里写上"结论必须带证据引用";expected_output 里强制要求输出原始数据摘录;报告 agent 的任务描述里加一句"对上游结论保持怀疑,标注每条结论的置信度"。
坑 4:本地开源模型跑不好 function calling
CrewAI 的 agent 要靠 function calling 来调工具。有些开源模型(尤其是 7B 的小模型和没做 agent 微调的模型)调工具的格式时对时错,表现为 agent 疯狂输出乱七八糟的 JSON。
对策: 选 agent 能力强的模型(Qwen2.5 系列 14B 以上、DeepSeek-V3 这些都不错);用 vLLM 部署时开启 --enable-auto-tool-choice --tool-call-parser hermes;真不行就在 CrewAI 里把 temperature 降到 0.1。
坑 5:backstory 写得敷衍,agent 人设崩塌
一开始我偷懒,backstory 就写一句"你是运维专家"。结果那个 agent 干活跟没头苍蝇似的,想到哪做到哪。后来我把每个角色的工作习惯、原则底线、输出要求都写进去,稳定性立刻上一个台阶。backstory 不是自我介绍,是这个角色的"操作手册",多写几句不亏。
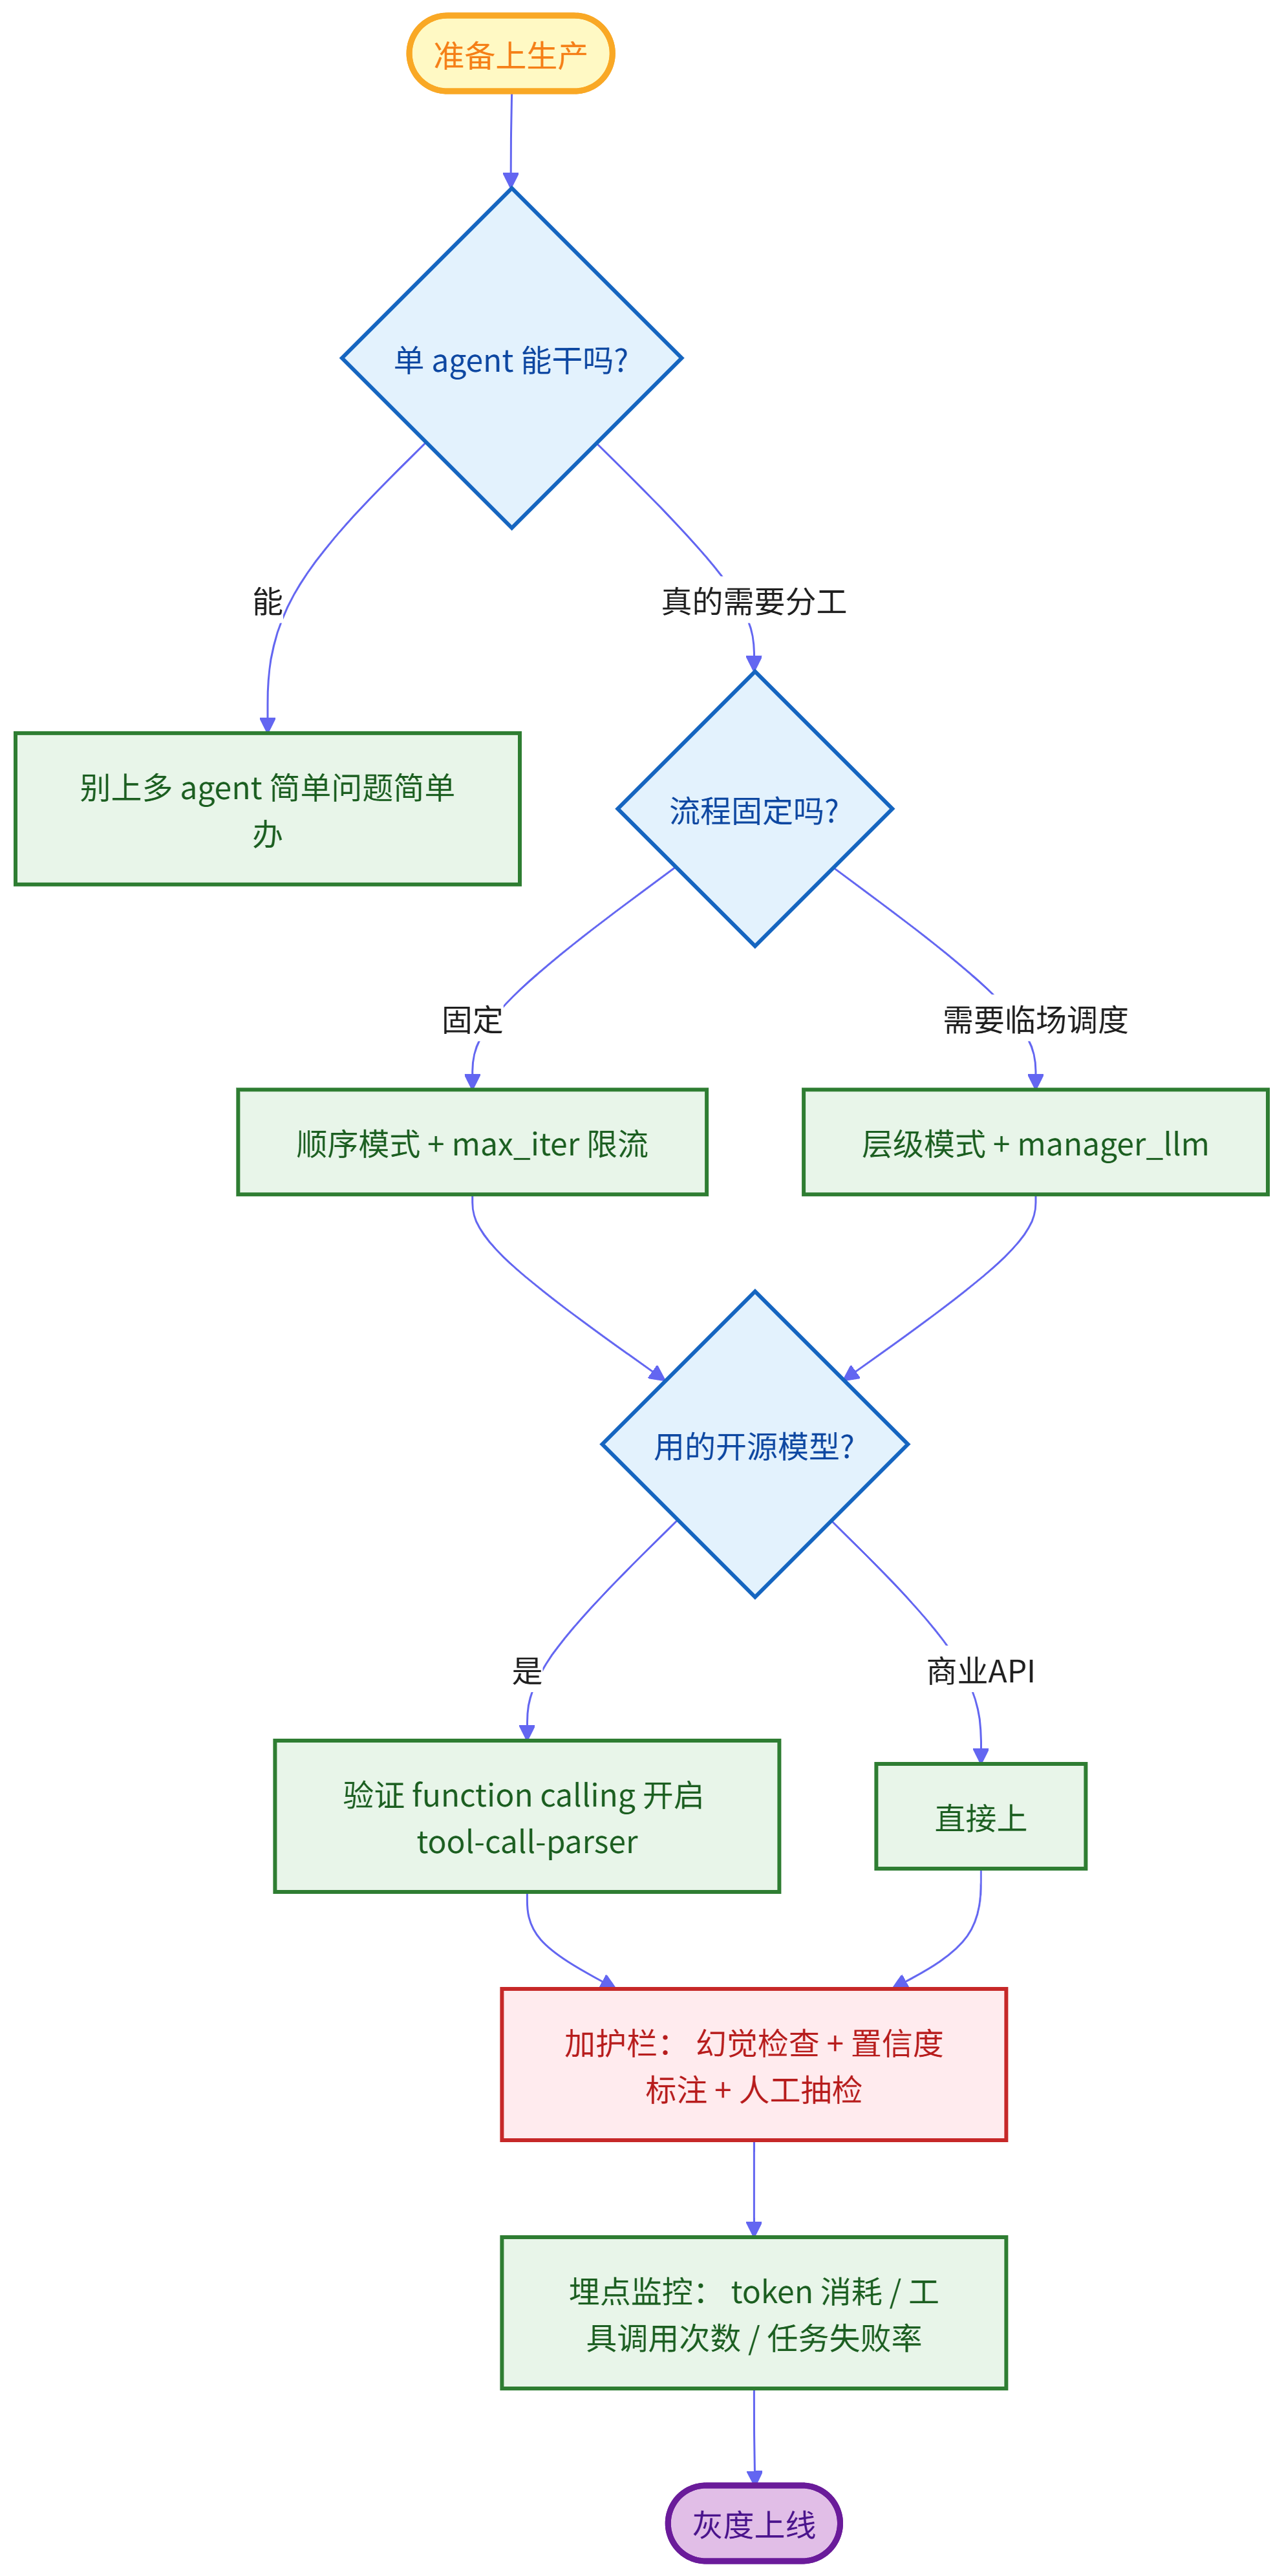
五、什么场景值得上 CrewAI,什么场景纯属自找麻烦
用了小半年,我总结了一个判断标准:任务能拆成"几个角色 + 明确分工 + 串行步骤",而且每步的中间结果对下一步有用——这种适合 CrewAI。
适合的:
- 故障诊断(日志员 → 监控员 → 报告员,每个环节的输出都是下个环节的输入)
- 周报/月报生成(各专员收集数据,主编汇总)
- 安全事件分析(告警分诊员 → 载荷分析员 → 处置建议员)
- 面试准备、竞品调研这类"多维度收集 + 汇总"的活
不适合的:
- 单次问答(杀鸡用牛刀,一次 LLM 调用能解决的事别搞三个 agent)
- 需要极强实时性的场景(多 agent 流水线跑一次至少一两分钟,扛不住秒级响应)
- 强事务性的操作(多 agent 各调各的工具,出了问题不好回滚,涉及"执行类"操作务必加人工确认)
还有一点掏心窝子的话:别为了用多 agent 而用多 agent。我一个同事把一个简单的"查数据库出报表"的活儿拆成了 5 个 agent,说是"职责分离",实际跑起来 token 翻了八倍,结果跟单 agent 版一模一样。多 agent 是手段不是目的,单 agent + 好工具能解决的,就别上班组。
回过头看,CrewAI 给我的最大启发不是技术本身,而是一种组织 AI 干活的思路:与其让一个无所不能的超级 agent 去干所有事,不如让几个各有所长、互相制衡的普通 agent 协作。日志员只管看日志,监控员只管看指标,写报告的只管把话说清楚——分工明确之后,每个角色只需要把自己那摊事干好,整体效果反而比"一个 agent 从头干到尾"稳定得多。
这跟管理真人团队是一个道理:招一个全能选手很难,但把三个各怀绝技的普通人排成一组,把流程理顺,往往能干出超出预期的活。
代码都在上面了,场景也是真实跑过的。如果你也有那种"天天重复、流程固定、还挺费人"的活儿,不妨拿 CrewAI 排个 AI 班组试试。踩坑了也别慌,上面那五个坑我都替你踩过了——带着 max_iter 和置信度上,基本能少走一半弯路。
有问题欢迎评论区聊,尤其是已经在用多 agent 框架的朋友,特别想知道你们在生产上是怎么做监控和护栏的。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号