Qwen3-0.6B微调-Excel转标准JSON实战
原创
Qwen3-0.6B微调-Excel转标准JSON实战
原创
大盘鸡拌面
发布于 2026-09-20 18:20:22
发布于 2026-09-20 18:20:22
我拿 Qwen3-0.6B 训了个"表格翻译官",专治各种奇形怪状的 Excel
事情的起因
公司做人力的那套系统,有个看着不起眼但特别磨人的功能:导入 Excel。
需求一句话就能说完——业务同事从各个渠道拿到的岗位表、简历表,导进系统,前端出一张规整的列表。听起来不就是 EasyExcel.readList() 两行的事吗。我第一版也就是这么写的,然后被真实世界教做人了。
真实世界长这样:智联导出的表头叫"工作城市",猎聘叫"工作地点",BOSS 那边是"职位诱惑"前面还夹了两行说明文字,某分公司自己攒的模板更绝,表头在第 4 行、A 列到 C 列是合并单元格、薪资那一列写成"1.5万-2.5万·13薪"、还有一列叫"期望(可备注)"——你根本不知道他想表达什么。
我写了三个月的规则。到后来 ExcelColumnMapper 这个类膨胀到 1100 多行,四百多个 if-else 和正则,改一处崩三处。最恶心的是每次新接入一个数据源,就得排半天开发,业务同事的表已经堆了一屏幕。
那阵子正好在看小模型微调,就动了个念头:表头这东西,本质上是个语义问题——"工作城市"和"工作地点"和"City"是一回事,人眼一扫就知道,规则代码却要一条条喂。既然人眼一扫就知道,那让一个 0.6B 的模型扫一下,是不是也行?
结论是行,而且好得有点出乎意料。下面是全过程。
第一个关键决定:千万别让 0.6B 去逐行抽数据
这是我想说得最多的一条,因为大部分人(包括一开始的我)思路都是"把 Excel 丢给大模型,让它直接输出 JSON"。
这么做在小模型上必死。原因有三个:一是几百行数据的 token 数量轻松超上下文;二是 0.6B 的注意力扛不住长表格,抄到第 40 行就开始串行、漏行、甚至自己编;三是数值和日期它一紧张就会算错,而 HR 系统里薪资算错属于生产事故。
所以我换了个分工,把任务拆开:
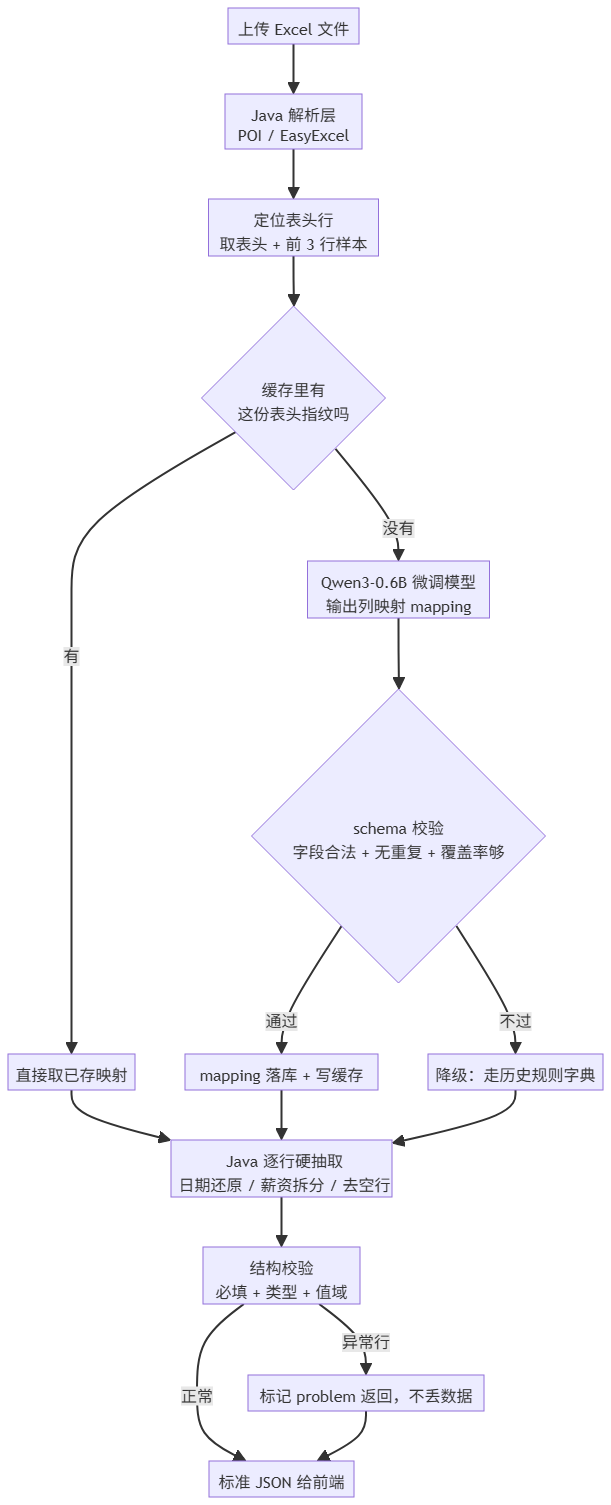
模型只干一件窄到不能再窄的事——看懂表头,输出一份"列 → 标准字段"的映射关系。真正的逐行取值由 Java 按映射硬抽。
这么一拆,整个方案的性质就变了。模型的输入从"整张表"变成"表头 + 三行样本",输出从"几百条记录"变成"一个十几项的 JSON"。推理成本从秒级掉到几十毫秒,最要命的不确定性也被关进了一个小笼子里:映射如果错了,最多这一列全错,我能立刻看出来、能改、能缓存、能兜底;而行级抽取由代码负责,是确定性的,永远不飘。
给 0.6B 派活的关键,是活必须窄到它能"背下来"。
标准格式先长什么样
映射的"目标语言"得先定下来,不然后面全是空谈。这是我们最后收敛出来的岗位表 schema,字段不多,但每个都代表一类脏数据:
{
  "title":        "string   职位名称",
  "city":         "string   工作城市,只留市名",
  "district":     "string   区县,可空",
  "salary_raw":   "string   原样字符串,一个字都不改",
  "salary_low_k": "number   月薪下限,单位 K",
  "salary_high_k":"number   月薪上限,单位 K",
  "salary_months":"number   一年发几薪,默认 12",
  "exp_raw":      "string   经验原文",
  "exp_years_min":"number   经验下限年数,不限填 0",
  "edu":          "string   枚举:大专/本科/硕士/博士/学历不限",
  "company":      "string",
  "source":       "string   枚举:zhaopin/liepin/boss/company_x",
  "url":          "string   原文里的链接,可空"
}salary_raw 一定要留着。解析错了还能靠原始字段回滚重跑,这个字段救过我两次。
训练数据是这么攒的
模型没见过我们的表,所以得先造数据集。我用的是 Alpaca 格式的三段式:instruction 固定,input 放表头和样本行,output 放映射 JSON。
表头来源不是编的,就是把过去两年系统里成功导入过的模板全捞出来,一共 287 个,人工对着标准字段过一遍标签。这一步别偷懒,脏标签训出来的模型你根本查不出原因。
然后做增强。真实表格的花样远超你想像,所以我在脚本里对每个表头做了这些变异:
- 换名:同义词表轮播,"工作城市/城市/工作地点/所在地/City/工作地"
- 换序:列随机打乱,模拟各家导出顺序不同
- 注水:插几个空列、以及"备注""序号""是否需要出差"这种压根不在 schema 里的干扰列
- 加噪:全角半角混用、列名里塞换行、"薪资(月薪) " 带尾空格、合并单元格导致的空列名
- 造歧义:把"1.5万-2.5万·13薪"和"15000-25000"和"15-25K"三种写法撒进样本行
287 条放大到 4100 多条,用了 5 分钟左右。数据集里挑一条出来大概是这样:
{"instruction":"你是Excel表头映射器。读取given列名与样例行,把每一列映射到标准字段。只能使用这些目标字段:title,city,district,salary_raw,salary_low_k,salary_high_k,salary_months,exp_raw,exp_years_min,edu,company,source,url。无法对应的列一律映射为IGNORE。只输出JSON对象,键为列名字符串,值为标准字段名。","input":"列名:[\"序号\",\"职位名称\",\"工作城市\",\"所在区县\",\"薪资(月薪) \",\"经验\",\"学历\",\"公司名称\",\"备注\",\"岗位链接\"]\n样例行1:[\"1\",\"风控策略运营\",\"北京\",\"海淀区·上地\",\"1.5万-2.5万·13薪\",\"3-5年\",\"本科\",\"某某科技\",\"需要出差\",\"https://x.cn/j/8812\"]\n样例行2:[\"2\",\"交易风控专家\",\"上海\",\"浦东新区\",\"2万-3.5万\",\"5-10年\",\"硕士\",\"某某基金\",\"\",\"https://x.cn/j/9021\"]","output":"{\"序号\":\"IGNORE\",\"职位名称\":\"title\",\"工作城市\":\"city\",\"所在区县\":\"district\",\"薪资(月薪) \":\"salary_raw\",\"经验\":\"exp_raw\",\"学历\":\"edu\",\"公司名称\":\"company\",\"备注\":\"IGNORE\",\"岗位链接\":\"url\"}"}注意 output 里那个 "薪资(月薪) " 尾巴上的空格是故意保留的。列名一律原样当 key,不做 trim 归一化,这样 Java 侧拿到映射能直接对上解析出来的原始列,省掉一层二次匹配。这个坑是我先踩了才在数据里故意的。
训练配置
0.6B 真的很轻,一张 4060 Ti 16G 就能开跑,我实测峰值 9.2 GB。用的 LLaMA-Factory 的 LoRA SFT:
### qwen3_excel_mapping.yaml
model_name_or_path: Qwen/Qwen3-0.6B
trust_remote_code: true

stage: sft
do_train: true
finetuning_type: lora
lora_rank: 16
lora_alpha: 32
lora_dropout: 0.05
lora_target: all

dataset: excel_header_mapping_v3
template: qwen3            # 老版本挂 qwen 也能跑
cutoff_len: 1024           # 输入很短,没必要留长上下文
overwrite_cache: true
preprocessing_num_workers: 8

output_dir: saves/qwen3-0.6b/lora/excel_map_v3
logging_steps: 5
save_steps: 100
plot_loss: true
num_train_epochs: 3.0
per_device_train_batch_size: 8
gradient_accumulation_steps: 2
learning_rate: 1.0e-4
lr_scheduler_type: cosine
warmup_ratio: 0.03
bf16: true
flash_attn: auto
一个 Qwen3 特有的点,必须单独说:训练和推理都要把 thinking 关掉。默认它会在回答前先输出一段思考,对 0.6B 来说这段思考又长又不稳,很容易把真正的 JSON 挤出 max_new_tokens,前端就拿到半截。我加了一个 enable_thinking: false 的 flag 传下去,稳定了很多。
合并 adapter、量化成 AWQ 之后交给 vLLM 起服务,一张卡够了:
vllm serve /models/qwen3-0.6b-excel-map-awq \
  --served-model-name excel-mapper \
  --max-model-len 2048 \
  --enable-prefix-caching \
  --gpu-memory-utilization 0.55 \
  --dtype half
效果对比,200 份留出来的测试模板(训练时完全没见过):
模型 | 全列映射正确 | 至少错一列 | 平均耗时 |
|---|---|---|---|
Qwen3-0.6B 原始 | 41% | 59% | 68 ms |
Qwen-Plus(走 API) | 93% | 7% | 1.9 s |
微调后 0.6B | 96.5% | 3.5% | 41 ms |
剩下那 3.5% 基本集中在"这列压根不存在标准字段"的情况——模型硬给它安了个名字。解法不是继续训,是后面加了白名单校验,不认识的字段直接判失败走降级,反而比模型自觉更可靠。
Spring Boot 这边怎么接
分四块:定位表头、构造请求、校验映射、逐行抽取。
定位表头行
别信"表头一定在第一行"。我们的做法是在前 10 行里找,打分标准是非空单元格最多、文本长度分布最均匀、且下面还有数据的那一行:
public final class HeaderLocator {

    private static final int SCAN_ROWS = 10;

    public static int find(Sheet sheet) {
        int best = 0;
        double bestScore = -1D;
        DataFormatter fmt = new DataFormatter();
        for (int r = 0; r <= Math.min(SCAN_ROWS, sheet.getLastRowNum()); r++) {
            Row row = sheet.getRow(r);
            if (row == null) {
                continue;
            }
            int filled = 0;
            List<Integer> lens = new ArrayList<>();
            for (Cell c : row) {
                String v = fmt.formatCellValue(c).trim();
                if (!v.isEmpty()) {
                    filled++;
                    lens.add(v.length());
                }
            }
            if (filled < 2 || lens.isEmpty()) {
                continue;
            }
            double avg = lens.stream().mapToInt(Integer::intValue).average().orElse(0);
            // 表头特征:列都填了、名字都不长、名字长度还比较一致
            double spread = lens.stream().mapToDouble(l -> Math.abs(l - avg)).average().orElse(9);
            double score = filled * 2D - Math.max(0, avg - 8) - spread;
            if (score > bestScore) {
                bestScore = score;
                best = r;
            }
        }
        return best;
    }
}
合并单元格得在取表头之前展平,否则"工作经历"合并了 D 到 F 三列,你会拿到两个空列名,模型直接懵。POI 里就是遍历 sheet.getMergedRegionList(),把左上角的值刷进区间内所有格子。
调模型
@Service
@RequiredArgsConstructor
public class HeaderMappingClient {

    private static final Set<String> ALLOWED = Set.of(
        "title", "city", "district", "salary_raw", "salary_low_k", "salary_high_k",
        "salary_months", "exp_raw", "exp_years_min", "edu", "company", "source", "url", "IGNORE");

    private static final Pattern FENCE = Pattern.compile("\\{[\\s\\S]*}");

    private final RestClient llm;
    private final MappingCache cache;

    public Map<String, String> map(List<String> headers, List<List<String>> sampleRows) {
        String key = fingerprint(headers);
        var hit = cache.get(key);
        if (hit.isPresent()) {
            return hit.get();                       // 同一套表头只推理一次
        }

        String input = "列名:" + JSON.toJSONString(headers) + "\n"
            + IntStream.range(0, Math.min(3, sampleRows.size()))
              .mapToObj(i -> "样例行" + (i + 1) + ":" + JSON.toJSONString(sampleRows.get(i)))
              .collect(Collectors.joining("\n"));

        ChatBody body = ChatBody.builder()
            .model("excel-mapper")
            .messages(List.of(
                ChatMsg.system(SYSTEM),
                ChatMsg.user(input)))
            .temperature(0.0)                        // 关键,见下文
            .maxTokens(512)
            .addGenerationConfig("chat_template_kwargs", Map.of("enable_thinking", false))
            .build();

        String raw = llm.post().uri("/v1/chat/completions")
            .contentType(MediaType.APPLICATION_JSON).body(body)
            .retrieve().body(ChatResponse.class)
            .choices().get(0).message().content();

        Map<String, String> mapping = parseLoose(raw, headers);
        validate(mapping, headers);
        cache.put(key, mapping);
        return mapping;
    }

    /** 模型偶尔会包 ```json 围栏、或者结尾多一句"希望有帮助",所以只截首尾大括号。 */
    private Map<String, String> parseLoose(String raw, List<String> headers) {
        Matcher m = FENCE.matcher(raw);
        if (!m.find()) {
            throw new MappingUnstableException("模型没返回 JSON: " + abbreviate(raw));
        }
        Map<String, String> parsed = JSON.parseObject(m.group(), new TypeReference<>() {});
        // 它可能把列名的空格吃掉,回贴成原列名
        Map<String, String> fixed = new LinkedHashMap<>();
        for (String h : headers) {
            String v = parsed.getOrDefault(h, parsed.get(h.trim()));
            fixed.put(h, v == null ? "IGNORE" : v.trim());
        }
        return fixed;
    }

    private void validate(Map<String, String> mapping, List<String> headers) {
        for (var e : mapping.entrySet()) {
            if (!ALLOWED.contains(e.getValue())) {
                throw new MappingUnstableException("非法目标字段 " + e.getValue());
            }
        }
        long named = mapping.values().stream().filter(v -> !"IGNORE".equals(v)).count();
        if (named < 2) {
            throw new MappingUnstableException("识别到的列太少,判定失败");
        }
        long distinct = mapping.values().stream().filter(v -> !"IGNORE".equals(v)).distinct().count();
        if (distinct != named) {
            throw new MappingUnstableException("两列映射到了同一个字段,交给规则兜底");
        }
    }
}temperature=0.0 这件事怎么强调都不过分。同表头两次推理给出不同映射,缓存直接失效,还会让测试变成玄学。另外 fingerprint 我最初用的是文件名加大小,很快发现同事改个名又要重跑一遍,现在换成"排序后列名拼接"的 SHA-256,只要表头结构一样就命中。
拿到 mapping 之后,Java 硬抽
这部分没有模型了,全是确定性的代码,也正是我敢把系统交给业务用的原因:
public List<JobRow> extract(List<String> headers, List<List<String>> rows,
                            Map<String, String> mapping) {
    List<JobRow> out = new ArrayList<>();
    for (List<String> row : rows) {
        Map<String, String> byField = new HashMap<>();
        for (int i = 0; i < headers.size(); i++) {
            String target = mapping.getOrDefault(headers.get(i), "IGNORE");
            if (!"IGNORE".equals(target) && !byField.containsKey(target)) {
                byField.put(target, cell(row, i));          // 先到的列优先
            }
        }
        if (isBlankRow(byField)) {
            continue;
        }
        JobRow j = new JobRow();
        j.setTitle(byField.get("title"));
        j.setCity(CityNorm.strip(byField.get("city")));        // "北京市/北京" -> 北京
        j.setDistrict(byField.get("district"));
        String salary = byField.get("salary_raw");
        j.setSalaryRaw(salary);
        salaryParser.parse(salary).ifPresent(s -> {
            j.setSalaryLowK(s.lowK());
            j.setSalaryHighK(s.highK());
            j.setSalaryMonths(s.months());
        });
        j.setExpRaw(byField.get("exp_raw"));
        j.setEdu(EduNorm.pick(byField.get("edu")));
        j.setCompany(byField.get("company"));
        j.setUrl(LinkNorm.first(byField.get("url")));
        j.setProblem(salary == null ? "no_salary" : null);
        out.add(j);
    }
    return out;
}
一个完整的例子,从一份烂表到前端
拿我们真的遇到过的一份表说。某分公司 HR 手工攒的春招岗位表,长这个样子(表头上面压了两行说明,薪资那一列的"·13薪"混在文字里,"工作经历"是个合并单元格):
A           B              C        D(合并 D:F)      G          H
1  2026年春季校园招聘需求汇总表(本表由各部门填写后回传HR)
2  填表说明:薪资请写月薪,币种人民币;经验要求可写"不限"
3  序号   | 招聘部门·岗位 | 工作地 | 工作经历       | 薪资待遇   | 学历要求
4  1     | 风控-策略运营 | 北京市海淀区 | 3-5年    | 1.5万-2.5万·13薪 | 统招本科
5  2     | 交易风控     | 上海市  | 经验不限      | 20000-30000 | 硕士
前端点"上传",整条链路是这样:
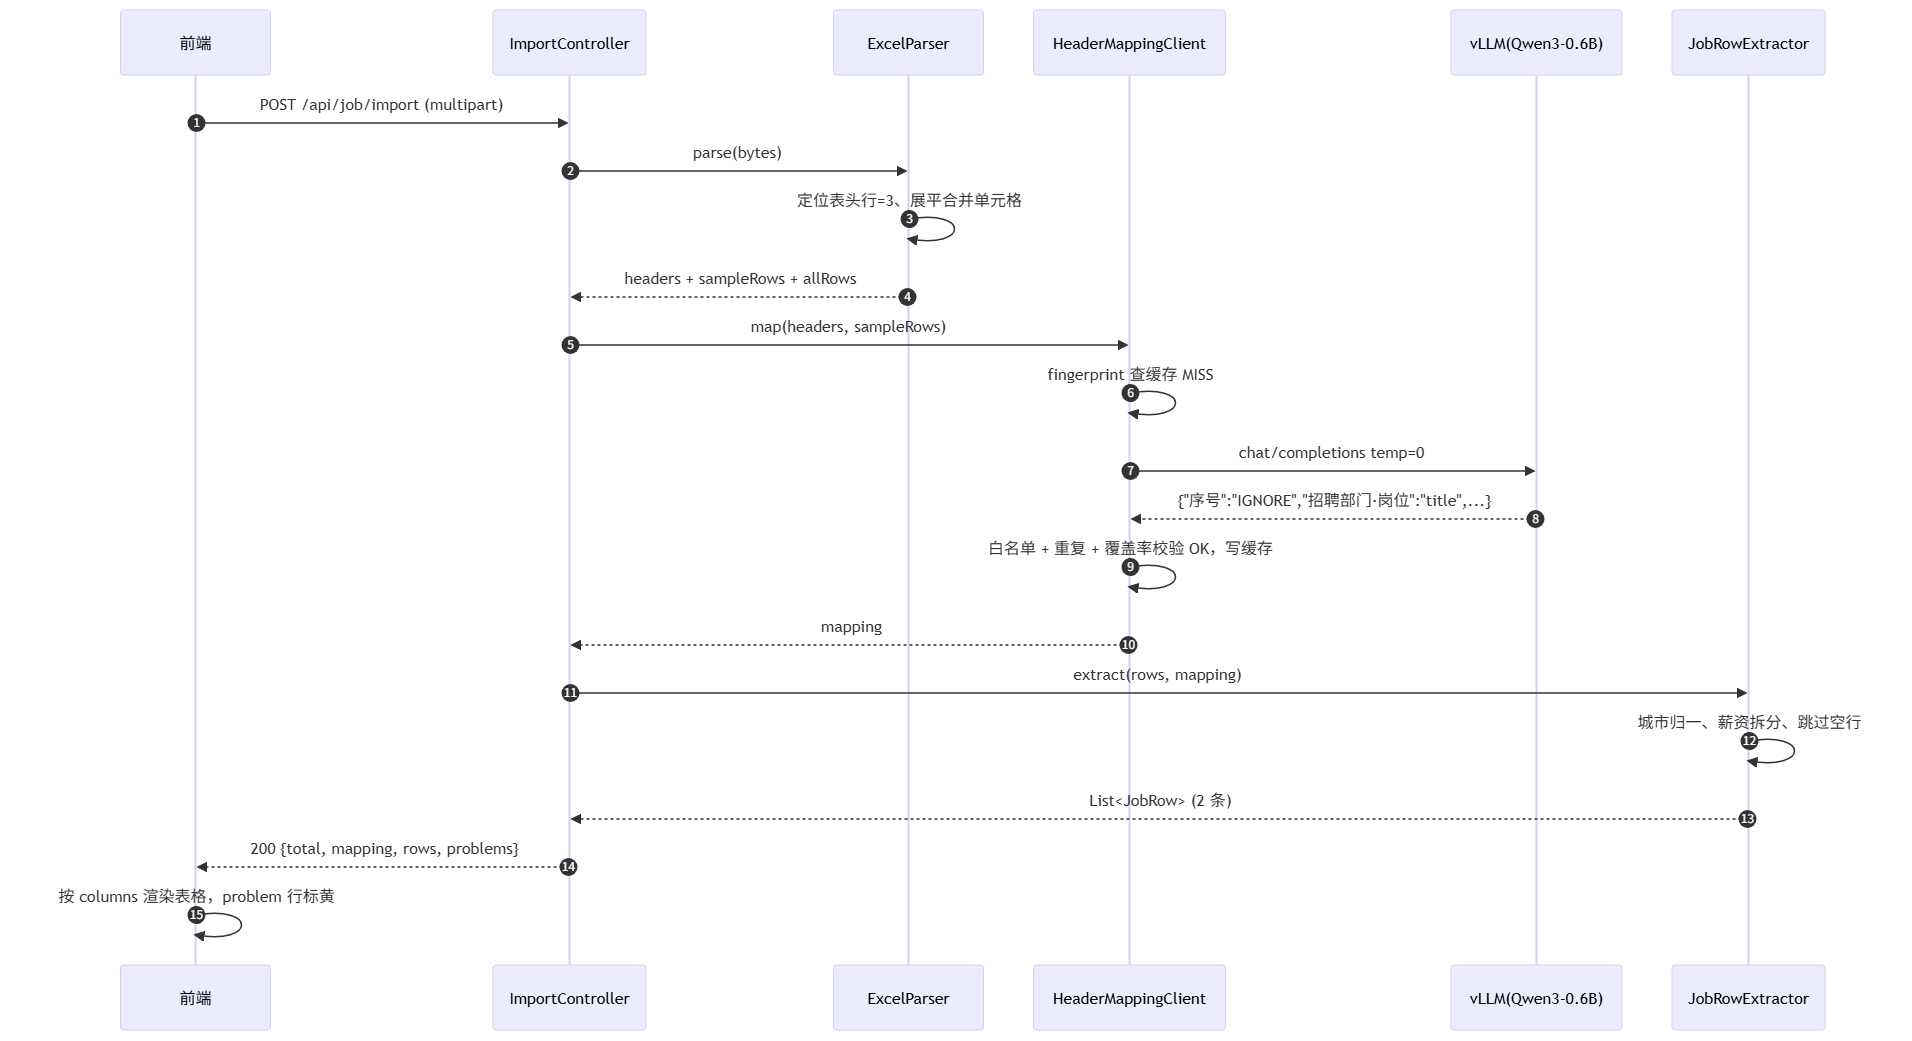
模型这一次真正吐出来的东西(41 ms):
{
  "序号": "IGNORE",
  "招聘部门·岗位": "title",
  "工作地": "city",
  "工作经历": "exp_raw",
  "": "IGNORE",
  "薪资待遇": "salary_raw",
  "学历要求": "edu"
}
Java 接着把薪资拆开,最后返给前端的是这样一份。columns 单独返回,前端照它渲染表头,以后加字段不用改前端:
{
  "ok": true,
  "fileKey": "2026春招需求表_final_v3.xlsx",
  "headerRow": 3,
  "total": 2,
  "mapping": { "薪资待遇": "salary_raw", "工作地": "city", "招聘部门·岗位": "title" },
  "columns": [
    { "field": "title",   "label": "岗位" },
    { "field": "city",    "label": "城市" },
    { "field": "salary",  "label": "月薪" },
    { "field": "edu",     "label": "学历" },
    { "field": "exp",     "label": "经验" }
  ],
  "rows": [
    {
      "title": "风控-策略运营",
      "city": "北京", "district": "海淀区",
      "salary_raw": "1.5万-2.5万·13薪",
      "salary_low_k": 15, "salary_high_k": 25, "salary_months": 13,
      "exp_raw": "3-5年", "exp_years_min": 3,
      "edu": "本科", "company": "风控", "problem": null
    },
    {
      "title": "交易风控",
      "city": "上海", "district": null,
      "salary_raw": "20000-30000",
      "salary_low_k": 20, "salary_high_k": 30, "salary_months": 12,
      "exp_raw": "经验不限", "exp_years_min": 0,
      "edu": "硕士", "company": null, "problem": "no_company"
    }
  ],
  "problems": [ { "row": 2, "field": "company", "code": "no_company" } ]
}
顺便注意 edu:原文"统招本科",我这儿归一成了"本科"。这个转换是代码里一张枚举表干的,不是模型。
踩过的坑,一条比一条隐蔽
Excel 日期到了 Java 里成了 46023。 POI 给的是序列数,别指望 getStringValue。必须判 CellType.NUMERIC + DateUtil.isCellDateFormatted,走 getDateCellValue;碰到那份 1904 日期模式的表还要额外修正一次偏移。
"万"这个字害我差点背锅。 智联的"1.8万"是月薪,猎聘的"18万"是年薪。我第一版一视同仁,导致一批岗位薪资整整高估 12 倍,报表上看着一片繁荣。后来强制按 source 决定口径,并且一律保留 salary_raw,才算能追溯。
模型会凭空造字段。 你给的标准字段里没有"绩效",它偏偏能吐出一个 bonus,因为训练时它见过类似的直觉。光靠 prompt 里写"只能用这些字段"是拦不住的,必须服务端做白名单,越界直接判失败降级。
max_new_tokens 给小了,输出到一半被截。 被截断的 JSON 长得非常像正常 JSON,JSON.parseObject 抛异常还好,有一次刚好括号齐了,只是少了一列,程序开开心心跑下去了。现在的做法是校验"映射覆盖到的列数 ≥ 表头列数 × 0.6",达不到就重试一次。
多个 sheet。 有些简历表第 1 个 sheet 是"填写说明",第 2 个才是数据。策略是遍历所有 sheet,取"识别出的表头列数 × 数据行数"最大的那个,而不是默认读第一个。
并发一上来 vLLM 就 OOM。 业务同事月底集中导表,二十个请求同时打进来。gpu-memory-utilization 从 0.85 降到 0.55,前面加一个 Semaphore 限到 4,并且把映射调用设成 800 ms 超时——超时就降级走规则字典,绝不能让导入按钮整个转圈卡死。
空列名。 合并单元格展平之前,会有连续几个空字符串当列名,模型给的答案完全随机。现在在送进模型前就把空列名改成 __col_7 这样的占位符,回来再对上去。
GBK。 老的 .xls 导出的 CSV 一律是 GBK,前端上传的 UTF-8 文件名还经常带全角括号。DataFormatter 之外,文件层面统一过一次编码。
为什么不用现成的大模型 API
有人问,接个 Qwen-Plus 不就完事了,费这劲。
三个理由。第一个是数据合规,简历和岗位表里有姓名、电话,这些出内网要走安全评审,流程比开发还长。第二个是稳定,同一个模板今天认明天不认,业务方会觉得这系统在闹脾气。第三是钱和速度,我们日均 1200 多次导入,映射又高度重复(缓存命中之后 92% 的请求根本不需要推理),一个 0.6B 常驻卡完全吃得下,成本几乎是一张卡的钱。
上线之后的体感变化很直接:新数据源接入的耗时从平均 2.5 天降到"当天上传、当天可用",剩下的工作从写映射代码变成了核对一下模型给的映射对不对。那个 1100 行的 ExcelColumnMapper 我保留了,降级还在用,但再没往里加过新分支。
还能往前走的话
多 sheet 和多模板混排现在是硬啃规则的,下一步想试试让模型顺手输出 headerRow 和列的数据类型判断,等于把 HeaderLocator 那套打分也交给它。另一个是想把 0.6B 换成 1.7B 做同数据对比——按现在的曲线看提升有限,因为瓶颈已经不在模型容量上,而在任务拆分是不是够窄。
最后留个真实感受:这件事里最值钱的不是微调那 5 分钟,而是"让模型只做映射、不做抽取"这个决定。选对任务的边界,小模型就是又快又稳的工具;选错了,70B 也能给你算错工资。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号