大模型微调核心解析:了解有监督与无监督微调差异,厘清大模型适配业务实现路径23.2
原创
大模型微调核心解析:了解有监督与无监督微调差异,厘清大模型适配业务实现路径23.2
原创
未闻花名
发布于 2026-09-21 13:36:47
发布于 2026-09-21 13:36:47
一、前言
相信大家也一样,在刚接触大模型的时候,一听到微调就觉得很高深,好像只有算法专家才能玩明白。日常刷技术文章,会频繁看到SFT、无监督微调、继续预训练这些名词,很多人分不清它们之间到底有什么区别。
后来我们我们对微调有所了解了,手里也攒了一堆业务数据,直接上手做有监督微调,投入大量人力标注样本,最后模型效果提升却微乎其微;也有人直接丢大量未标注文本跑无监督微调,结果模型发生灾难性遗忘,输出乱码、偏离任务。
本质上,不管是有监督微调还是无监督微调,核心目标都是改造通用大模型,让它适配我们自己的领域知识、业务习惯。二者没有绝对的好坏,只是适用场景、数据条件、技术代价完全不一样。
二、微调基础认知
1. 什么是大模型微调
预训练大模型,是在海量互联网通用文本上训练出来的,它学会通用语言能力、常识知识,但对垂直行业、内部业务、私有知识库一无所知。预训练阶段,模型学习的是通用世界知识;但我们要把大模型用在企业客服、行业问答、文档摘要、私有知识库问答等场景,通用能力往往不够。
微调,就是在已经训练完成的预训练模型权重基础上,使用我们自己的业务数据集,再做一轮小规模训练,更新部分或者全部模型参数,把业务知识、任务范式灌输进模型。
在这里我们要区分一个常见误区:微调不等同于全量参数训练。现在主流有全量微调、LoRA、QLoRA 等参数高效微调方案,不管是有监督还是无监督微调,都可以搭配参数高效技术,不用改动全部模型权重,降低显存开销。
很多人也会混淆“继续预训练”和微调:
- 继续预训练大多属于无监督范式,属于微调大类下的分支。
- 微调不是重训大模型,不会从零初始化权重,是站在预训练成果之上做二次适配。
2. 微调的两大方式
按照训练数据是否拥有人工标注标签,微调划分为两大范式:有监督微调(SFT)、无监督微调。
- 有监督微调:输入和期望输出成对的标注数据,告诉模型 “输入这个,你就要输出这个标准答案”。
- 无监督微调:只有原始文本,没有人工编写的答案标签,模型从文本本身的语义、上下文规律中自我学习。
SFT仅仅是有监督微调的其中一种典型应用。无监督微调也不是冷门技术,大量行业大模型的第一步领域适配,都是先用无监督微调灌入领域语料,再配合有监督微调打磨任务输出。
两者在整个大模型技术链路中承担不同分工。一般工程落地的标准链路:无监督微调做领域知识注入,有监督微调对齐输出格式、指令范式,后续再接DPO偏好对齐。二者经常组合使用,而不是二选一。
3. 训练的目标差异
大模型基础训练目标统一是自回归语言建模,也就是给定上文,预测下一个 token。两种微调都是基于这个基础目标,但数据构造逻辑天差地别。
- 有监督微调:构造指令‑回答样本,模型强制学习输入到指定输出的映射关系,损失函数聚焦于拟合人工给出的标准答案。
- 无监督微调:直接使用连续原始文档,模型学习文档内部上下文、行业术语、行文风格,没有强制标准答案,只是拟合文本本身的分布。
简单打个比方。把大模型比作学生:
- 无监督微调相当于把一堆行业专业书籍丢给学生自己阅读,学生自主理解里面的知识术语,但是没人出题,也没有标准答案。
- 有监督微调就是做习题集,每一道题目都附带标准答案,反复刷题,学会看到题目就要输出指定答案。
学生读完一堆专业书,知识面拓宽,但不一定会做题;刷了大量习题集,做题能力变强,但如果没有阅读专业书籍,缺少底层领域知识,遇到习题之外的问题就会答错。这就是为什么工程上经常两者结合。
三、有监督微调(SFT)详解
1. 核心原理
有监督微调 Supervised Fine‑Tuning,简称SFT,也是我们接触最多的微调方式。它的核心前提是数据集为成对标注样本,每一条样本包含输入Prompt和对应的期望输出Response。比如指令问答场景:Prompt写“解释什么是债权”,Response是人工写好的标准答案。
训练的时候,会把prompt和response拼接成完整文本序列,训练过程中,计算模型预测 response部分token和人工标准答案之间的交叉熵损失,反向传播更新模型参数。Prompt部分一般不参与损失计算,只作为上下文输入,只强制模型去拟合人工标注的输出。
核心前提:
- 模型底座:预训练完成的大模型,已经具备通用语言、推理能力;不重新从零训练,只做二次更新。
- 训练数据:成对样本 (Prompt输入,Response期望输出)。
样本格式示例:
<user>什么是债权</user>
<assistant>债权是得请求他人为一定行为的民法上权利……</assistant>
整套逻辑非常直白:给模型大量输入‑输出样例,让模型记住,遇到同类输入,就生成标注里类似的输出。
有监督微调不是只能做指令问答,文本分类、实体抽取、摘要、翻译都可以做。大模型时代,SFT 大多用于指令对齐,教会模型遵循人类指令,输出固定格式、固定语气的结果。
2. 损失函数:自回归交叉熵损失
大模型本质是自回归模型,任务是根据上文预测下一个 token。 有监督微调沿用预训练的交叉熵损失:

- 输入拼接好的完整序列,模型逐个预测 response 位置每一个 token;
- 将模型预测的 token 概率分布,和人工标注真实 token 做对比,计算交叉熵损失;
- 通过反向传播,更新模型参数(可以是全量参数,也可以是 LoRA/QLoRA 少量适配器参数),不断缩小预测结果与标准答案之间差距。
简单说:不断告诉模型 “你这里预测错了,把权重改一改,下次尽量输出人工写的答案”。
3. 数据集构建要点
有监督微调最大成本就是标注数据集,数据集质量直接决定最终效果,数量其次。
- 样本格式统一 必须统一对话模板,全部样本使用相同的角色标记,不能一部分用user‑assistant,一部分用别的格式。训练用什么模板,推理时就必须用一模一样的模板,格式错了效果会断崖下跌,这是高频踩坑点。
- 样本多样性 样本不能高度同质化。如果全部样本句式几乎一样,模型很容易过拟合,只会背诵训练集的答案,遇到换一种说法的提问就失效。需要丰富提问角度、表达方式。
- 样本质量优先于数量 少量高质量标注样本,效果远好于大量粗糙标注。标注答案本身就有错别字、事实错误,微调之后模型会学会这些错误。脏数据对SFT的伤害极大。
- 合理划分训练集、验证集 一定要留出验证集,监控训练过程loss变化,不能跑完训练就直接上线。当训练loss持续下降,验证loss开始上升,代表出现过拟合,需要提前终止训练。
4. 微调后的结果
- 学会指令范式:知道什么时候该充当助手回答问题,识别 user/assistant 角色;
- 学会输出格式:比如输出 JSON、列表、固定客服话术;
- 学会任务映射:同类提问,复刻标注集中的回答风格与结论;
- SFT主要学 “怎么输出”,而不是深度学新知识。
如果底座模型本身不懂某个行业知识,就算给 SFT 样本,模型只会模仿回答句式,底层概念依旧不懂,容易产生幻觉。SFT 很难凭空给模型灌入大量全新领域知识。
5. 优势与适用场景
核心优势:
- 输出可控性强:人工定义标准答案,模型能够对齐输出格式、语气、回答范式,适配指令类任务。
- 迭代方向明确:想要模型改成什么输出,直接修改标注数据,训练后就可以引导模型变化,可解释性较强。
- 适配指令对齐:RLHF/DPO 对齐流程的前置基础,几乎所有对话大模型都会经过 SFT 阶段。
- 小样本可生效:几十到几百条高质量样本,就可以看到明显任务效果提升。
适合场景:
- 指令类任务:问答、提取信息、格式化输出、生成固定格式 JSON。
- 需要严格输出范式:例如客服话术,要求回答遵循固定规范。
- 任务目标明确,能够产出输入‑输出成对标注。
- 希望修正模型输出话术、语气、回复风格。
6. 存在缺陷说明
依赖人工标注成本高:
- 质量标注耗费大量人力,垂直行业专家标注成本更高,很难做到百万级样本。
容易过拟合:
- 样本少、训练轮次过多,模型直接背诵训练集样本,泛化能力下降。输入稍微改写,就输出错误。
无法补充底层领域知识:
- SFT 本质学习的是“输入到输出的映射”,不是深度学习领域知识。
- 如果模型本身不理解行业术语,就算给标注样本,也很难真正学会复杂专业逻辑。
- 举个例子,你给大模型几百条医疗问答SFT样本,如果模型底层不懂医学概念,只是模仿回答句式,遇到复杂推导依旧会幻觉,这就是SFT的边界。
会放大标注数据中的错误:
- 标注集里面的错误事实、偏见,会被模型完整学进去,数据脏,模型就脏。
经验总结:不要直接拿 SFT 去做领域知识灌入。单纯依靠 SFT 解决领域知识缺失,效果上限很低。领域知识优先交给无监督微调,SFT 负责打磨指令输出。
7. 应用实践示例
场景:只对 assistant 回答计算loss,通过手动构造 loss mask,prompt (user 部分) 不参与损失,仅assistant回答算损失。
import torch
from datasets import Dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    TrainingArguments,
    Trainer
)
from peft import LoraConfig, get_peft_model

model_name = "Qwen/Qwen2-0.5B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)

# SFT成对样本:prompt‑response
sft_data = [
    {
        "prompt": "什么是债权?",
        "response": "债权是得请求他人为一定行为的民法上权利,债权人可以要求债务人履行对应义务。"
    },
    {
        "prompt": "债权转让需要注意什么?",
        "response": "债权人转让债权需要通知债务人,未通知债务人,转让对债务人不发生效力。"
    }
]
dataset = Dataset.from_list(sft_data)

# Qwen对话模板,拼接样本,并生成loss_mask:user部分=0不计算loss,assistant部分=1计算loss
def build_sft_sample(example):
    messages = [
        {"role": "user", "content": example["prompt"]},
        {"role": "assistant", "content": example["response"]}
    ]
    text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=False)
    tokenized = tokenizer(
        text,
        truncation=True,
        max_length=256,
        padding="max_length",
        return_tensors=None
    )
    input_ids = tokenized["input_ids"]
    labels = input_ids.copy()

    # 找到<|im_start|>assistant 的位置,前面全部mask为-100(交叉熵会忽略-100)
    assistant_start = tokenizer.encode("<|im_start|>assistant", add_special_tokens=False)
    seq_len = len(input_ids)
    pos = None
    for i in range(seq_len - len(assistant_start)):
        if input_ids[i:i+len(assistant_start)] == assistant_start:
            pos = i + len(assistant_start)
            break
    if pos is not None:
        # prompt部分设置-100,loss不计算
        labels[:pos] = [-100] * pos
    tokenized["labels"] = labels
    return tokenized

tokenized_sft = dataset.map(build_sft_sample)

training_args = TrainingArguments(
    output_dir="./sft_lora",
    per_device_train_batch_size=2,
    num_train_epochs=3,
    learning_rate=2e-5,
    logging_steps=5,
    save_strategy="epoch",
    bf16=True
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_sft,
)

if __name__ == "__main__":
    trainer.train()
    model.save_pretrained("./sft_lora/final_lora")
    tokenizer.save_pretrained("./sft_lora/final_lora")
重点说明:
- labels 中把 user/prompt 部分设置为 -100,PyTorch CrossEntropyLoss 会自动忽略该位置,只对 assistant 回答计算损失;
- 训练时用什么模板,推理必须完全一致;
四、无监督微调详解
1. 核心原理
无监督微调,训练数据集只有原始文本文档,不存在人工标注的输入‑输出配对标签。数据是连续完整的文本,比如行业书籍、行业报告、企业内部文档、技术手册。训练目标依旧是自回归预测下一个 token。模型读取连续文本,学习文本内部的上下文、专有名词、领域逻辑、行文习惯。
经常说的“领域继续预训练”,就属于无监督微调最典型实现。它不要求人为构造指令问答,直接把大段领域文档喂给模型。举个通俗例子,我们把整套法律法条文档拼接成文本序列送入模型训练。没有提问,没有标准答案,模型只需要学习法条文本本身的语言分布,记住法条术语、逻辑关系。训练完成之后,模型底层权重里面沉淀领域知识。
同时需要了解,无监督微调≠RAG。 RAG 是检索增强,不改动模型权重;无监督微调实实在在更新模型权重,知识内化进模型参数内部。两者经常搭配,但技术本质完全不同。无监督微调同样支持参数高效微调 LoRA/QLoRA,不需要全量参数训练。
核心前提:
- 模型:原始预训练大模型或经过处理的底座,复用预训练学到的通用语言能力。
- 数据:纯原始文档,书籍、行业报告、企业文档、技术手册,不需要人工标注、不需要构造 prompt‑answer 对。
- 训练目标:依然是大模型原生的自回归下一个token预测,和预训练阶段目标一模一样。
示例输入样本:直接是连续文档片段
“民法典第五百四十六条,债权人转让债权,未通知债务人的,该转让对债务人不发生效力……”
没有用户问题,没有指定标准答案,就是一段自然连续的文本。
2. 数据集构建要点
无监督微调不需要人工打标签,但不代表数据集可以随便丢进去,数据集处理同样关键。
- 文本清洗过滤:需要过滤低质量网页、乱码、重复文档、错误内容。无监督微调会全盘吸收输入文本的一切内容,脏文本会直接污染模型,带来大量幻觉。重复文档过多,极易造成过拟合。
- 文本切片处理:长文档按照模型上下文窗口做切片,切分成合适长度连续片段。不要把不相关的文档强行拼接在一起,会制造虚假上下文,干扰模型学习。
- 不需要构造问答对:不需要人为生成问题答案,保留原始文档自然上下文。不要模仿SFT的样本格式。
- 验证集构造:从领域文档中抽一部分作为验证集,监控语言建模loss,观察模型对领域文本的拟合程度。
数据处理逻辑:
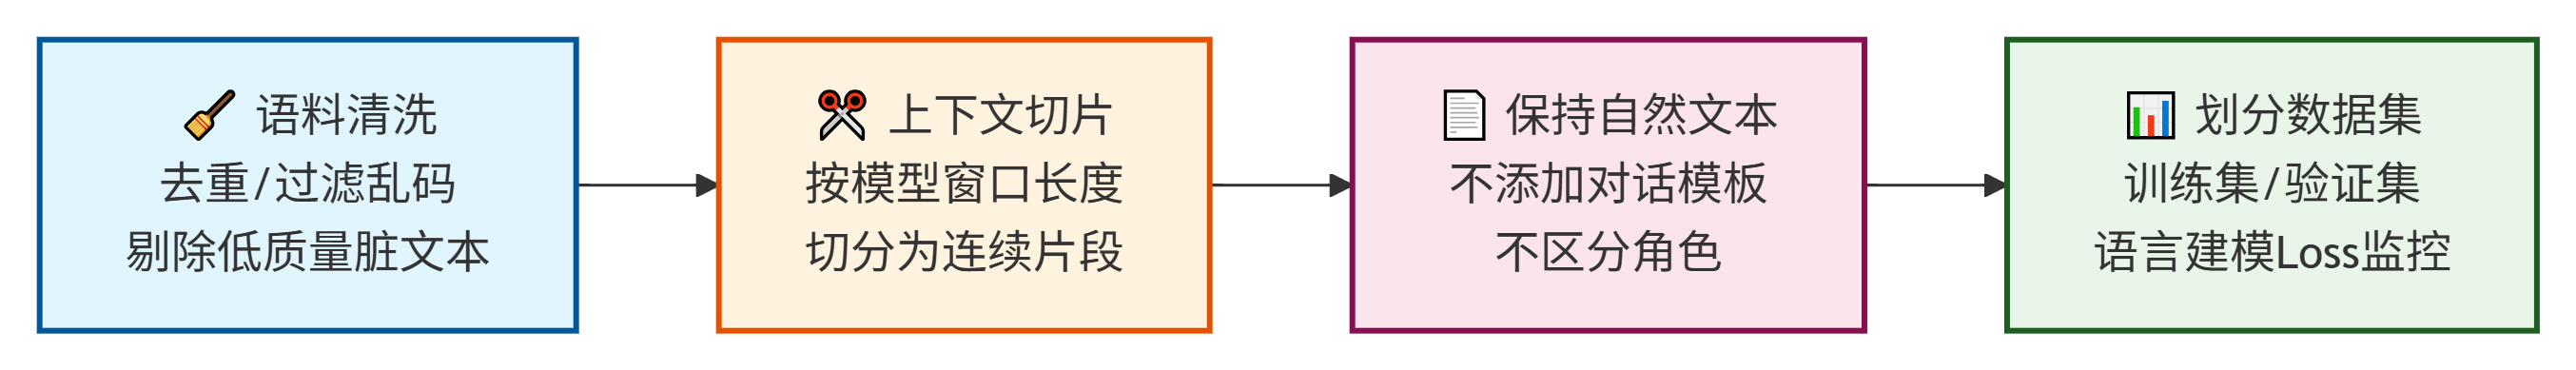
- 1. 对原始语料做清洗:去重、过滤乱码、剔除低质量脏文本。无监督微调会全盘吸收输入文本,脏数据直接带来幻觉。
- 2. 按模型上下文窗口做切片:把长文档切为固定长度的连续片段。
- 3. 不添加对话模板,不区分 user/assistant,保持原文自然上下文。
- 4. 划分训练集、验证集,用领域文本的语言建模 loss 监控训练质量。
注意:不要把多篇完全无关文档强行拼接成一条样本,会制造虚假上下文,模型学到错误语义关联。
3. 损失与训练过程
沿用自回归交叉熵损失,和预训练目标完全一致:

- 1. 将一段连续领域文本转为 token 序列输入模型;
- 2. 模型根据上文,预测序列中每一个位置的下一个 token;
- 3. 将预测 token 分布和真实原文 token 做对比计算交叉熵损失;
- 4. 反向传播更新权重(可以全量微调,也可以 LoRA/QLoRA 参数高效微调),让模型越来越 “擅长生成这类领域文本”。
和 SFT 有监督微调最关键区别:
- SFT:只对回答部分算损失,prompt 部分不参与损失,强迫模型学会输入→指定输出的任务映射。
- 无监督微调:整条文本全部参与损失计算,模型只是拟合这份领域文本本身,不存在 “问题、答案” 的概念。
4. 微调后的结果
- 学会领域专有名词、专业术语、概念关系;
- 学习行业文本的行文习惯、句式逻辑;
- 在模型底层权重沉淀领域知识,缓解通用大模型的领域幻觉;
同时需要注意:
- 不会自动学会 “用户提问,助手回答” 的对话范式;
- 不会自动对齐输出格式,不会自动输出 JSON、固定话术;
- 没有标准答案约束,输出自由度很高,不会约束模型怎么回复用户。
通俗比喻: 预训练模型 = 懂通识的学生; 无监督微调 = 给学生一堆专业书籍让他自主通读,扩充专业知识库; 读完书,知识变多,但没人教他怎么做习题,拿到题目依旧不一定会答题。
5. 优势与适用场景
核心优势:
- 无需昂贵人工标注:只要能拿到原始领域文本就可以训练,适合文档资源丰富、缺少标注人力的场景。
- 注入底层领域知识:修改模型底层知识分布,真正补齐大模型缺失的行业常识、专有名词。解决通用大模型不懂行业概念的根本问题。
- 拓展模型行文风格:可以学习企业内部文档的写作风格,生成符合行业习惯文本。
适合场景:
- 垂直领域大模型构建:法律、医疗、工业、金融行业,拥有大量原始文档。
- 模型缺少领域基础常识,频繁出现领域概念幻觉。
- 缺少人力做大量指令标注。
- 前置底座处理:先做无监督领域微调,再基于得到的底座,去做后续SFT指令微调,这是行业主流流水线。
6. 存在缺陷说明
没有对齐指令能力:
- 无监督微调完成后的模型,懂行业知识,但不一定听得懂人类指令。
- 如果我们直接提问,它可能续写文档,而不是回答我们的问题。
- 它只学会写领域文本,没学会 “用户提问,助手回答” 这套交互范式。
- 这个问题很容易出现,做完无监督微调直接上线对话,效果很差。
容易发生灾难性遗忘:
- 当领域语料和原始预训练通用文本分布差距过大,大量训练轮次之后,模型会丢失通用能力,常识变差、基础语法出错,输出乱码。
- 必须控制训练步数、学习率,不可过度训练。
输出不可控:
- 没有标准答案约束,模型自由续写,输出内容自由度高,事实幻觉风险依旧存在,无法约束输出格式。
无法直接解决任务对齐:
- 不能指望无监督微调之后,模型自动学会输出 JSON、客服话术这类指定格式,该部分依旧需要交给SFT完成。
7. 应用实践示例
场景:输入纯领域原始文本,无问答对,自回归预测下一个 token,全部文本参与 loss。
import torch
from datasets import Dataset
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    TrainingArguments,
    Trainer,
    DataCollatorForLanguageModeling
)
from peft import LoraConfig, get_peft_model

model_name = "Qwen/Qwen2-0.5B-Instruct"

# 1. 加载模型、tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# 2. LoRA配置
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()

# 3. 构造无监督语料:纯领域文档文本,没有问答
raw_texts = [
    "民法典第五百四十六条,债权人转让债权,未通知债务人的,该转让对债务人不发生效力。",
    "债权转让的通知不得撤销,但是经受让人同意的除外。",
    "合同变更指有效成立的合同在尚未履行或未履行完毕之前,由于一定法律事实的出现而使合同内容发生改变。"
]
dataset = Dataset.from_dict({"text": raw_texts})

# 4. 文本tokenize,连续语言建模
def tokenize_fn(examples):
    return tokenizer(
        examples["text"],
        truncation=True,
        max_length=256,
        padding="max_length"
    )

tokenized_ds = dataset.map(tokenize_fn, batched=True)
data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False  # 因果LM,不是掩码MLM
)

# 5. 训练参数
training_args = TrainingArguments(
    output_dir="./unsupervised_ft_lora",
    per_device_train_batch_size=2,
    num_train_epochs=3,
    learning_rate=2e-5,
    logging_steps=5,
    save_strategy="epoch",
    fp16=False,
    bf16=True,
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_ds,
    data_collator=data_collator,
)

if __name__ == "__main__":
    trainer.train()
    model.save_pretrained("./unsupervised_ft_lora/final_lora")
    tokenizer.save_pretrained("./unsupervised_ft_lora/final_lora")
重点说明:
- DataCollatorForLanguageModeling(mlm=False):整条序列全部参与loss计算;
- 输入是纯文本,没有user/assistant模板;
- 目标和预训练完全一致:预测下一个token。
五、两种微调对比
1. 核心维度对比
数据条件:
- 有监督微调:需要标注好的 {prompt,response} 成对样本,标注成本高。
- 无监督微调:原始无标签文档,不需要人工标注,数据获取门槛低。
学到的内容:
- 有监督微调:学习指令与输出之间映射关系,对齐任务范式、输出格式。
- 无监督微调:学习领域知识、术语、文本分布,更新底层知识底座。
能力侧重点:
- 有监督微调:任务对齐强,知识补强弱。
- 无监督微调:知识补强强,指令对齐弱。
过拟合表现:
- 有监督微调:背诵训练集问答样例。
- 无监督微调:丢失通用能力、灾难性遗忘。
典型在流水线位置:
- 无监督微调:底座预处理阶段。
- 有监督微调:指令对齐阶段。
关键对比小结:
项目 | 有监督微调 SFT | 无监督微调(领域继续预训练) |
|---|---|---|
数据 | {prompt,response} 标注问答对 | 无标签原始连续文档 |
损失计算 | 仅 Response 回答部分算损失 | 整条文本全部参与损失 |
学习重点 | 输入到输出的任务映射、指令范式 | 领域知识、术语、文本分布 |
产出效果 | 会做题,遵从指令 | 扩充知识库,不一定会做题 |
典型风险 | 过拟合背诵样本 | 灾难性遗忘、丢失通用能力 |
2. 应用实践方案
只做有监督微调:
- 适用:领域知识模型本身已经掌握,核心问题是输出格式、指令、话术不对。
- 局限:如果模型不懂行业概念,仅靠 SFT 上限很低。
只做无监督微调:
- 适用:只需要生成领域文档文本,不需要对话问答。
- 局限:不能直接拿来做对话问答,听不懂用户指令。
无监督微调 + 有监督微调:
兼顾领域知识与指令遵从,大多数开源行业大模型实践的完整链路:
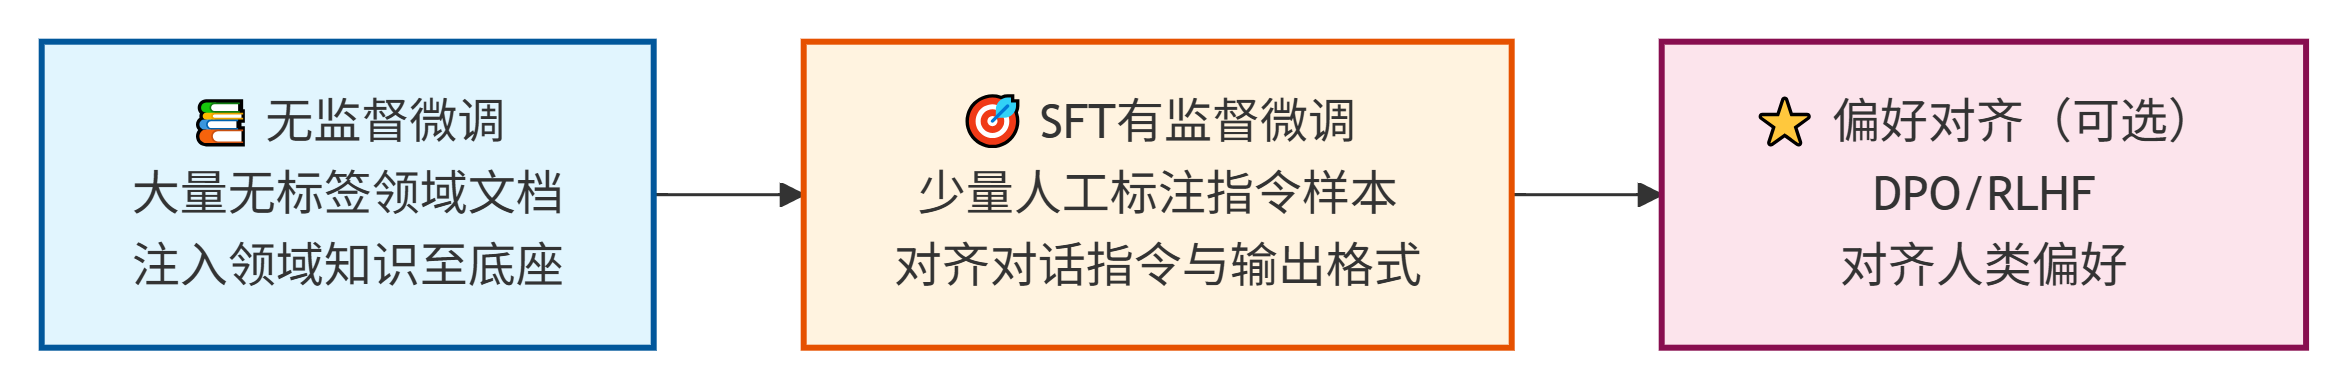
- 1. 使用大量无标签领域文档,执行无监督微调,把领域知识灌入模型底座。
- 2. 在更新后的底座之上,使用少量人工标注指令样本,执行SFT有监督微调,对齐对话指令、输出格式。
- 3. 可选:后续追加 DPO/RLHF 做人类偏好对齐。
3. 微调场景选择
不要盲目上来就做全量参数微调。LoRA、QLoRA 参数高效微调,两种微调范式都支持,可以极大降低硬件显存压力,普通消费级显卡就可以完成实验,优先选择参数高效方案做原型验证。
方案选择前可以问自己三个问题:
- 模型是不是经常搞错行业专有名词?经常出现领域幻觉? 如果是,优先补上无监督微调,补强底层知识。
- 模型懂知识,但是提问之后输出乱七八糟,不按照要求输出 JSON、固定话术? 优先使用有监督 SFT 微调对齐指令范式。
- 手上资源是大量原始文档,还是少量人工问答标注? 多原始文档,走无监督;有高质量问答标注,走 SFT;两者都有,优先组合方案。
六、总结
有监督微调SFT依靠成对标注样本,教会模型 “看到什么输入,输出什么结果”,擅长对齐指令、约束输出格式,是对话模型必不可少的一环,但受限于标注成本,很难深度补充底层领域知识,容易过拟合背诵样本。
无监督微调依托无标签原始领域文档,完成领域知识内化,低成本改造模型底座,补齐行业术语与逻辑;但是它不会教会模型遵从人类指令,直接拿来对话往往效果糟糕,训练不当会引发灾难性遗忘。
二者不是互斥二选一的关系,而是能力互补。应用实践的标准做法,大多先用无监督微调把行业知识注入底座,再叠加有监督微调做指令对齐。微调不是万能银弹,不能指望少量微调就修复模型全部问题。要分清问题根源:是模型本身不知道知识,还是知道知识但是不会按格式回答。知识问题交给无监督微调,指令范式问题交给有监督微调。理解两种范式的边界,结合自身数据集条件选择合适方案,才可以少踩坑,拿到稳定可落地的大模型效果。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号