给非技术同事科普 AI 的正确姿势:我用 3 个真实案例讲明白了
原创
给非技术同事科普 AI 的正确姿势:我用 3 个真实案例讲明白了
原创
大盘鸡拌面
发布于 2026-09-22 19:52:33
发布于 2026-09-22 19:52:33
这篇文章不是讲大模型原理的,原理我自己也没啃透。我想说的是另一件事——过去一年,我被运营、财务、HR、客服轮番拉去问"AI 到底怎么用",前几次我都讲砸了,直到换了种讲法。下面这 3 个案例都是真事,代码也是我实际在跑的东西(脱敏过)。如果你身边也有同事一边听说 AI 很神、一边又不知道从哪下手,也许能直接拿去用。
一、我第一次讲砸,是因为我讲了原理
去年部门搞了一次分享,让我给非技术同事讲讲 AI。我准备得特别认真,从"什么是大语言模型"讲起,讲了 token、讲了注意力机制、讲了为什么它会一本正经地胡说八道。PPT 做了二十多页,自认为逻辑很顺。
讲完之后,运营的小刘问我一句话:"所以……我明天上班,到底拿它干啥?"
我当时愣在那儿,答不上来。
那次之后我复盘了很久,发现问题不在我讲得深不深,而在于——我讲的是"它是什么",同事想知道的是"它能替我干哪一段活"。这两件事差得非常远。你跟一个每天要处理两百条差评的运营讲注意力机制,就像跟一个想学开车的人讲发动机热效率,听完他还是不会上路。
后来我把讲法整个换了,效果立竿见影。先给你看我现在用的这套路径:
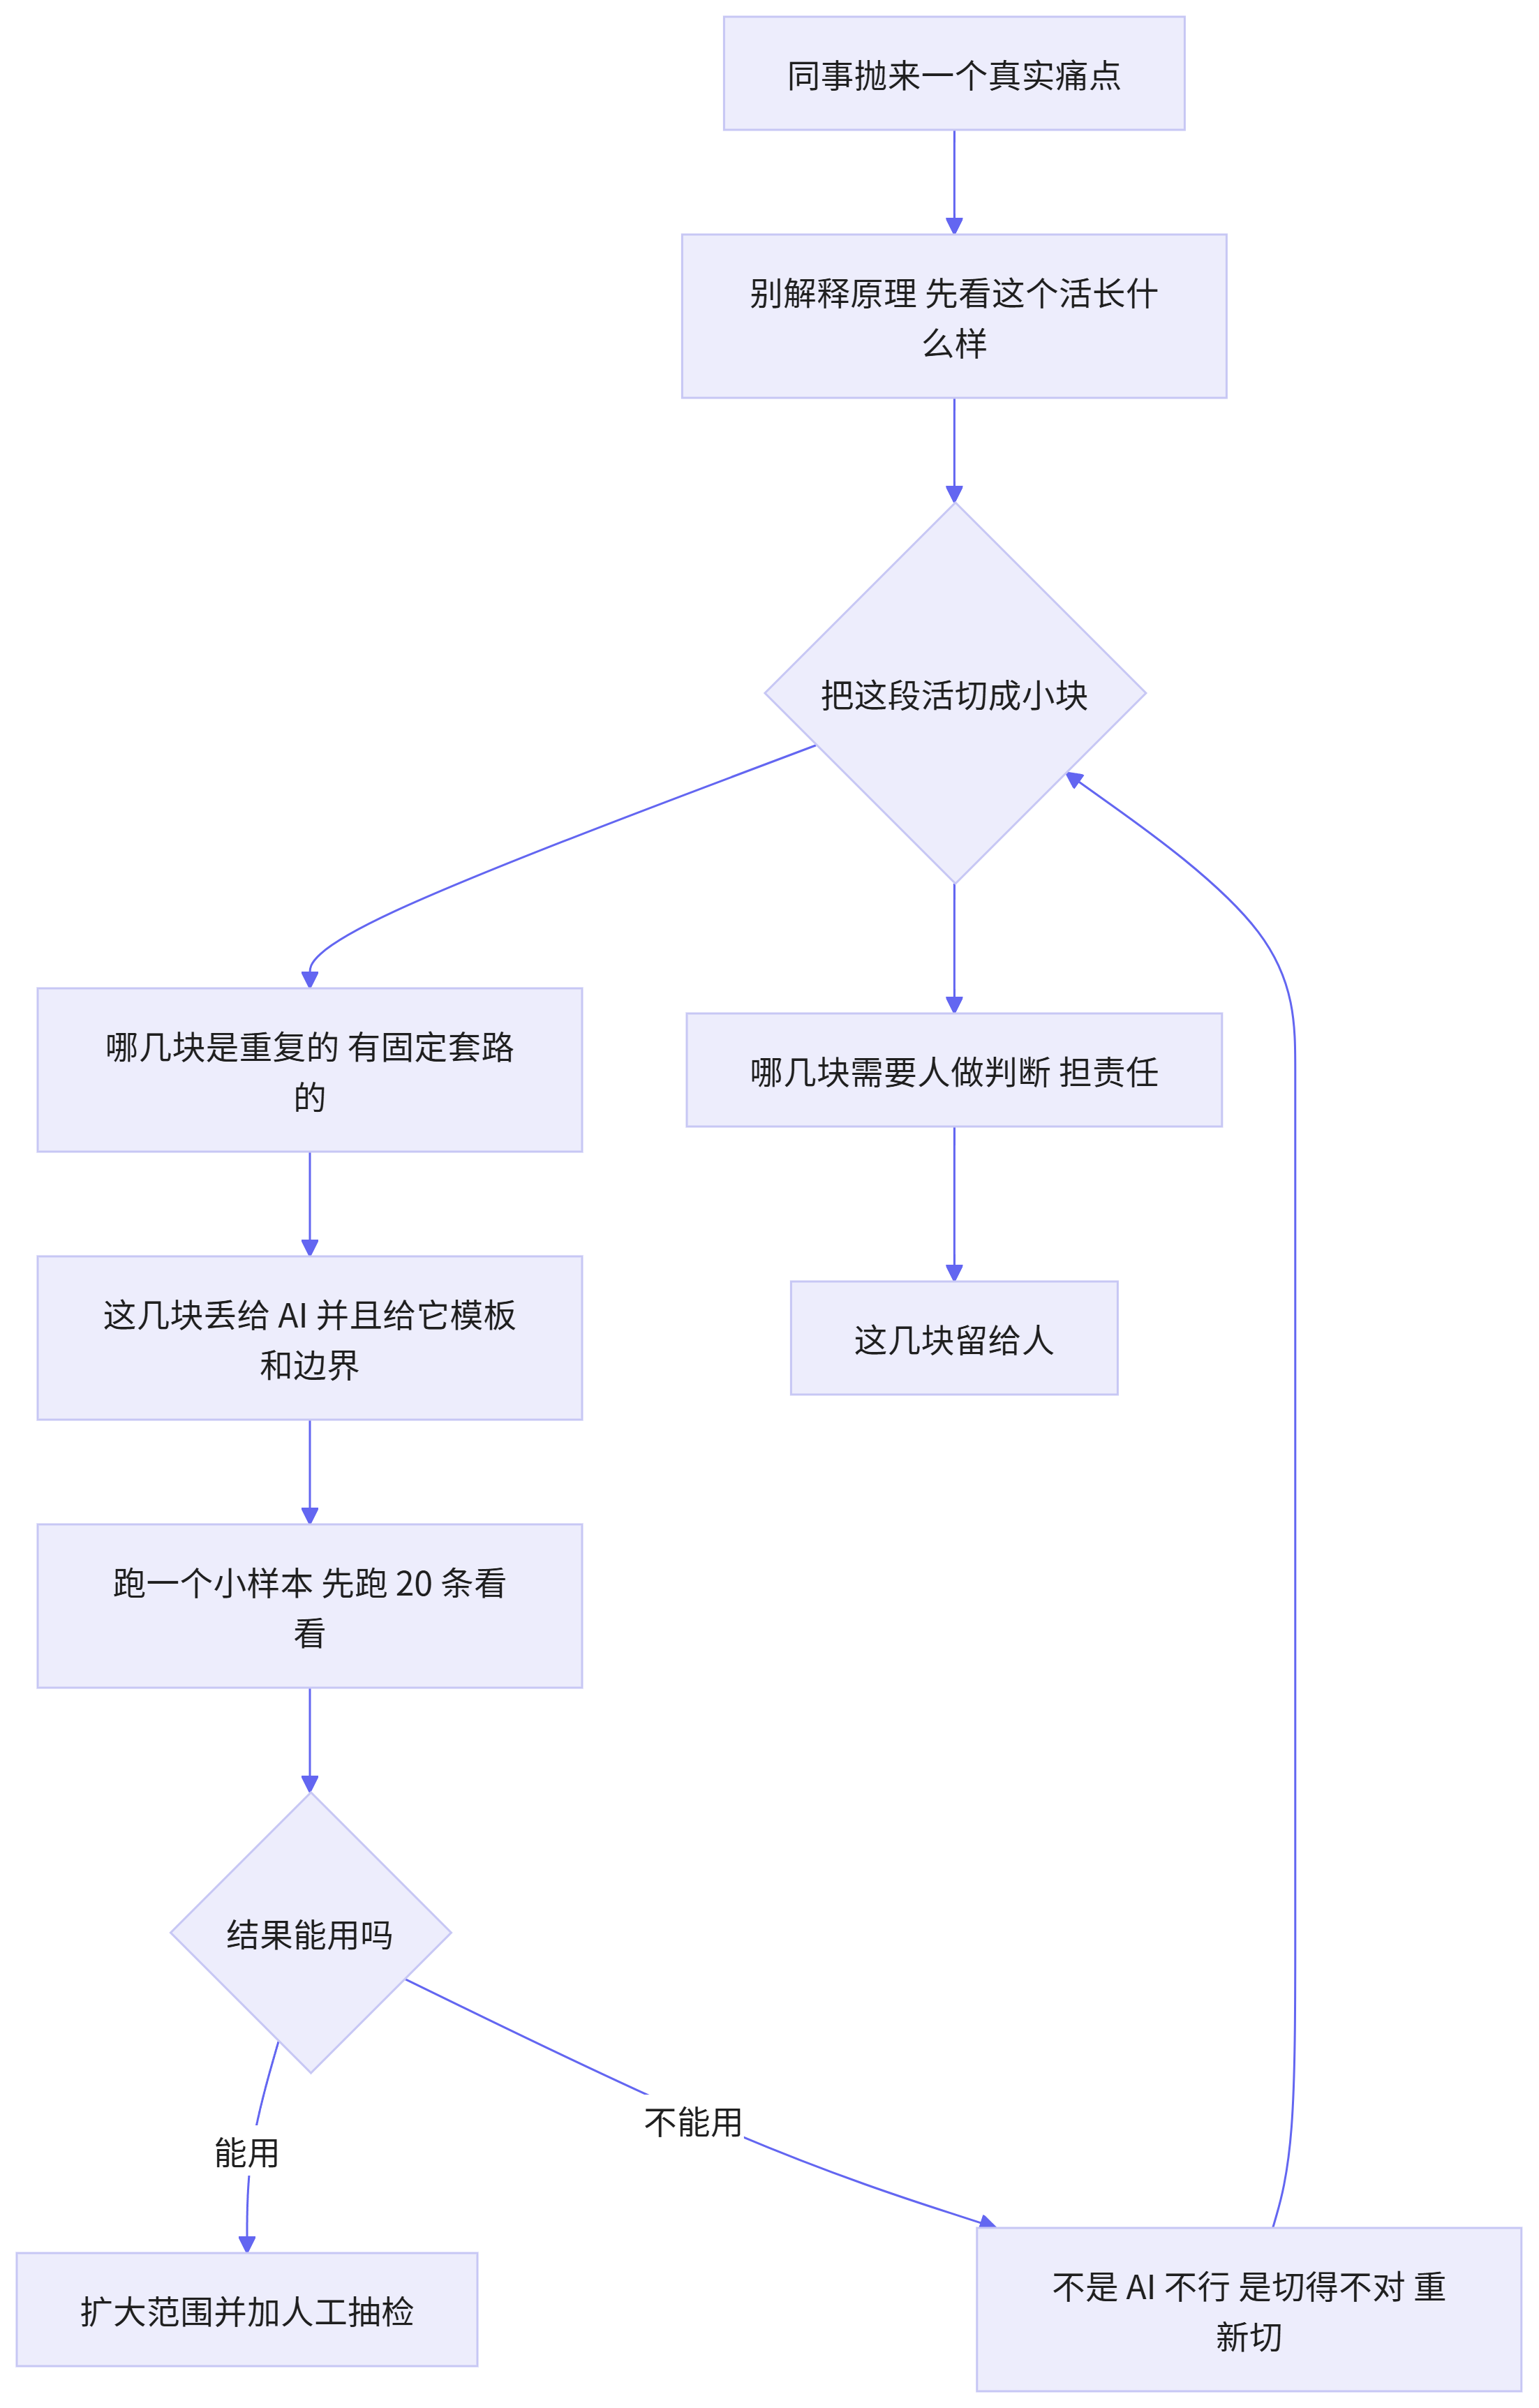
这套路径的核心就一句话:别让同事去理解 AI,让 AI 去适配同事手上的活。方向一反,事情就通了。
二、案例一:运营小刘的两百条差评
小刘管店铺售后,每个月要把上个月的差评分类打标,然后写进复盘里。分类大概有六七种:物流慢、质量差、色差、客服态度、尺码不准、描述不符、其他。
她之前怎么干呢?导一份 Excel 出来,两千多条评论,一条一条看,往下拉标签。我见过她干这活,眼睛盯着屏幕,鼠标点得飞快,一小时大概能过三百条。干完一整份,要两三天,而且到后面人麻了,标签就开始乱填。
我没跟她讲任何原理,就问了她一个问题:"这些标签,是不是你看了句子就能定,基本不用查别的东西?"
她说对啊,看一眼就知道。
我说,那这就成了。这种"看一眼就知道、但要重复两千次"的活,就是 AI 最擅长接的那一类。
我给她写了个脚本,逻辑非常简单:读 Excel → 拼提示词 → 拿结果 → 写回去。
import pandas as pd
import json
from openai import OpenAI

client = OpenAI(base_url="https://your-gateway/v1", api_key="sk-xxx")

# 标签必须是我们业务里真实要用的,不能让模型自由发挥
LABELS = ["物流慢", "质量差", "色差", "客服态度", "尺码不准", "描述不符", "其他"]

def classify(text: str) -> dict:
    prompt = f"""
你是电商售后专员。请判断下面这条差评属于哪一个标签。

只能从这几个里面选一个:{"/".join(LABELS)}
如果你真的判断不了,就选"其他",不要自己造标签。

除了标签,再给一句不超过15字的理由。

必须只返回 JSON,格式:{{"label": "xxx", "reason": "xxx"}}

差评内容:{text}
"""
    resp = client.chat.completions.create(
        model="qwen-plus",
        messages=[{"role": "user", "content": prompt}],
        temperature=0,          # 分类任务,要的是稳定,不是创意
        response_format={"type": "json_object"},
    )
    try:
        data = json.loads(resp.choices[0].message.content)
        if data.get("label") not in LABELS:   # 兜底:模型乱答就归到"其他"
            data["label"] = "其他"
        return data
    except Exception:
        return {"label": "其他", "reason": "解析失败"}

df = pd.read_excel("差评.xlsx")
rows = []
for t in df["评论内容"]:
    r = classify(str(t))
    rows.append(r)

df["标签"] = [r["label"] for r in rows]
df["判断理由"] = [r["reason"] for r in rows]
df.to_excel("差评_已打标.xlsx", index=False)

print(df["标签"].value_counts())
小刘第一次跑,只跑了 50 条。她自己抽了 10 条出来对,对了 9 条。她当时的原话是:"那条错得也合理,那条评论确实又骂物流又骂质量。"
后来她两千多条全跑完,用了不到二十分钟,自己再花半小时抽查。以前三天的活,现在一个下午。
这个案例我想说明的其实是第三行代码里那个 temperature=0。但我没这么讲。我跟小刘说的是:"你把它当成一个新来的实习生,打字飞快、不喊累,但你得告诉他只能从这七个标签里选,不然他自己能给你编出第十一个来。"
她一下就懂了。
整个过程是这样跑的:
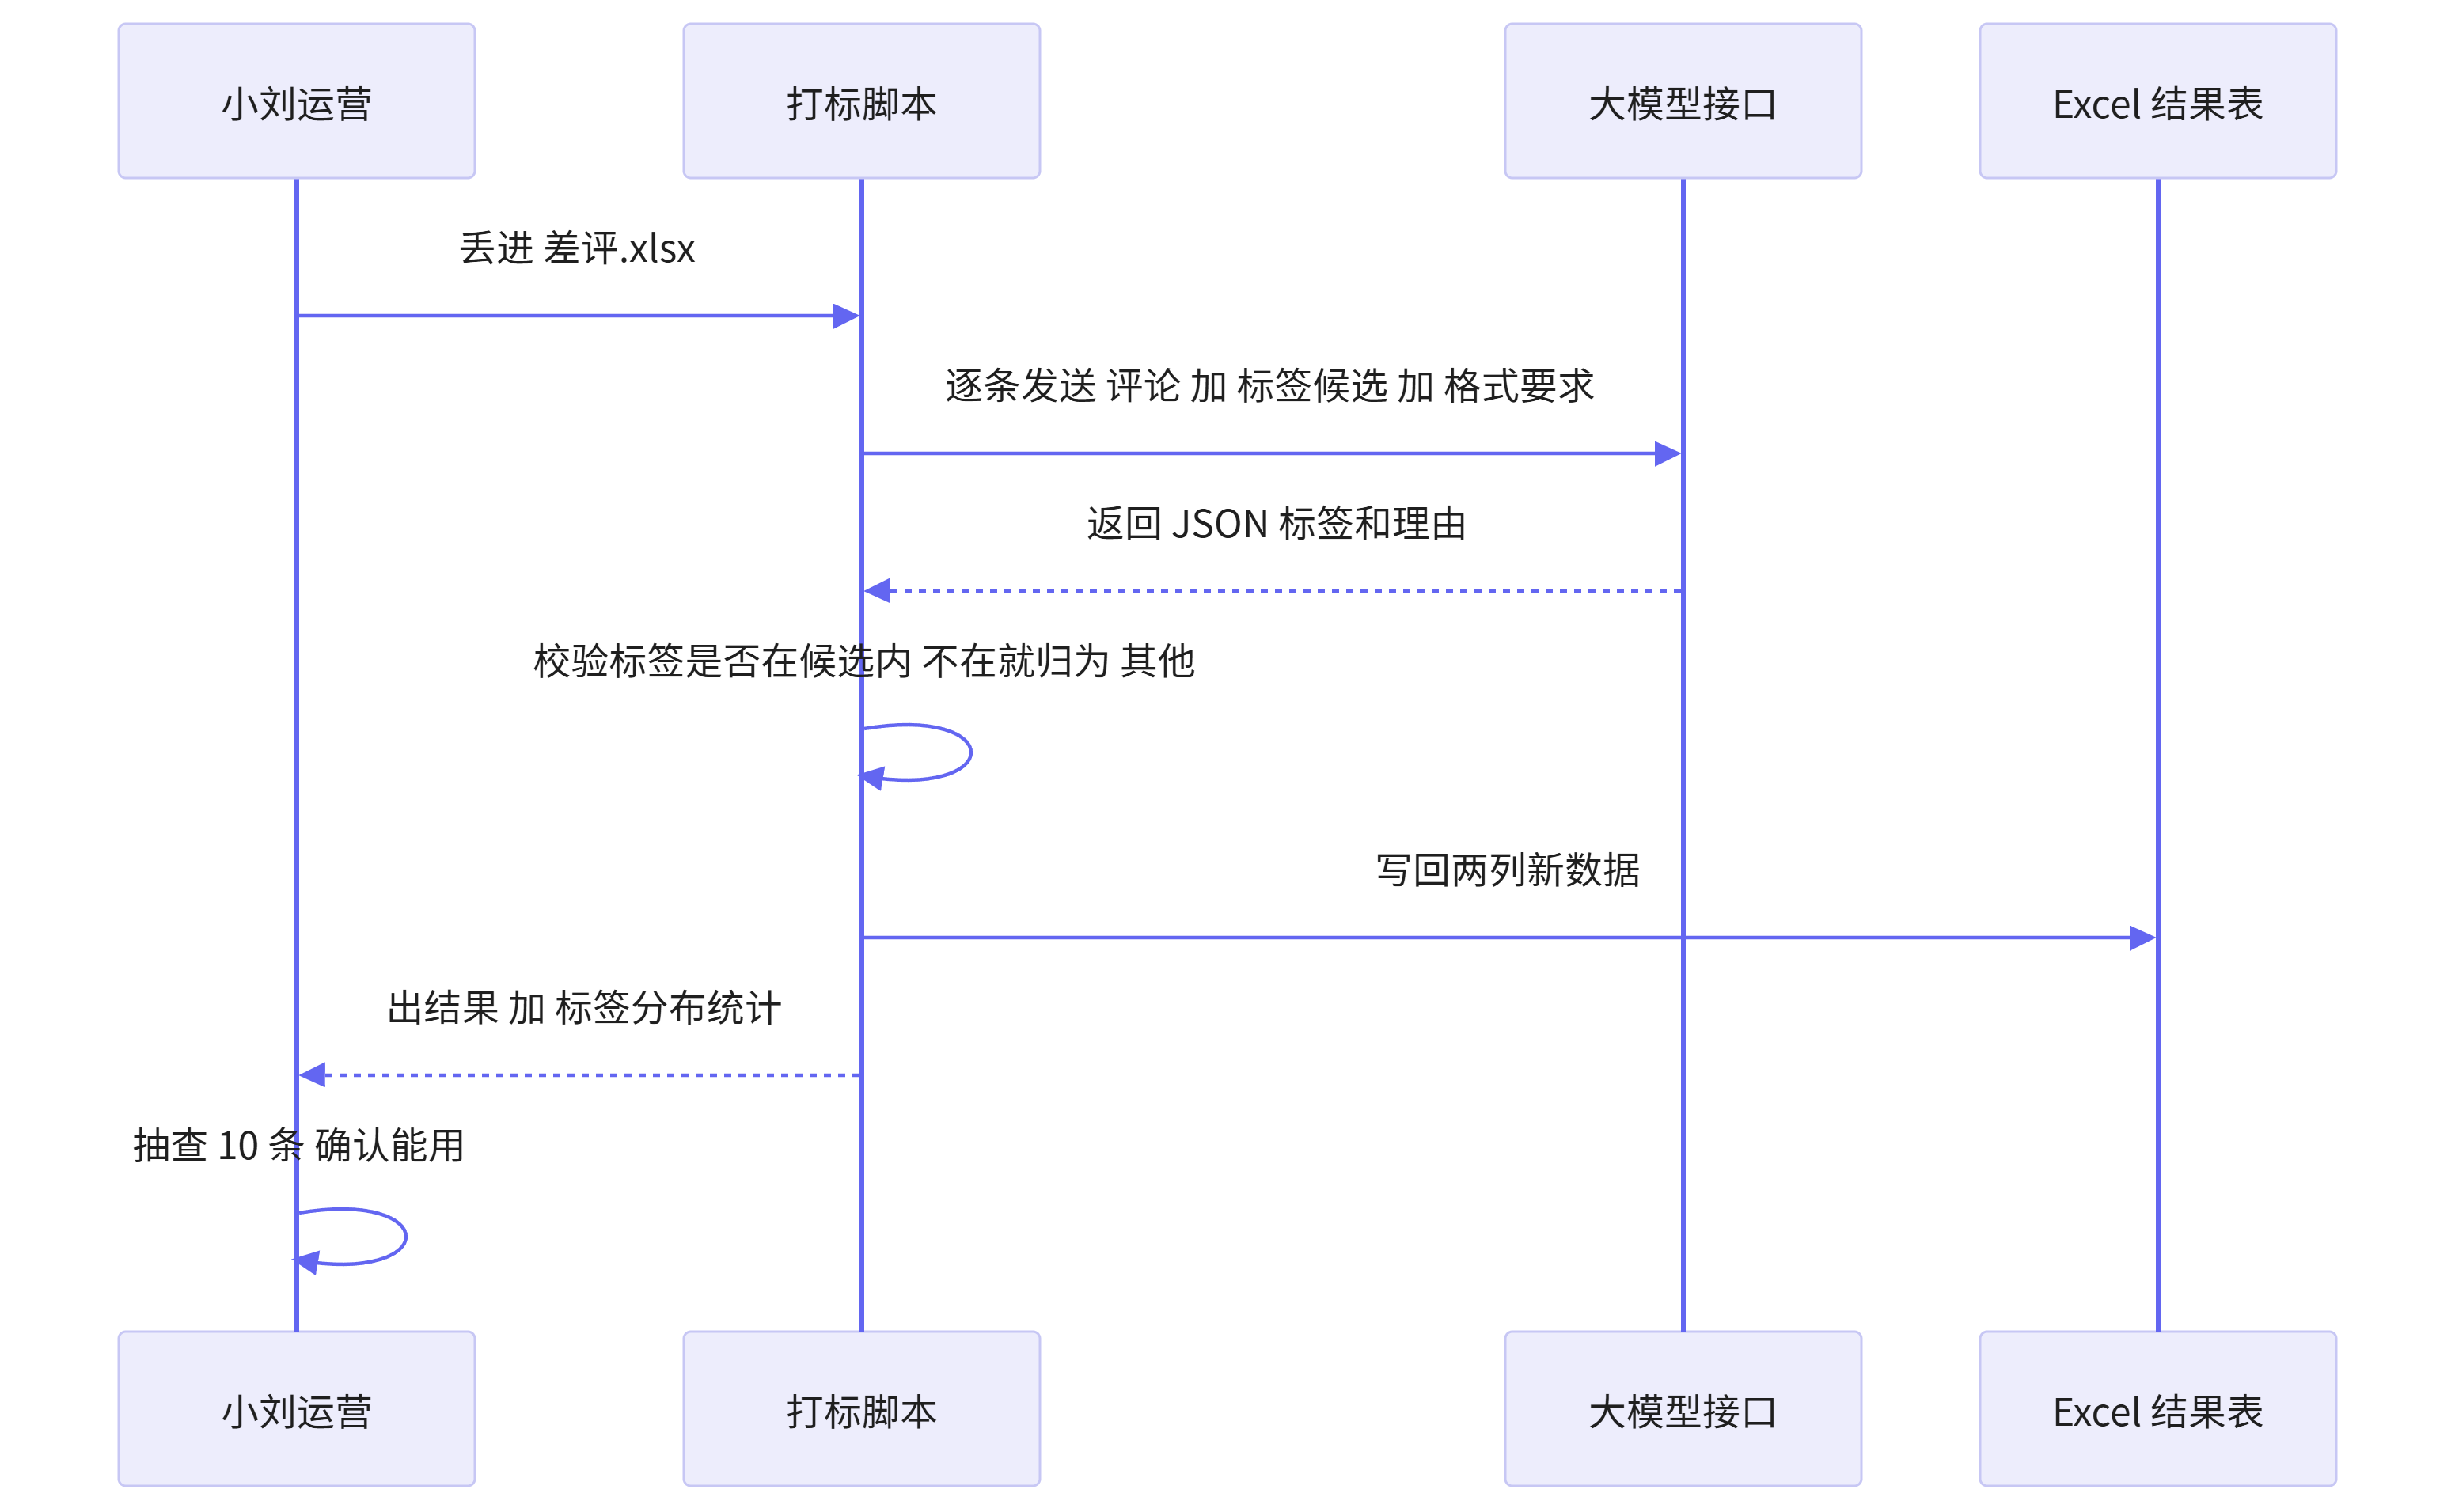
注意中间那一步"校验标签是否在候选内"。这一步是我加的,不是模型自带的。凡是你要把结果落到表格里、落到系统里的场景,都必须加这道人工校验,不然模型哪天心情不好给你返回一个"物流太慢了",你的透视表就废了。
三、案例二:财务王姐的报销单,教会我"给模板"
第二个案例是财务的王姐。她每个月要处理几百张发票和报销单,最烦的是从一堆 PDF、图片里把信息摘出来:发票号码、开票日期、金额、税额、供应商名称。
她试过直接问 AI:"帮我从这张发票里提取信息。"结果第一次拿到的结果是一段话,第二次是一个表格,第三次又变成一堆键值对。格式每次都不一样,她根本没法往系统里贴。
问题出在哪?她给了任务,但没给"长什么样"。
人跟人协作的时候也一样。你跟实习生说"把这份材料整理一下",他交上来什么格式都有可能。但你要是给他一个填好的样表,说"就按这个填",他基本不会跑偏。AI 一模一样。
我的做法是用一个数据结构把输出的形状钉死,让它没法自由发挥。
from pydantic import BaseModel, Field
from typing import Literal, Optional
import json

class Invoice(BaseModel):
    invoice_no: str = Field(description="发票号码,纯数字")
    date: str = Field(description="开票日期,格式 YYYY-MM-DD")
    seller: str = Field(description="销售方名称")
    amount: float = Field(description="价税合计金额,单位元")
    tax: Optional[float] = Field(None, description="税额,没有就填 null")
    category: Literal["交通", "餐饮", "住宿", "办公", "其他"] = Field(
        description="按费用性质归类"
    )
    confidence: float = Field(description="你对这次提取的把握,0到1之间")

def extract(ocr_text: str) -> Invoice:
    schema = Invoice.model_json_schema()
    prompt = f"""
从下面的发票文本里提取字段,严格按照这个 JSON Schema 输出:
{json.dumps(schema, ensure_ascii=False)}

规则:
- 看不清的字段不要瞎猜,字符串填 "",数字填 null
- confidence 低于 0.6 的,请在最后加一句提醒
- 只输出 JSON,不要解释

发票文本:
{ocr_text}
"""
    resp = client.chat.completions.create(
        model="qwen-plus",
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    return Invoice.model_validate_json(resp.choices[0].message.content)

# 跑一张
inv = extract(ocr_text)
print(inv.amount, inv.category, inv.confidence)
这里真正起作用的不是 Pydantic 这个库本身,而是 confidence 这个字段。
我让模型在输出信息的同时,顺便自报一下"我有几成把握"。然后我在代码里加了一条:凡是 confidence < 0.6 的,单独挑出来,放进一个"人工复核清单"。
王姐现在的工作流变成:几百张发票跑一遍,大概八九十张是低把握的,她只复核这八九十张,剩下的直接过。她说以前是"每张都得盯",现在是"只有可疑的才需要我看"。
我后来跟她总结过一句她特别爱引用的话:"不要让 AI 替你做决定,让它替你把'不用做决定'的那部分先清掉。"
顺便说个细节。这段代码里有一句"看不清的字段不要瞎猜,填 null"。这句话看着不起眼,实际非常关键。不加这句,模型遇到模糊的发票号码,会给你编一个看起来很像的号码出来——那才是最可怕的,因为你根本看不出它是编的。允许 AI 说"我不知道",比逼它每次都给答案,要安全得多。
四、案例三:HR 的制度问答,让我学会了先讲"它会骗你"
第三个案例是 HR 的小周。她想做一个员工问答机器人,回答"年假怎么算""出差补贴标准是多少""试用期多久"这类问题,因为每天回答重复问题确实烦。
这个需求我一开始是有点犹豫的。因为这类场景最容易翻车——模型不知道的东西,它不会说不知道,它会编一个听起来特别合理的答案。你问它"我们公司试用期几个月",它根本没读过你们公司制度,但它会给你一个"一般为 3 个月"的回答,还说得挺笃定。员工信了,出了事算谁的?
所以我这次是先讲风险,再给方案。我直接跟小周说:这玩意会瞎编,但只要加一层,就能把它按住。
这一层就是"先检索,再回答"——先把相关的制度原文找出来,塞给模型,让它只能依据这段原文回答,原文里没有就明确说没有。
import numpy as np

# 1) 把制度文档切块,全部转成向量(一次性做,存起来)
chunks = split_by_section("员工手册.md")          # 按章节切,别按字数硬切
vectors = np.array([embed(c) for c in chunks])    # 每条一个向量

def embed(text: str) -> list:
    r = client.embeddings.create(model="text-embedding-v3", input=text)
    return r.data[0].embedding

def ask(question: str, top_k: int = 3, threshold: float = 0.45):
    qv = np.array(embed(question))
    # 2) 余弦相似度,找最像的几段
    sims = vectors @ qv / (np.linalg.norm(vectors, axis=1) * np.linalg.norm(qv))
    idx = np.argsort(sims)[::-1][:top_k]

    picked = [(chunks[i], float(sims[i])) for i in idx if sims[i] >= threshold]

    # 3) 最关键的一步:一段都够不上,就直接认怂
    if not picked:
        return {"answer": "员工手册里没查到相关内容,建议直接问 HR。",
                "source": None, "ok": False}

    context = "\n\n---\n\n".join(f"[{c}]\n{t}" for t, c in picked)
    prompt = f"""
只根据下面这段制度原文回答问题。
如果原文里没有答案,就原话说"制度里没有相关规定",绝对不许自己推测或补充。
回答完,把依据的那一条原文附在最后。

制度原文:
{context}

问题:{question}
"""
    resp = client.chat.completions.create(
        model="qwen-plus",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.2,
    )
    return {"answer": resp.choices[0].message.content,
            "source": [c for _, c in picked], "ok": True}
这段代码里有两道闸门,我给小周画了这张图:
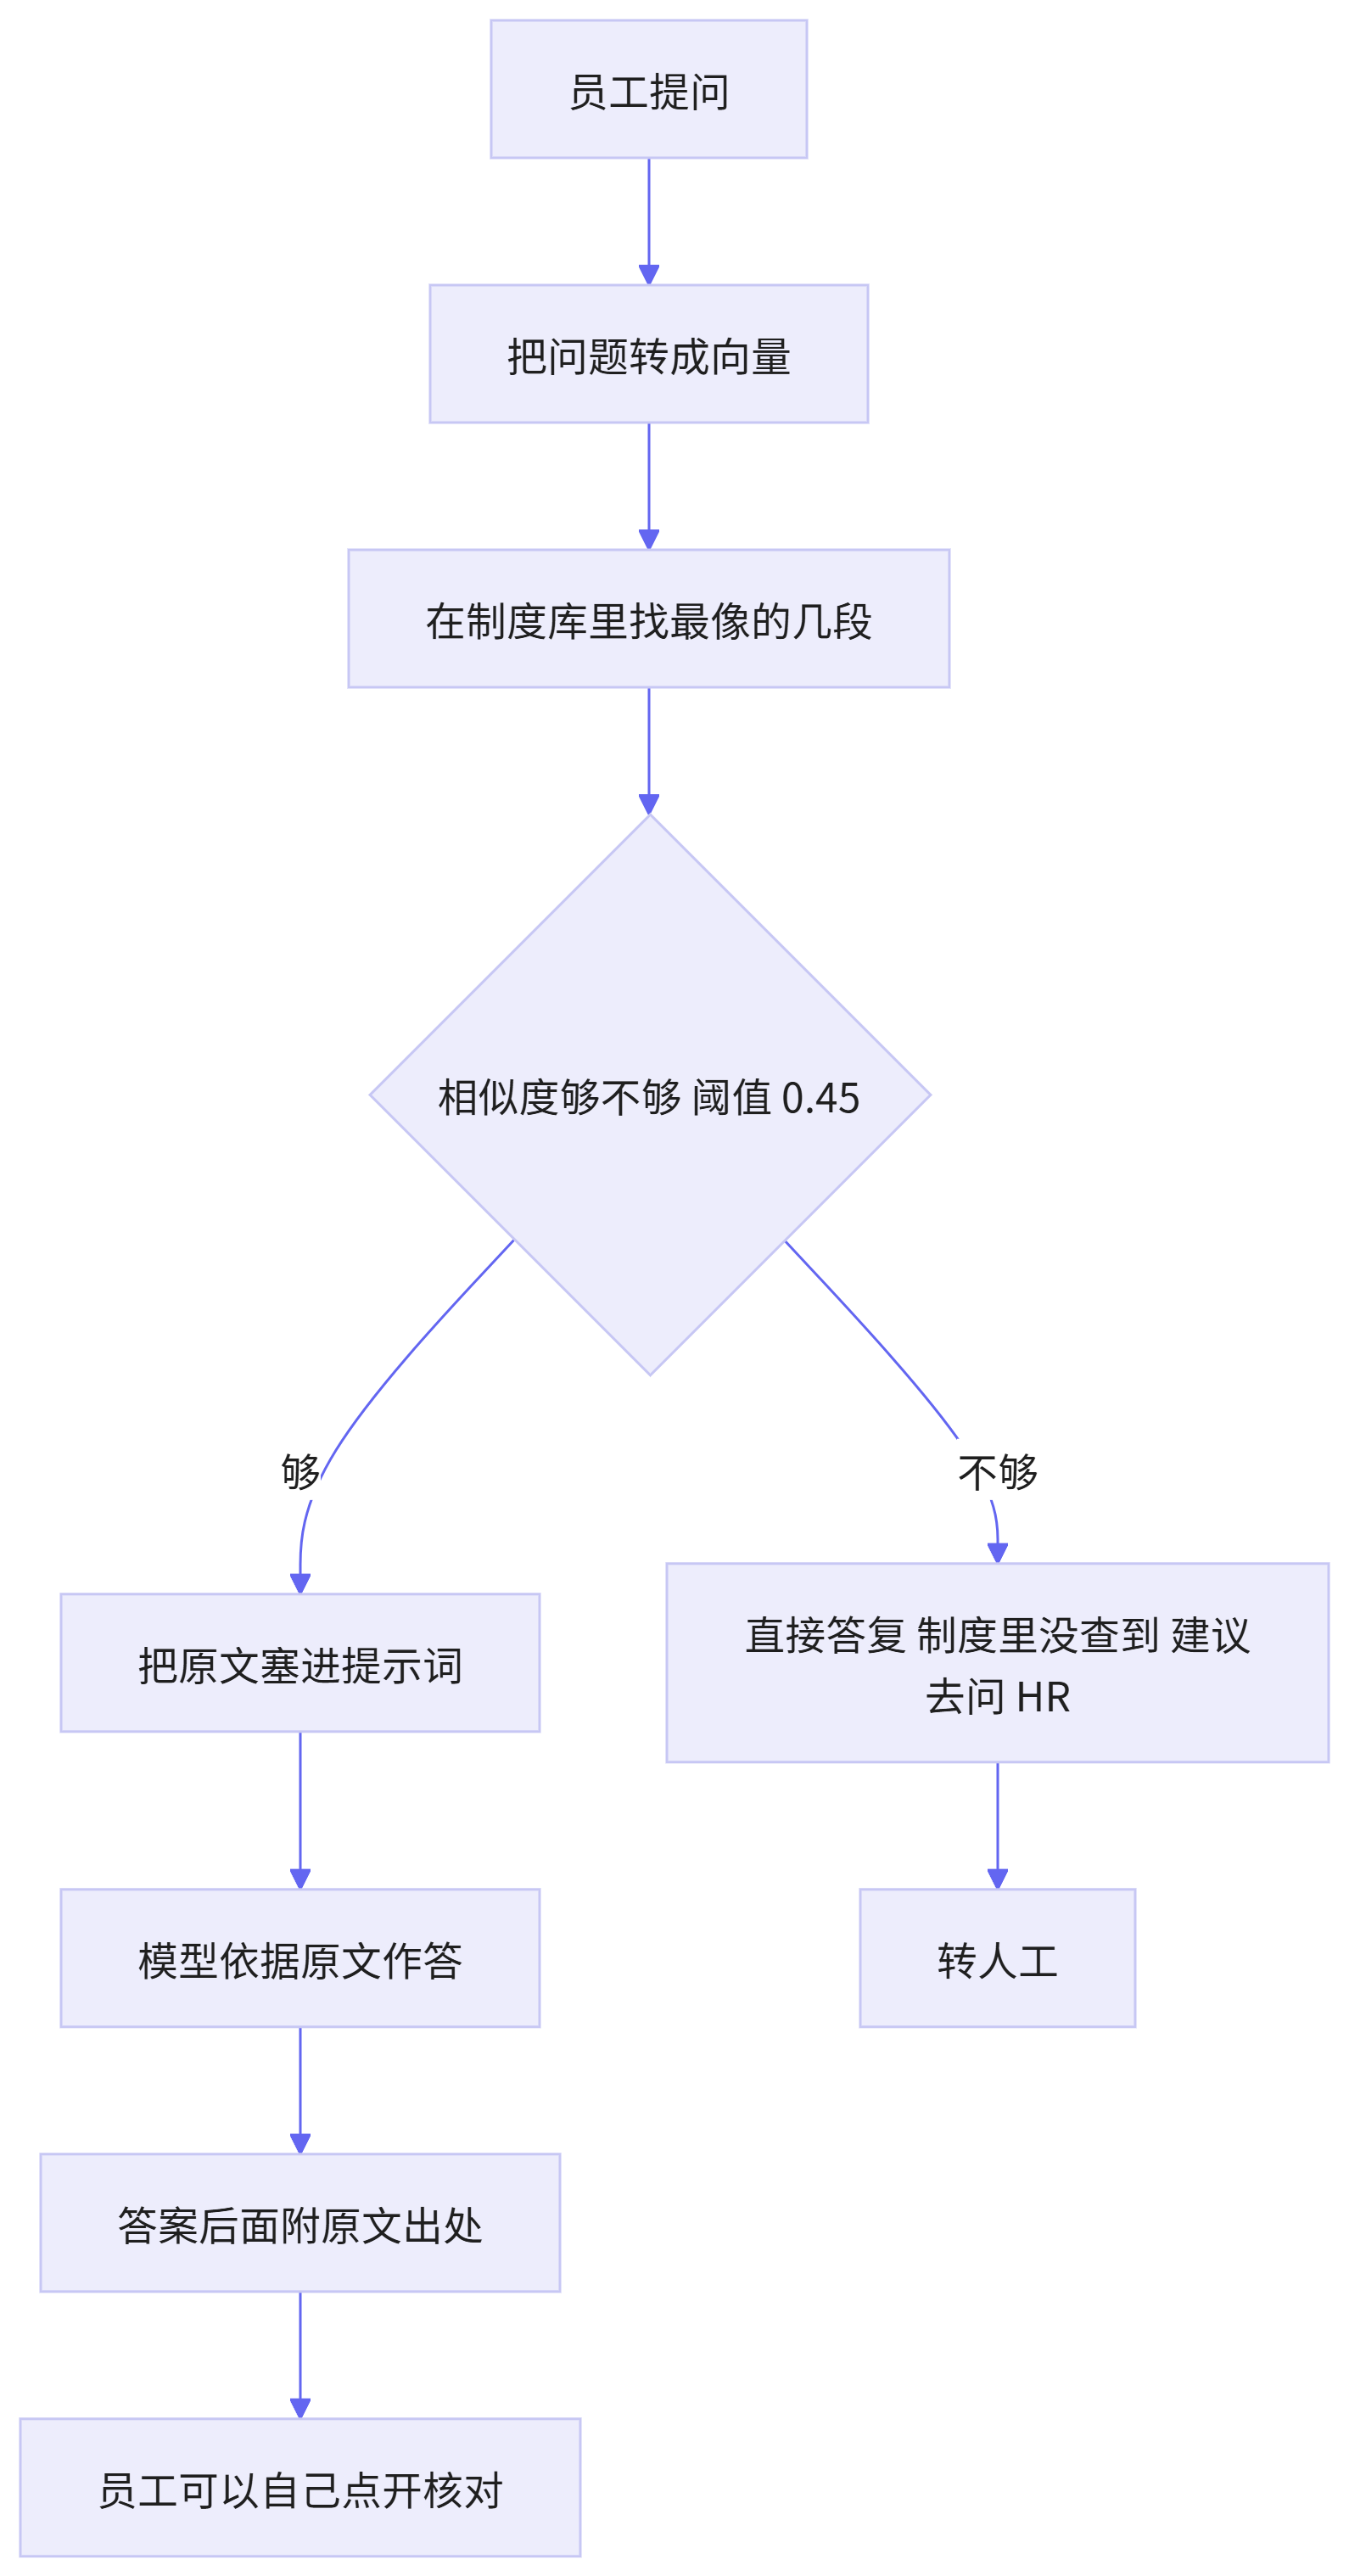
第一道闸门是相似度阈值——压根没找到相关原文,就别让它答。第二道闸门是提示词里的那句"不许自己推测",以及要求它附出处。
小周上线之后,最大的变化不是省了多少时间,而是员工开始自己核对原文了。因为答案后面挂着制度条款,大家点开看一眼就踏实了。以前她口头答复,员工还半信半疑;现在白纸黑字挂着,反而没人来追问。
这件事给我的启发是:在非技术同事面前,主动说清楚 AI 会犯什么错,比把它吹得无所不能,更容易赢得信任。你先认了它的短板,后面给的方案人家才敢用。
五、一张图:什么活该给 AI,什么活别碰
三个案例讲完,我发现它们其实能被同一张判断图框住。现在同事来问我,我基本就甩这张图给他。
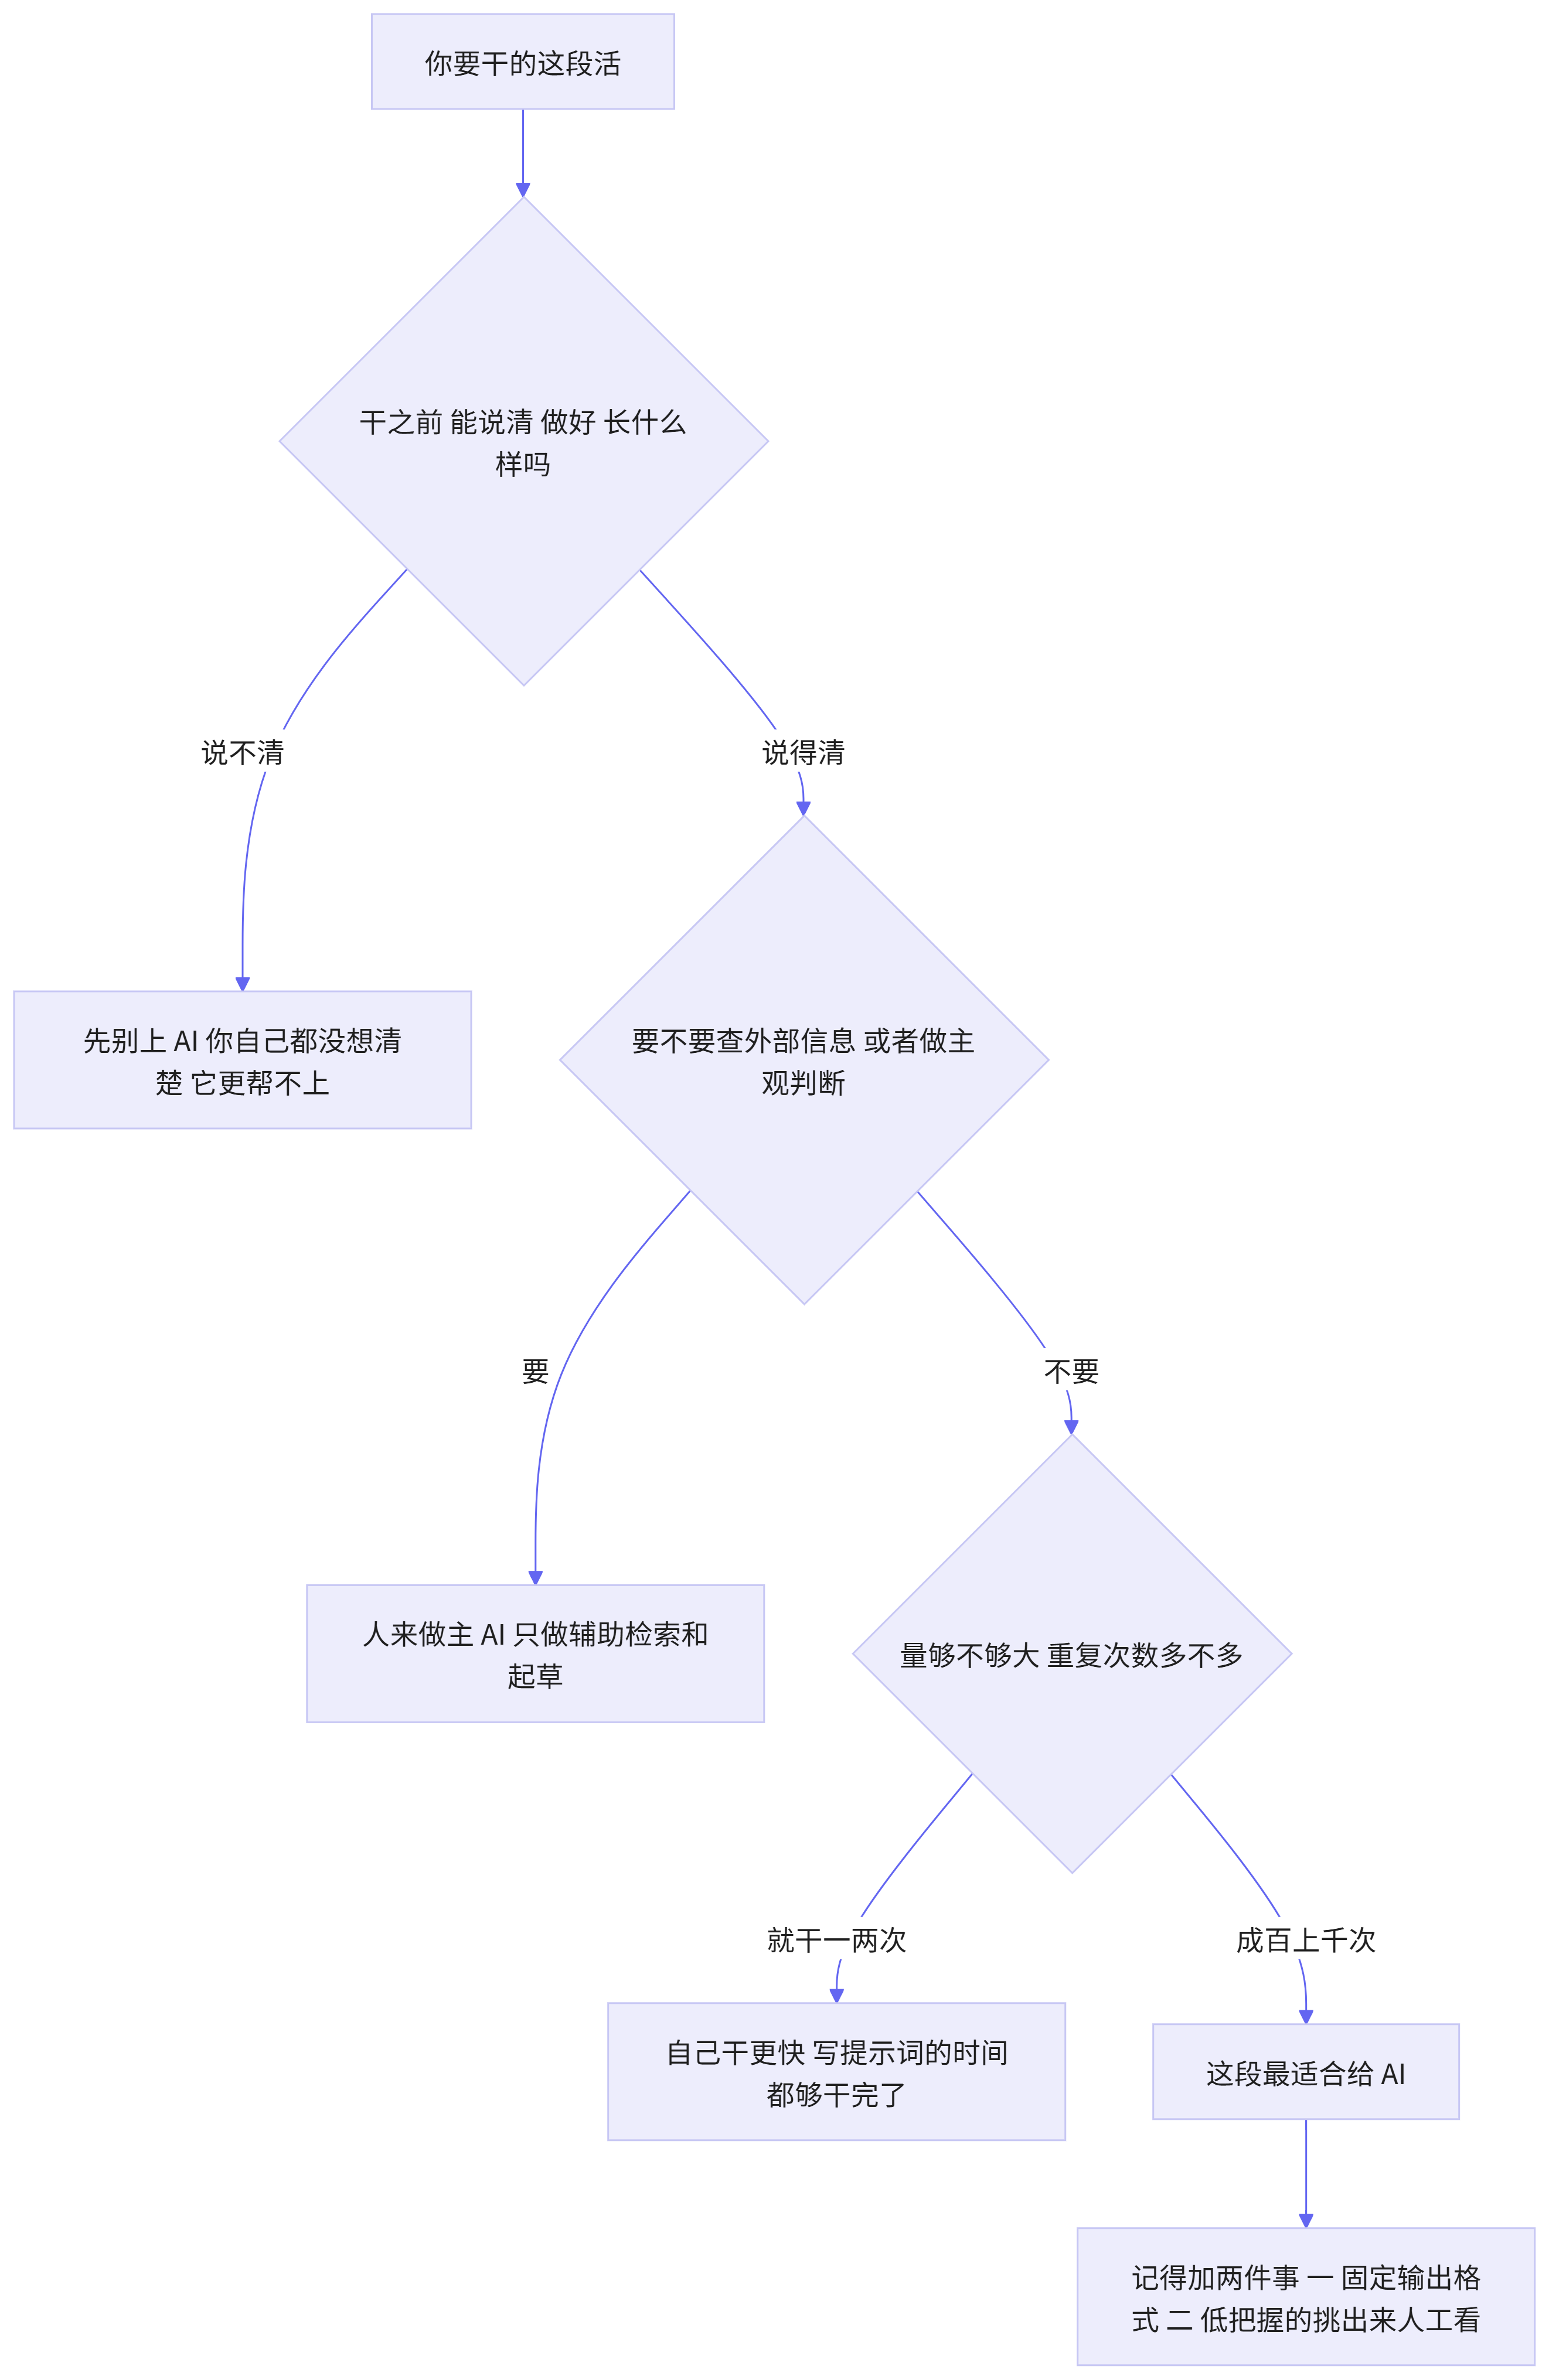
我把里面对应的三个案例标一下,你大概就明白我为什么这么切:
案例 | 说清「做好」的标准 | 要不要主观判断 | 量级 | 结论 |
|---|---|---|---|---|
差评分类 | 能,就这 7 个标签 | 基本不用 | 两千多条 | ● 全给 AI,人工抽检 |
发票提取 | 能,字段固定 | 不用 | 几百张 | ● 全给 AI,低置信度人工复核 |
制度问答 | 能,答案得有出处 | 需要,涉及责任 | 高频重复 | ▲ AI 起草 + 附原文,人做终审 |
这张表里最值得琢磨的是第三行的"需要主观判断"。凡是最后要有人签字、有人担责的活,AI 只能走到"起草"这一步,不能走到"定稿"。这条线我画得很死,因为一旦越过,出事的时候没人能兜住。
六、绕了一圈,其实就三句话
回头看这三个案例,我给非技术同事讲 AI 的方式,最后收敛成了三句话:
第一句:别从"AI 能干什么"开始讲,从"你手上哪段活最烦"开始讲。 顺序一反,对方立刻就有画面了。我后来给客服、给法务讲,开场白都变成了"你上周最不想干的是哪件事",效果比讲原理好十倍。
第二句:给模板比给自由更重要。 不给模板,模型每次给你的东西都不一样,你还得花时间收拾;给了模板,输出直接能落表、能进系统。这三个案例里,真正让结果能用的,全都是"把输出形状钉死"那一步。
第三句:先说它会错在哪,再说它有多厉害。 我现在的习惯是,每次讲完方案,一定留五分钟专门讲"这个方案会怎么翻车"。讲完之后,同事反而更愿意试——因为他们知道坑在哪,踩进去也不慌。
还有个小经验顺手提一句:第一次给同事演示的时候,别拿你准备好的完美案例。我试过,效果反而不好,因为太顺了,像演的。后来我改成现场让他随便给一条真实数据,跑出来哪怕结果一般,也当场改提示词调一版。那个"当场改、当场变好"的过程,比任何完美案例都有说服力。
我不是 AI 专家,我只是个被同事问烦了之后,被迫总结出一套讲法的普通开发。
这一年下来我最大的感受是:AI 这事儿,技术门槛其实没那么高,真正的门槛是"能不能把别人手上的活拆明白"。拆得清楚,几十行代码就能解决一个真实痛点;拆不清楚,再强的模型也接不住。
如果你也准备给身边的同事讲 AI,我建议你别急着做 PPT。先找一个人,问他一句"你上周最烦的是哪件事",然后坐他旁边,看着他那段活从头到尾做一遍。看完了,你大概就知道该怎么讲了。
你要是也在做类似的事,欢迎在评论区说说你遇到的场景。特别是那种"看起来 AI 能做、但一上手就翻车"的,我挺想收集一些,攒够了我再写一版翻车合集。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号