Jev 模型原理详解:三种原语、并行采样与校准置信度是怎么运作的
原创
Jev 模型原理详解:三种原语、并行采样与校准置信度是怎么运作的
原创
hollyx
发布于 2026-09-23 19:23:06
发布于 2026-09-23 19:23:06
过去一周我把 Jev 接进了自己的几条自动化流水线做验证,也翻完了 TypeSafe 的官方文档和几份第三方实测。相比外界"它很快、很便宜"的印象,我更想把注意力放在一个问题上:它凭什么能做到这些?这篇文章就从工程视角,把 Jev 的原理拆开来讲清楚,它为什么要放弃生成文本、三种原语到底怎么用、并行采样和自回归的区别在哪、校准置信度为什么才是关键,以及 RLCD 这套训练方法想优化的到底是什么。文中数据均来自官方公开信息与我参考的第三方测试,Jev 仍处早期访问阶段,规格可能调整。
一、先想清楚:为什么要放弃"生成文本"
在讲机制之前,得先理解 Jev 想解决的错配。
大语言模型的产物是"给人读的文本"。可当我需要它做一个判断、并且这个判断要被下游代码消费时,麻烦就来了。我的常规写法是:把状态丢给模型,让它输出一段 JSON,然后解析、校验、再进入业务分支。这条链路里有三个我反复踩过的坑:模型偶尔在 JSON 后面多写一句解释导致解析失败;字段值跳出我给定的枚举范围;或者干脆拒绝回答。本质上,我是在把一个"擅长生成文本的系统"硬掰成"输出结构化判断的系统",再把结果解析回代码能依赖的形式。
Jev 的设计思路是把中间那步直接删掉。我给它两块东西:一份 state(要判断的状态,可以是字符串、对象或数组)和一组 questions(针对状态提出的类型化问题);它返回的是结构化数值和概率分布,我的代码直接读字段、按值分支,不需要生成文本,也不需要解析。官方对它的一句话定义是"非结构化状态进,类型化概率决策出"。想通这一层,后面所有机制都是为这个目标服务的。
二、三种原语:我实际在用的 Choice、Score、Noul
Jev 目前只提供三种问题类型,官方称之为 primitives(原语)。我在项目里几乎每天都在用,把它们的实际手感记录下来:
原语 | 回答什么 | 返回内容 | 我的典型用法 |
|---|---|---|---|
Choice | 从若干选项里选一个 | 选项、各选项概率、置信度 | 意图路由:这条请求交给哪个处理器 |
Score | 在一个尺度上打分 | 分值、概率分布、置信度 | 风险/情绪分级 |
Noul | 一条陈述是否成立 | 0 到 1 的概率 | 是否命中某条规则、是否紧急 |
真正让我觉得顺手的一点是:三种问题可以在一次请求里混着问,它们各自独立地评估同一份 state,而且加问题几乎不增加响应时间。我做过一个客服工单的例子:同一条消息,一次调用里同时问"交给哪个团队(Choice)""客户有多激动(Score)""是否紧急(Noul)",三个答案一起回来。
这里有一条我踩过坑才真正记住的设计纪律:每个问题都必须是原子的、单一维度的判断。像"分析这件事并给出最佳方案"这种问题它答不好,因为那需要慢思考。正确做法是把它拆成若干个"一个有经验的人一秒就能拍板"的小问题,再在我自己的代码里把答案组合起来。还有一个容易被忽略的细节:候选项是我这边给的,不是模型临时造的,模型只在我划定的边界里判断"选哪个","能不能执行"始终握在我自己的代码手里。
三、并行采样:它快的根本原因不是"模型小"
很多人第一反应是"它快大概是因为模型小",但我认为更本质的原因在采样方式。
传统大模型是自回归的:逐个 Token 串行生成,每个字都依赖前一个字,所以一段 JSON 要一个一个"蹦"出来,再交给我解析。Jev 不是这样,它把所有要回答的判断在一次前向计算中并行产生。下面这张图是我理解这件事时画的对照:
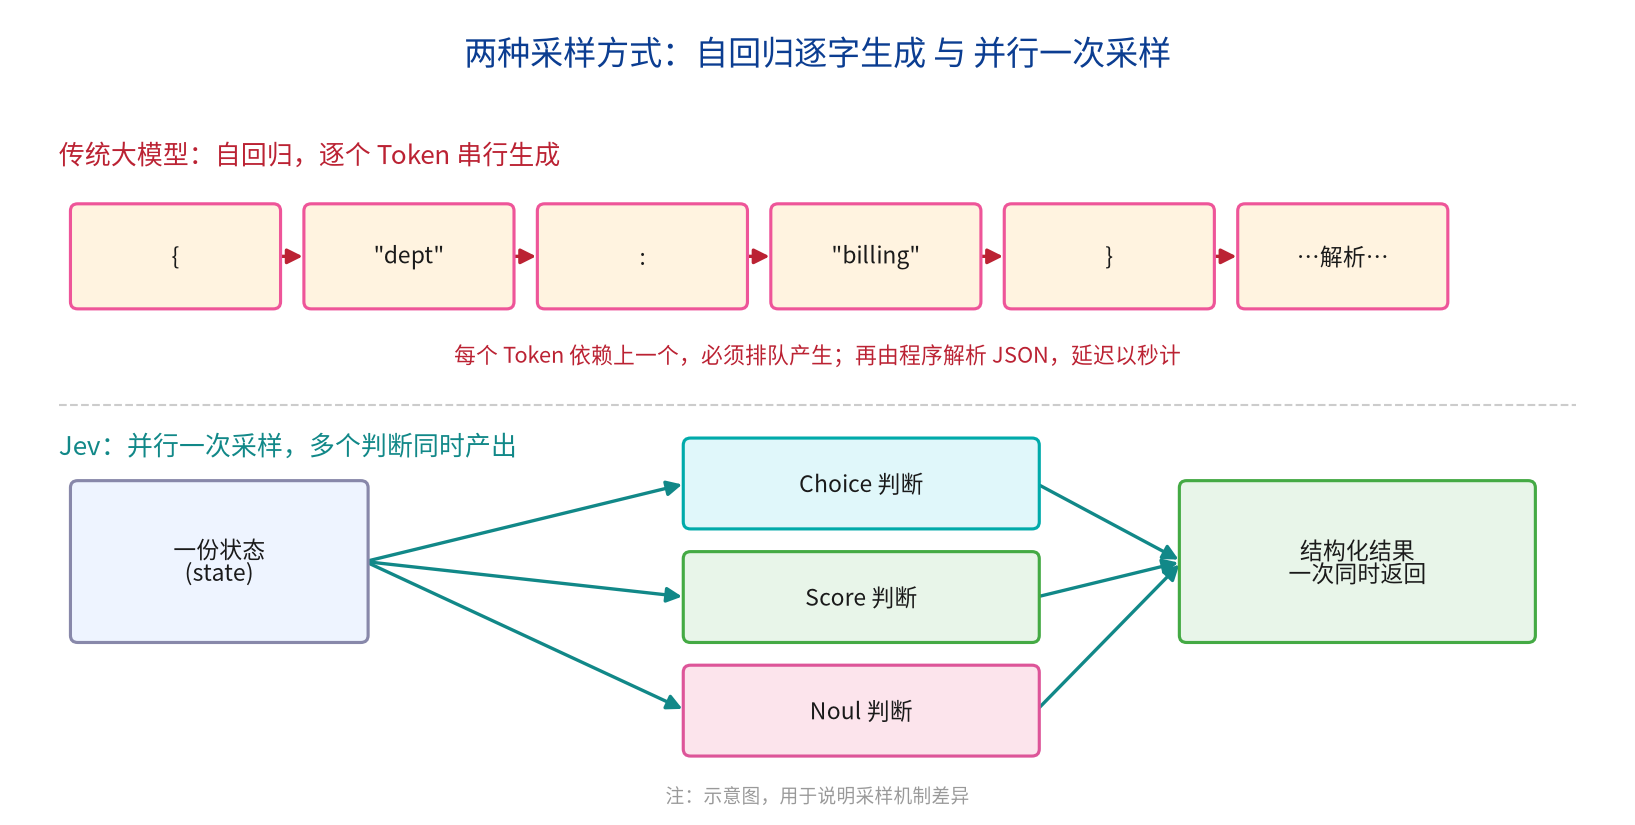
两种采样方式:自回归逐字生成与并行一次采样
这解释了两个我实测中观察到的现象:一是延迟稳定落在毫秒级(官方口径 70~500 毫秒),而不是像大模型那样随输出长度线性增长;二是我在一次调用里多加几个问题,响应时间几乎没变,因为它们是并行评估的,而不是排队生成的。对我做高频判断的场景来说,这个特性比单纯的"便宜"更有价值。
四、类型安全:"不会幻觉"到底指什么
Jev 被反复提到的一个卖点是"不会幻觉",但我必须把它说准确,否则很容易误导。
它的准确含义是类型层面的保证:输出被约束在我提供的 schema 里。如果一个 Choice 问题只给了 billing、technical、sales 三个选项,它不可能返回第四个标签,也不可能产生类型错误。官方把这个性质描述为"在类型上不可证伪"。
但这和"永远正确"是两回事。Jev 完全可能选错,也可能给错误答案分配高概率。它保证的只是"不跑到剧本外"。我认为这恰恰是自动化真正需要的性质:在一条有延迟约束、埋了好几层依赖的链路里,一个"越界的答案"比"一个偶尔选错但格式永远合法的答案"危险得多。把这一点想清楚,才不会对它抱有错误期待。
五、校准置信度:我认为这才是原理里最关键的一环
如果只让我留下 Jev 的一个特性,我会选"校准过的置信度",而不是速度。
让大模型判断一件事,它很容易回我一句"我有 95% 的把握"。问题是,这个 95% 只是它生成出来的文本,并不意味着它长期真有约 95% 的正确率。Jev 的每个 Choice 和 Score 答案都带一个 0 到 1 的 confidence,来自概率分布的形状;官方的主张是"置信度越高,正确率越高"。我参考的第三方实测也印证了这个方向:落在 0.9~1.0 区间的判断,参考标签几乎都为"是";落在 0.0~0.1 的,几乎都为"否"。
这件事对我写自动化的意义在于:控制流不该只有"是/否"两态。有了可信的置信度,我可以把它直接写进程序分支:
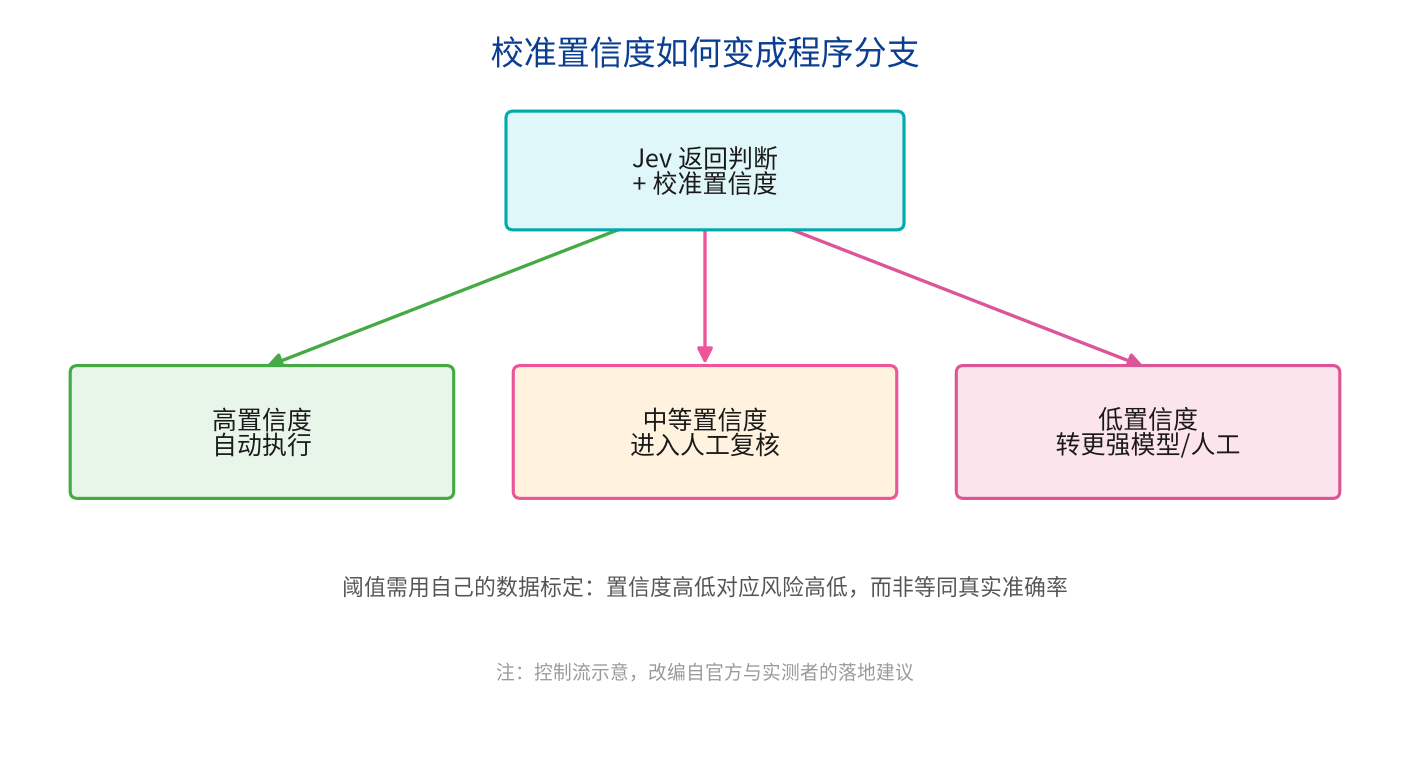
校准置信度如何变成程序分支
高置信度自动执行、中等置信度进人工复核、低置信度转交更强模型或人,置信度本身成了分支条件。但我要补一句实践中的教训:阈值必须用我自己的数据去标定。我在项目里把 0.9 设为自动采纳门槛,同时非常清楚"0.9 是我人为设的线,绝不代表模型有九成真实准确率"。置信度反映的是相对高低与风险分层,不是可以直接当作准确率的数字。
六、RLCD:它训练时到底在优化什么
最后一块拼图是训练方法。Jev 不是用 RLHF 训出来的,而是用 TypeSafe 自研的 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。
两者的优化目标不一样。RLHF 优化的是"人类更偏好哪个回答",这很适合把话说得漂亮、让人读着舒服;而 RLCD 的目标是"带诚实概率的答案",不仅要选对,还要让模型知道自己有多确定,并把这份确定性如实反映到概率上。这正好呼应了前面那两点:类型安全的输出加上校准的概率,才凑成一个"软件可以直接依赖"的判断接口。
需要说明的是,RLCD 的奖励函数、网络结构、参数量这些细节官方并未公开,我也无法验证。所以我对它的判断只停留在可观测的行为层面:输出稳定落在 schema 内、概率校准方向正确、延迟稳定在毫秒级,这些是我能实测到的,至于底层实现,保持一个诚实的"未知"更稳妥。
七、把原理串起来看
把上面几块拼到一起,Jev 的逻辑其实相当自洽:它放弃生成文本,是为了消除"生成再解析"的错配;它用并行采样,是为了把延迟压到毫秒级;它把输出约束在类型里,是为了让答案永远不越界;它用 RLCD 训练出校准的置信度,是为了让我的代码能按"有多确定"来分支。这四件事不是各自独立的卖点,而是围绕同一个目标,做一个给软件用、而不是给人读的决策接口。
理解了原理,也就理解了它的边界:凡是需要生成、需要算数、需要多因素慢推理的任务,都不该交给它。把逻辑留在代码里,只把那个"一秒能拍板"的窄判断交给 Jev,这是我一周实践下来最想强调的一句话。它究竟会不会成为一种通用范式,还要更多时间和独立验证来回答,但"决策"与"生成"应该分开来做这条思路,已经足够清晰。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号