研报入库更聪明:Jev 把段落按主题自动归类进知识库
原创
研报入库更聪明:Jev 把段落按主题自动归类进知识库
原创
hollyx
发布于 2026-09-23 21:47:29
发布于 2026-09-23 21:47:29
量化研究员要用研报,前提是研报得先被结构化地整理进知识库。过去研报切片靠人工或大模型逐段归类,批量一多就慢又贵。这一周我把这道主题分类换成 Jev,入库效率和检索质量一起上来了。这篇讲清楚这个场景应用前后的差别:归类怎么做、批量成本降了多少、检索怎么更高效。文中对比为基于实测口径的方案性测算,非某机构真实数据,Jev 仍处早期访问阶段。
一、原来的做法:逐段人工或大模型归类
应用前,研报文本切片后,靠人工或大模型逐段判断它属于哪类主题,营收预测、行业观点、风险提示、估值分析,再归档入库。
问题是研报量大、切片多,逐段用大模型归类成本高、批量处理慢,人工归类又费人力。归类质量参差,知识库结构化程度不够,研究员后续检索就不精准。
二、改造后的做法:Jev 按主题打标签入库
应用后,我把主题分类交给 Jev。
研报切片进 Jev,用 Choice 归类到营收预测、行业观点、风险提示、估值分析等主题,自动打上标签后存入知识库。毫秒级、成本极低,批量研报也能快速消化。
下面这张图是应用前后的对照:
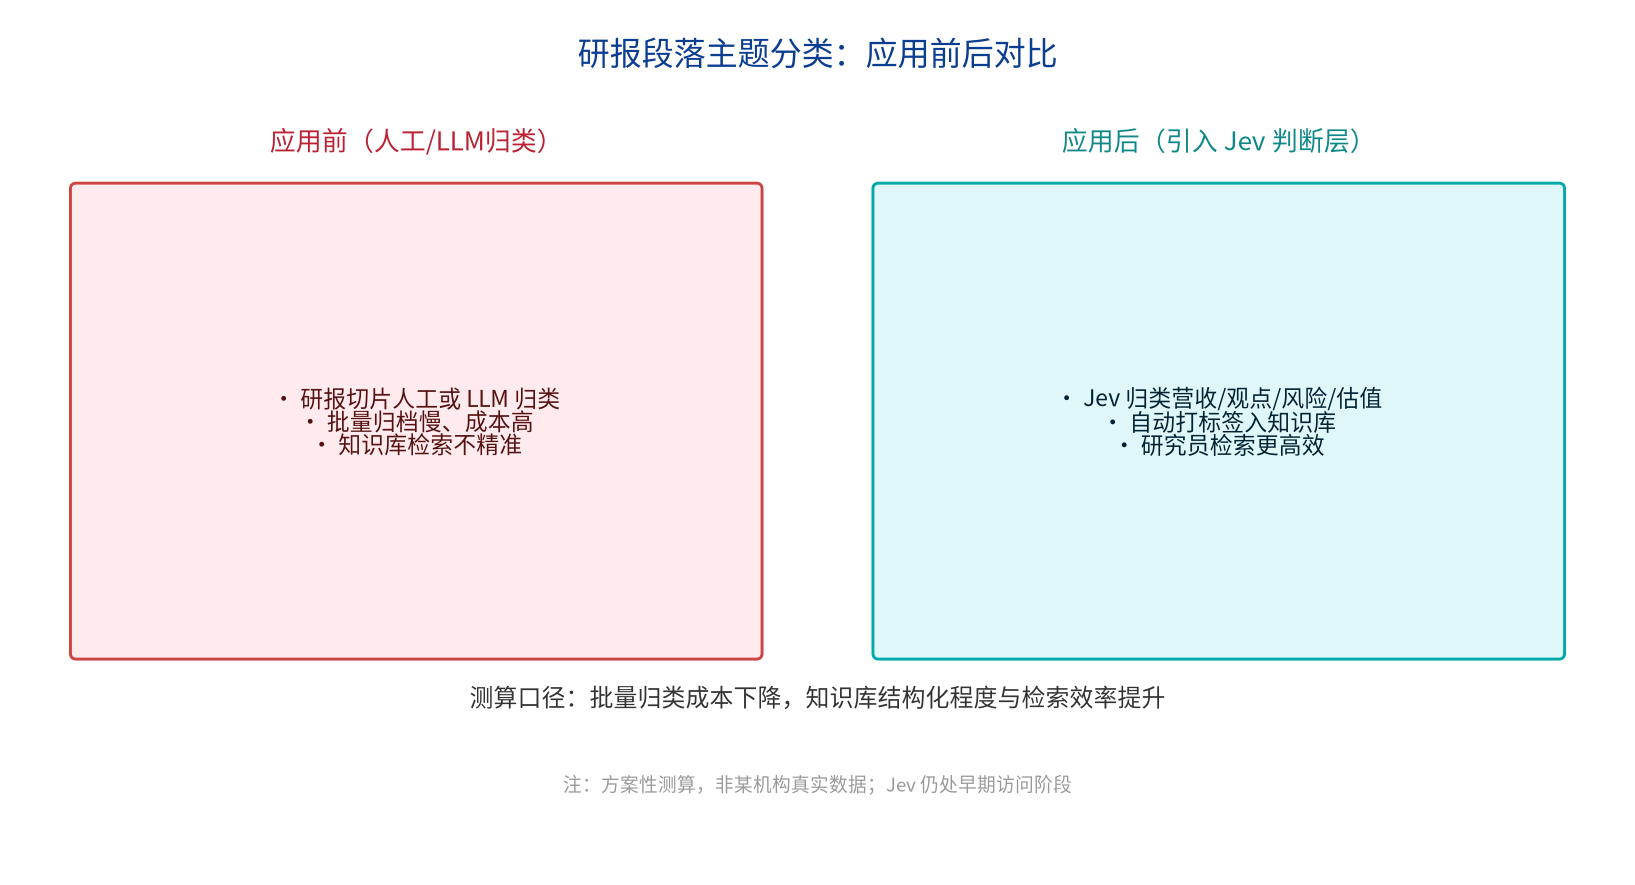
研报段落主题分类:应用前后对比
三、价值对比:批量成本与检索效率
收益体现在两处。
成本上,批量主题归类从人工或大模型换成 Jev,单位成本大幅下降,研报入库不再是瓶颈。
检索上,段落被准确打上主题标签后,知识库的结构化程度提升,研究员按主题检索时命中更准、效率更高。
四、这套方案的边界
Jev 在这里做的是"主题归类"这个判断,不做研报解读或投资建议。归类标签体系需要研究团队预先定义清楚,标签之间界限越明确,归类越稳。它也可能把跨主题的段落归错类,重要研报的关键段落建议人工抽检。收益为方案性测算,真实归类准确率要以自己的研报和标签体系为准。
五、最终效益
这套改造的效益是"用低成本的主题归类,让研报知识库更好用"。批量归类成本随迁移到 Jev 而下降,知识库结构化程度和检索效率提升,研究员能更快找到需要的内容。把"这段研报讲的是哪类主题"的归类交给 Jev、把"这些信息意味着什么"的分析留给研究员,研报入库既高效又利于后续检索。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号