一个周末上线企业知识库问答:Dify 开源平台实战与踩坑全记录
原创
一个周末上线企业知识库问答:Dify 开源平台实战与踩坑全记录
原创
大盘鸡拌面
发布于 2026-09-23 23:24:05
发布于 2026-09-23 23:24:05
先说个扎心的事实:很多团队的大模型应用死在了"胶水代码"上。模型是好的、RAG 思路是对的,但前端对接、后端编排、知识库管理、日志追踪……这些活儿堆起来,一个需求两周起步。后来我们把这套东西搬到了 Dify 上,同样的功能,两天搞定。这篇就聊聊我们用 Dify 落地的完整过程,包括那些官方文档不会告诉你的坑。
一、Dify 是个啥?为什么值得看
一句话概括:Dify 是一个开源的 LLM 应用开发平台,把 Prompt 编排、RAG 知识库、Agent 工具调用、应用发布这些"脏活累活"全部可视化 + 平台化了。
你以前自己搭一个知识库问答,要写的东西大概是这样一条链路:文档解析 → 分块 → Embedding → 向量库 → 检索 → 拼 Prompt → 调模型 → 后处理 → API 封装 → 前端。每一个环节都是代码,每一个环节都可能出 Bug。
Dify 把这条链路变成了"画布上拖节点":
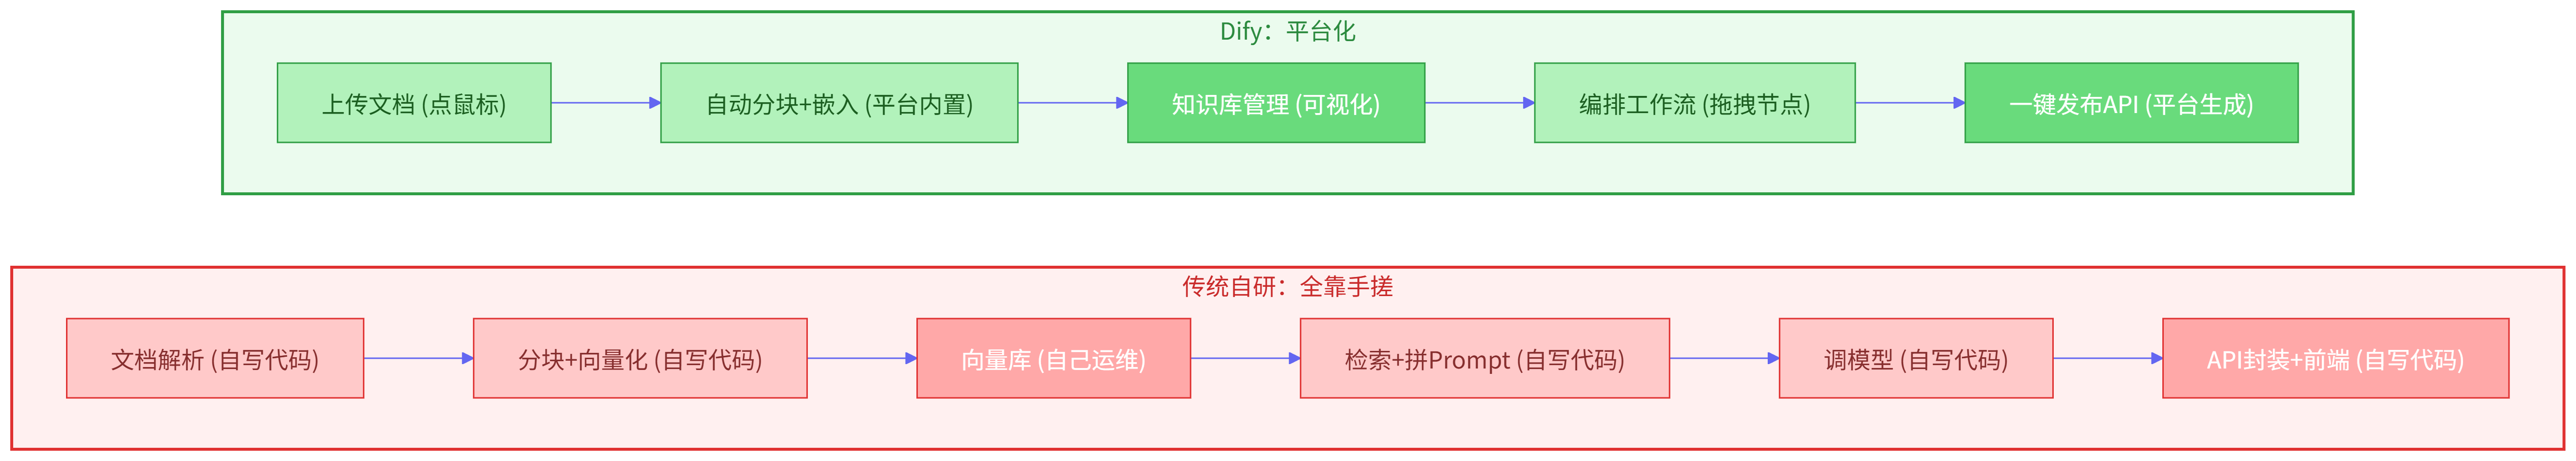
而且它是开源的(基于 Apache 2.0 改的附加条款,商用注意看一眼 LICENSE),可以私有化部署,模型随便接——OpenAI、通义、DeepSeek、本地 vLLM 起的服务都行。对企业来说,"数据不出内网 + 模型可替换"这两点就足够有吸引力了。
二、部署:十分钟起一套,但有几个隐藏选项
部署本身很简单,docker-compose 一把梭:
# docker-compose.yaml(精简版,完整版去官方仓库拿)
services:
  api:
    image: langgenius/dify-api:0.15.3
    restart: always
    environment:
      # 模型供应商的密钥在界面里配,这里配的是基础组件
      - DB_PASSWORD=difyai123456
      - REDIS_PASSWORD=difyai123456
      # 向量库可以选:weaviate(默认) / qdrant / milvus
      - VECTOR_STORE=qdrant
      # 文件存储:本地 or S3
      - STORAGE_TYPE=opendal
      - OPENDAL_SCHEME=fs
      - OPENDAL_FS_ROOT=/storage
    depends_on:
      - db
      - redis
      - qdrant

  worker:
    image: langgenius/dify-api:0.15.3
    restart: always
    # 异步任务都在 worker 里跑:文档嵌入、批量导入
    # 知识库大了之后,worker 数量要加
    deploy:
      replicas: 2

  web:
    image: langgenius/dify-web:0.15.3
    restart: always
    ports:
      - "80:3000"

  qdrant:
    image: langgenius/qdrant:v1.7.3
    restart: always
    volumes:
      - ./volumes/qdrant:/qdrant/storage
起来之后访问 80 端口,注册管理员账号,去"设置 → 模型供应商"里配模型。我们接的是内网 vLLM 起的 Qwen2.5-14B(OpenAI-API-compatible 方式),配上一个 bge-large-zh-v1.5 做 Embedding。
第一个坑就在 Embedding 模型上:知识库建好之后再换 Embedding 模型,所有文档要重新嵌入,几万页文档重嵌一遍要几个小时。所以动手建知识库之前,先把 Embedding 模型定死。如果后面要换,正确姿势是新建一个知识库用新模型重新嵌入,验证效果后再切流量,而不是直接在老库上换。
三、实战:搭一个"HR 制度问答 + IT 自助"双能力机器人
光讲概念没意思,上完整案例。需求是这样的:公司员工经常问"年假怎么算""试用期多久""VPN 连不上怎么办"这类问题,HR 和 IT 同事每天被重复问题轰炸。目标:做一个问答机器人,制度问题查 HR 知识库,技术问题查 IT 知识库,都答不了就创建工单转人工。
整体编排
在 Dify 里我们用的是 Chatflow(对话型工作流),画布长这样:
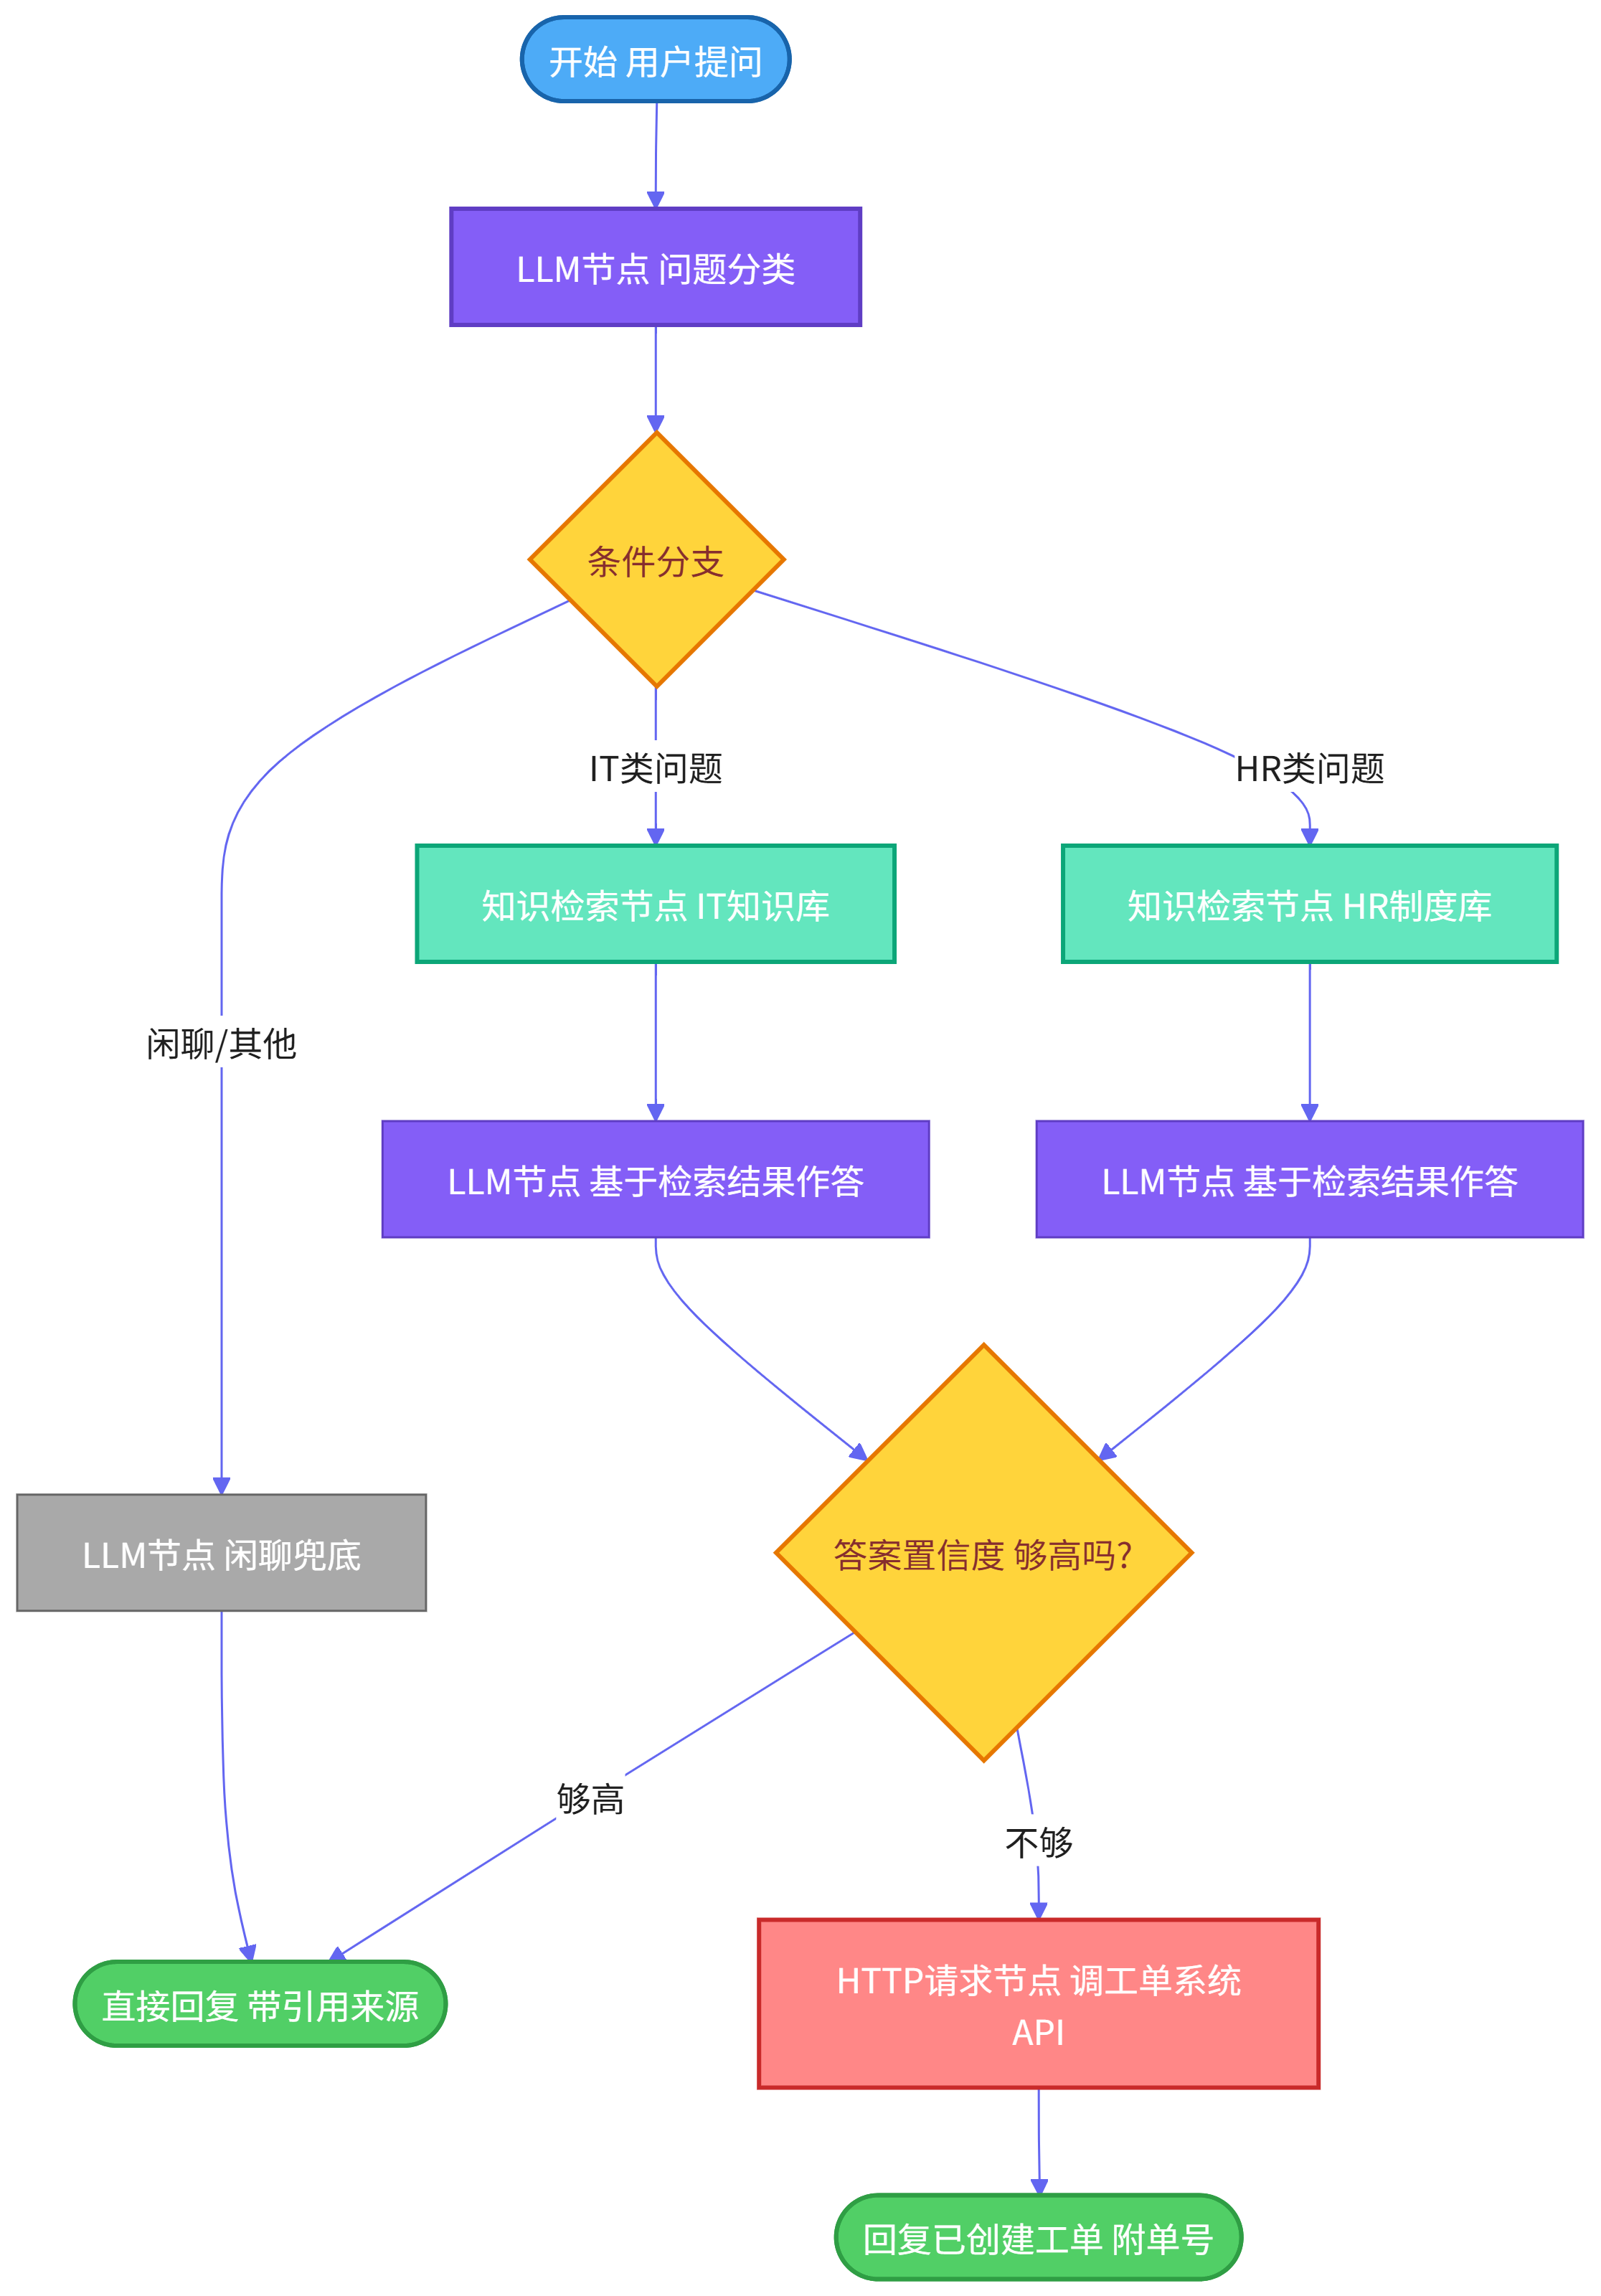
注意几个设计点:
- 先分类再检索,而不是把 HR 和 IT 知识库混在一起检索。混着检索的话,"年假"和"休假日系统报错"这种问题容易互相干扰召回质量。
- 检索之后还有一道置信度检查,答不了就老实转工单。宁可说"我不确定,帮你转人工",也别一本正经地编个假制度出来——员工照着假制度去请假,那乐子就大了。
- 引用来源必开,回答里带上"出自《考勤管理制度》第 3.2 节",可信度蹭蹭往上涨,也方便 HR 发现答错时快速定位。
工作流 DSL:Dify 的应用是可以"代码化"的
Dify 有个特别实用的功能:整个应用可以导出成 DSL(YAML 格式),这意味着应用的配置可以进 Git、可以 Code Review、可以在不同环境之间同步。这对工程团队太重要了——以前 Prompt 改了没人知道,现在每次改动都有 diff 记录。
导出来的 DSL 长这样(节选核心部分):
# HR-IT助手.yml(Dify DSL,有删减)
app:
  name: HR-IT智能助手
  mode: advanced-chat   # chatflow 类型
  version: 0.1.5

model:
  provider: openai_api_compatible
  model: qwen2.5-14b-instruct
  parameters:
    temperature: 0.2     # 制度问答要稳定,温度调低

workflow:
  graph:
    nodes:
      - id: classify
        type: llm
        data:
          prompt_template:
            - role: system
              content: |
                你是企业内部问题分类器。判断用户问题属于哪一类:
                - hr:考勤、请假、薪酬、福利、入职离职等制度问题
                - it:电脑、网络、账号、软件等技术人员问题
                - other:闲聊或无法判断
                只输出一个词:hr / it / other,不要解释。

      - id: if-branch
        type: if-else
        data:
          conditions:
            - variable_selector: [classify, text]
              comparison_operator: contains
              value: hr

      - id: hr-retrieval
        type: knowledge-retrieval
        data:
          dataset_ids:
            - hr-policy-dataset-id
          retrieval_mode: multiple      # 多路召回
          multiple_retrieval_config:
            top_k: 4
            score_threshold: 0.5        # 相似度阈值,低于0.5的不要
            reranking_enable: true      # 开启重排
            reranking_model:
              model: bge-reranker-large

      - id: hr-answer
        type: llm
        data:
          prompt_template:
            - role: system
              content: |
                你是企业HR制度问答助手。严格依据下方检索到的制度内容回答,
                并在回答末尾注明来源文档和章节。
                如果检索内容无法回答问题,只输出:【NOT_CONFIDENT】
                不要编造制度内容。

                检索到的制度内容:
                {{#hr-retrieval.result#}}

      - id: confidence-check
        type: if-else
        data:
          conditions:
            - variable_selector: [hr-answer, text]
              comparison_operator: not contains
              value: NOT_CONFIDENT

      - id: create-ticket
        type: http-request
        data:
          method: post
          url: https://itsm.internal.example.com/api/v1/tickets
          headers:
            Authorization: Bearer {{#env.ITS_TOKEN#}}
          body:
            type: json
            data: |
              {
                "title": "{{#sys.query#}}",
                "source": "ai_assistant",
                "category": "auto",
                "description": "AI助手无法回答,用户原问题:{{#sys.query#}}"
              }
看到 【NOT_CONFIDENT】 这个标记了吗?这是个很好用的小技巧:让模型在没把握的时候输出一个约定的标记,然后用条件分支检查这个标记,比让模型直接输出置信度数字靠谱多了——模型自己打的分经常虚高,但"答不出来就输出特定标记"这个行为微调过 Prompt 之后很稳定。
代码节点:处理 Dify 原生能力覆盖不了的业务逻辑
Dify 内置了一个 Code 节点,可以直接跑 Python/JavaScript,用来做格式转换、数据加工这类活。比如我们的场景里要把工单系统返回的 JSON 加工成用户友好的回复:
# Dify Code 节点:加工工单创建结果
# 输入变量:ticket_response (object) - HTTP节点返回的工单系统响应
# 输出变量:reply (string), ticket_id (string)

import json

def main(ticket_response: dict) -> dict:
    """
    把工单系统的原始响应加工成用户能看懂的话
    业务规则:
    1. 创建成功 → 告知单号和预计响应时间
    2. 创建失败 → 降级提示,给出人工渠道
    """
    try:
        code = ticket_response.get("code", -1)
        data = ticket_response.get("data", {})

        if code == 0 and data.get("ticket_id"):
            ticket_id = data["ticket_id"]
            # 工单系统返回的 SLA:P4问题 8 小时内响应
            sla_hours = data.get("sla_hours", 8)

            reply = (
                f"这个问题我暂时没有把握,已经帮你转给专业同事了。\n\n"
                f"📋 工单号:{ticket_id}\n"
                f"⏱️ 预计 {sla_hours} 小时内会有同事联系你。\n"
                f"着急的话也可以直接打 IT 服务台:内线 8888。"
            )
            return {"reply": reply, "ticket_id": ticket_id}
        else:
            # 工单系统异常,降级到人工渠道
            reply = (
                "不好意思,工单系统好像开小差了,没能自动帮你建单。\n"
                "你可以直接打内线 8888 找 IT 服务台,或者发邮件到 "
                "it-help@example.com,说明下问题就行。"
            )
            return {"reply": reply, "ticket_id": ""}

    except Exception as e:
        return {
            "reply": "系统出了点小状况,请联系 IT 服务台(内线 8888)。",
            "ticket_id": ""
        }
业务系统怎么调 Dify 的 API
编排完之后,Dify 会自动生成 API。企业微信机器人、Web 页面、飞书应用,谁想接就直接调:
import requests
import json

class DifyChatClient:
    """业务系统对接 Dify 应用的客户端"""

    def __init__(self, base_url, api_key):
        # api_key 在 Dify 应用的"访问 API"页面生成
        # 注意:每个应用一个 key,别搞混
        self.url = f"{base_url}/v1/chat-messages"
        self.headers = {
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json"
        }
        # 会话管理:同一个用户的连续对话要用同一个 conversation_id
        self._user_conversations = {}

    def chat(self, user_id: str, message: str, stream: bool = False):
        """
        发送用户消息
        - user_id: 你业务系统里的用户标识,Dify 用它做限流和日志归组
        - message: 用户输入
        """
        payload = {
            "inputs": {},           # 如果工作流定义了开始变量,在这里传
            "query": message,
            "response_mode": "streaming" if stream else "blocking",
            "user": user_id,
        }

        # 关键:带上 conversation_id 才能延续多轮对话
        conv_id = self._user_conversations.get(user_id)
        if conv_id:
            payload["conversation_id"] = conv_id

        if not stream:
            resp = requests.post(self.url, headers=self.headers,
                                 json=payload, timeout=60)
            resp.raise_for_status()
            data = resp.json()

            # 记下 conversation_id,下次带上
            self._user_conversations[user_id] = data["conversation_id"]

            return {
                "answer": data["answer"],
                "conversation_id": data["conversation_id"],
                # 元数据里有引用的知识库片段,前端可以展示"来源"
                "metadata": data.get("metadata", {}),
            }
        else:
            return self._stream_chat(payload)

    def _stream_chat(self, payload):
        """流式响应:打字机效果必备"""
        resp = requests.post(self.url, headers=self.headers,
                             json=payload, stream=True, timeout=120)
        for line in resp.iter_lines():
            if not line:
                continue
            line = line.decode("utf-8")
            if line.startswith("data: "):
                chunk = json.loads(line[6:])
                event = chunk.get("event")

                if event == "message":
                    yield {"type": "text", "content": chunk["answer"]}

                elif event == "message_end":
                    # 对话结束时拿到 conversation_id 和引用
                    yield {
                        "type": "end",
                        "conversation_id": chunk.get("conversation_id"),
                        "metadata": chunk.get("metadata", {}),
                    }

                elif event == "error":
                    yield {"type": "error", "content": chunk.get("message")}


# ===== 企业微信回调里的用法示例 =====
def on_wecom_message(msg):
    client = DifyChatClient(
        base_url="http://dify.internal.example.com",
        api_key="app-xxxxxxxx"   # 应用级 API Key
    )

    result = client.chat(
        user_id=msg["from_user"],   # 用企微 userid 做标识
        message=msg["content"]
    )
return result["answer"]这里的第二个坑:user 字段别乱传。Dify 的会话隔离、日志检索、按用户限流全靠这个字段。我们一开始图省事统一传了 "test",结果日志里所有人的对话搅在一起,排查问题的时候根本分不清谁是谁,而且有个用户连续触发限流,把所有人的请求都带崩了。
四、数据流:一次问答在 Dify 里发生了什么
这个"每个节点留痕"的特性,是我们排查问题时的救命稻草。有一次业务方反馈"机器人说年假是 5 天,但新制度明明改成了 10 天",打开 Dify 的日志一看:检索出来的片段还是老文档——是 HR 同事更新了文档但没在 Dify 里重新同步。知识库文档更新后必须重新"嵌入",Dify 不会自动感知外部文件变化,这算是第三个坑。
五、踩坑清单:官方文档不会写但这些事你必须知道
坑 1:分块策略别用默认的。 默认 500 token 一块,对制度类文档效果一般——一条"年假规定"经常被拦腰切断。我们的做法:按 Markdown 标题分块(Dify 支持父级分块 Parent-child chunking),保证一个完整条款在一个块里。就这一改动,回答准确率从 71% 提到 89%。
坑 2:Rerank 必开。 向量检索的 top-k 召回噪声不小,加一个 bge-reranker 做精排,检索质量立竿见影。显存够的话强烈建议把 Rerank 模型也部署在本地。
坑 3:别在 Chatflow 里塞太多分支。 我们第一版野心很大,塞了 HR、IT、行政、财务四个方向十几个节点,结果画布乱成一锅粥,改一处牵全身。后来拆成了四个独立应用,前面加一层轻量路由。每个应用职责单一,DSL 才好维护。
坑 4:worker 资源要给够。 知识库批量导入文档时,嵌入任务全压在 worker 上。我们有次导入 2000 份文档,默认 1 个 worker 跑了 6 个小时,还把 API 进程的内存挤爆了。worker 扩到 3 个副本之后,同样的事 40 分钟干完。
坑 5:测试集要在上线前建好。 Dify 自己没有评估体系,我们从工单历史里抽了 120 条真实问题做成测试集,每次改 Prompt、换模型、调分块都跑一遍,防止"改好一处、改坏三处"。这个习惯救过我们至少两次。
坑 6:版本升级先看 Breaking Changes。 Dify 迭代很快,隔三差五发版。有次我们直接拉最新镜像升级,DSL 格式变了,旧的 Chatflow 导入直接报错。现在的规矩是:生产环境锁定版本号,升级先在测试环境导入 DSL 验证。
说了这么多,泼点冷水收个尾。Dify 不是银弹:
适合的场景:企业内部知识库问答、客服机器人、工单预分类、报表解读这类"编排为主、深度定制为辅"的应用。团队有 1-2 个懂 Prompt 的人,但不想养一个平台研发团队——Dify 就是为你准备的。
不太适合的场景:需要极低延迟(毫秒级)、超深度定制 Agent 编排逻辑、或者已有成熟 LLM 中间件的团队。这些场景自己写代码自由度更高,硬套 Dify 反而束手束脚。
我们现在的姿势是:80% 的标准需求用 Dify 快速搭,20% 的深度定制需求自研微服务,两边通过 API 互相调用。Dify 里甚至可以把你自研的服务注册成自定义工具(Custom Tool),编排能力不减反增。
一句话总结:如果你正在手搓第三个 LLM 应用的胶水代码,停一下,先把 Dify 拉起来跑一遍。有些轮子,真没必要自己造。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号