大模型业务稳定性:拆解路由重试、校验降级与复核机制,解决业务不确定性异常难题23.8
原创
大模型业务稳定性:拆解路由重试、校验降级与复核机制,解决业务不确定性异常难题23.8
原创
未闻花名
发布于 2026-09-28 17:24:01
发布于 2026-09-28 17:24:01
一、前言
回忆一下我们调用大模型的通用场景,首先把大模型当成传统确定性接口直接调用,写完 Prompt,调用API,拿到结果直接返回业务层。测试环境一切美好,上线之后各种问题接踵而至。有时候是模型服务超时熔断,有时候是返回内容格式错乱,有时候不同模型给出完全矛盾的答案,业务拿到冲突结果不知道怎么处理;还有部分场景,大模型输出模棱两可,机器没办法判断对错,直接交给用户就会产生业务风险。
其实大模型本身具备天然的不确定性,它不像传统数据库查询、RPC接口,输入固定就输出固定。幻觉、格式错误、服务抖动、限流、上下文溢出,都是常态。想要把大模型真正落地到生产业务,只靠调Prompt、换更强的模型远远不够。我们必须在应用层搭建一套完整的容错防护体系,也就是模型路由、重试、校验、降级、人工复核整套机制。核心目标不是消除大模型的不确定性,而是接纳不确定性,通过工程手段管控风险,把不可控的模型输出,转化为业务可以安全消费的数据。
二、智能分发调度路由
1. 模型路由基础
模型路由,简单来说就是请求的分配中枢。面对多模型集群,根据业务场景、模型能力、负载状态、成本约束,把业务请求分发到最合适的模型实例上。
很多早期项目直接硬编码模型地址,所有请求全部丢给同一个大模型。一旦这个模型服务限流、宕机,整个业务直接瘫痪:
- 简单任务也调用高价大模型,造成大量成本浪费;
- 复杂推理任务又用轻量小模型,输出质量完全达不到业务标准。
路由要解决三个核心现实问题:
- 能力匹配:不同业务请求复杂度不一样,简单抽取任务用轻量模型,复杂逻辑推理、高风险内容调用强能力模型。
- 容灾切换:单一模型故障,自动切换备选模型,避免业务整体不可用。
- 成本管控:在效果可接受前提下,优先使用低成本模型,控制整体调用开销。
路由不等于简单的负载均衡。传统负载均衡只关心服务压力;大模型路由需要感知业务语义、模型能力、输出质量、调用成本、服务健康状态。
2. 路由核心决策维度
我们可以把路由的决策因子分成几大类,实际业务中可以组合使用:
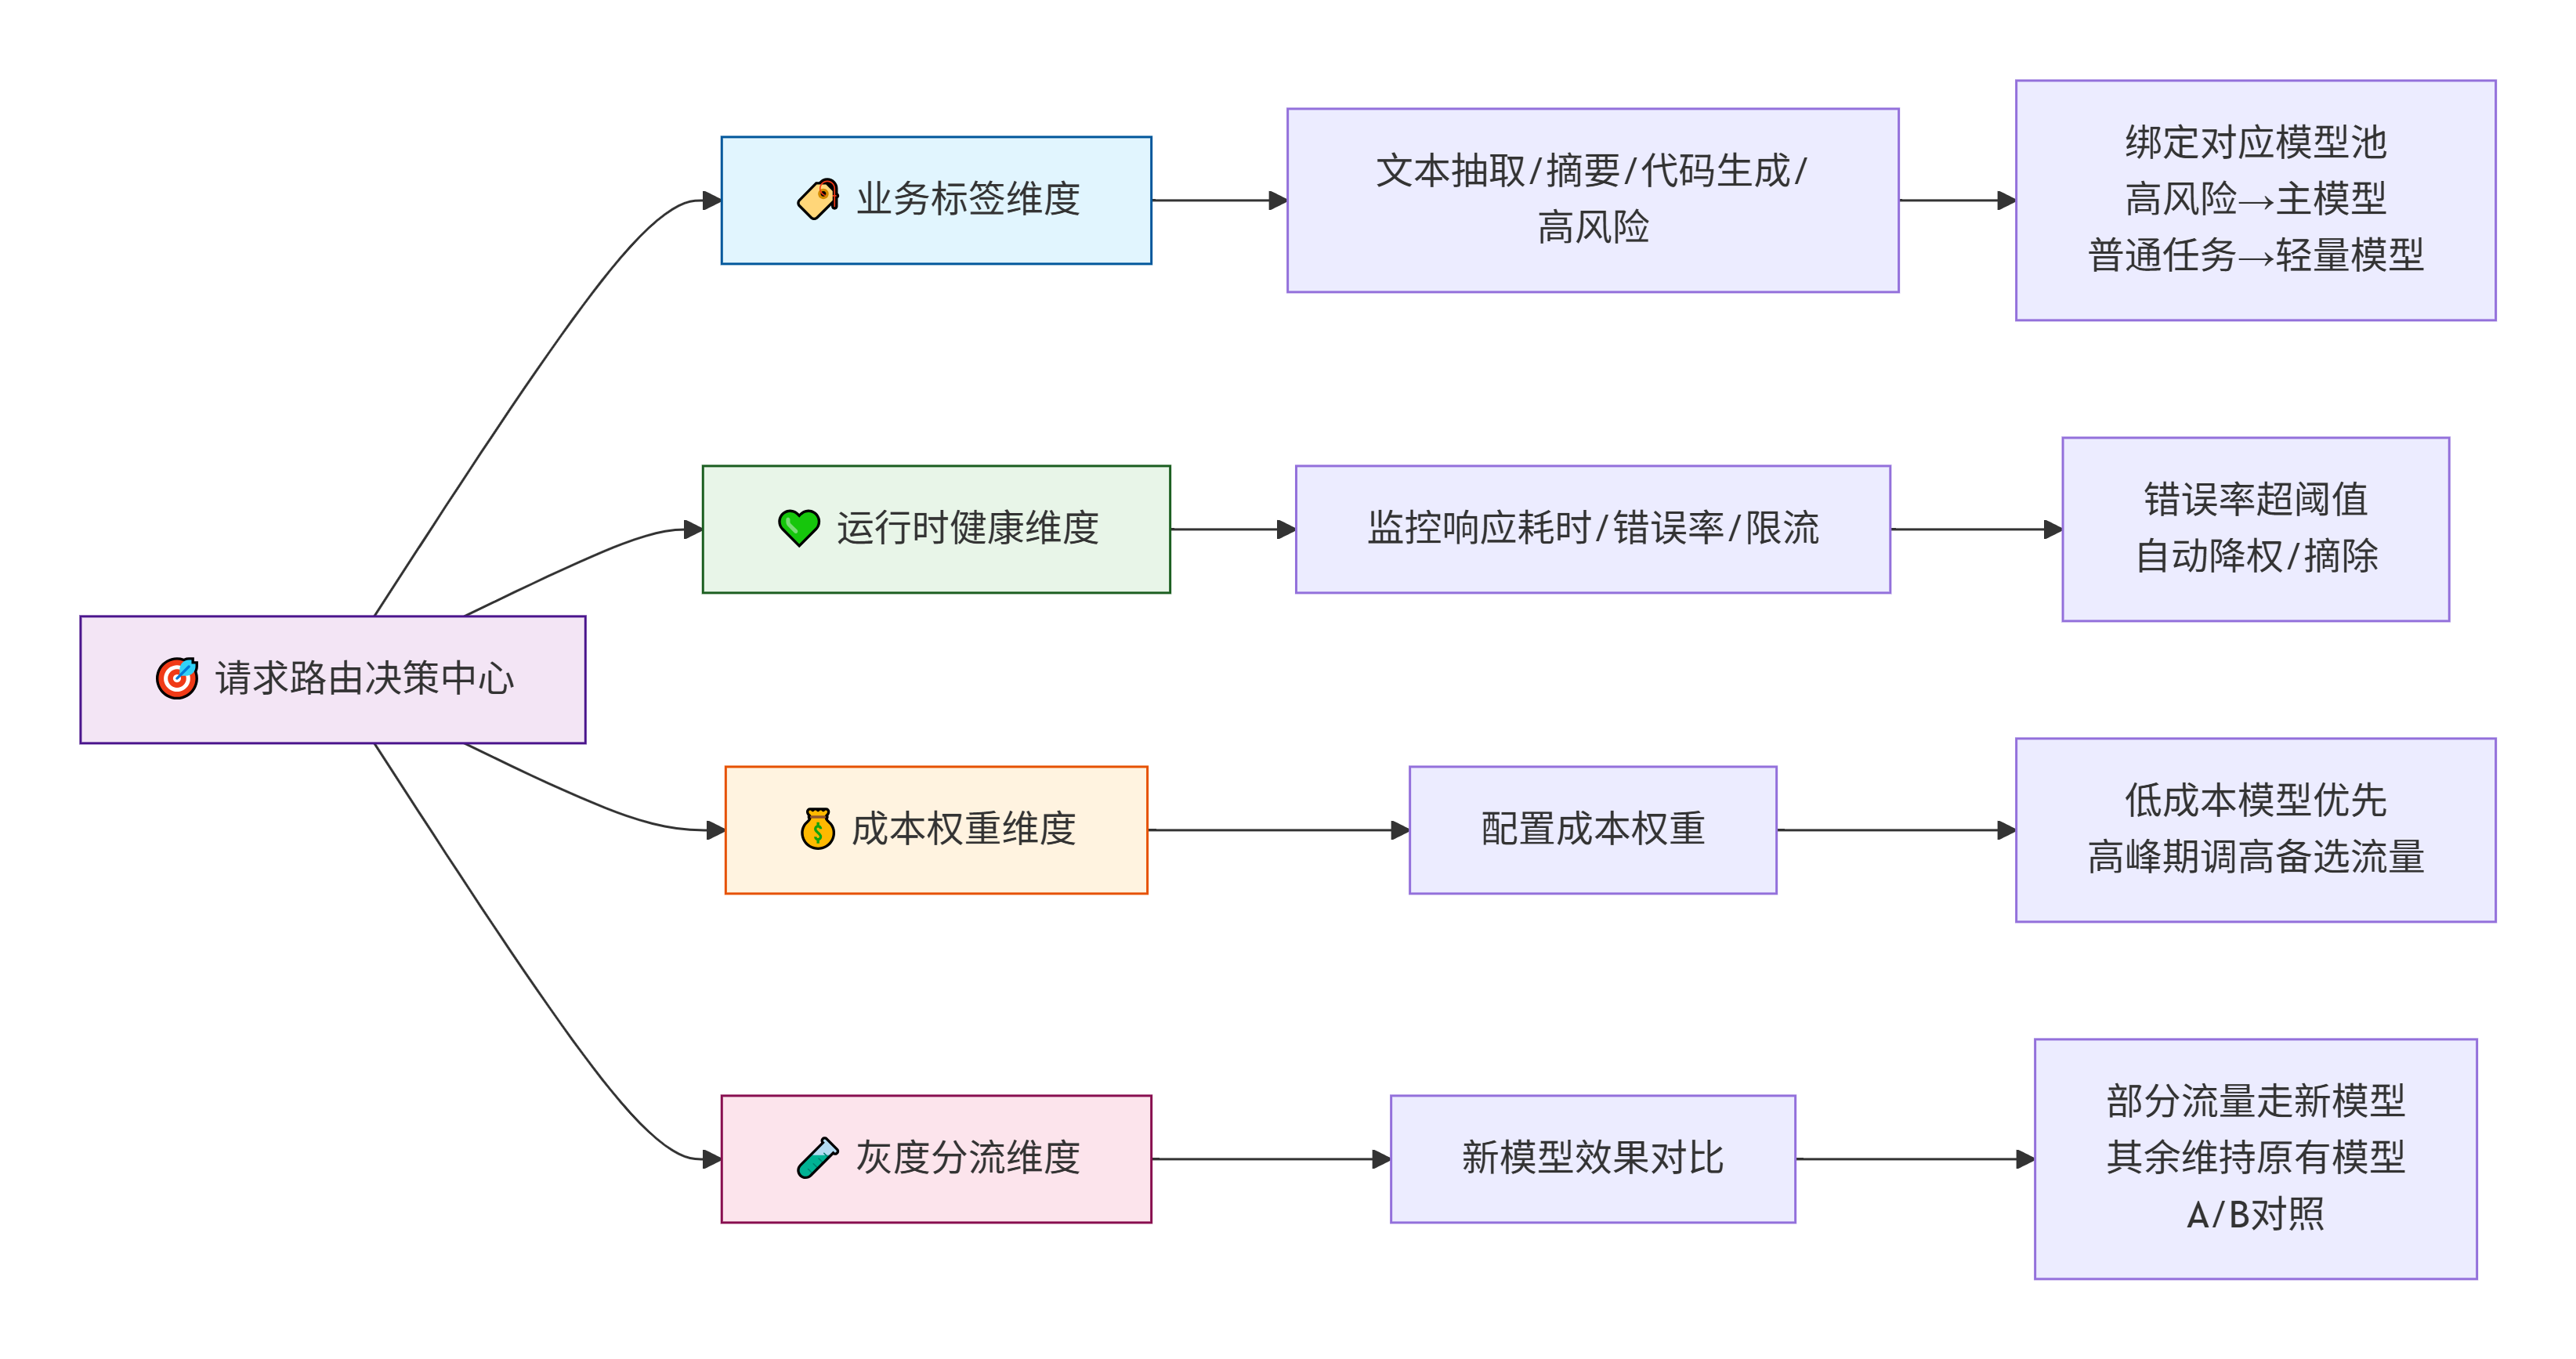
- 业务标签维度:区分请求类型,文本抽取、摘要、代码生成、高风险决策类任务,打上不同标签,绑定对应模型池。比如客户投诉风险判定,强制路由到高能力主模型;普通文本润色,路由廉价轻量模型。
- 运行时健康维度:监控模型接口响应耗时、错误率、限流报错。当某一个模型错误率超过阈值,自动降低权重,或者临时摘除该模型。
- 成本权重维度:配置权重,优先使用低成本模型,高峰期自动调高备选模型流量。
- 灰度分流维度:一部分流量走新模型做效果对比,其余流量维持原有稳定模型,做 A/B 对照。
路由不是一劳永逸的配置。线上需要持续采集各个模型在真实业务下的效果指标,动态调整路由策略,不能只看模型厂商对外宣传的榜单能力。纸面跑分很高的模型,不一定适配实际的业务 Prompt。
3. 基础路由示例代码
该通过为不同任务类型(风险判断、复杂推理、信息提取等)预先配置对应的模型池与成本等级,在运行时根据任务类型自动匹配可用模型,同时结合健康检查(错误率阈值)排除故障节点,实现任务驱动的智能路由——高价值复杂任务优先调用高性能大模型(高成本),高频通用任务则路由到轻量模型(低成本),从而在保障业务效果的前提下最大化成本效益。
from dataclasses import dataclass
from typing import Optional, Dict

# 模型元数据配置
@dataclass
class ModelMeta:
    model_name: str
    endpoint: str
    cost_level: str  # high / medium / low
    support_task: set[str]
    error_rate: float = 0.0  # 运行时统计错误率

class ModelRouter:
    def __init__(self):
        self.model_pool: Dict[str, ModelMeta] = {
            "gpt-main": ModelMeta(
                model_name="gpt-main",
                endpoint="https://xxx/v1/chat/completions",
                cost_level="high",  # 高性能大模型,推理成本高,适合复杂推理/风控等高价值任务
                support_task={"risk_judge", "complex_reason"}
            ),
            "qwen-light": ModelMeta(
                model_name="qwen-light",
                endpoint="https://yyy/v1/chat/completions",
                cost_level="low",  # 轻量模型,推理成本低,适合抽取/改写/总结等高并发通用任务
                support_task={"extract", "rewrite", "summary"}
            )
        }
        # 故障阈值,错误率超过该值则不选中该模型
        self.error_threshold = 0.15

    def select_model(self, task_type: str) -> Optional[ModelMeta]:
        """根据任务类型+健康状态选择模型"""
        candidates = [
            m for m in self.model_pool.values()
            if task_type in m.support_task and m.error_rate < self.error_threshold
        ]
        if not candidates:
            return None
        # 业务可扩展:增加权重、成本策略,这里优先返回第一个可用候选
        return candidates[0]

# 使用示例
if __name__ == "__main__":
    router = ModelRouter()

    # 成本等级简短理由映射
    cost_reason = {
        "high": "(高性能大模型,推理成本高)",
        "medium": "(中等模型,性价比均衡)",
        "low": "(轻量模型,推理成本低)",
    }

    # 场景1:高风险判断任务 → gpt-main
    print("=== 场景1:风险判断任务(risk_judge) ===")
    selected = router.select_model(task_type="risk_judge")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑")

    # 场景2:复杂推理任务 → gpt-main
    print("\n=== 场景2:复杂推理任务(complex_reason) ===")
    selected = router.select_model(task_type="complex_reason")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑")

    # 场景3:信息提取任务 → qwen-light
    print("\n=== 场景3:信息提取任务(extract) ===")
    selected = router.select_model(task_type="extract")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑")

    # 场景4:文本改写任务 → qwen-light
    print("\n=== 场景4:文本改写任务(rewrite) ===")
    selected = router.select_model(task_type="rewrite")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑")

    # 场景5:内容总结任务 → qwen-light
    print("\n=== 场景5:内容总结任务(summary) ===")
    selected = router.select_model(task_type="summary")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑")

    # 场景6:不支持的任务类型 → 降级
    print("\n=== 场景6:不支持的翻译任务(translate) ===")
    selected = router.select_model(task_type="translate")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑")

    # 场景7:模型错误率超阈值 → 被排除
    print("\n=== 场景7:gpt-main 错误率超阈值被排除 ===")
    router.model_pool["gpt-main"].error_rate = 0.3
    selected = router.select_model(task_type="risk_judge")
    if selected:
        print(f"路由选中模型:{selected.model_name}, 成本等级:{selected.cost_level}{cost_reason[selected.cost_level]}")
    else:
        print("无可用模型,触发降级逻辑(gpt-main 因错误率超阈值被跳过,且无其他模型支持该任务)")
输出结果:
=== 场景1:风险判断任务(risk_judge) === 路由选中模型:gpt-main, 成本等级:high(高性能大模型,推理成本高) === 场景2:复杂推理任务(complex_reason) === 路由选中模型:gpt-main, 成本等级:high(高性能大模型,推理成本高) === 场景3:信息提取任务(extract) === 路由选中模型:qwen-light, 成本等级:low(轻量模型,推理成本低) === 场景4:文本改写任务(rewrite) === 路由选中模型:qwen-light, 成本等级:low(轻量模型,推理成本低) === 场景5:内容总结任务(summary) === 路由选中模型:qwen-light, 成本等级:low(轻量模型,推理成本低) === 场景6:不支持的翻译任务(translate) === 无可用模型,触发降级逻辑 === 场景7:gpt-main 错误率超阈值被排除 === 无可用模型,触发降级逻辑(gpt-main 因错误率超阈值被跳过,且无其他模型支持该任务)
4. 实践经验总结
- 1. 不要过度追求模型数量。模型池不是越多越好,每新增一个模型,后续校验、效果评估、问题排查成本都会成倍上涨。够用即可。
- 2. 路由决策逻辑不要写死代码。全部放到配置中心,线上可以动态调整,不需要发布服务。
- 3. 高风险业务,不要把全部流量交给单一模型,预留备选模型作为兜底选项。
三、可控容错重试机制
1. 重试解决的问题
大模型调用过程中,大量失败属于瞬时故障。网络抖动、服务瞬时限流、队列排队超时,这类问题不需要业务介入,重新发起请求就可以恢复。但是重试绝对不是无脑循环重发。
很多项目简单写一个while循环无限重试,会带来严重后果:
- 放大上游服务压力,造成雪崩;
- 重复生成内容,带来业务重复数据;
- 超时场景下越重试,系统压力越大。
重试机制核心目标:对瞬时故障做自动恢复,同时规避重试风暴,区分哪些错误可以重试,哪些绝对不能重试。
我们要区分两类错误:
- 可重试错误:网络超时、503服务繁忙、429限流、连接断开。属于临时状态,重试有概率成功。
- 不可重试错误:入参非法、鉴权失败、Prompt违规被拦截、上下文长度超限。这类问题重试多少次都不会成功,直接终止。
2. 重试核心策略要素
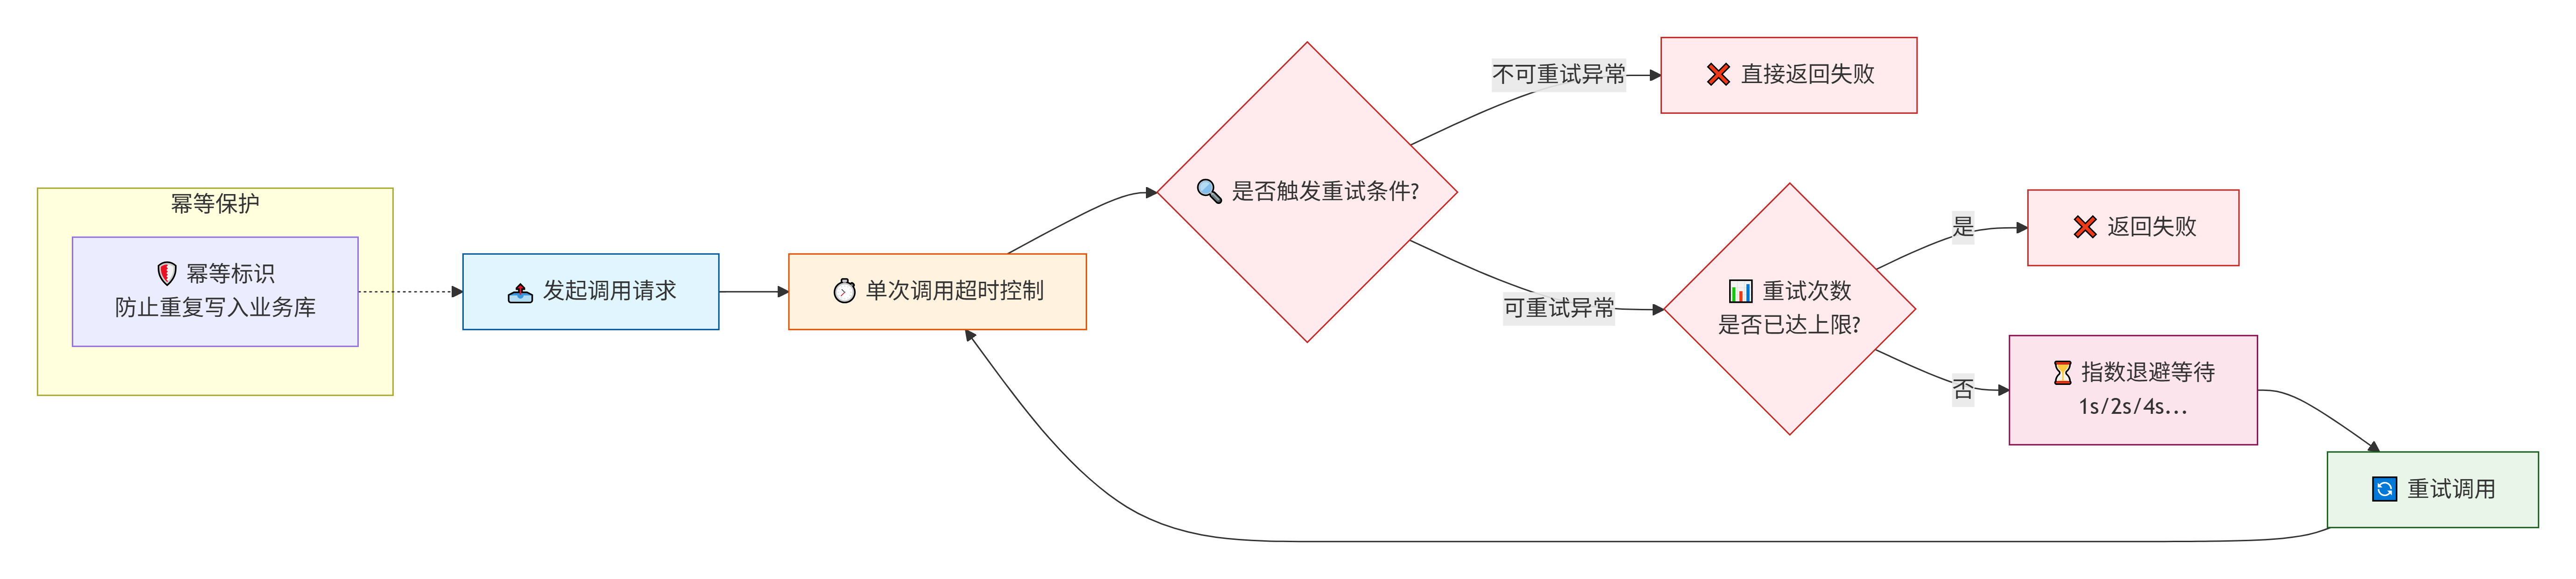
- 最大重试次数:设置上限,一般2‑3次足够,不建议设置更大。大模型 API 调用成本高,多次重试会带来高额费用。
- 退避间隔:不能立刻重试,使用指数退避。第一次等待1s,第二次等待2s,逐步拉长间隔,避免短时间大量请求打垮模型服务。
- 重试条件过滤:必须做错误码判断,只有可重试异常才执行重试。
- 超时控制:单次调用、整体重试链路都设置总超时,防止请求无限挂住。
- 幂等保护:部分业务场景,重复调用模型会产生不同结果,要做好标识,避免重复写入业务库。
一个非常容易忽略点:模型返回业务逻辑错误,比如输出格式不对,不属于网络故障,不应该走网络重试。格式错误属于输出质量问题,交给后续校验模块处理,而不是重新调用。
3. 重试机制实践示例
该重试机制实践示例基于tenacity库,对可恢复异常(如限流)使用指数退避策略(1s→2s→4s)自动重试最多3次,服务恢复则调用成功、全部失败则降级;对不可恢复异常(如参数错误)则立即终止重试、直接返回错误,确保系统兼具容错性与响应效率。
import time
from tenacity import retry, stop_after_attempt, wait_exponential, wait_fixed, retry_if_exception_type, before_log, after_log
import logging

# 配置日志输出
logging.basicConfig(level=logging.INFO, format="[%(asctime)s] %(message)s", datefmt="%H:%M:%S")
logger = logging.getLogger(__name__)

class ModelServiceUnavailable(Exception):
    """服务临时不可用,可以重试"""
    pass

class ModelParamInvalid(Exception):
    """参数错误,不可重试"""
    pass

# 模拟调用计数器(用于中途恢复的场景)
_call_count = 0

def call_llm_api(mock_error_type: str):
    """模拟调用大模型API"""
    global _call_count
    _call_count += 1
    logger.info(f"  [API调用] 第{_call_count}次发起请求,模拟错误类型: {mock_error_type}")

    if mock_error_type == "rate_limit":
        logger.warning(f"  [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试)")
        raise ModelServiceUnavailable("429 请求限流")

    elif mock_error_type == "rate_limit_then_ok":
        # 前2次限流,第3次成功
        if _call_count <= 2:
            logger.warning(f"  [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试)")
            raise ModelServiceUnavailable("429 请求限流")
        else:
            logger.info(f"  [API响应] 200 OK → 返回结果")

    elif mock_error_type == "invalid_param":
        logger.error(f"  [API响应] 400 参数非法 → 抛出 ModelParamInvalid(不可重试)")
        raise ModelParamInvalid("prompt参数非法")

    return "大模型返回结果内容"

# 只对可重试异常执行重试:指数退避 1s→2s→4s,最多3次
@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=1, max=4),
    retry=retry_if_exception_type((ModelServiceUnavailable,)),
    before=before_log(logger, logging.INFO),
    after=after_log(logger, logging.INFO),
    reraise=True
)
def safe_call_llm(error_type: str):
    return call_llm_api(error_type)

if __name__ == "__main__":
    # =========================================================
    # 场景1:限流 → 重试3次均失败 → 降级
    # =========================================================
    print("=" * 60)
    print("场景1:限流异常 → 指数退避重试(1s→2s→4s)3次 → 全部失败 → 降级")
    print("=" * 60)
    _call_count = 0
    try:
        start = time.time()
        res = safe_call_llm("rate_limit")
        print(f"\n>>> 调用成功:{res}")
    except ModelServiceUnavailable:
        elapsed = time.time() - start
        print(f"\n>>> [最终结果] 重试3次全部失败(耗时{elapsed:.1f}s),进入降级流程\n")

    # =========================================================
    # 场景2:限流 → 前2次失败 → 第3次成功
    # =========================================================
    print("=" * 60)
    print("场景2:限流异常 → 前2次失败 → 第3次恢复 → 调用成功")
    print("=" * 60)
    _call_count = 0
    try:
        start = time.time()
        res = safe_call_llm("rate_limit_then_ok")
        elapsed = time.time() - start
        print(f"\n>>> [最终结果] 第3次重试成功(耗时{elapsed:.1f}s):{res}\n")
    except Exception as e:
        print(f"\n>>> [最终结果] 调用失败:{e}\n")

    # =========================================================
    # 场景3:参数错误 → 不重试 → 立即失败
    # =========================================================
    print("=" * 60)
    print("场景3:参数非法异常(ModelParamInvalid) → 不可重试 → 立即抛错")
    print("=" * 60)
    _call_count = 0
    try:
        start = time.time()
        res = safe_call_llm("invalid_param")
        print(f"\n>>> 调用成功:{res}")
    except ModelParamInvalid:
        elapsed = time.time() - start
        print(f"\n>>> [最终结果] 参数非法,禁止重试,直接返回业务错误(耗时{elapsed:.1f}s)\n")

    # =========================================================
    # 场景4:正常调用 → 无异常 → 一次成功
    # =========================================================
    print("=" * 60)
    print("场景4:正常调用 → 无异常 → 一次返回")
    print("=" * 60)
    _call_count = 0
    try:
        start = time.time()
        res = safe_call_llm("normal")
        elapsed = time.time() - start
        print(f"\n>>> [最终结果] 一次调用成功(耗时{elapsed:.1f}s):{res}\n")
    except Exception as e:
        print(f"\n>>> [最终结果] 调用失败:{e}\n")

    # =========================================================
    # 总结
    # =========================================================
    print("=" * 60)
    print("重试机制总结")
    print("=" * 60)
    print("策略        | 异常类型                | 重试方式       | 结果")
    print("-----------|------------------------|---------------|-------------------")
    print("指数退避    | ModelServiceUnavailable| 1s→2s→4s 3次  | 全部失败则降级")
    print("指数退避+恢复| ModelServiceUnavailable| 1s→2s→成功     | 重试期间服务恢复")
    print("不重试      | ModelParamInvalid      | 立即失败       | 参数错误直接返回")
    print("正常返回    | 无异常                  | 无需重试       | 一次调用成功")
输出结果:
============================================================ 场景1:限流异常 → 指数退避重试(1s→2s→4s)3次 → 全部失败 → 降级 ============================================================ [21:54:03] Starting call to '__main__.safe_call_llm', this is the 1st time calling it. [21:54:03] [API调用] 第1次发起请求,模拟错误类型: rate_limit [21:54:03] [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试) [21:54:03] Finished call to '__main__.safe_call_llm' after 0(s), this was the 1st time calling it. [21:54:04] Starting call to '__main__.safe_call_llm', this is the 2nd time calling it. [21:54:04] [API调用] 第2次发起请求,模拟错误类型: rate_limit [21:54:04] [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试) [21:54:04] Finished call to '__main__.safe_call_llm' after 1(s), this was the 2nd time calling it. [21:54:06] Starting call to '__main__.safe_call_llm', this is the 3rd time calling it. [21:54:06] [API调用] 第3次发起请求,模拟错误类型: rate_limit [21:54:06] [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试) [21:54:06] Finished call to '__main__.safe_call_llm' after 3(s), this was the 3rd time calling it. >>> [最终结果] 重试3次全部失败(耗时3.0s),进入降级流程 ============================================================ 场景2:限流异常 → 前2次失败 → 第3次恢复 → 调用成功 ============================================================ [21:54:06] Starting call to '__main__.safe_call_llm', this is the 1st time calling it. [21:54:06] [API调用] 第1次发起请求,模拟错误类型: rate_limit_then_ok [21:54:06] [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试) [21:54:06] Finished call to '__main__.safe_call_llm' after 0(s), this was the 1st time calling it. [21:54:07] Starting call to '__main__.safe_call_llm', this is the 2nd time calling it. [21:54:07] [API调用] 第2次发起请求,模拟错误类型: rate_limit_then_ok [21:54:07] [API响应] 429 请求限流 → 抛出 ModelServiceUnavailable(可重试) [21:54:07] Finished call to '__main__.safe_call_llm' after 1(s), this was the 2nd time calling it. [21:54:09] Starting call to '__main__.safe_call_llm', this is the 3rd time calling it. [21:54:09] [API调用] 第3次发起请求,模拟错误类型: rate_limit_then_ok [21:54:09] [API响应] 200 OK → 返回结果 >>> [最终结果] 第3次重试成功(耗时3.0s):大模型返回结果内容 ============================================================ 场景3:参数非法异常(ModelParamInvalid) → 不可重试 → 立即抛错 ============================================================ [21:54:09] Starting call to '__main__.safe_call_llm', this is the 1st time calling it. [21:54:09] [API调用] 第1次发起请求,模拟错误类型: invalid_param [21:54:09] [API响应] 400 参数非法 → 抛出 ModelParamInvalid(不可重试) >>> [最终结果] 参数非法,禁止重试,直接返回业务错误(耗时0.0s) ============================================================ 场景4:正常调用 → 无异常 → 一次返回 ============================================================ [21:54:09] Starting call to '__main__.safe_call_llm', this is the 1st time calling it. [21:54:09] [API调用] 第1次发起请求,模拟错误类型: normal >>> [最终结果] 一次调用成功(耗时0.0s):大模型返回结果内容 ============================================================ 重试机制总结 ============================================================ 策略 | 异常类型 | 重试方式 | 结果 -----------|------------------------|---------------|------------------- 指数退避 | ModelServiceUnavailable| 1s→2s→4s 3次 | 全部失败则降级 指数退避+恢复| ModelServiceUnavailable| 1s→2s→成功 | 重试期间服务恢复 不重试 | ModelParamInvalid | 立即失败 | 参数错误直接返回 正常返回 | 无异常 | 无需重试 | 一次调用成功
4. 重试机制注意事项
- 埋点统计:统计总调用、重试次数、重试成功率,观察线上限流、抖动情况。如果大量请求走到重试,说明上游服务压力大,需要配合路由切流。
- 不要把业务语义错误当成调用故障。输出幻觉、格式错乱,不要用重试尝试修复,重试大概率得到另一个错误答案。
- 高成本大模型,严格控制重试上限,避免成本失控。
四、结果校验识别异常
1. 校验的价值所在
就算 API 调用完全成功,大模型返回200状态码,也不代表输出内容业务可用。幻觉、格式错乱、输出截断、多个模型返回互相冲突的结论,都是生产常态。
路由和重试解决的是调用层面故障;校验模块解决输出内容层面故障。很多工程体系缺失这一环,直接把模型输出交给上层业务,就埋下业务风险。
校验主要处理两类现象:
- 单模型输出异常:JSON 格式解析失败、输出为空、内容截断、不符合业务约束、产生幻觉虚假信息。
- 多模型结果冲突:路由多模型并行调用,不同模型给出截然相反的业务判断,机器无法直接采信任意一方。
校验不是追求100%识别所有幻觉,现实中做不到。目标是过滤掉明显低级错误,识别冲突、不确定性,把无法自动判定的案例交给降级或者人工复核。
2. 分层校验策略
我们把校验分成三层,由简单到复杂,性能开销从小到大:
格式校验:
- 检查输出是否符合约定格式。业务如果约定返回JSON,就校验JSON可解析;
- 需要特定字段,校验字段是否存在、字段类型是否正确。
- 很多抽取、结构化业务,绝大部分的问题都出在格式错乱。
规则业务校验:
写业务规则约束输出。例如:
- 金额不能是负数;
- 分类结果只能是枚举内给定值;
- 摘要长度不能超过指定字符;
- 不允许出现特定敏感业务表述。
语义一致性校验:
针对高风险场景。可以用轻量模型做二次校验:
- 主模型输出一个结论,校验模型对结果做审核,判断输出是否和输入原始材料冲突;
- 当并行调用多个模型,对比不同模型输出,检测结论冲突。
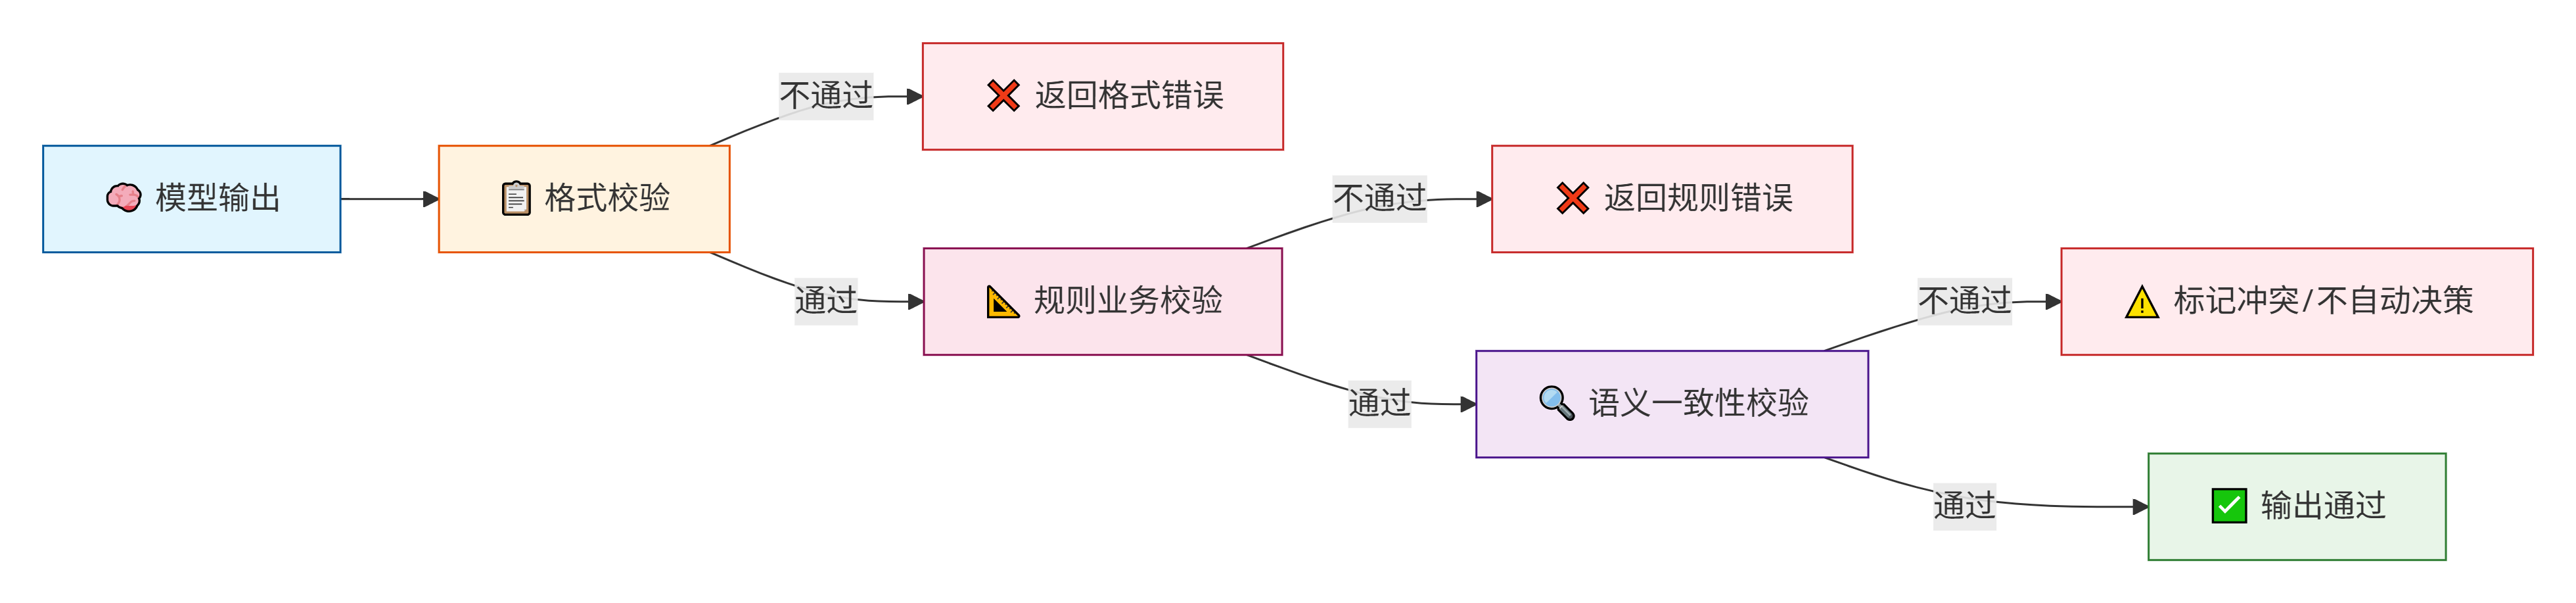
冲突判定示例:两个模型对同一条客户内容,一个判定为高风险,一个判定为无风险,就标记为冲突状态,不自动做业务决策。
3. 校验模块基础示例
该校验模块对LLM输出进行三层把关:JSON格式解析校验确保结构合法、业务枚举校验约束分类值在允许范围内、多模型冲突检测发现结论不一致时触发人工介入,从格式到语义逐层兜底,保障大模型输出可靠可控。
import json
from typing import List, Dict

class LLMOutputValidator:
    def __init__(self, allow_enum: set):
        self.allow_enum = allow_enum

    def check_json_format(self, raw_text: str) -> tuple[bool, dict | None]:
        """校验JSON格式"""
        try:
            data = json.loads(raw_text)
            return True, data
        except json.JSONDecodeError:
            return False, None

    def check_business_enum(self, data: dict) -> bool:
        """业务枚举校验,分类结果必须在允许集合内"""
        label = data.get("risk_label")
        if label not in self.allow_enum:
            return False
        return True

    def detect_conflict(self, model_output_list: List[dict]) -> bool:
        """检测多模型输出是否存在结论冲突"""
        labels = {item.get("risk_label") for item in model_output_list}
        # 同时出现多种不同结论,判定冲突
        if len(labels) > 1:
            return True
        return False

if __name__ == "__main__":
    validator = LLMOutputValidator(allow_enum={"high", "medium", "low"})
    raw = '''{"risk_label":"high"}'''
    format_ok, parse_data = validator.check_json_format(raw)
    if format_ok and parse_data:
        bus_ok = validator.check_business_enum(parse_data)
        print(f"格式校验:{format_ok},业务校验:{bus_ok}")

    # 模拟多模型冲突
    outputs = [{"risk_label":"high"}, {"risk_label":"low"}]
    is_conflict = validator.detect_conflict(outputs)
    print(f"是否存在结果冲突:{is_conflict}")
输出结果:
格式校验:True,业务校验:True 是否存在结果冲突:True
4. 校验的现实局限
语义校验会带来额外模型调用成本,不需要所有请求都开启。
- 普通业务只做格式 + 规则校验;
- 高风险决策场景才开启多模型对比、二次语义校验。
校验模块输出三种状态:校验通过;校验失败;存在冲突/不确定。后两种状态,不能直接执行业务逻辑,流转到降级或者人工复核通道。
五、业务兜底降级策略
1. 降级的定位
经过路由、重试、校验之后,依然会出现处理失败场景。模型服务大面积故障、输出全部校验不通过、大量结果冲突。此时不能直接抛出错误给前端用户,需要执行降级。
降级的核心思想:放弃部分 AI 智能化能力,优先保障业务流程可以继续运转。降级不等于简单返回报错,要区分不同降级等级,根据业务损失可控程度选择兜底策略。
这里要注意区分降级和重试:
- 重试是尝试恢复正常;
- 降级是承认当前AI链路无法正常工作,主动切换兜底路径。
2. 多档位降级方案
按照业务影响从低到高,划分不同降级档位,系统根据失败原因自动选择:
- 1. 模型降级(软降级):主模型链路失败,路由切换到备用次选模型,重新执行完整流程。不改变业务逻辑,只是更换模型实例。
- 2. 规则兜底降级:放弃大模型推理,使用传统写好的业务规则、正则、配置模板输出结果。适合结构化抽取、简单分类场景。牺牲智能灵活性,保证结果格式合规。
- 3. 输出模板降级:无法自动生成有效结果,返回预设友好提示给用户。例如 “当前暂时无法完成分析,请修改输入后重试”。适合面向C端用户交互场景。
- 4. 流转人工降级:AI完全无法处理,不生成自动结果,直接把原始请求上下文入队,推送人工复核队列。高风险业务最常用,宁可机器不决策,也不要输出错误决策。
- 5. 业务熔断降级:极端大规模故障,关闭 AI 子模块,上层业务走原有旧流程,完全绕开大模型链路。
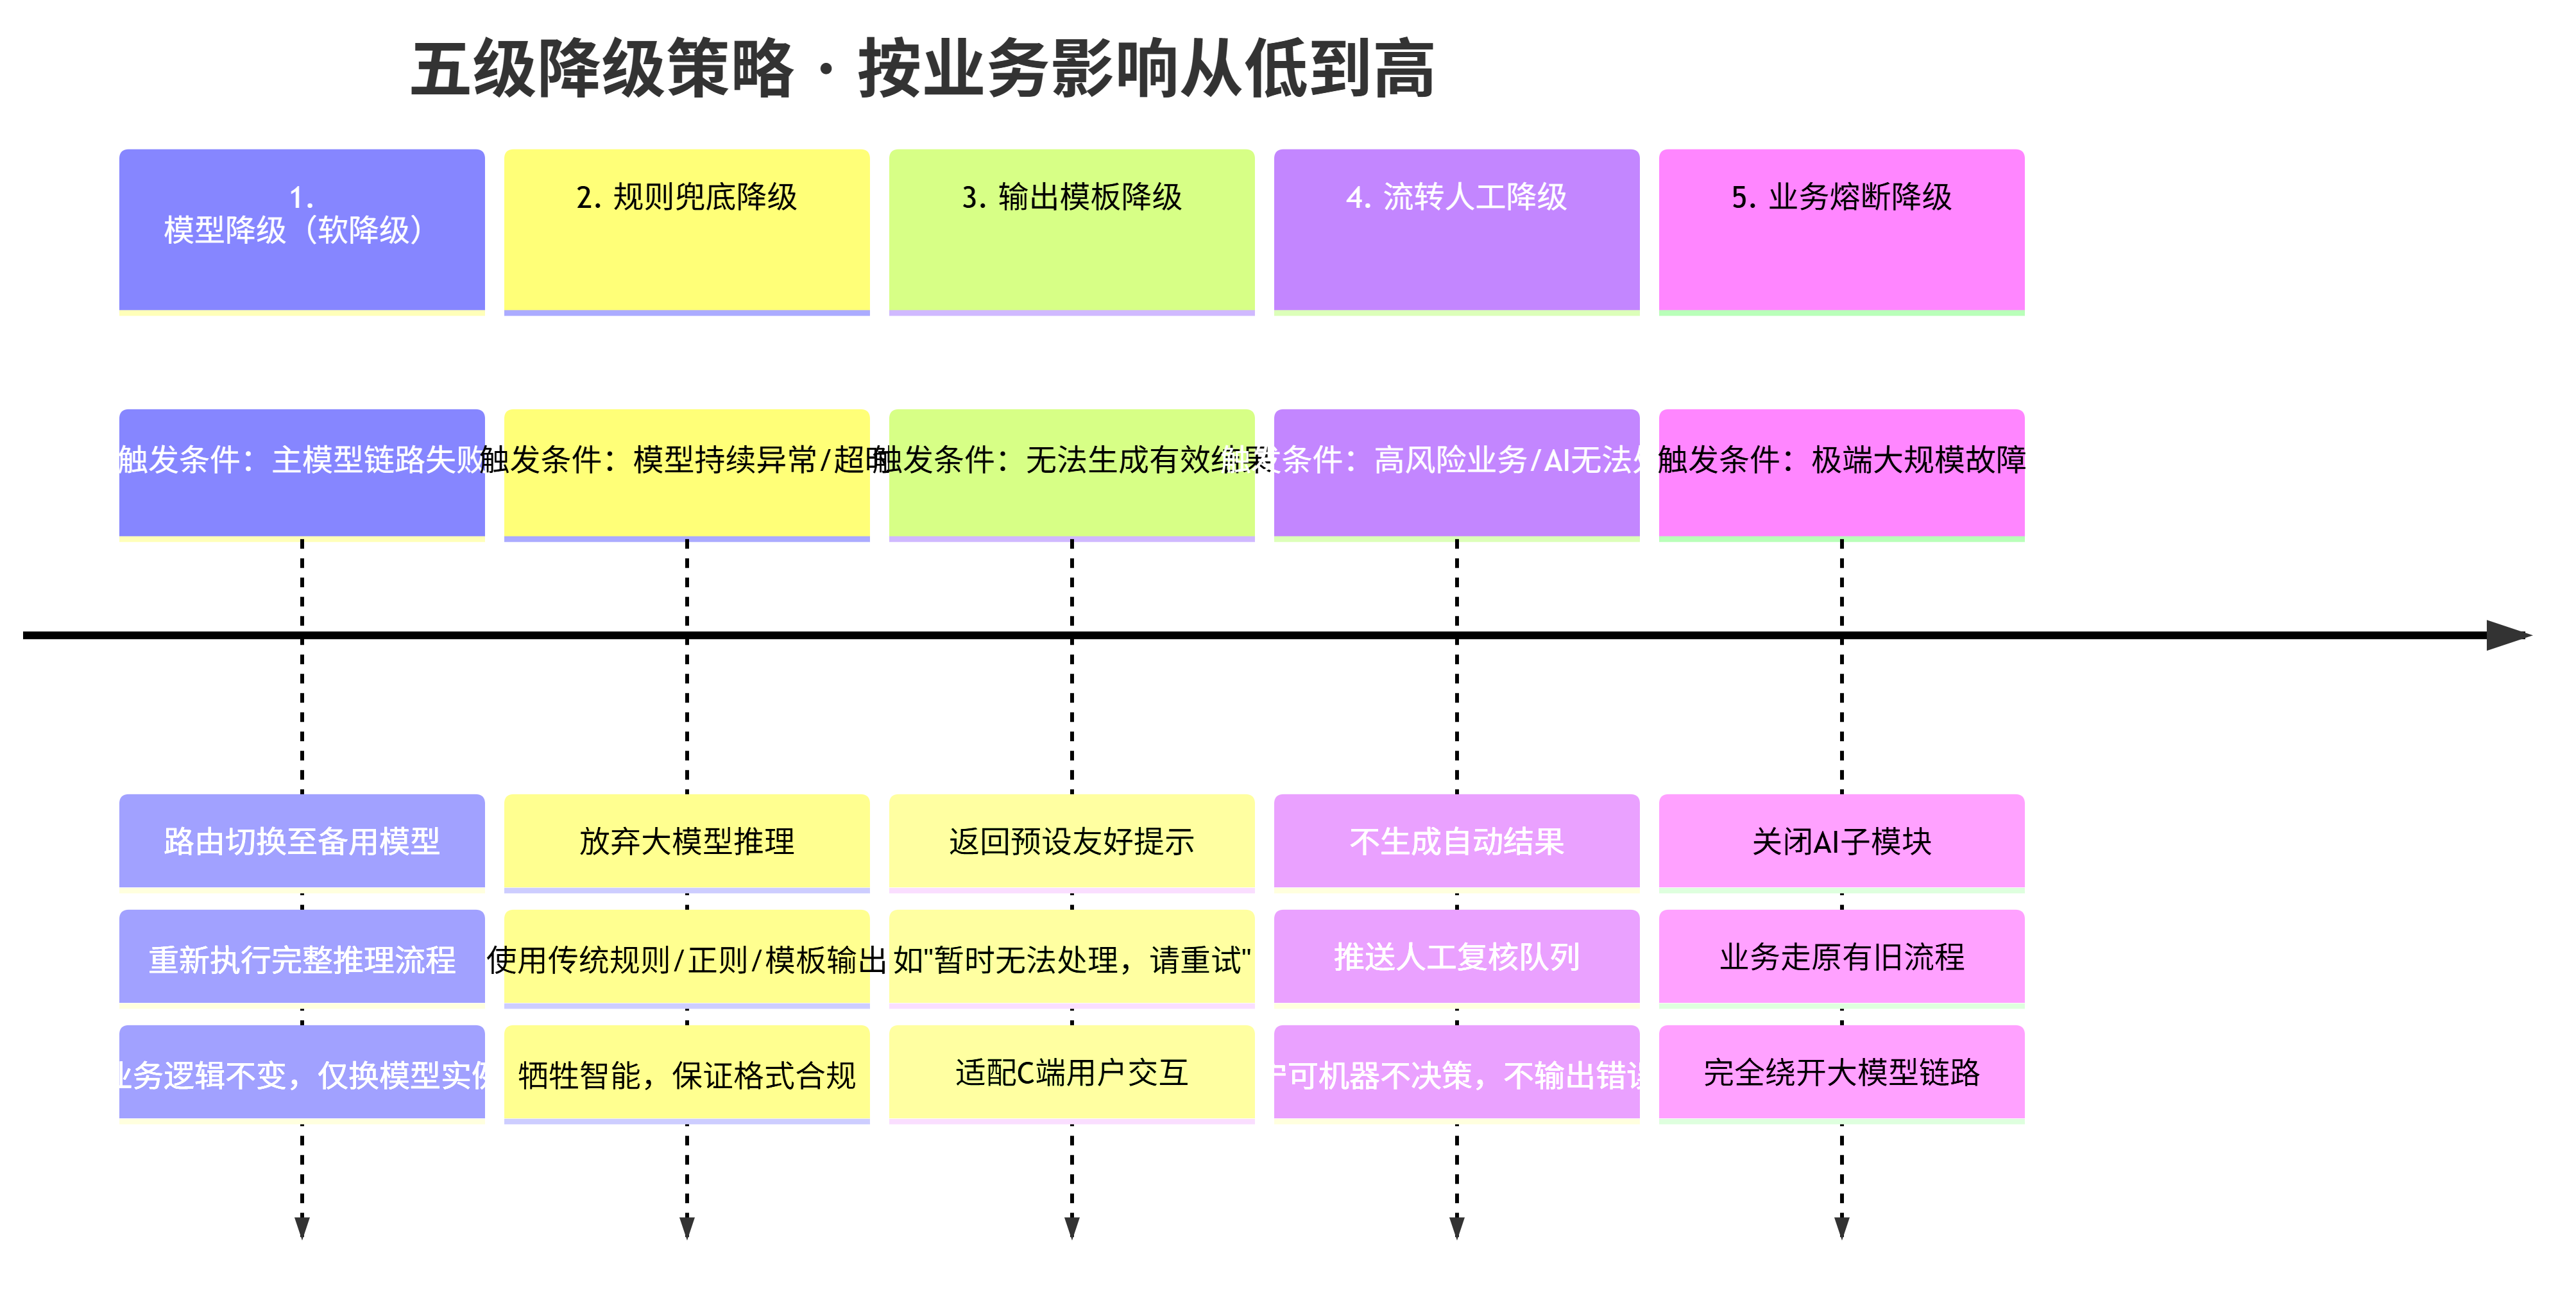
关键原则:降级方案提前设计上线,不要等到线上出故障才临时想对策。每一个业务场景,都要明确:链路失败之后,允许采用哪一档降级策略。
3. 降级流程应用示例
该降级模块构建了"主模型→备用模型→规则引擎→模板提示→人工复核"五级兜底链路,当上级节点异常时自动下沉到下一级处理,确保大模型应用在任意环节故障时仍能保障业务可用、不中断服务。
from enum import Enum

# 降级等级:从轻到重,逐级兜底
class DegradeLevel(Enum):
    NORMAL = "normal"               # 正常,无需降级
    BACKUP_MODEL = "backup_model"   # 一级:主模型不可用 → 切换备用模型
    RULE_FALLBACK = "rule_fallback" # 二级:模型全不可用 → 传统规则兜底
    TEMPLATE_TIP = "template_tip"   # 三级:规则也失败 → 返回固定模板提示
    TO_MANUAL = "to_manual_review"  # 四级:最终兜底 → 转人工复核

class DegradeHandler:
    """降级处理器:逐级降级,保障业务不中断"""
    def __init__(self):
        self.template_map = {
            "tip": "系统暂时无法完成智能分析,请调整输入内容后重试。"
        }

    def rule_fallback_execute(self, input_text: str):
        """传统规则兜底示例"""
        return {"risk_label":"unknown", "reason":"AI链路异常,规则兜底标记未知"}

    def dispatch_degrade(self, degrade_level: DegradeLevel, input_context: dict):
        """根据降级等级分发到对应处理逻辑"""
        if degrade_level == DegradeLevel.BACKUP_MODEL:
            # 一级降级:主模型挂了,切到备用模型继续服务
            return {"degrade":True, "way":"切换备用模型", "context":input_context}
        elif degrade_level == DegradeLevel.RULE_FALLBACK:
            # 二级降级:模型全挂,用规则引擎兜底
            return self.rule_fallback_execute(input_context.get("text",""))
        elif degrade_level == DegradeLevel.TEMPLATE_TIP:
            # 三级降级:规则也跑不了,给用户一个友好提示
            return {"msg": self.template_map["tip"]}
        elif degrade_level == DegradeLevel.TO_MANUAL:
            # 四级降级:自动链路全断,写入人工复核队列
            return {"degrade":True, "way":"送入人工复核队列","task_id":input_context["task_id"]}
        else:
            # 正常路径,无需降级
            return {"status":"ok"}

if __name__ == "__main__":
    handler = DegradeHandler()
    context = {"task_id":"t1001","text":"待分析业务文本"}

    # ---- 逐级演示降级流程 ----
    print("=" * 50)
    print("降级流程演示:逐级兜底,保障业务可用")
    print("=" * 50)

    # 正常:无需降级
    print("\n>>> [正常] 主模型健康,直接返回")
    res = handler.dispatch_degrade(DegradeLevel.NORMAL, context)
    print(f"    结果: {res}")

    # 一级降级:主模型不可用 → 切备用模型
    print("\n>>> [一级降级] 主模型超时 → 切换备用模型")
    res = handler.dispatch_degrade(DegradeLevel.BACKUP_MODEL, context)
    print(f"    结果: {res}")

    # 二级降级:模型全不可用 → 规则兜底
    print("\n>>> [二级降级] 备用模型也失败 → 规则引擎兜底")
    res = handler.dispatch_degrade(DegradeLevel.RULE_FALLBACK, context)
    print(f"    结果: {res}")

    # 三级降级:规则失败 → 模板提示
    print("\n>>> [三级降级] 规则引擎异常 → 返回固定提示")
    res = handler.dispatch_degrade(DegradeLevel.TEMPLATE_TIP, context)
    print(f"    结果: {res}")

    # 四级降级:自动链路全断 → 转人工
    print("\n>>> [四级降级] 自动链路全断 → 转人工复核")
    res = handler.dispatch_degrade(DegradeLevel.TO_MANUAL, context)
    print(f"    结果: {res}")

    print("\n" + "=" * 50)
    print("降级链路:模型→备用→规则→模板→人工,逐级兜底不中断")
输出结果:
================================================== 降级流程演示:逐级兜底,保障业务可用 ================================================== >>> [正常] 主模型健康,直接返回 结果: {'status': 'ok'} >>> [一级降级] 主模型超时 → 切换备用模型 结果: {'degrade': True, 'way': '切换备用模型', 'context': {'task_id': 't1001', 'text': '待分析业务文本'}} >>> [二级降级] 备用模型也失败 → 规则引擎兜底 结果: {'risk_label': 'unknown', 'reason': 'AI链路异常,规则兜底标记未知'} >>> [三级降级] 规则引擎异常 → 返回固定提示 结果: {'msg': '系统暂时无法完成智能分析,请调整输入内容后重试。'} >>> [四级降级] 自动链路全断 → 转人工复核 结果: {'degrade': True, 'way': '送入人工复核队列', 'task_id': 't1001'} ================================================== 降级链路:模型→备用→规则→模板→人工,逐级兜底不中断
4. 降级实践说明
- 降级必须埋点监控,统计各类降级发生频次。如果某一类降级大量触发,代表上游链路存在隐患,需要优化Prompt、路由策略或者扩容模型资源。
- 区分面向用户和面向内部业务。C端产品尽量使用模板提示;风控、审批类内部业务,优先流转人工复核,不要自动输出猜测结果。
- 降级数据完整留存日志:原始输入、模型输出、失败原因、降级档位,方便后续复盘优化模型体系。
六、风险兜底人工复核
1. 人工复核机制
无论工程机制做多么完善,大模型业务永远存在机器无法判断的场景:结果冲突、语义高度模糊、高风险决策。机器拿不准的时候,强行自动输出,就会带来业务事故。
人工复核不是技术落后的体现,是大模型落地高风险业务必不可少的闭环。整套链路前面的路由、重试、校验、降级,最终都会把无法自动处理的案例输送到复核队列。
人工复核的目标:
- 接管 AI 无法判定的不确定性案例,规避错误决策带来业务损失。
- 沉淀复核标注数据,反向迭代 Prompt、校验规则、模型选择,持续优化 AI 能力,减少后续人工工作量。
做人工复核,不能仅仅只做简单的人工处理,丢掉数据回流,就浪费最大价值。复核不只是纠错,更是训练迭代的数据来源。
2. 复核核心流程
完整复核链路分为 5 个环节:
- 1. 入队:校验模块标记冲突、不确定、高风险样本,降级模块推送,带上完整上下文:原始输入、各个模型输出结果、失败原因标签、时间戳。
- 2. 任务分发:按照业务类型、风险等级分配给对应审核人员,高风险任务优先处理。
- 3. 人工操作:审核人员查看全部上下文,选择确认AI结果、修改结果、驳回,填写处理理由。
- 4. 结果回写:把人工最终决策写回业务系统,替代AI输出执行业务逻辑。
- 5. 数据回流:把“输入文本 + AI输出 + 人工标准答案”保存样本库,用于后续微调、Prompt迭代、优化校验规则。
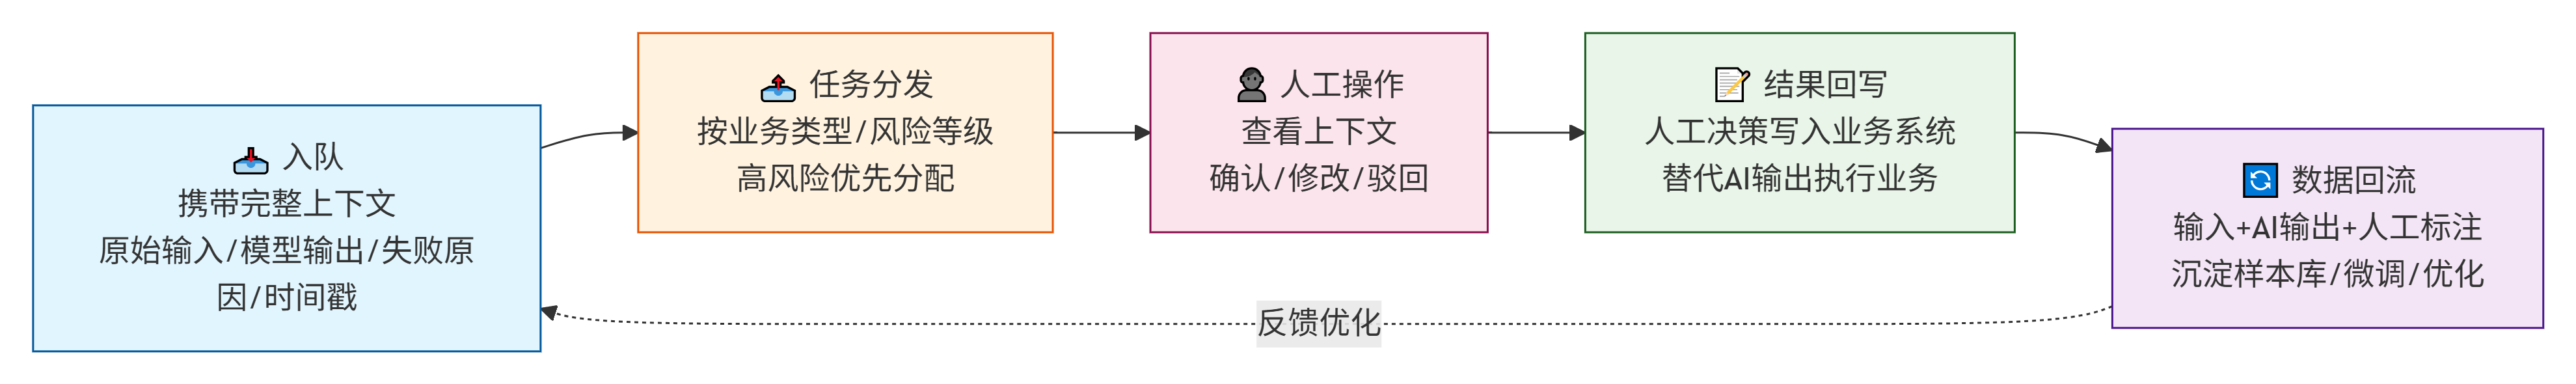
人工复核追求降低人工负担。不要把全部流量送入复核队列。前面机制的意义,就是尽可能过滤掉可以自动处理的样本,只把小部分疑难案例交给人。如果复核队列数量巨大,说明前面的自动化链路存在缺陷。
3. 复核队列应用示例
该复核队列模块将模型输出冲突或校验失败的任务自动推入人工复核队列,由操作员认领并提交复核结果,同时可沉淀为训练样本用于后续模型迭代优化,实现AI异常场景的人机协同闭环。
from dataclasses import dataclass
from typing import List, Optional

@dataclass
class ReviewTask:
    task_id: str
    input_content: str
    model_outputs: List[dict]
    reason: str  # 为什么进入复核:冲突/校验失败
    review_result: Optional[dict] = None
    review_operator: Optional[str] = None

class ManualReviewQueue:
    def __init__(self):
        self.queue: List[ReviewTask] = []

    def push_task(self, task: ReviewTask):
        self.queue.append(task)

    def pop_pending_task(self) -> Optional[ReviewTask]:
        if len(self.queue) == 0:
            return None
        return self.queue.pop(0)

    def submit_review_result(self, task: ReviewTask, operator: str, result: dict):
        task.review_operator = operator
        task.review_result = result
        # 此处可以把样本写入数据集,用于后续迭代优化
        print(f"任务{task.task_id}完成复核,操作员:{operator},人工结果:{result}")

if __name__ == "__main__":
    review_queue = ManualReviewQueue()
    task = ReviewTask(
        task_id="rev_0001",
        input_content="待分析业务文本",
        model_outputs=[{"risk_label":"high"},{"risk_label":"low"}],
        reason="多模型输出结论冲突"
    )
    review_queue.push_task(task)
    get_task = review_queue.pop_pending_task()
    if get_task:
        review_queue.submit_review_result(get_task, "user_a", {"risk_label":"low"})
输出结果:
任务rev_0001完成复核,操作员:user_a,人工结果:{'risk_label': 'low'}
4. 复核应用注意事项
- 设置队列积压告警。如果待复核任务堆积持续上涨,代表自动化链路能力不足,需要优化模型和校验规则。
- 做好权限与留痕,所有人工操作完整日志保存,满足业务审计需求。
- 建立定期复盘机制,定期分析复核样本,看看是 Prompt 问题,还是校验规则缺失,持续反哺自动化链路,逐步降低人工占比。
七、整体串联与观测
1. 完整链路流转
把前面所有模块串起来,完整业务请求流转顺序:
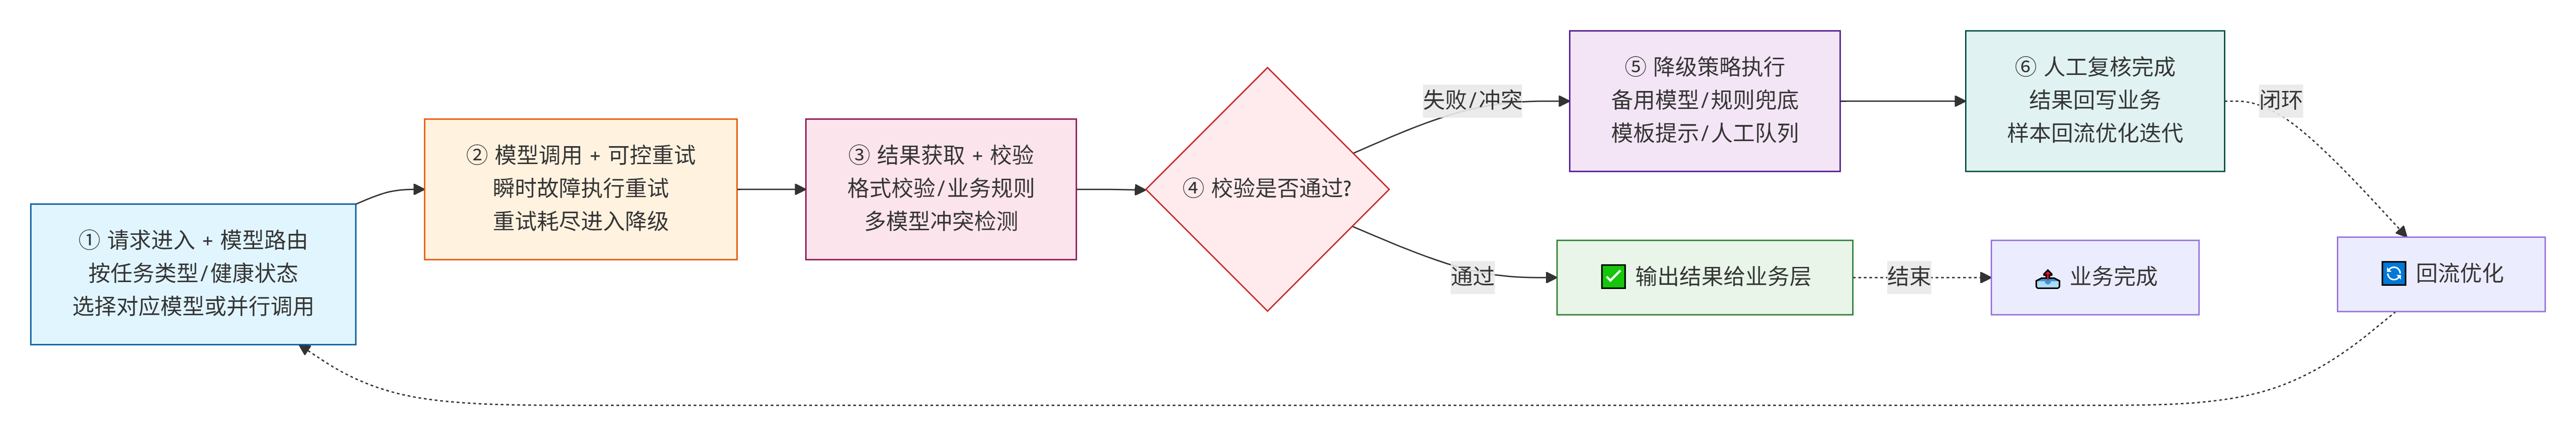
- 1. 请求进入,模型路由根据任务类型、健康状态,选择对应模型或者多模型并行调用。
- 2. 发起模型调用,遇到瞬时故障,执行可控重试;重试耗尽依然失败,进入降级。
- 3. 获取模型返回结果,交给校验模块:格式校验、业务规则校验、多模型冲突检测。
- 4. 校验通过:输出结果给到业务层。
- 5. 校验失败 / 检测冲突:进入降级策略,可选切换备用模型、规则兜底、模板提示、送入人工复核队列。
- 6. 人工复核完成后,人工结果回写业务,样本回流用于迭代优化。
整套机制不是相互独立,是一环扣一环的防护网:
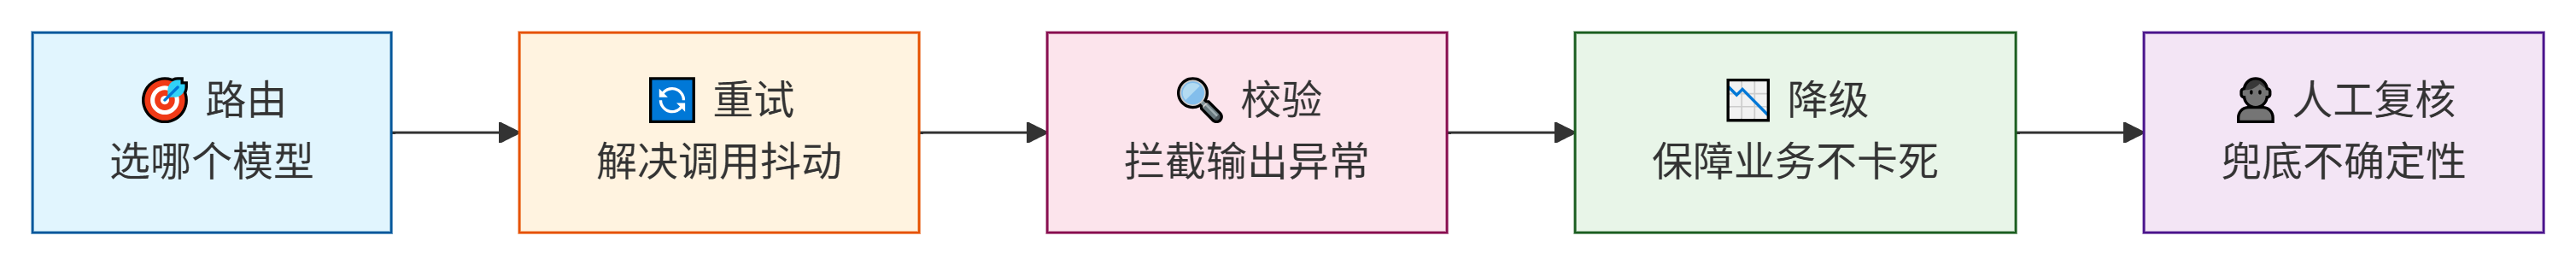
- 路由解决选哪个模型;
- 重试解决调用抖动;
- 校验解决输出异常冲突;
- 降级保障业务不卡死;
- 人工复核兜底机器无法处理的不确定性。
2. 核心观测指标
没有监控的工程机制等于没有落地。核心埋点指标:
- 路由指标:各个模型调用量占比,模型健康错误率。
- 重试指标:总调用次数,触发重试比例,重试成功占比。
- 校验指标:校验通过率,格式失败数量,业务规则失败数量,冲突样本数量。
- 降级指标:各降级档位触发次数统计。
- 复核指标:入队任务数量,处理完成率,队列积压数量。
通过指标,我们可以直观看到整个大模型应用的健康度,定位短板。例如冲突样本持续走高,说明单一模型能力不足,可以优化 Prompt 或者增加模型对比策略。
3. 实践细节权衡
在实践应用过程中,我们要避免经常会出现的两种情况:
- 1. 过度依赖大模型,什么防护都不做,上线之后被幻觉、服务抖动各种问题打垮。
- 2. 防护机制做的过于厚重,每个请求都多模型并行、多层校验,带来巨大的成本与延迟,性能完全无法接受。
现实工程要做权衡:普通业务链路做轻量化防护;只有高风险业务,才启用完整多模型校验、人工复核全套能力。不要对所有请求一刀切使用最高等级防护。
八、总结
大模型的不确定性,是它与生俱来的特性。我们做工程开发,不应该幻想彻底消灭幻觉、冲突、异常,而是学会接纳不确定性,搭建分层防护体系。模型路由负责选对模型,打好基础;重试处理网络瞬时故障,提升调用成功率;校验拦截格式错误、识别结果冲突;降级保证业务不会彻底瘫痪;人工复核作为最后的安全兜底,同时产出优化迭代的数据。
应用这些组合机制,把大模型从一个不可控的黑盒能力,变成可以被业务安全使用的生产组件。随着接触的越深入,我们越会明白,不存在永远稳定完美的大模型应用。任何应用体系也不是一次性写完就结束,它是持续迭代的系统。监控指标告诉我们哪里出问题,人工复核产出真实样本,反过来优化Prompt、调整路由策略、补充校验规则,不断降低异常和人工复核的占比。希望我们都可以在实际项目中少踩坑,平稳把大模型能力落地到真实业务当中。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号