Coding Agent 长任务中的 Context 压缩时机
原创
Coding Agent 长任务中的 Context 压缩时机
原创
七牛开发者
发布于 2026-10-09 17:28:35
发布于 2026-10-09 17:28:35
Coding Agent 执行大型代码任务时,Context 会随着文件检索、代码阅读、修改和测试逐渐增长。运行时间越长,积累的历史记录也越多。目前,一种常见的处理方式是设置 Context 长度阈值,当剩余空间不足时,系统便会触发压缩,将此前的交互历史整理成摘要,让 Agent 继续执行。
但这种方式存在一个问题:Context 的长度与任务进度未必同步。 例如,Agent 可能只用了少量 Context 就定位了 Bug,准备进入代码修改阶段。此时,前面大量搜索记录和失败假设的作用开始下降,却仍然占据上下文空间。反过来,Agent 也可能正在调查某个复杂问题,尚未找到原因,就因为触及长度阈值而被迫压缩,导致部分尚未验证的线索丢失。
上周发布的论文「AutoCompact: Learning When to Compact Context in Long-Horizon Coding Agents」就研究了上面这个问题。作者提出 AutoCompact,让 Coding Agent 学习自主判断 Context 的压缩时机、生成压缩后的工作状态,并根据保留的信息继续执行任务。
在论文的实验部分,作者使用 Qwen3-Coder-30B-A3B-Instruct 作为基础模型。在 SWE-bench Verified 和 SWE-PolyBench Verified 上,AutoCompact 的任务通过率分别提高了 9.2 和 5.0 个百分点。
从长度阈值转向任务进度
AutoCompact 的核心思路是让 Agent 自主决定何时压缩 Context。
在传统的上下文长度触发压缩的方案中,Agent 会不断积累工具输出和交互历史,直到 Context 使用量达到预设阈值,系统才会触发压缩。AutoCompact 则引入了一个由模型主动调用的 compact() 动作,让 Agent 基于当前任务进度来判断是否需要整理已有信息。
以一次 Bug 修复任务为例,Agent 的执行过程可能分为下面这四个阶段:
- 搜索代码仓库,找到相关文件。
- 阅读代码,定位问题原因。
- 修改代码,运行测试。
- 检查修改结果并提交。
当 Agent 完成问题定位、准备进入代码修改阶段时,可能不再需要完整保留此前的大量搜索记录和探索过程。这时候,Agent 可以主动调用 compact()把已确认的问题原因、相关的代码位置和后续任务整理成工作状态摘要,为接下来的代码修改保留必要的上下文。
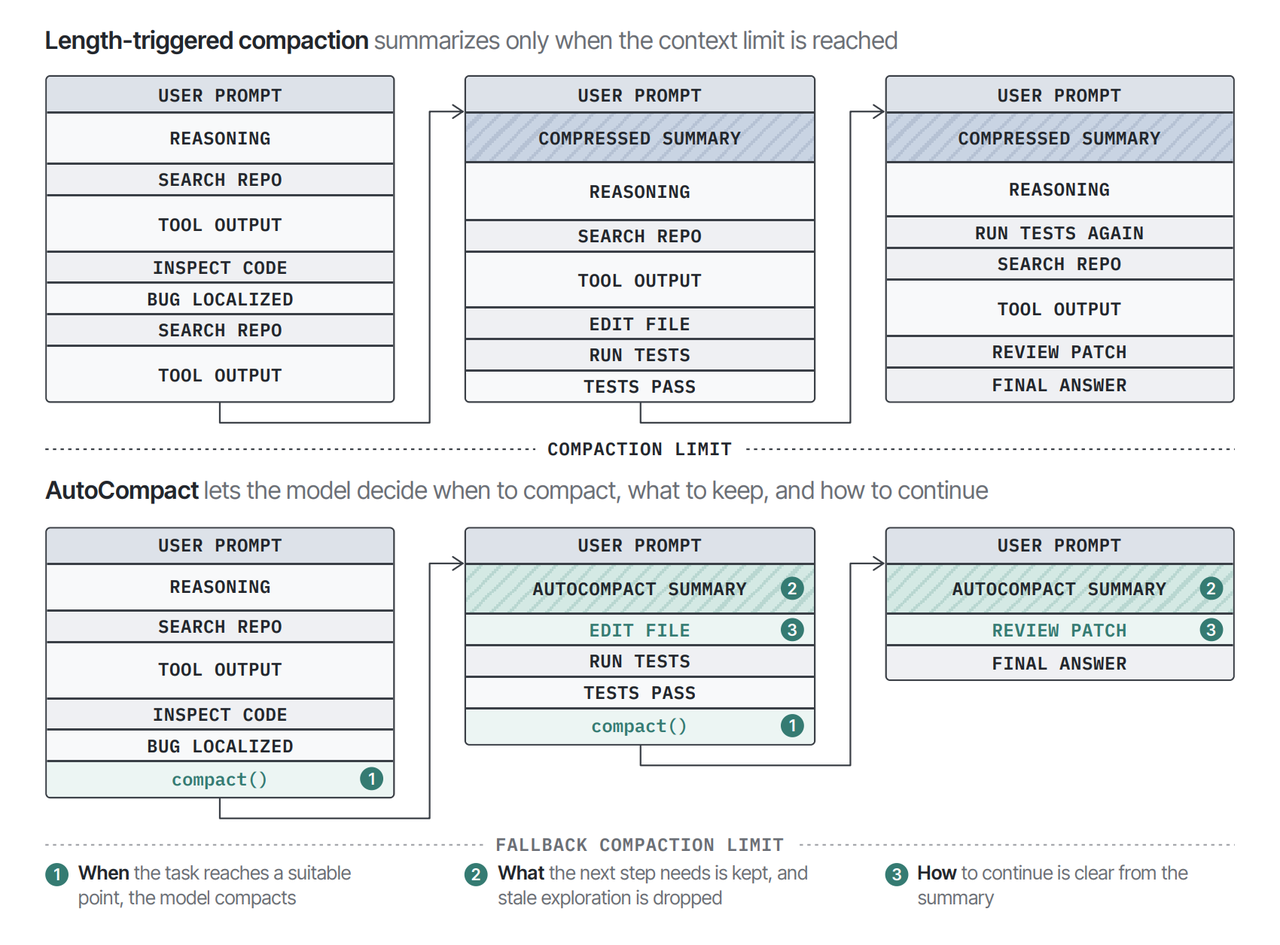
图注:长度阈值 vs AutoCompact
这个机制涉及三个决策:
- 什么时候压缩(When):判断当前阶段是否完成,历史信息能否被整理为更简洁的工作状态。
- 保留哪些信息(What):保留已经确认的结论、相关代码位置、工作区状态以及剩余任务,舍弃不再需要的探索细节。
- 压缩后如何继续(How):根据摘要中的工作状态继续执行,避免重复搜索、遗漏修改或偏离原定任务。
进行实际压缩时,AutoCompact 会将此前的交互历史替换为模型生成的工作状态摘要,摘要以 # Auto Context Summary 开头,同时保留原始的任务要求。
这样,Agent 可以从压缩后的上下文继续工作。不过,允许模型主动调用 compact() 只解决了接口问题。模型还需要学会判断什么时候调用,以及如何正确使用压缩结果。
用 Judge 修正 Agent 的压缩行为
作者在初步实验中发现,即使在 Prompt 中明确加入 Context 压缩规则,基础模型也很少在达到长度限制前主动调用 compact()。所以,AutoCompact 采用了两阶段训练方法:首先通过 Judge 引导的数据收集和监督微调(SFT),让模型学习压缩时机、摘要生成及后续执行;随后利用强化学习(RL),进一步优化模型的任务表现。
在第一阶段,研究团队先让基础模型执行真实的软件工程任务,并引入 Judge 对执行过程进行检查。每当模型提出一个动作,Judge 就会根据当前可见的执行历史,判断这个动作是否合理,以及是否需要修正。
Judge 主要检查三类问题:
- 压缩时机:如果 Agent 已经定位 Bug,却仍在重复搜索,Judge 可以将当前动作替换为
compact();如果问题还在调查中,则允许 Agent 继续探索。 - 摘要内容:如果 Agent 生成的工作状态摘要遗漏了目标文件、已确认的结论或当前修改进度,Judge 会补充这些信息,确保摘要能够支持后续执行。
- 后续动作:如果摘要明确记录了下一步需要修改的文件,但 Agent 又重新执行此前完成的搜索,Judge 会修正当前动作,使其与摘要记录的任务状态保持一致。
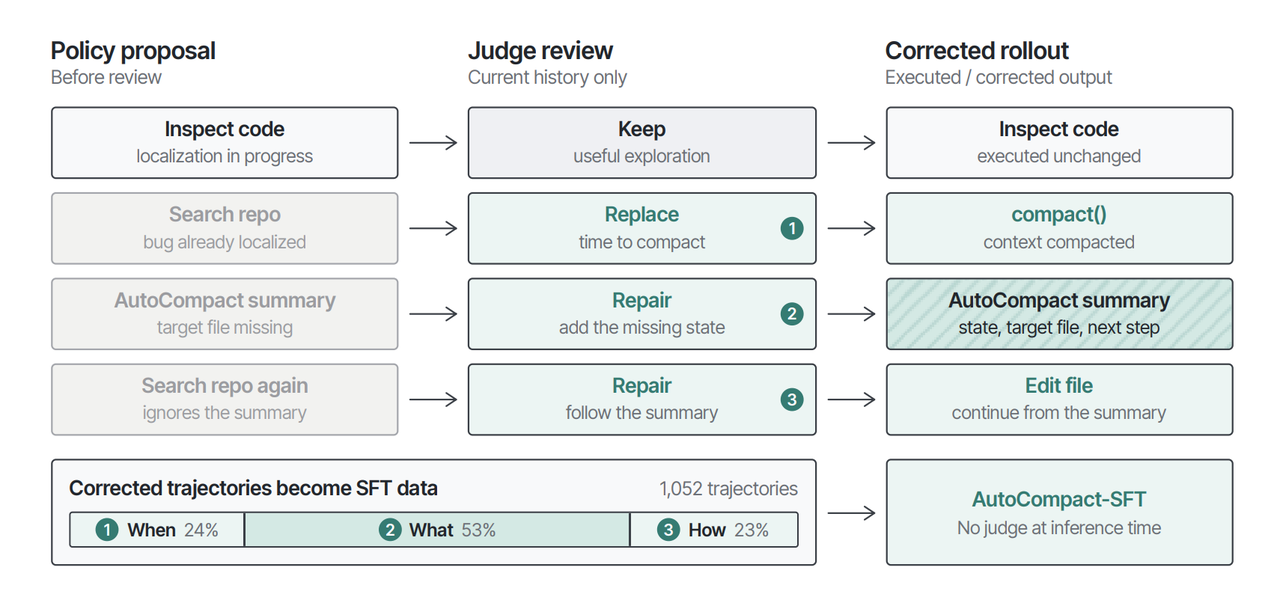
图注:Judge 引导的在线策略数据收集。上图展示了模型从提出动作、Judge 检查修正,以及修正结果进入后续执行的完整流程。
在这套数据收集流程中,Judge 会在动作执行前完成检查和修正。例如,当 Agent 应该进入代码修改阶段,却仍然提出继续搜索时,Judge 会修正这一动作,执行环境随后采用修正后的动作。Agent 后续看到的交互历史,也会包含实际执行的修正结果。
这样收集到的训练数据,能够反映 Agent 在 Context 压缩后的真实执行过程。相比之下,如果在一条完整的执行轨迹中事后插入压缩动作,后续动作会沿用原始轨迹。即使摘要改变了上下文,也无法反映 Agent 在新上下文下会如何继续执行。
作者使用 GPT-5.5-Codex 作为 Judge,在 379 个 SWE-rebench 任务中收集了 1,052 条修正后的执行轨迹。其中,24% 用于监督压缩时机,53% 用于监督工作状态摘要的生成,23% 用于监督压缩后的继续执行。
这些数据随后用于监督微调,得到 AutoCompact-SFT。训练完成后,Agent 在推理阶段便可以自主执行 Context 压缩,无需再调用 Judge。
用任务结果训练 Context 管理
经过监督微调,模型开始学会主动调用 compact(),但合理的压缩行为还需要通过最终任务结果来验证。为此,作者进一步引入强化学习,让模型根据任务完成情况优化 Context 管理策略。
这一阶段使用 SWE-Gym 软件工程任务进行训练,并采用 GRPO 算法优化策略。每个任务采样 8 条执行轨迹,根据最终生成的补丁能否通过测试,给予二元结果奖励。奖励同时作用于 Coding Agent 的代码操作和 Context 管理行为,包括何时调用 compact()、如何生成摘要,以及压缩后如何继续执行。
作者没有单独设计评价摘要质量的奖励函数,而是利用最终任务结果,让模型学习不同压缩决策对任务完成情况的影响。
训练过程中还需要处理 Context 重写带来的问题。调用 compact() 后,原有交互历史会被摘要替换,因此,一条完整的执行轨迹无法再按照上下文持续增长的单一序列进行处理。
所以,作者以每次 Context 重写为分界点,将完整轨迹拆分成多个片段。每个片段内部的上下文前缀保持连续增长,不同片段则共享所属轨迹的强化学习优势信号。通过这种方式,压缩前的决策、摘要生成以及压缩后的执行动作,都能根据同一次任务的最终结果进行优化。
实验表现
作者在两个软件工程基准上评估了 AutoCompact:
- SWE-bench Verified:500 个经过验证的软件工程任务。
- SWE-PolyBench Verified:用于评估跨编程语言代码任务的基准。
实验中,所有方法均采用相同的基础模型和 Agent 执行框架。评价结果取三次运行的平均值。论文比较了完整历史执行、固定长度触发压缩、基于规则的主动压缩,以及经过 SFT、RL 训练的主动压缩策略。
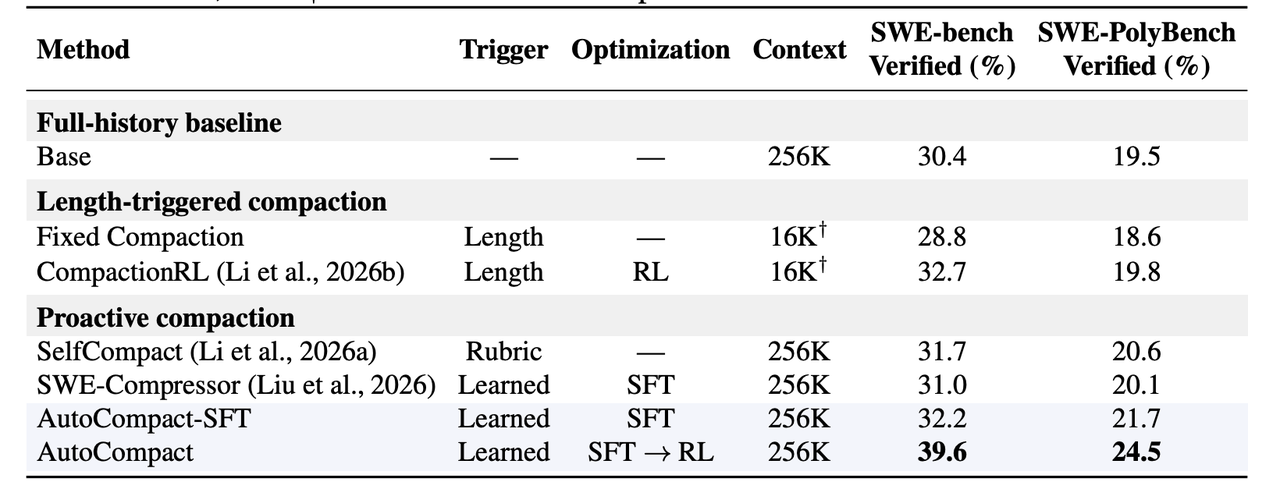
图注:不同 Context 压缩方法在 SWE-bench Verified 和 SWE-PolyBench Verified 上的任务通过率对比
从实验结果看,固定长度压缩(Fixed Compaction)在两项基准上的通过率均略低于基础模型(Base)。引入强化学习的 CompactionRL 改善了任务表现,但提升幅度有限。
AutoCompact-SFT 在两项基准上的表现均优于基础模型。经过强化学习后,AutoCompact 的通过率进一步提升至 39.6% 和 24.5%,相比 SFT 阶段分别提高了 7.4 和 2.8 个百分点。
不过,解读这些结果时还需要考虑实验条件的差异。Fixed Compaction 和 CompactionRL 使用 16K 的强制压缩阈值,而主要的主动压缩方法采用 256K Context。因此,表中的性能差异也可能受到上下文预算的影响,无法全部归因于压缩策略本身。
为了进一步区分压缩策略与实验条件的影响,作者又设计了多组不同推理预算和压缩机制下的对比实验。
有效的主动压缩
论文还通过一组实验,考察主动压缩在 Context 空间充足时是否仍能带来收益。
作者将 Context 窗口设置为 256K,在这一条件下,所有执行轨迹均未达到强制压缩阈值。研究团队随后设置了每任务 0.10~4.00 美元的六档推理预算,对比不同模型的任务通过率。
结果显示,AutoCompact-SFT 在所有预算档位下均优于基础模型(Base),经过强化学习的 AutoCompact 则进一步提高了通过率。在另一组 16K 阈值实验中,所有模型都使用相同的长度触发兜底压缩机制,AutoCompact 依然在全部预算档位取得了更高的通过率。
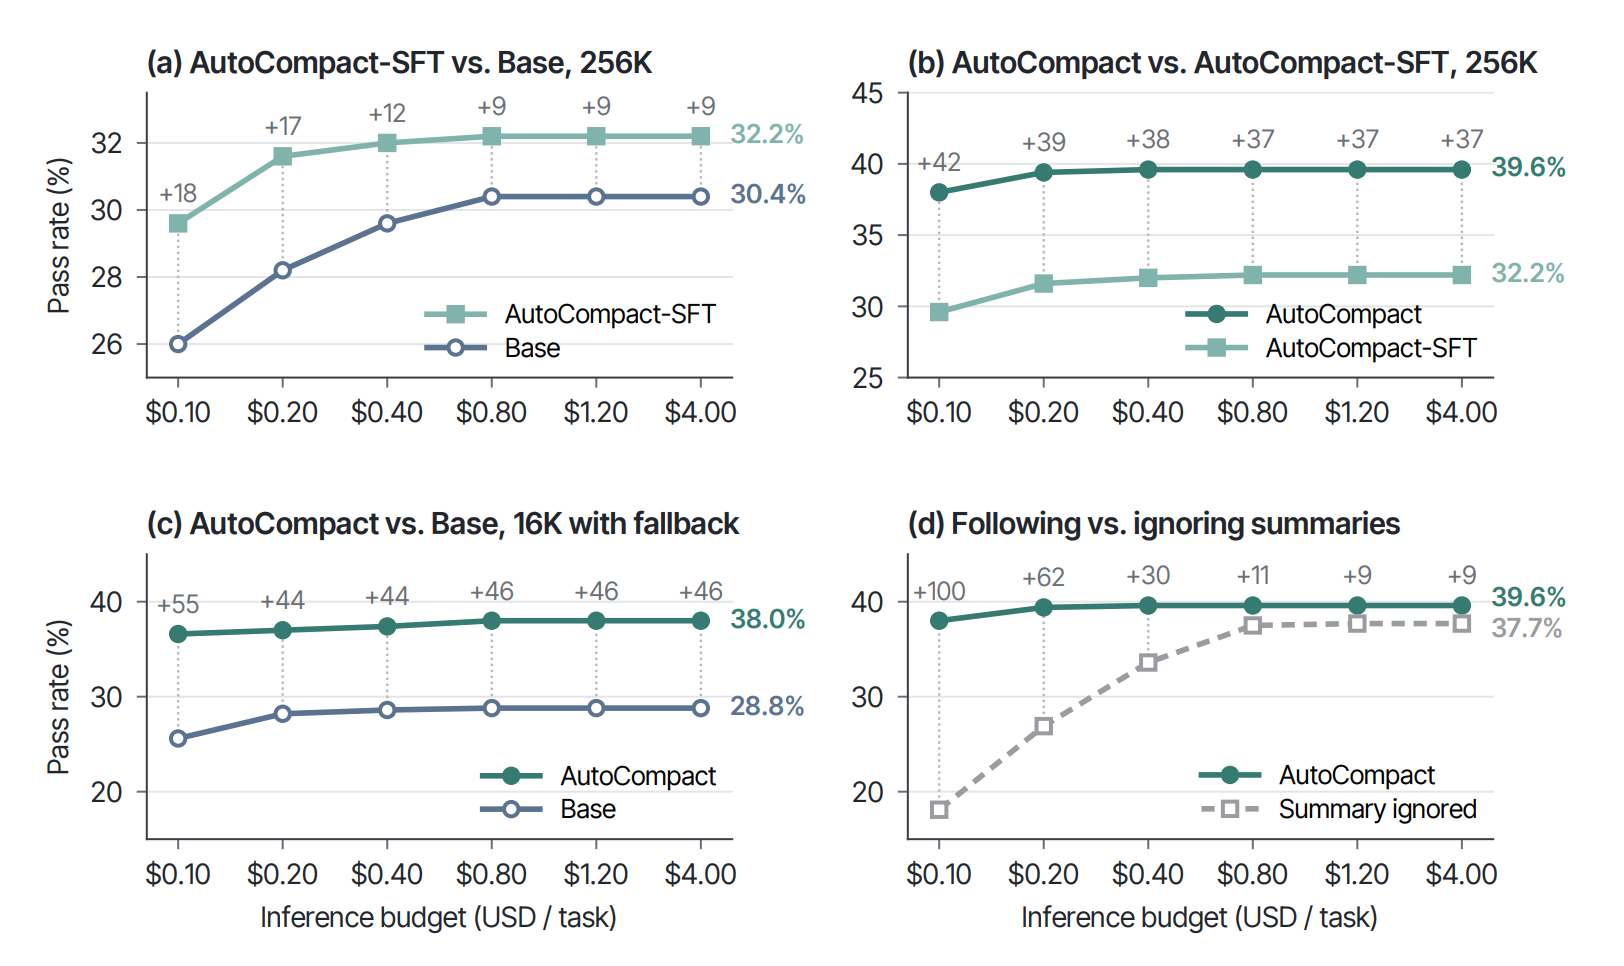
图注:不同推理预算下,AutoCompact 的任务通过率对比及主动压缩机制的消融实验结果。
作者还进行了一组消融实验,用来区分模型训练和实际执行压缩带来的收益。实验使用同一个训练后的模型,一组正常执行 compact(),另一组则忽略模型发出的压缩调用,保留原有交互历史。两组模型参数完全相同,区别在于是否真正执行 Context 压缩。
结果显示,执行压缩的模型表现更好。在每任务 0.10 美元的预算下,两组通过率相差 19.9 个百分点;当预算提高至 4.00 美元时,差距缩小至 1.9 个百分点。
这组实验进一步说明,AutoCompact 的性能提升既来自训练对模型执行行为的改善,也来自 Context 压缩本身的作用。尤其在推理预算有限时,及时清理不再需要的历史信息,有助于减少上下文负担,让 Agent 将更多资源用于当前任务。
压缩质量与后续动作
除了任务通过率,论文还分析了模型压缩行为本身的变化。
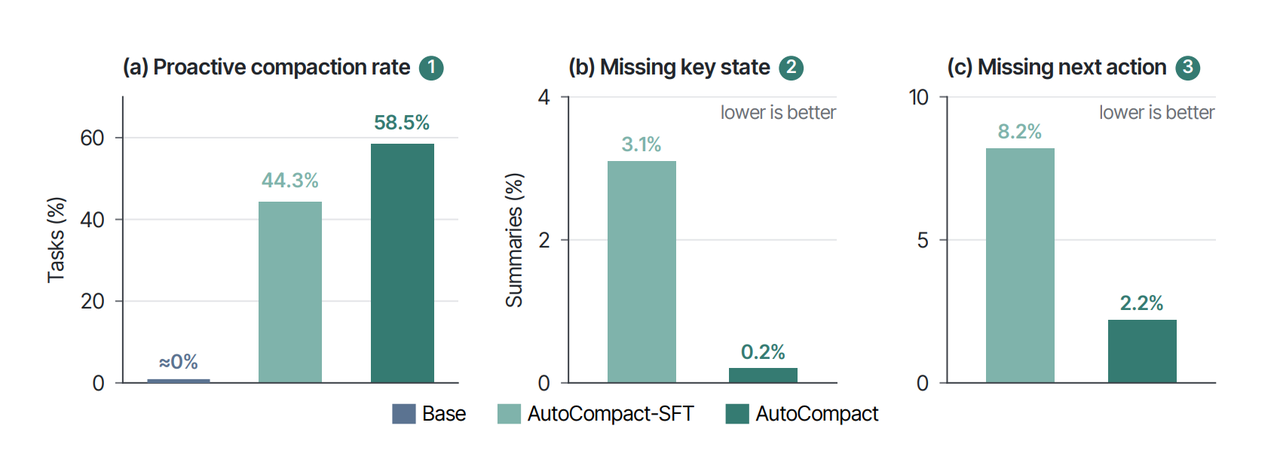
图注:三组压缩行为统计图,分别对应主动压缩率、关键状态遗漏率和下一步动作遗漏率。
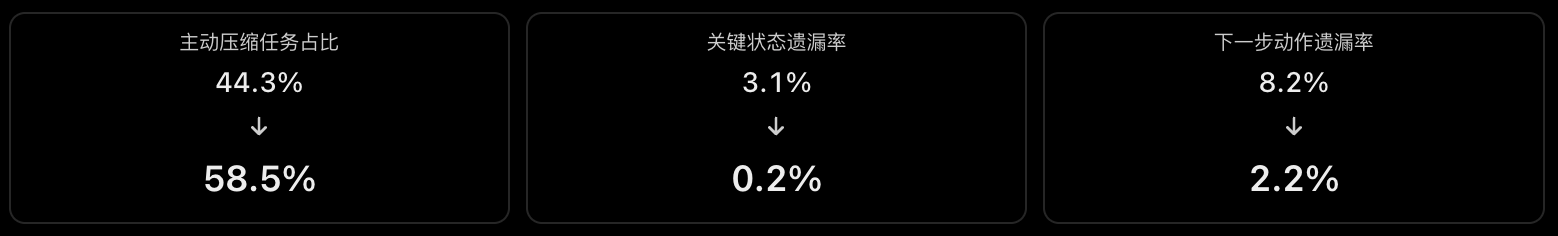
经过监督微调(SFT),模型在 44.3% 的任务中主动调用压缩;经过强化学习(RL)训练后,这一比例提高至 58.5%。与此同时,摘要中的关键状态遗漏率从 3.1% 降至 0.2%,下一步动作遗漏率从 8.2% 降至 2.2%。
这些结果表明,经过 RL 训练,Agent 在更多任务中主动压缩 Context,生成的摘要也能保留更完整的任务信息。不过,上述遗漏率主要通过关键词筛查和随机人工抽查进行评估,能够反映信息是否被保留,却难以完整衡量摘要中的任务状态与后续动作是否一致。
为进一步分析这一问题,论文展示了 SWE-bench Verified 中 django-13809 任务的执行案例。
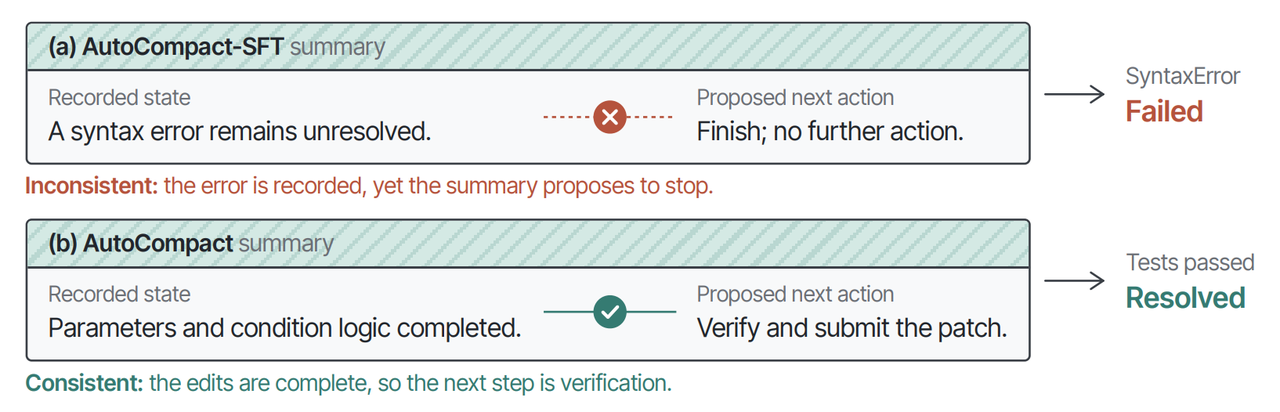
图注:SFT 与 RL 训练后,Agent 生成的工作状态摘要、后续动作及任务结果对比。
在这个任务中,AutoCompact-SFT 生成的摘要虽然记录了一个尚未解决的语法错误,却同时建议结束任务,不再执行后续操作。由于下一步动作与摘要记录的状态存在冲突,最终任务因 SyntaxError 而失败。
相比之下,经过 RL 训练的 AutoCompact 在摘要中记录了参数和条件逻辑的修改情况,并将验证补丁作为后续操作。Agent 随后完成验证,通过测试并完成任务。
这一案例说明,Context 压缩除了需要保留完整的任务信息,还需要确保后续动作与摘要记录的工作状态保持一致。对于 Coding Agent,如果摘要中仍有尚未解决的错误,后续就需要继续修复或验证;只有完成必要的修改和检查后,才能结束任务。
小结
AutoCompact 将 Context 压缩纳入 Agent 的执行决策,让模型根据任务进度主动整理历史。例如,完成问题定位、结束一轮测试或切换到下一项任务时,都可以考虑压缩 Context,保留后续执行所需的工作状态。
论文也表明,主动压缩需要兼顾三个方面:压缩时机、摘要信息的完整性,以及后续执行的连续性。 如果摘要遗漏了重要信息,或者后续动作与摘要记录的状态不一致,即使减少了 Context 占用,也可能影响任务完成。
不过,AutoCompact 的实验仍有一定局限。研究主要基于 Qwen3-Coder-30B-A3B-Instruct 和单一 Agent 框架,RL 训练轨迹限制为 32K tokens,而主要评估窗口为 256K。对于其他模型、更长时间的任务以及多 Agent 协作场景,仍需进一步验证。
从现有结果看,即使 Context 空间充足,Coding Agent 也可能从主动压缩中获益。如何在合适的时机整理工作状态,并确保任务连续执行,是这项研究提供的主要参考。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号