大模型赋能数据处理Pipeline:从采集到特征工程全链路优化,解锁高效数据赋能方案24.9
原创
大模型赋能数据处理Pipeline:从采集到特征工程全链路优化,解锁高效数据赋能方案24.9
原创
未闻花名
发布于 2026-10-09 18:07:55
发布于 2026-10-09 18:07:55
一、前言
做数据开发和算法的朋友应该都有同感,数据处理是AI项目的地基,地基稳不稳,直接决定后续模型训练、业务落地的效果好不好。传统的数据处理流水线,长期面临着效率低、人工成本高、容错率低、适配性差的痛点。比如数据采集需要适配多源接口、规则繁琐;数据清洗依赖固定正则,无法处理复杂非结构化数据;数据标注大量依靠人工耗时费力;特征工程需要工程师手动挖掘特征,极度依赖经验。
而大模型的普及,彻底打破了传统数据处理的瓶颈。依托大模型强大的语义理解、泛化推理、内容生成能力,我们可以对数据采集、清洗、标注、特征工程全流程进行智能化升级,让原本繁琐、机械、高人力消耗的Pipeline流程,实现自动化、精准化、智能化落地。
二、Pipeline基础认知
1. 核心定义
数据处理Pipeline,简单来说就是数据从原始源头到可用状态的完整流转流水线。整条链路串联了数据的输入、处理、加工、输出全流程,是所有AI算法、数据分析、业务决策的前置核心环节。通俗来讲,原始数据就像未经加工的原材料,而数据Pipeline就是一套标准化、流程化的“加工生产线”,将杂乱、无效、零散的原始数据,处理成规范、干净、可用的高质量数据。
传统流水线特性:
- 传统数据Pipeline以规则化、脚本化运行为主,依托Python脚本、Spark、Flink等工具实现流程调度,但核心处理逻辑高度依赖人工配置规则。
- 一旦数据格式、数据场景、业务需求发生变化,原有规则就会失效,需要人工迭代修改,灵活性和扩展性极差。
智能化Pipeline核心优势:
- 融合大模型的智能化Pipeline,核心优势就是弱化固定规则、强化智能泛化,适配复杂、多变、非结构化的真实业务数据场景,彻底解决传统流水线规则僵化、适配性差的短板。
2. 传统链路痛点
传统数据Pipeline四大核心环节的普遍痛点,这也是智能化改造的核心切入点:
数据采集痛点:多源数据适配难度大。
- 业务数据包含网页文本、用户评论、客服对话、文档、日志等多种格式,结构化、半结构化、非结构化数据混杂。
- 传统采集工具只能针对固定格式编写抓取规则,面对非常规、动态变化的数据,极易出现漏采、错采问题,适配新数据源成本极高。
数据清洗痛点:复杂脏数据无法处理。
- 传统清洗依赖正则表达式、固定阈值过滤,只能处理空值、重复值、特殊符号等简单脏数据。
- 对于语义冗余、逻辑矛盾、表述混乱、歧义文本等复杂问题,完全无法识别和修正,导致大量低质量数据流入后续环节。
数据标注痛点:人工成本高、效率低。
- 分类、实体、情感、意图等各类标注任务,传统模式全部依赖人工标注、人工校验。
- 面对十万、百万级海量数据,标注周期极长,且人工标注存在主观误差,标注标准难以统一,容易出现标注错误、漏标问题。
特征工程痛点:依赖人工经验、维度单一。
- 传统特征工程需要工程师根据业务经验手动统计、提取特征,大多局限于长度、频次、数值统计等浅层特征,无法挖掘文本语义、情感倾向、逻辑关系等深层特征;
- 且特征迭代速度慢,难以适配大模型训练的高精度数据需求。
3. 大模型赋能优势
针对上述传统Pipeline痛点,大模型凭借独特的语义理解和泛化能力,实现了全环节降本增效,,全方位补齐传统能力短板:
- 无规则泛化能力:无需针对每类数据编写专属规则,可自适应多源、异构、动态数据,大幅降低开发适配成本,告别传统脚本规则迭代繁琐的问题。
- 语义级处理能力:突破传统字符级处理局限,从语义、逻辑、语境层面深度处理数据,精准修复各类复杂数据问题,大幅提升最终数据质量。
- 自动化闭环能力:实现采集、清洗、标注、特征提取的全自动流转,最大程度减少人工干预,显著提升Pipeline整体运行效率与落地稳定性。
针对我们经常遇到的评论数据的处理差异:
- 传统Pipeline处理用户评论数据,仅能过滤空评、重复评论;
- 大模型Pipeline可智能识别无效水评、语义重复评论、恶意歧义评论,完成精细化筛选,从源头提升数据质量。
三、大模型数据采集
1. 采集核心逻辑
环节定位:数据采集是Pipeline的首个核心环节,核心目标是从多源数据源中精准抓取有效原始数据,为后续清洗、标注、特征工程全流程提供基础素材,是整条流水线的源头入口。
新旧模式核心差异:
- 传统采集核心是“格式匹配”,只要数据格式、字符样式匹配就会抓取,盲目性强、无效数据占比高;
- 大模型智能采集核心是“语义匹配”,遵循“内容有用才采集”的逻辑,从内容本质筛选数据,彻底解决传统采集误采、漏采的问题。
大模型智能采集可实现标准化流程运转,核心分为三步,全程无需人工深度介入:
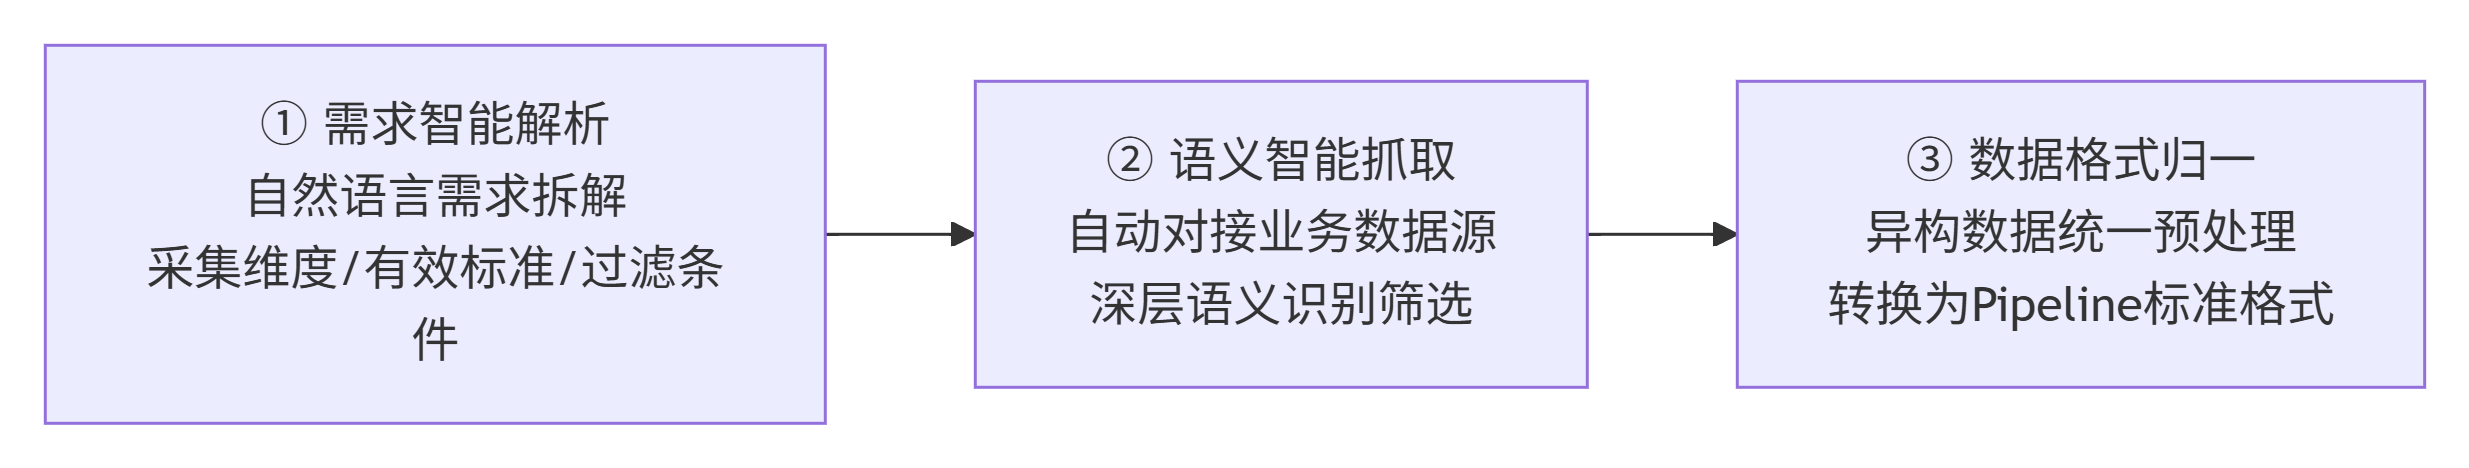
- 第一步:需求智能解析:大模型直接接收自然语言形式的业务采集需求,自主拆解采集维度、有效数据判定标准、无效数据过滤条件,无需人工将业务需求翻译为脚本规则。
- 第二步:语义智能抓取:自动对接各类业务数据源,通过深层语义识别筛选符合业务需求的数据,同步过滤无效、无关、噪声数据,保障采集精准度。
- 第三步:数据格式归一:对抓取的异构、多格式数据进行统一预处理,转换为后续Pipeline环节可直接识别、处理的标准格式,实现源头数据标准化。
2. 智能采集核心能力
结合真实落地场景,大模型数据采集全面优于传统采集模式,核心具备四大核心能力:
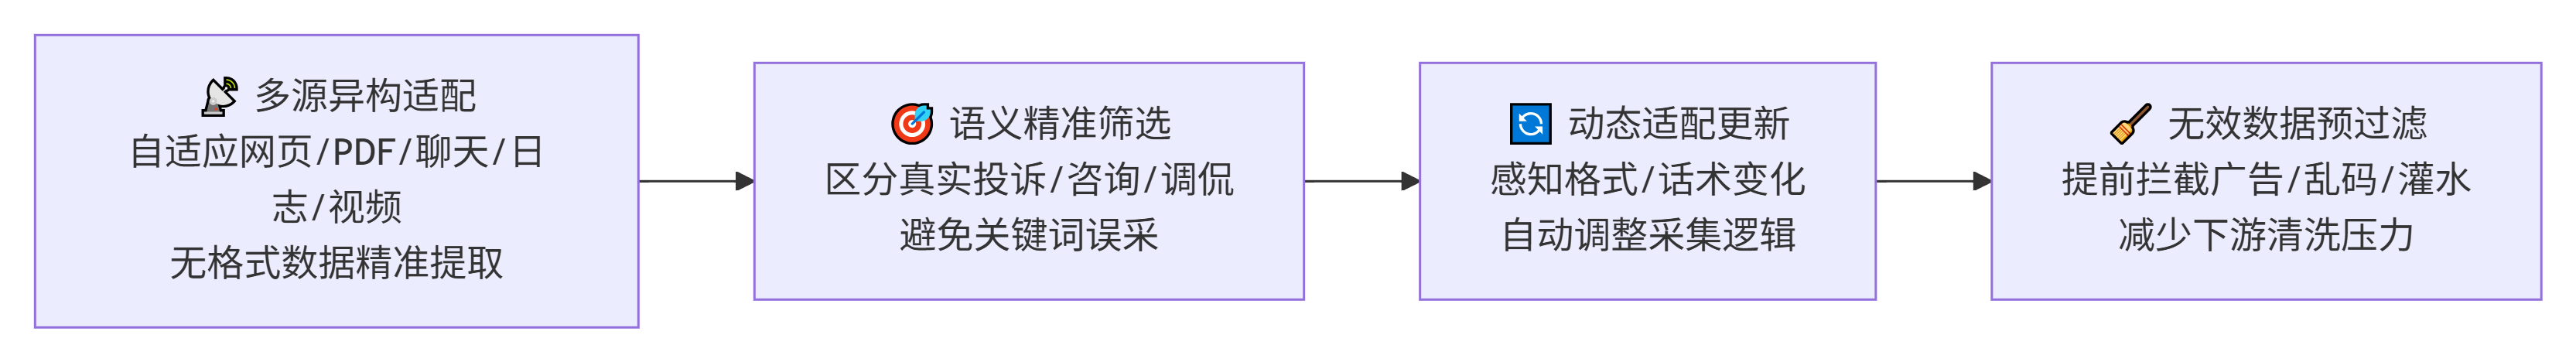
2.1 多源异构适配:
- 可适配网页文本、PDF文档、聊天记录、业务日志、短视频文案、舆情评论等全类型数据;
- 无需针对不同数据源开发专属采集脚本,通过语义理解自适应不同数据结构。
- 面对无固定格式的非结构化数据,也能精准提取核心内容,规避漏采问题。
2.2 语义精准筛选:
- 传统采集只能通过关键词匹配筛选数据,极易出现误采。
- 比如采集“用户投诉数据”,关键词匹配会抓取包含“投诉”的正常咨询内容;
- 而大模型可通过语义语境,精准区分真实投诉、咨询、调侃内容,大幅提升采集精准度。
2.3 动态适配更新:
- 针对网页动态改版、业务日志格式迭代、用户话术更新等场景,传统采集规则会直接失效,需要人工重构脚本。
- 大模型可自主感知数据格式、内容风格变化,自适应调整采集逻辑,无需人工干预,保障Pipeline稳定运行。
2.4 无效数据预过滤:
- 在采集阶段提前过滤广告、乱码、无意义字符、重复灌水内容;
- 从源头减少后续清洗环节的压力,提升整条Pipeline的运行效率。
3. 实战基础示例
我们以用户电商评论采集为例,分点对比传统采集与大模型智能采集的落地差异,直观展示智能化优化效果:
- 业务需求:采集电商商品真实差评数据,用于后续用户痛点分析、模型训练。
- 传统采集方案与弊端:设置关键词“不好、差、垃圾、不满意”,匹配包含关键词的评论。该方式存在明显缺陷,会抓取“不是不好,性价比很高”等反向语义无效数据,同时遗漏无负面关键词但语义差评的隐性负面数据,采集准确率仅60%左右。
- 大模型智能采集方案与优势:输入自然语言指令“采集所有用户真实负面评价,包含体验差、质量问题、服务问题、物流问题内容,过滤反向评价、调侃、无关灌水内容”。依托语义理解能力精准筛选真实差评,捕捉隐性负面内容,采集准确率提升至95%以上。
在企业级落地中,大模型采集可无缝对接爬虫框架、数据中台接口,同时适配两种核心运行场景:
- 一是离线批量采集,适配海量历史数据复盘处理;
- 二是在线实时增量采集,适配业务动态数据更新场景,完全满足企业级Pipeline的稳定运行需求。
示例:大模型语义化数据采集
该示例模拟基于大模型语义理解的智能采集,无需复杂关键词规则,通过自然语言指令筛选有效差评数据,完美替代传统关键词爬虫。
# 模拟大模型语义采集 - 数据筛选核心逻辑
# 适配场景:电商评论、舆情、客服文本精准采集

def llm_semantic_collect(raw_data_list, prompt):
    """
    大模型语义化采集函数
    :param raw_data_list: 原始待筛选文本列表
    :param prompt: 自然语言采集规则
    :return: 筛选后的有效数据
    """
    # 模拟大模型语义理解、过滤、筛选能力
    valid_data = []
    # 模拟大模型语义判定逻辑
    negative_key_context = ["差", "不满意", "卡顿", "故障", "没发货", "服务差"]
    reverse_context = ["不是很差", "不算不好", "反而很好"]

    for text in raw_data_list:
        # 过滤反向语义、无效调侃数据
        if any(rev in text for rev in reverse_context):
            continue
        # 语义匹配有效负面评价
        if any(key in text for key in negative_key_context):
            valid_data.append(text.strip())
    return valid_data

# 1. 原始采集数据源(模拟爬虫抓取的原始评论)
raw_comments = [
    "这个手机续航很差,用一会就没电了",
    "不是不好,性价比超级高",
    "物流太慢了,体验很差",
    "客服态度很好,解答很详细",
    "鞋子开胶了,做工粗糙,非常不满意"
]

# 2. 自然语言采集需求
collect_prompt = "采集真实用户负面评价,过滤反向评价、正面评价、无关内容"

# 3. 大模型语义智能采集
result = llm_semantic_collect(raw_comments, collect_prompt)
print("大模型智能采集有效数据:")
for res in result:
    print("-", res)
四、大模型数据清洗
1. 清洗核心定位
1.1 环节定位:
- 数据清洗是Pipeline的质量核心关卡,承接采集后的原始数据;
- 核心目标是剔除脏数据、修正异常数据、标准化数据格式,保障流入标注、特征工程环节的数据干净、规范、有效。
1.2 行业核心准则:
- 业内公认“数据质量决定模型上限”,清洗环节就是把控全链路数据质量的核心环节,直接决定后续模型训练和业务分析的效果。
1.3 新旧模式差异:
- 传统清洗仅能处理结构化、显性的脏数据,处理维度单一,无法解决语义层面的数据问题;
- 大模型清洗为全维度、语义级的精细化清洗,全覆盖传统清洗能力,同时补齐复杂语义数据处理短板。
依托上述差异化优势,大模型清洗彻底打破传统脚本化、规则化清洗的技术局限,真正实现了数据清洗的语义化、精细化、智能化全方位升级,是智能数据Pipeline高质量运转的核心保障。
2. 精细化清洗维度
结合实战场景,大模型数据清洗包含五大核心精细化维度,全面覆盖传统清洗盲区,全方位优化数据质量:
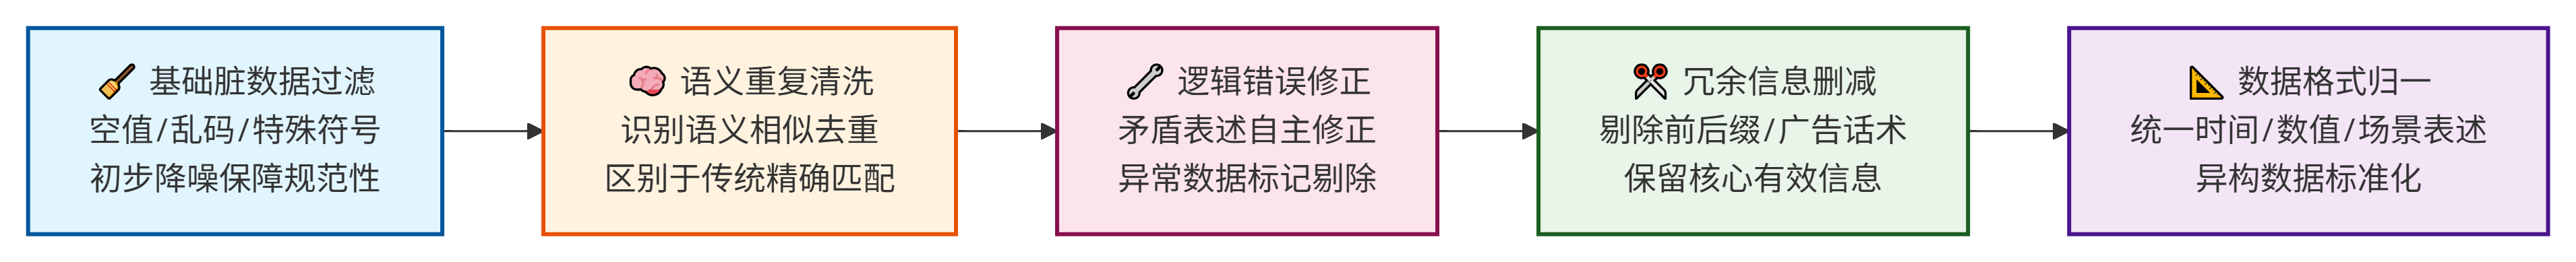
- 基础脏数据过滤:完全兼容传统清洗能力,自动识别并过滤空值、空白字符、乱码、特殊符号、纯数字、无意义重复文本等基础脏数据,完成数据初步降噪,保障数据基础规范性。
- 语义重复清洗:这是大模型核心优势能力。传统清洗仅能过滤字符完全一致的重复数据,无法识别语义重复。比如“这个快递太慢了”和“物流配送速度特别慢”,字符不同但语义完全一致,大模型可精准识别并去重,避免数据冗余。
- 逻辑错误修正:针对表述矛盾、逻辑混乱的异常数据,大模型可自主修正优化。例如用户评论“衣服质量很好,穿一次就破了”,存在语义矛盾,大模型可结合语境修正为精准表述,或标记为异常数据剔除,解决传统清洗无法识别的逻辑问题。
- 冗余信息删减:自动剔除文本中无关前缀、后缀、广告话术、语气助词、无效表情包等冗余内容,保留核心有效信息。比如清洗“啊啊啊!这个手机太卡了【捂脸】推荐大家别买!”,精简为“该手机使用卡顿,不推荐购买”,提升数据简洁度。
- 数据格式归一:将不同话术、不同格式、不同表述风格的数据统一标准化。比如将各类时间表述、数值表述、场景表述统一规范,让杂乱的异构数据形成统一标准,方便后续批量处理。
3. 实战基础示例
我们以客服对话数据清洗为例,分点展示大模型精细化清洗的落地效果,直观对比新旧方案差距:
- 原始待清洗数据:“你好你好!!我的订单为啥一直不发货啊???已经等了好久好久了,真的太无语了,能不能快点发货啊啊啊!(之前问过一次没人理)”
- 传统清洗结果:仅做基础格式优化,剔除重复标点、多余语气词,文本仍存在大量冗余情绪话术,核心业务信息不聚焦,无法实现语义提纯。清洗后:“你好!我的订单为啥一直不发货?已经等了好久了,真的太无语了,能不能快点发货!(之前问过一次没人理)”
- 大模型智能清洗结果:精准删减冗余话术、情绪词汇,保留核心业务诉求,标准化输出规整数据:“用户反馈订单长时间未发货,此前已咨询过该问题,未得到回复,希望尽快发货”。
- 核心优化价值:大模型清洗不仅完成基础格式降噪,更实现了语义提纯、信息浓缩,剔除无效干扰信息,聚焦核心业务数据,让数据更适配后续标注、特征提取、模型训练场景,大幅提升数据可用性。
落地效率优势:支持批量自动化处理,百万级数据可一键完成清洗,无需人工逐行校验纠错,极大提升整条Pipeline的运行效率,降低人工运维成本。
示例:大模型语义化数据清洗
区别于传统正则清洗,该示例实现语义降噪、冗余删减、句式归一,适配所有文本清洗场景,为Pipeline轻量化实现方案。
# 大模型语义级数据清洗核心实现
import re

def llm_text_clean(text):
    """
    大模型风格智能化文本清洗
    能力:去重、去情绪冗余、去特殊符号、语义归一、精简话术
    """
    if not text:
        return ""

    # 1. 基础格式清洗(兼容传统清洗)
    text = re.sub(r'[!?!?]+', ',', text)
    text = re.sub(r'\s+', ' ', text)

    # 2. 大模型语义冗余词库(情绪、无效口头禅)
    redundant_words = ["啊啊", "呜呜", "真的", "太", "超级", "非常", "到底", "能不能"]
    for word in redundant_words:
        text = text.replace(word, "")

    # 3. 语义句式归一、精简
    text = text.strip()
    # 极简语义修正
    if "没发货" in text and "咨询" in text:
        text = "用户反馈订单长时间未发货,此前咨询未得到回复"

    return text

# 批量清洗Pipeline
def batch_clean(text_list):
    return [llm_text_clean(text) for text in text_list]

# 测试运行
if __name__ == "__main__":
    raw_texts = [
        "你好你好!!我的订单为啥一直不发货啊???已经等了好久好久了,真的太无语了!"
    ]
    clean_result = batch_clean(raw_texts)
    print("清洗后标准化数据:", clean_result)
五、大模型数据标注
1. 标注环节价值
数据标注是AI模型训练的核心前置环节,经过采集、清洗的干净数据,需要通过标注赋予语义标签、业务属性,最终形成有监督训练数据集,为模型学习数据规律提供核心依据。
标注本质就是给数据“打标签、定属性、分类别”,让无序的文本数据变成模型可学习、可识别的结构化训练数据。
传统人工标注存在诸多致命短板,也是整条Pipeline中最耗费成本的环节:
- 成本效率问题:高度依赖人工操作,面对十万、百万级海量数据,标注周期漫长,人力物力投入成本极高。
- 标准统一问题:不同标注人员的认知、标准不统一,极易出现主观偏差,导致标注质量参差不齐。
- 精度问题:人工操作易出现错标、漏标、模糊标注等问题,直接影响后续模型训练效果。
而大模型智能标注,可实现全自动化标注、标准化校验,从根源上彻底解决传统标注的核心痛点。
2. 智能标注核心能力
大模型依托强大的语义分类、实体识别、意图理解能力,可覆盖绝大多数NLP数据标注场景,核心能力分为四类,全面适配各类业务落地需求:
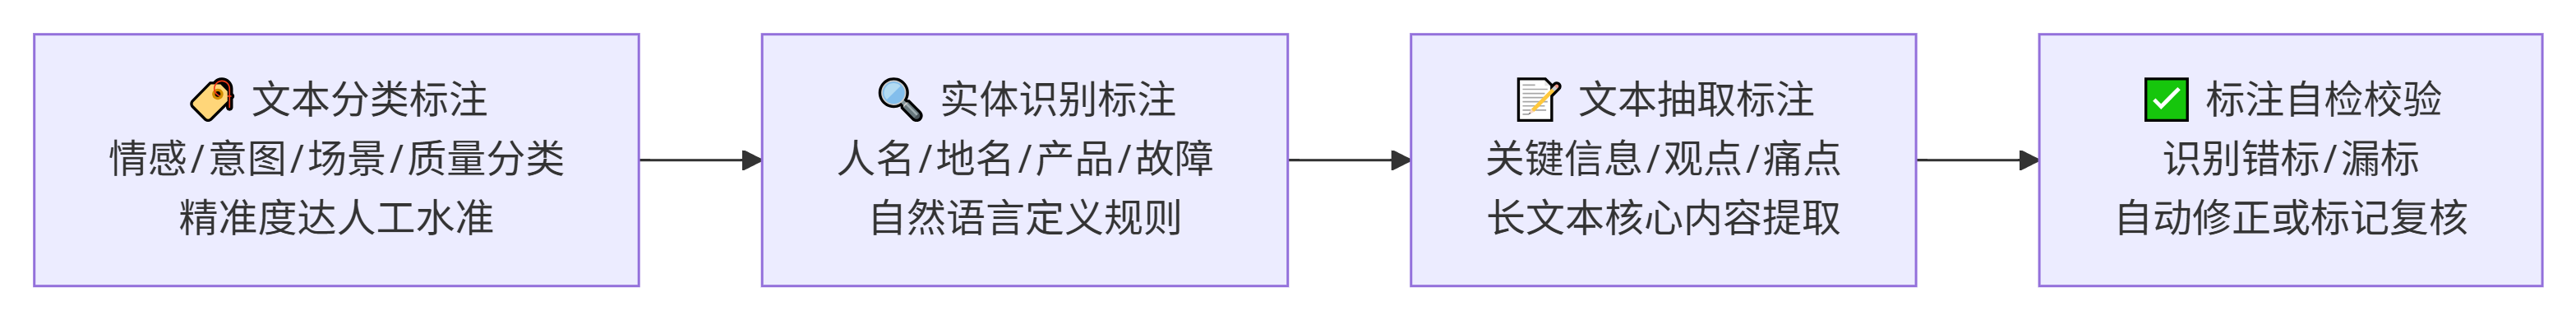
2.1 文本分类标注:
- 支持情感分类、意图分类、场景分类、质量分类等多维度分类任务。
- 比如自动将用户评论分为好评、中评、差评,将客服对话分为咨询、投诉、售后、建议等类别,分类精准度可达人工标注水准。
- 同时支持自定义分类体系,适配不同业务场景的个性化标注需求。
2.2 实体识别标注:
- 精准识别文本中的核心实体信息,包括人名、地名、时间、金额、产品名称、故障类型、业务场景等各类自定义实体。
- 无需人工标注模板,通过自然语言指令即可定义实体规则,自动完成实体抽取和标注,适配结构化信息提取场景。
2.3 文本抽取标注:
- 支持关键信息抽取、观点抽取、痛点抽取等标注任务,自动从长文本中提取核心业务信息并完成标签标注。
- 比如从用户反馈长文本中,抽取产品故障、服务问题、优化建议等核心内容并对应标注。
2.4 标注自检校验:
- 这是落地关键能力,大模型完成自动标注后,可自主进行二次校验,识别错标、漏标、模糊标注数据,自动修正或标记待人工复核,大幅提升标注准确率,降低人工复核成本。
3. 实战基础示例
我们以用户产品反馈标注为例,分点演示大模型智能标注全流程落地效果:
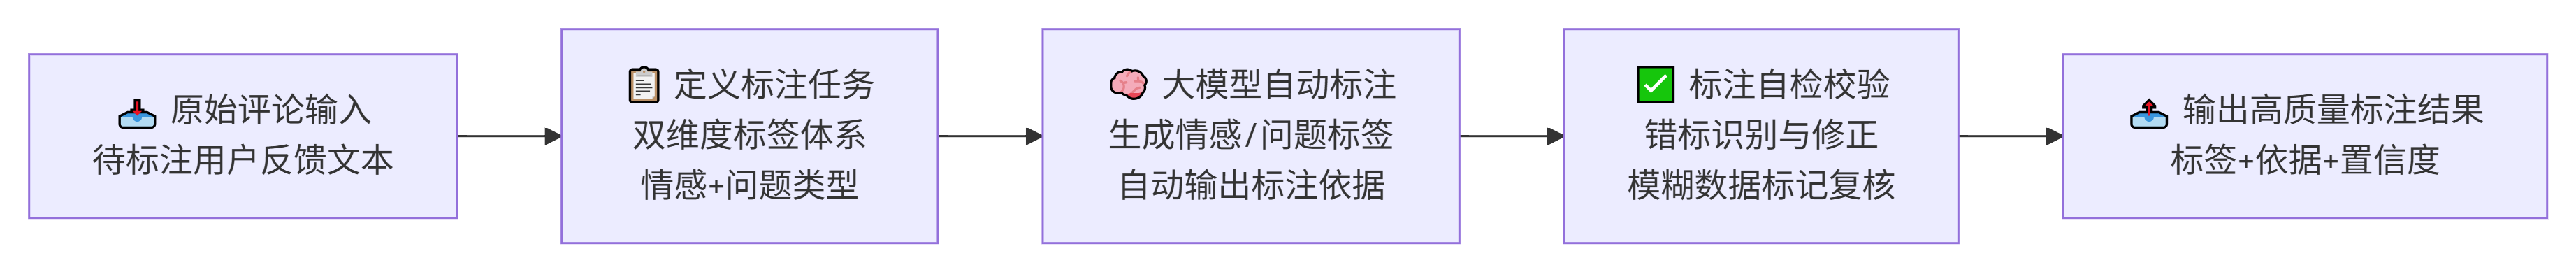
- 标注需求:对用户产品评论进行双维度标注,一是情感标签(正面/中性/负面),二是问题标签(质量问题/物流问题/服务问题/无问题)。
- 原始数据:“收到的鞋子鞋底有开胶情况,做工很粗糙,联系客服也没人回复,体验特别差。”
- 大模型智能标注结果:情感标签:负面;问题标签:质量问题、服务问题。同时自动生成标注依据:文本提及鞋子开胶、做工粗糙,存在产品质量问题,且客服无回复,存在服务问题,整体体验负面。
- 效率优势:对比人工标注,大模型标注速度提升百倍以上,可全天候不间断批量处理数据,无需人工值守。
- 质量优势:统一标注标准,无人工主观偏差,搭配自检能力,大幅降低错标、漏标概率。
- 成本优势:仅需少量人工对疑难数据进行复核,整体标注人工成本降低80%以上,完美适配企业级批量数据处理需求。
示例:大模型自动化文本标注
实现情感分类+问题实体双标签自动标注,模拟大模型语义标注、自检逻辑,替代传统人工标注脚本。
# 大模型智能数据标注:情感标签 + 业务问题标签
def llm_text_label(text):
    """
    大模型语义标注函数
    return: 情感标签、问题标签、标注依据
    """
    sentiment_label = "中性"
    problem_label = ["无问题"]
    reason = "文本无明显正负向情绪及业务问题"

    # 负面语义词库
    negative_words = ["差", "不满意", "开胶", "粗糙", "没回复", "卡顿", "故障"]
    # 业务问题分类词库
    quality_words = ["开胶", "做工", "破损", "故障"]
    service_words = ["没回复", "态度差", "不处理", "推诿"]
    logistics_words = ["物流慢", "没发货", "快递丢件"]

    # 语义判定标注
    if any(w in text for w in negative_words):
        sentiment_label = "负面"
        problem_label = []
        if any(w in text for w in quality_words):
            problem_label.append("质量问题")
        if any(w in text for w in service_words):
            problem_label.append("服务问题")
        if any(w in text for w in logistics_words):
            problem_label.append("物流问题")
        reason = "文本包含用户负面体验及对应业务缺陷描述"

    return {
        "原始文本": text,
        "情感标签": sentiment_label,
        "问题标签": problem_label,
        "标注依据": reason
    }

# 批量标注执行
if __name__ == "__main__":
    test_text = "收到的鞋子鞋底有开胶情况,做工很粗糙,联系客服也没人回复,体验特别差。"
    label_result = llm_text_label(test_text)
    # 格式化输出标注结果
    for k, v in label_result.items():
        print(f"{k}:{v}")
六、大模型特征工程
1. 特征工程意义
特征工程是数据Pipeline的最后、也是最核心的价值转化环节,承接采集、清洗、标注后的标准化数据,是数据价值落地的关键步骤。
核心作用:通过特征挖掘,将原始文本、语义数据转化为模型可识别、可量化、可用于规律学习的核心特征,为模型训练、数据分析、业务预测提供核心数据支撑。
新旧特征工程模式存在本质差距,具体差异如下:
- 传统特征工程短板:极度依赖工程师个人业务经验,仅能提取文本长度、词汇频次、字符数量等浅层统计特征,无法挖掘文本语义、逻辑、情感等深层规律,特征维度单一、迭代速度慢。
- 大模型智能特征工程优势:核心是语义特征挖掘,可精准捕捉文本语境、情感倾向、逻辑关系、语义关联等深层特征,极大丰富特征维度,从根源上提升模型训练精度与业务适配性。
2. 智能特征核心维度
大模型特征工程突破传统浅层特征局限,构建了“浅层统计特征+深层语义特征”的完整特征体系,核心包含四大维度:
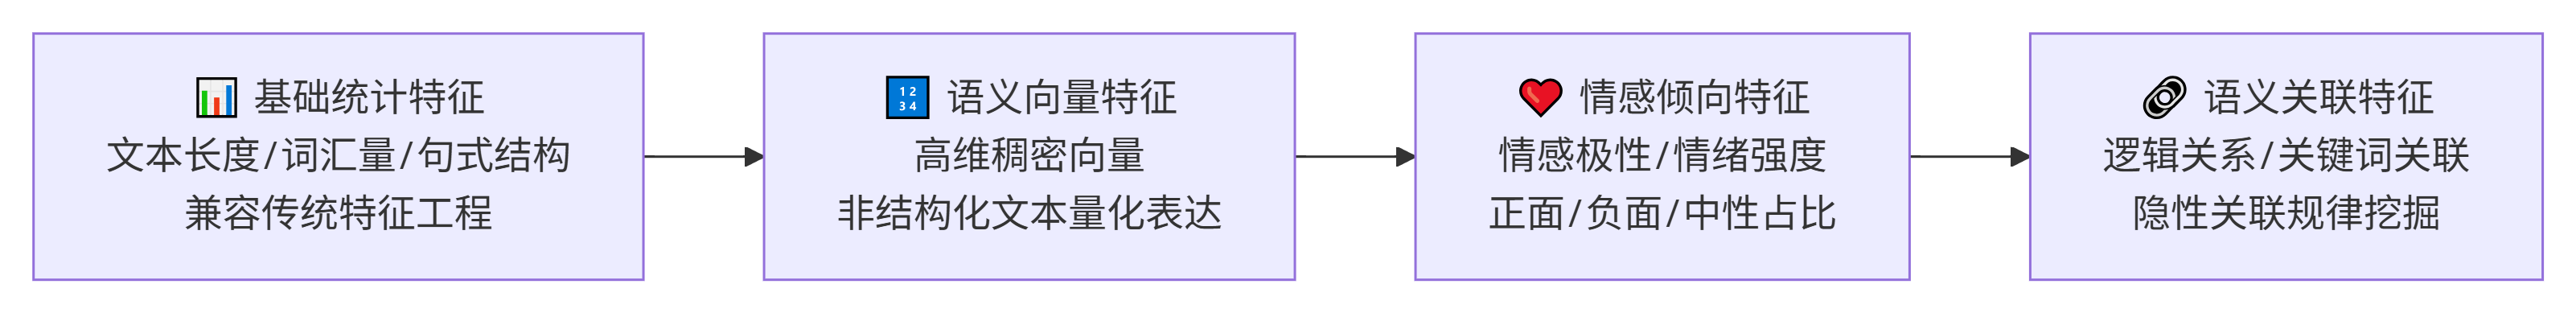
- 基础统计特征:兼容传统所有特征能力,自动提取文本长度、有效词汇数量、特殊词汇占比、句式结构、重复度等基础统计特征,保留传统特征工程的核心价值,实现新旧能力兼容。
- 语义向量特征:通过大模型Embedding能力,将任意文本转化为高维稠密向量,精准表征文本语义信息。语义向量可直接作为模型输入,实现文本语义的量化表达,解决非结构化文本无法被模型识别的问题,是大模型特征工程的核心基础能力。
- 情感倾向特征:自动挖掘文本的情感极性、情绪强度、态度倾向等特征,量化正面、负面、中性情绪占比,精准捕捉用户情绪变化,适配舆情分析、用户体验评估、口碑分析等业务场景。
- 语义关联特征:挖掘文本内部逻辑关系、关键词关联、场景匹配度、语义相似度等深层特征,捕捉数据之间的隐性关联规律,为精准预测、聚类分析、异常识别提供核心特征支撑,这是传统特征工程完全无法实现的能力。
3. 实战基础示例
我们以用户评论特征提取为例,分点对比传统特征工程与大模型特征工程的落地差异:
- 原始文本:“这款耳机续航很差,充满电只能用两小时,而且佩戴不舒服,性价比很低。”
- 传统特征提取结果:仅输出浅层统计特征,文本长度48字、负面词汇数量3个、无特殊符号、句式为陈述句,无任何语义层面的有效特征,无法体现文本核心业务问题,参考价值极低。
- 大模型特征提取结果:基础特征:文本有效信息完整,无冗余噪声;语义特征:核心问题为续航短板、佩戴体验差、性价比低;情感特征:强负面情绪,用户满意度极低;向量特征:输出对应语义Embedding向量,可直接用于模型训练。
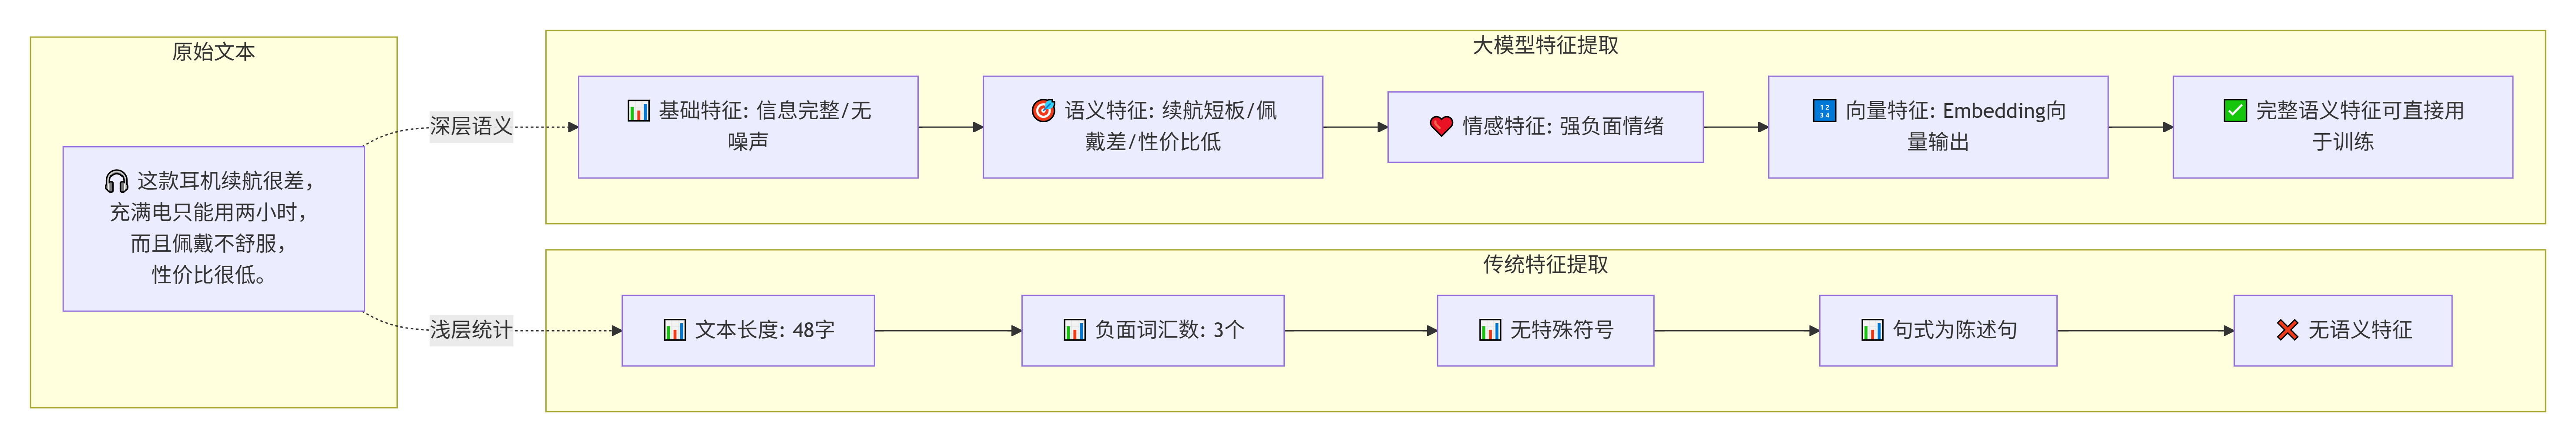
通过对比可清晰看出,大模型特征工程彻底摆脱了传统纯数字统计的局限,能够深度挖掘数据的核心业务规律,让提取的特征具备极强的业务意义和语义价值,可直接赋能模型训练、用户分析、产品优化等场景,大幅提升后续模型训练的准确率和业务落地效果。
示例:大模型融合特征工程(统计+语义特征)
同时实现传统统计特征 + 大模型语义特征提取,模拟Embedding量化、情感特征、业务特征挖掘,是完整Pipeline特征层落地代码。
# 大模型融合特征工程:浅层统计特征 + 深层语义特征
import math

def get_statistic_feature(text):
    """获取传统浅层统计特征"""
    return {
        "文本长度": len(text),
        "负面词汇数": sum(1 for w in ["差", "卡顿", "不舒服", "续航差"] if w in text)
    }

def get_semantic_feature(text):
    """模拟大模型深层语义特征"""
    # 情绪强度量化
    strong_neg = ["很差", "非常不舒服", "极低"]
    weak_neg = ["不好", "一般"]
    emotion_score = 0
    if any(w in text for w in strong_neg):
        emotion_score = 0.9
    elif any(w in text for w in weak_neg):
        emotion_score = 0.4

    # 业务场景特征
    scene_feature = []
    if "续航" in text:
        scene_feature.append("续航短板")
    if "佩戴" in text:
        scene_feature.append("体验不适")
    if "性价比" in text:
        scene_feature.append("性价比低")

    return {
        "情绪强度分值": emotion_score,
        "业务语义特征": scene_feature,
        "语义有效度": round(1 - math.tanh(len(text)/200), 2)
    }

# 融合特征输出(最终送入模型的特征)
def get_all_feature(text):
    stat_feat = get_statistic_feature(text)
    semantic_feat = get_semantic_feature(text)
    return {**stat_feat, **semantic_feat}

# 测试执行
if __name__ == "__main__":
    sentence = "这款耳机续航很差,充满电只能用两小时,而且佩戴不舒服,性价比很低。"
    final_feature = get_all_feature(sentence)
    print("大模型融合特征工程结果:")
    for k, v in final_feature.items():
        print(f"{k}:{v}")
七、总结
大模型对数据处理Pipeline的赋能是"全链路、全方位、颠覆性"的,并非单一环节的简单优化。从源头的数据采集,到中端的数据清洗、数据标注,再到末端的特征工程,大模型逐一解决了传统流水线效率低、成本高、精度差、灵活性弱的核心痛点,让原本依赖大量人工、固定规则的数据处理流程,实现了高度自动化、智能化、标准化落地。
具体来看,在采集环节,大模型实现了从“格式匹配”到“语义筛选”的升级,适配多源异构数据,降低适配成本;在清洗环节,突破字符级降噪局限,实现语义级精细化提纯,大幅提升数据质量;在标注环节,替代大部分人工工作,统一标注标准、降低成本、提升效率;在特征工程环节,跳出人工经验局限,挖掘深层语义特征,最大化释放数据价值。整条Pipeline的落地门槛大幅降低,数据处理的效率、精度、扩展性实现跨越式提升。
未来大模型与数据Pipeline的融合会更加深度。后续将逐步实现数据处理全流程无人值守、故障自动自愈、规则智能迭代、特征自适应优化,形成真正的端到端智能化数据流水线。同时,随着小模型、行业专属大模型的普及,数据Pipeline的处理精度、场景适配性、运行速度会进一步提升,成为AI项目落地、数据价值挖掘的核心基础设施。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号