大模型高效协同开发核心方法:SDD规范驱动开发,打通需求、编码、测试全链路闭环25.2
原创
大模型高效协同开发核心方法:SDD规范驱动开发,打通需求、编码、测试全链路闭环25.2
原创
未闻花名
发布于 2026-10-12 19:49:47
发布于 2026-10-12 19:49:47
一、前言
当下使用大模型辅助编程已经成了我们开发者很常见的一种现象,但不知道大家有没有遇到这种情况:编码效率看似翻倍,项目落地质量却断崖式下跌。随便输入一句需求描述,大模型就能秒出完整代码,基础功能一键跑通,体验极其流畅。可一旦进入真实生产场景,各种隐藏问题就会集中爆发:正常流程没问题,边界场景直接报错;迭代更新功能时,AI无意识篡改原有核心逻辑;代码缺少异常处理、参数校验,漏洞层出不穷;更头疼的是,多轮对话后大模型丢失上下文,相同需求每次生成的代码风格、逻辑都不统一。
这种无规范、纯prompt驱动的AI编码模式,原来就是所谓的“体感式编程”。这种模式的核心弊端,是把软件开发的核心逻辑判断完全交给概率模型,人类只负责接收代码、简单调试,彻底颠倒了开发的核心主次。编程的本质从来不是敲代码,而是定义规则、约束行为、明确边界,代码只是规则的落地载体。大模型擅长机械编码、批量生成测试用例、优化代码格式,但完全不具备主动梳理业务规则、界定功能边界、规避业务漏洞的能力。
正是为了解决大模型编程的随机性、不可控性、难维护性,规范驱动开发SDD(Spec-Driven Development)正式成为AI编程领域的主流新标准。不同于传统软件工程的软件设计文档,新一代SDD是专为大模型协同开发量身打造的前置式开发范式。它的核心逻辑极简且高效:人类优先完成所有业务思考,输出无歧义的行为规范与验收契约,再让大模型基于固定规约完成编码、测试、优化工作,让规范成为人与AI协同的唯一事实标准。
二、SDD核心认知
1. 基础核心定义
SDD规范驱动开发,是适配大模型编程场景的前置规约式开发方法论,核心准则为:先定规范,后写代码,规约优先,一切溯源。和传统开发、传统AI随性开发不同,SDD彻底重构了开发流程的优先级,将原本编码阶段暴露的问题,全部前置到规范定义阶段解决,从根源降低AI编码的出错概率。核心特点可分为三点:
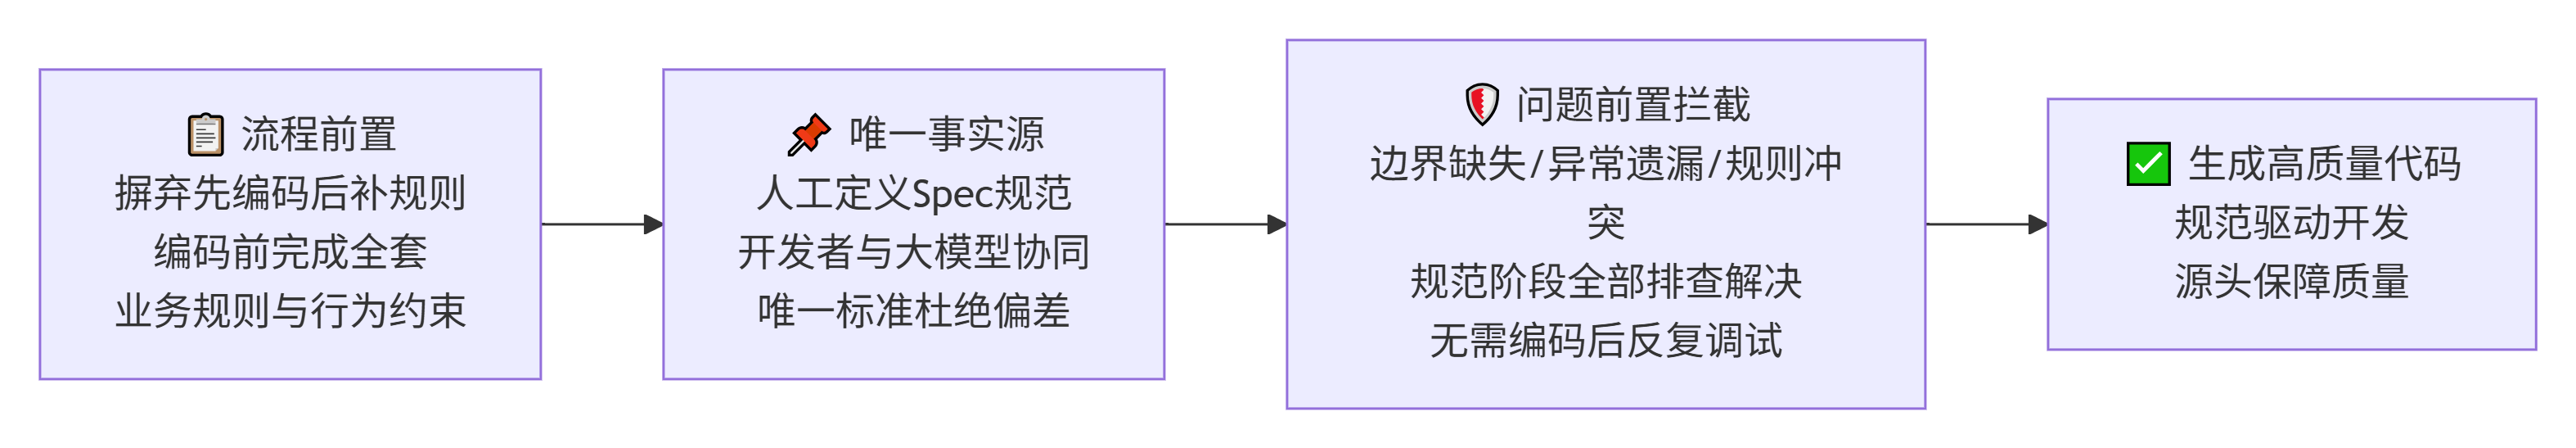
- 流程前置:摒弃“先编码后补规则”的传统模式,在任何代码编写前,完成全套业务规则与行为约束定义。
- 唯一事实源:人工定义的Spec规范,是开发者与大模型协同开发的唯一标准,杜绝理解偏差与随机实现。
- 问题前置拦截:边界缺失、异常遗漏、规则冲突等常见AI编码问题,全部在规范阶段排查解决,无需编码后反复调试修复。
针对 “规范先行、源头拦截” 的开发理念,参考以下时序图,清晰展示规则定义在前、协同开发在后、验证闭环的协作逻辑:
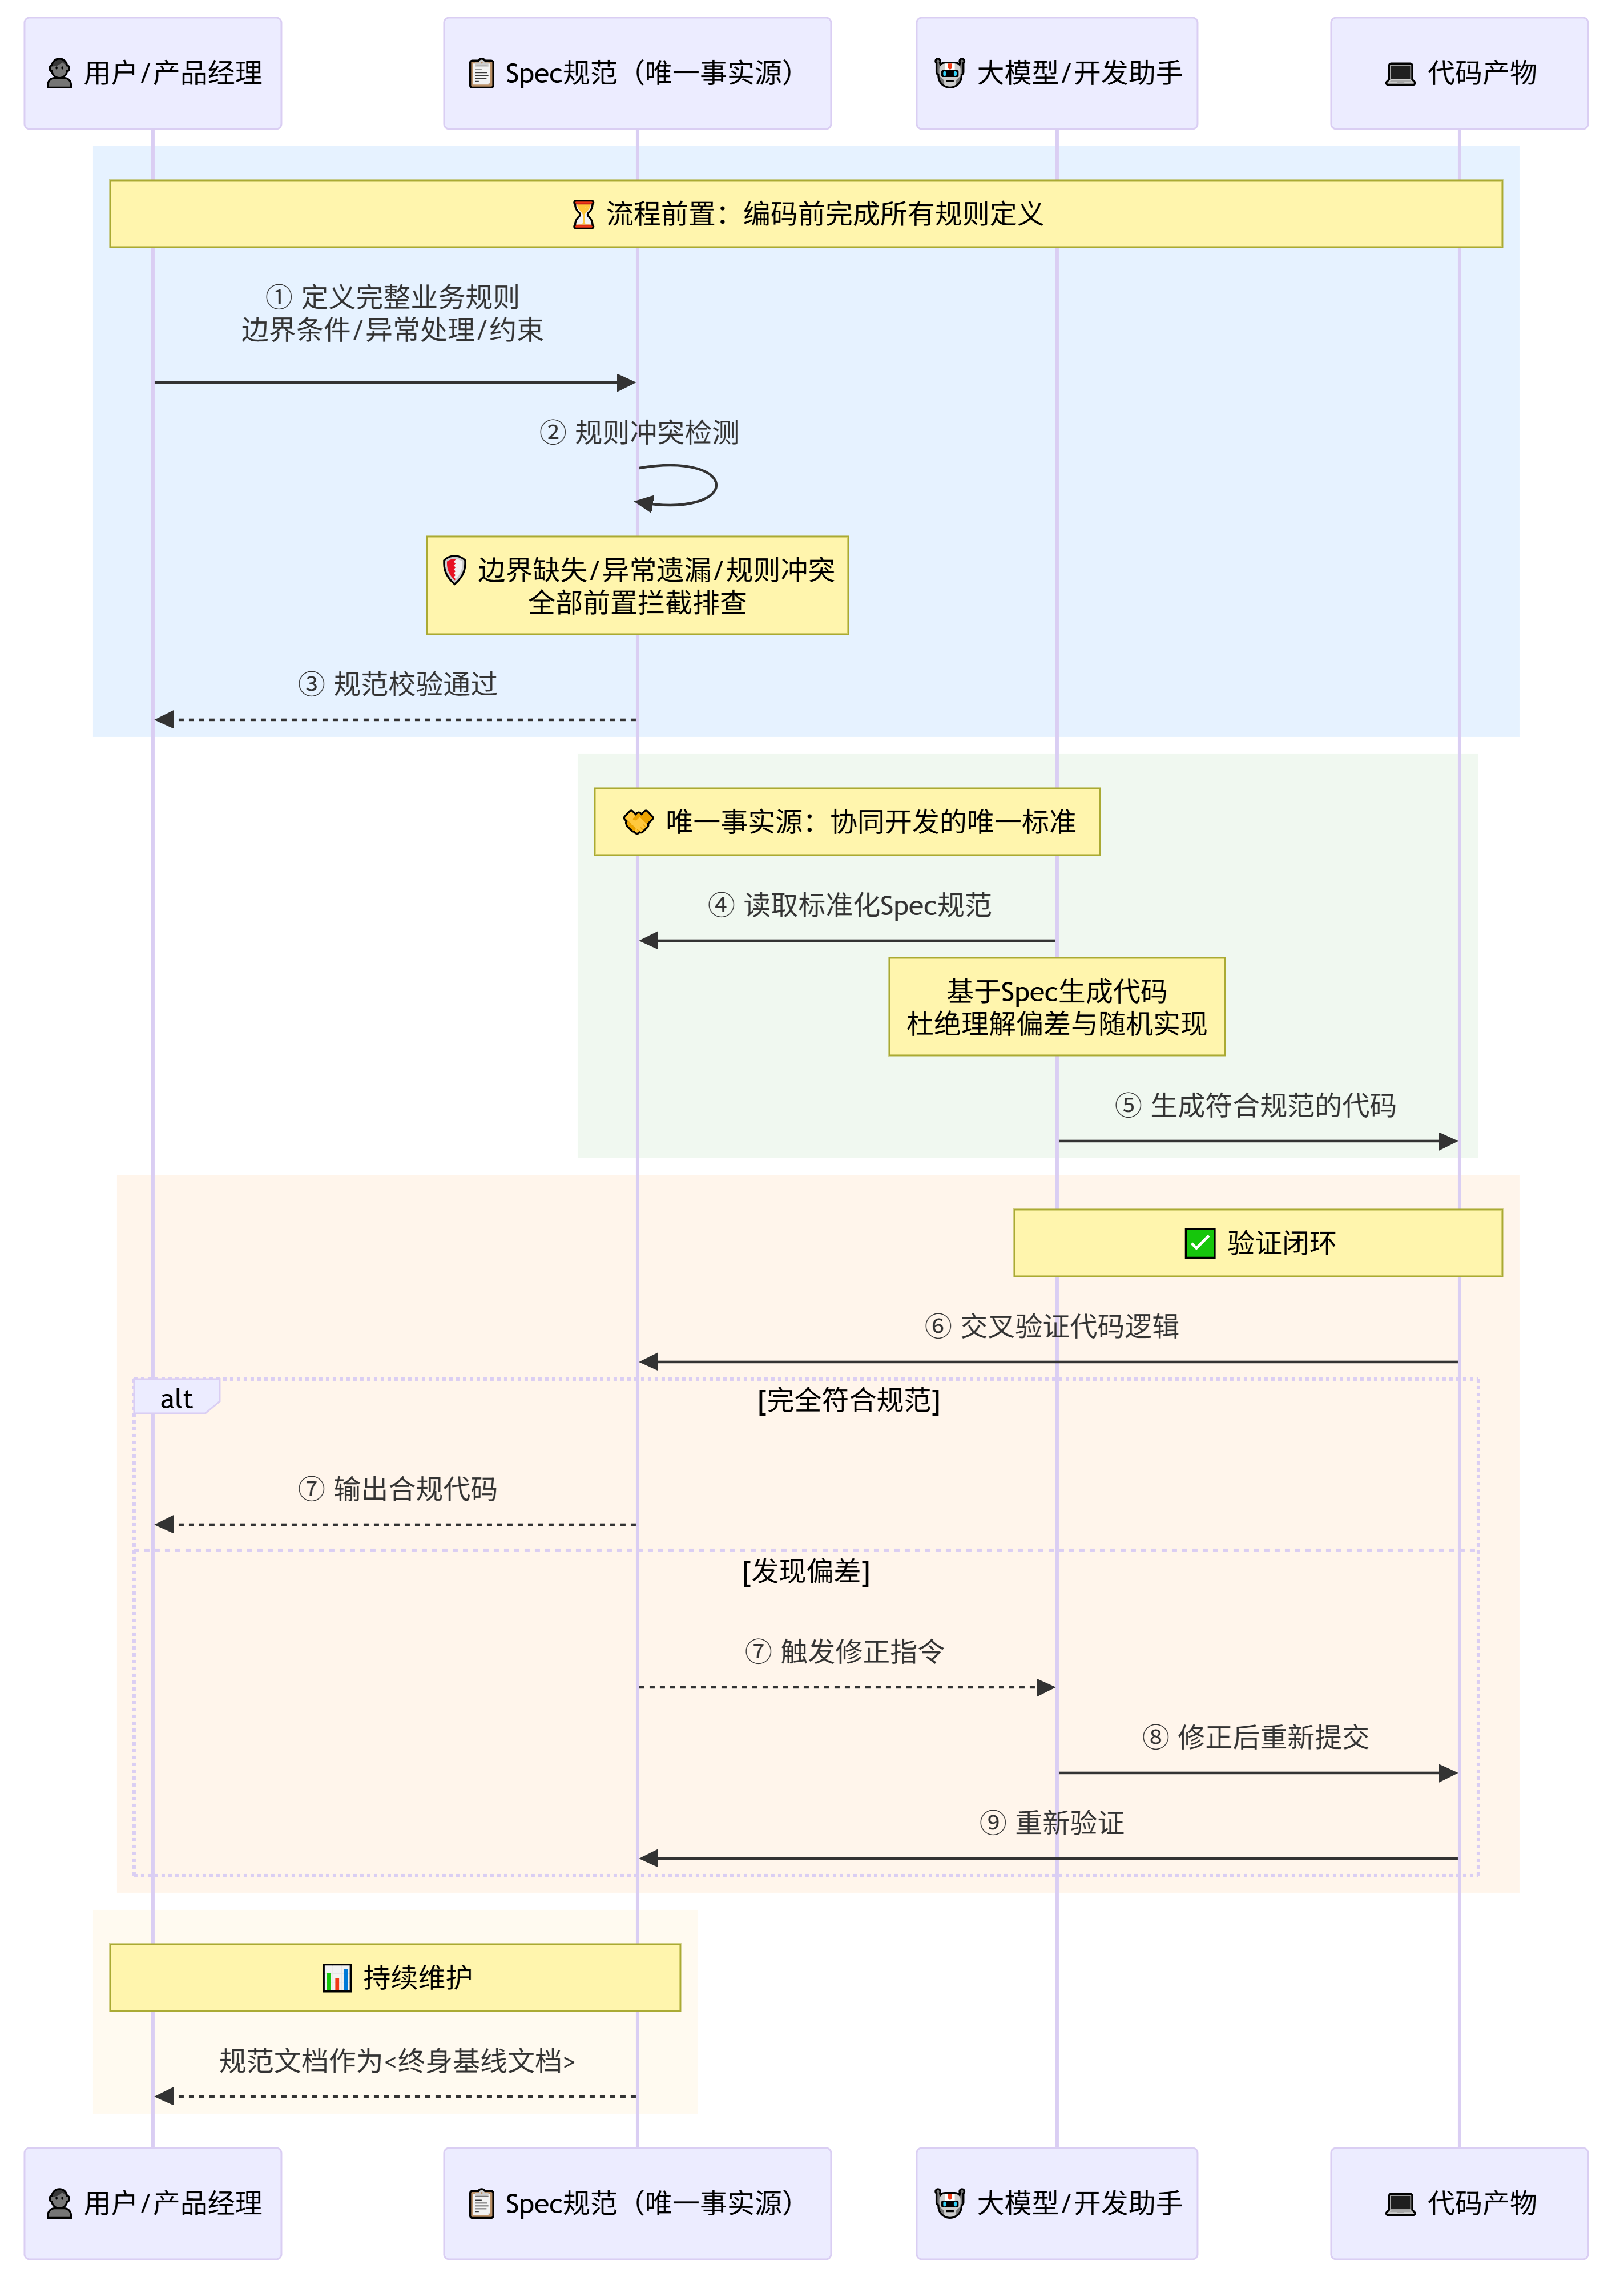
核心逻辑说明:
阶段 | 关键动作 | 解决的问题 |
|---|---|---|
流程前置 | 编码前完成全套业务规则与行为约束定义,人工校验边界与异常 | 边界缺失、异常遗漏、规则冲突全部在规范阶段解决 |
唯一事实源 | Spec规范作为开发与大模型协同的唯一标准,双方严格参照 | 杜绝理解偏差与随机实现,统一对齐 |
问题前置拦截 | 规范阶段完成规则冲突检测与边界补全,不依赖编码后调试修复 | 降低传统开发中反复调试修复的成本与风险 |
验证闭环 | 代码与Spec交叉验证,合格输出,偏差则触发修正指令重新验证 | 保障代码始终与规范一致 |
为了避免混淆新旧SDD概念,这里做明确区分,二者缩写一致、定位完全不同,适配场景严格区分:
- 传统SDD(Software Design Description):软件设计说明书,属于后置文档。核心作用是记录已完成的系统架构、模块结构、技术设计,用于项目归档、交接查阅,不驱动编码流程。
- 新范式SDD(Spec-Driven Development):规范驱动开发,属于前置开发范式。核心作用是提前定义业务行为、输入输出、边界异常、验收标准,是驱动AI编码、测试、迭代的核心依据,而非单纯文档记录。
一份合格的SDD规范,严格遵循只定义行为、不定义实现的核心原则,具体要求如下:
- 聚焦外部可观测结果:只明确系统最终呈现的功能效果、入参出参约束、异常反馈提示。
- 剥离内部实现细节:不规定代码算法、变量命名、函数结构、存储方式等底层编码逻辑。
- 通用无适配门槛:不绑定任何技术栈、框架、大模型,一份规范可适配多套技术实现方案。
简单来说,SDD是人和AI都必须严格遵守的开发契约,人类负责制定契约,AI负责履约落地。
从落地形态来看,SDD规范无需复杂工具支撑,普通Markdown、结构化文本、YAML格式均可落地。一份完整、合格的SDD规范,必须包含六大核心模块,缺一不可,缺少任意一项,都会导致大模型编码出现漏洞,失去规范约束的意义:
- 业务目标与功能边界:明确本次迭代要实现的能力,同时划定范围,界定不做的功能,避免需求蔓延。
- 角色与业务诉求:明确使用对象、核心诉求与业务价值,锚定功能设计初衷。
- 输入输出数据契约:标准化入参、出参、数据格式、字段约束,杜绝参数歧义。
- 正常执行流程:梳理完整正向业务链路,明确每一步标准执行逻辑。
- 全量边界与异常场景:枚举所有极端场景、非法入参、业务异常,提前定义处理规则。
- 可量化验收标准:制定可落地、可测试的验收规则,作为代码校验的唯一依据。
2. 主流范式对比
目前主流开发范式包含四种:原生手动开发、TDD测试驱动开发、AI随性开发、SDD规范驱动开发。其中TDD和SDD最易混淆,下面从执行流程、核心优势、核心短板三个维度,逐一拆解各范式特性,清晰区分差异化:
2.1 传统手动开发
- 执行流程:需求理解-直接编码-调试测试-补写文档
- 核心优势:开发灵活、无固定流程约束,适配小型临时需求。
- 核心短板:
- 需求理解依赖开发者主观判断,无统一标准;
- 文档后置,迭代后无据可查;
- 多人、AI协同时极易出现理解偏差,维护成本极高。
2.2 TDD测试驱动开发
- 执行流程:先写测试用例-编写代码适配测试-重构优化
- 核心优势:聚焦代码单元校验,保证单段代码逻辑可用、无bug。
- 核心短板:仅关注代码底层逻辑,不覆盖整体业务场景,无法规避业务规则漏洞、边界缺失等上层问题。
2.3 AI随性开发
- 执行流程:模糊prompt-生成代码-简单调试-上线
- 核心优势:极速出原型,无需复杂思考,适合快速demo验证想法。
- 核心短板:无任何规范约束,大模型基于概率生成代码,普遍存在边界缺失、规则错位、迭代回归问题,完全无法支撑生产级稳定项目。
2.4 SDD规范驱动开发
- 执行流程:梳理业务-制定规范-拆解任务-AI生成代码+测试-校验落地
- 核心优势:从业务源头锁定所有规则,消除需求歧义,约束AI编码随机性,实现可追溯、可迭代、可生产的高质量开发。
- 核心短板:新增前置梳理工作,短期小幅提升开发前置成本。
SDD与TDD并非替代关系,而是互补黄金组合,二者分工明确、完美适配AI开发场景:
- SDD负责业务层:制定全局业务规约,定义功能标准、边界规则、异常处理逻辑,解决业务是否做对的核心问题。
- TDD负责代码层:基于SDD验收标准编写测试用例,校验代码落地是否完全匹配规约,解决代码是否做好的落地问题。
二者结合,可完美实现AI编码从临时原型到稳定生产的全链路落地闭环。
3. 核心解决痛点
SDD本质是精准解决了大模型辅助编程的四大核心痛点,也是当前绝大多数开发团队的普遍难题:
3.1 需求歧义性,AI理解偏差
- 日常口头需求、简单prompt均为模糊描述,存在大量隐含业务规则、边界场景。
- 人类可凭借经验预判处理,而大模型仅能字面解析需求,极易出现功能缺失、逻辑错位。
- SDD通过结构化规范,将所有隐性规则显性化,彻底消除需求理解偏差。
3.2 迭代回归混乱,旧功能频繁报错
- 无规范的AI开发中,每次迭代更新功能,大模型会重新生成全量代码,极易无意识篡改原有稳定业务逻辑,引发线上回归bug。
- SDD固化可溯源的业务规约,迭代优先更新规范,再驱动代码变更,所有改动有据可查,从根源杜绝回归问题。
3.3 代码评审效率极低,排查成本高
- 传统AI开发需逐行审核上千行代码,人工排查逻辑漏洞、边界缺失,耗时费力且极易遗漏。
- SDD模式下,优先审核数百字的规范文档,确认业务无误后,仅校验代码是否匹配规约,评审效率提升5倍以上,大幅降低人工成本。
3.4 项目无沉淀、难维护,沦为僵尸代码
- 多数AI开发项目仅迭代代码,无任何业务文档沉淀。
- 新人接手、长期迭代后,无人知晓功能设计初衷与约束规则,项目无法二次优化迭代。
- SDD规范随代码同步更新,成为项目永久活文档,留存完整业务逻辑,大幅提升可维护性。
三、SDD完整落地流程
1. 四步闭环流程
SDD拥有一套标准化、可落地的四步闭环流程,全程遵循规约前置、人工把关、AI落地、校验闭环的核心原则,无冗余环节,适配个人开发、团队协作、AI辅助开发全场景。整套流程环环相扣,且硬性规定:所有代码变更、功能迭代必须从规约更新开始,禁止直接修改代码。流程具体拆解:
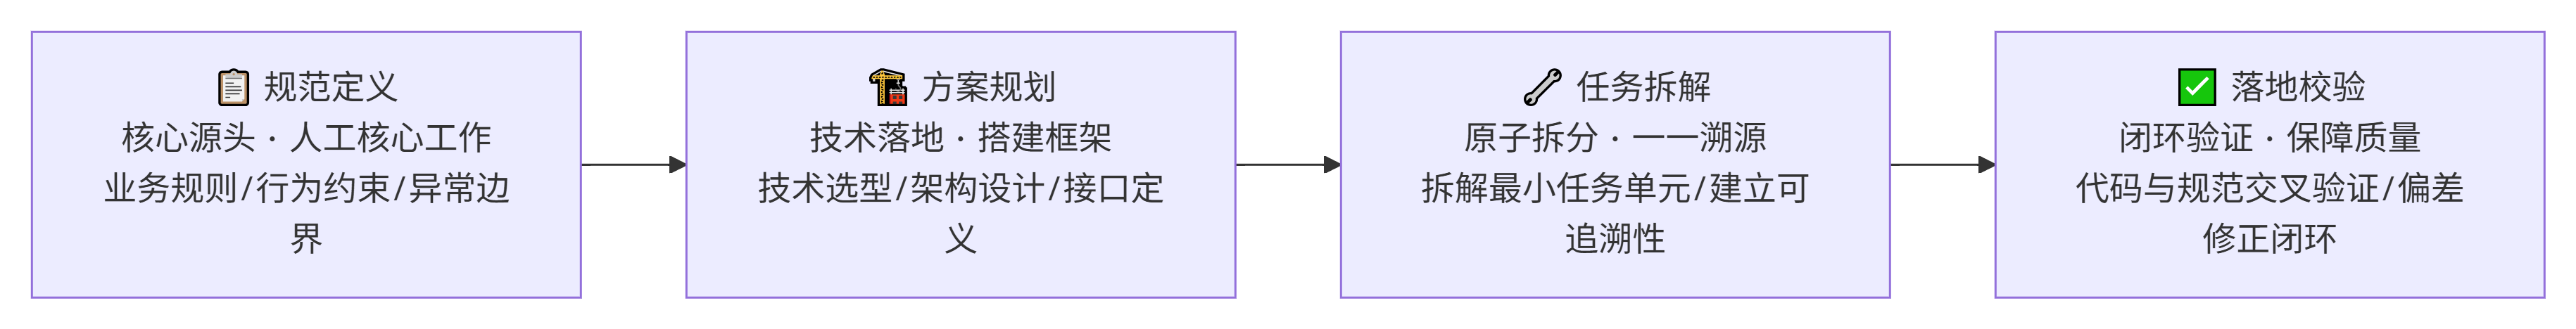
1.1 第一步:规范定义(核心源头,人工核心工作)
此阶段完全不写代码、不思考实现细节,仅专注梳理业务逻辑,是SDD最核心、最关键的环节,也是开发者的核心价值所在。具体工作内容:
- 明确功能目标,精准界定迭代范围,区分本次迭代实现与不实现的功能,避免需求扩散;
- 梳理用户诉求与业务价值,标准化输入输出数据规则;
- 枚举全部正常业务流程、极端边界场景、异常报错场景;
- 编写可量化、可落地、可测试的验收标准;
- 完成后人工评审,确认无逻辑漏洞、无场景遗漏,方可进入下一环节。
1.2 第二步:方案规划(技术落地,搭建框架)
基于已评审通过的业务规范,完成技术层面落地规划,搭建统一代码框架,统一AI编码标准。具体工作内容:
- 确定适配的技术栈、开发框架,对齐项目现有技术体系;
- 规划项目文件目录、模块划分,保证结构清晰;
- 定义数据结构、存储规则、数据库模型变更;
- 梳理外部接口、第三方依赖、系统关联关系;
- 制定统一测试策略、异常处理方案、性能约束标准。
此阶段仅确定技术方案,不编写具体业务代码,核心目的是统一编码规范,避免AI生成代码杂乱无章。
1.3 第三步:任务拆解(原子拆分,一一溯源)
将整体技术方案拆解为最小原子任务,严格遵循单一职责、最小粒度、一一溯源原则,让AI可精准执行。具体拆解标准:
- 每个原子任务仅对应规范中的一条验收标准,实现精准溯源;
- 单个任务只负责一项核心能力,包含数据定义、逻辑实现、异常处理、测试覆盖;
- 拆分后任务无耦合、无重叠,方便AI逐一对标开发,避免逻辑混乱;
- 细化任务粒度,便于后续问题定位、bug追溯、责任划分。
1.4 第四步:落地校验(闭环验证,保障质量)
此阶段全程由大模型承担机械编码工作,开发者仅负责把关校验,实现高效闭环。具体执行流程:
- 大模型根据原子任务,依次生成业务代码、工具方法、全套单元测试用例;
- 自动执行测试用例,校验代码行为是否100%匹配规范验收标准;
- 测试不通过时,优先排查源头问题(任务拆解、方案规划、规范定义),修正后重新生成代码;
- 禁止人工手动修补代码,杜绝代码与规约脱节。
最终实现"规约-代码-测试-校验"的完整开发闭环。
2. 流程执行时序
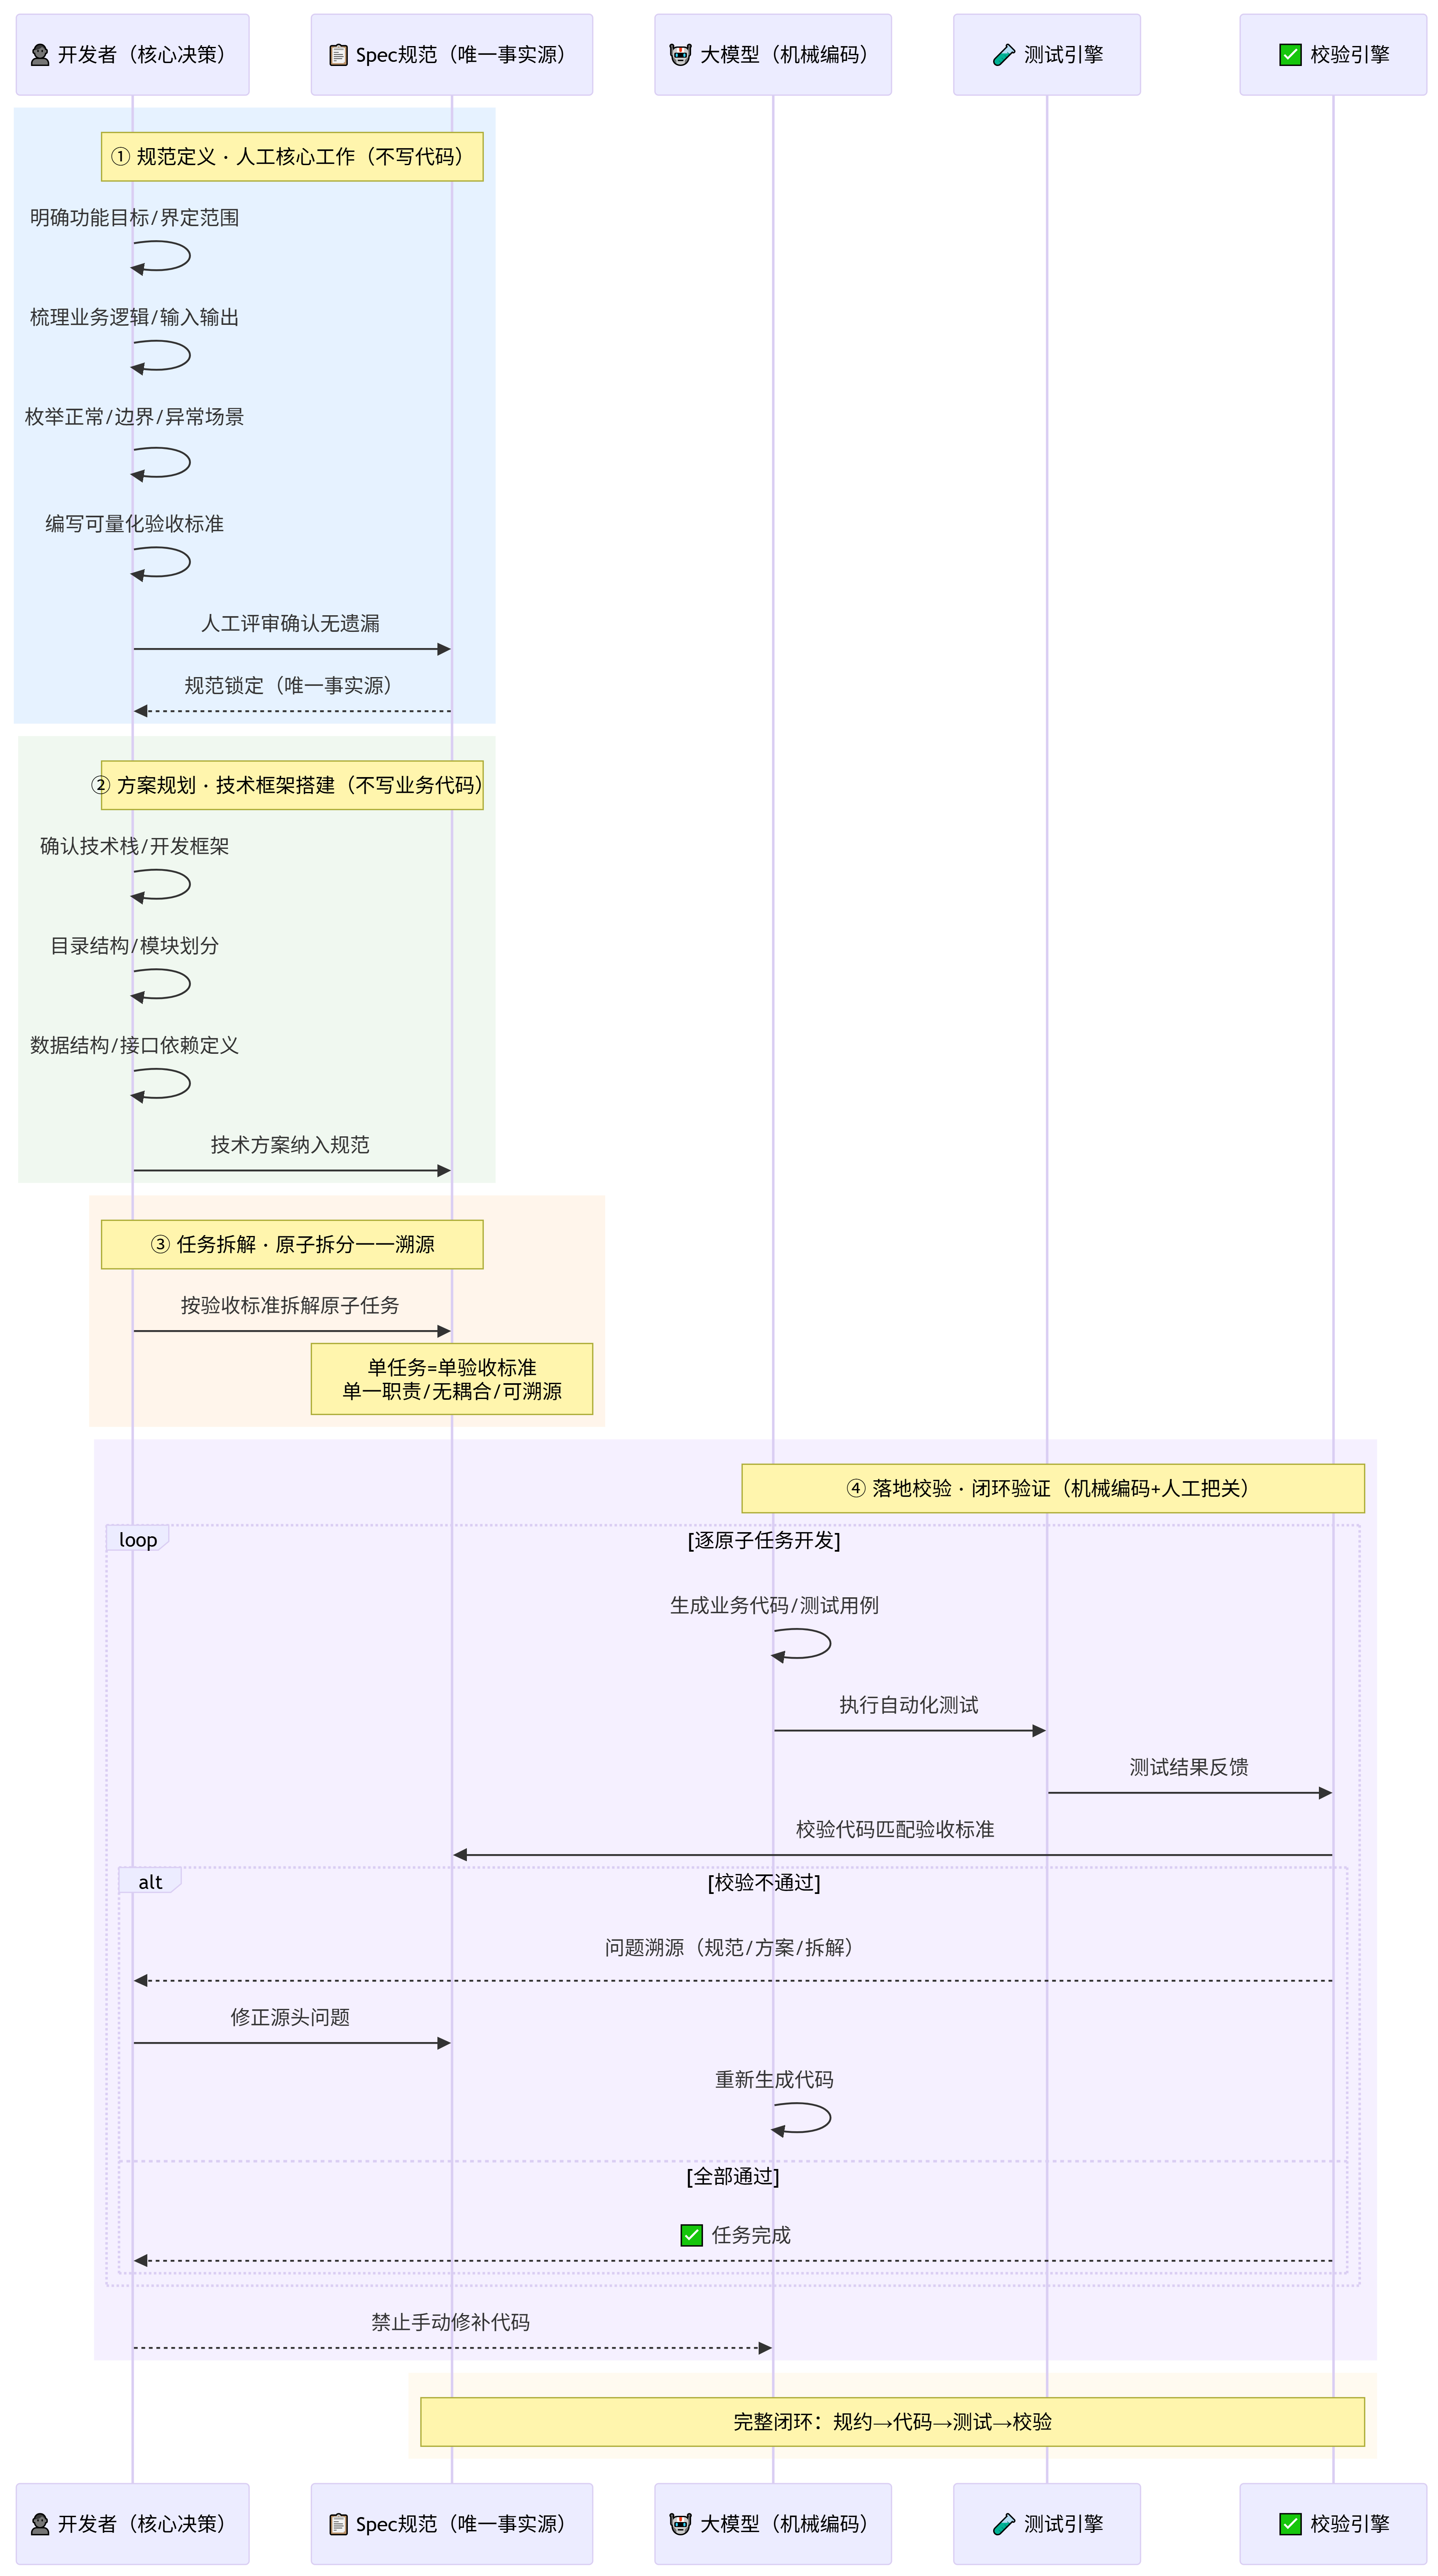
流程核心说明:
阶段 | 核心原则 | 具体工作 |
|---|---|---|
① 规范定义 | 人工核心,不写代码 | 明确功能目标、枚举正常/边界/异常场景、编写可量化验收标准、人工评审 |
② 方案规划 | 技术框架搭建,不写业务代码 | 确定技术栈、目录结构、模块划分、数据结构、接口依赖、测试策略 |
③ 任务拆解 | 原子拆分,一一溯源 | 按验收标准拆解最小原子任务,单一职责、无耦合、可溯源 |
④ 落地校验 | 大模型机械编码,人工把关 | 大模型生成代码+测试用例 → 自动执行测试 → 校验匹配验收标准 → 不通过则溯源源头修正 → 禁止人工修补代码 |
3. 工程目录规范
想要长期稳定落地SDD范式,必须搭建标准化工程目录,核心原则为:规范与代码同仓管理、同步迭代、同版本追溯。SDD落地失败,核心原因是规范文档单独存储,导致文档与代码脱节、规范腐烂。本节提供一套全技术栈通用的标准化目录结构,适配Python、Java、前端等所有项目:
- 目录层级规范:项目根目录下新建specs全局规范目录,与src源代码目录、tests测试目录同级,保证项目结构统一清晰。
- 全局宪章文件:specs根目录下创建constitution.md,定义项目全局通用约束,包含统一编码规范、异常处理规则、性能标准、安全约束,所有功能开发必须严格遵守。
- 业务模块规范:按业务模块拆分子文件夹,每个模块独立存放三套文档:spec.md核心业务规约、plan.md技术实现方案、tasks.md原子任务清单。
该目录结构的核心优势:
- 在开始大模型接入项目时,可优先读取全局宪章与模块规范,快速对齐项目标准;
- 彻底解决多人AI协作中代码风格混乱、逻辑不统一、规则不一致的问题;
- 所有规范纳入Git版本管理,变更全程可追溯、可回滚、可复盘。
配套硬性迭代规则,落地核心保障:
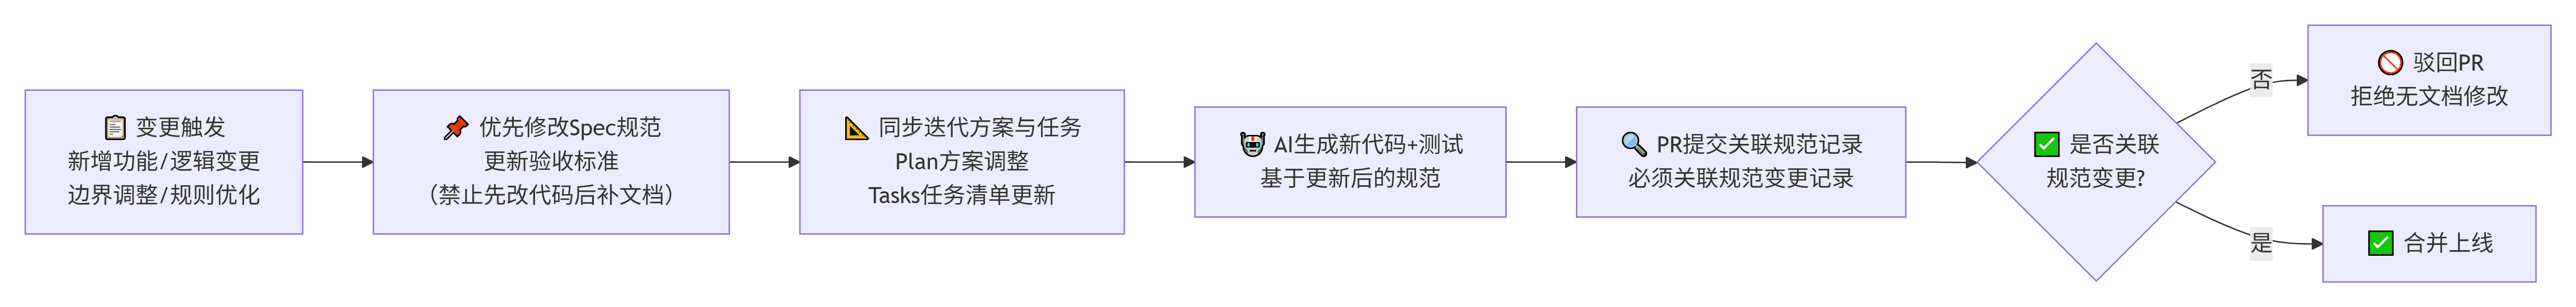
- 新增功能、逻辑变更、边界调整、规则优化,必须优先修改对应模块spec规约,更新验收标准;
- 规约更新完成后,同步迭代plan方案与tasks任务清单;
- 最后再由AI生成新代码与测试用例,禁止先改代码、后补文档;
- 代码PR提交时,必须关联对应规范变更记录,无文档更新的代码修改一律驳回,彻底杜绝规范腐烂。
四、SDD应用实践分析
为了更进一步直观理解,我们以“用户手机号验证码登录功能”为示例场景,完整时许SDD四步落地全流程,包含规范编写、方案规划、任务拆解、代码实现、单元测试,所有内容可直接运行,覆盖正常流程、边界场景、异常报错全场景。
1. 功能规范编写(spec.md)
本规范聚焦业务行为,无任何实现细节,严格遵循SDD规约定义准则,明确所有业务约束与验收标准。
用户手机号验证码登录 - SDD规范文档 一、业务目标 实现用户手机号+验证码登录功能,校验手机号合法性、验证码有效性,登录成功返回用户信息与登录令牌;拦截所有非法入参与失效凭证,保障登录安全。本次迭代仅实现手机号验证码登录,账号密码登录、第三方登录不在本次范围内。 二、用户故事 作为终端用户,我输入合法手机号和有效验证码,可成功登录系统;输入错误、过期、空参数时,获取精准的错误提示,明确知晓登录失败原因。 三、输入输出契约 接口函数:phone_code_login(phone: str, code: str) 入参约束:phone为11位中国大陆手机号,非空;code为6位数字验证码,非空。 出参约束:登录成功返回字典,包含用户ID、手机号、登录token、登录时间;登录失败抛出对应业务异常,返回精准中文提示。 四、正常业务流程 1. 校验手机号、验证码参数格式合法;2. 校验验证码是否存在且未过期(有效期5分钟);3. 校验验证码与手机号匹配;4. 新用户自动创建账号,老用户直接登录;5. 生成唯一登录令牌,返回用户信息与令牌。 五、异常边界场景 1. 手机号为空/空白字符:抛出异常“手机号不能为空”;2. 手机号格式非11位数字:抛出异常“手机号格式错误”;3. 验证码为空/空白字符:抛出异常“验证码不能为空”;4. 验证码非6位数字:抛出异常“验证码格式错误”;5. 验证码过期:抛出异常“验证码已失效,请重新获取”;6. 验证码不匹配:抛出异常“验证码错误”。 六、验收标准(AC) AC01:合法手机号+有效验证码,新用户自动注册并登录,返回完整用户信息与token;AC02:合法手机号+有效验证码,老用户正常登录,刷新登录token;AC03:空手机号、空验证码触发对应参数异常;AC04:手机号、验证码格式错误触发格式异常;AC05:过期、错误验证码触发校验失败异常。 七、非功能约束 Python3.10+开发,异常提示统一中文,无模糊报错;验证码有效期固定5分钟;token为32位随机字符串;所有场景必须编写单元测试覆盖,无遗漏场景。
2. 技术方案规划(plan.md)
# 手机号验证码登录 - 技术方案 一、文件结构 业务逻辑:src/auth/login_service.py;数据模型:src/auth/model.py;单元测试:tests/test_login.py 二、数据存储方案 采用内存模拟缓存与数据库,适配演示场景,生产环境可替换Redis+MySQL;缓存存储手机号-验证码-过期时间映射关系;数据库存储用户基础信息。 三、核心实现要点 1. 优先执行参数格式校验,拦截非法入参;2. 校验验证码缓存有效性与匹配性;3. 用户不存在则自动初始化用户数据;4. 登录成功生成随机token;5. 所有异常分层抛出,精准对应业务场景;6. 严格遵循spec规范所有约束,不新增、不删减业务规则。 四、测试方案 采用pytest编写单元测试,自动重置内存数据,隔离测试场景;全覆盖AC01-AC06所有验收场景,保证每一条规范都有对应的测试用例验证。
3. 原子任务拆解(tasks.md)
# 登录功能原子任务清单(全溯源spec验收标准) 1. 定义用户数据模型、验证码缓存数据结构(适配AC01、AC02); 2. 实现手机号、验证码参数格式校验逻辑(适配AC03、AC04); 3. 实现验证码有效期、匹配性校验逻辑(适配AC05); 4. 实现新用户自动注册、老用户登录逻辑(适配AC01、AC02); 5. 实现登录token生成与结果返回逻辑; 6. 编写全场景单元测试用例,覆盖所有验收标准; 7. 执行测试,确保全部用例通过,代码完全匹配规范。
4. 完整业务实现示例
以下为大模型基于上述规范、方案、任务生成的标准化代码,完全贴合规约约束,无任何逻辑偏差。
4.1 认证数据模型 model.py
定义了认证模块的核心数据模型与基础工具。通过@dataclass定义了User(用户)和CodeCache(验证码缓存)两个数据类,使用字典模拟内存存储,并提供generate_token生成32位随机登录Token、reset_auth_data重置测试数据,为登录认证流程提供底层数据支撑。
# src/auth/model.py
from dataclasses import dataclass
from datetime import datetime, timedelta
import random
import string

# 用户数据模型
@dataclass
class User:
    user_id: str
    phone: str
    create_time: datetime

# 验证码缓存模型
@dataclass
class CodeCache:
    phone: str
    code: str
    expire_time: datetime

# 内存模拟存储
user_db: dict[str, User] = {}
code_cache_db: dict[str, CodeCache] = {}

# 生成32位登录Token
def generate_token() -> str:
    return ''.join(random.sample(string.ascii_letters + string.digits, 32))

# 重置测试数据
def reset_auth_data():
    user_db.clear()
    code_cache_db.clear()
4.2 手机验证码登录 login_service.py
实现了手机号验证码登录的核心业务逻辑。phone_code_login函数依次执行参数非空校验、格式校验(11位手机号、6位验证码)、验证码有效性校验(缓存查询、过期判断、值比对),通过后自动注册新用户或查询已有用户,最终返回用户信息与登录Token。send_sms_code模拟验证码发送,将验证码写入缓存并设置过期时间。
# src/auth/login_service.py
from datetime import datetime
from src.auth.model import User, CodeCache, user_db, code_cache_db, generate_token

def phone_code_login(phone: str, code: str) -> dict:
    # 1. 参数非空校验
    if not phone or phone.strip() == "":
        raise ValueError("手机号不能为空")
    if not code or code.strip() == "":
        raise ValueError("验证码不能为空")

    # 2. 参数格式校验
    if len(phone) != 11 or not phone.isdigit():
        raise ValueError("手机号格式错误")
    if len(code) != 6 or not code.isdigit():
        raise ValueError("验证码格式错误")

    # 3. 验证码有效性校验
    cache_info = code_cache_db.get(phone)
    if not cache_info:
        raise ValueError("验证码错误")
    if datetime.now() > cache_info.expire_time:
        raise ValueError("验证码已失效,请重新获取")
    if cache_info.code != code:
        raise ValueError("验证码错误")

    # 4. 用户账号处理
    if phone not in user_db:
        # 新用户自动注册
        new_user = User(
            user_id=f"user_{phone}",
            phone=phone,
            create_time=datetime.now()
        )
        user_db[phone] = new_user
    user = user_db[phone]

    # 5. 生成登录信息
    return {
        "user_id": user.user_id,
        "phone": user.phone,
        "token": generate_token(),
        "login_time": datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    }

# 模拟发送验证码接口(辅助测试)
def send_sms_code(phone: str, code: str, expire_min: int = 5):
    expire_time = datetime.now() + timedelta(minutes=expire_min)
    code_cache_db[phone] = CodeCache(phone=phone, code=code, expire_time=expire_time)
5. 全覆盖单元测试
实现对手机验证码登录功能进行单元测试。通过@pytest.fixture(autouse=True) 在每个用例前后自动重置测试数据,保证用例间互不干扰。共覆盖5个验收场景(AC01~AC05):新用户登录、老用户登录、空参数异常、格式错误异常、验证码失效/错误异常,分别验证正常流程与各类异常分支,确保登录逻辑的健壮性。
# tests/test_login.py
import pytest
from src.auth.login_service import phone_code_login, send_sms_code
from src.auth.model import reset_auth_data

@pytest.fixture(autouse=True)
def init_test_env():
    reset_auth_data()
    yield
    reset_auth_data()

def test_ac01_new_user_login():
    """AC01 新用户合法登录"""
    send_sms_code("13800138000", "123456")
    res = phone_code_login("13800138000", "123456")
    assert res["phone"] == "13800138000"
    assert len(res["token"]) == 32

def test_ac02_old_user_login():
    """AC02 老用户正常登录"""
    send_sms_code("13800138000", "123456")
    phone_code_login("13800138000", "123456")
    send_sms_code("13800138000", "654321")
    res = phone_code_login("13800138000", "654321")
    assert res["user_id"] == "user_13800138000"

def test_ac03_empty_param_error():
    """AC03 空参数异常"""
    with pytest.raises(ValueError, match="手机号不能为空"):
        phone_code_login("", "123456")
    with pytest.raises(ValueError, match="验证码不能为空"):
        phone_code_login("13800138000", "")

def test_ac04_format_error():
    """AC04 格式错误异常"""
    with pytest.raises(ValueError, match="手机号格式错误"):
        phone_code_login("13800", "123456")
    with pytest.raises(ValueError, match="验证码格式错误"):
        phone_code_login("13800138000", "123")

def test_ac05_code_invalid_error():
    """AC05 验证码失效/错误异常"""
    send_sms_code("13800138000", "123456", expire_min=-5)
    with pytest.raises(ValueError, match="验证码已失效,请重新获取"):
        phone_code_login("13800138000", "123456")
    send_sms_code("13800138000", "123456")
    with pytest.raises(ValueError, match="验证码错误"):
        phone_code_login("13800138000", "654321")
执行pytest测试命令,所有用例测试通过,代码行为完全匹配SDD规范所有约束。后续若需修改登录规则,例如调整验证码有效期、新增手机号段校验,只需优先修改spec规范,再驱动代码和测试更新,彻底规避盲目改代码导致的bug。
五、SDD应用工具生态
1. 三级落地层级
SDD落地并非一刀切的标准化流程,可根据团队规模、项目体量、迭代属性灵活选择。实践将SDD落地划分为三个递进层级,从入门轻量化到高阶标准化,适配不同场景,无需盲目追求高阶模式:
一级入门:规范先行模式
- 核心逻辑:新增功能前优先编写基础规范,明确业务规则与验收标准,AI生成代码后无需长期维护文档。
- 适配场景:个人独立开发、快速原型验证、小型demo项目、临时迭代需求。
- 落地价值:门槛极低,仅调整开发顺序,即可大幅降低AI编码出错率,快速体验SDD核心收益。
二级成熟:规范锚定模式
- 核心逻辑:规范文档纳入Git版本管理,与代码同步迭代、同步更新,所有功能变更必须优先更新规约,让规范成为项目永久事实源。
- 适配场景:中小型团队协作、长期迭代的生产项目、核心业务模块、需要持续维护的线上功能。
- 落地价值:兼顾成本与收益,既避免文档冗余负担,又彻底解决代码迭代混乱、规则丢失、无据可查的问题,是绝大多数团队的终极落地模式。
三级高阶:规约即源码模式
- 核心逻辑:将结构化规约作为一等源码,通过专业工具自动编译生成代码与测试用例,全程无人工编码干预。
- 适配场景:大型企业核心系统、高精密业务模块、对稳定性一致性要求极致的项目。
- 落地特点:规范性、代码一致性、可控性最强,但落地成本极高、流程复杂,普通团队无需尝试。
2. 轻量化工具生态
SDD的核心本质是开发方法论与思维模式,而非绑定特定工具框架。无需依赖专业工具,纯手写Markdown即可完整落地。行业现有工具均为轻量化辅助手段,仅用于简化流程、提升效率,不改变SDD核心逻辑:
- 模板辅助工具:VS Code SDD模板插件,可一键生成规范、方案、任务标准化模板,省去手动排版、结构搭建的时间,统一文档格式。
- 智能规约工具:AI智能规约生成工具,可基于简单自然语言需求,快速生成初始规范草稿,人工微调完善即可使用,大幅降低前置梳理成本。
- 自动化校验工具:CI/CD集成SDD校验规则,代码提交时自动检测规约与代码行为是否匹配,实时拦截规范腐烂、代码与文档脱节问题。
核心重点提醒:所有工具都是辅助手段,绝对不能本末倒置。
- SDD落地的核心是人类前置梳理业务逻辑、界定边界、明确规则;
- 工具仅能简化流程、统一格式,无法替代人类的业务判断与规则设计能力;
- 过度依赖AI自动生成规范,会导致规约边界缺失、逻辑漏洞,彻底失去SDD落地意义。
3. 实践问题总结
3.1 过度规范化,规约冗余过重
- 问题成因:开发者将内部代码实现细节、算法逻辑、变量定义、代码结构写入规范,把行为规约写成伪代码,违背SDD核心原则。
- 规避方案:坚守核心判定标准,规范仅描述外部可观测功能与行为,不涉及任何内部编码细节,更换技术栈后规约依然完全适用。
3.2 规范腐烂,文档与代码脱节
- 问题成因:迭代中仅修改代码逻辑、修复bug、优化功能,长期不更新对应规范文档,导致规约与实际代码行为不一致,文档彻底失效。
- 规避方案:建立硬性迭代机制,所有业务逻辑变更必须优先更新规约,代码PR评审同步校验文档一致性,杜绝文档滞后。
3.3 全场景强制落地,本末倒置
- 问题成因:不分场景对微小bug修复、临时调试代码、探索性demo,强行套用完整SDD全套流程,导致开发效率大幅下降。
- 规避方案:分级落地、按需适配。大型核心功能完整落地全套流程,微小迭代、临时调试、探索性需求轻量化处理,无需冗余文档。
3.4 过度信任规约约束力,忽视测试校验
- 问题成因:开发者认为只要规范写得足够详细,AI就会100%履约执行,省略测试校验环节。
- 规避方案:明确分工边界,规约负责定义标准,测试负责校验落地结果,永远以测试执行结果为最终判定依据,不盲目信任AI生成结果。
六、总结
大模型重构了软件开发的效率边界,但并没有降低软件开发的核心门槛。AI可以替代人类完成敲代码、写单测、优化语法等所有机械性工作,但永远无法替代人类的业务思考、规则定义、边界把控能力。这也是SDD规范驱动开发能够成为新一代AI编程范式的核心原因。
过去我们依赖prompt技巧优化AI编码效果,本质是被动适配AI;而SDD范式是让我们主动掌控AI,把开发的核心主动权收回人类手中。它重新定义了人机协同编程的分工:人类聚焦高价值的业务定义、规则约束、风险把控,大模型承担低价值的编码实现、测试编写、代码优化,真正实现人机各司其职、高效协同。
SDD不是一套复杂的技术框架,也不是一套冗余的文档规范,而是适配AI时代的开发思维升级。补齐了大模型编程的核心短板,让AI编码从随机体感开发升级为标准化可控开发,让原型代码真正具备落地生产、长期迭代的能力。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号