Agent 小知识:Stateful Session 是什么?
原创
Agent 小知识:Stateful Session 是什么?
原创
七牛开发者
发布于 2026-10-15 16:00:26
发布于 2026-10-15 16:00:26
我们使用 Coding Agent 时,经常会给它安排一些需要持续执行的任务。
比如,先让它分析一个项目的代码结构,再定位某个 Bug,接着修改代码、运行测试。如果测试失败,就根据报错继续调整。整个过程可能经历几十次模型调用,但 Agent 往往能够知道自己已经做了什么,接下来应该做什么。
还有一种情况,任务执行到一半,我们暂时离开了会话窗口。过一段时间,可能是当天,也可能是下周,才重新打开原来的会话,要求 Agent 继续工作。
问题来了:Agent 是怎么知道之前的任务进行到哪一步的?
我们之前聊过上下文窗口,它决定了模型在一次推理中能够看到哪些信息。对于需要连续执行任务的 Agent 来说,每完成一步,都会产生新的对话记录、工具调用结果和任务进度。这些信息只有被重新提供给模型,才能成为后续推理的依据。
但问题是,这些不断产生的信息总得有地方保存。尤其当任务中断、会话重新打开时,系统该从哪里找回之前的执行记录,又该如何知道任务进行到了哪一步?
这就涉及本期要讲的概念:Stateful Session(有状态会话)。
从 Stateless 到 Stateful
讲 Stateful Session 之前,我们先来弄清楚 Session 是什么。
在 Agent 系统中,Session 通常表示一段连续的交互过程。它可以包含多轮用户输入、模型回复、工具调用,以及与这段交互相关的其他状态。Stateful 中的 State 指状态,也就是系统在某个时刻保存下来的信息。
因此,我们可以把 Stateful Session 理解为:Agent 系统在多次交互之间维护会话状态,让后续执行能够利用此前积累的信息。
要理解它的作用,可以先看看 Stateless(无状态)模式。
假设我们连续向模型发送两次请求:第一次:
用户:分析 auth.py 中的登录逻辑。

模型:发现 validate_token() 中可能存在
Token 过期时间判断问题。
第二次:
用户:修复刚才发现的问题。如果两次请求完全独立,第二次又没有提供前面的对话内容,模型自然不知道「刚才发现的问题」是什么。这就是 Stateless 调用的一个典型特点:每次请求独立处理,系统不会自动利用上一次请求留下的状态。
不过,Stateless 并不意味着无法实现多轮对话。开发者仍然可以在第二次请求中重新提供第一次的消息记录,让模型获得必要的信息。
到了 Stateful Session,历史信息的维护就可以由会话管理机制负责。例如,系统创建一个 Session,并为它分配唯一标识:session_id: sess_001。第一轮交互结束后,系统将相关信息保存到这个 Session 中。第二轮请求继续使用 sess_001,Runtime 就可以读取此前的状态,再结合新的用户指令继续执行。
从用户的角度看,Agent 始终在处理同一个任务。而在系统内部,模型可能已经被调用了很多次。
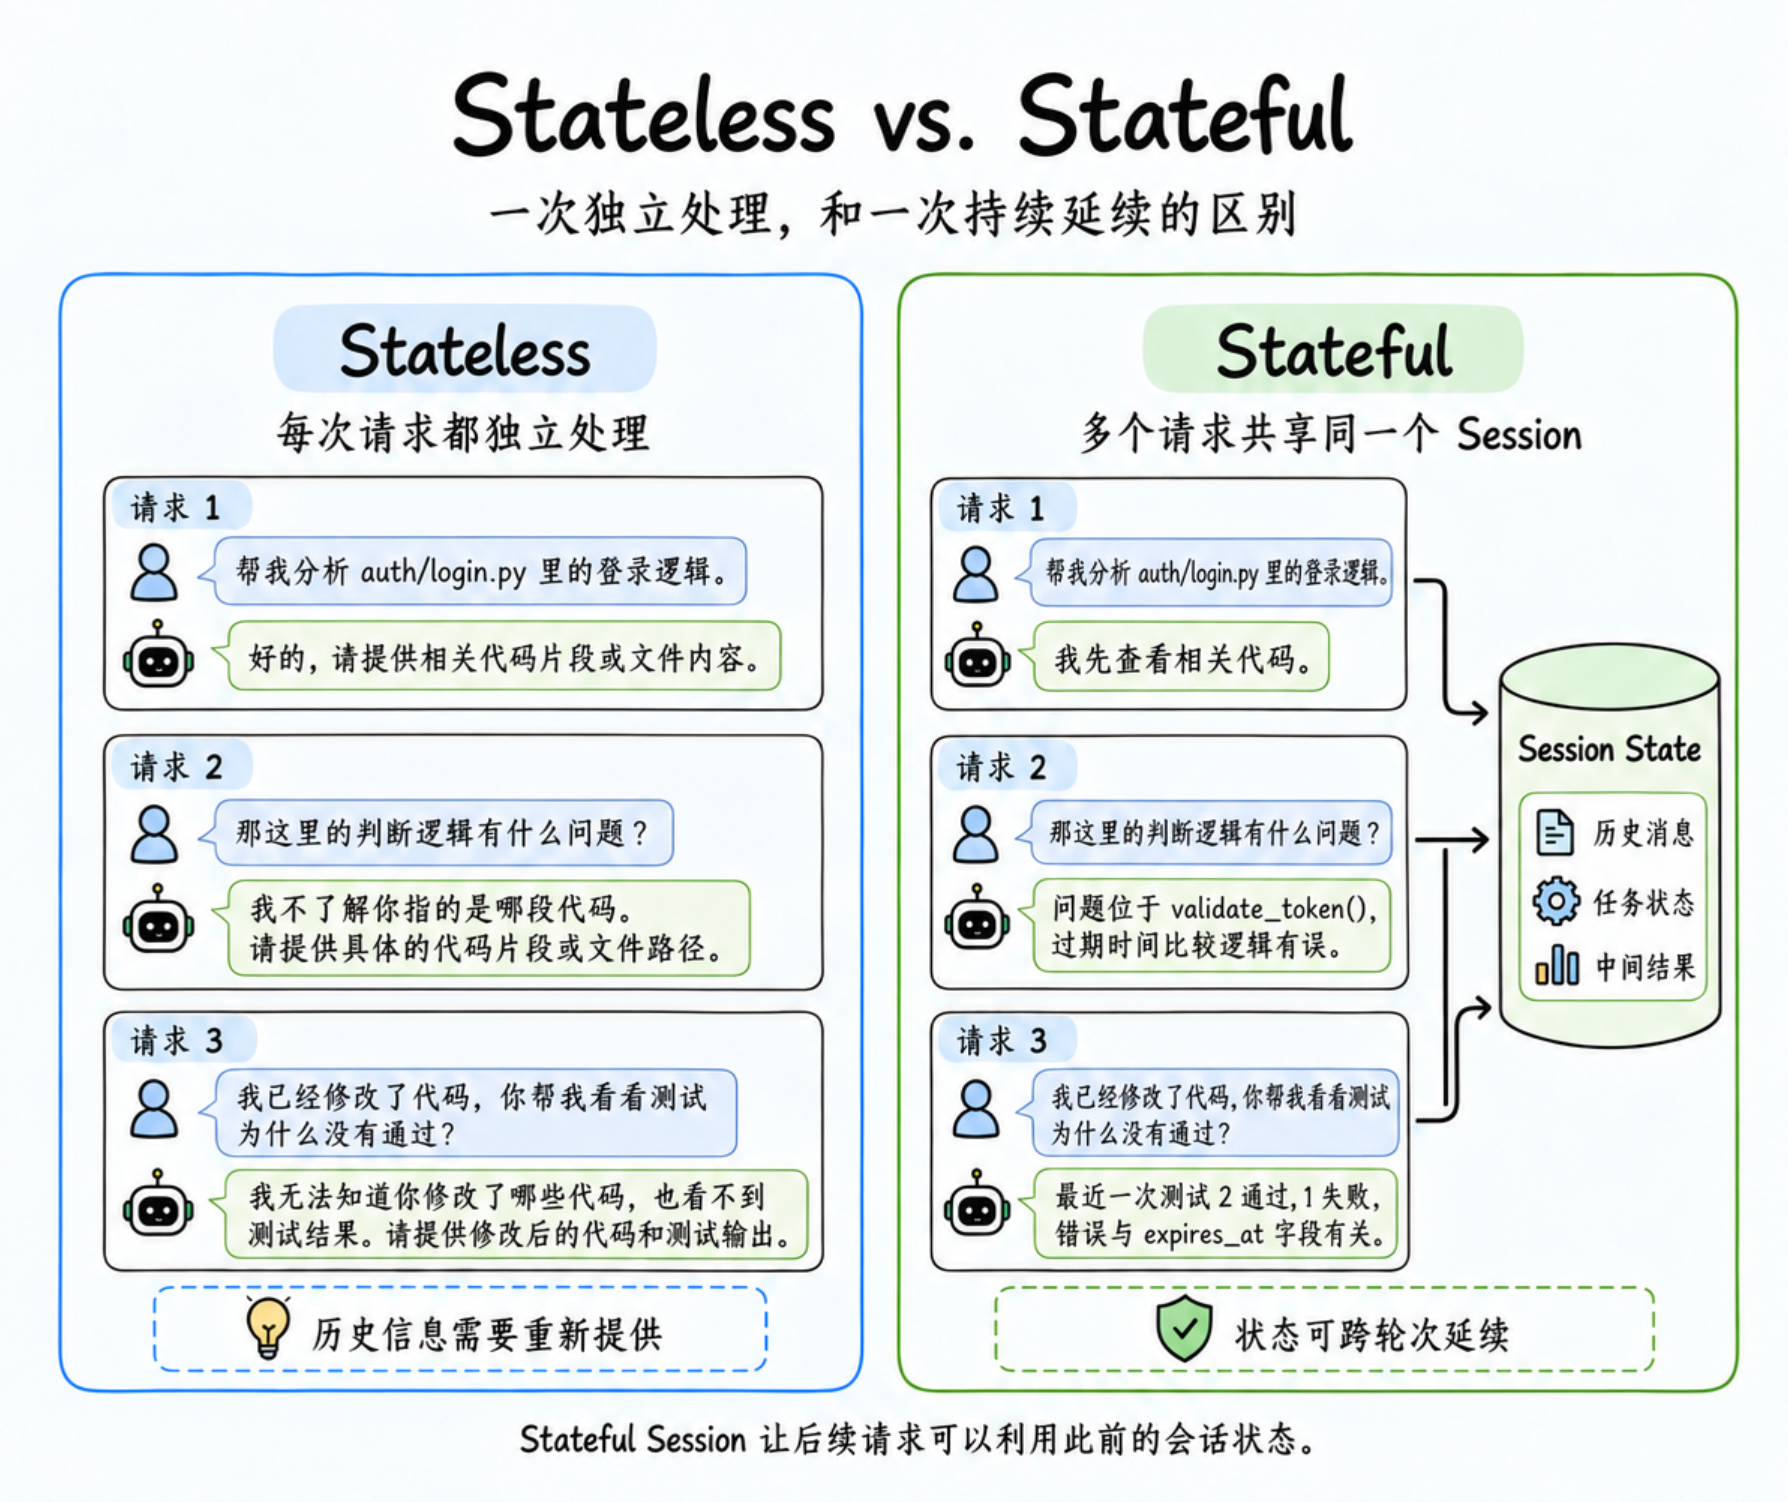
这里有个知识点:Stateful 描述的是会话状态能够持续维护,并不代表底层模型天然具备跨请求记忆。模型每次推理时仍然需要获得必要的上下文。会话状态的维护和传递,通常由模型之外的 Agent Runtime 负责。
一个 Session 里到底有什么?
对于普通 Chatbot,Session 中最常见的信息就是消息历史,包括用户说过什么、模型回答了什么。
但 Agent 的执行过程要复杂得多。一个 Coding Agent 在修复 Bug 时,可能需要读取源码、执行 Shell 命令、修改文件、运行测试,并根据工具返回结果调整下一步操作。
在这样的任务中,仅仅知道用户和 Agent 说过什么,未必足够。我们可以把 Session 需要维护的信息大致分为三类。
第一类是交互历史。这部分记录用户输入、模型回复以及工具调用相关消息。它能够帮助 Agent 理解当前指令与此前交互之间的关系。
比如用户说「继续修改刚才那个函数」,系统需要从历史记录中找到此前讨论的是哪个函数。
第二类是任务状态。这部分信息描述 Agent 当前正在完成什么任务,以及任务已经推进到哪个阶段。
例如:
任务:修复登录接口的 Token 过期问题

已完成:
- 分析 auth.py
- 定位 validate_token()
- 修改过期时间判断逻辑

当前状态:
- 测试运行失败
- 原因:测试数据缺少 expires_at 字段

下一步:
- 修复测试数据并重新验证
这些内容可以随着 Agent 执行不断更新。
第三类是中间结果。例如,Agent 从文件中提取的关键信息、某次工具调用的返回结果、已经生成的分析结论,或者后续步骤需要继续使用的数据。这些信息可能保存在消息历史中,也可能通过独立的状态字段或外部存储维护。
这里要注意一件事,那就是 Session 并没有统一的数据结构。有些系统只管理对话消息,有些系统还会将任务状态、执行结果等信息关联到会话中。
对于具备持续任务能力的 Agent,关键是能够找到后续执行需要的信息。
Session 的状态是怎么变化的?
前面讲了 Session 保存哪些信息,接下来看看这些状态是如何随着任务推进而变化的。
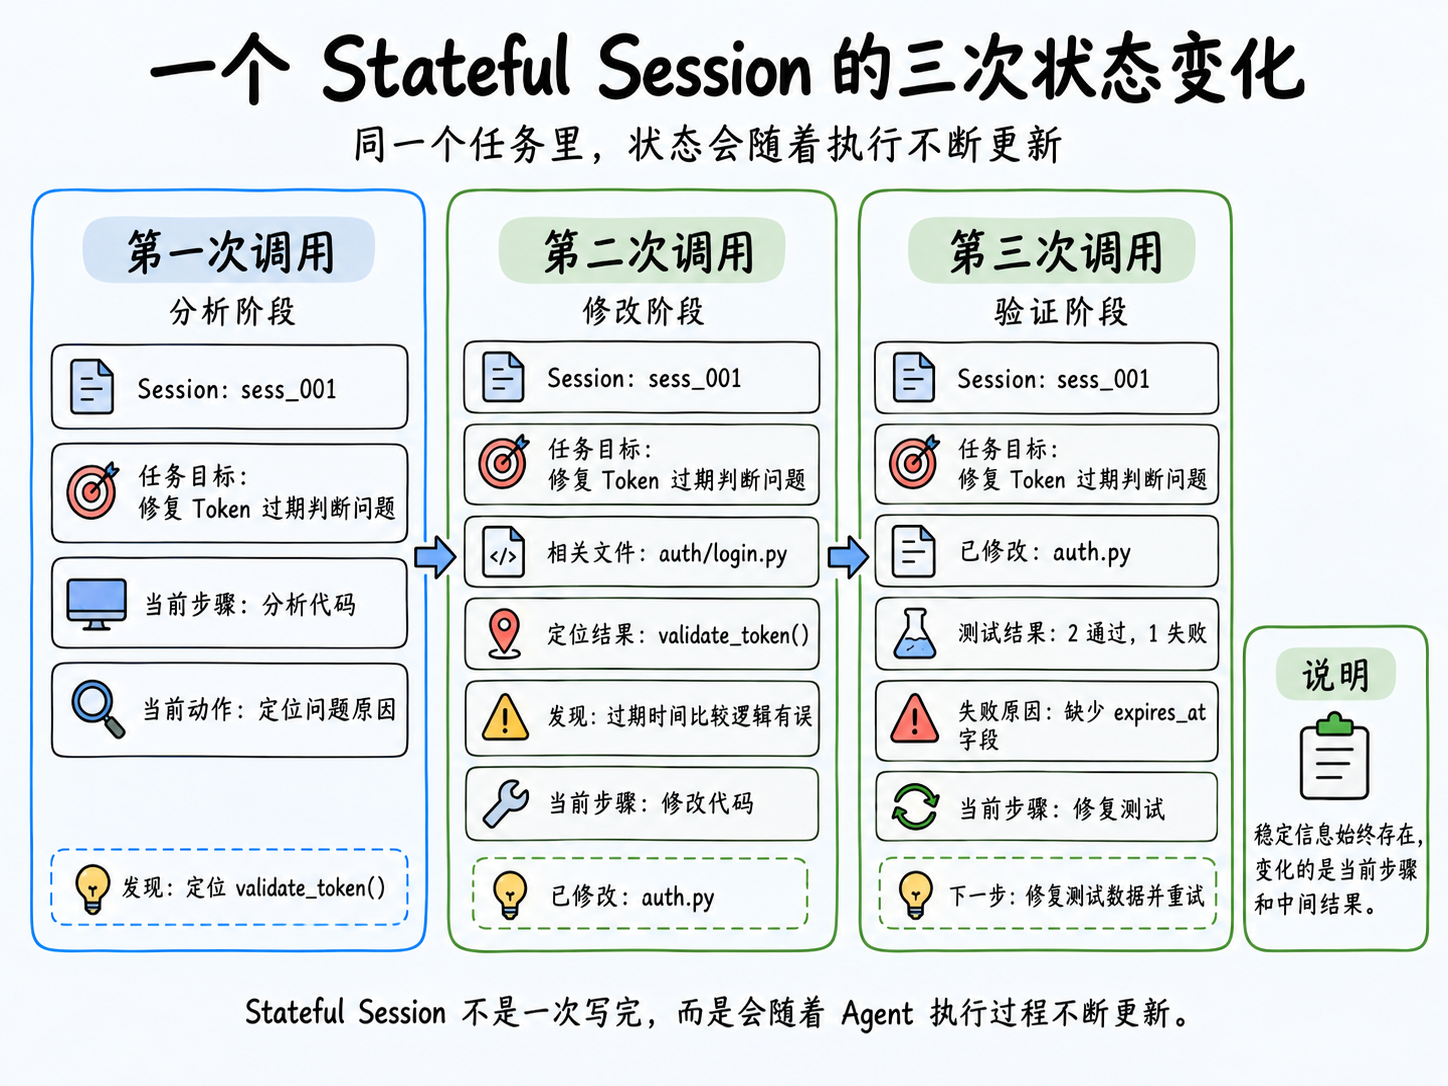
还是以修复登录接口中的 Token 过期问题为例。用户向 Agent 提出修复要求后,系统创建 Session,记录任务目标和初始状态。此时,Agent 还没有开始分析代码,Session 中的任务信息相对简单:
Session: sess_001

goal: 修复 Token 过期判断问题
status: running
current_step: 分析代码
Agent 读取相关文件后,发现过期时间判断逻辑存在问题。这时,系统可以更新任务状态:
Session: sess_001

goal: 修复 Token 过期判断问题
status: running
current_step: 修改代码

findings:
  - 问题位于 validate_token()
  - 过期时间比较逻辑存在错误
接着,Agent 修改代码并执行测试,但测试没有通过。Session 状态再次变化:
Session: sess_001

goal: 修复 Token 过期判断问题
status: running
current_step: 修复测试

modified_files:
  - auth.py

test_result:
  - 2 passed
  - 1 failed

next_action:
  - 检查测试数据中的 expires_at 字段
可以看到,同一个 Session 中,任务目标始终没有变化,但当前步骤、已完成操作和执行结果都在不断更新。这一过程可以概括为:
用户发起任务
      ↓
创建 Session
      ↓
读取当前状态
      ↓
模型推理 / 工具执行
      ↓
产生新的执行结果
      ↓
更新 Session State
      ↓
进入下一轮执行
在 Agent 的执行循环中,Runtime 会反复读取和更新 Session State。每轮执行前,Runtime 可以根据当前任务目标、执行进度和已有结果,为模型提供必要的信息;模型完成推理或工具调用后,新的执行结果又会被用于更新状态,供下一轮继续使用。
Session 的生命周期
Session 不会一直处于执行状态。在一个完整的任务过程中,它可能经历创建、运行、暂停、恢复和结束等阶段。
这些阶段对应着不同的状态管理需求。
创建与运行
当用户发起新任务时,系统可以创建 Session,建立会话标识和初始状态。随后,Agent 开始执行任务。每次模型推理、工具调用或者用户交互,都可能产生新的状态信息。
在这个阶段,Session 需要持续更新,让 Agent 能够根据已有进度决定下一步行动。
暂停与恢复
假设 Agent 已经完成代码修改,但执行测试之前需要用户确认。此时,系统可以将任务标记为等待状态,并保存必要信息:
session_id: sess_001

status: waiting_for_user
current_step: 等待测试确认

completed:
  - 已定位问题
  - 已修改 auth.py

pending:
  - 运行测试
用户稍后返回,确认继续执行。
Runtime 读取 Session 中保存的状态,就能够知道任务已经完成代码修改,接下来需要执行测试。不过,暂停后能否恢复,还取决于状态有没有被持久化保存。如果 Session 只存放在当前进程的内存中,那么进程结束后,状态可能随之丢失。如果系统将 Session 状态写入数据库、文件或其他持久化存储,就可以在之后重新加载这些信息。
这里需要区分两个概念:
- Stateful:会话能够在多次交互之间维护状态。
- Persistent:状态能够保存到持久化存储中,在原有运行进程结束后仍可读取。
一个 Session 可以是 Stateful 的,但未必具备持久化能力。另外,即使系统持久化了 Session,也需要看具体保存了哪些状态。
例如,只保存对话历史,可以帮助 Agent 恢复此前的交互背景;如果还保存了工作流的执行位置和必要的中间结果,就可能进一步支持从特定步骤继续任务。
因此,能够继续对话和能够恢复任务执行,是不同层次的能力。
结束与清理
当 Agent 完成任务,或者用户主动结束会话时,Session 可以进入结束状态。
不过,结束之后是否立即删除状态,需要由系统决定。例如,一些应用会保留历史 Session,方便用户以后查看任务记录;另一些临时任务可能只需要在执行期间维护状态,完成后即可清理。
还有些 Session 会设置有效期,超过一定时间后自动过期。所以,Session 的生命周期和状态的实际保存时间也不一定完全相同。
Stateful Session 和 Context、Memory 的关系
看到这里,可能会产生一个疑问:既然 Session 已经保存了对话历史和任务状态,那它与 Context、Memory 又有什么区别?
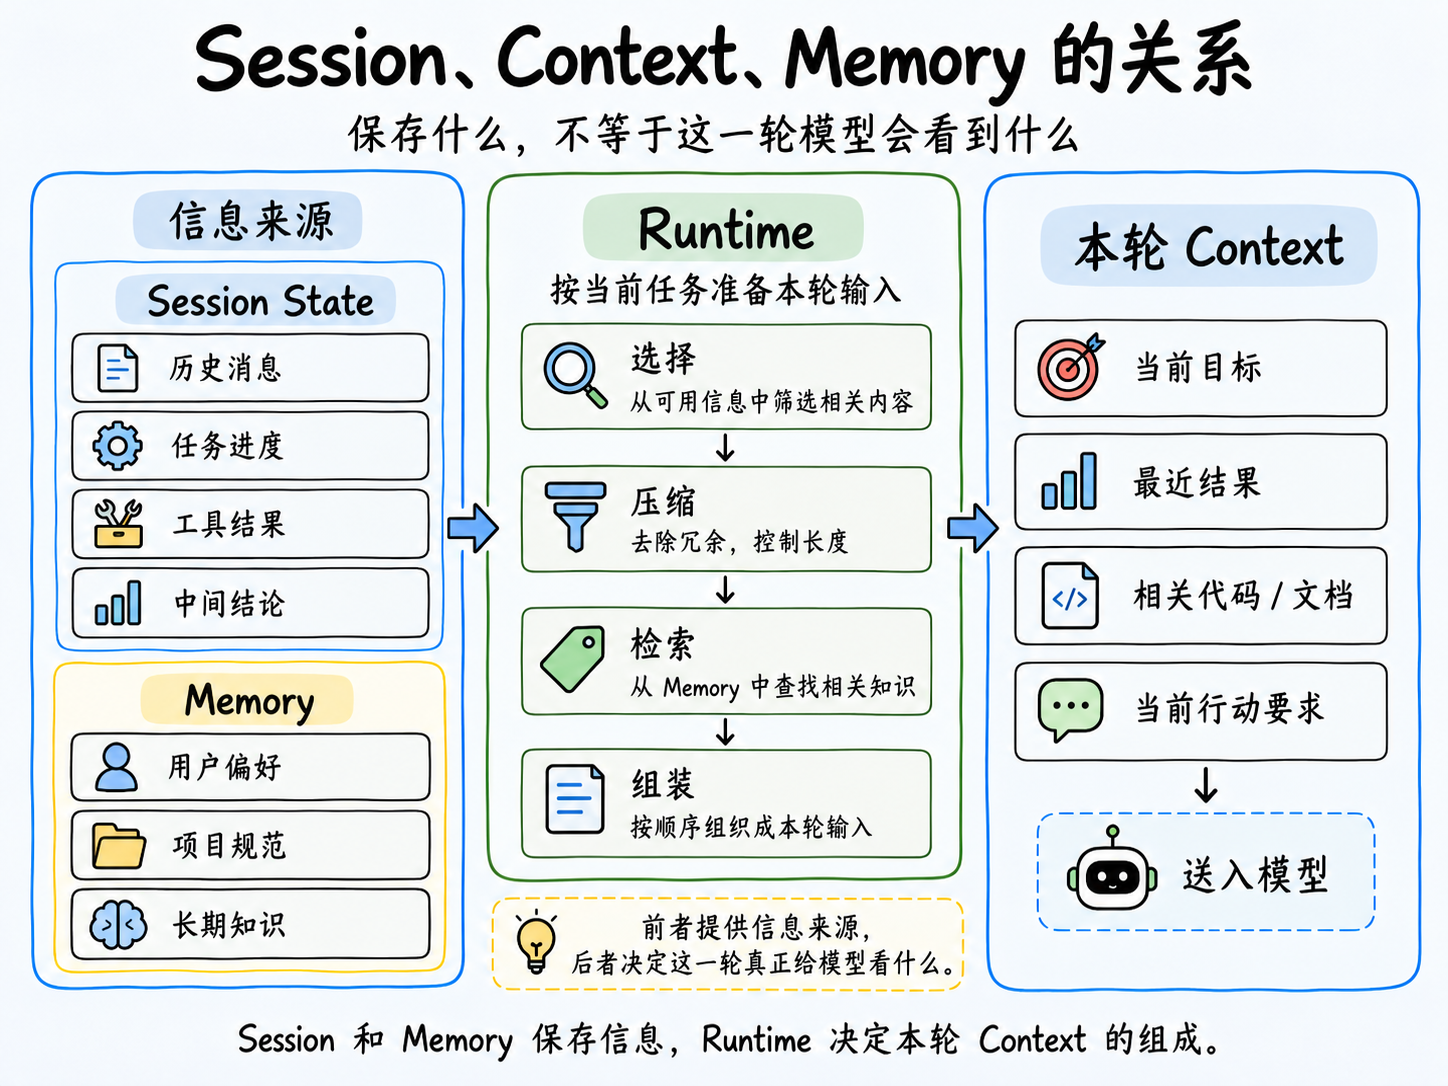
我们之前讲过,Context 是模型在一次推理中实际能够看到的信息。例如,Agent 当前要分析一个测试失败的问题,Runtime 可能会将任务目标、相关代码、最近一次报错和必要的历史记录放进模型输入。
但 Session 中保存的信息可能远远超过这些内容。一个 Agent 运行了几十轮,Session 里已经积累大量工具结果和历史记录。如果每次调用模型都把全部信息带上,很快就会遇到上下文窗口限制。
所以,Session 中有多少信息,和模型这一轮能够看到多少信息,是两回事。
可以这样理解:
- Session State:系统为当前会话维护了哪些状态。
- Context:本次模型推理实际获得了哪些信息。
- Memory:系统能够长期保留、并在需要时重新利用哪些信息。
例如,Agent 正在修改一个软件项目。Session 维护当前任务的进度,包括修改了哪些文件、哪些测试已经通过。Context 则包含当前这一步需要的代码、错误信息和任务要求。Memory 可能记录用户长期使用的代码风格、项目约定或过去积累的经验,以便在其他任务或新会话中继续使用。
当然,这些概念在不同 Agent 系统中的实现边界可能有所区别。Memory 也可能被划分为会话内的短期记忆,以及跨会话使用的长期记忆。
更重要的是理解它们在信息生命周期中的不同作用。这也解释了为什么 Agent 即使拥有 Stateful Session,依然需要上下文管理。
Session 可以保存大量历史,但模型每次推理仍然只能处理当前输入。Runtime 需要从已有状态中选择、压缩或检索相关信息,再组织成本轮 Context。
有了 Stateful Session,就能随时恢复任务吗?
最后还有一个容易混淆的问题。
假设 Coding Agent 执行任务时已经修改了三个文件,但在运行测试之前突然中断。如果 Session 保存了之前的任务状态,Agent 重新运行时,可以知道哪些文件已经修改、当前应该执行什么步骤。
但这并不意味着它能够恢复到中断前的所有细节。
例如,Agent 可能已经启动了某个进程,或者在外部系统中执行过一次操作。这些外部环境的变化,未必包含在 Session State 中。
如果运行环境已经被重置,Agent 即使恢复了任务信息,也可能需要重新检查文件、启动进程或获取外部数据。同样,如果某个工具调用已经完成,但执行结果还没来得及保存,恢复后的 Agent 可能无法直接判断这次操作是否成功。
因此,Session 状态恢复的范围,取决于系统实际保存了什么,以及外部工作环境是否仍然可用。对于需要执行长任务的 Agent,Session 通常还需要与执行状态持久化、环境管理等机制配合,才能提供更完整的任务恢复能力。
这也是 Stateful Session 的一个重要边界:它可以帮助 Agent 延续任务,但无法单独保证整个运行环境都恢复到之前的状态。
小结
Stateful Session 让 Agent 能够在多次交互之间维护会话状态,保留对话历史、任务进度和必要的中间结果。随着任务推进,这些状态会不断更新,并在后续交互中被重新读取和使用。
结合持久化存储,Session 还可以在进程结束后重新加载已有状态。如果需要恢复更复杂的执行过程,则需要进一步考虑执行位置和外部环境。
对于需要持续执行任务的 Agent,Stateful Session 提供了会话连续性的基础,让 Agent 能够利用此前积累的信息,沿着已有的任务进度继续工作。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号