你的游戏本身就是脚手架:如何让 AI Agent 读懂游戏并十倍加速迭代?

你的游戏本身就是脚手架:如何让 AI Agent 读懂游戏并十倍加速迭代?
leikooo
发布于 2026-10-15 21:41:58
发布于 2026-10-15 21:41:58
作者:Kyle Kukshtel(独立游戏《Cantata》制作人、Depot 游戏数据编辑器作者、15 年资深游戏工程师)
序言:从 Web 的丝滑到游戏的撞墙
我想聊一聊在真实的游戏开发中如何使用大语言模型。我指的不是那些在社交媒体上看起来很炫酷、但仅能一键生成玩具项目的「One-shot」型 Demo,而是真正的全职研发,那种你每周工作 5 天、每天扎实写上 8 个小时代码的工程环境。
在深入正题之前,我认为有必要先在 LLM 的认知上达成共识,或者至少厘清一些基本常识,这样后续的内容才不至于显得突兀。对于不少已经熟悉这一领域的开发者来说,这部分或许只是温故知新;如果你只想直奔干货,可以直接向下划到下一章节。
我将 LLM 引入日常开发工作的旅程,始于我做的一个名为 mood.site 的情绪板网站。那时行业里还根本没有所谓的「智能体」概念,我当时纯粹只是想测试一下当时的 ChatGPT 究竟能不能写出像样的代码。用过最开始 GPT 的了解,当时如果用 web 端编码是非常原始笨拙。体验虽然痛苦,但结果却令我眼前一亮。尽管当时我依然需要自己手动核验相当多的逻辑,但那次体验足以彻底将我转化为 AI 编程的信徒。如果没有 LLM,我绝不可能在那么短的时间内把它做出来(利用晚上下班时间,耗时约 2 到 3 周,累计大约 20 个小时)。如果是纯靠自己从零手敲,我可能到今天还在折腾它的第一个版本。
从那之后,mood 成为了我在 LLM 技术演进过程中的试验田,并激励我启动了许多采用类似技术栈的新项目。此外,随着 Claude Code 以及后续顶尖 Claude 模型的诞生,LLM 的工程能力迎来了质的飞跃。以我个人的亲身体验而言,我认为当面对一个现代 Web 技术栈时,LLM 几乎没有什么做不到的事情。
看到这里,人们很容易得出「LLM 已经无所不能」的结论,毕竟当今软件工程的大半壁江山都是 Web 软件。然而,每当我试图把 LLM 应用于构建任何非 Web 的游戏开发场景时,事情就变得不一样了:
LLMs are Bad At Games 幻灯片
大语言模型根本不擅长做游戏
每次我尝试让 LLM 去处理与游戏相关的系统时,它几乎必定会原地翻车。
这可能包含我个人的职业偏见。我已经做了近 15 年的游戏程序员,自认为对游戏底层的运转逻辑了如指掌,我能在一英里外一眼嗅出糟糕的游戏代码长什么样。但如果是 Svelte (Svelte 是新一代的 Web 前端框架)编写的 Web 应用,我的涉猎显然没那么深,所以我更容易倾向于觉得 LLM 写出来的 Web 代码「还挺不错的」。也许它在资深前端眼里其实也是一堆垃圾?但我们确实有充分的理由相信,LLM 产出的 Svelte 和 Web 全栈代码质量客观上更高,这很大程度上得益于开源世界中存在着海量高质量的 Web 开源项目供模型训练。相比之下,公开可供训练的高质量游戏源码数量,其量级要少上好几个数量级。
不仅如此,游戏内部还包含着浩如烟海的非代码内容。游戏绝不仅仅是将静态图片和文字摆放到页面布局中那么简单。游戏世界里有大量根本无法简单用代码表征的复杂资产。更致命的是,在此之上,游戏依然需要处理所有类似于 Web 排版布局的事情,但这仅仅是游戏不得不处理的 100 多个独立子系统中的冰山一角而已。
这也是为什么许多开发者热衷于用 Three.js 来制作 AI 演示游戏的原因之一:他们可以非常轻松地把所有资产全部抽象为基础的几何方块,从而跳过游戏研发中通常不可或缺的资产生成、格式适配与管线预处理。其代价就是,很多此类作品充斥着浓郁的「工业垃圾」味,因为除了 LLM 预训练集的中庸风格之外,它们没有任何真正的作者表达。
然而,这套思路并非完全一无是处。
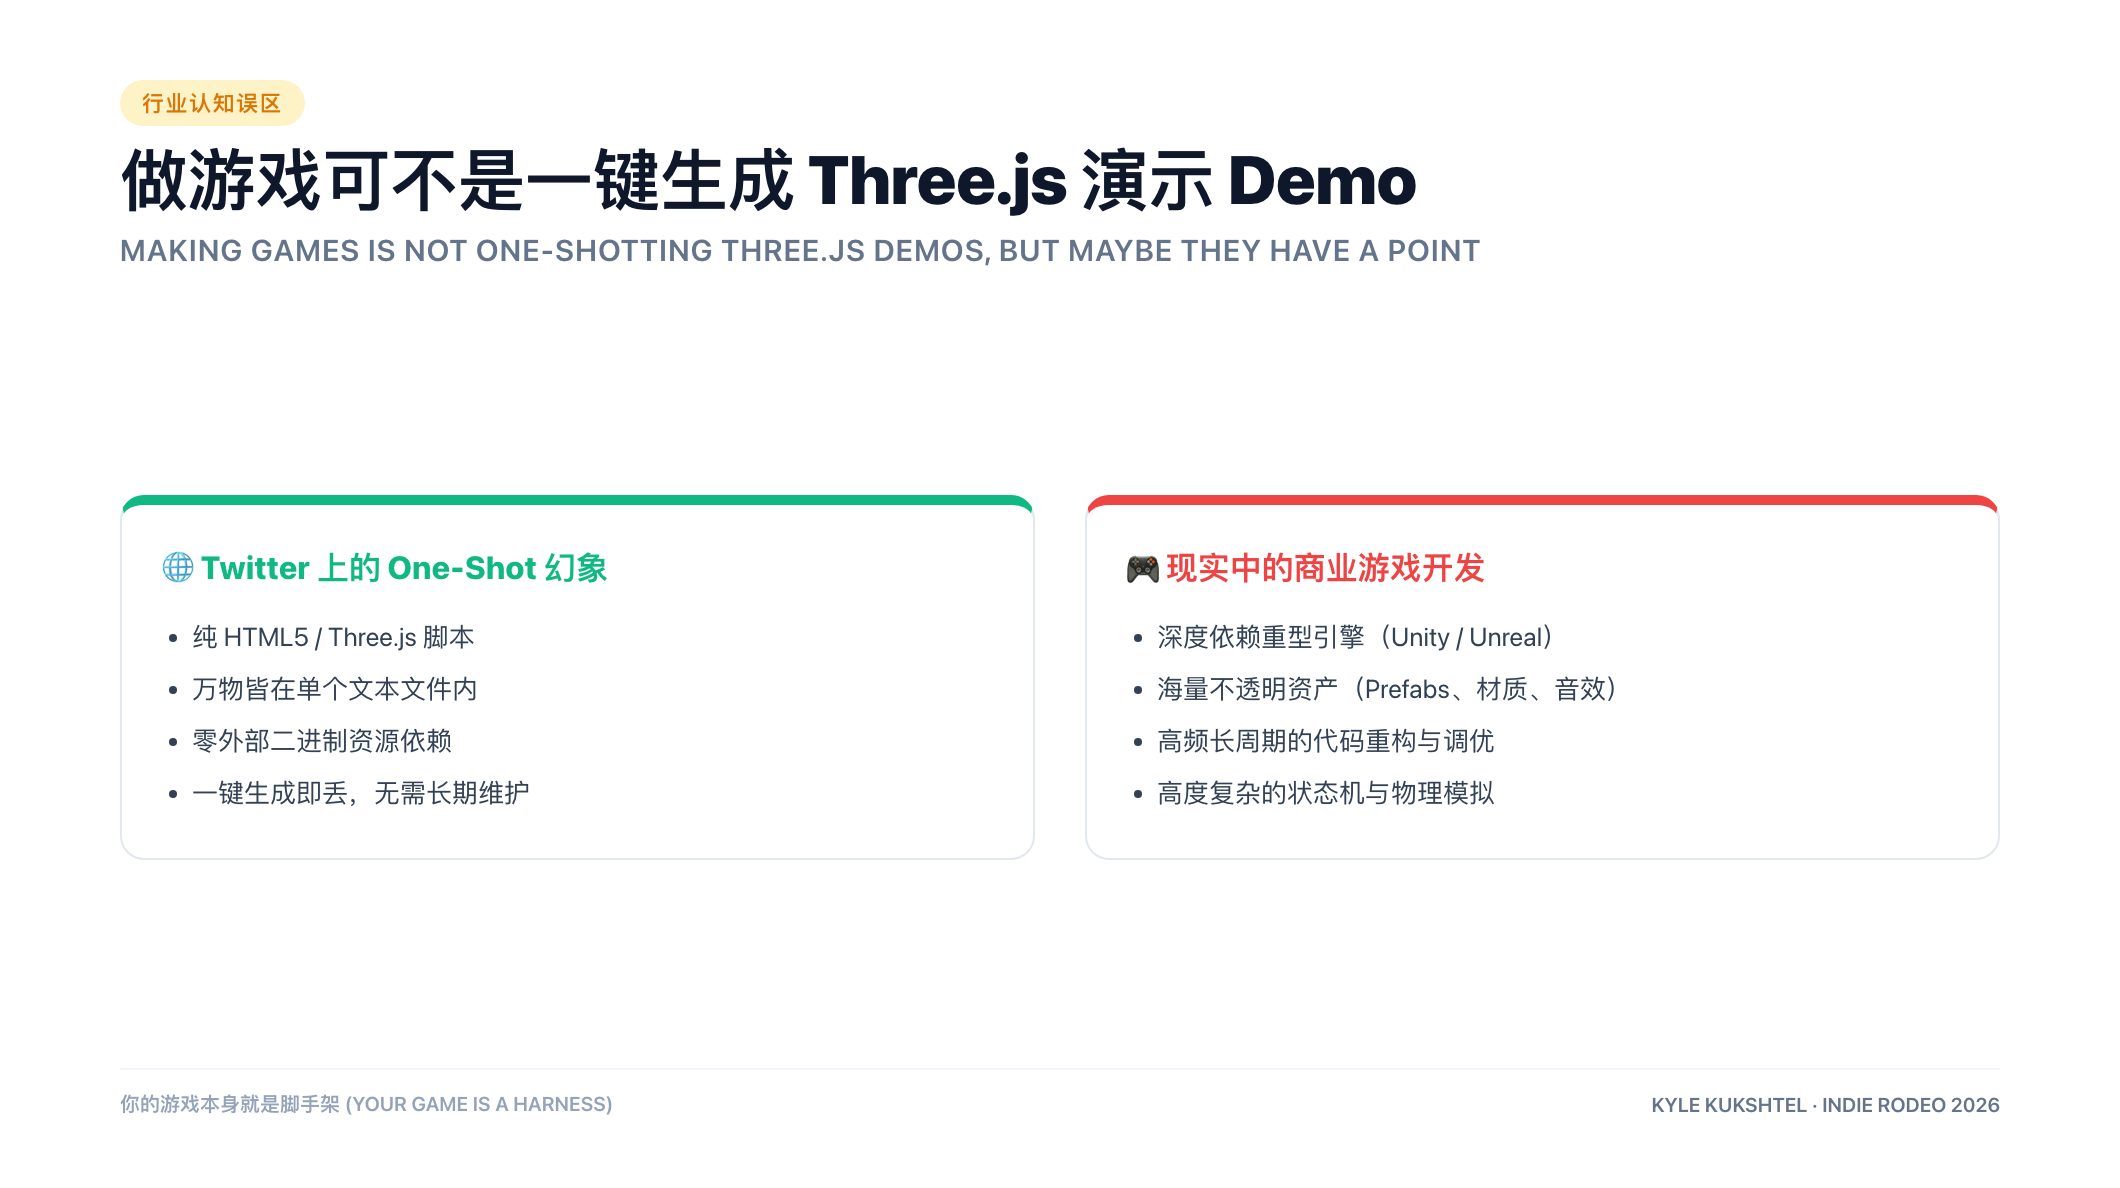
Three.js:一切皆代码
One-shot Three.js 工作流的核心逻辑(以及 LLM 构建 Web 应用的高超熟练度)在于:一切皆代码。当万物皆以纯文本代码的形式存在时,LLM 就能极其轻松地理解上下文、进行推演并执行修改。
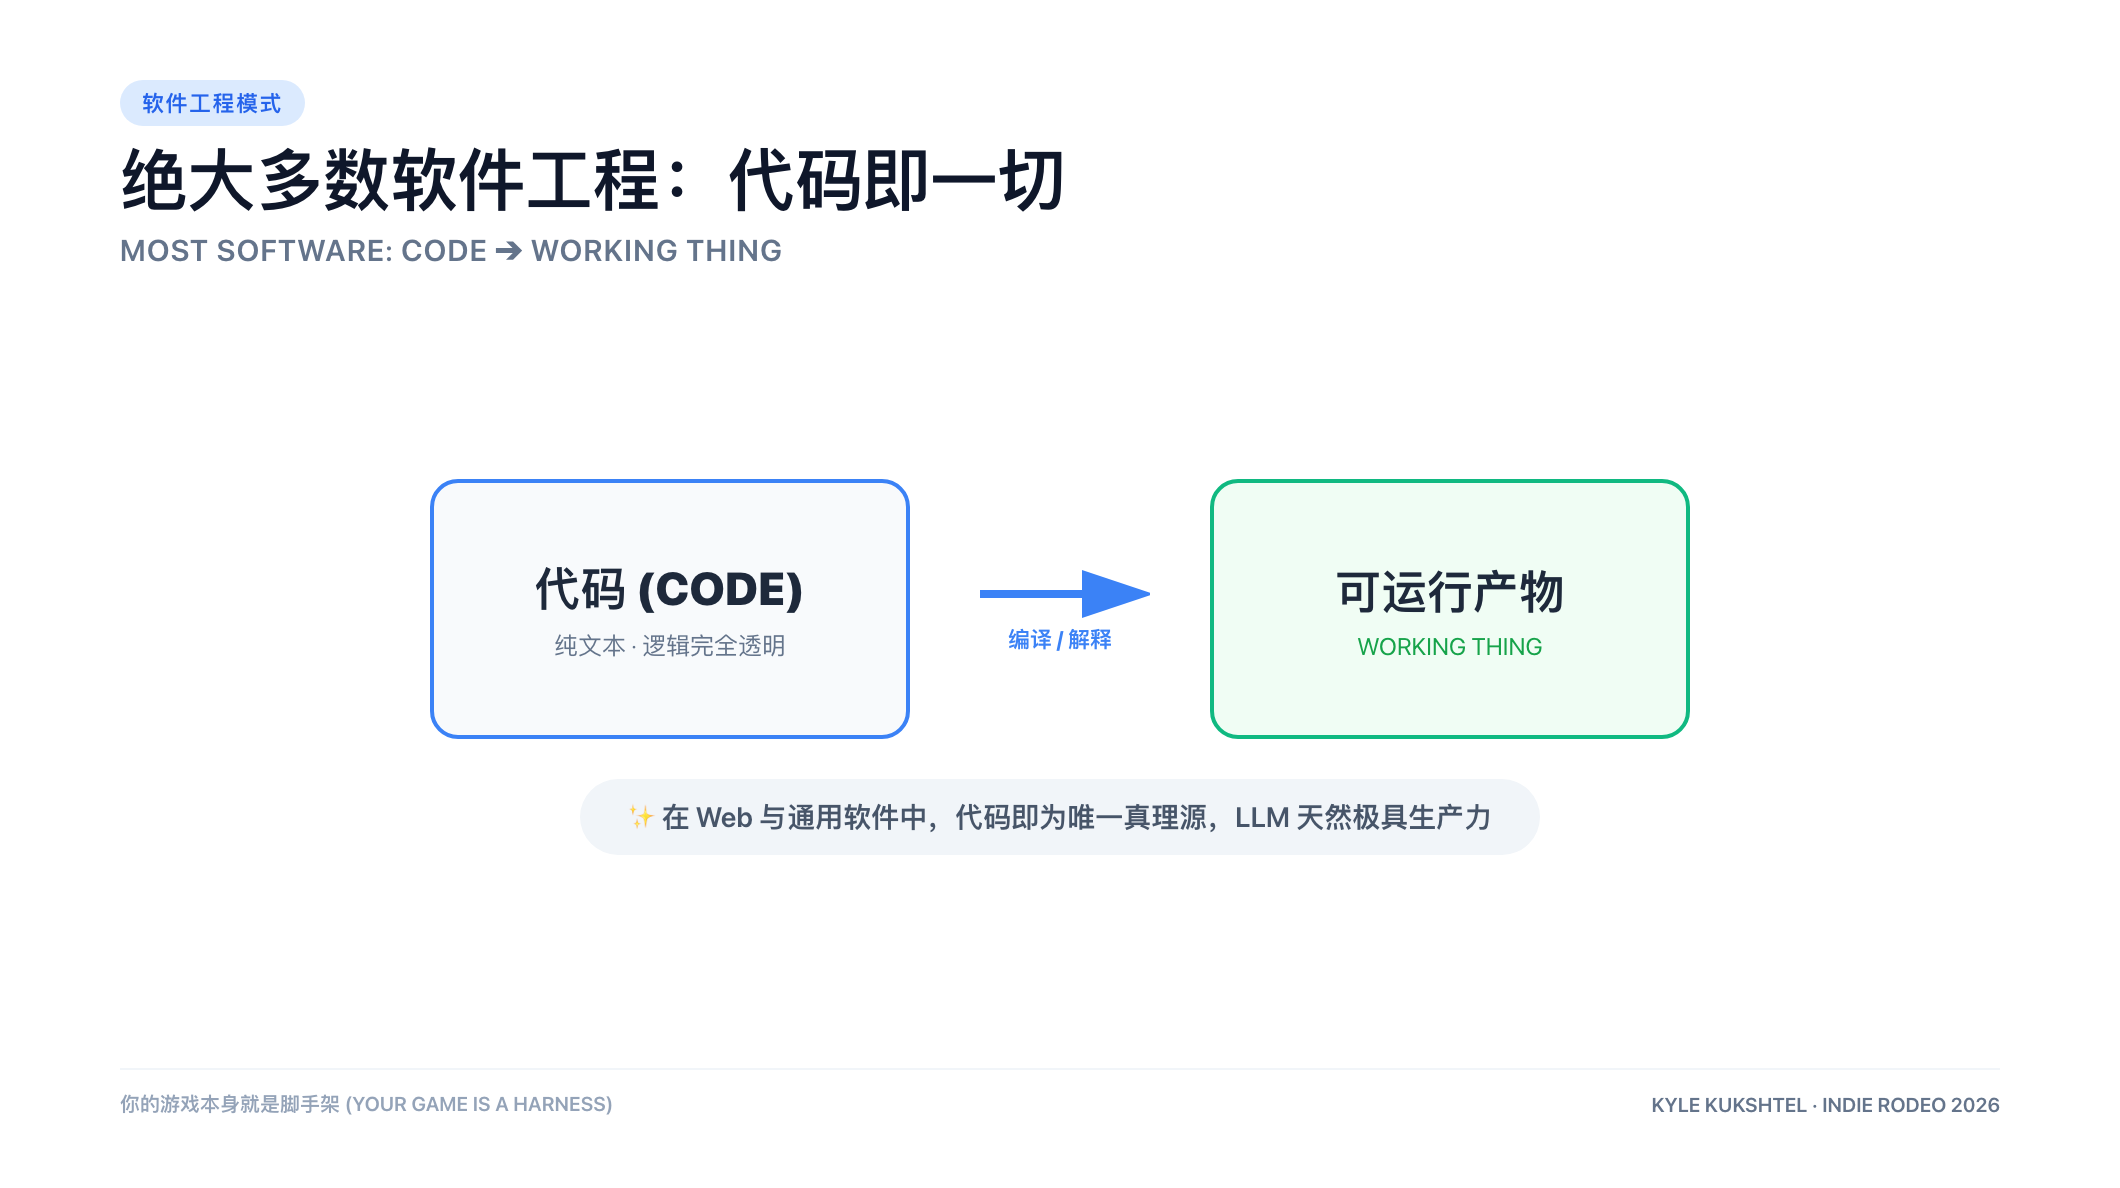
传统游戏:代码只是冰山一角
然而,对于传统游戏开发而言,情况根本不是这样。或者说,代码远不是全部的故事。游戏当然有代码,但还包含着极多非代码资产。这意味着,游戏中存在着大量对 LLM 而言完全不透明的关键组件。如果你的游戏核心逻辑依赖于操纵与转换这些大模型看不见的黑盒资产,那么 LLM 在尝试修改你的游戏时必定会当场崩溃。
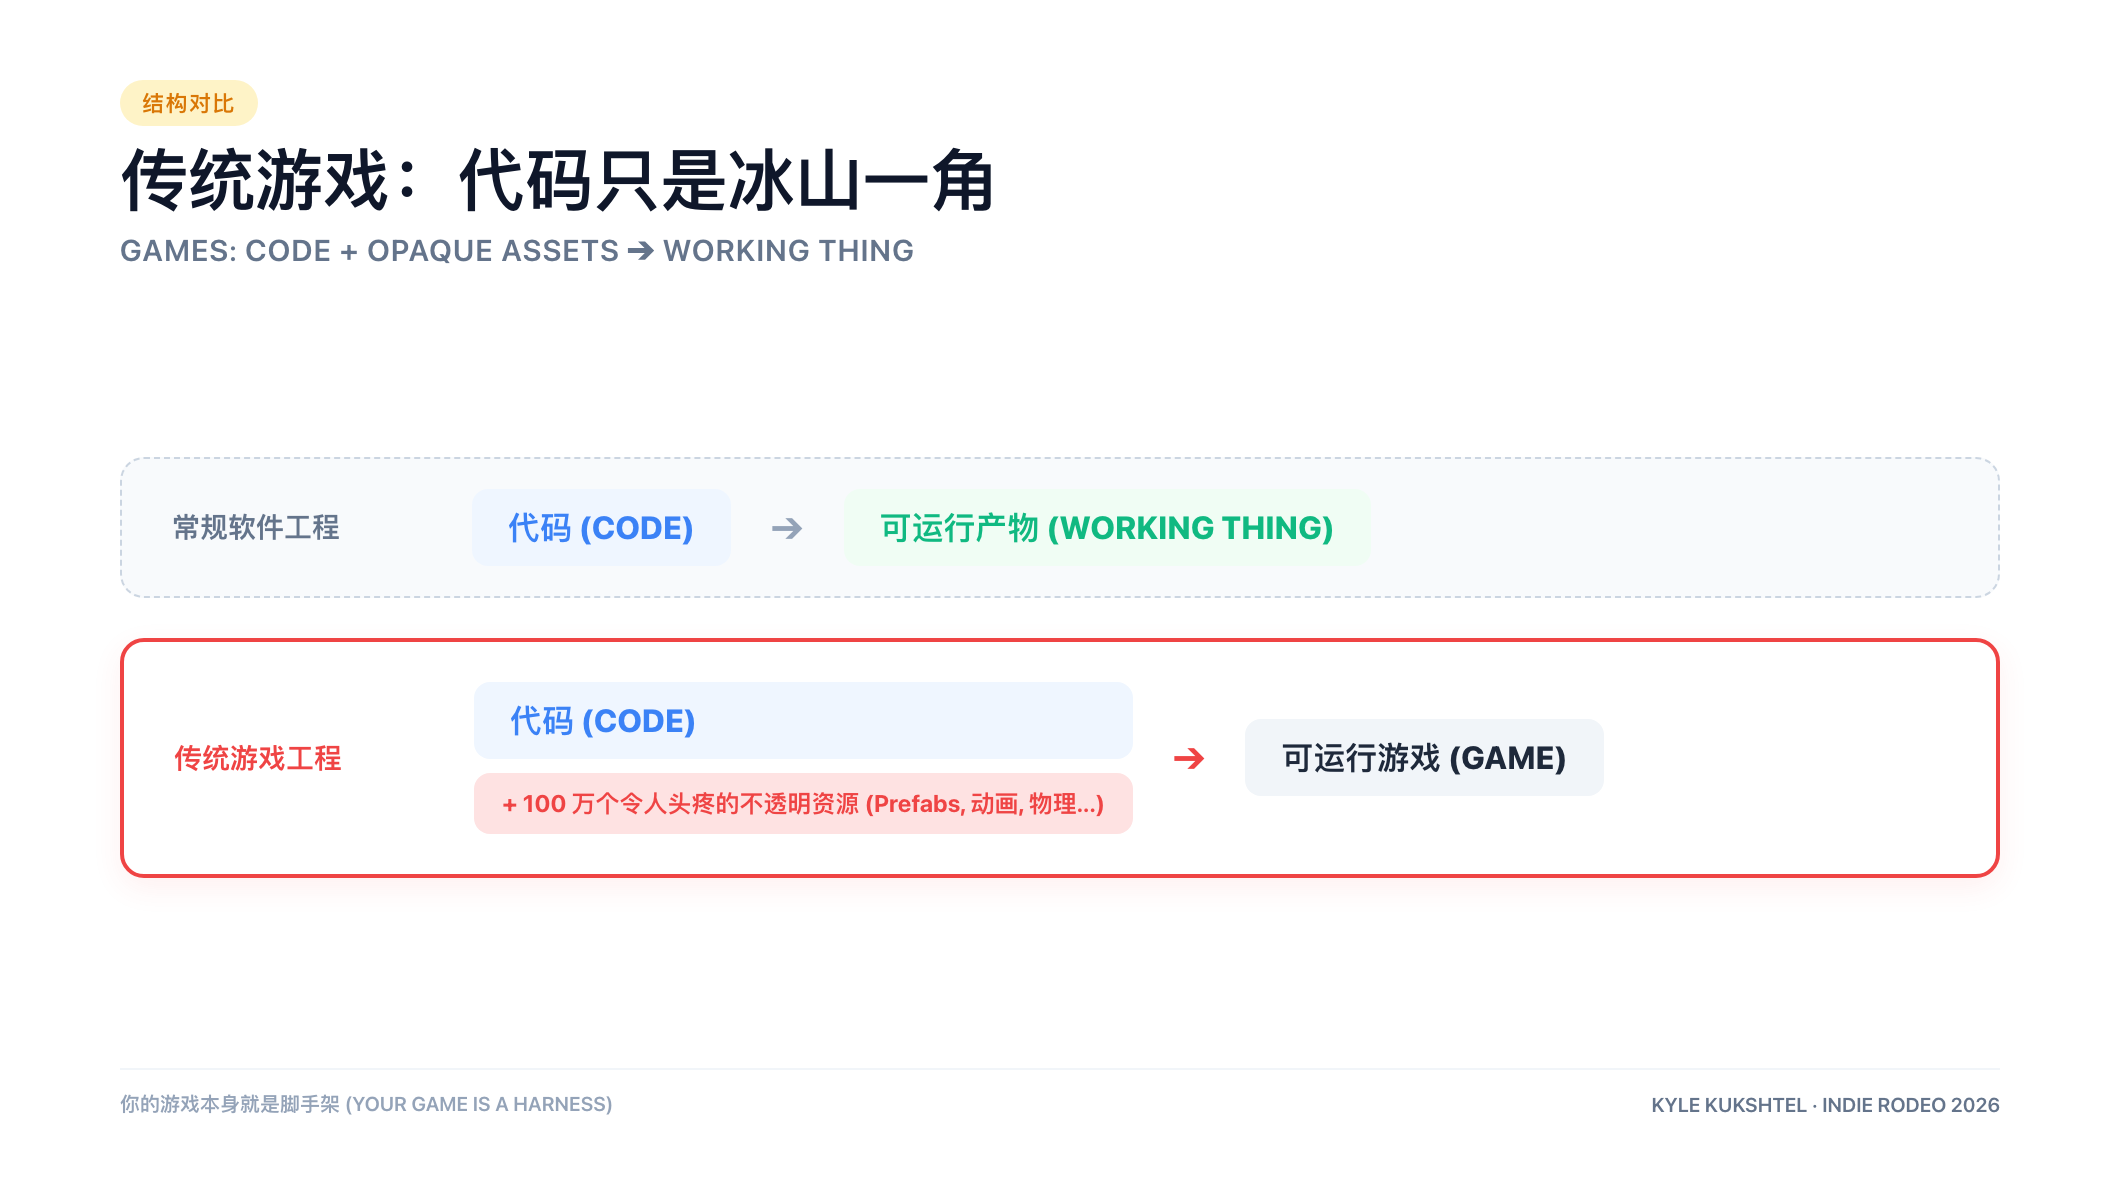
社区普遍结论:LLMs 在游戏开发中没用
我认为很多游戏开发者在前阵子都尝试过使用 LLM,并且无一例外地一头撞上了这堵南墙。「LLM 很烂/在游戏里根本派不上用场」的舆论呼声由此应运而生。
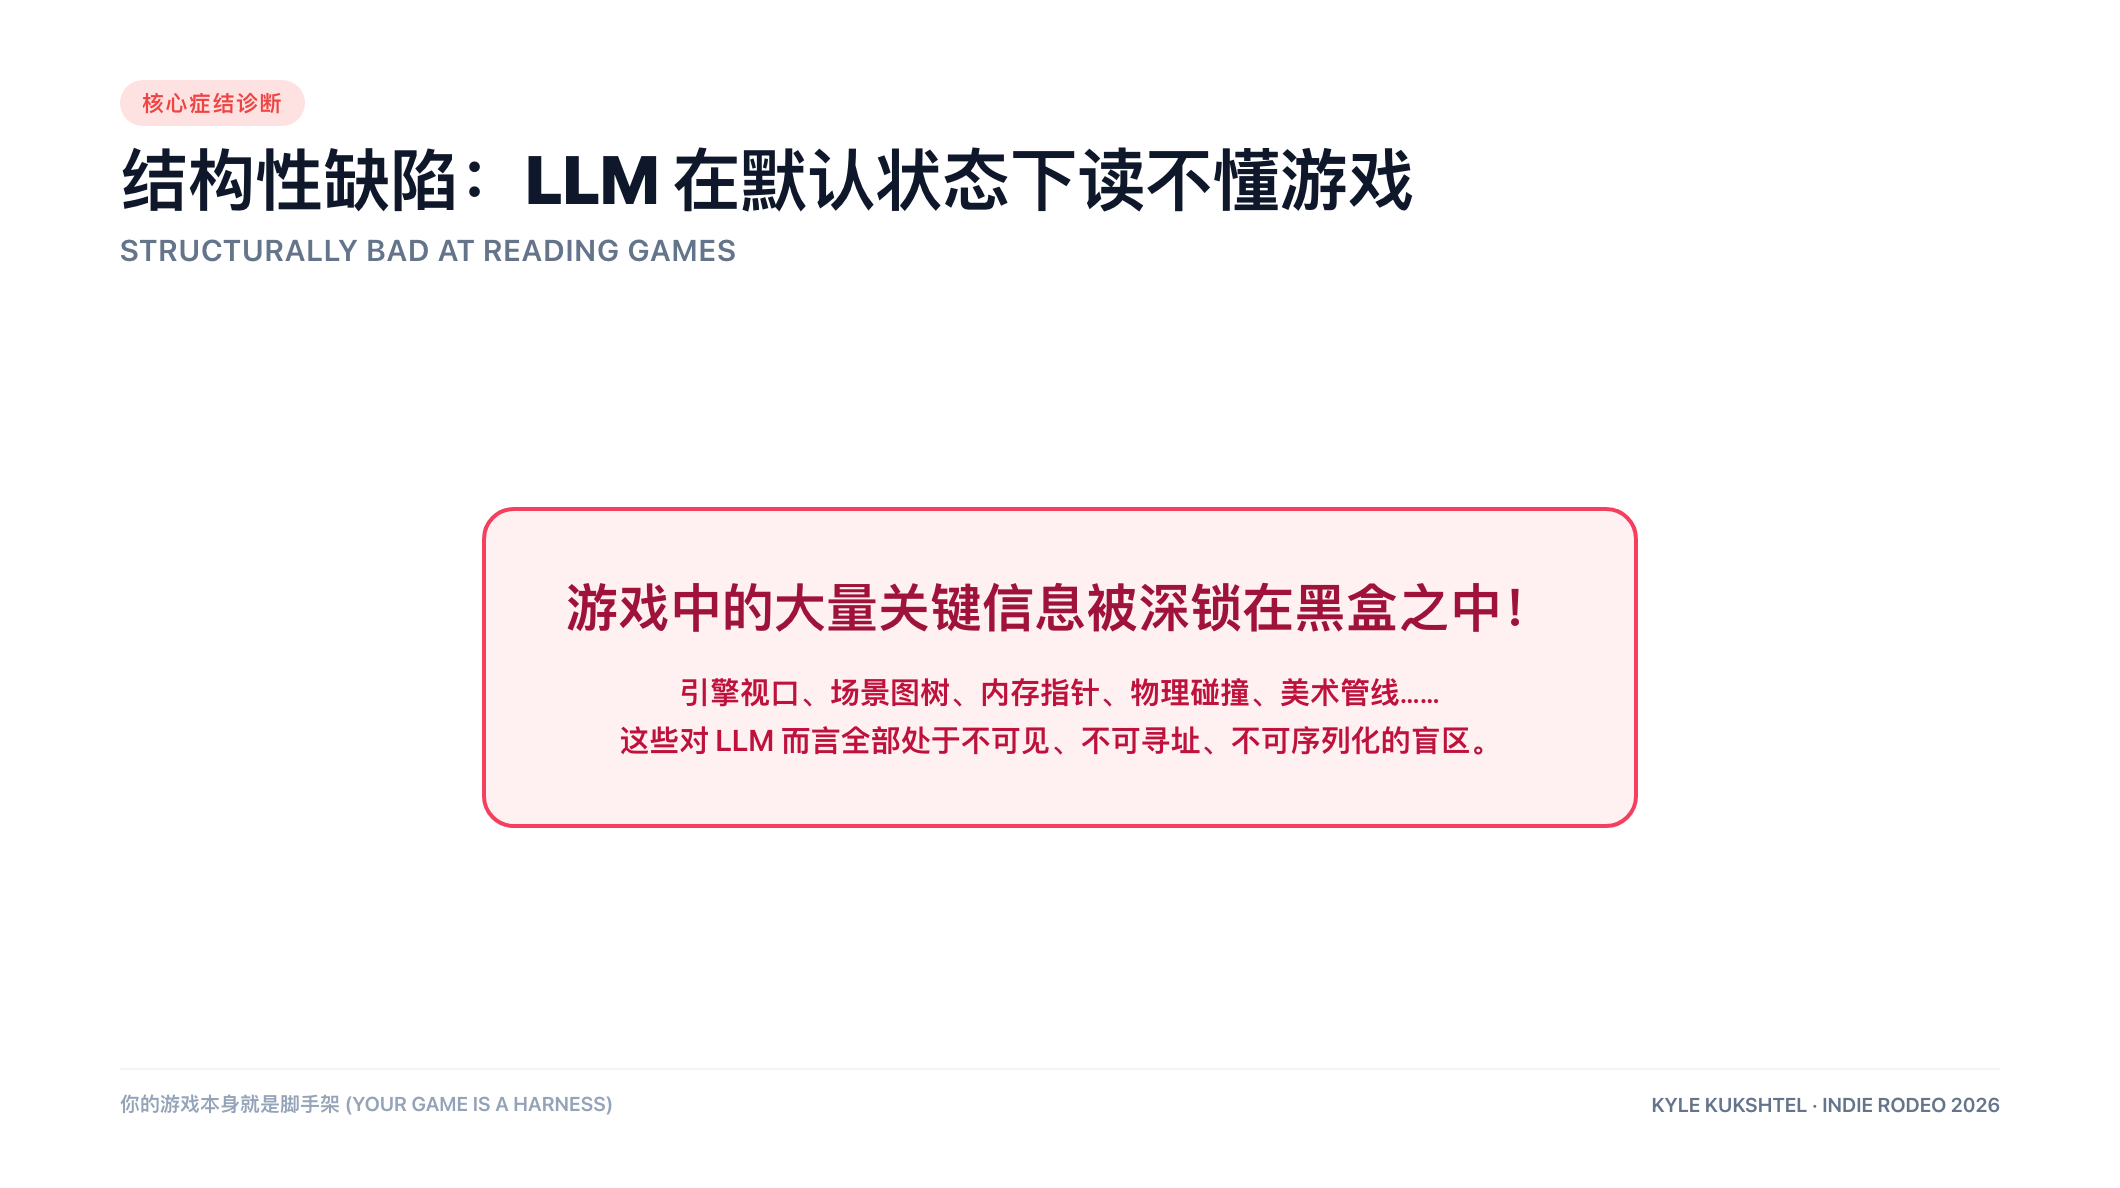
结构性缺陷:LLM 在默认状态下读不懂游戏
简而言之:从底层结构来看,LLM 在默认状态下根本读不懂游戏。
大语言模型极简常识与上下文管理
让我们进一步剖析其中的根本原因,以及我们究竟该如何逆转这一局面。
向任何 LLM 服务发起的一次提示词调用,本质上都可以拆解为三个基本组件:系统提示词、助手提示词和用户提示词。
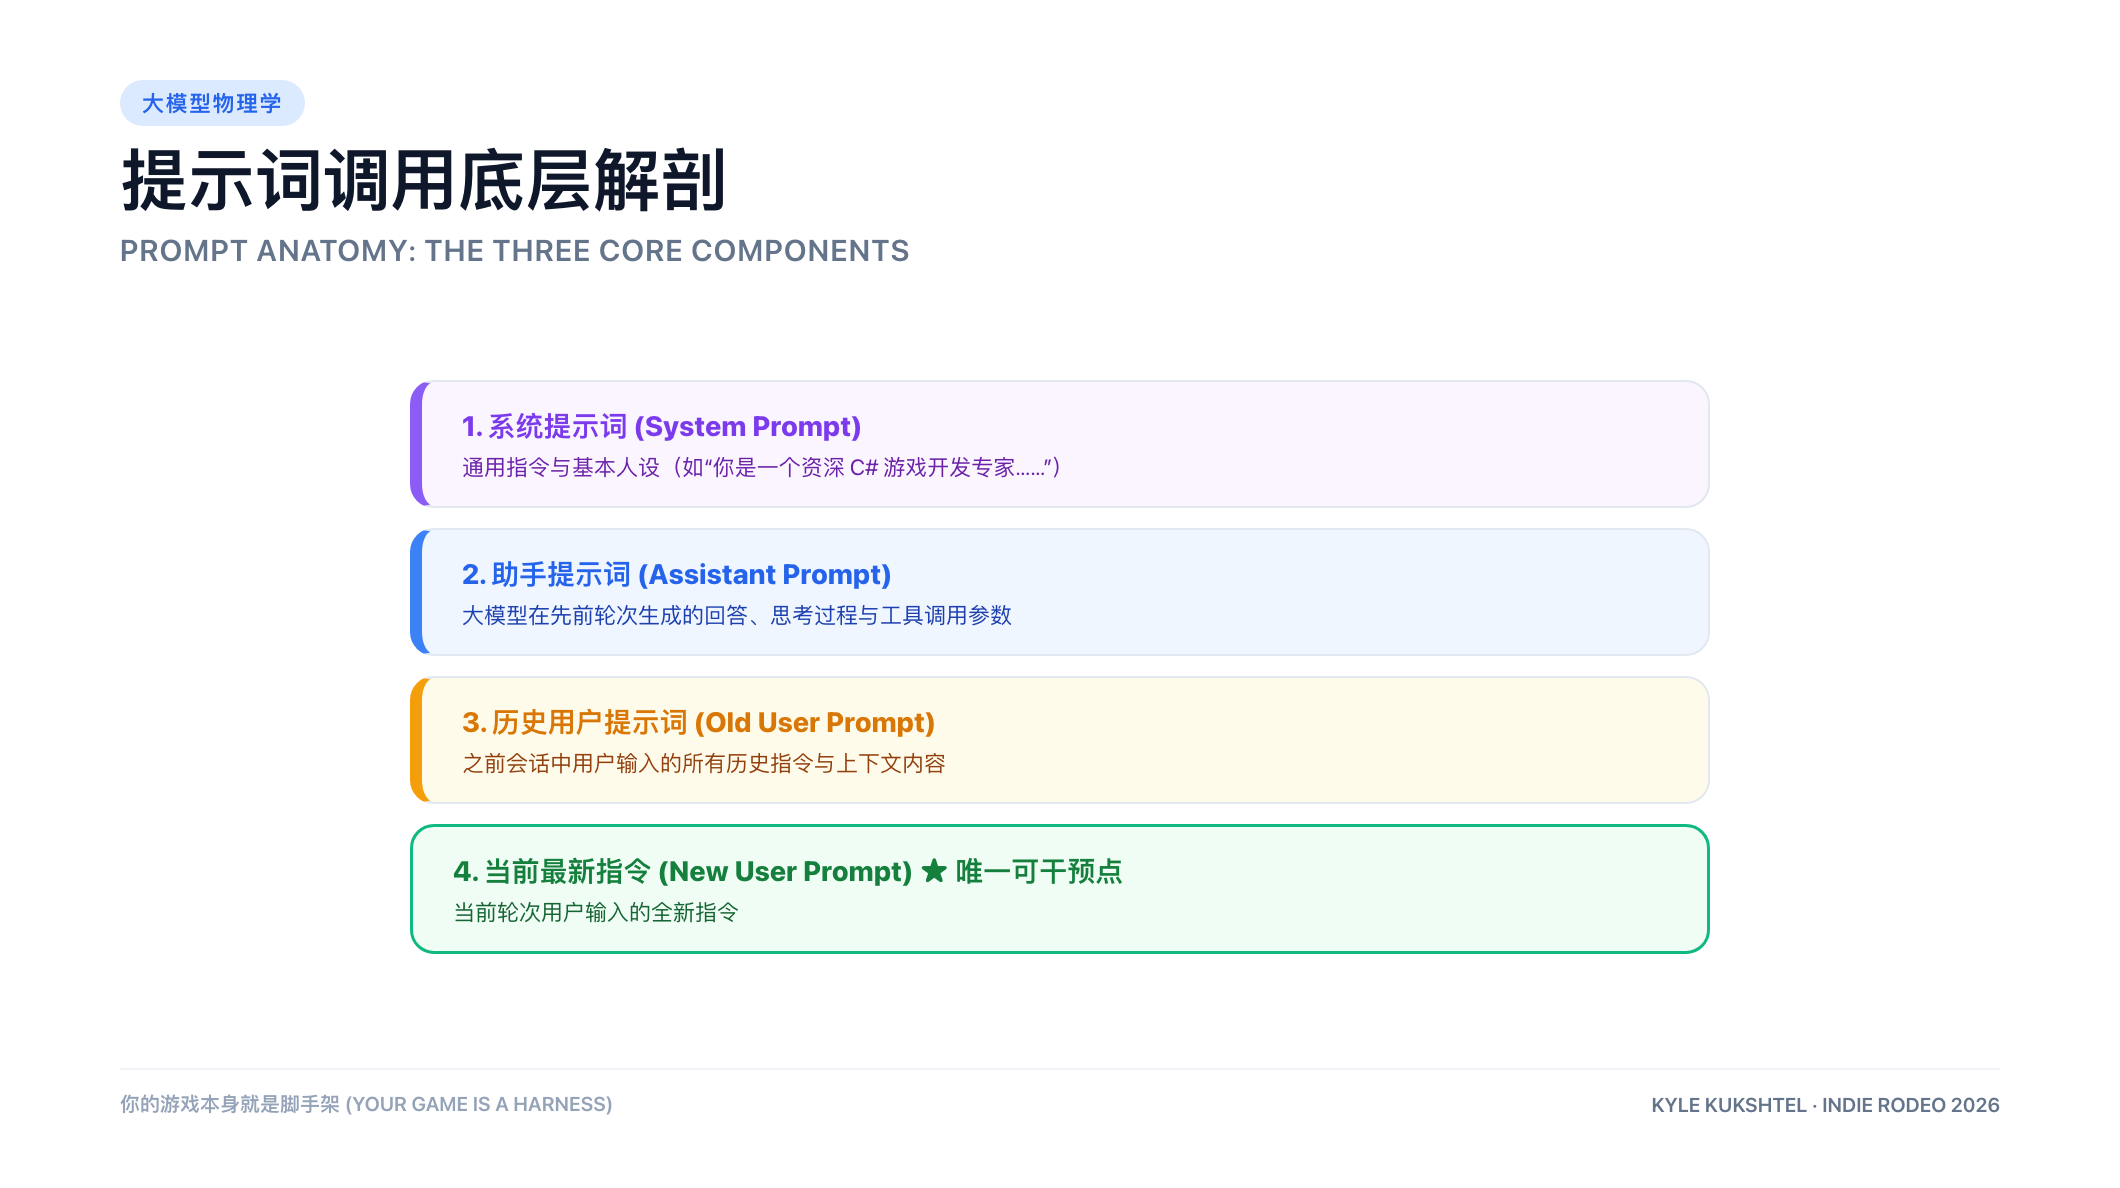
提示词三层结构
- 系统提示词:对所有用户通用的通用指令。它通常用于定义模型自身的基本人设与规则,比如「你是由 Anthropic 训练的智能大语言模型 Claude…」。这并非不重要(它非常重要),但与我们今天讨论的具体场景关联不大。你可以在这里查看各大厂商泄露的系统提示词案例。
- 助手提示词:你可以将其视为用于指导 AI 响应方式的边车结构,它代表了模型根据某些输入给出的历史回复向量。平时你一般不需要直接操心它。
- 用户提示词:这就是重中之重了。你在任何 AI 工具中输入的几乎所有内容都会落入这里。所有的聊天、附带的代码、报错日志等,都被倾倒进这个区域。当人们谈论「上下文」时,绝大多数时候指的正是「用户与助手提示词中累积的 Token 数量」。
人们很容易产生一种误解,以为对话框里的每一次聊天都是一个独立的「崭新」版本。但实际的运转机制是:当你在某个会话中与模型协作时(不同工具的会话边界定义不同,比如关闭 Claude Code 前的单一终端 Session,或是网页侧边栏中的一次独立 Chat),你此前发送过的每一条历史消息,都会在你发送新消息时,被完完整整地重新提交给模型。
这就像小时候在操场上玩的接龙游戏:轮到你发言时,你必须把前面所有人说过的话从头到尾复述一遍,然后再在最后补上你自己的新内容。
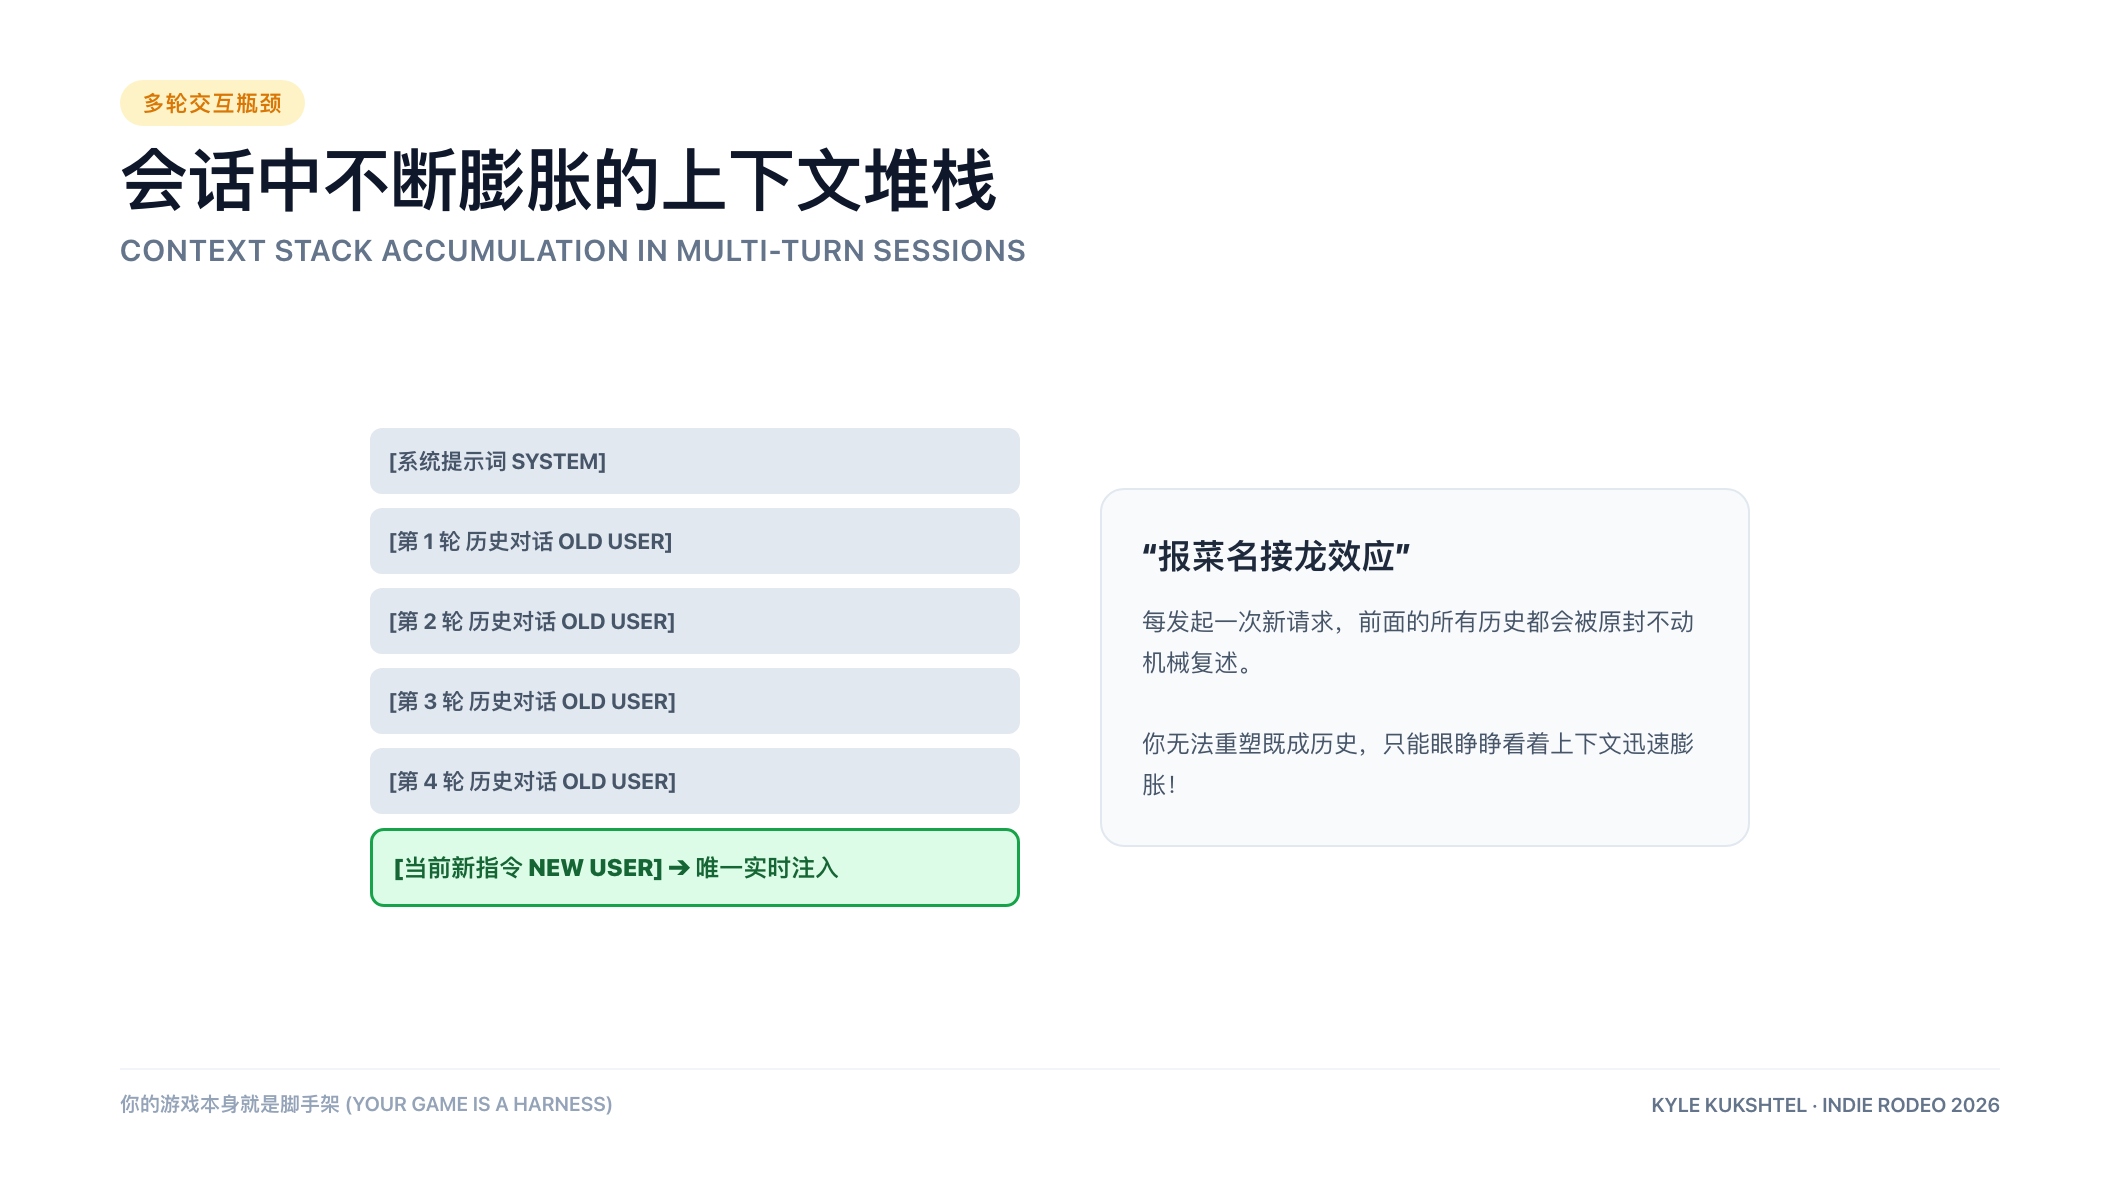
会话中不断膨胀的上下文堆栈
上下文与上下文污染
当你一遍又一遍地重复这一过程时,当前会话中的「上下文」就会急剧膨胀。
上下文累积过程
这听起来很顺理成章,但请注意一个致命陷阱:你真正能够直接干预的,永远只有上下文中「最新」的那一条消息。先前消息中的所有内容,都会被机械地一遍遍重复提交给模型。
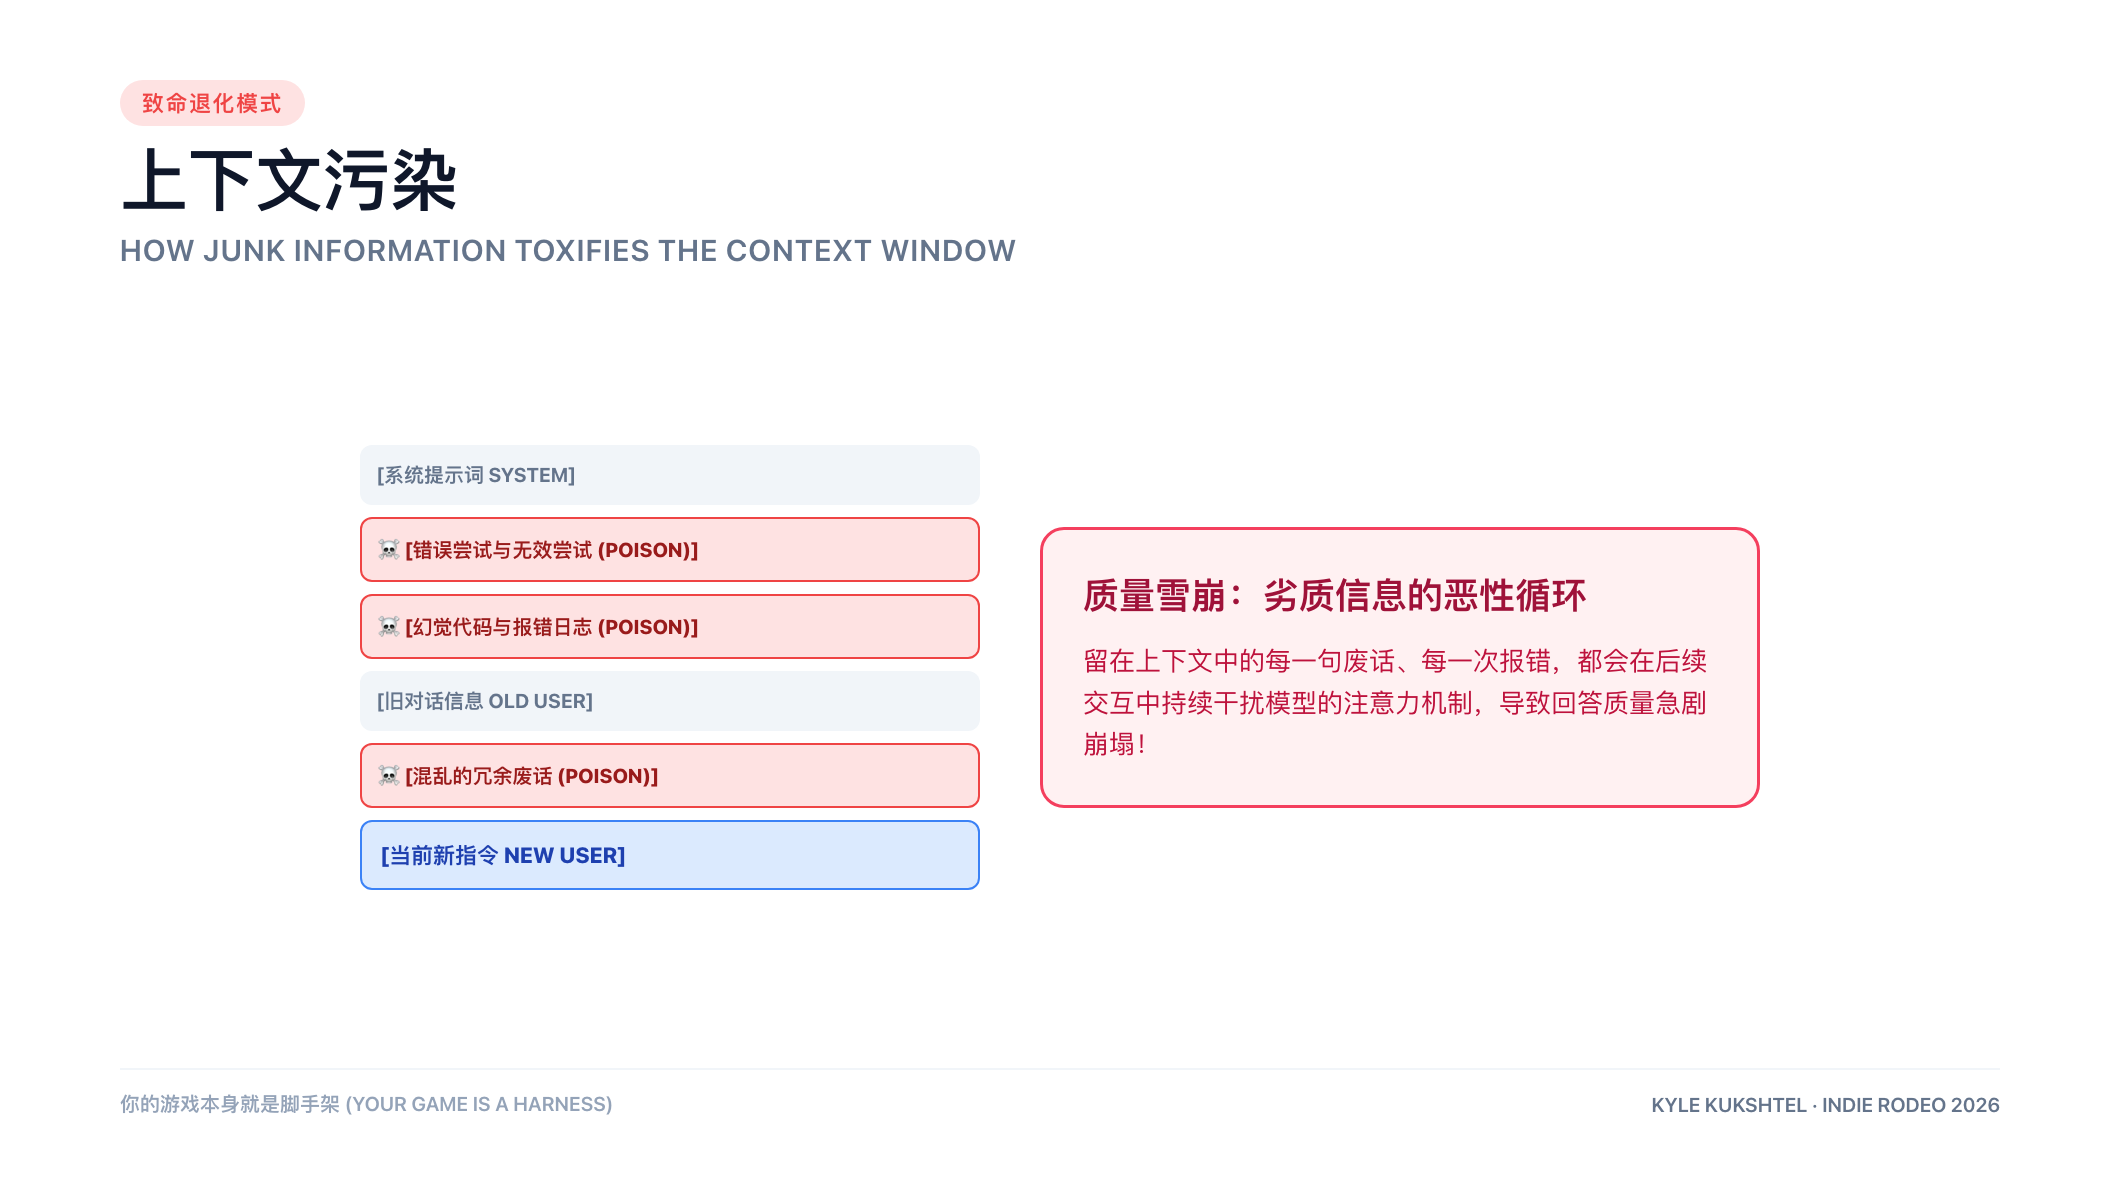
因此,你必须竭尽全力确保留在上下文里的全是「优质信息」。否则,你就会陷入极度恶劣的退化场景:前期产生的劣质信息(错误尝试、幻觉代码、无效日志)会形成持续的「上下文污染」,源源不断地误导模型后续的所有推理。
上下文污染导致生成质量断崖式崩塌
正是在这种物理约束下,管理上下文成为了驾驭 LLM 的决定性技艺,业界也随之诞生了一门全新的工程实践:上下文工程。上下文工程的核心灵魂可以概括为一个问题:「我们如何以最低限度的污染,把最精准、最有效的高质量信息注入上下文中?」
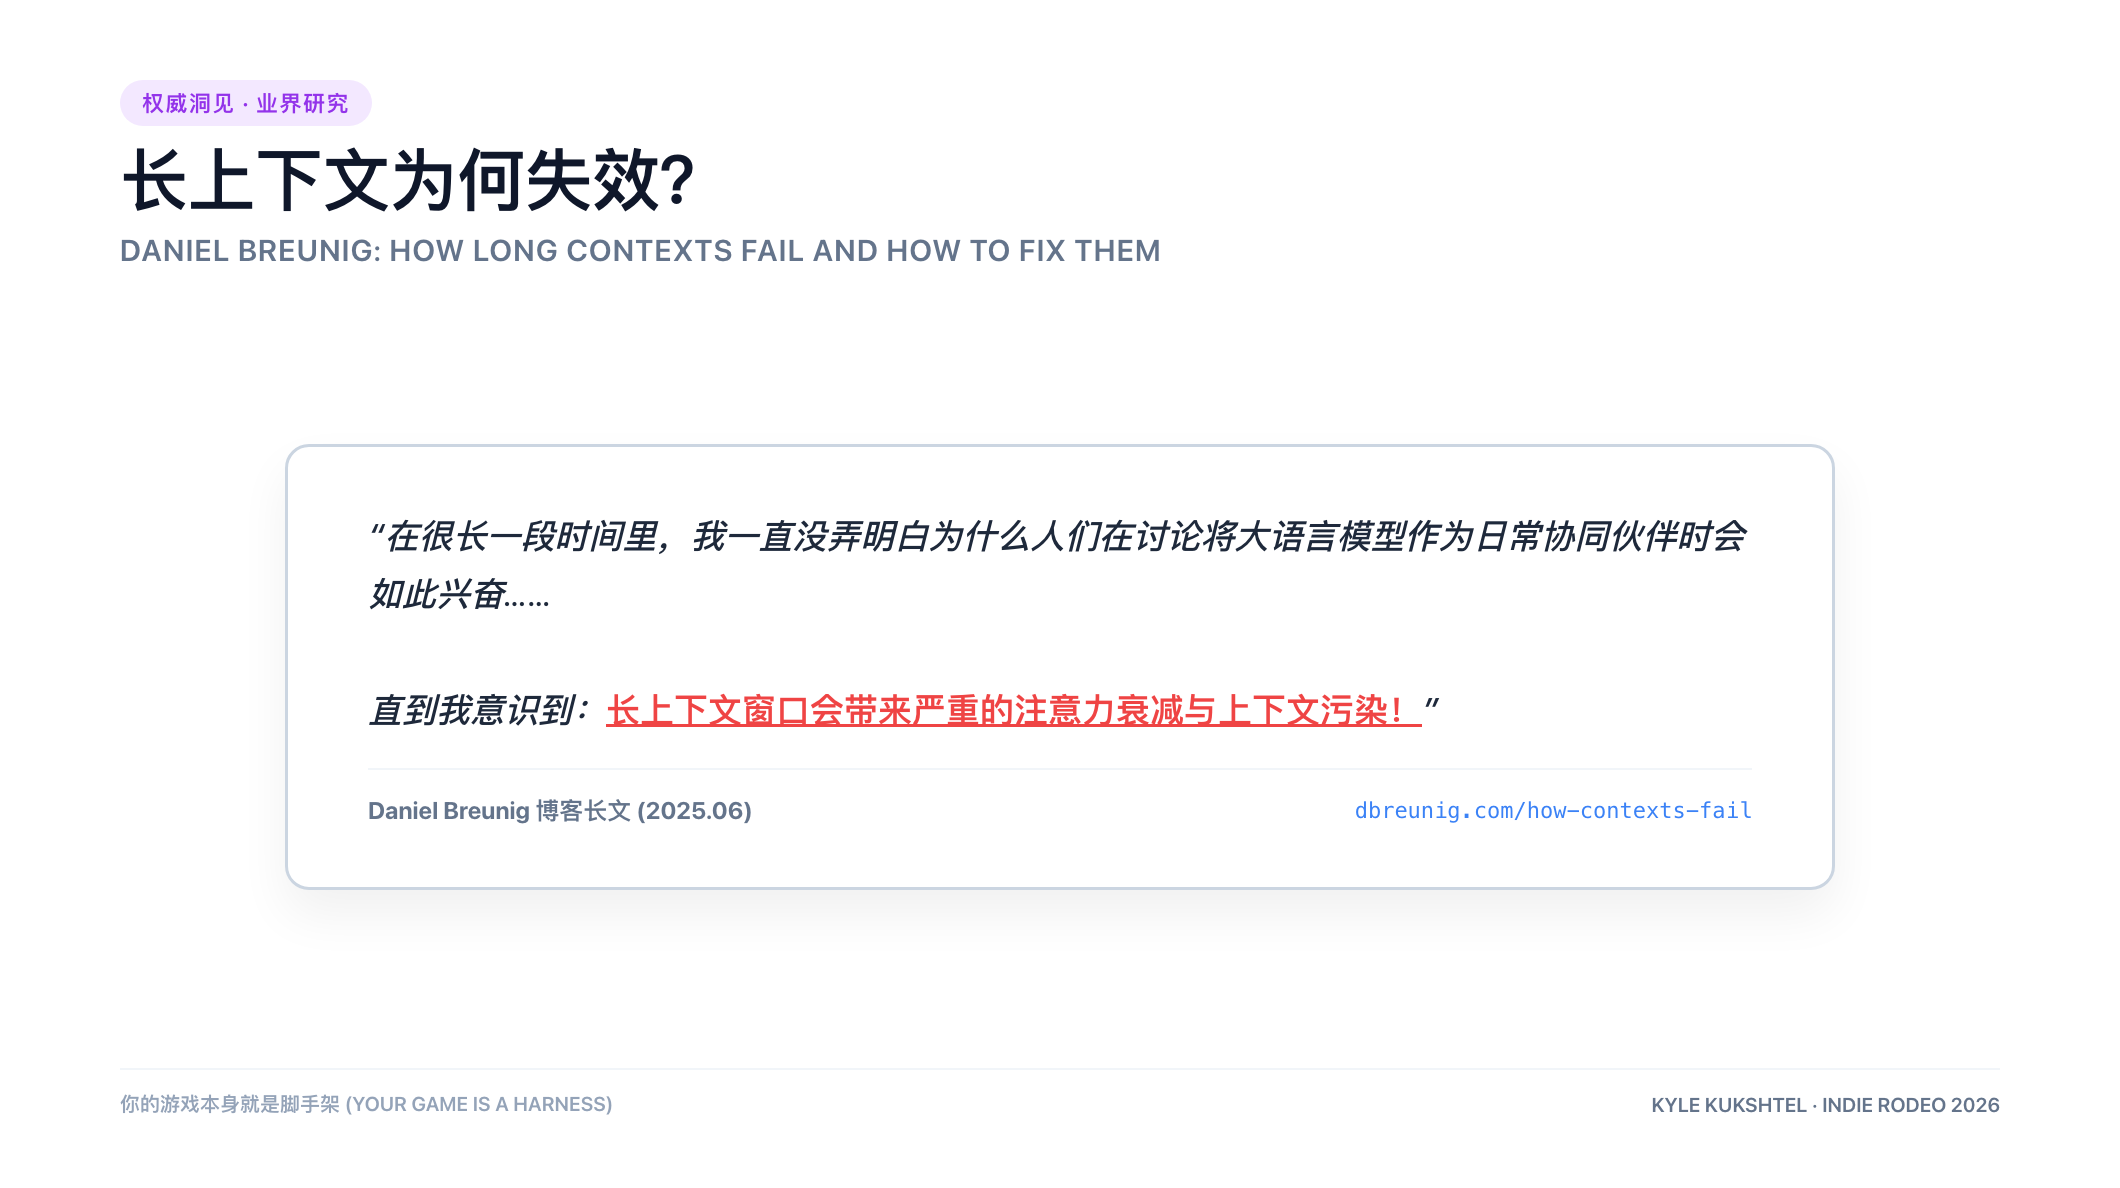
Daniel Breunig 曾写过一篇极具启发性的深度长文《长上下文失效的典型模式及修复之道》,其中提炼出了一个极具穿透力的结论:
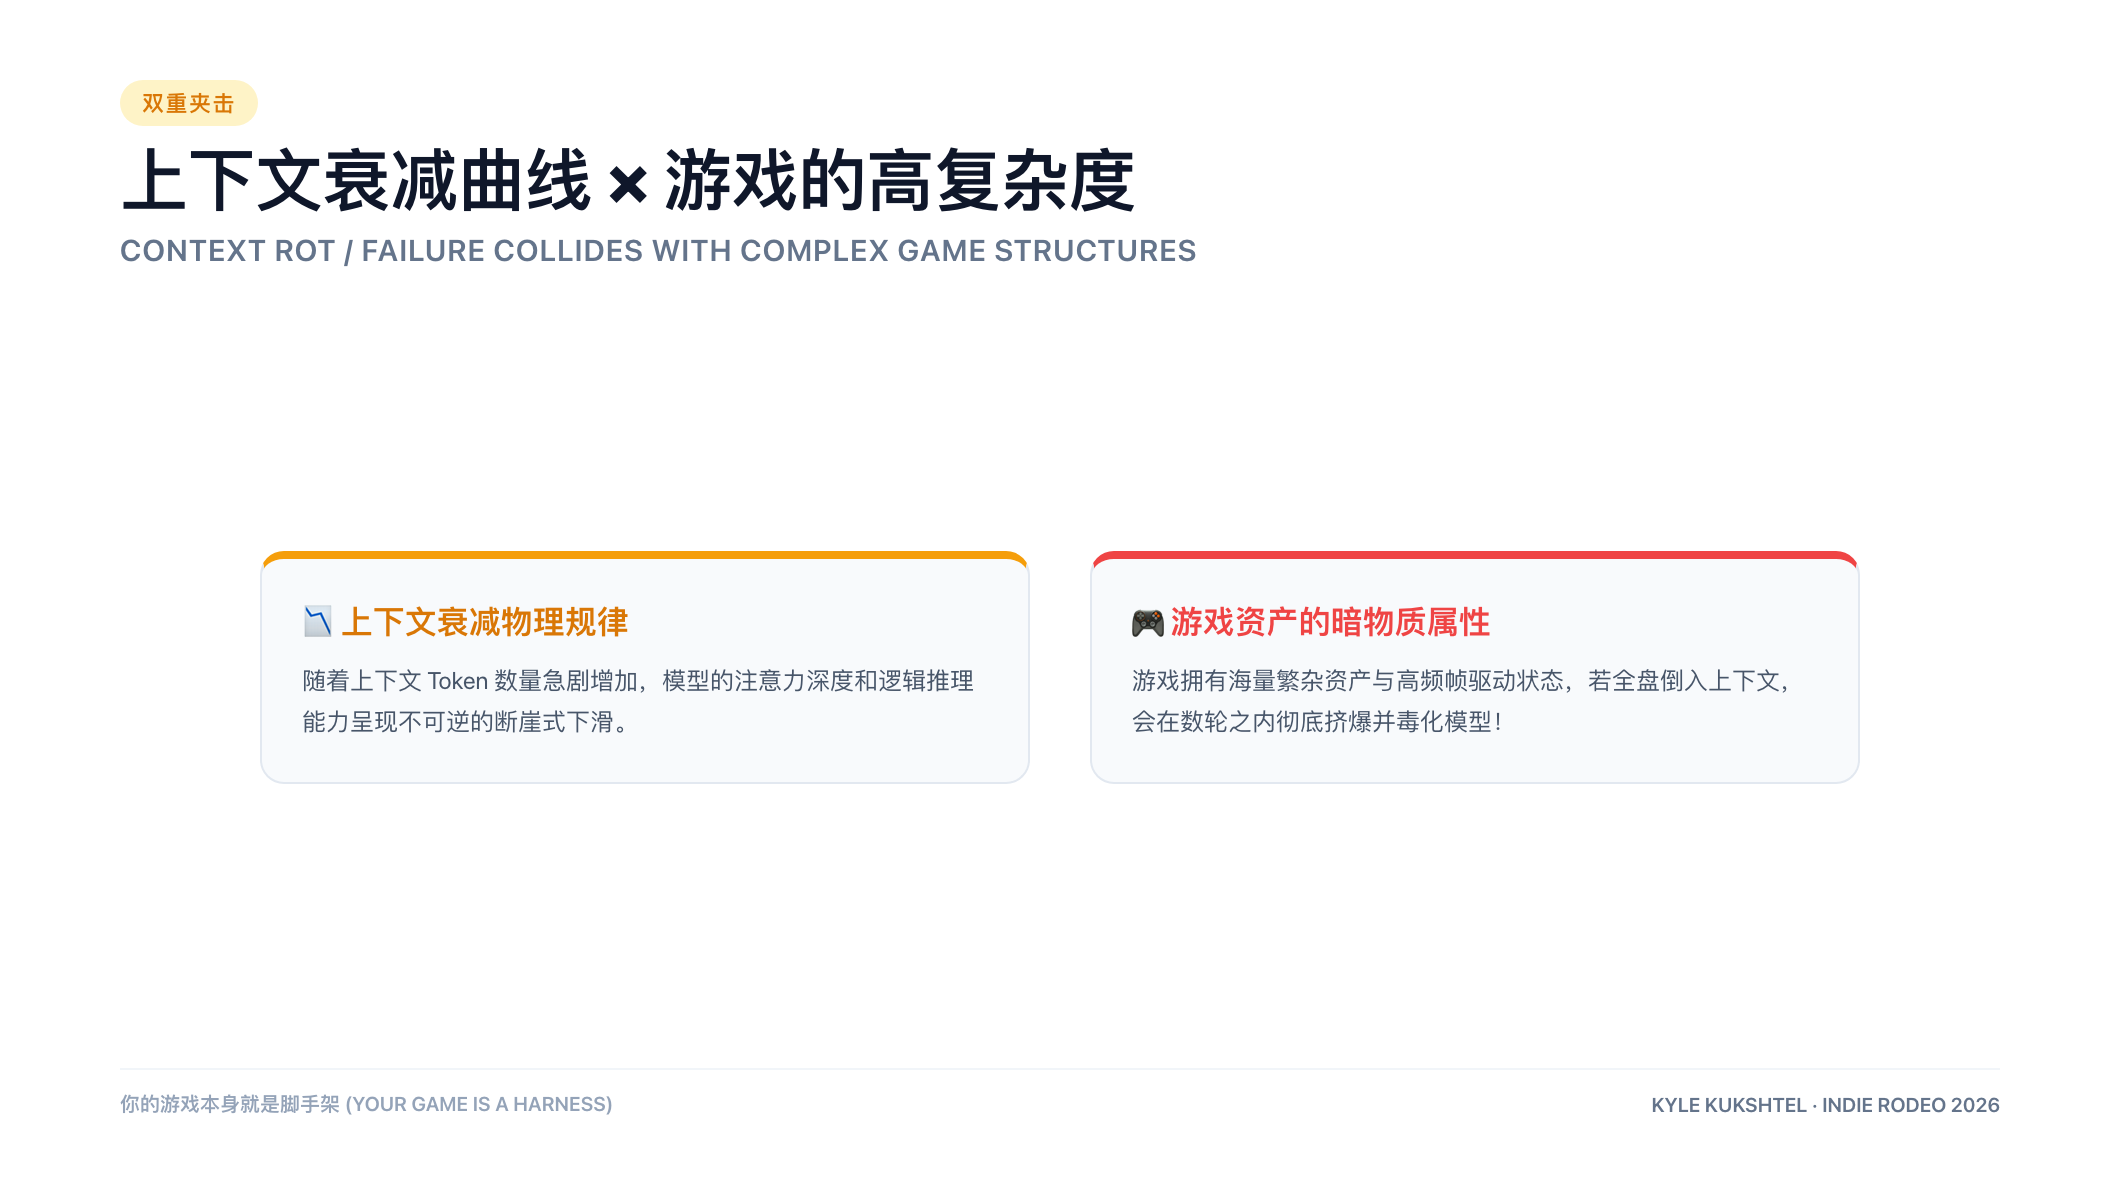
上下文膨胀的衰减曲线
上下文工程本身是一个无比宏大的课题,超出了本文的讨论范畴,但我们接下来将深度借鉴其核心法则,来解决「如何让 LLM 在游戏开发中大显身手」的命题。
换句话说:让 LLM 胜任游戏开发,本质上是一个「上下文工程」问题,而绝非因为游戏或 LLM 在先天基因上有什么不可调和的互斥缺陷!
游戏与 AI 之间的鸿沟是上下文问题
然而,这里的复杂之处在于:游戏太特殊了。或者说得更直白些:人类从来没有一套标准化的模板来指导如何制作一款游戏。我们虽然有诸如 Unity、Unreal 这样的商用游戏引擎,但在具体工具流层面几乎是零标准化的:每一款游戏都会根据自身的机制需求,演化出截然不同的架构形态。
什么是「脚手架」?
这种在标准化工具上的缺失在游戏领域尤为尖锐,但在其他尖端技术领域也屡见不鲜。正因如此,一个全新的概念应运而生,用于指挥智能体高效操纵复杂的工程产物,这就是脚手架。
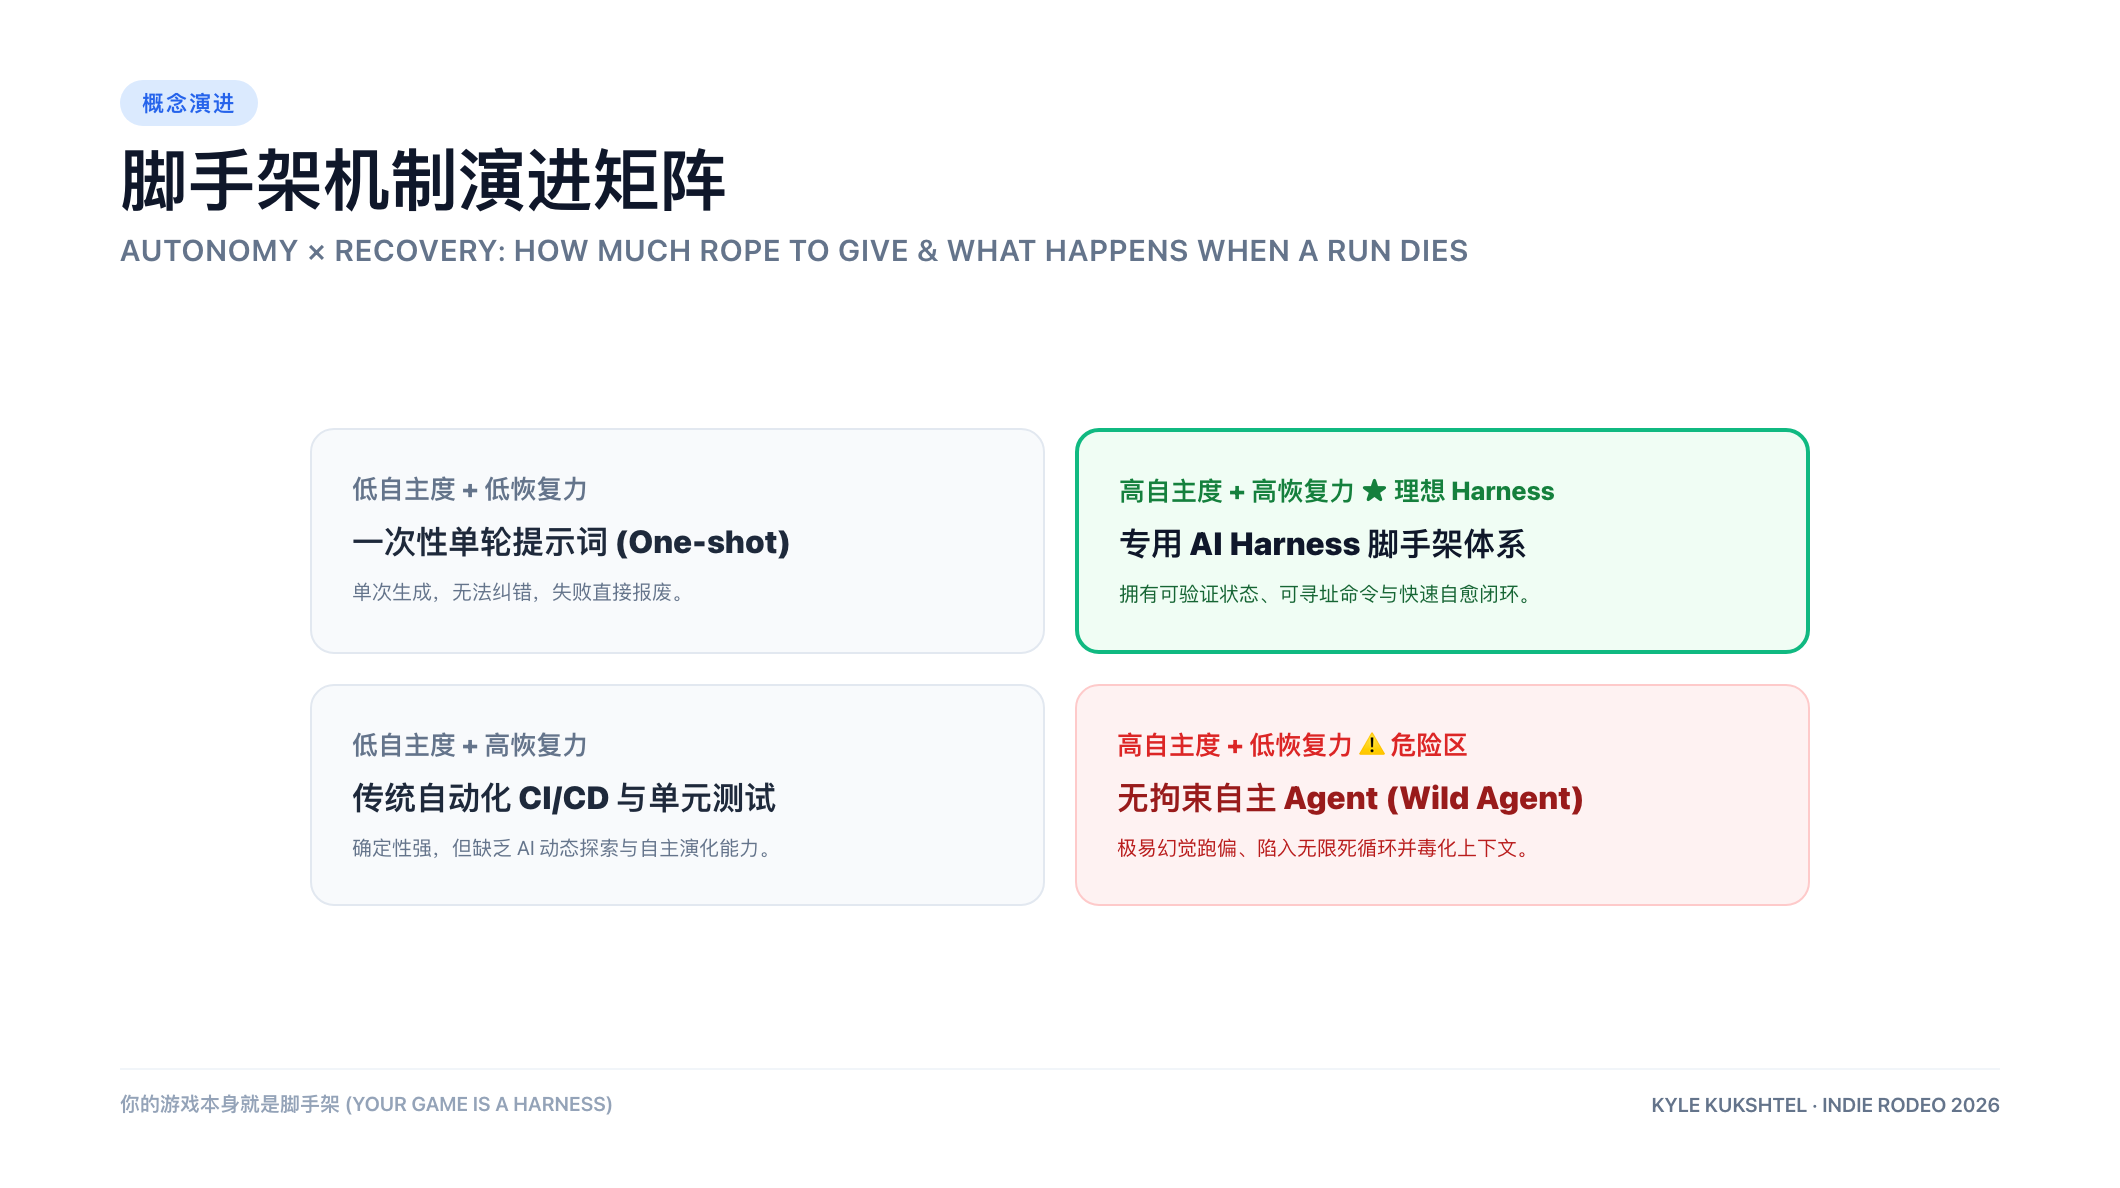
脚手架概念的演进
所谓「Harness(脚手架/拘束具/线束)」,其核心理念是指:为智能体预先设定好的一套标准行动模式与交互契约,使其能够针对明确(或宽泛)的输入指令做出精准响应。
你现在日常使用的 Claude Code、Cursor 本身就是一种通用的 Harness;但它们完全可以针对你所从事的具体业务领域进行扩展、蒸馏与定制。最近业内在这一领域动作频频,涌现出了海量针对不同软件开发周期的定制 Harness:
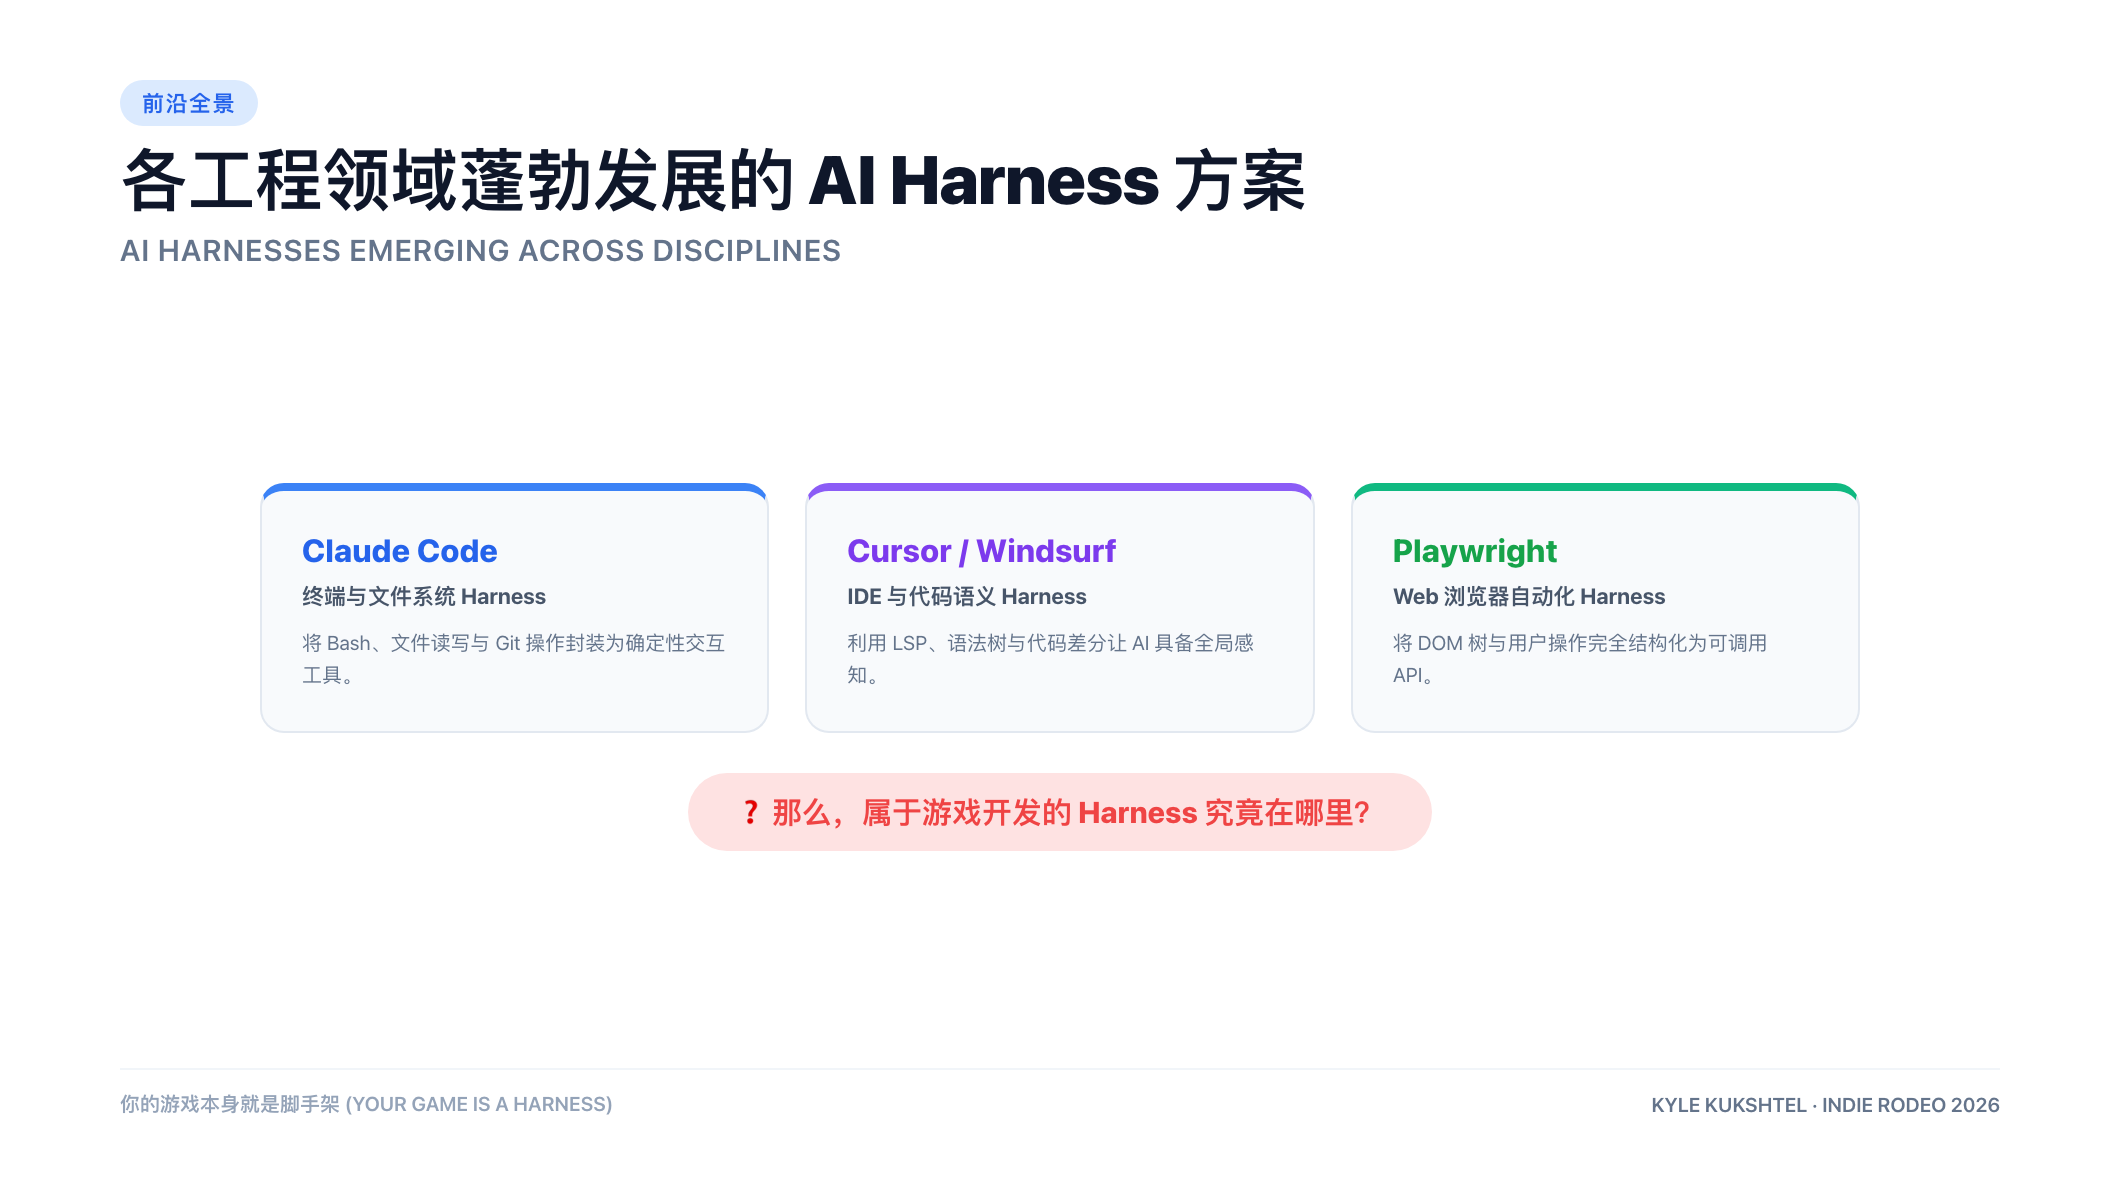
各领域蓬勃发展的 AI Harness 方案
这些优秀 Harness 的共同追求只有一件事:「Agent 如何更清晰地理解自己正在构建的对象,并在开发推进的全流程中进行精确引导?」 一个现代 Harness 可以集成浏览器自动化验证、遥测数据捕捉、性能分析,甚至贯穿整个软件研发生命周期,例如自动创建工单、更新设计文档等。
然而,现存所有的通用 Harness 都有一个致命短板:它们根本无法与你的游戏内核对话。
你的游戏对它们而言就像一个严密焊死的黑盒子。LLM 唯一能看见的,仅仅是代码编辑器里的文本字符。但正如我们前面所讨论的,对于游戏而言,纯文本代码根本无法代表游戏的真实运行状态。通用 Harness 本身并不能自动解决「游戏不仅仅是代码」这一核心痛点。
真正亟待解决的问题是:我们必须想办法把游戏中所有的暗物质(状态、资源、物理、表现),转化为 LLM 能够理解与操纵的具象载体。 我们必须亲手撬开游戏的黑盒,让游戏内部的运行细节变得对 LLM 处处透明、处处可寻址。
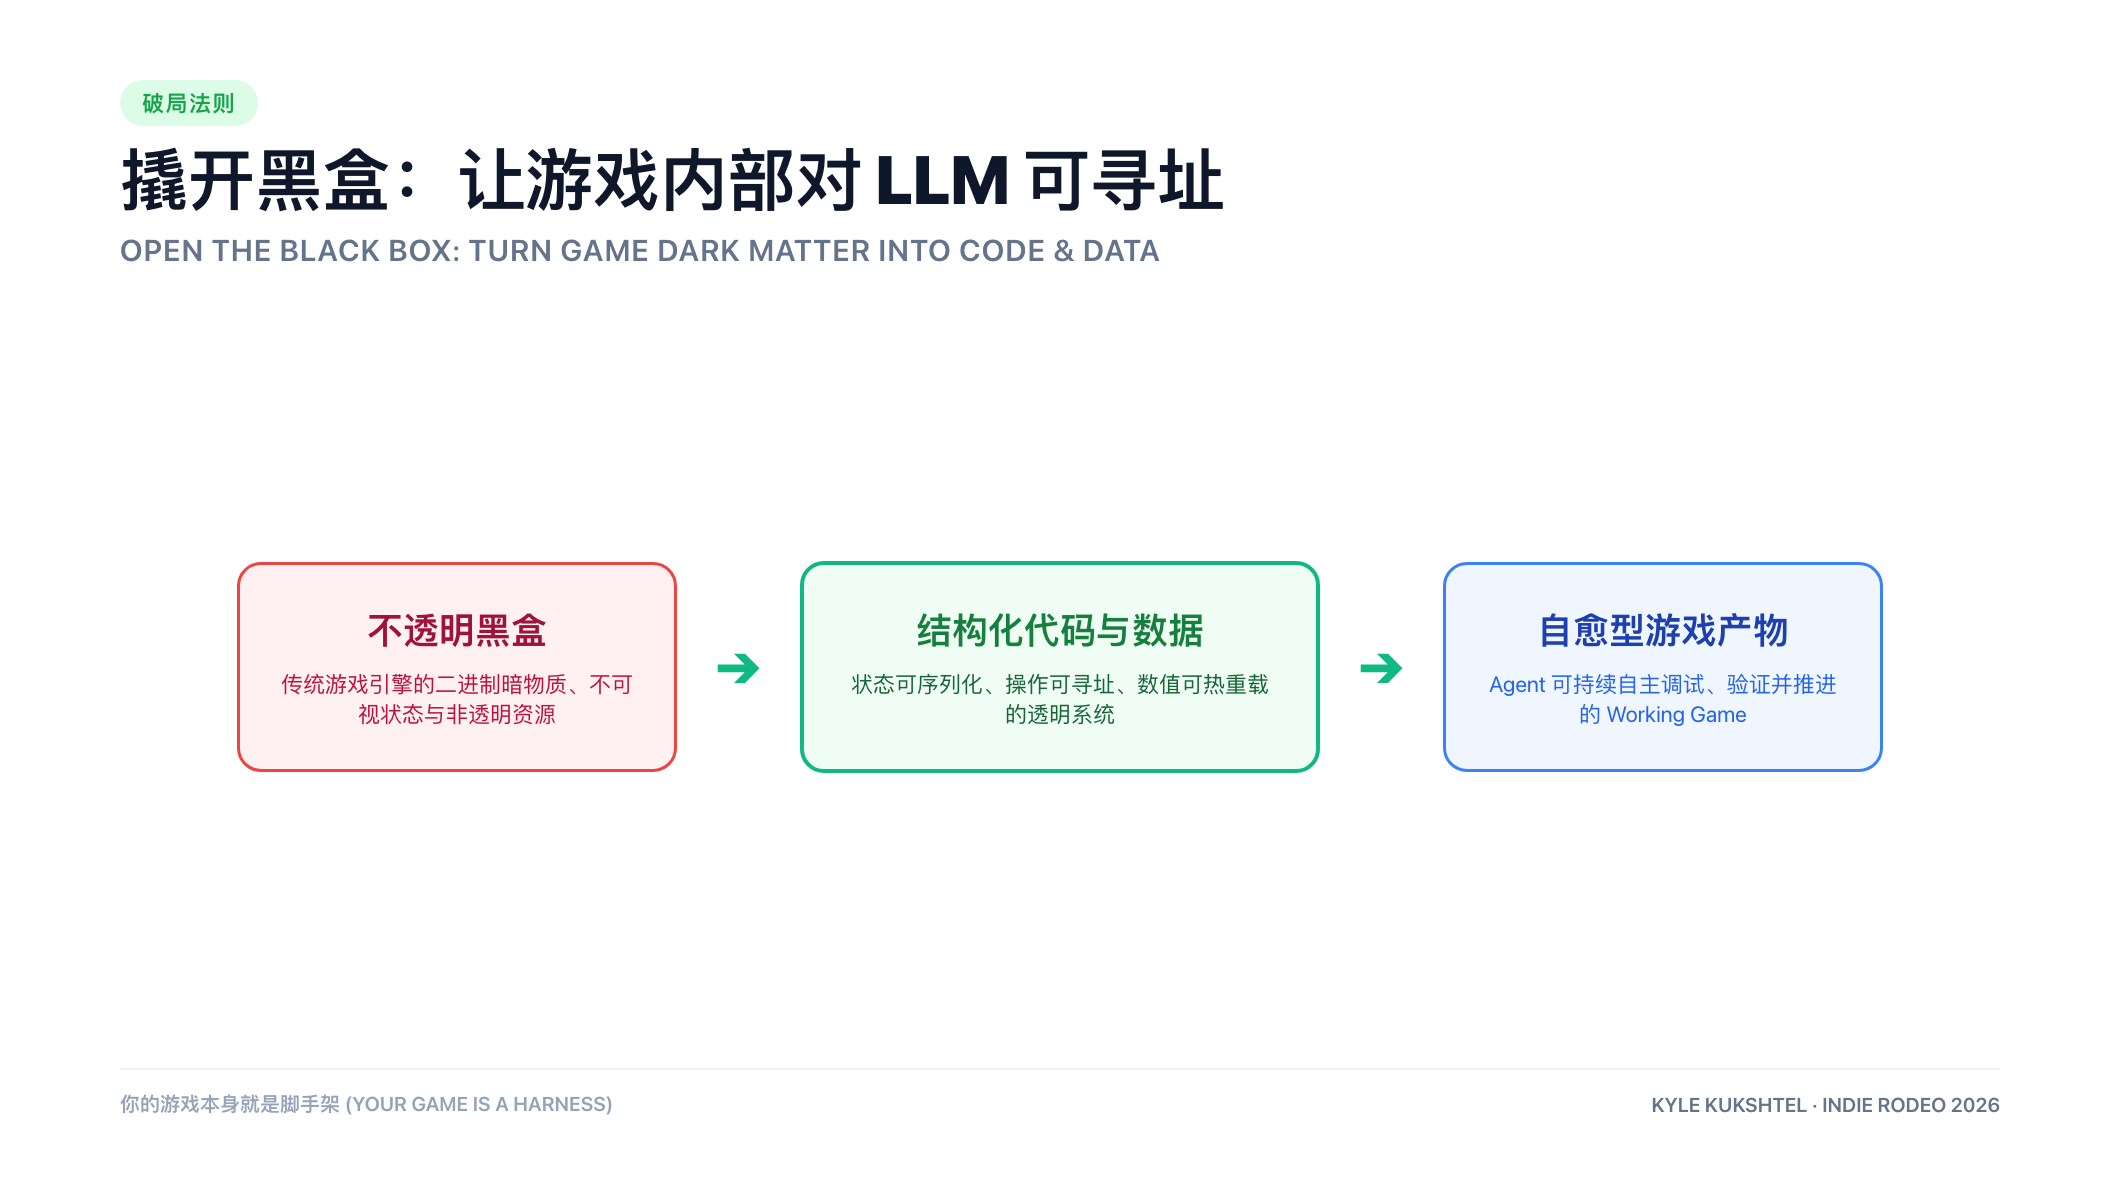
撬开黑盒:让游戏内部对 LLM 可寻址
在当天的演讲现场,我放了一张极其幽默的幻灯片,宣称屏幕上的这根箭头就是整场演讲的全部真谛。虽然在博文里这个包袱的效果打了折扣,但我还是决定把它原汁原味地保留在这里:
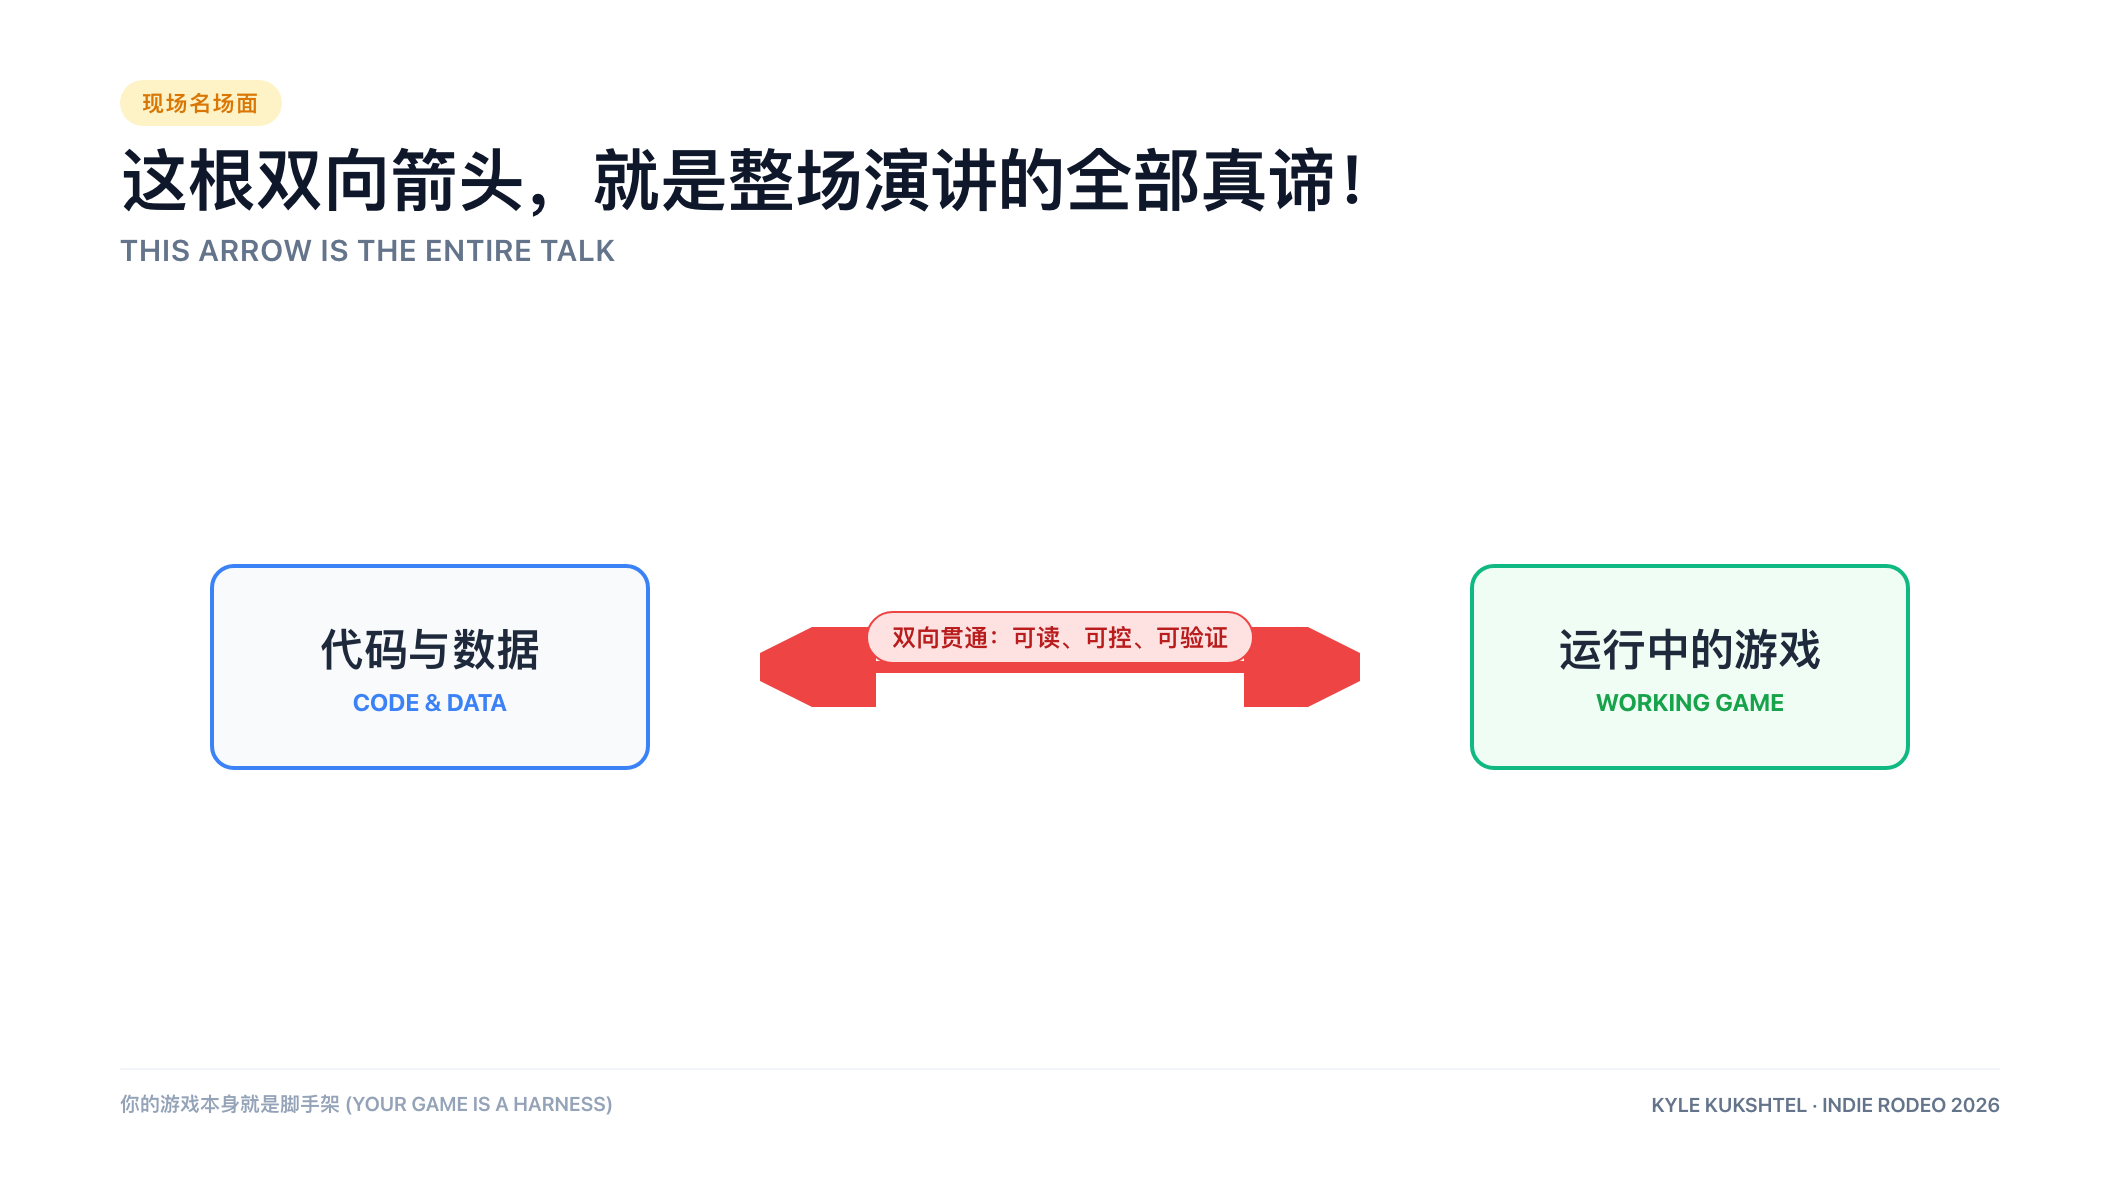
现场的笑点幻灯片:这根箭头就是一切
那么,让我们来聊聊具体该做什么
现在,让我们撸起袖子,进入真正的工程实操方案。
让游戏对 AI Agent 透明可读
以下是我总结出的一组高度具象、立即可落地的游戏工程架构原则,旨在让你的游戏对 LLM 变得透明、易读且可稳定操作。
顺便插一句:即便完全抛开 AI 不谈,以下绝大多数建议对于游戏开发本身而言也是极佳的工程实践。有了 AI 的加持,它们会爆发出十倍的生产力;但就算你纯手写开发,遵循这些原则也会让你的代码架构更加干净优雅。
---
1. 固定随机性
贯穿本文与整个演讲的核心主题,是确定性。
简而言之:你能在多大程度上、以多高精度的代价,在游戏中 100% 还原某个极度特定的状态?
我们的终极目标是:状态复现应当极度轻松、分毫不差。如果在项目快要完工的尾声才来临时补救这一点,将会极其痛苦,甚至不得不伤筋动骨地重构整个底层架构。
相反,如果你在敲下第一行代码之前就将这项约束确立为不可动摇的铁律,你就能在整个开发周期中彻底告别逻辑混乱代码的噩梦。
实现这一点的第一步非常直接:在游戏启动之初,建立一个全局单一的随机种子源。强制要求代码中任何涉及随机性的调用,全部走这个统一种子发生器。
这意味着你的游戏具备了在确定性条件下重现几乎任意游戏局面的能力。哪怕你的逻辑在 30 个不同的地方调用了 Random.Float 来决定怪物的行为,只要种子固定,第 30 次调用的数值在每一次运行时必定完全一致。确定性由此奠定。
2. 视觉截图能力与图像差分
为什么确定性复现状态如此关键?
试想一下 Agent 正在进行数十轮自动化迭代,试图微调某个游戏界面的布局。如果 Agent 无法从零开始反复精确还原到完全一致的游戏现场,而是频繁受阻于状态复现失败,它的迭代就会彻底停滞。
而一旦 Agent 成功进入了特定状态并做出了修改,它该如何评估自己的改动是对是错?
最直观的途径自然是截图。绝大多数商用引擎都提供了现成的截图 API:
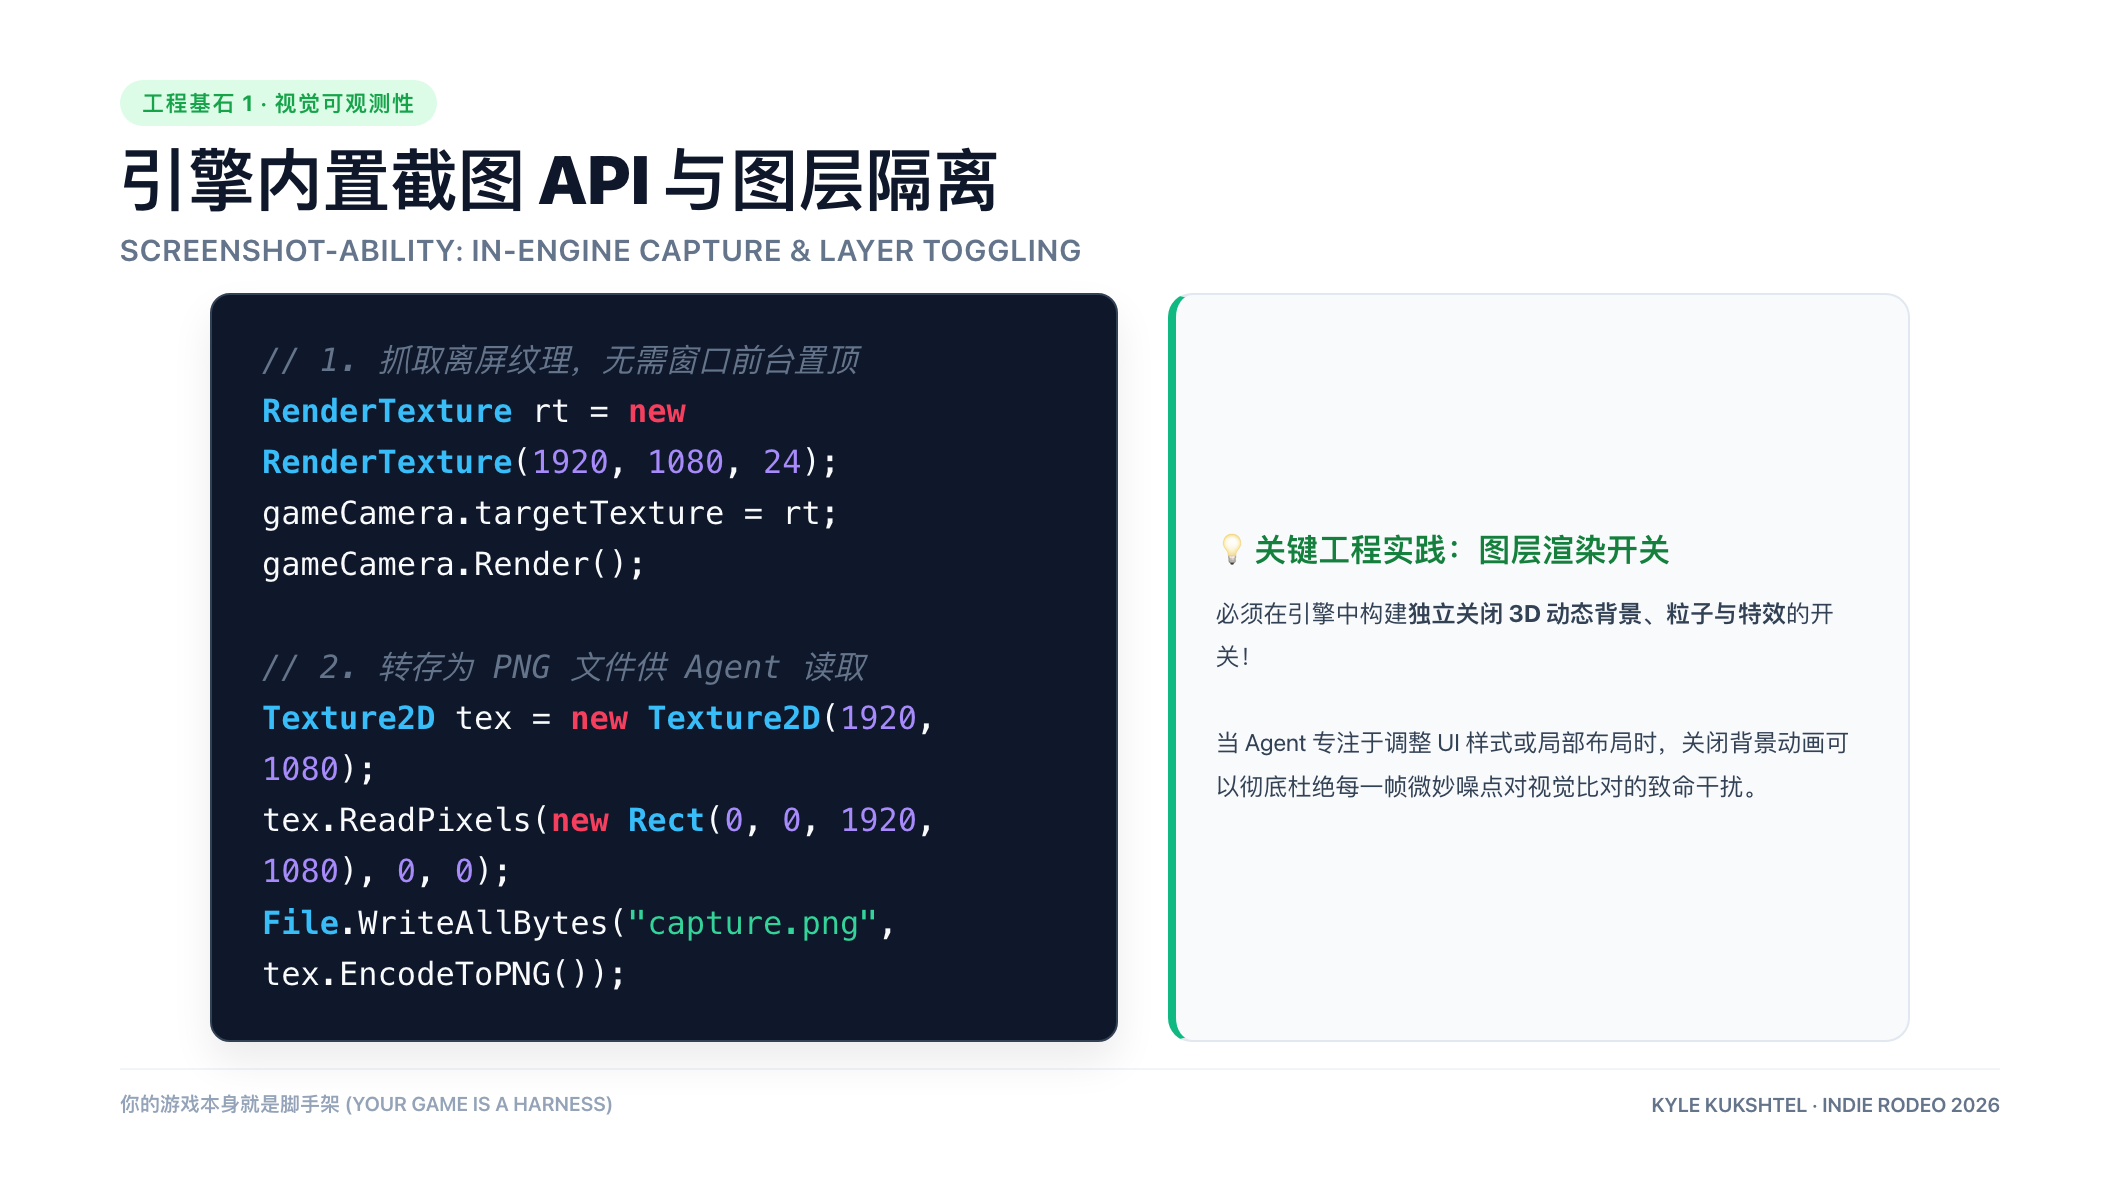
引擎内置的截图 API
这里强烈建议在引擎中增加自由切换 UI 层与玩法层渲染开关的能力。这样你就可以在验证 UI 样式时关闭背景的动态 3D 渲染,彻底杜绝背景动画对视觉评测产生的干扰。
让 Agent 在修改前后分别截取「修改前」与「修改后」的图片,似乎是让它直观理解世界变化的绝佳方式。
……真的是这样吗?
单纯对比前后截图在多模态模型中表现极差
事实极其残酷:当你直接将修改前后的两张大图扔给多模态大模型时,模型往往极其难以准确识别细微的改动,更不用说量化评估这一改动是否正在逼近最终目标。
这种来自海量原始像素的干扰本身就是一种隐蔽的「上下文污染」:盲目向模型灌入高分辨率截图,会严重模糊其对任务进展的感知,最终导致 Agent 与人类双双陷入困惑。
来看一个生动的现实案例:假设你截取了本次开发者大会的官网首页:
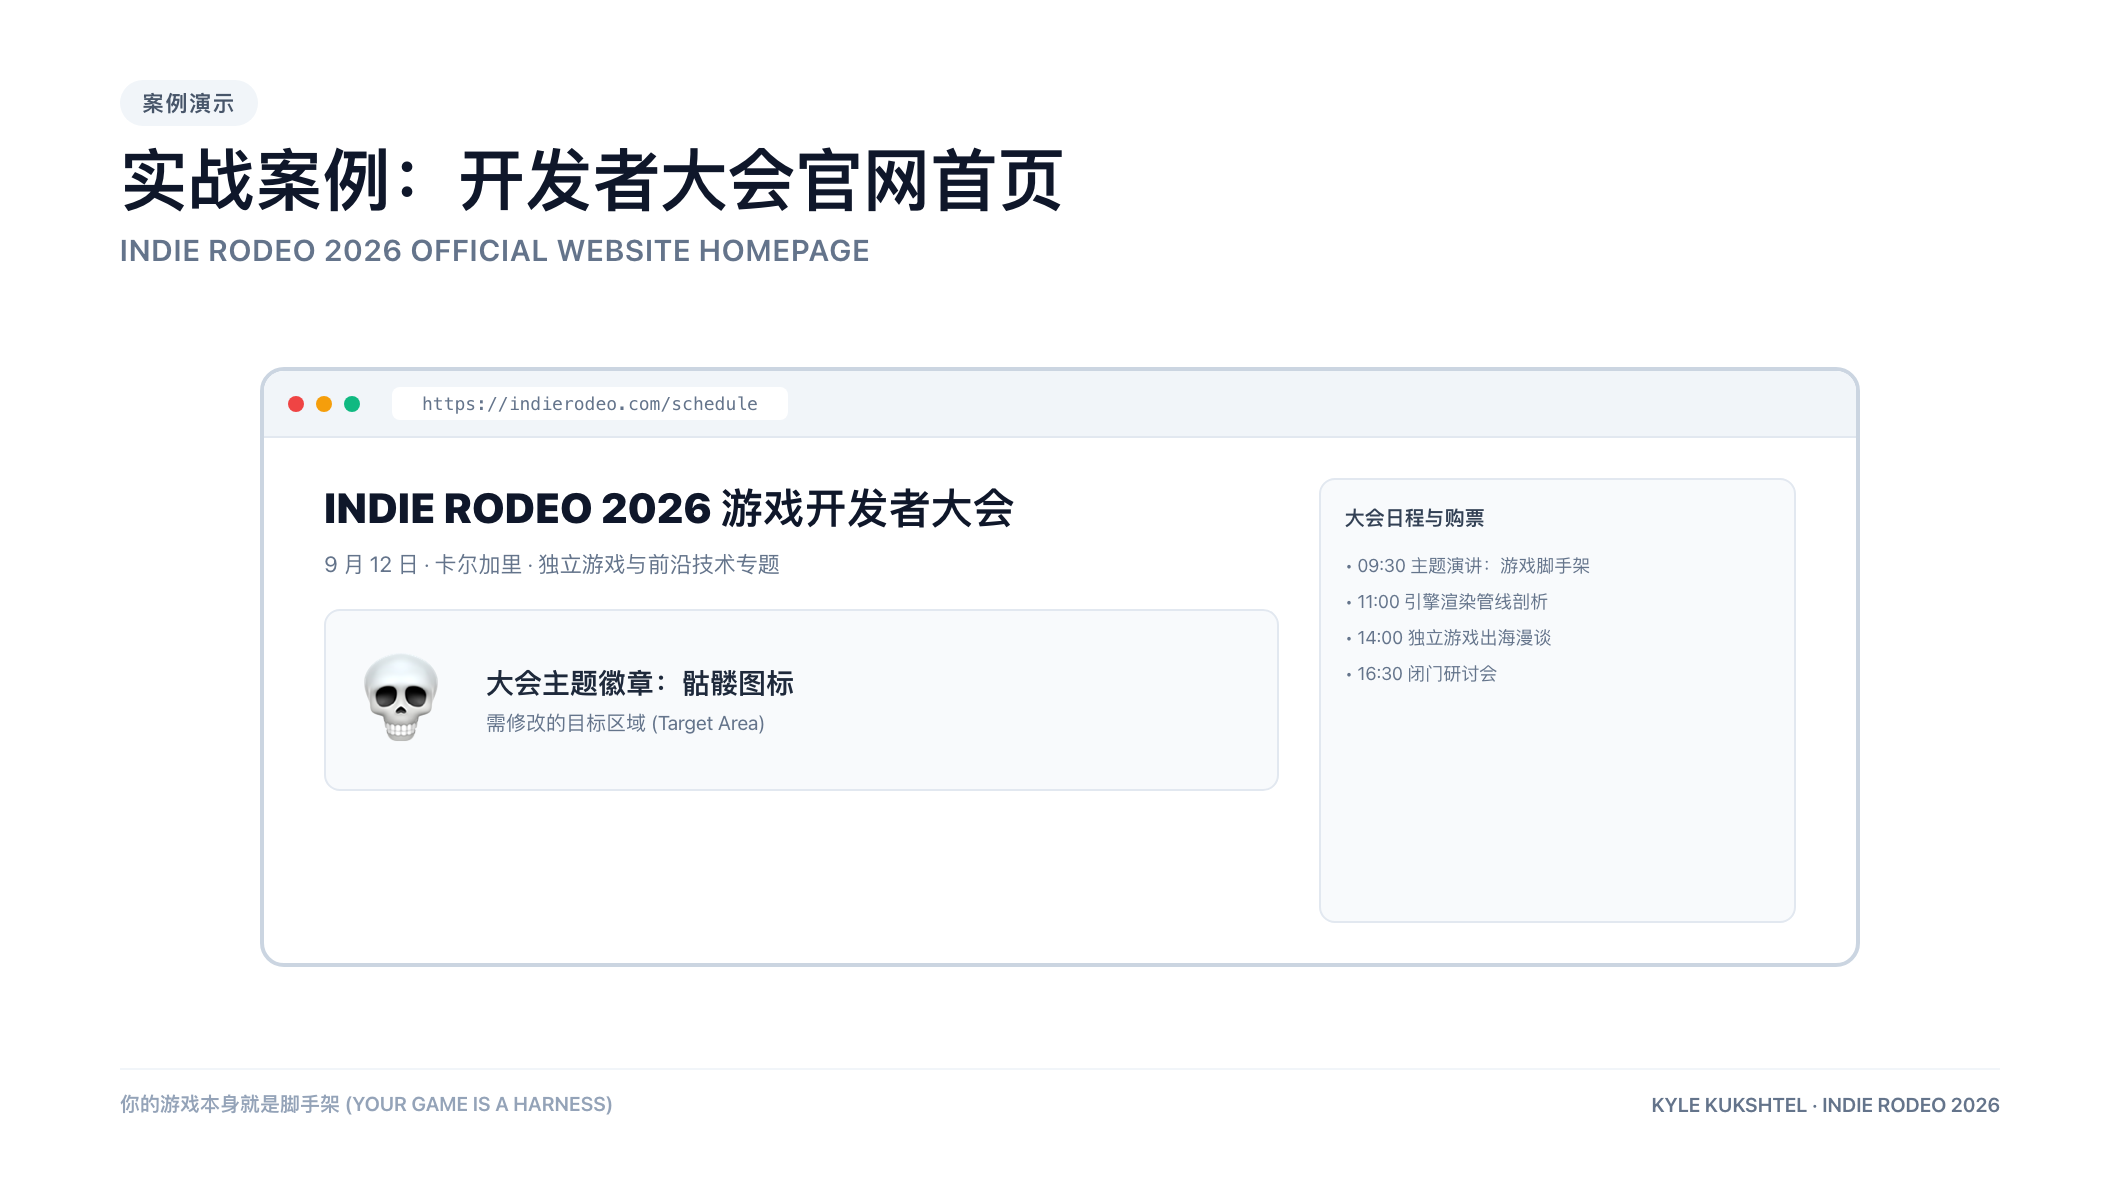
大会官网全图
你的指令是:「把图中的骷髅变成海盗」。即便模型具备局部标注能力,除了你的核心修改区域外,绿色区域内的大量无关像素都会被一股脑塞进上下文:
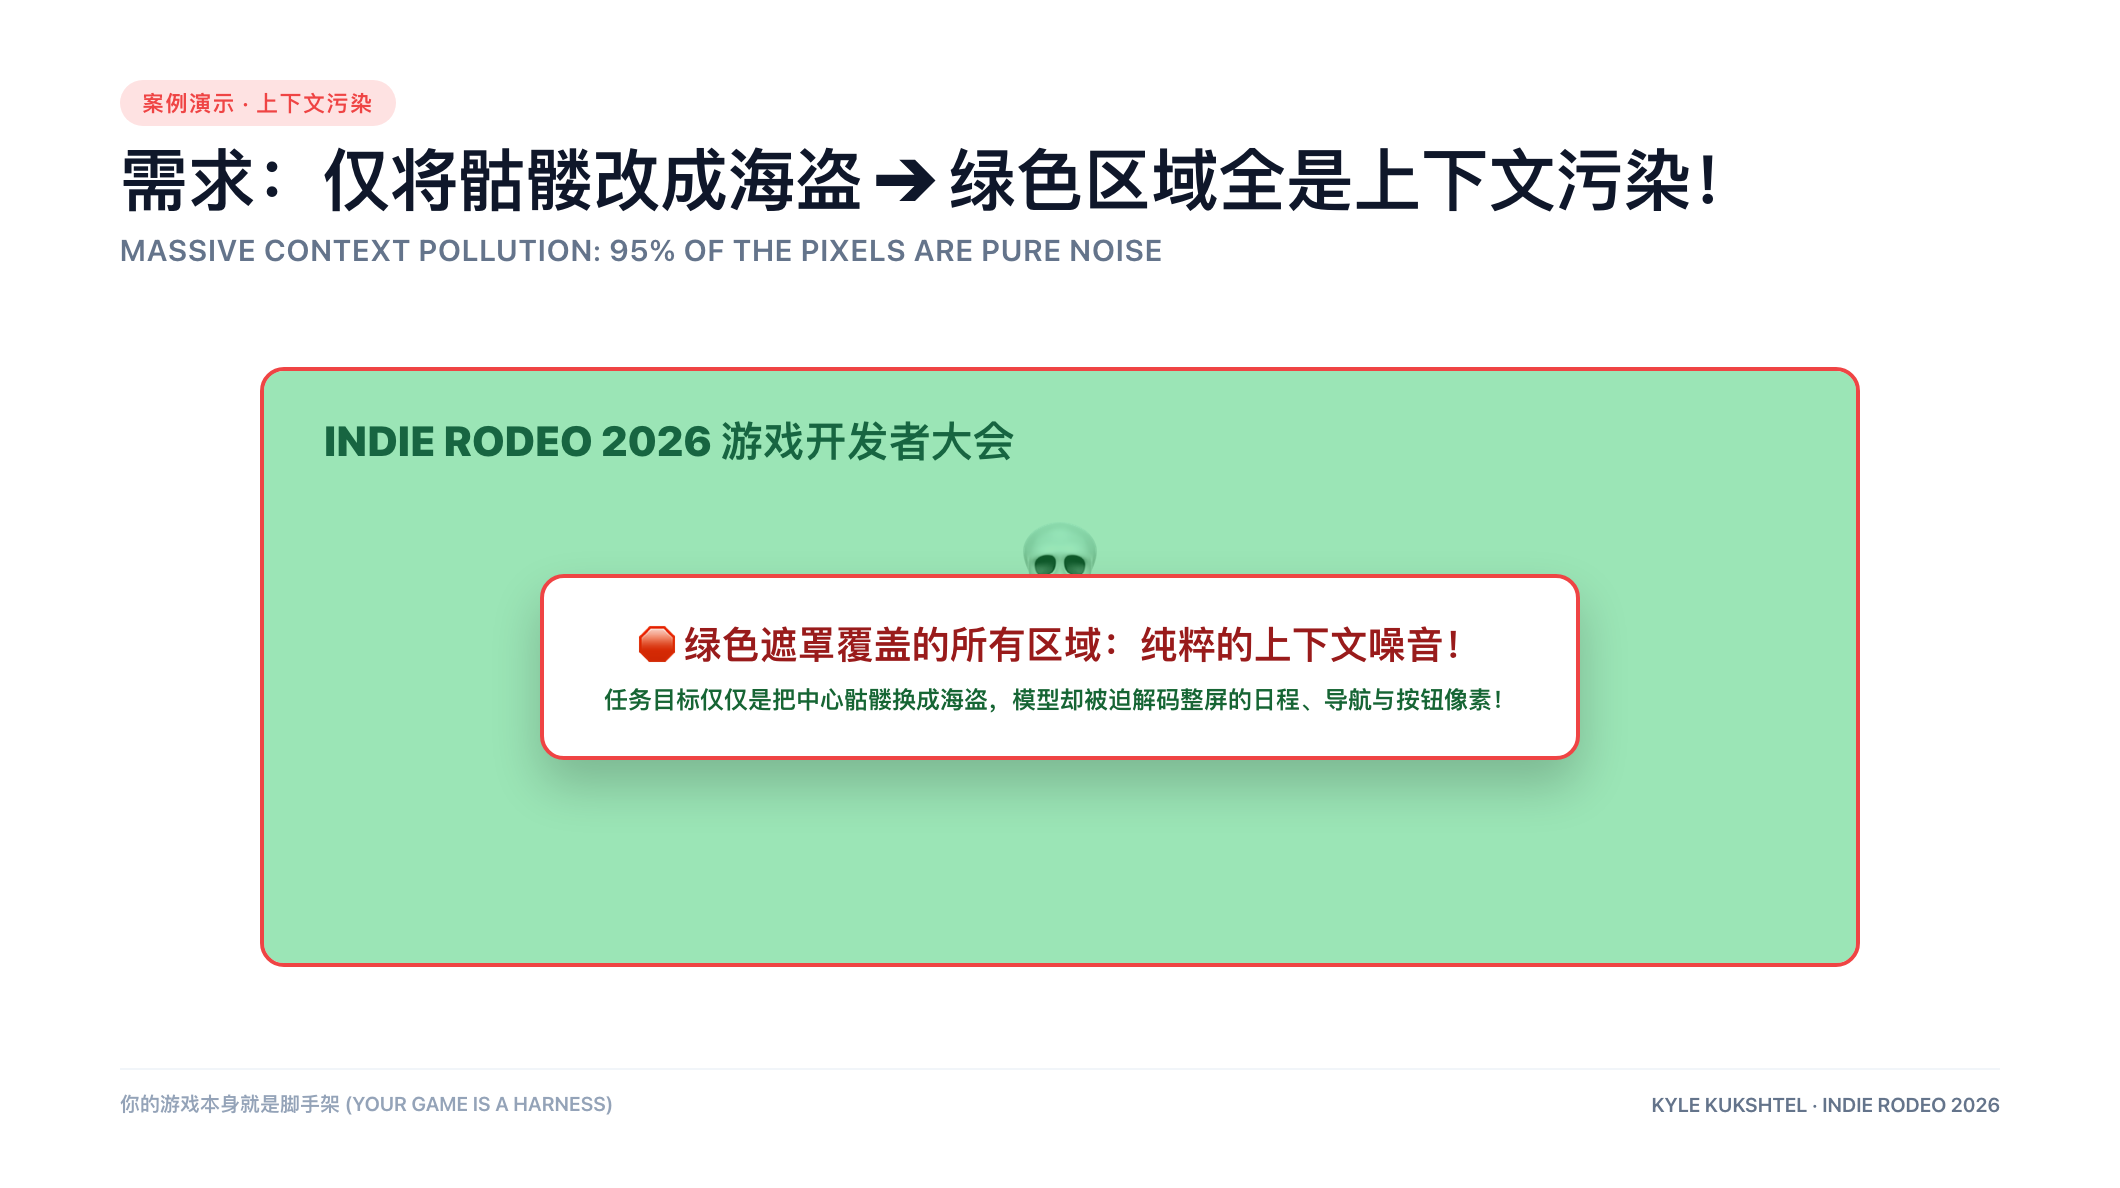
绿色高亮区域构成了严重的上下文污染
绿色区域内的所有像素数据,本质上都是纯粹的上下文噪点。LLM 不仅在被迫分析你要求的修改,还在被动处理这整张图中的杂乱信息。
你必须迫使 LLM 只关注发生变化的局部。如何做到?
答案是:图像差分!
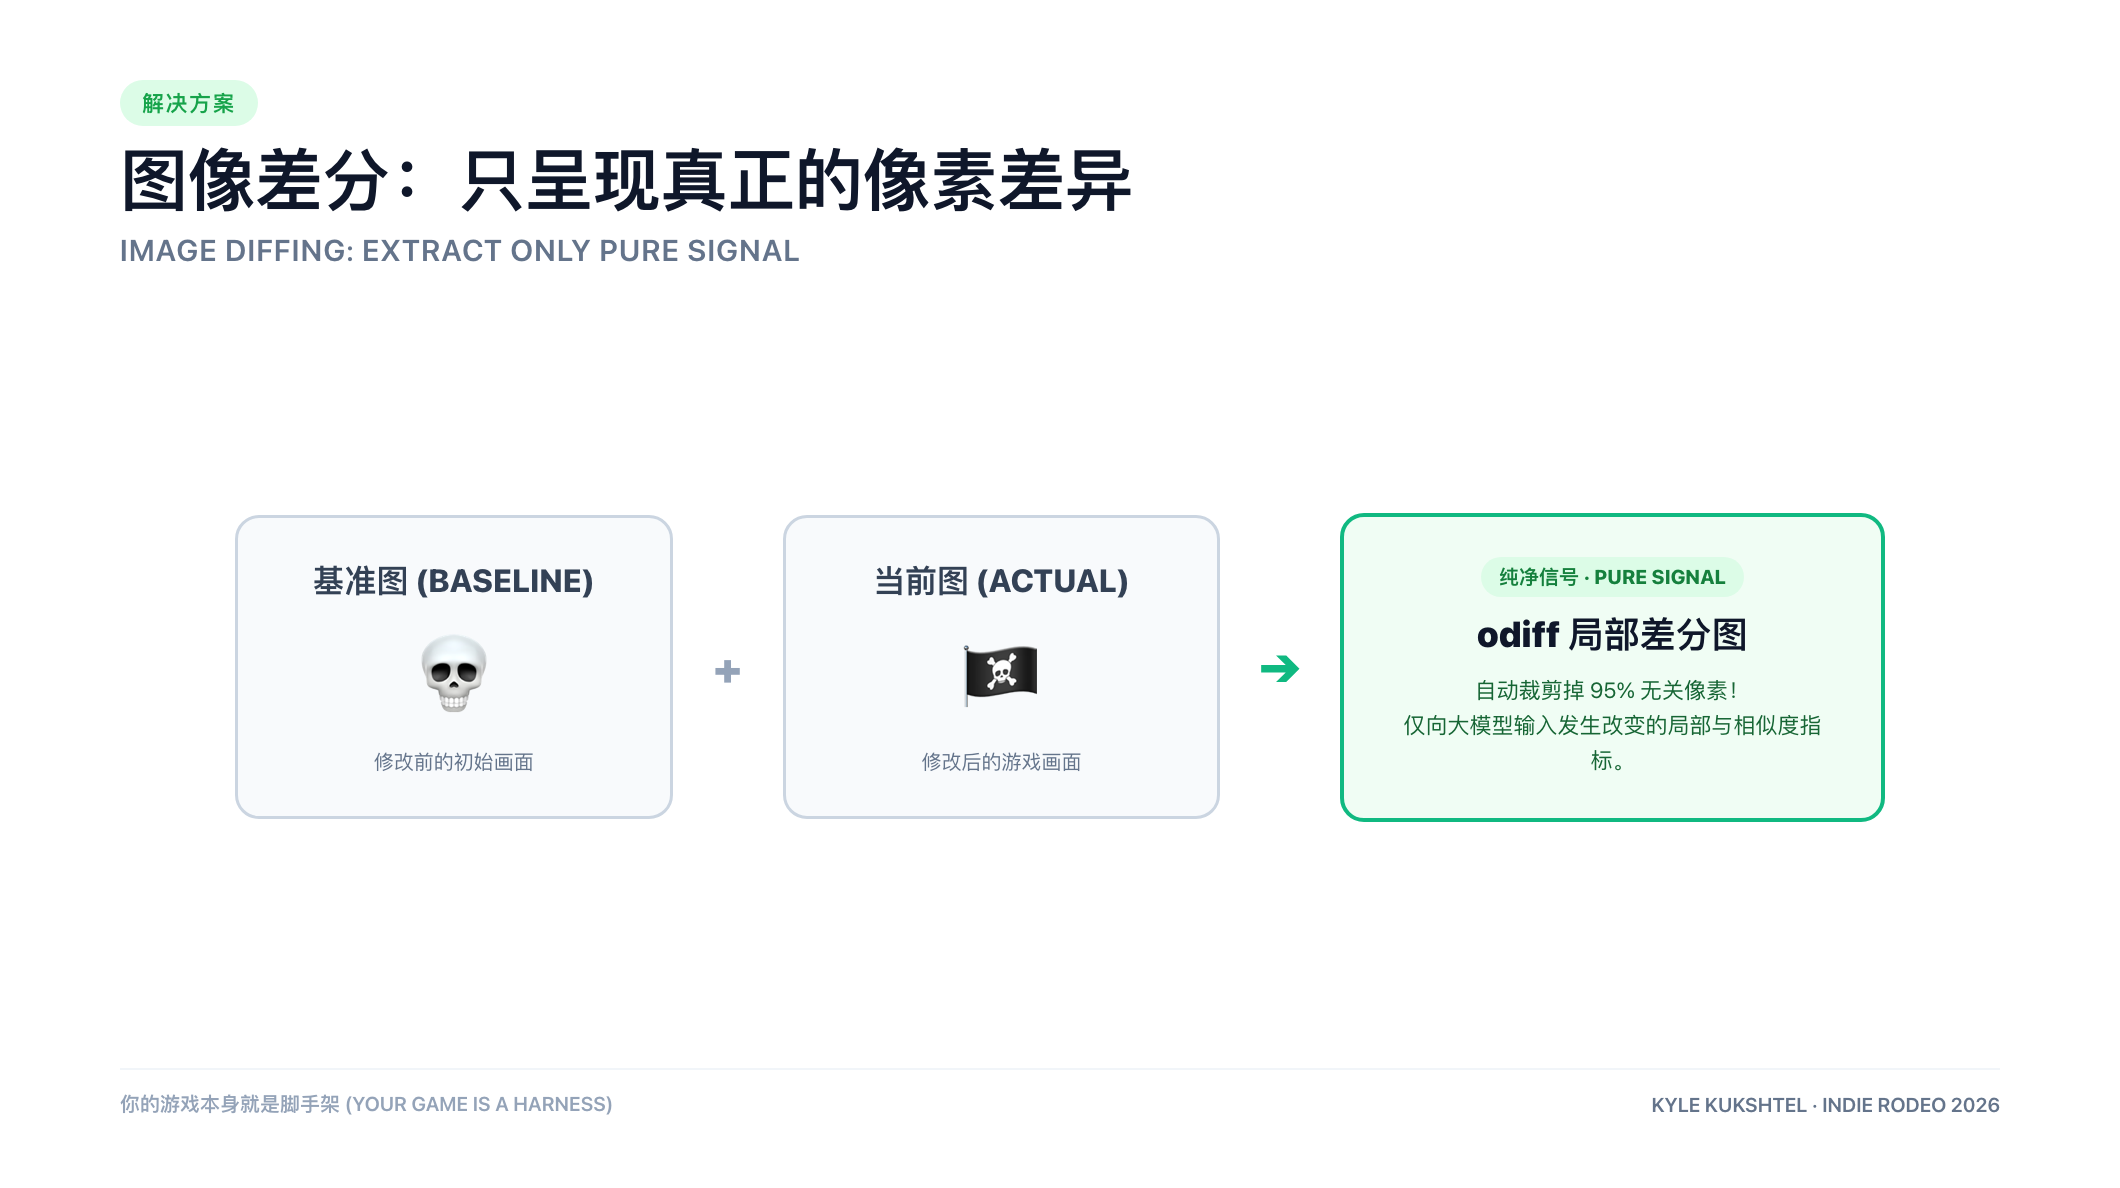
图像差分:只呈现真正的像素差异
就像我们在 Git 中对比代码 Diff 一样,如果你对两张图像进行数学差分并配合精准的局部裁剪,LLM 就能以极高的置信度直观看到变化,甚至能够获得一个量化的相似度指标。
幸运的是,你根本不需要从零手写算法。现在开源社区有一个非常优秀、免费且支持命令行的图像差分神器:odiff。
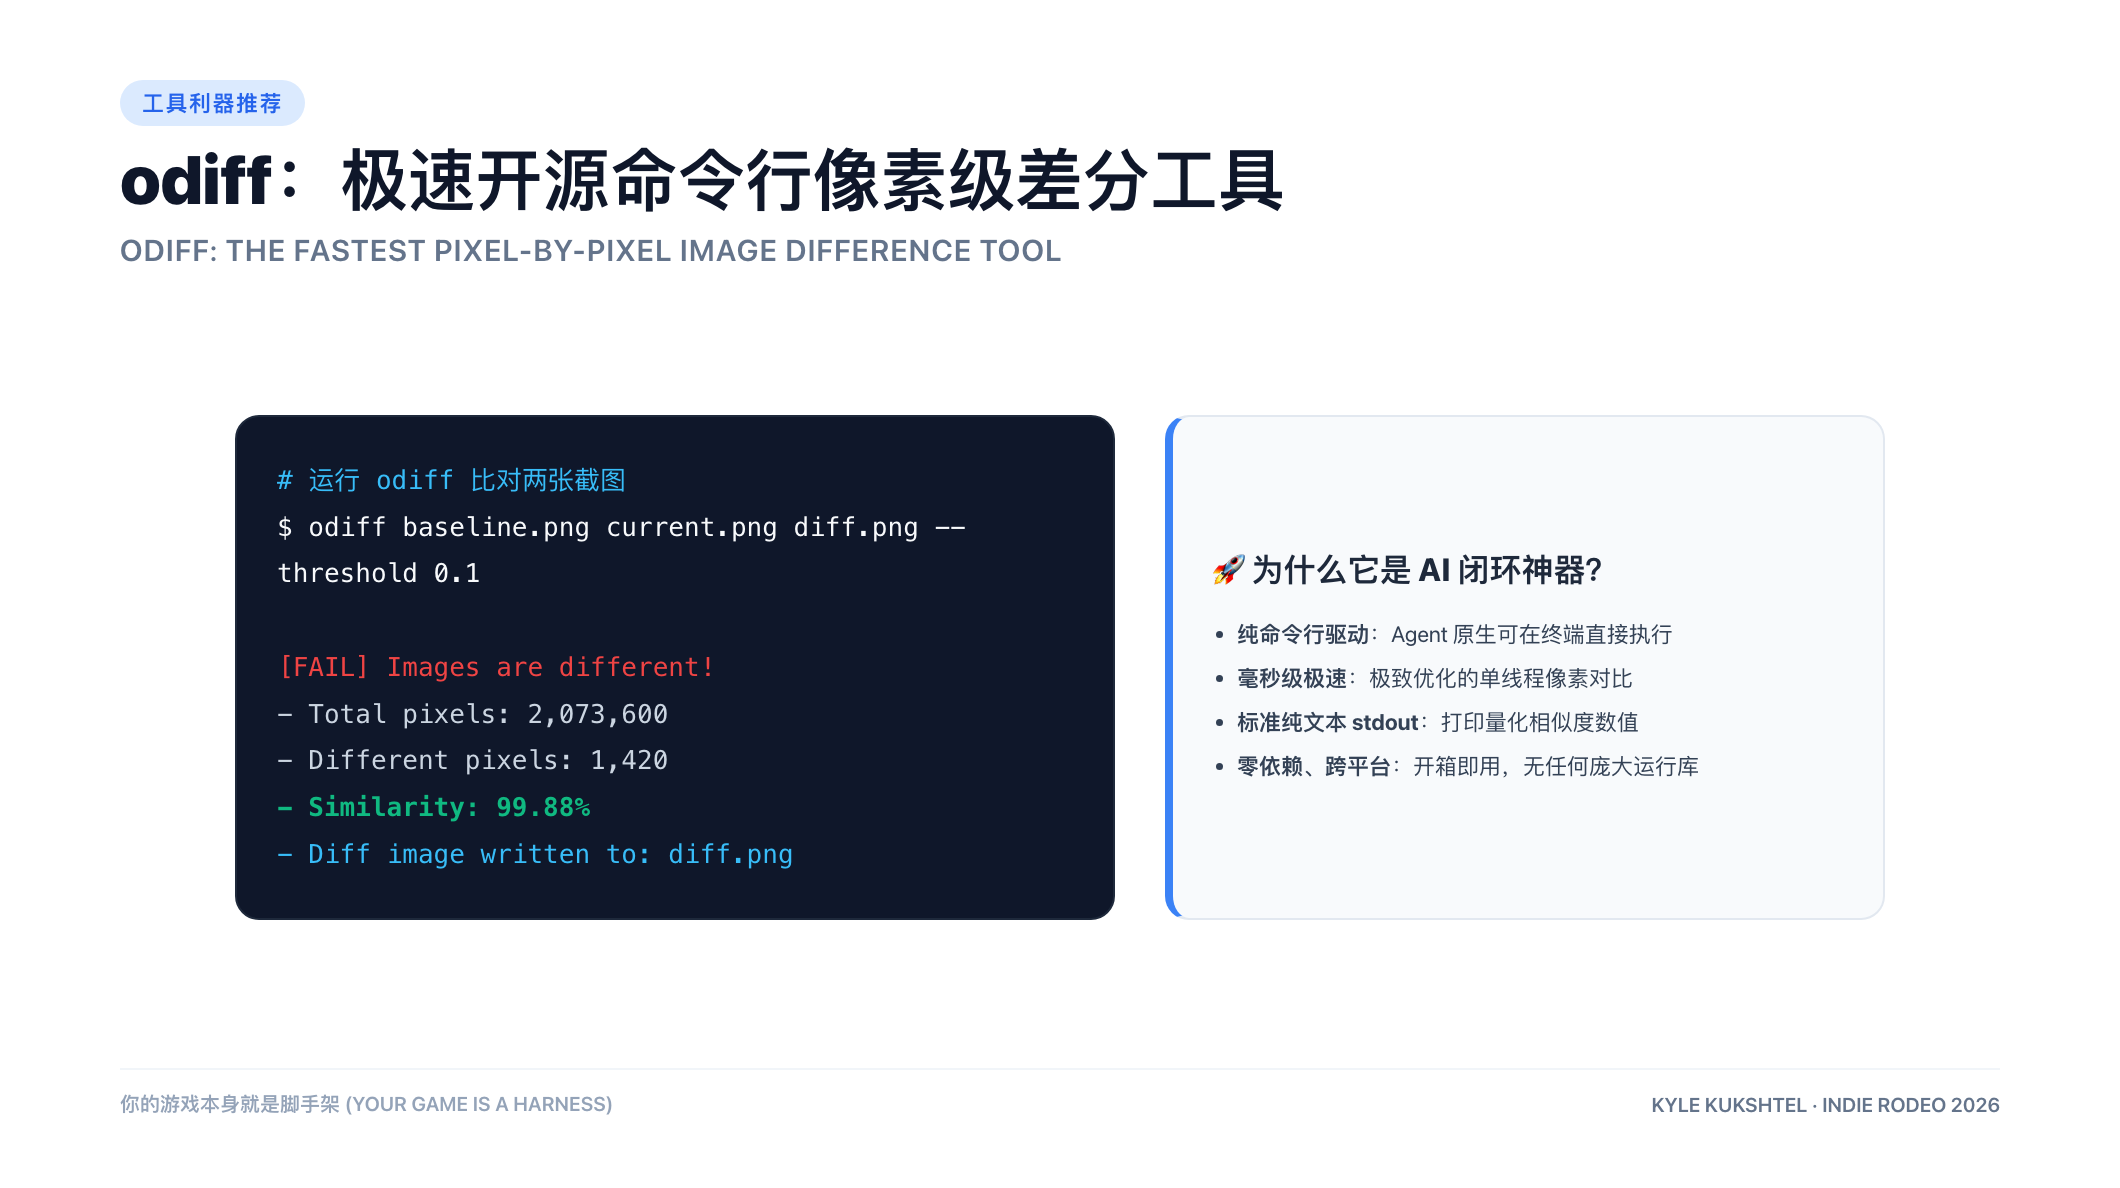
odiff 开源命令行工具
只要给它两张图片,odiff 就能瞬间计算出两者的差异,并直接输出一张高亮标注差异的 Diff 图像:
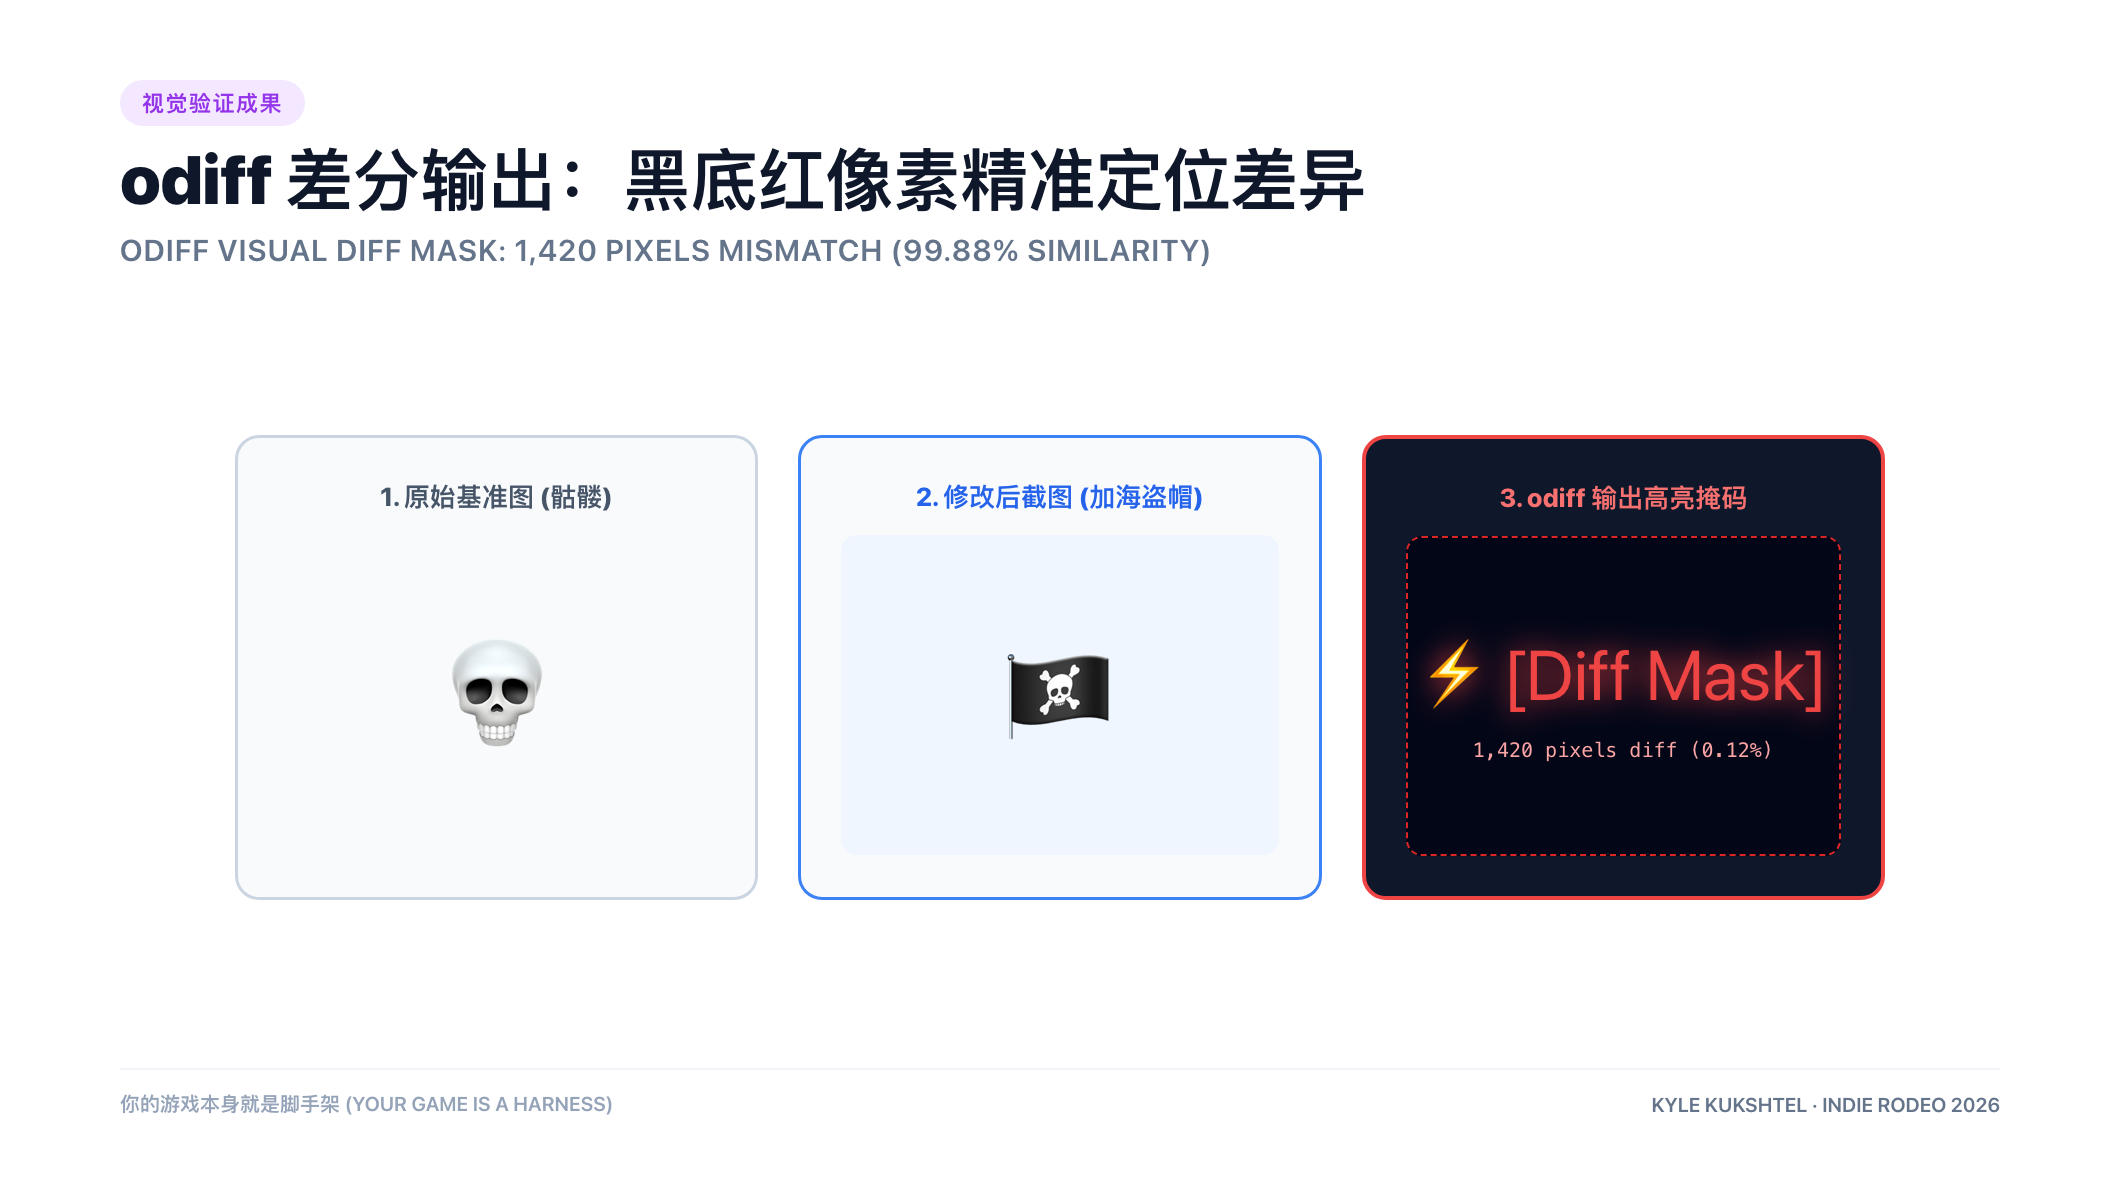
odiff 的差异高亮输出图
更绝妙的是,odiff 能够直接向标准输出打印出量化的相似度数值(比如 85% similar)。LLM 对这种纯文本数值极其敏感!在连续的 Agent 轮次中,它可以将这个百分比作为坚实的基准评估函数,自主朝着「降低差异/提高相似度」的目标稳步收敛。
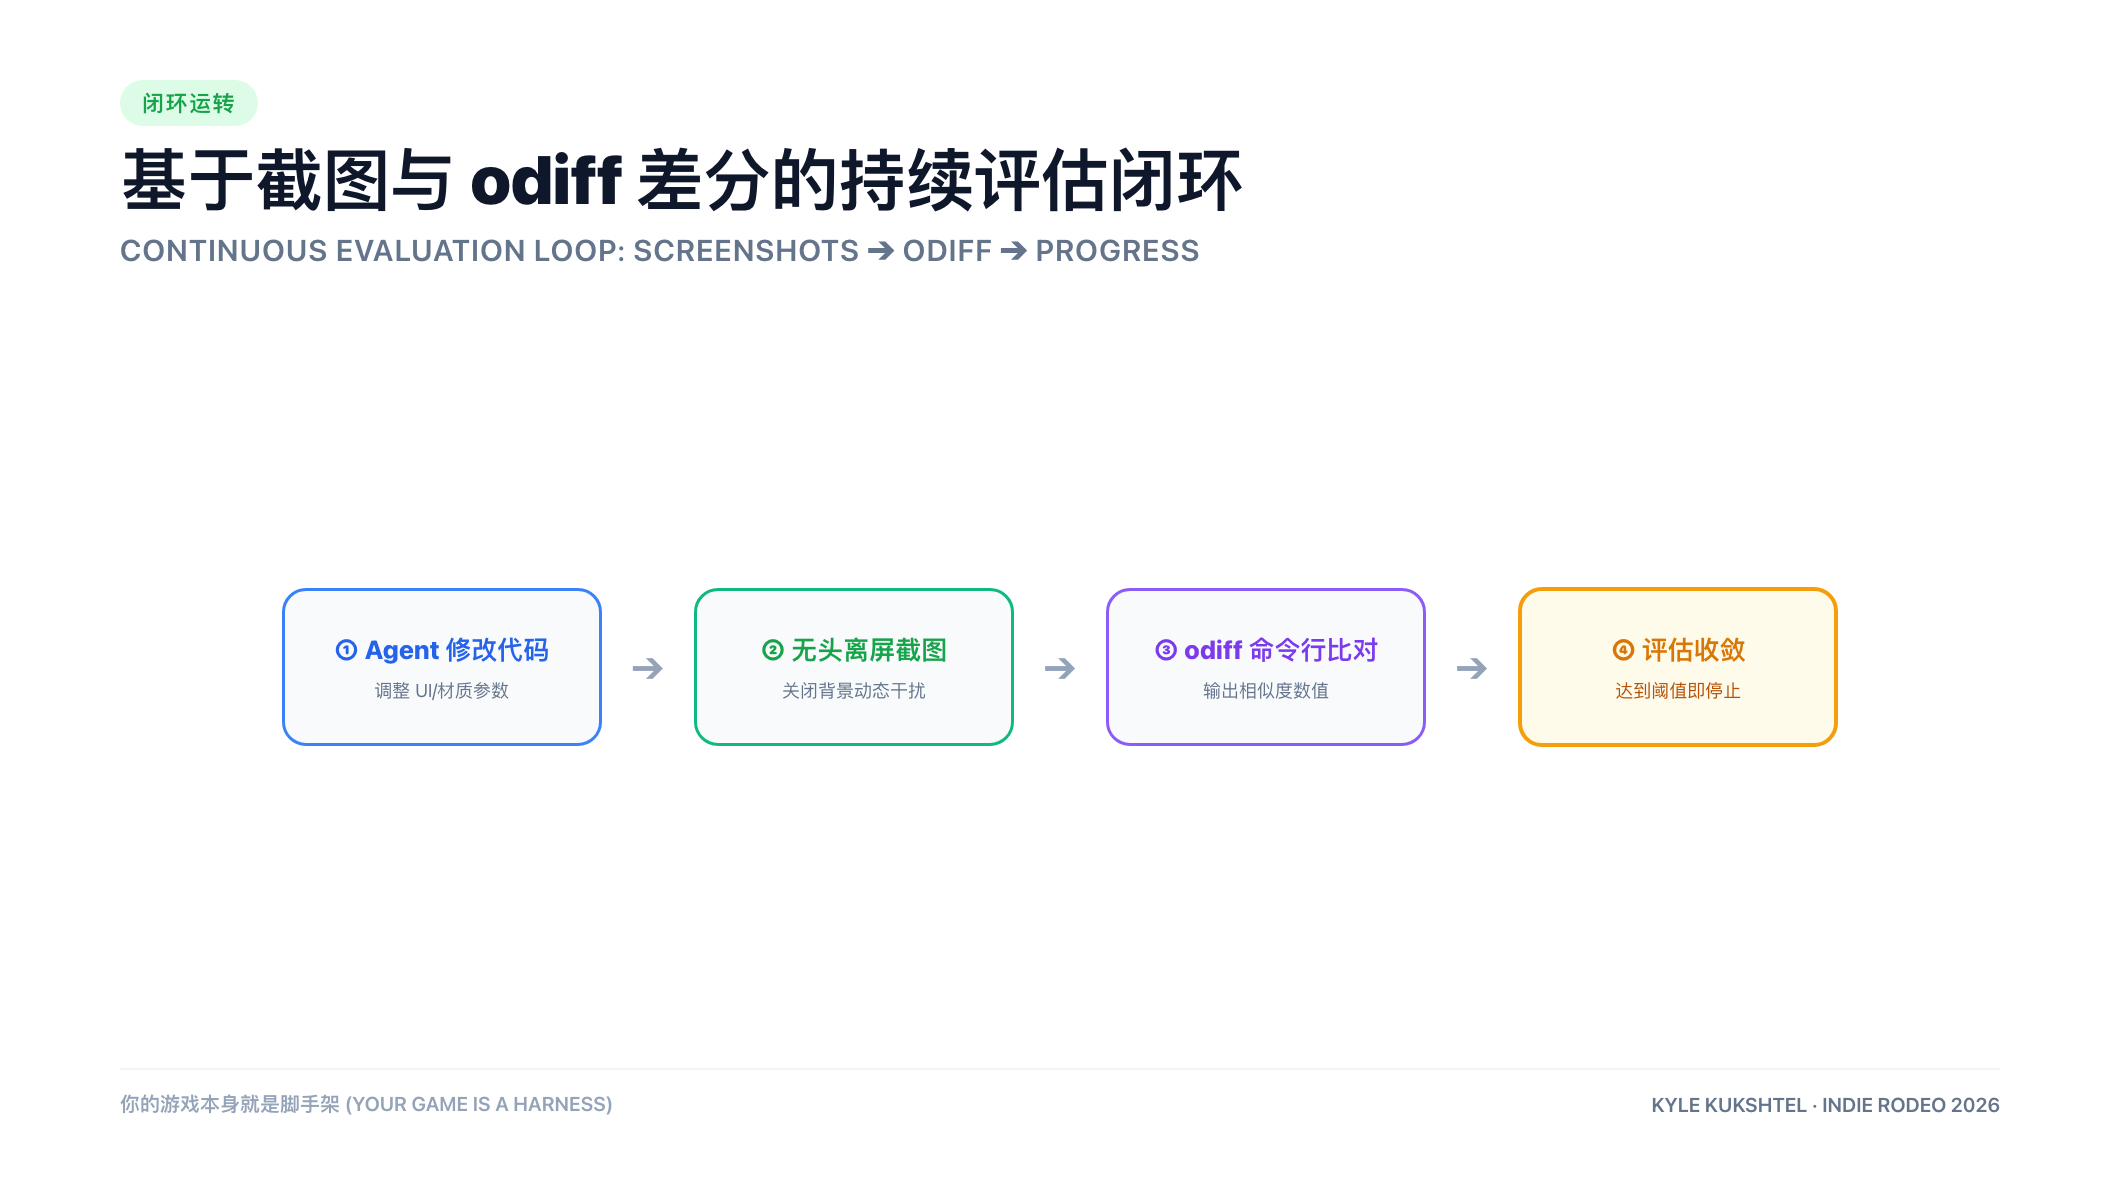
基于截图与 odiff 差分的持续评估闭环
但这还不是全貌。游戏绝不仅仅是静态的视觉画面。在视觉验证之下,还有一个更为关键的内部状态推进循环:
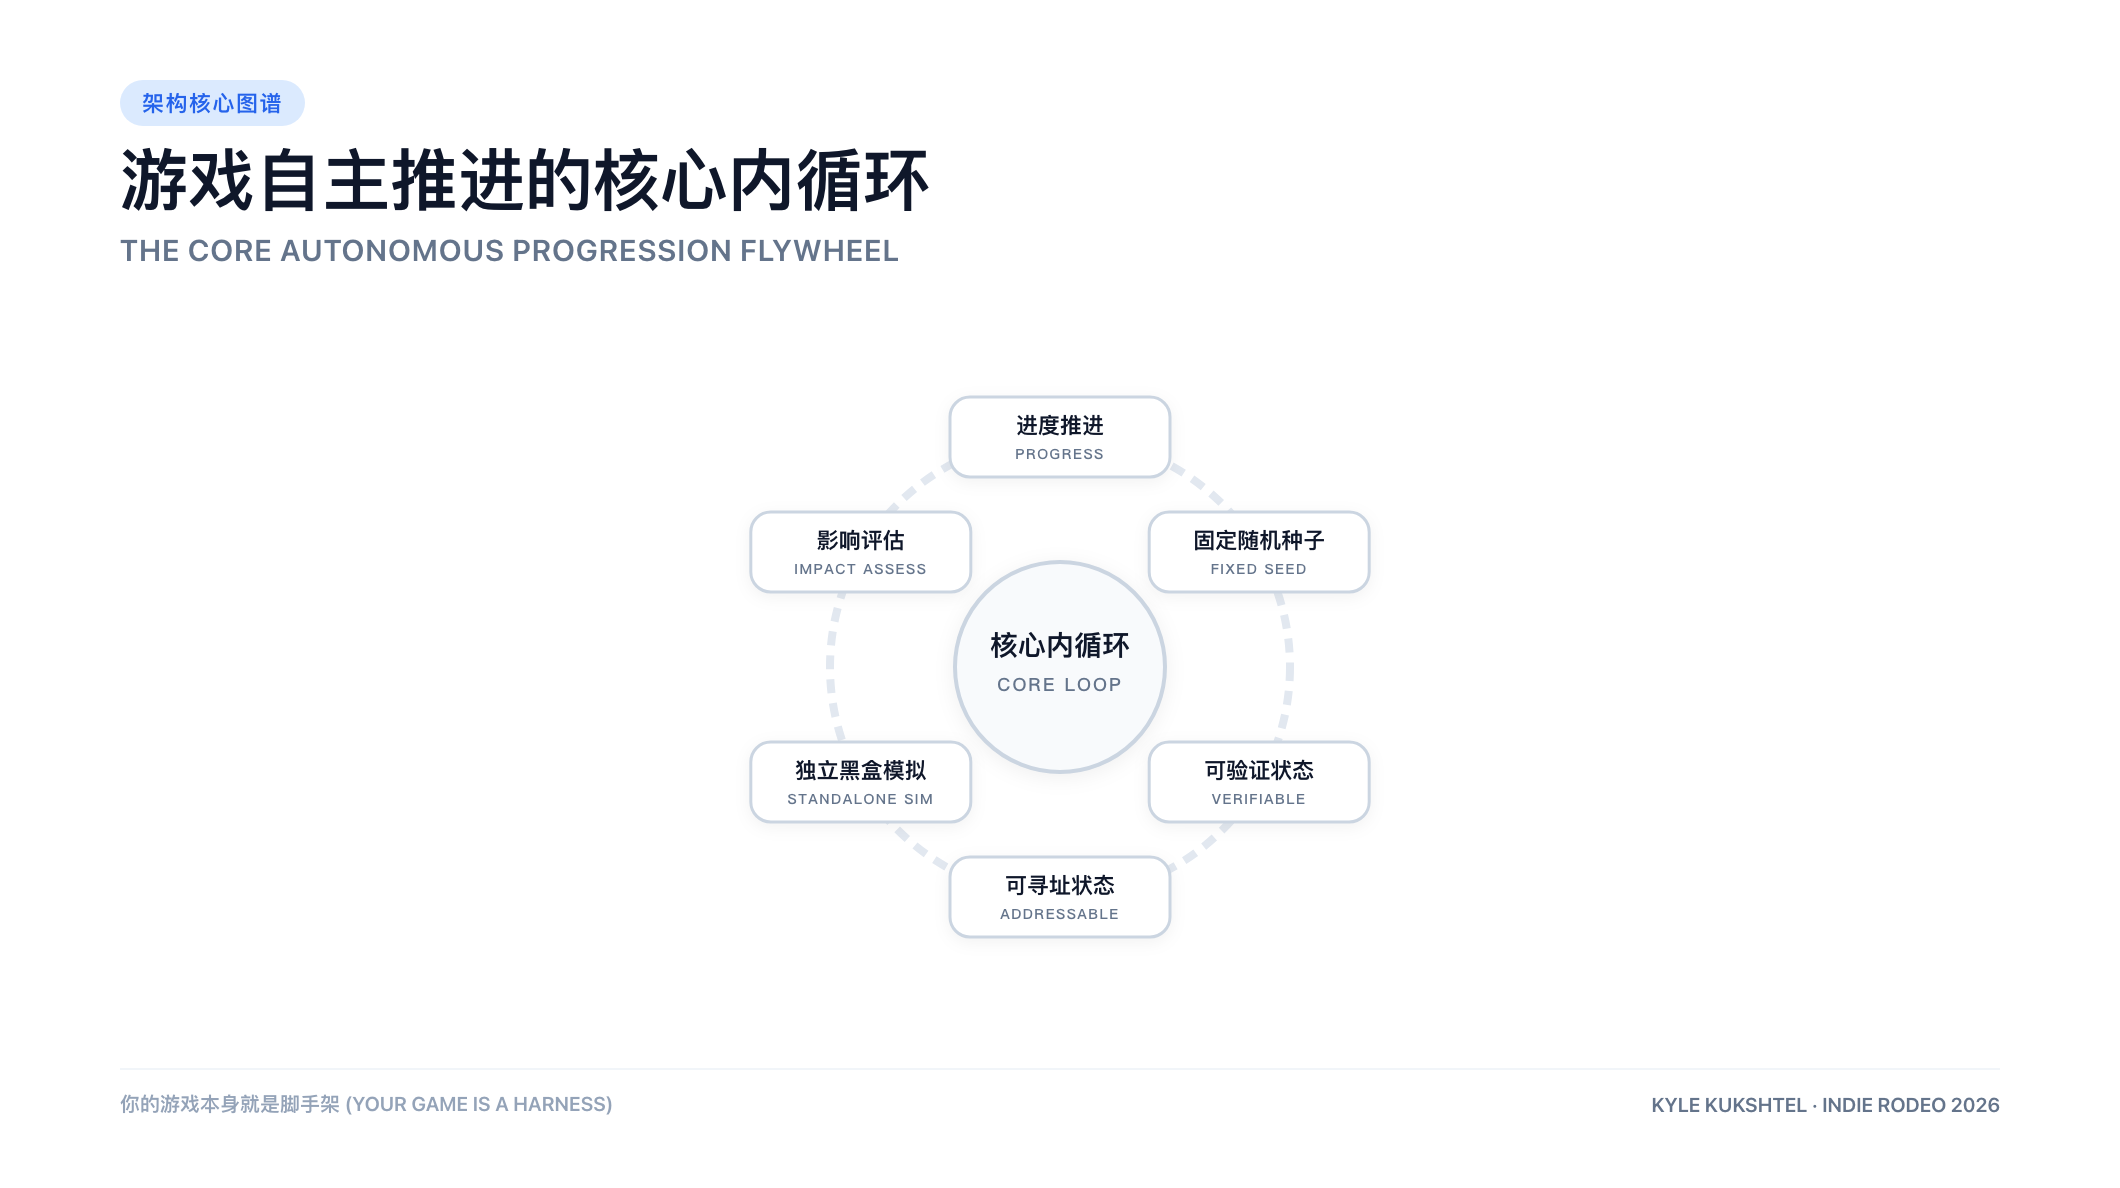
游戏推进的核心内循环
这个内部循环是 Agent 消耗最多时间的战场:在最终触发截图对比之前,它会在无视觉渲染的环境下自主跑上很多轮纯逻辑迭代。
我们的核心原则是:确保每一次改动都是达成目标所需的最小改动,并能被毫秒级验证。 你需要一个极其稳定、近乎「乏味」的代码基线,可以在近乎完全隔离的真空环境中执行推演,杜绝技术债务与面条代码的蔓延。
这就将我们引向了确定性状态的核心工程解法。
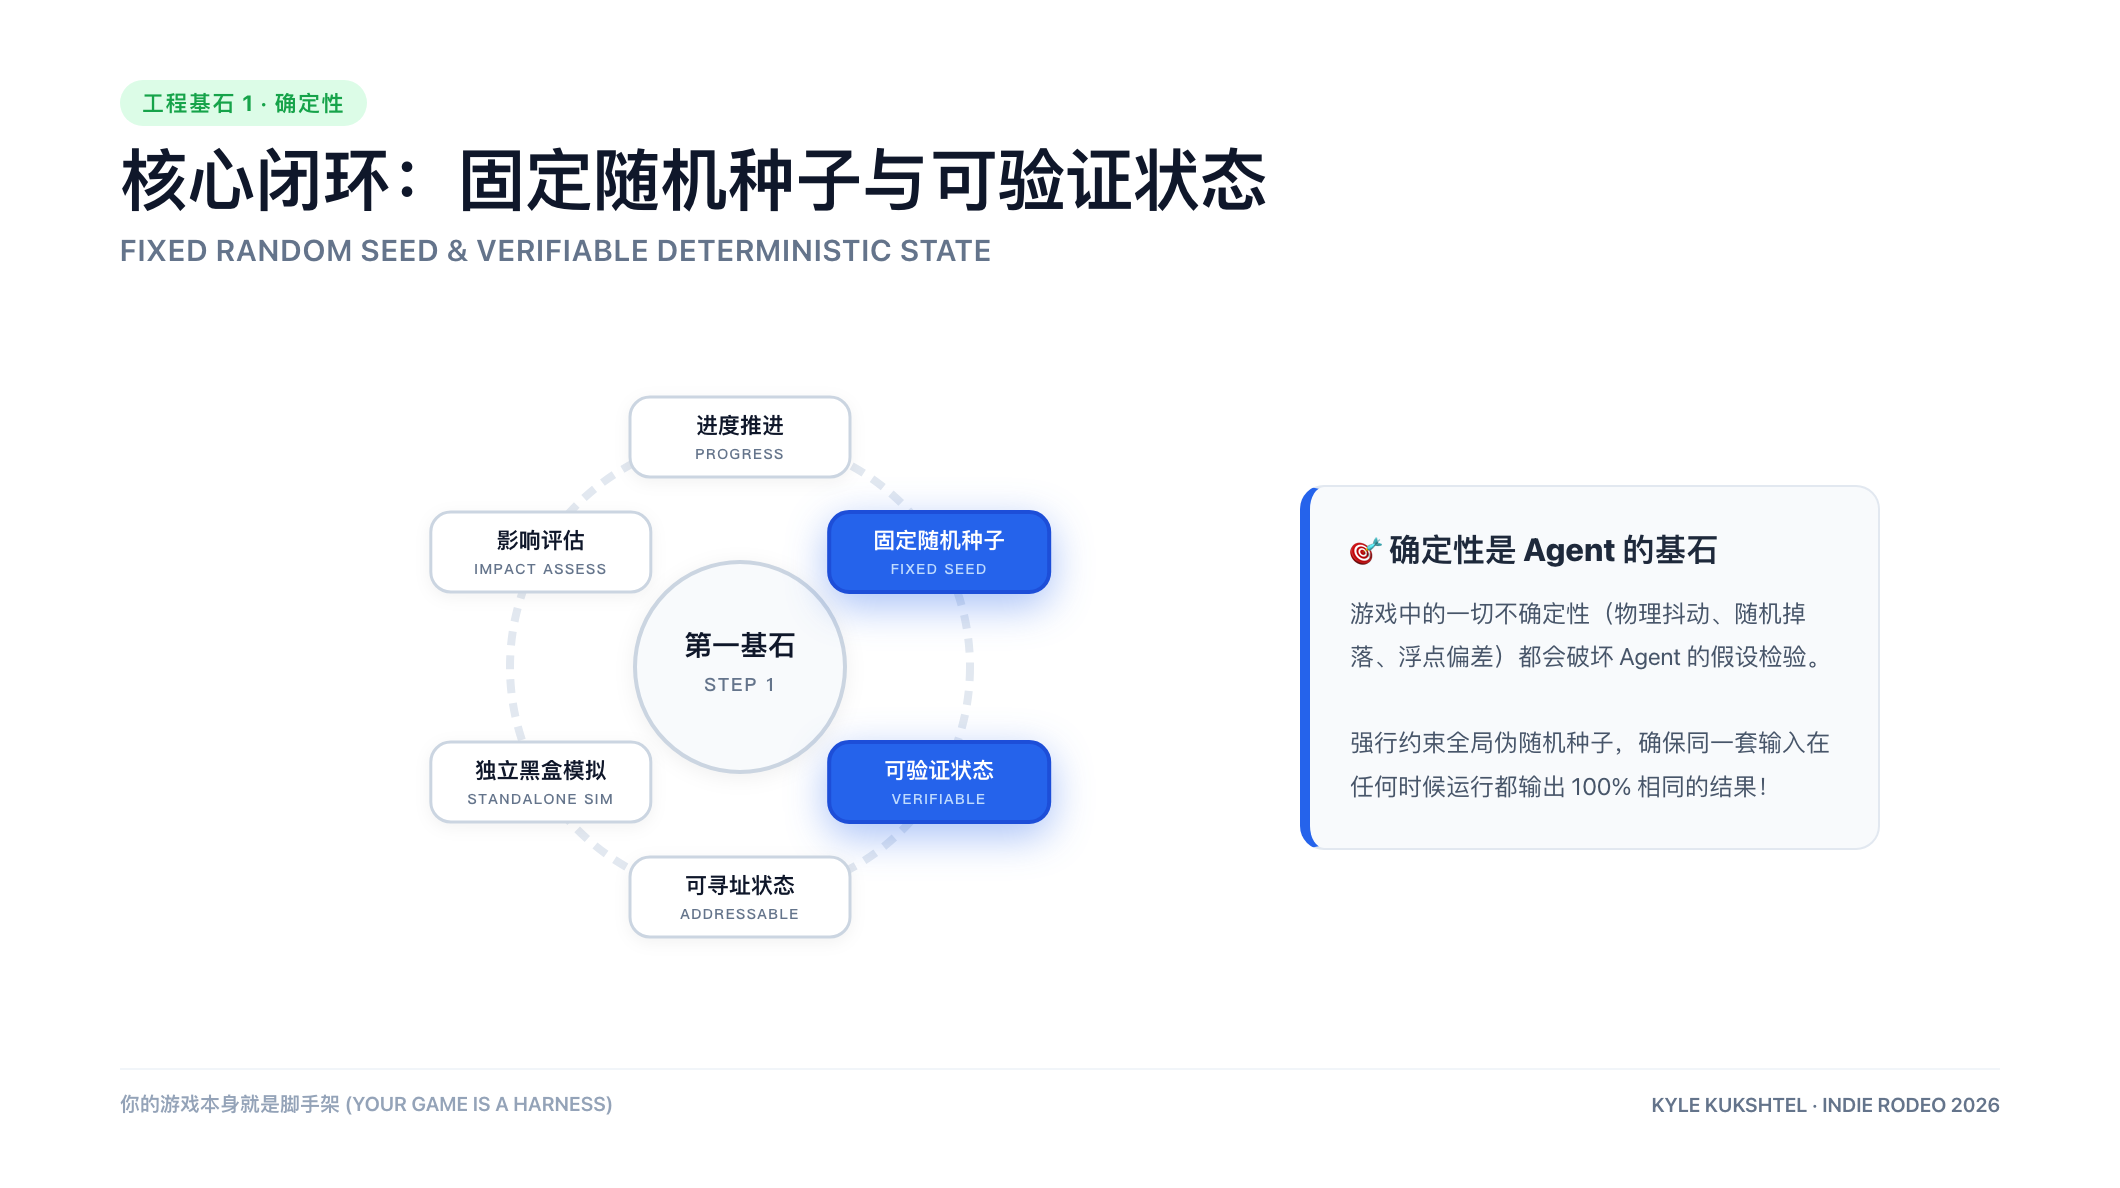
确定性状态的核心闭环目标
3. 确定性状态与单一 Fat Struct 构架构
评估一款游戏架构离「确定性状态」有多近,有一个极其简单的试金石:
在你的游戏中,完整保存并精确加载一个特定状态有多容易?
初学者常常把存档/读档当成开发后期才打补丁挂上去的一个普通「功能」;但是资深工程师深知,如果从开发的第一天起就将存读档机制融入整个架构设计,它将成为贯穿全生命周期的工程超能力。
让我们来看一种革命性的设计哲学:
「树就是狗」:面向对象在游戏后期的破产
大多数长期沉浸在传统面向对象层次结构中的游戏程序员,在项目快收尾时都会痛彻心扉地意识到屏幕上的这句话是多么真实:「树就是狗」。
当你审视具体逻辑时会发现,这两个在现实中天差地别、在 OOP 体系里继承链迥异的实体,从游戏底层代码的角度来看,实际上是同一种东西:
- 树:拥有 Mesh(网格)、Collider(碰撞体)。
- 狗:拥有 Mesh、Collider,外加移动能力。
「移动」并不是狗独有的专属性质(游戏里其他东西也会移动)。因此,树和狗无非是若干组件的不同组合形式而已。在底层代码的视角下,它们完全是一回事。
这种洞察在初听时可能违背直觉,甚至让人感觉「不适」。但只要你打破这种执念,就会豁然开朗:你终于可以摆脱为了维持复杂 OOP 类层次结构而构建起来的那堵令人窒息的抽象之墙。
拥抱 Thing 驱动开发
如果你把这个理念贯彻到底,你完全可以在游戏立项伊始就做出一个大胆假设:游戏里的一切本质上都是同一种结构(我们不妨直接将其定义为 Thing 结构体):
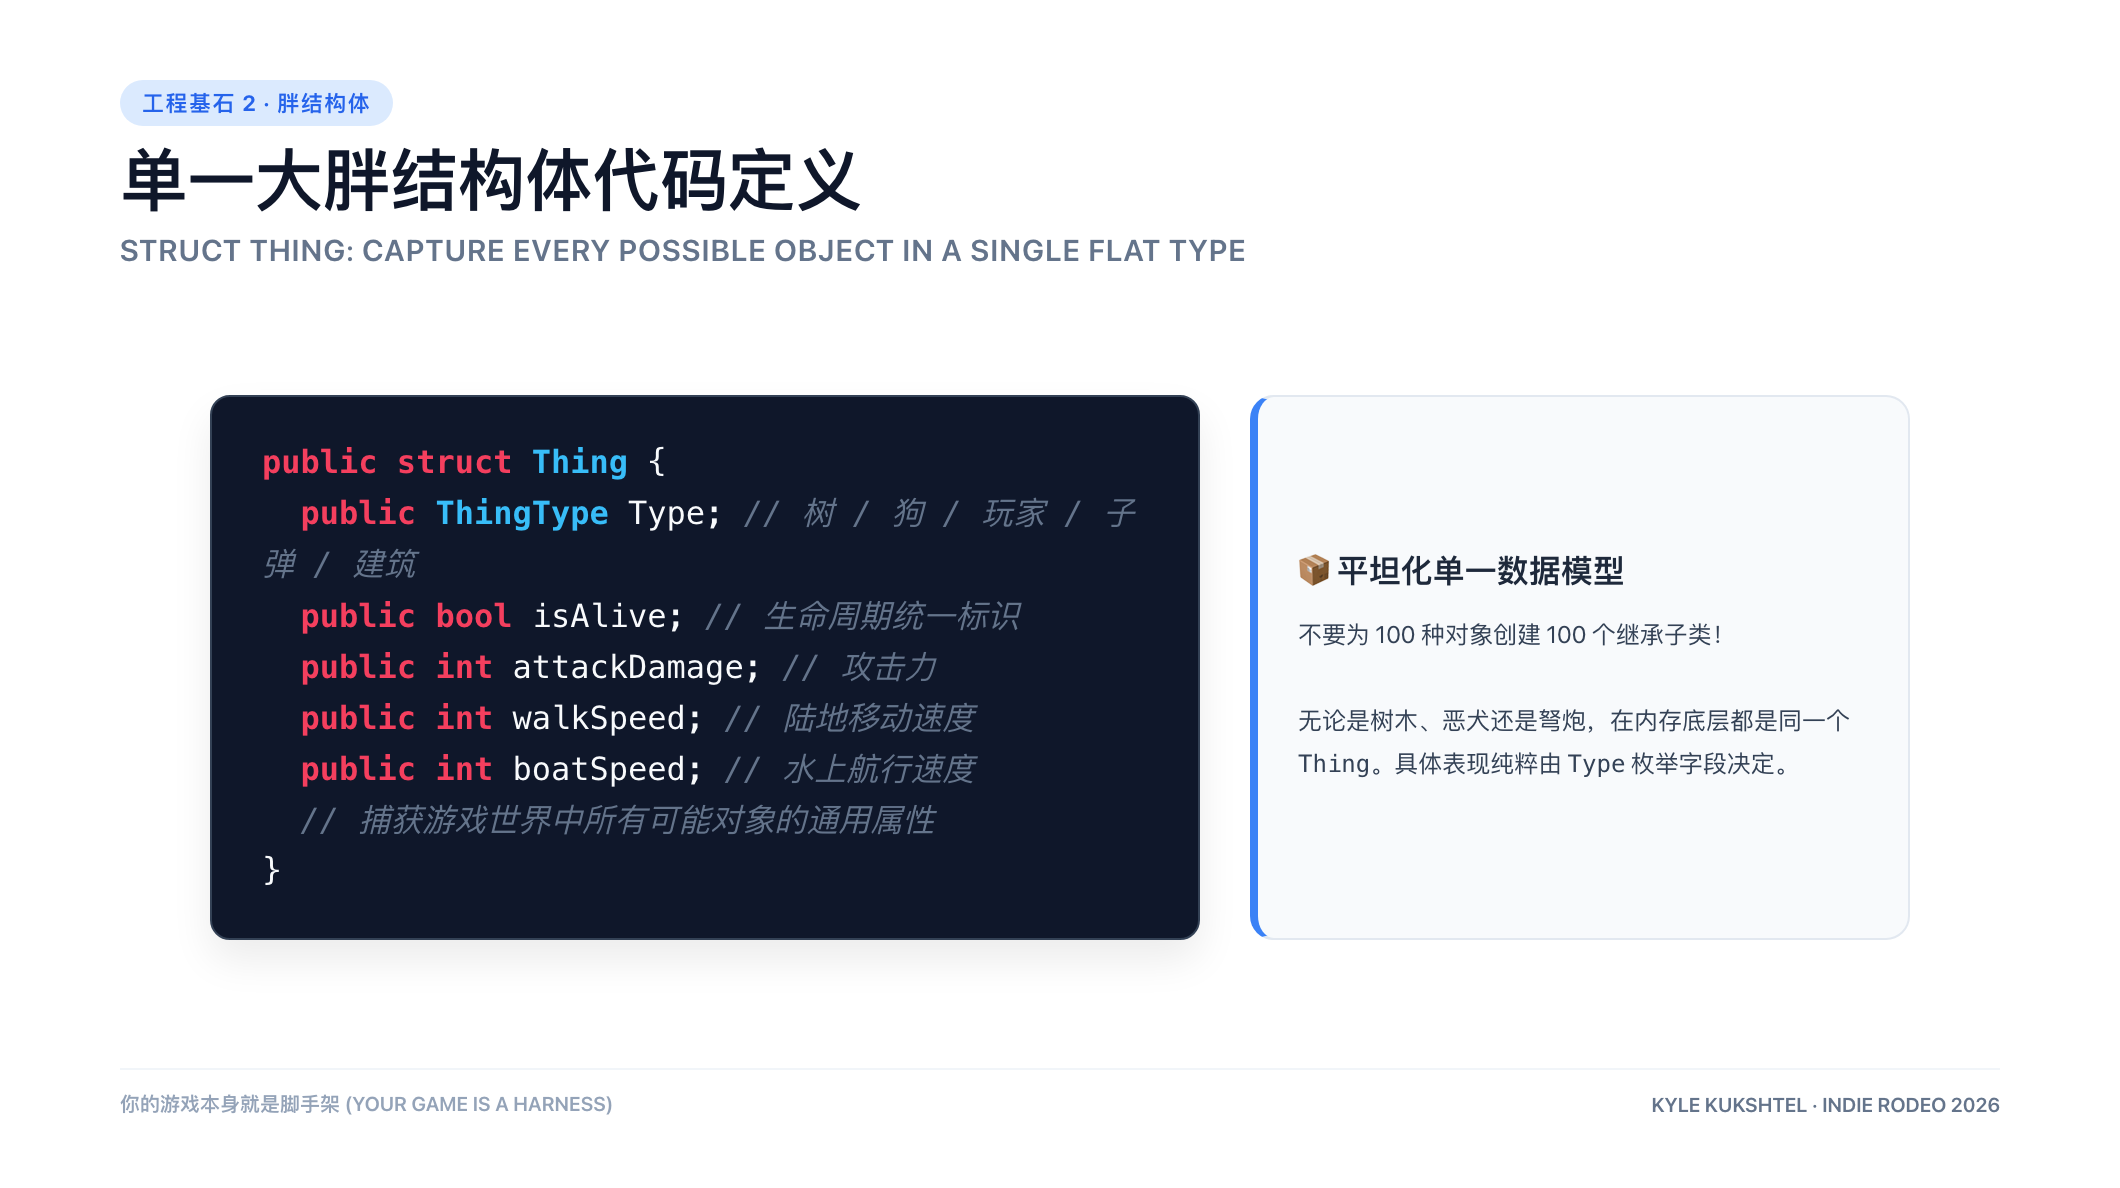
单一大胖结构体定义示例
在这个结构体中,包含一些通用的基础属性数值,以及由 isAlive 标志表达的生命周期概念。至于实体的具体类别,纯粹由一个枚举字段 Type 来标识;具体的游戏逻辑代码根据枚举值进行分支处理。
而事实证明,AI 简直爱死这种结构了!
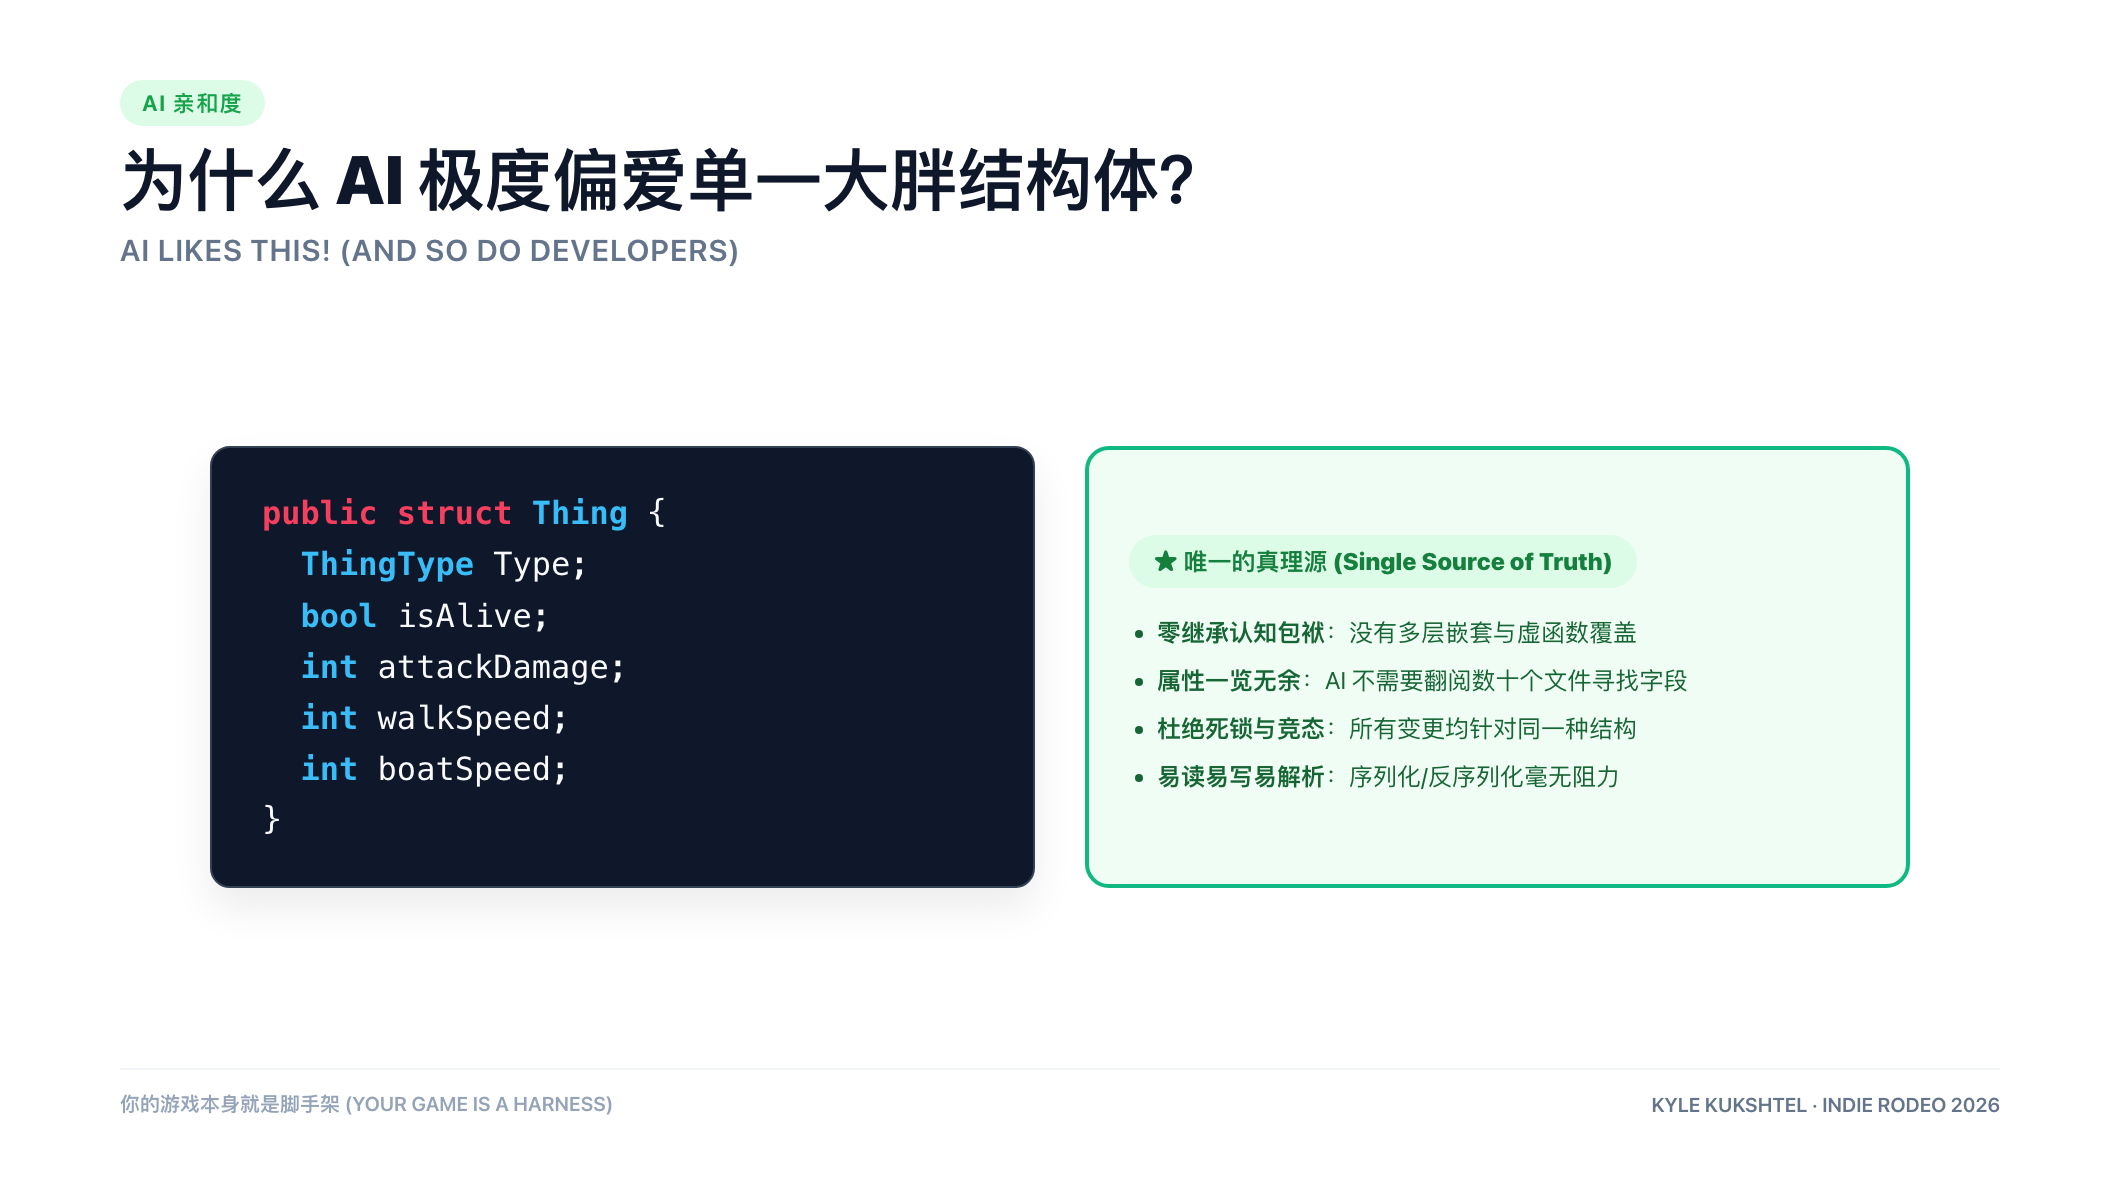
AI 对单一数据源结构的天然亲和度
在这种架构下,你的对象模型拥有了唯一的真理源。反观传统的 OOP 架构:如果你为 100 种对象定义了 100 个继承类,AI 为了完成一个修改,就必须把这 100 个类及其隐式继承关系全部读进上下文。这会瞬间塞爆上下文窗口,让 AI 陷入严重的决策焦虑:「我到底应该继承哪个基类?还是重构父类方法?亦或是新建一个派生类?」
而在单一大结构体下,不存在任何模棱两可。AI 在每一次改动中,都清清楚楚地知道该去哪里下刀。
不仅如此,单一结构让存档和读档变得无比低幼和健壮:
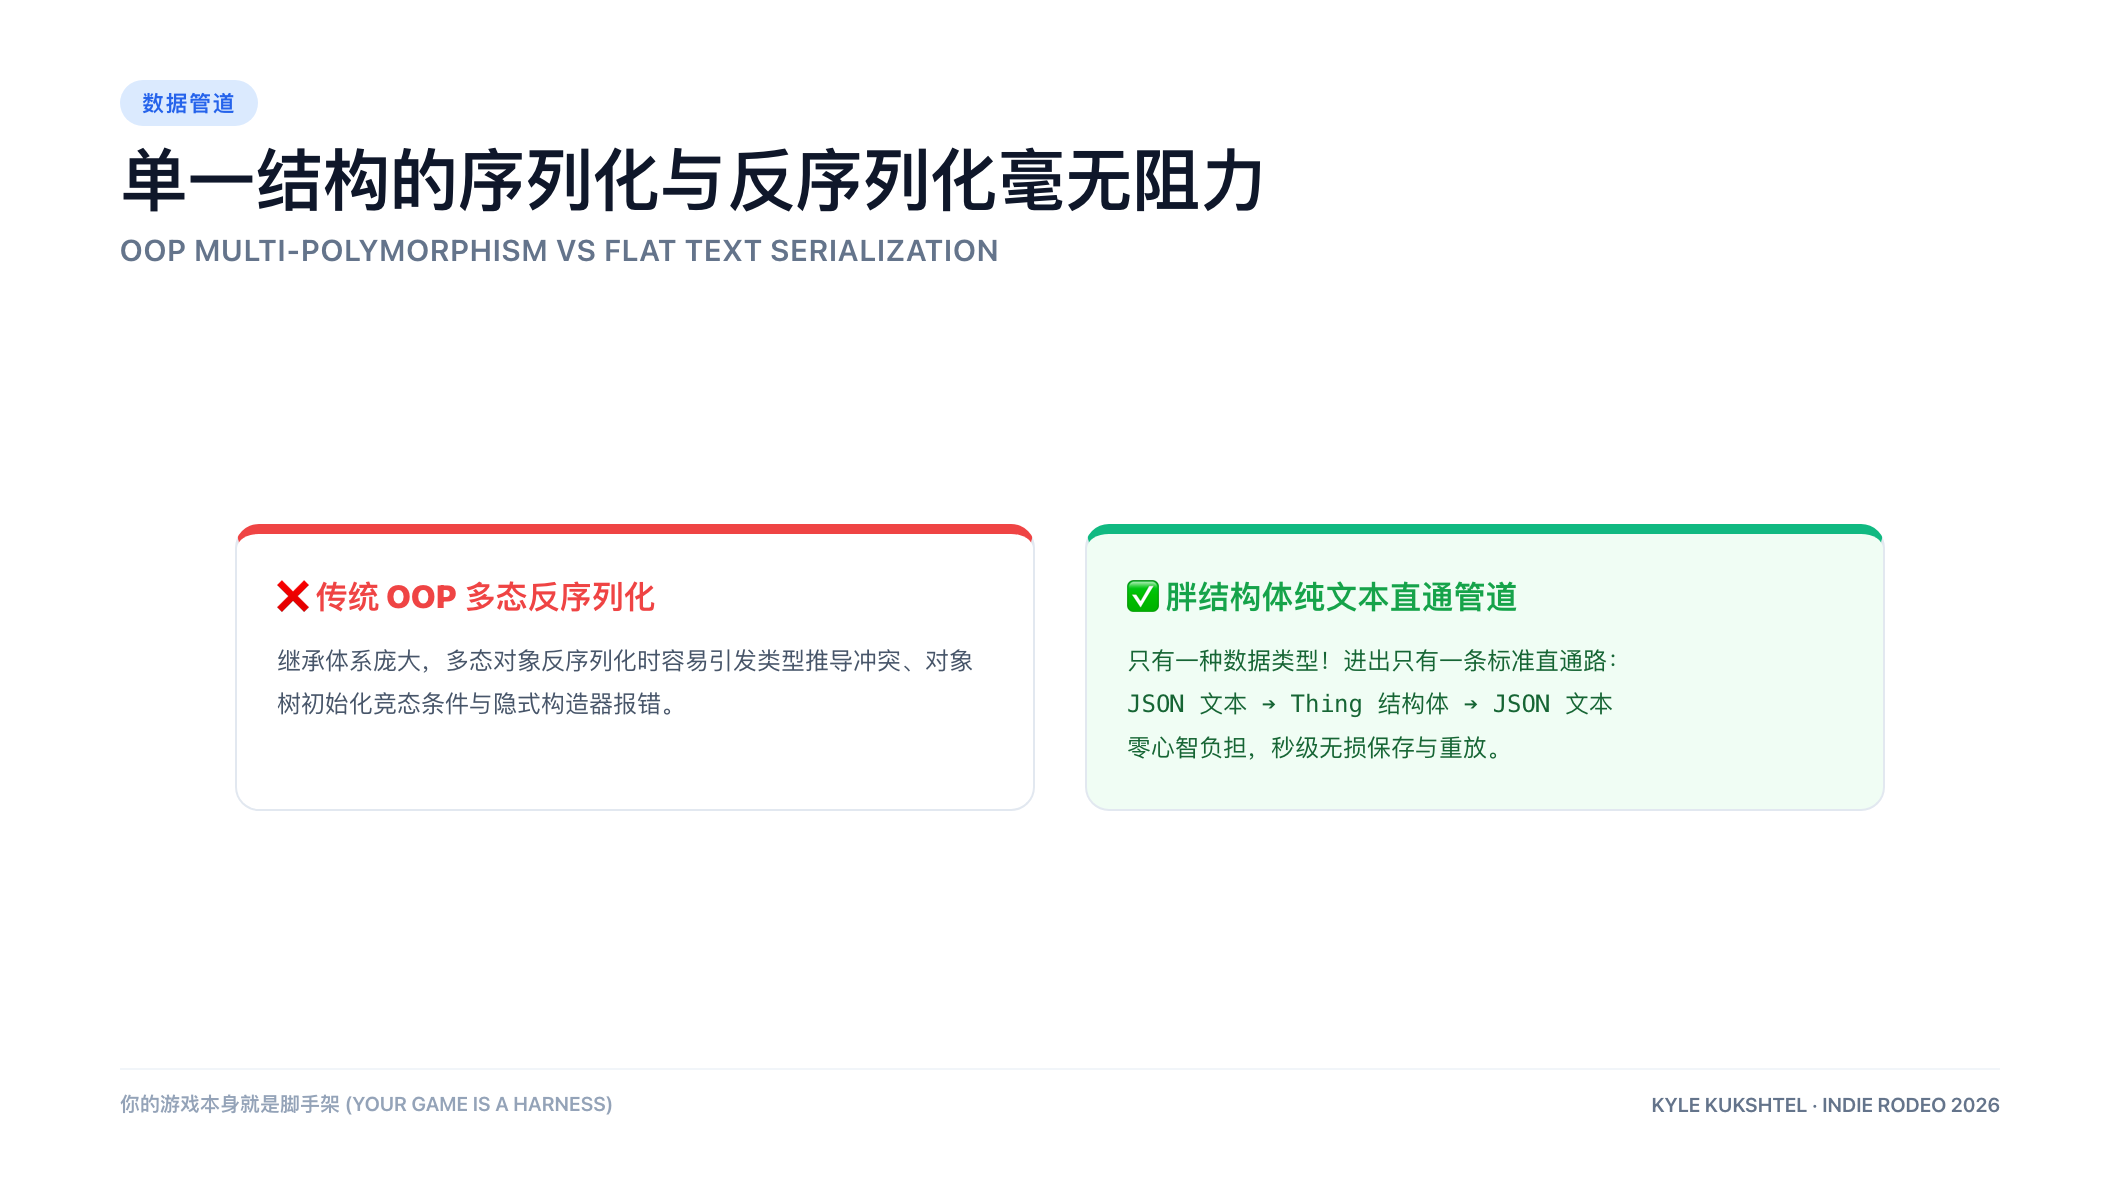
单一结构体的序列化与反序列化毫无阻力
当只有一种数据类型时,序列化和反序列化变成了单向直通的高速公路,进出只有一条标准管道。如果换成数十种派生类,你就会在反序列化时撞上由于对象依赖树引发的竞态条件,被迫去跟微软文档里令人头秃的「多态反序列化」死磕。在游戏开发中,那里全是致命暗坑。
在 Thing 架构下,整场游戏无非就是一个巨大的 List<Thing> 列表。保存就是把这个列表一次性导出,加载则是完全对称的反向解析。枚举分支判断纯粹发生在反序列化后的逻辑层,清爽至极。
4. 可寻址状态与命令模式
一旦你建立了上述基础,游戏其他模块的复杂度也会应声瓦解。
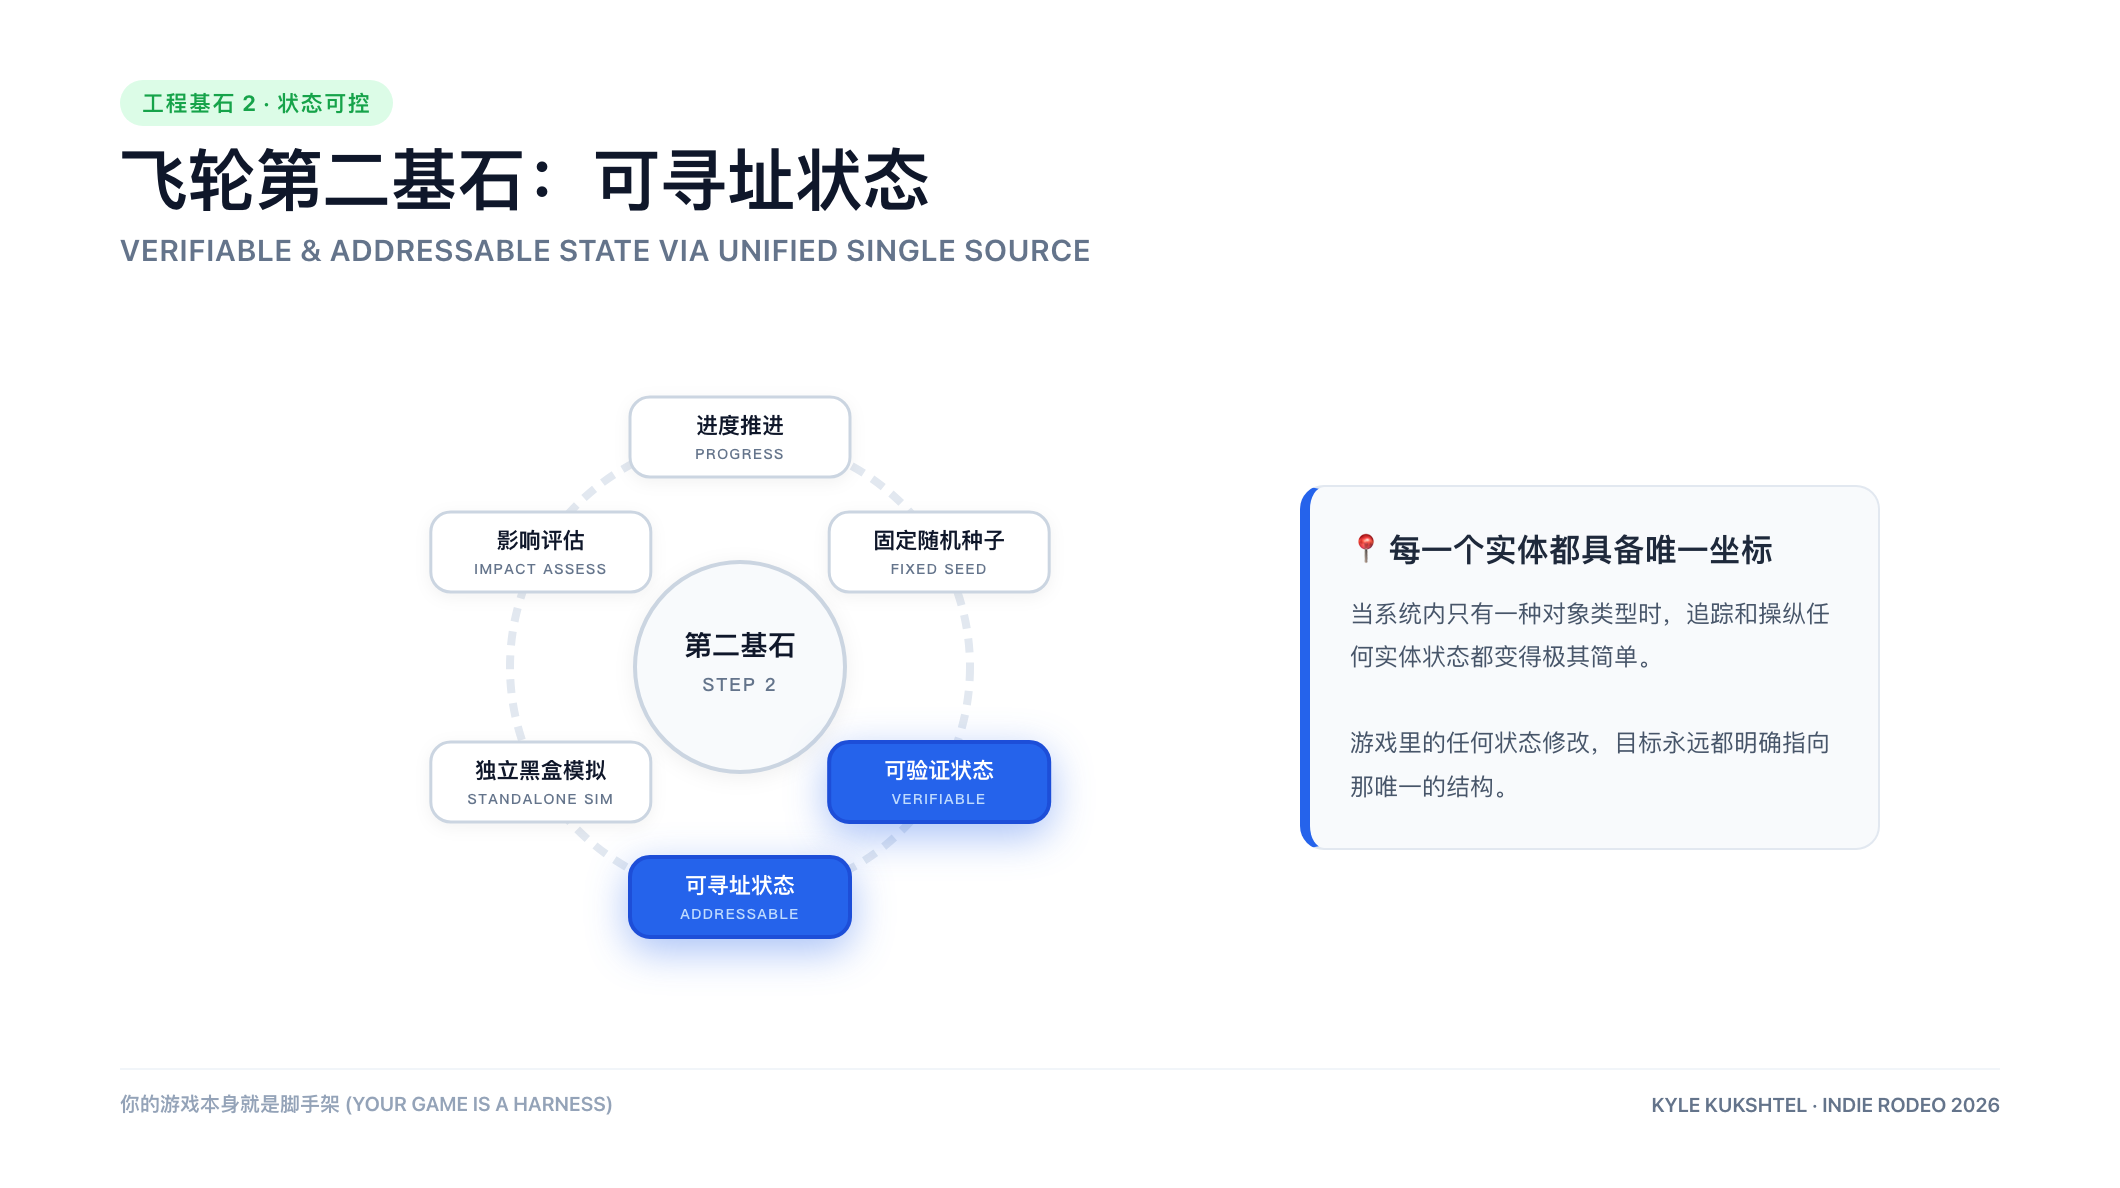
状态的可寻址性
如果系统内只有一种对象类型,那么捕获并追踪状态变更就会变得极为简单,因为游戏里的任何修改,目标永远都明确指向那唯一的结构。
在此基础上,我们可以极其自然地引入经典的命令模式:
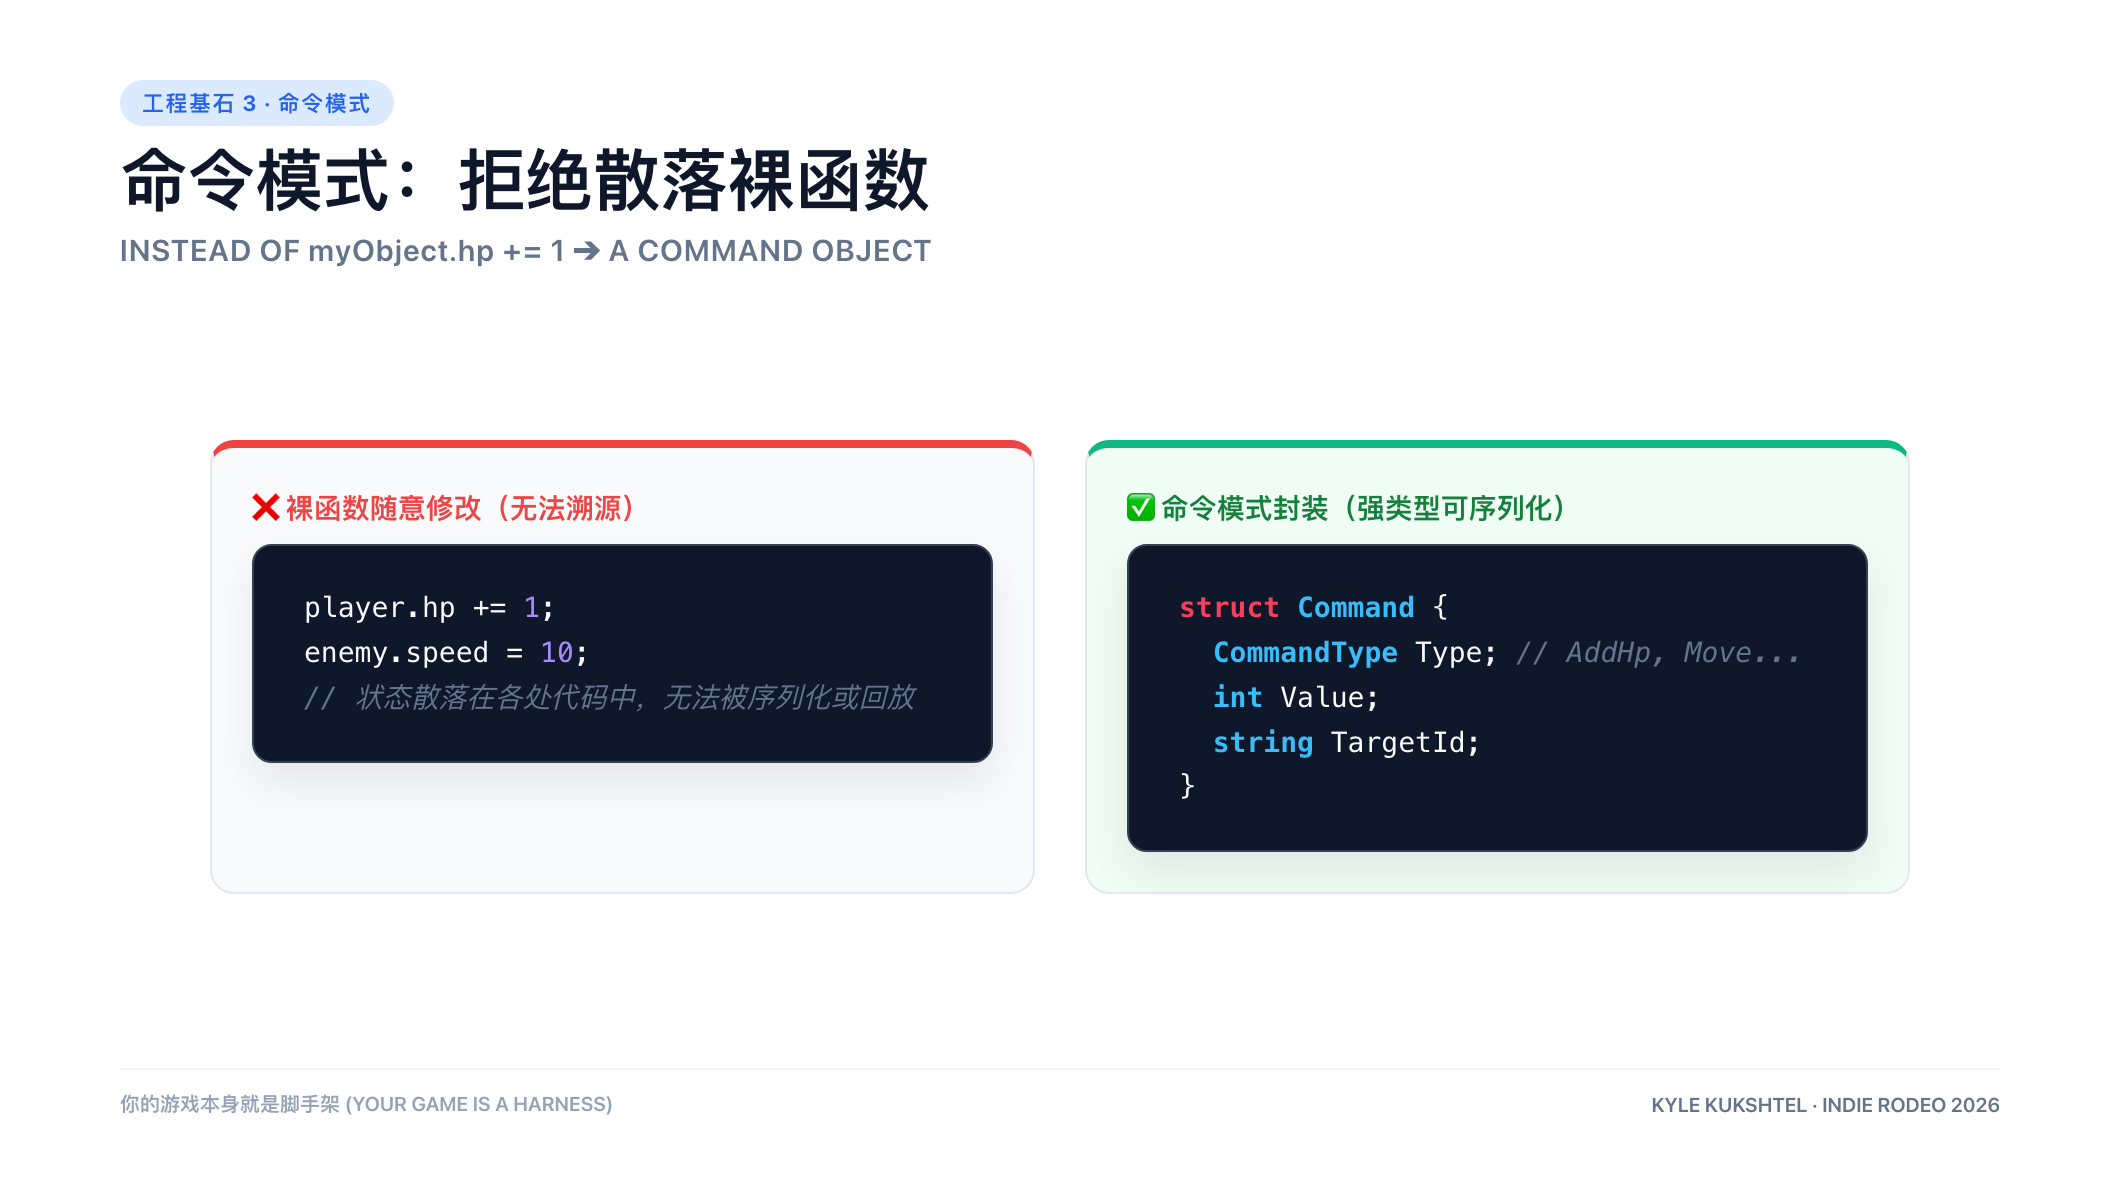
命令模式架构
命令模式的核心思想是:不再直接散落调用修改对象字段的裸函数,而是将每一次变更封装为一个(理想情况下可序列化的)命令对象。 这些命令被排队送入统一的处理器,由处理器集中对对象实施变更。
看似多了一层间接引用,但它的威力惊人:
假设玩家在游戏中进行了一连串操作,触发了某个恶性 Bug。在传统模式下,你得想方设法联系玩家,尝试根据模糊的口述在自己的电脑上碰运气复现。
但在命令模式下,你只需要拿到初始状态快照,然后原封不动地「回放」序列化后的命令流,就能百分之百精确重现该 Bug!
更重要的是,这套机制不仅能供人类使用,AI Agent 也可以全自动回放这一命令序列,在其自主尝试修复代码的过程中,随时校验状态是否符合预期。
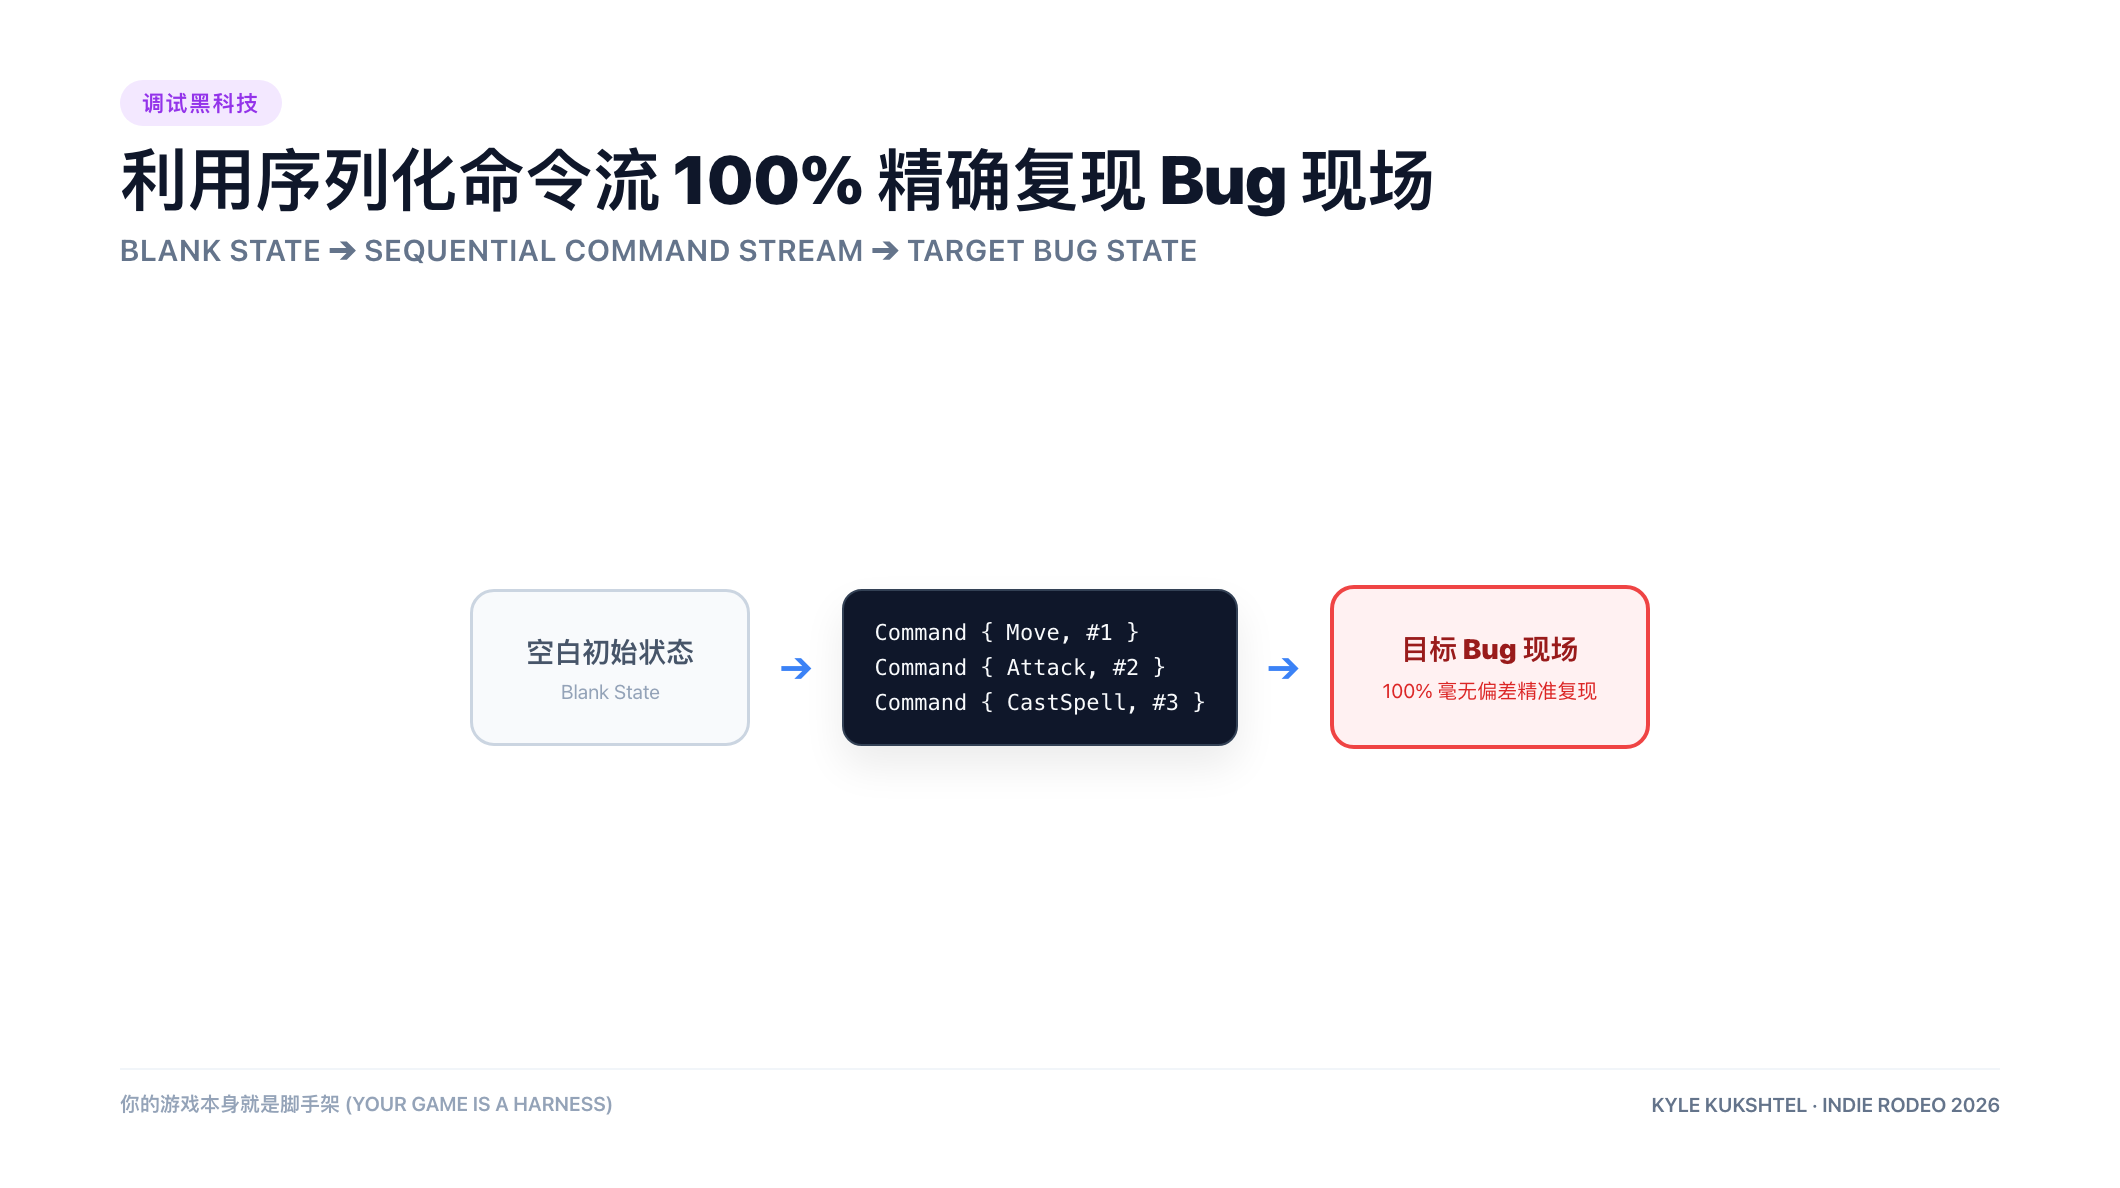
利用序列化命令流 100% 精确复现 Bug 现场
再往前迈一步:你甚至根本不需要在游戏客户端里手动操作来生成这些命令。你(或者 AI)可以在任何文本编辑器里手工编排一组 JSON 命令,然后直接注入到正在运行的游戏实例中执行,全程无需任何代码编译!
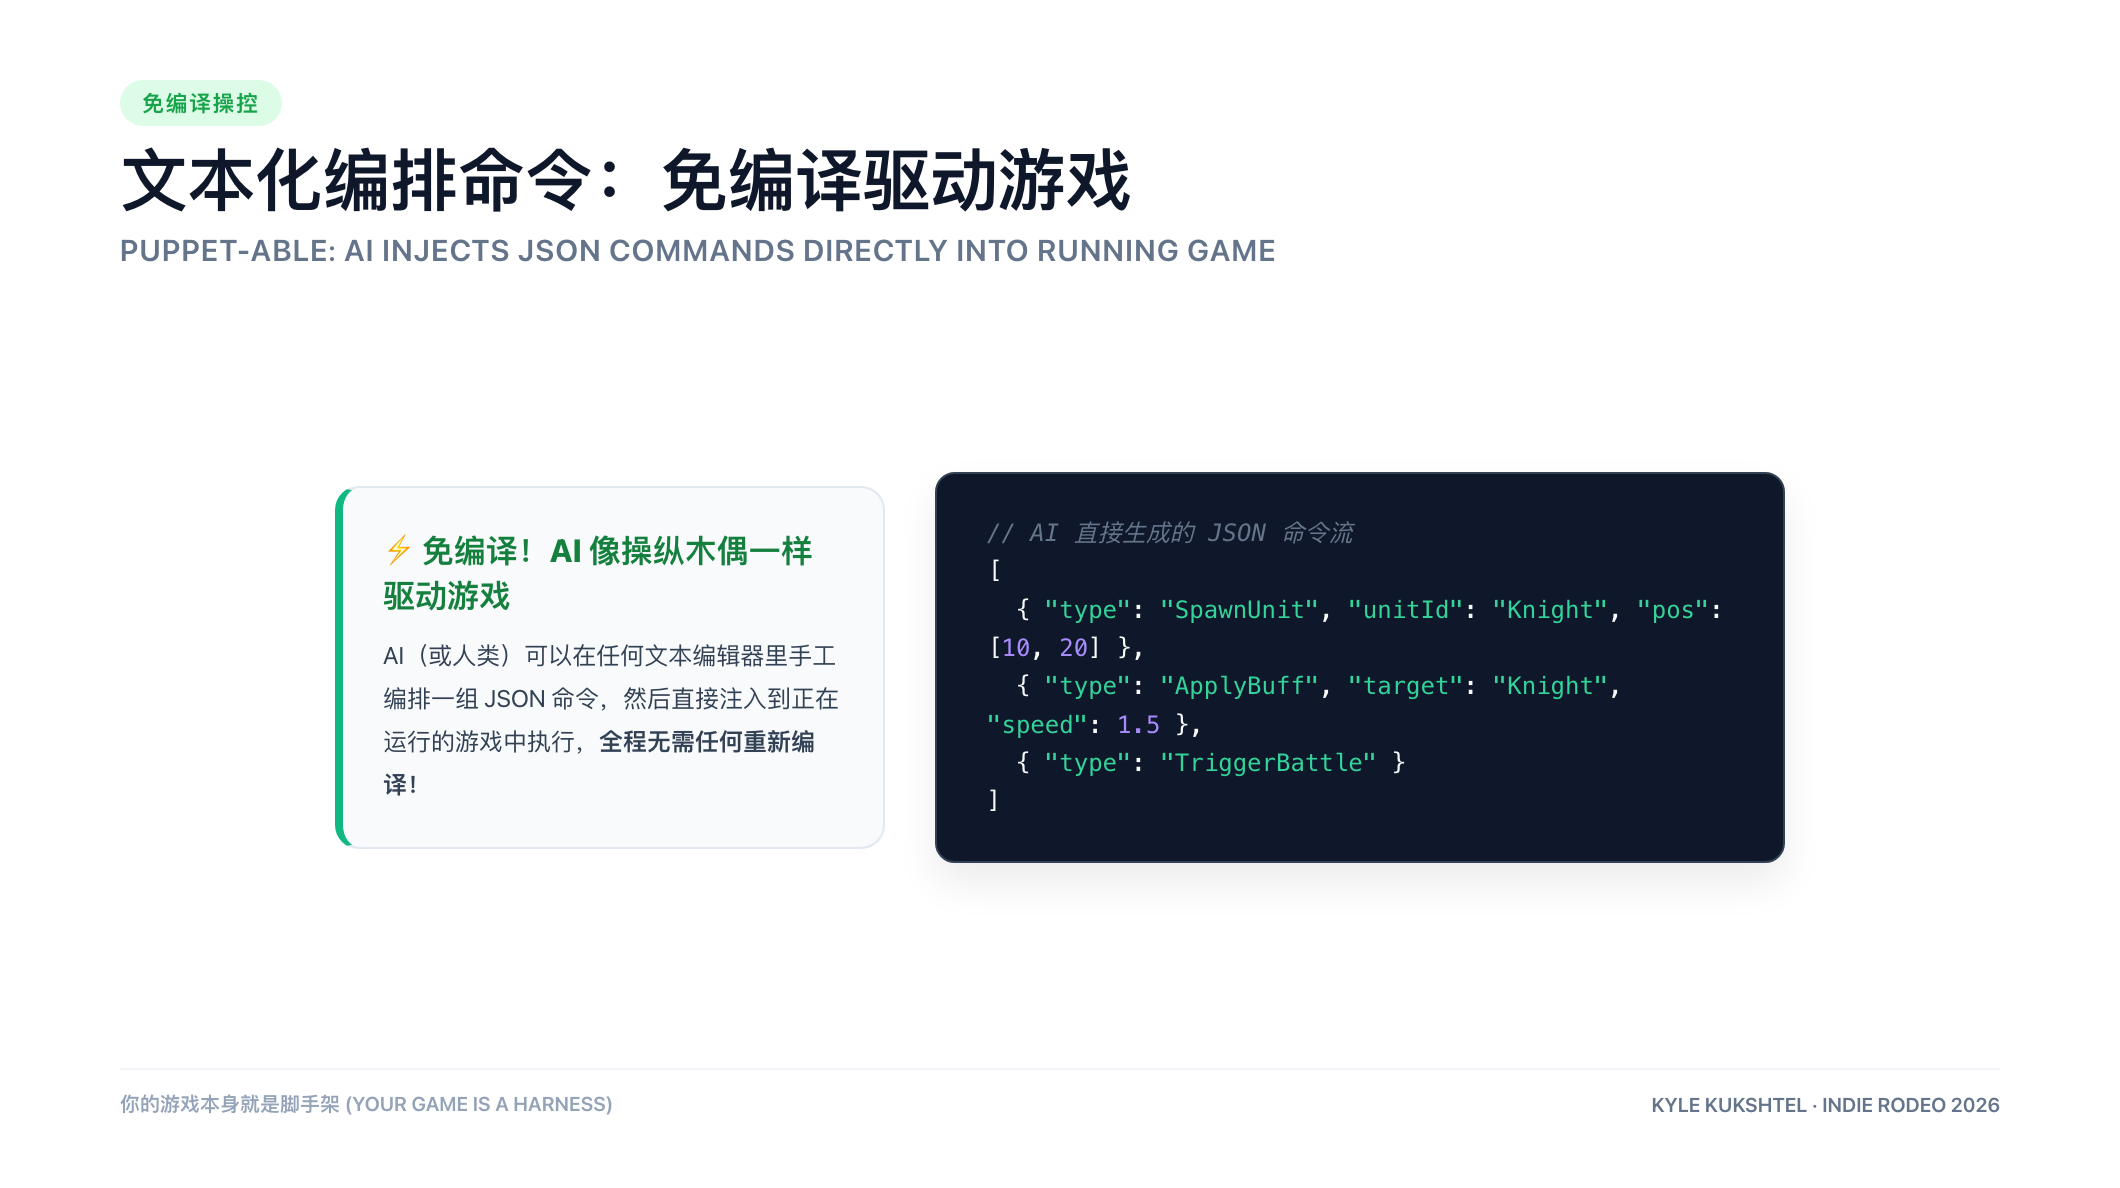
文本化编排命令:免编译驱动游戏
命令模式为 AI 提供了一个强类型的操作接口,让游戏变得像木偶一样处处可操控。
在免编译机制上停留片刻:在你的游戏管线中,能通过无需重新编译的方式修改的东西越多,整个架构就越强大。这不仅仅关乎人类的开发舒适度,对于智能体循环更是决定性的:Agent 无需等待漫长的 C++ / C# 编译与链接耗时,便能在数秒的极窄循环里飞速验证代码假设。
5. 外部化数据管理
这自然引出了我的一个核心关注点:数据管理。让我们再次回顾前面的单一大结构体代码:
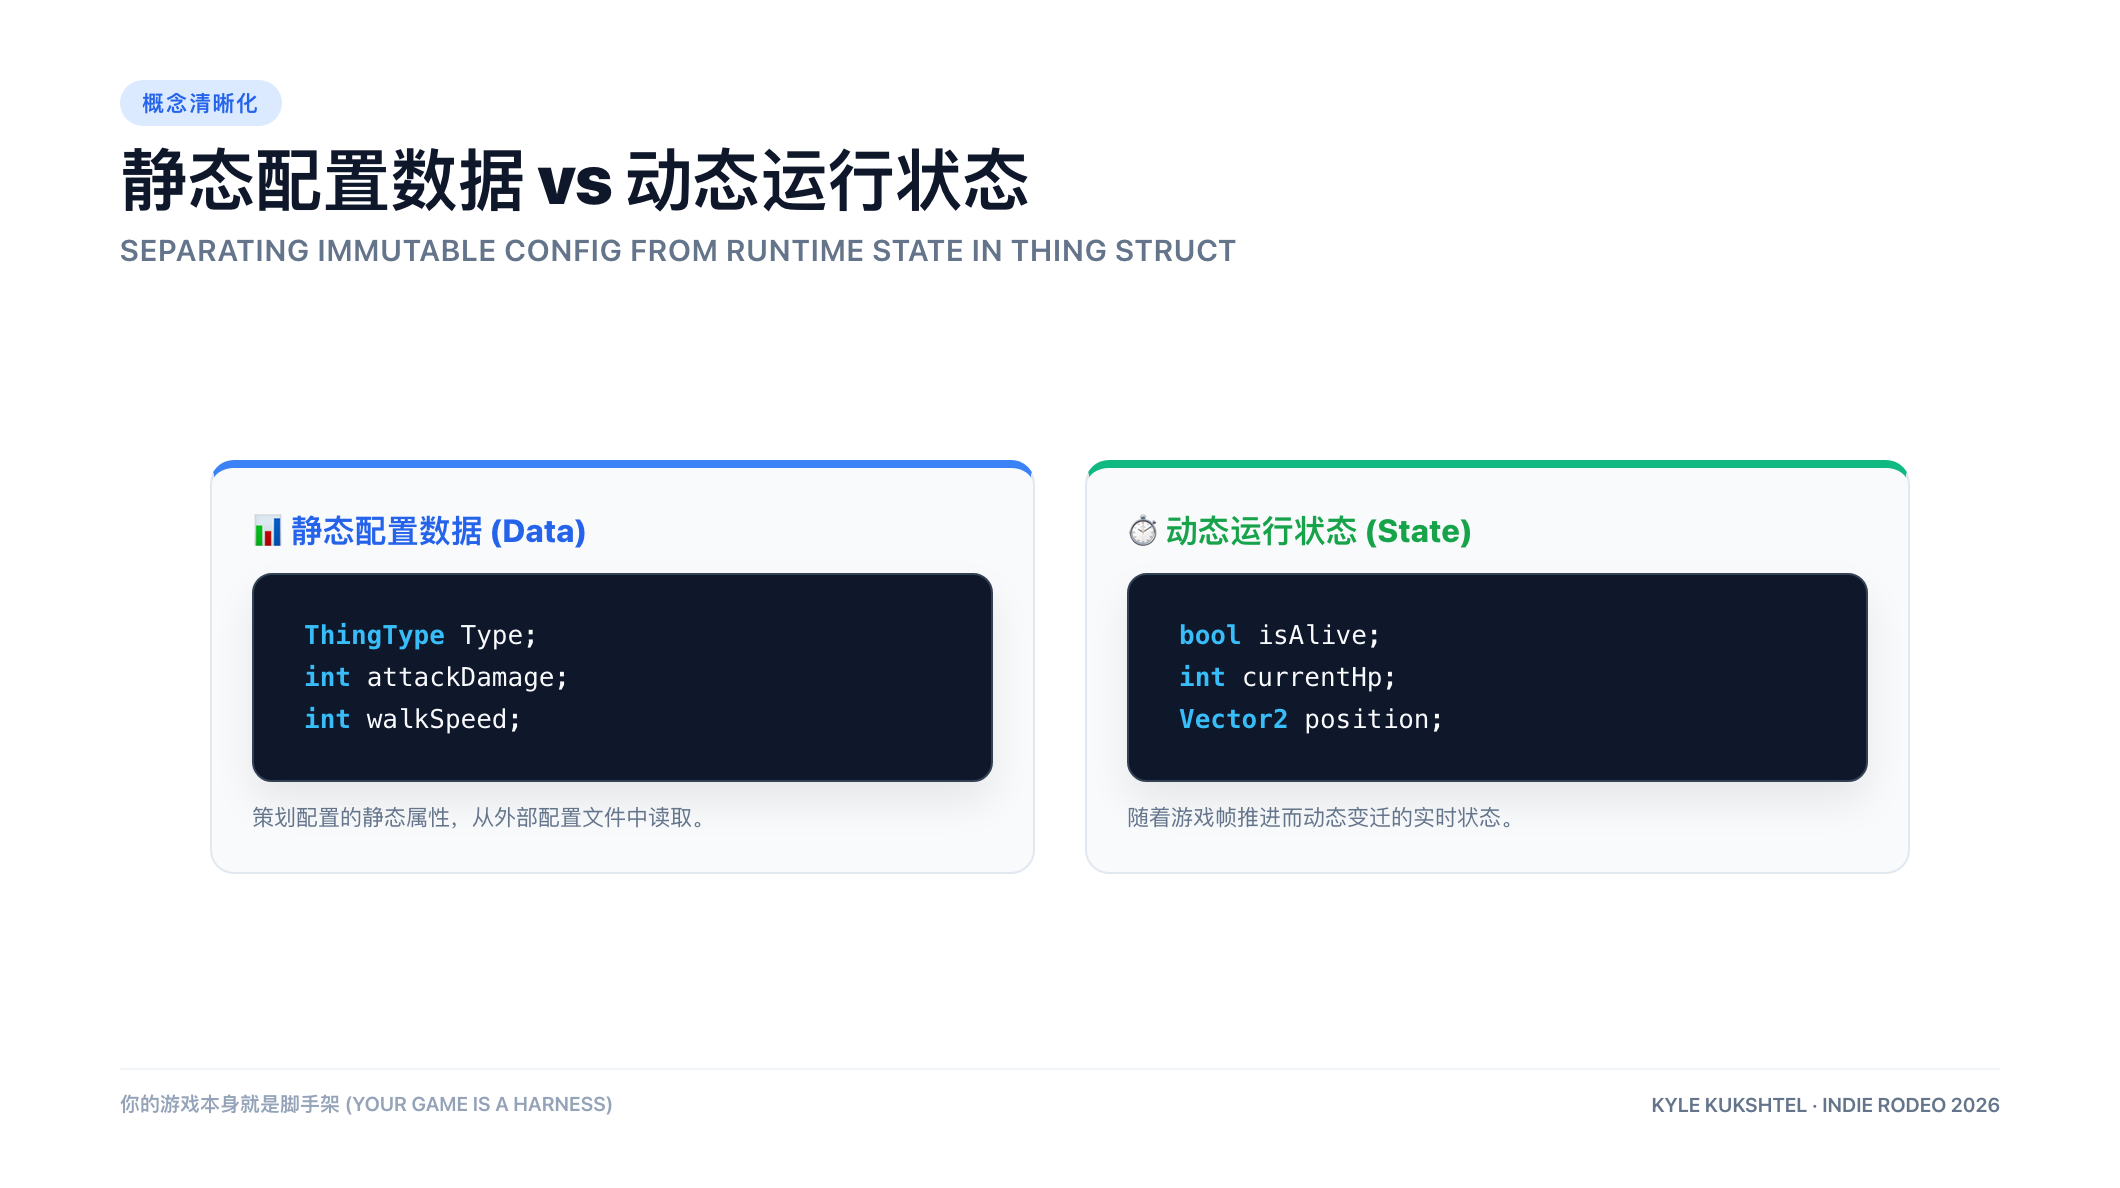
静态配置数据与动态运行状态的区别
所谓「数据」,我指的是游戏用来描述实体底层静态特性的配置数据。在上面的示例中,Type、attackDamage、walkSpeed、boatSpeed 全都属于静态数据。它们构成了游戏中某些 Thing 存在的基础骨架。
许多人在写游戏时习惯把这些数值硬编码在 C# / C++ 类或结构体定义里。一旦想要修改某个单位的基础移速,就必须修改代码、等待编译、重新启动游戏。
在 Agent 的工作流中,这种需要重新编译的改动会产生巨大的摩擦损耗。
更好的做法是:将所有的静态数据完全外部化为独立的数据资产(如 JSON、配置表),与逻辑代码彻底解耦。
游戏启动时只需要把外部数据反序列化并灌入对象即可。修改数值变成了纯粹的数据文件修改,在游戏运行状态下秒级热重载。这种架构甚至允许任何没有引擎编辑器环境的协作者(策划、测试、甚至外包)直接拿发布出来的最终游戏客户端进行高速调优。
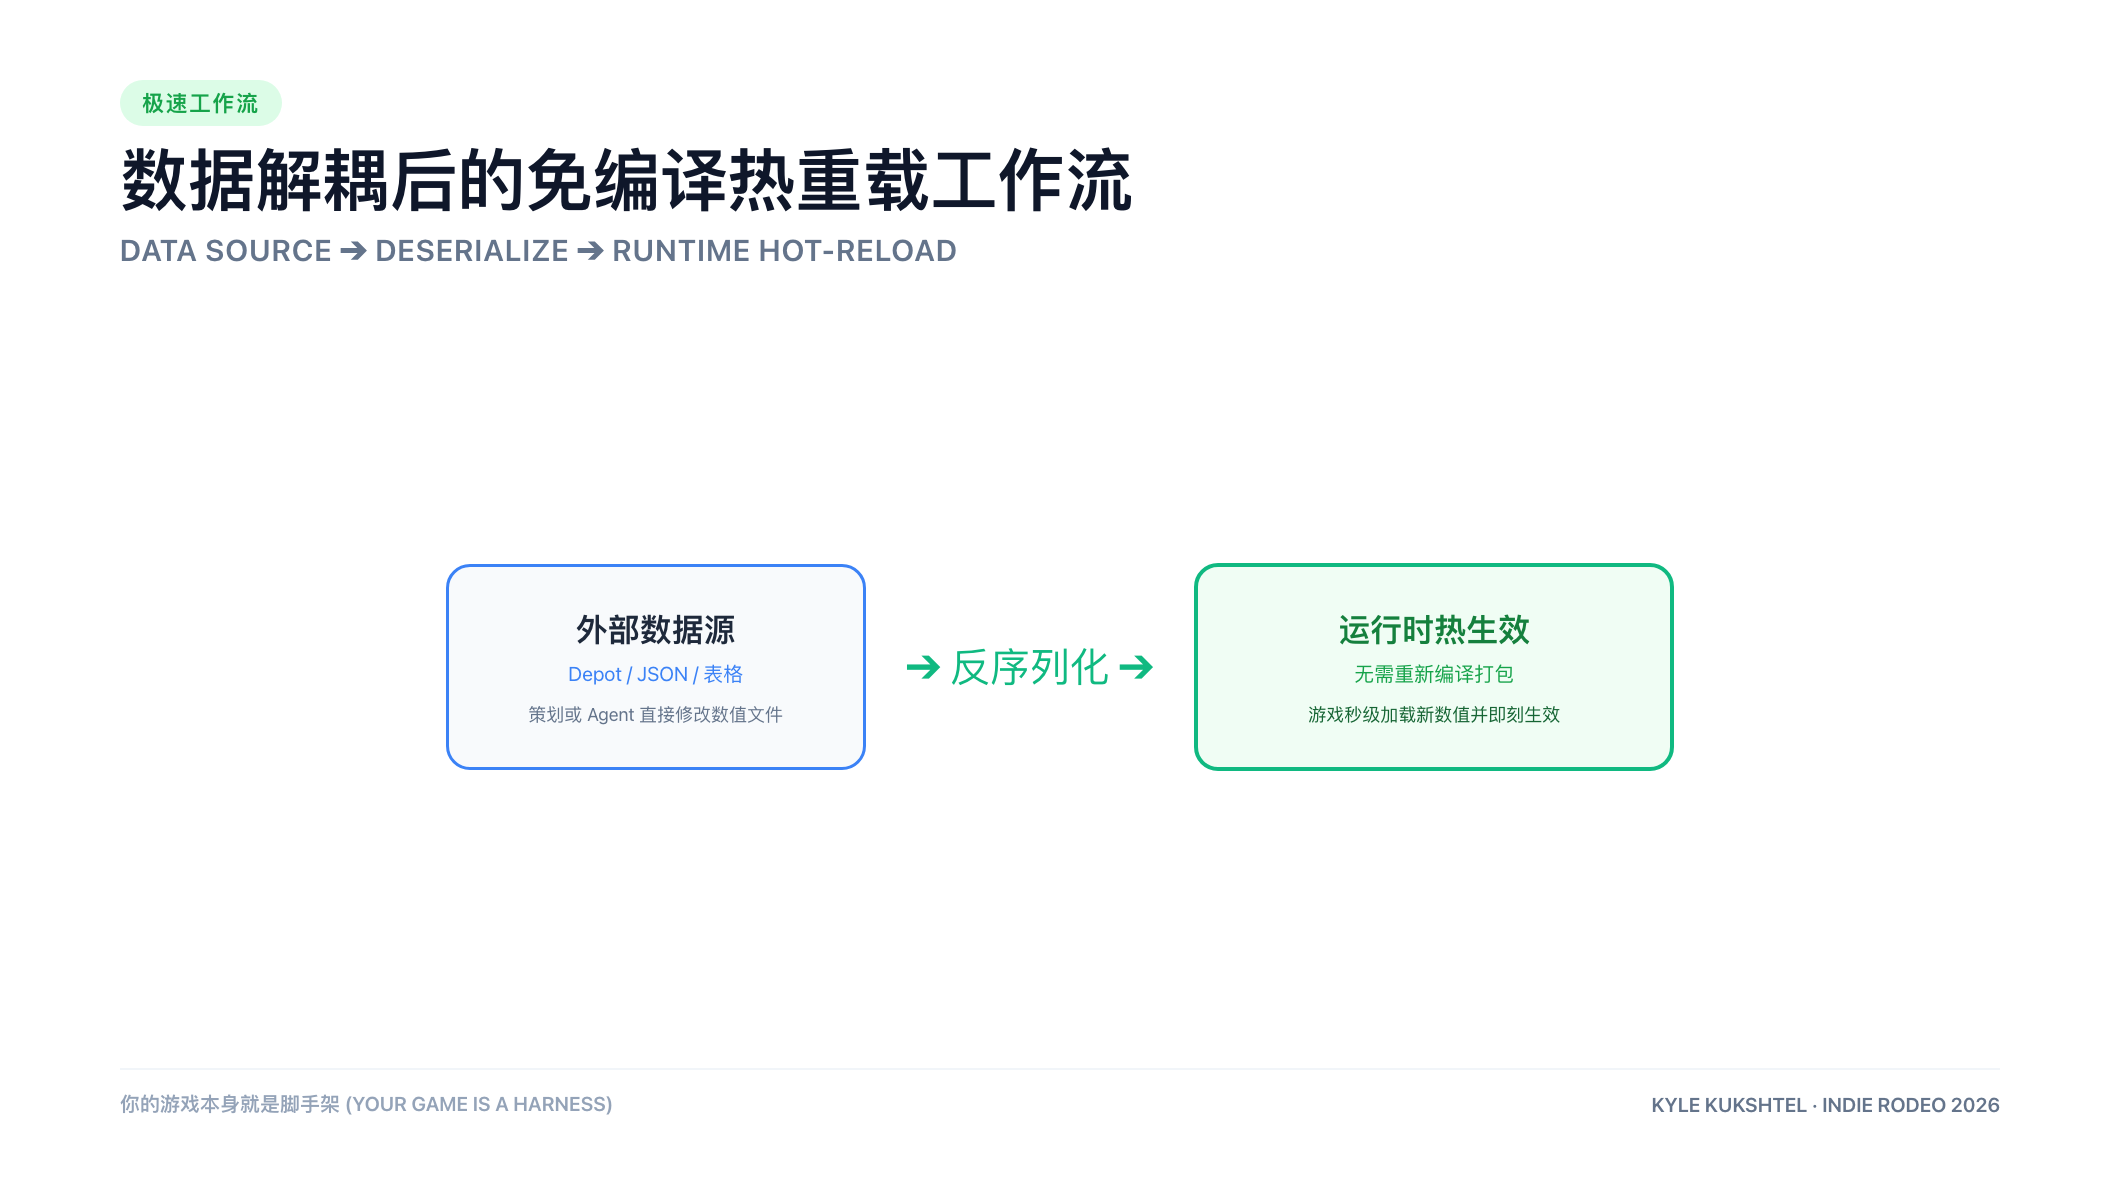
数据解耦后的免编译热重载工作流
在我们制作独立策略战棋游戏《Cantata》时,这正是我们的标准研发管线。团队里 7 位非程序员成员全部使用游戏的日常构建版本,配合我开发的定制化数据编辑器 Depot 进行内容迭代。这套工作流极其高效,以至于我现在正在将 Depot 打造为一个独立面向业界的商用产品:
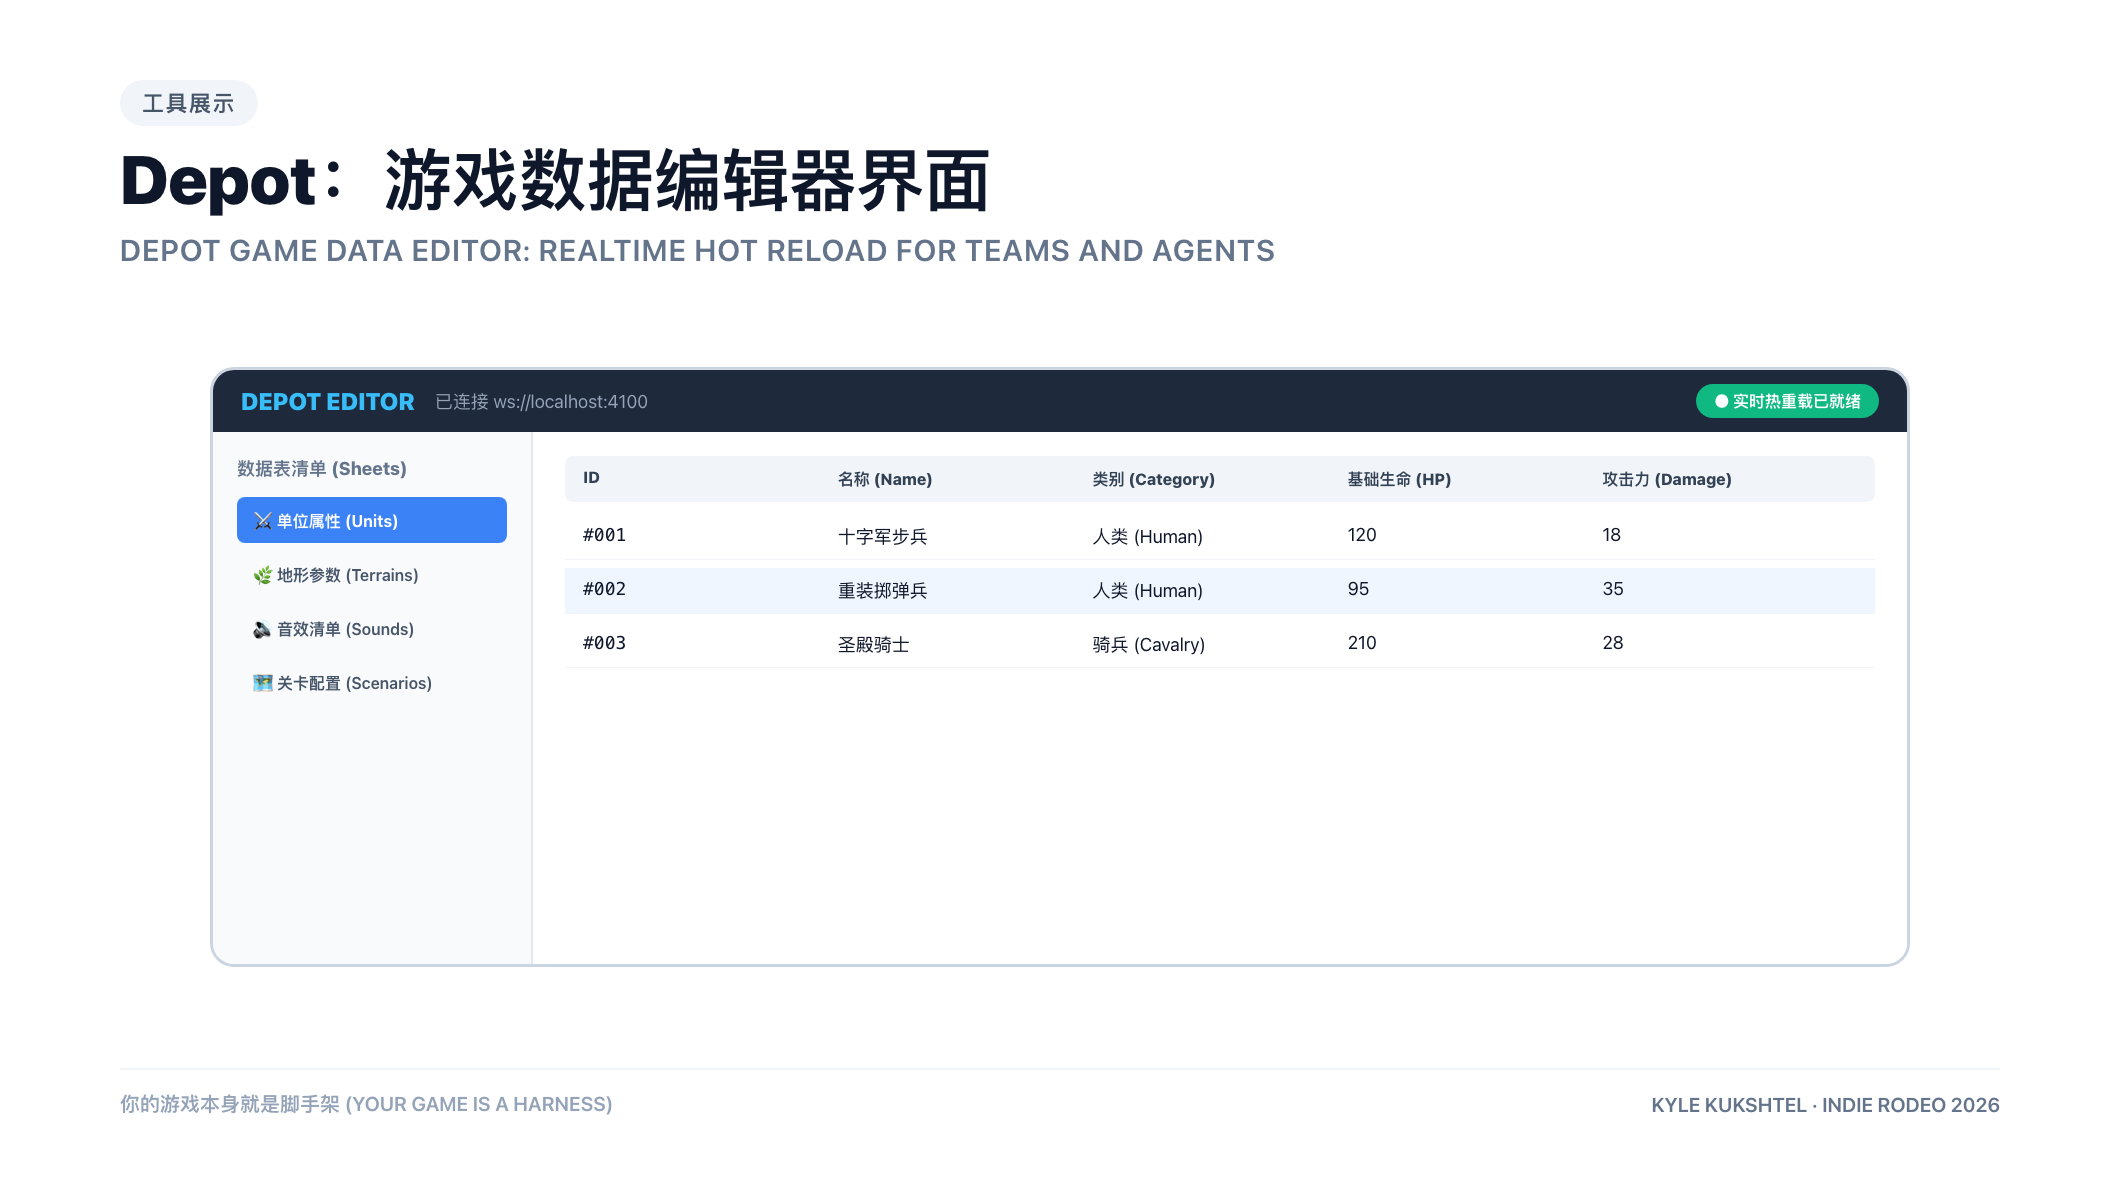
Kyle 开发的 Depot 游戏数据编辑器界面
团队成员在 Depot 中修改数据,游戏构建版本实时反序列化生效,整个过程完全不需要我频繁重新打包。
同样的,AI Agent 也可以轻易学会使用这些外部数据工具。它能够像团队里的资深数值策划一样,直接调整数据文件并在游戏中秒级热重载验证,彻底移除了漫长编译周期的生产力瓶颈。
Agent 直接操纵数据编辑工具
---
6. 独立无头模拟黑盒
现在进入整套架构最深水区的核心原则:黑盒游戏架构。
在传统游戏开发中,核心逻辑往往与视觉渲染、UI 回调、音效播放紧紧缠绕在一起。角色发起攻击,脚本在同一帧内扣减血量、播放受击动画、更新血条 UI 并触发声效。
这种强耦合的恶果在于:为了测试任何细微的逻辑分支,你必须把整个庞大的游戏完整跑起来:所有 3D 模型必须加载、材质必须编译、关卡场景必须初始化。当出现 Bug 时,你根本无法快速断言究竟是模拟逻辑出了问题,还是模型网格损坏,抑或是 UI 绑定的空指针异常。
一种远为优秀的架构是:将游戏的「模拟」逻辑,完全剥离于图形引擎之外,作为一个独立的、无头的纯代码动态链接库。
引擎本身并不「拥有」游戏模拟内核,它仅仅是一个消费模拟计算结果的哑客户端。引擎与模拟内核之间,完全通过我们前面介绍的 Command 对象 进行通讯,其模式与现代 Web 开发中的客户端/服务端架构如出一辙:
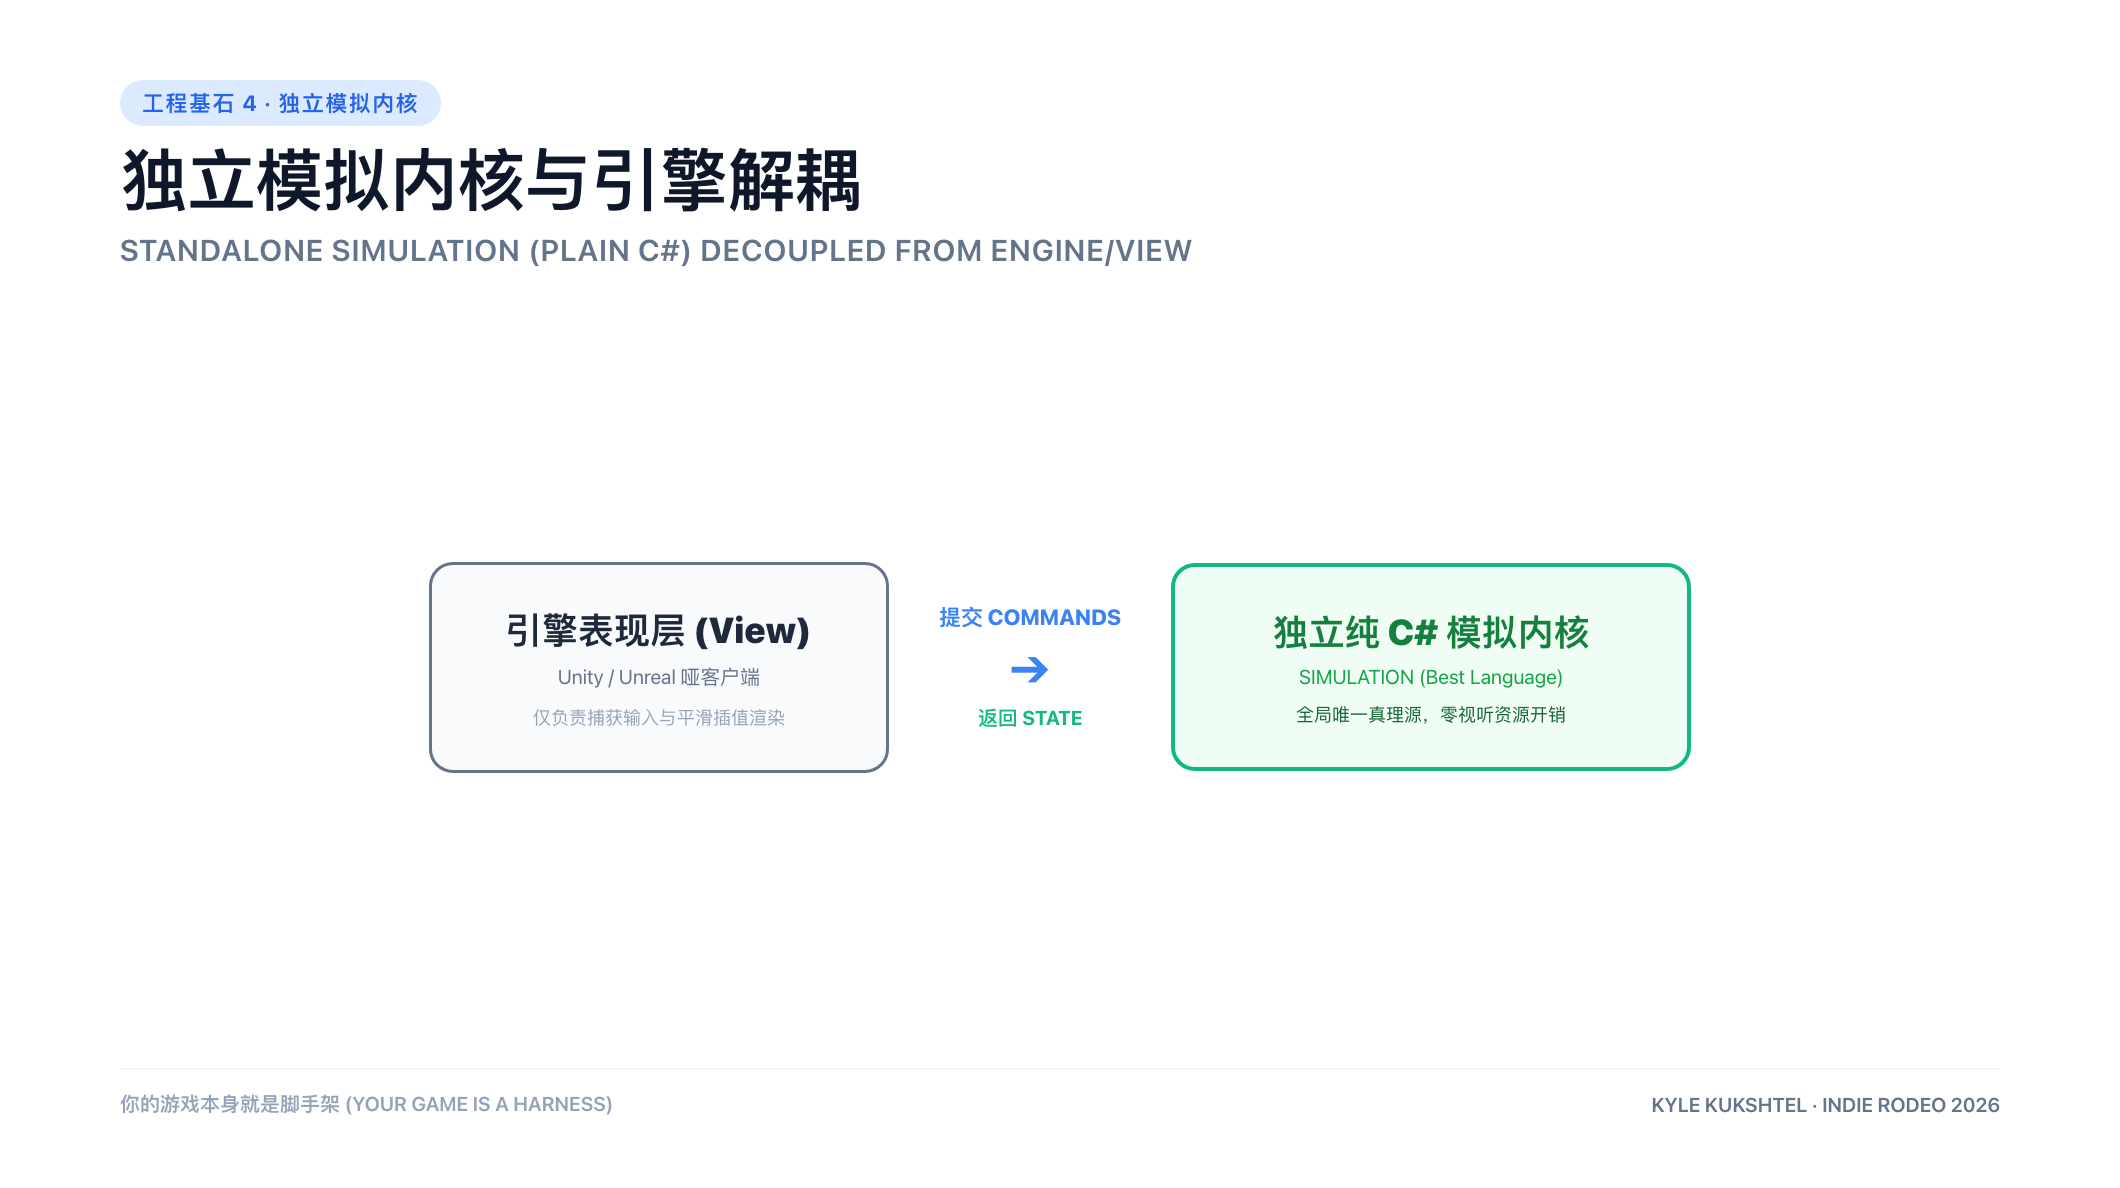
独立仿真内核与引擎解耦
- 引擎将玩家输入转化为 Command 发送给独立模拟内核。
- 模拟内核处理状态演算,将更新后的状态对象(或与上一帧的 State Diff 差异包)返回给引擎。
- 引擎根据收到的状态差异,只负责执行无脑的视觉渲染与动画播放,绝不掺杂任何核心裁决逻辑。
举个具体的物理位移例子:
角色从 A 点移动到 B 点,在表现层包含角色行走动画、骨骼转向、脚步声、视野迷雾更新。但在模拟内核眼中,位移仅仅是坐标从 A 到 B 的数值变更。
引擎提交一个位移指令,模拟内核判断该路径是否合法;如果合法,内核更新实体坐标,并将最新状态返回给引擎。引擎看到状态变化,在屏幕上把模型平滑插值移动过去。模拟内核是绝对的唯一真理源。
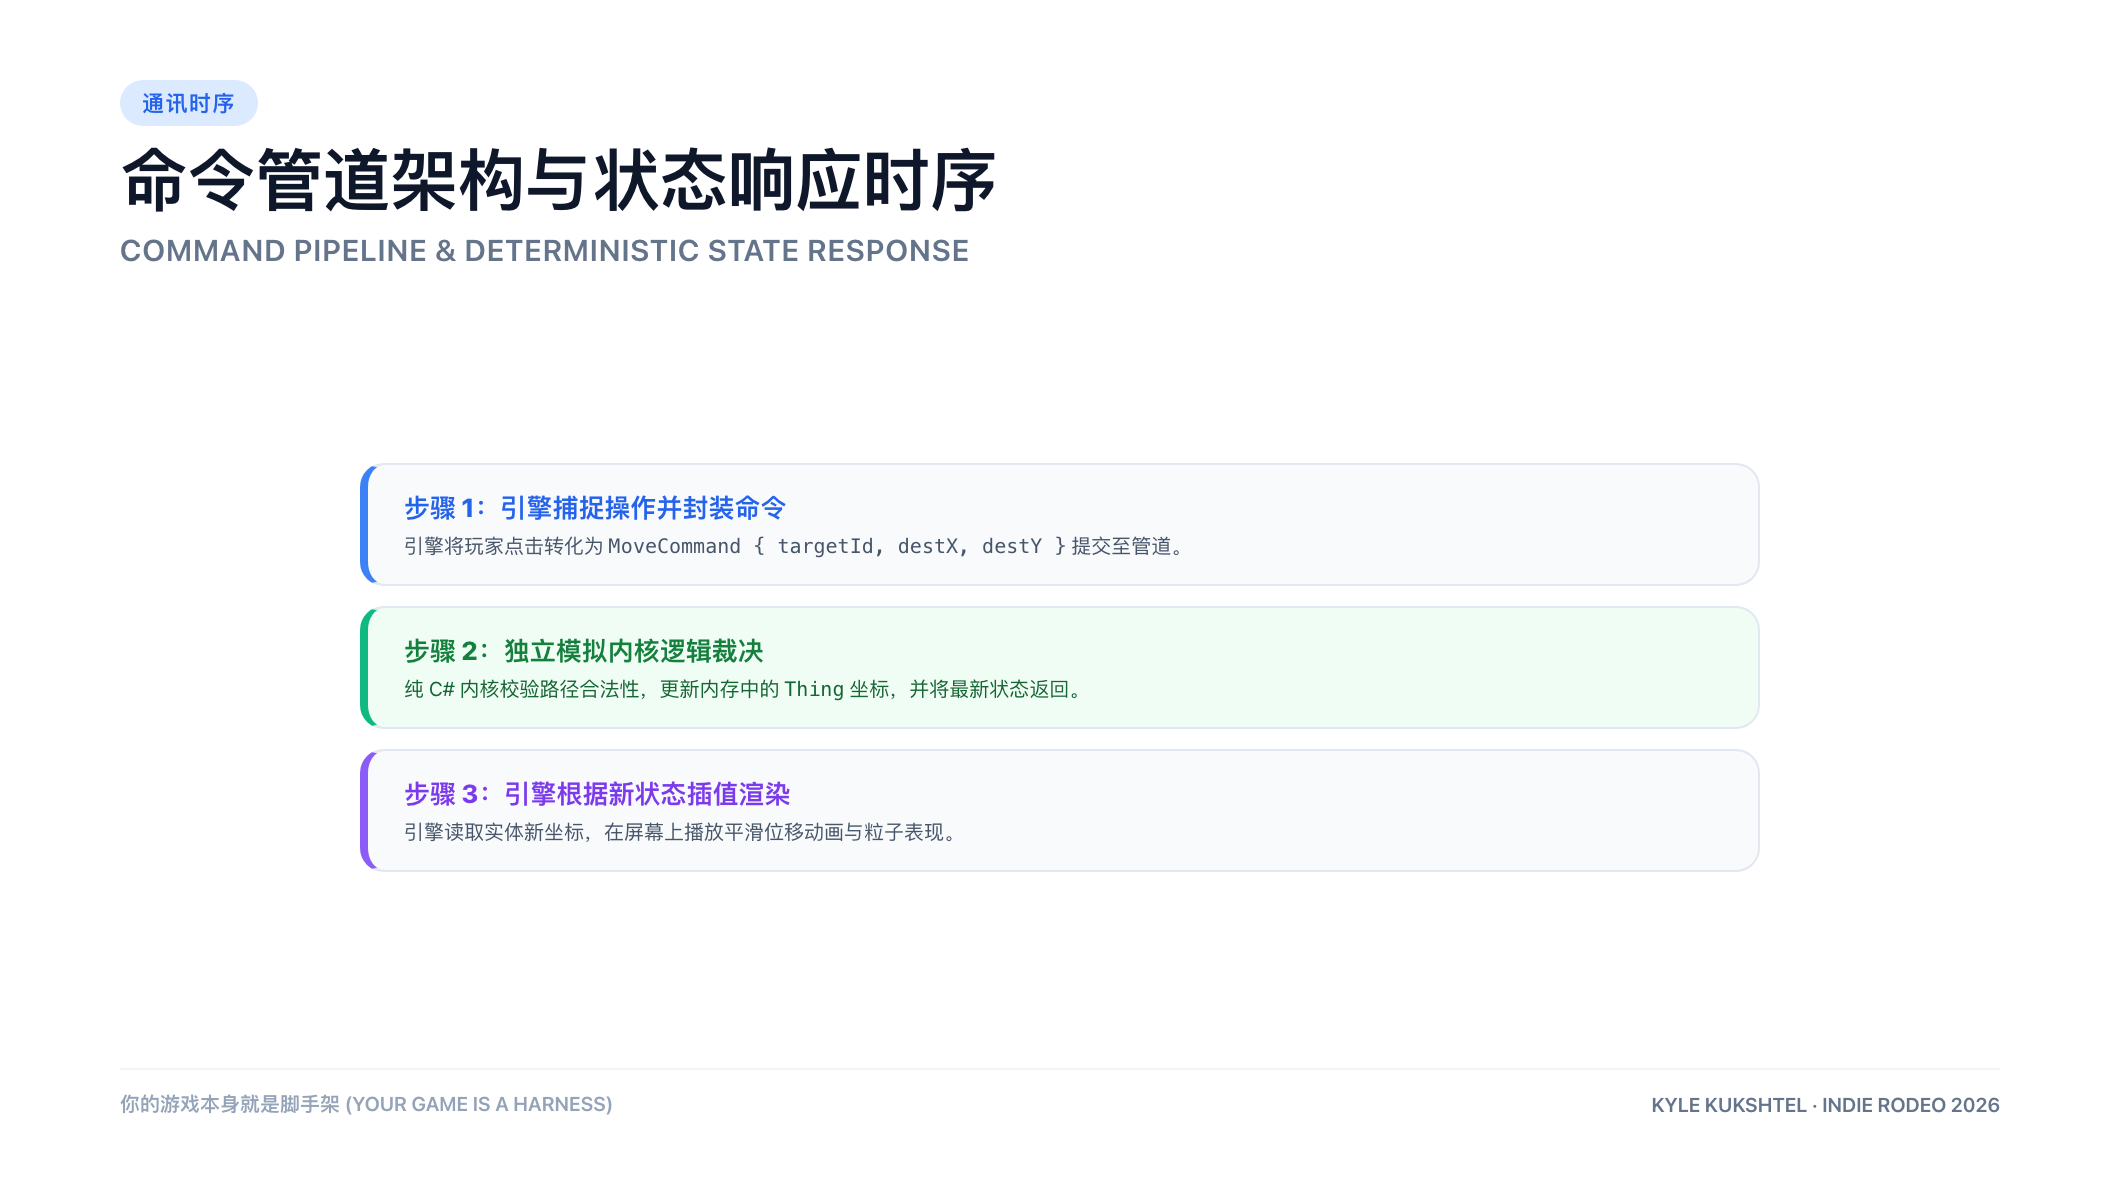
命令管道架构与状态响应
当你的模拟内核彻底独立于图形引擎存在时,一个巨大的红利随之而来:任何实体都可以向你的核心无缝发送命令!
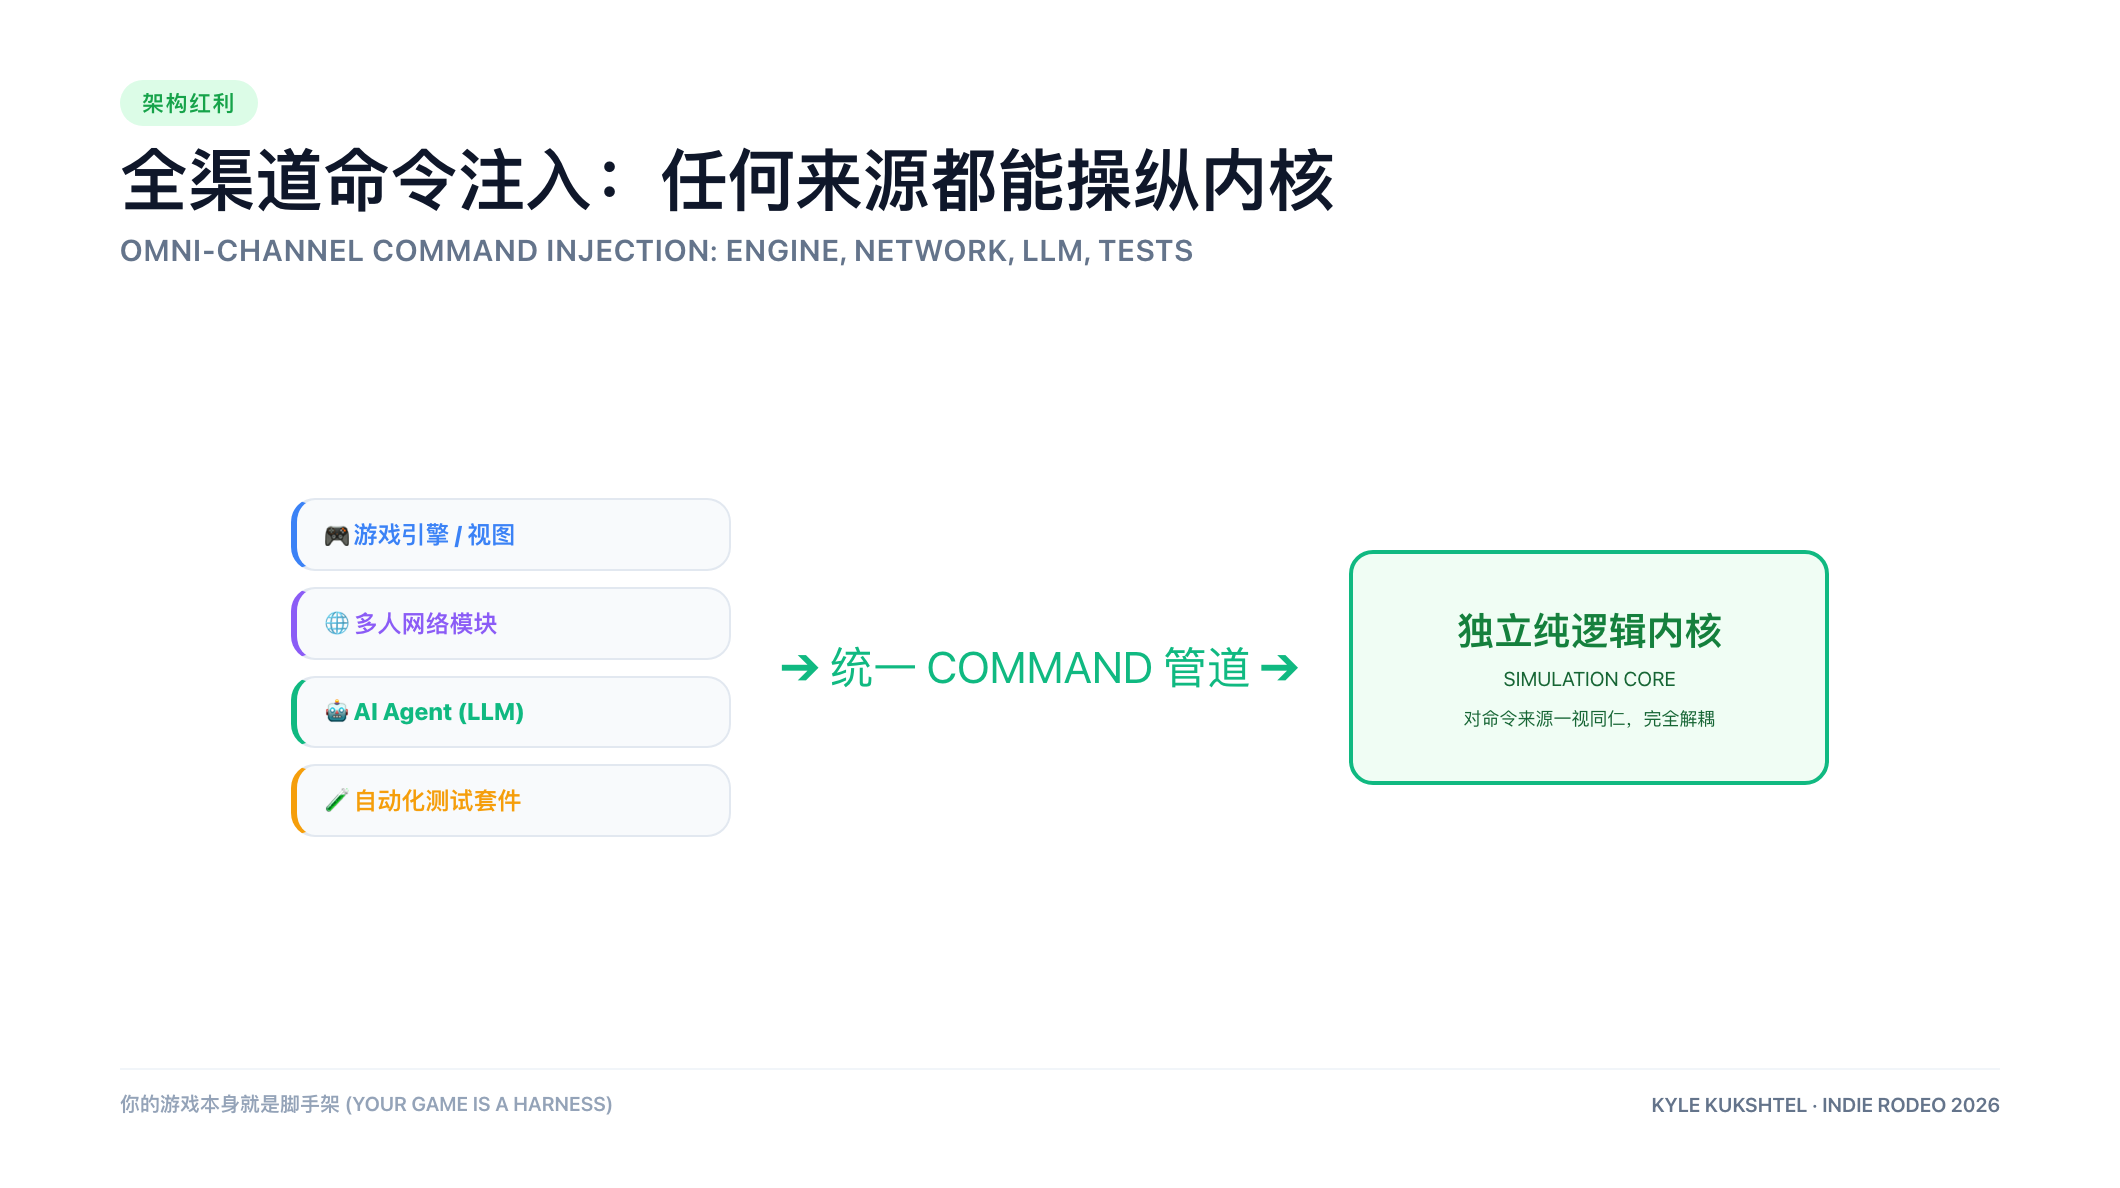
任何来源都可以直接向纯逻辑内核发送指令
- 网络模块可以发送指令(网络多人联机开发变得极其简单)。
- 单元测试脚本可以发送指令。
- LLM / AI Agent 也可以直接向纯逻辑内核注入指令!
传统的游戏单元测试往往因为环境依赖过重而举步维艰。但在独立模拟内核架构下,你可以完全抛弃庞重的游戏引擎,使用最纯粹的标准 C# / C++ 命令行工具链,以极高的并发度在纯内存里秒级跑完数千轮自动化单元测试。这正是 AI 最擅长、最喜欢的运行环境!
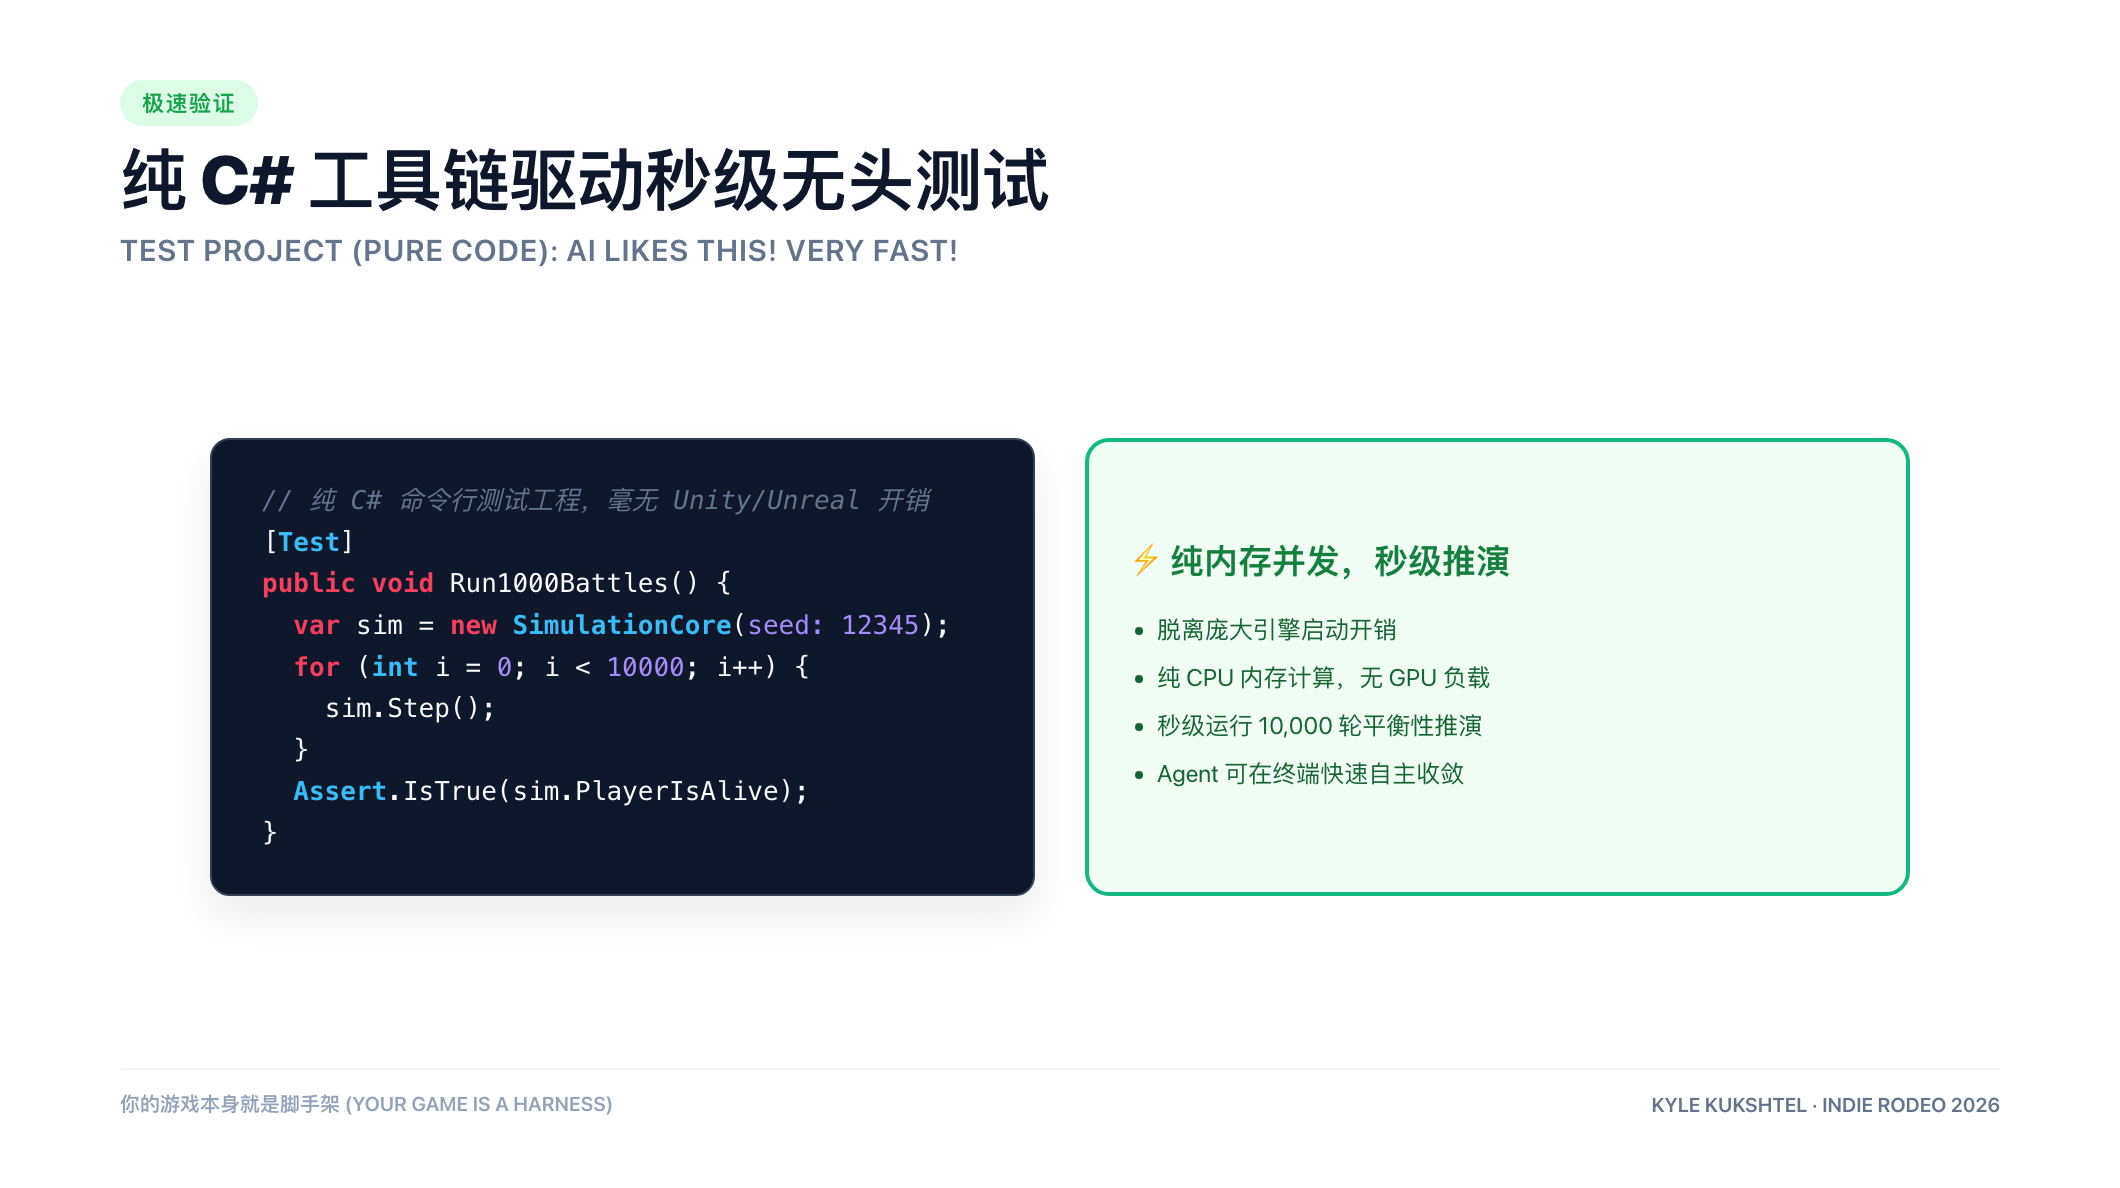
纯 C# 工具链驱动秒级无头测试
当你善用这种架构时,它将化身为游戏开发的超级动力。你可以把游戏当成一个纯粹的技术推演对象,彻底脱离沉重的视听资源开销。在真空环境中运行仿真、假设检验和自动化测试:
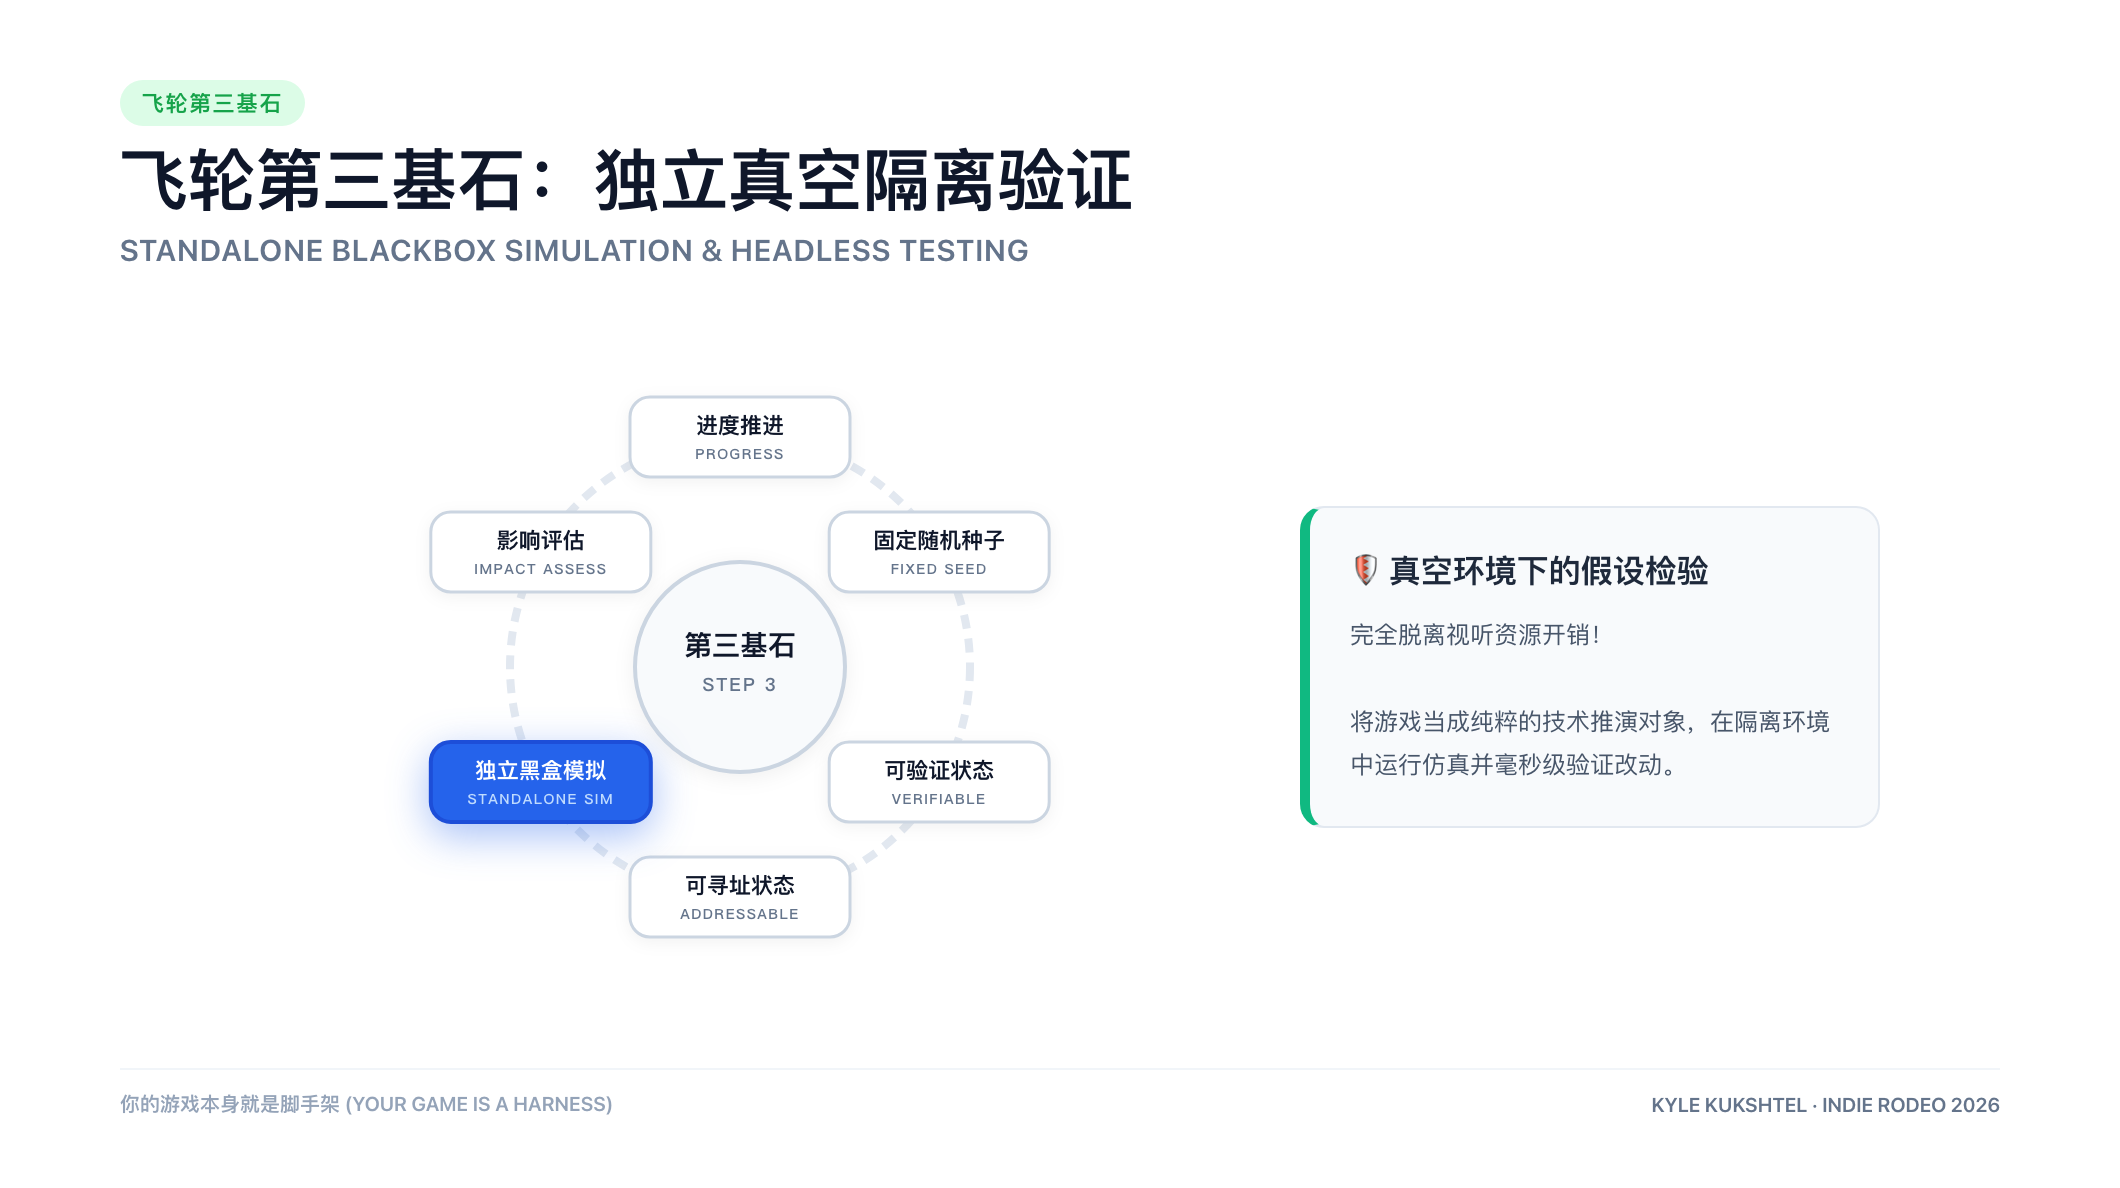
在真空隔离环境中验证一切
至此,在我们的整个飞轮运转图谱上,我们已经来到了接近终点的关键部位:我们拥有了确定性的输入参数,拥有了结构化且免编译的状态修改途径,并且能够在一个完全隔离的真空环境里毫秒级验证自己的改动。
7. 影响评估与纯文本性能分析
在完成了确定性输入、免编译操控与隔离测试之后,我们来到了飞轮的最后一环:我们如何确认所做的修改在整机性能上产生了预期的积极影响?
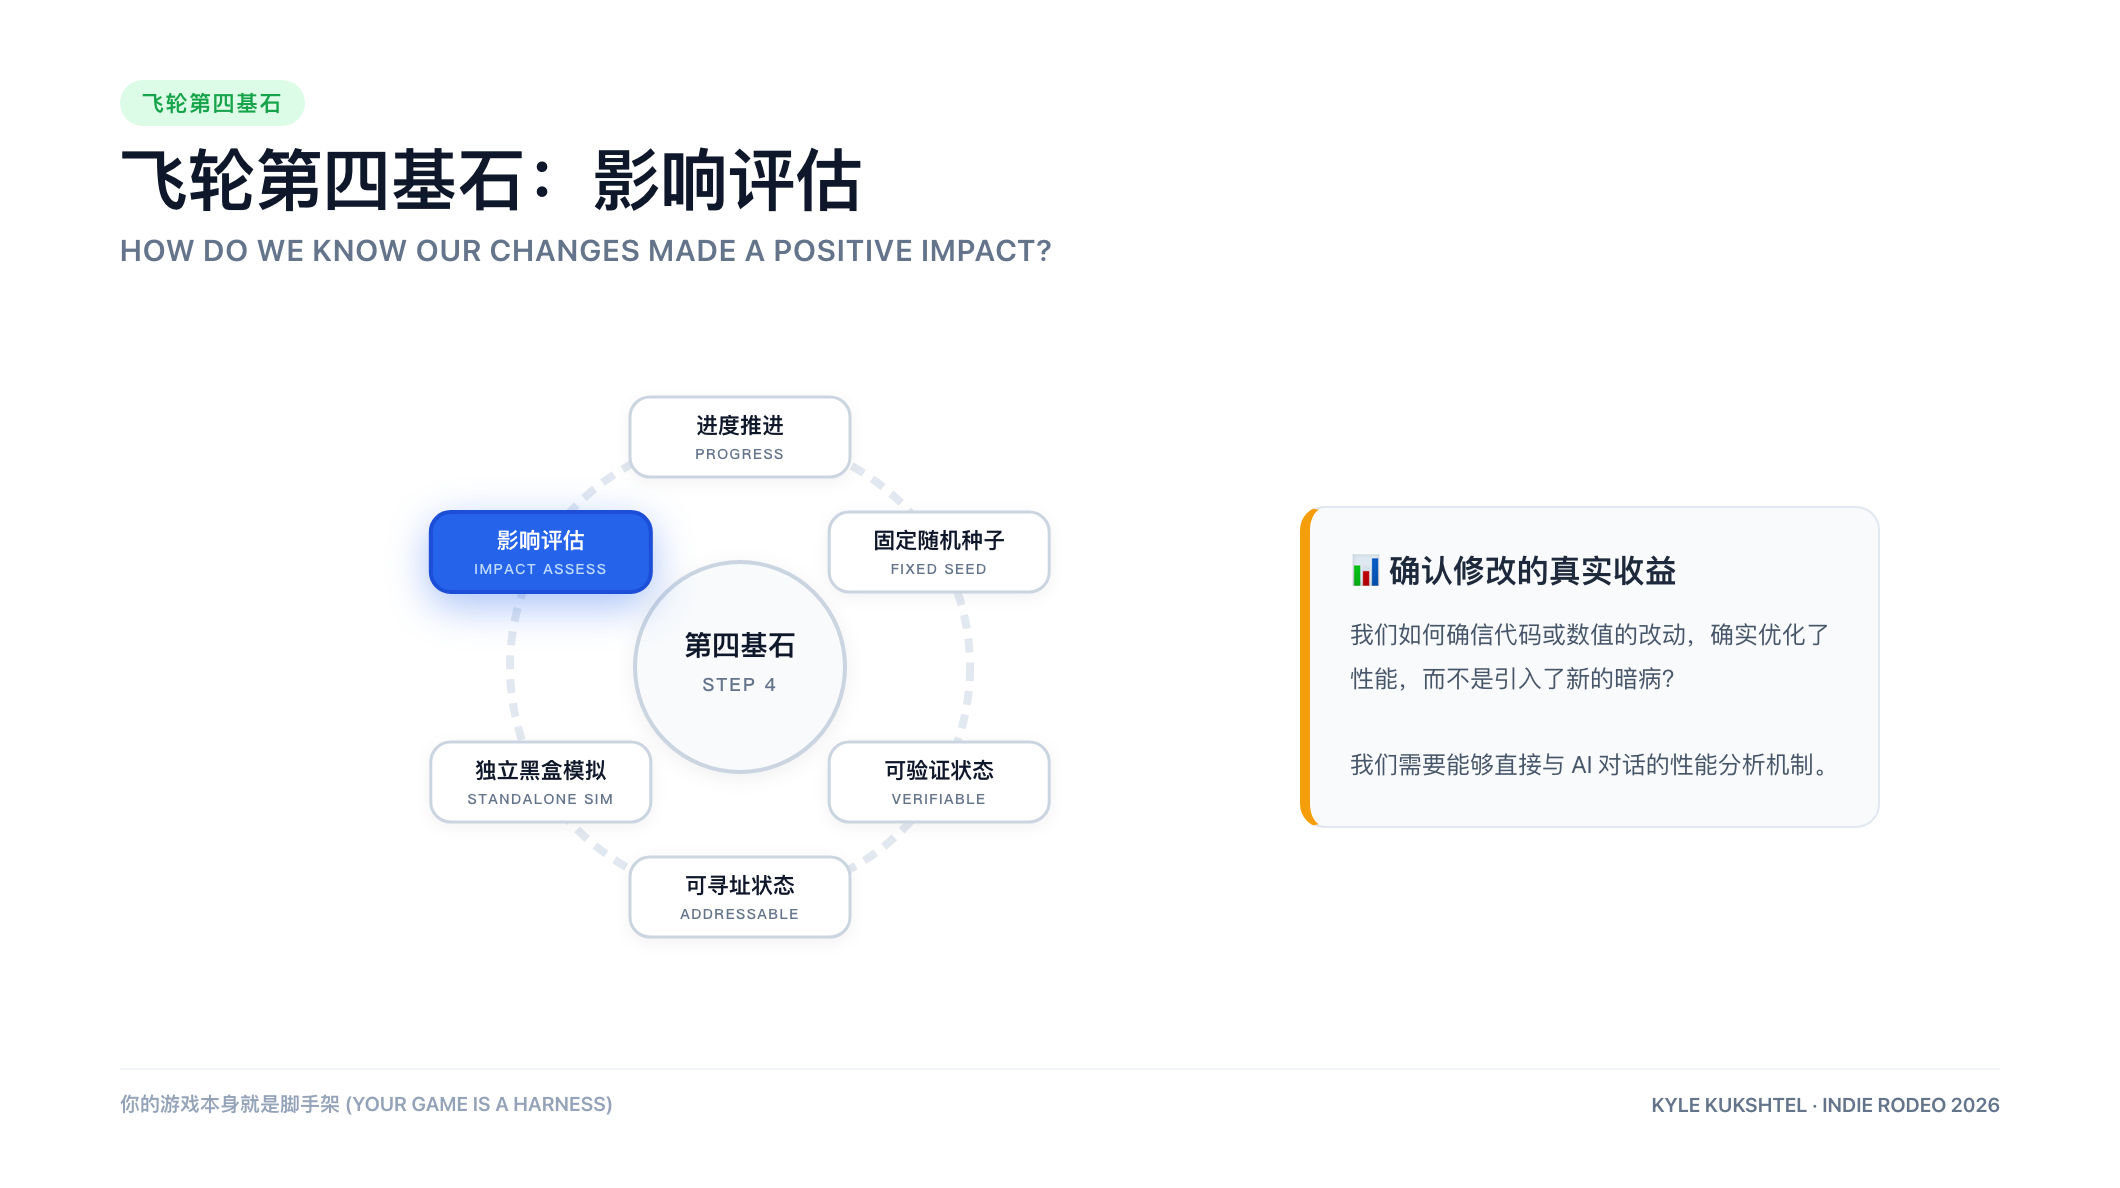
影响评估环节
传统的性能剖析高度依赖人工经验,开发者需要在 Unity Profiler、Unreal Insights 或 JetBrains dotMemory 中手动翻看调用栈与火焰图:
传统可视化 Profiler 是专为人类肉眼设计的
这些图形工具是专为「人类肉眼」设计的。AI 极其讨厌这类不可交互的图形界面(尽管 Unity 正在努力使其分析器对 Agent 更具可读性)。
AI 最擅长打交道的是结构化纯文本。如果性能分析工具能直接将采样快照输出为详尽的控制台文本报告,Agent 的迭代效率就会呈指数级飙升。
在这里,我强烈推荐一个免费、现代且支持命令行的性能分析利器:samply:
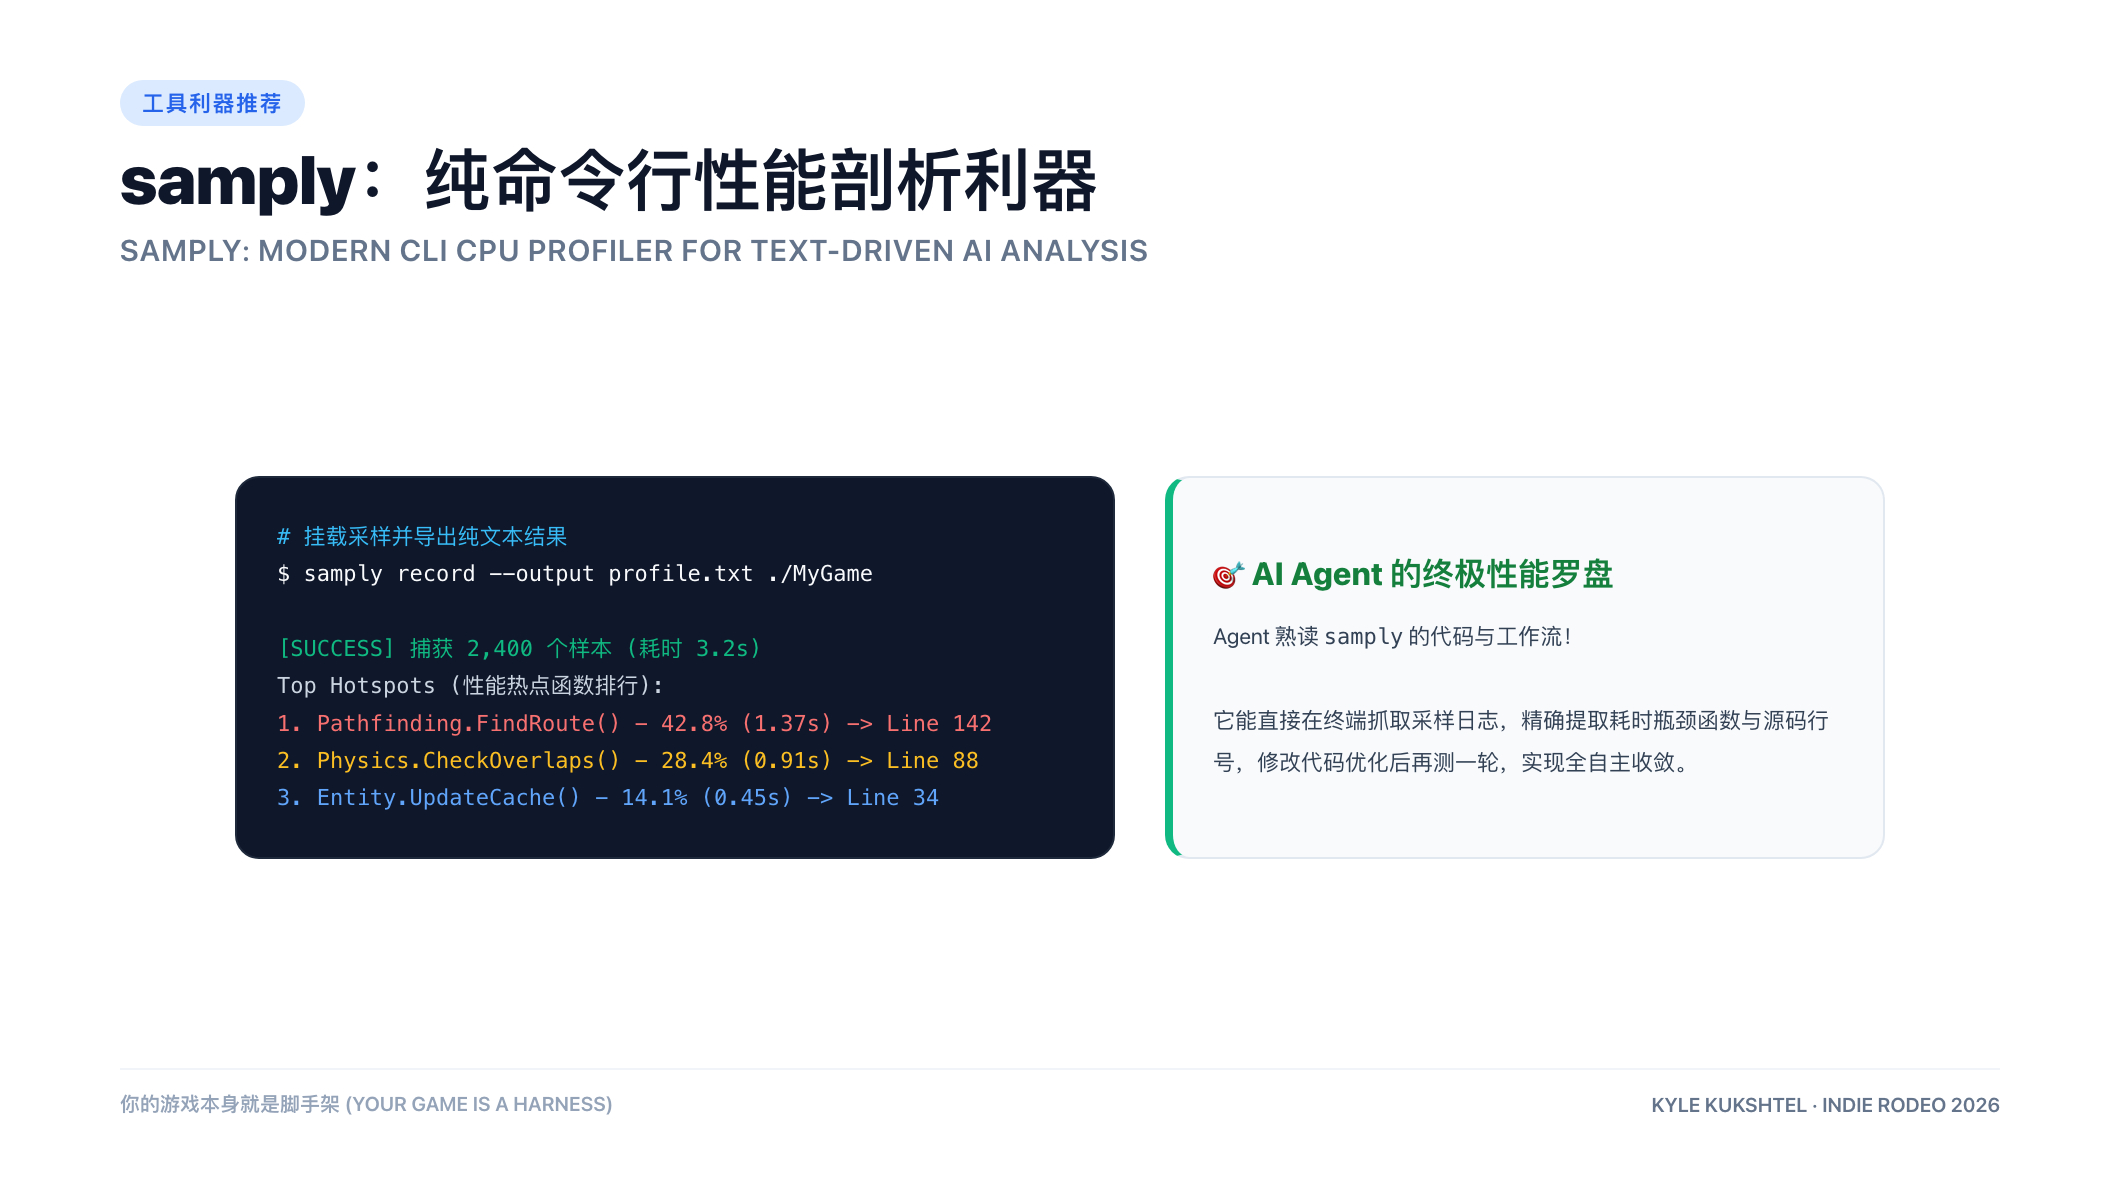
samply 纯命令行分析工具
samply 可以轻松挂载到你的本地工程中,并将性能捕获结果直接 Dump 到终端。AI Agent 本身就熟读 samply 的源码与文档,它能够自主执行采样、解析性能热点行号、修改优化代码并重新采样验证,实现完全自治的性能调优内循环。
8. 闭环拼图:Agent 高速自主迭代飞轮
当我们把上述所有工具、架构与方法论串联在一起时,整个 AI 游戏工程化的终极全貌便浮出水面:
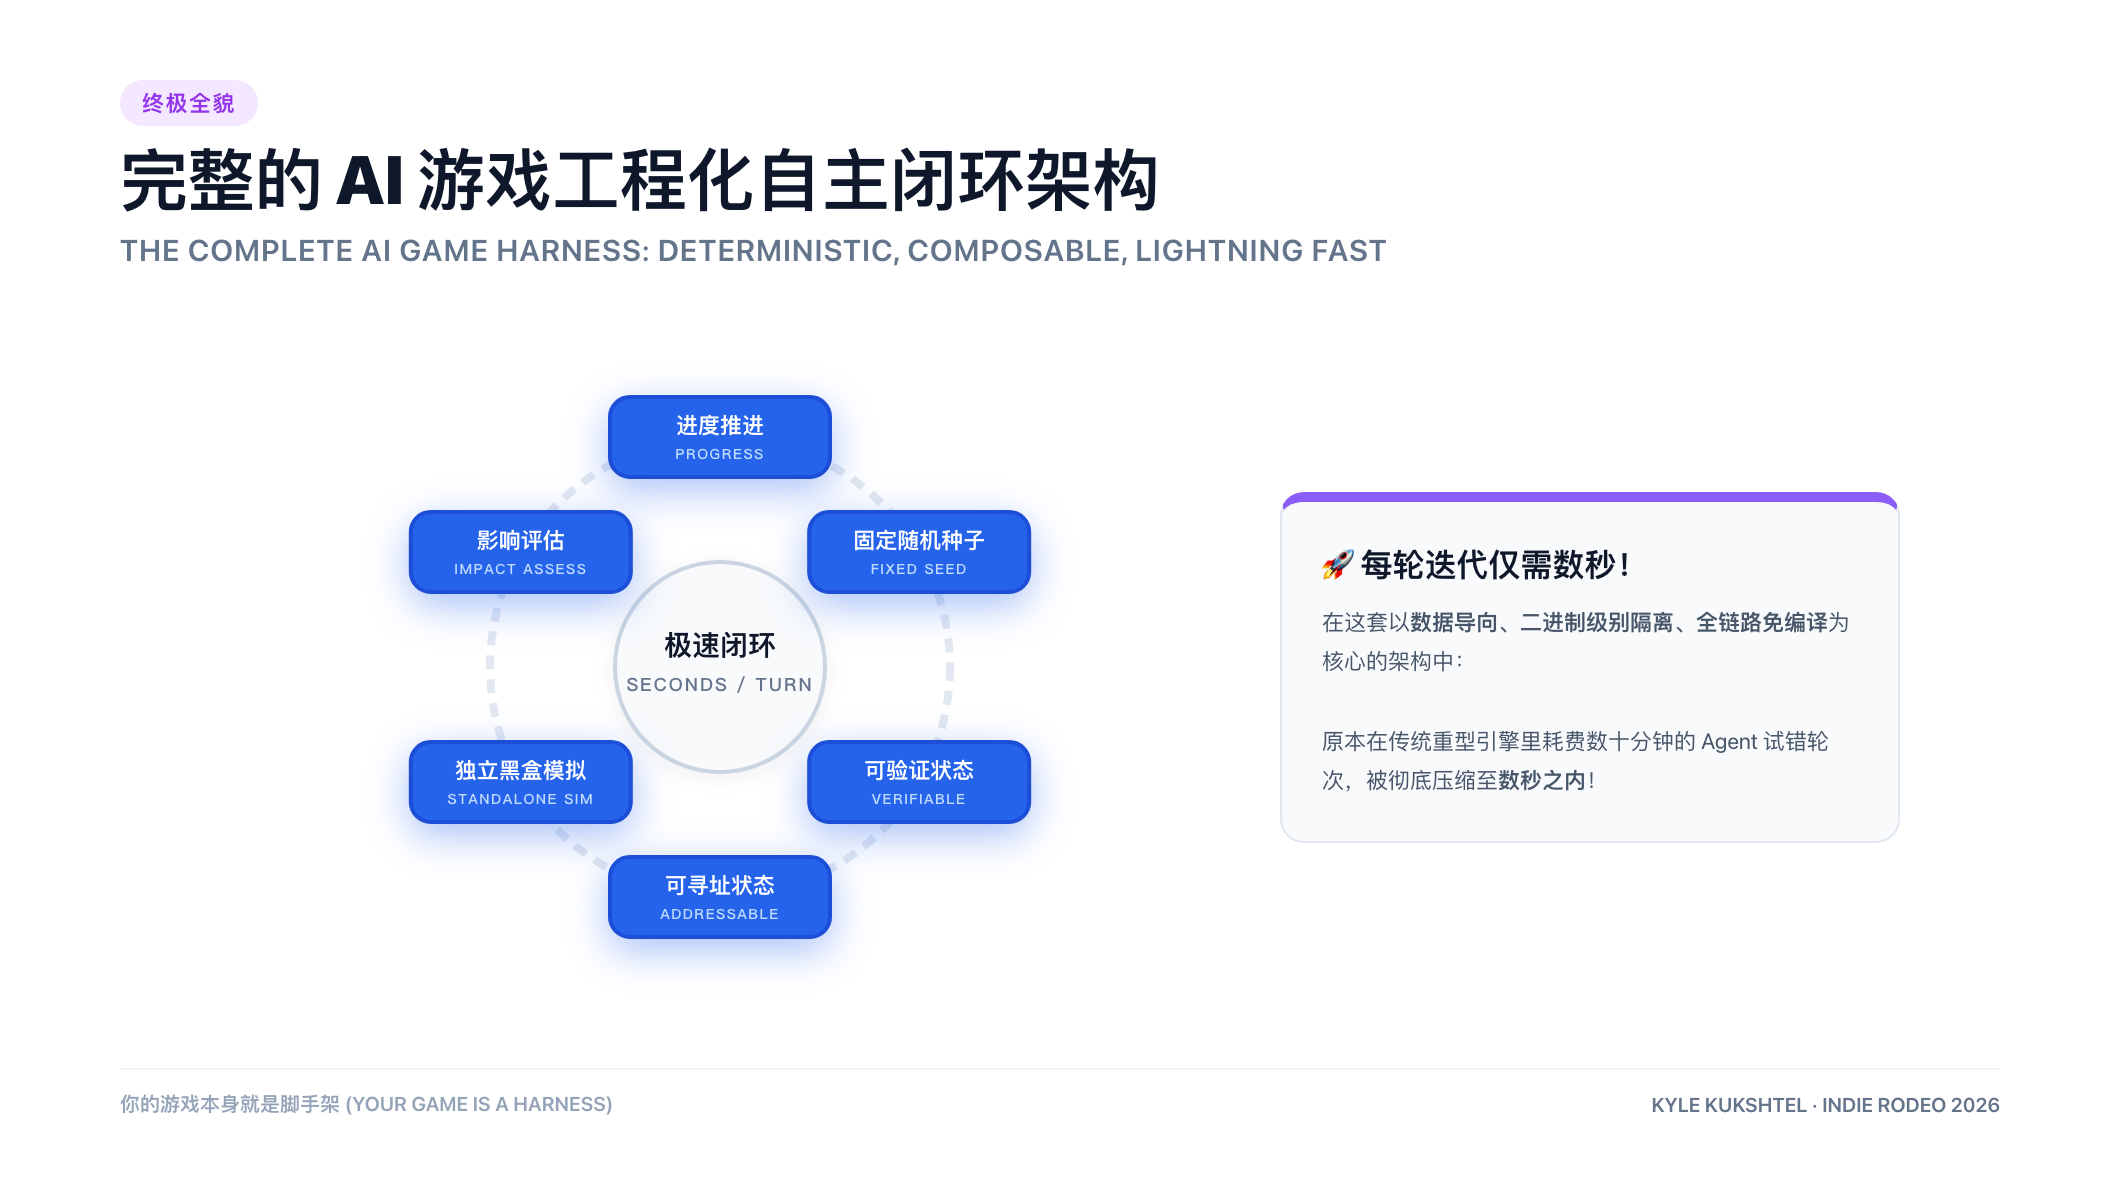
完整的 AI 游戏工程化自主闭环架构
在这套以数据导向、二进制级别隔离、全链路免编译为核心的工程架构中,一个原本在传统引擎里需要耗费数分钟甚至数十分钟的 Agent 迭代轮次,被无情压缩到了数秒之内!
它从根本上消除了所有让大模型步履维艰的上下文盲区与编译等待。正是因为整个闭环运行得如此迅捷、精准,这套流程可以无差别地覆盖到开发过程中的每一次微小改动,而不再是等到积重难返时才做一次昂贵的集成测试。
重新审视这一全貌,你会发现:这就是专为游戏量身定制的终极 Harness。
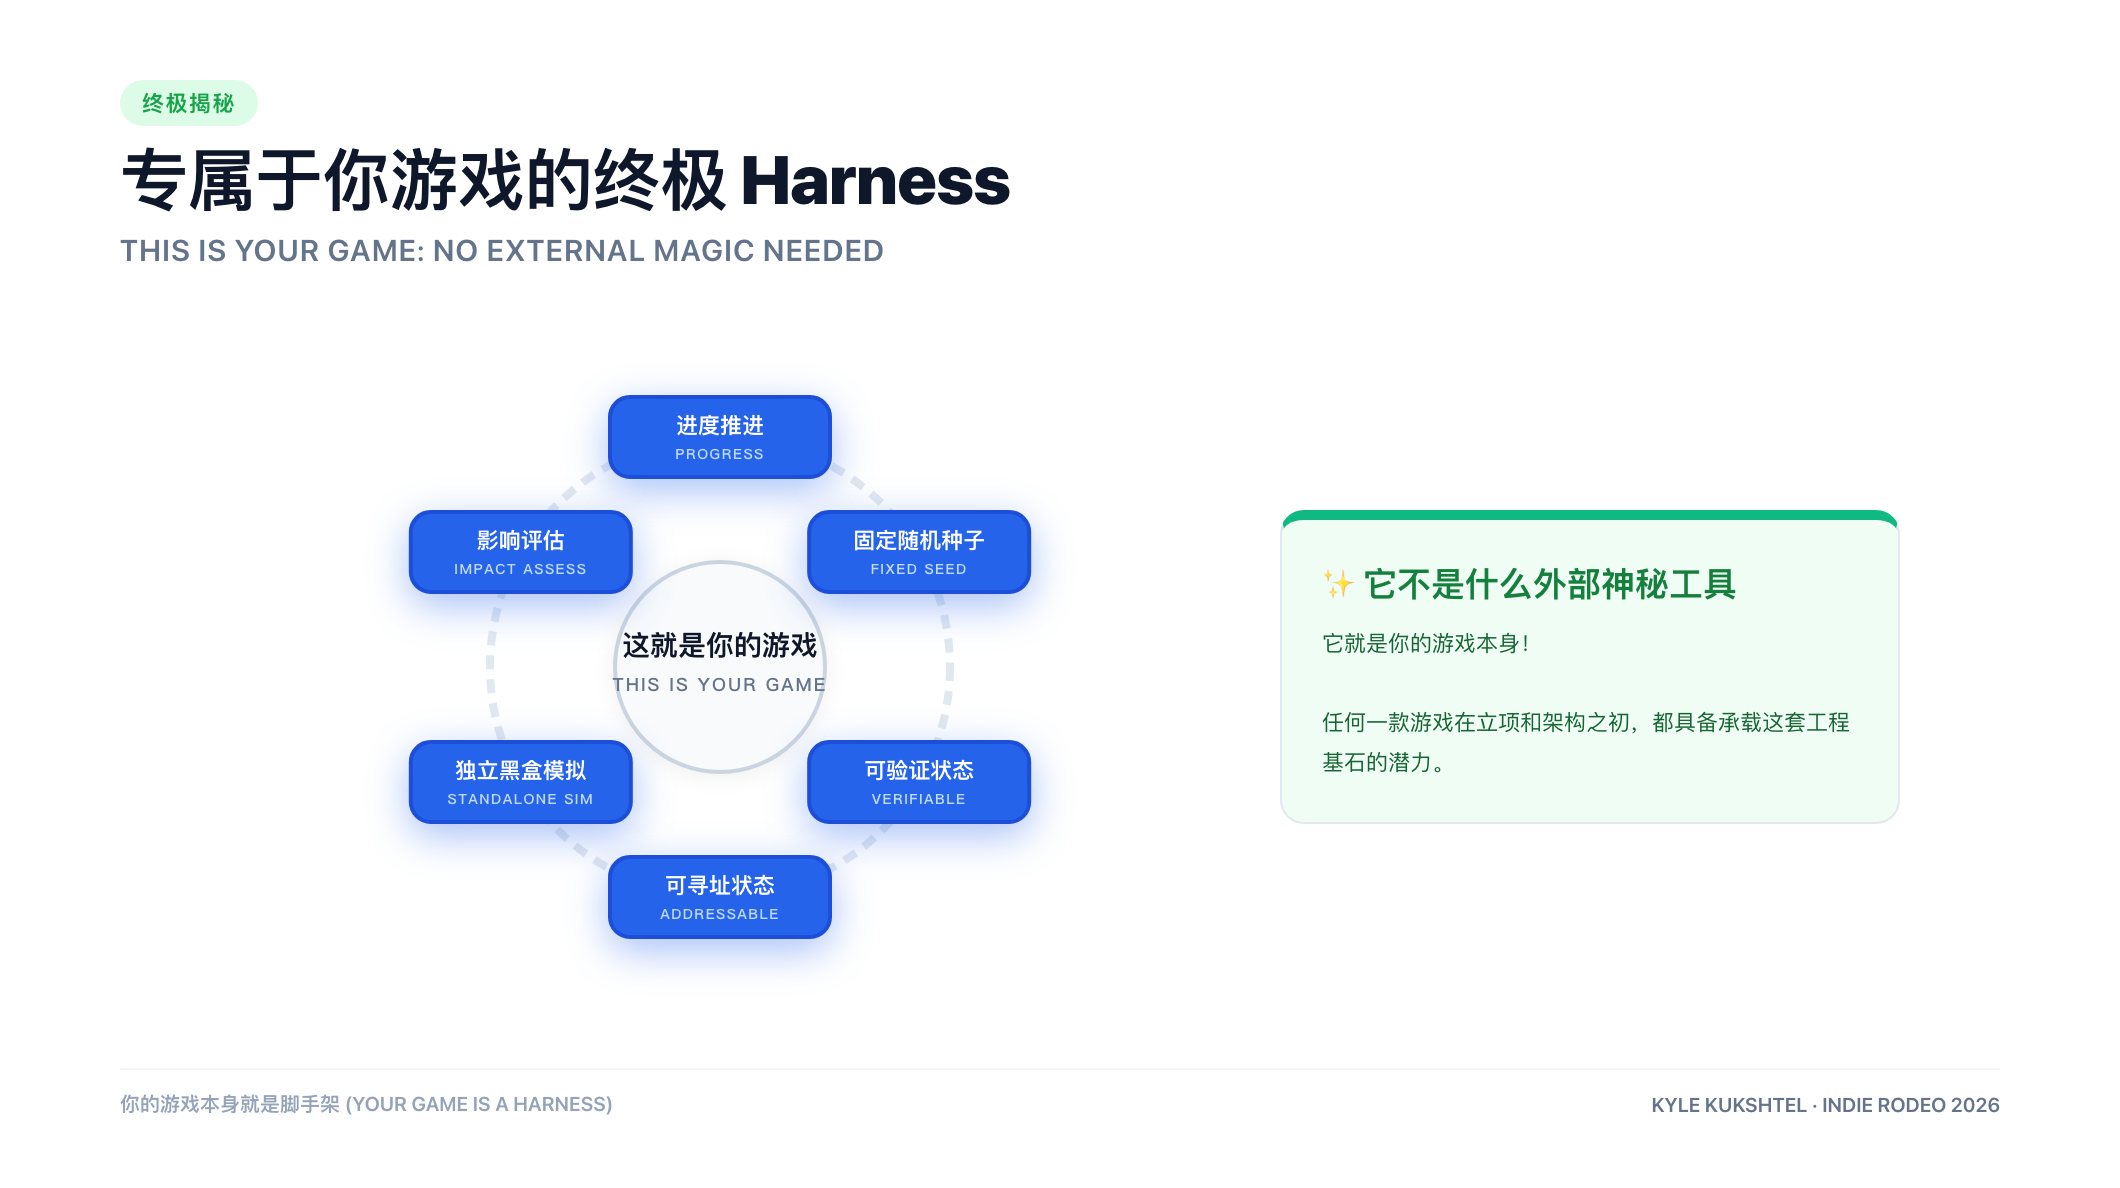
你的游戏本身就是 Harness 架构图
剧透一下:这并不是什么外部神秘工具,它就是你的游戏本身! 任何一款游戏在架构之初都具备承载这一切的潜力。或者正如我们开篇所言:
Your Game Is A Harness 总结
感谢你的阅读!
本文系外文翻译,前往查看
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号