大模型对齐核心技术拆解:详解RLHF强化学习、PPO优化、DPO偏好对齐的差异与实践22.3
原创
大模型对齐核心技术拆解:详解RLHF强化学习、PPO优化、DPO偏好对齐的差异与实践22.3
原创
未闻花名
发布于 2026-09-12 09:48:10
发布于 2026-09-12 09:48:10
一、前言
在日常使用大模型的过程中,很多人都会遇到一类典型问题:模型本身储备的知识足够全面,但输出的回答往往生硬冗长、重点模糊,甚至频繁出现内容幻觉、答非所问等问题,无法贴合人类的对话逻辑与使用习惯。这类问题并非源于预训练阶段的知识训练不足,核心原因是模型未完成人类偏好对齐优化。
目前市面上成熟的商用大模型,之所以能够实现自然流畅的对话、逻辑通顺的输出与正向合规的表达,核心均依托三大核心对齐技术:RLHF人类反馈强化学习、PPO近端策略优化、DPO直接偏好优化。这三项技术也是大模型微调迭代、偏好对齐、效果自动化评估的核心技术支柱。可能我们知晓RLHF是主流对齐技术,却不了解其完整训练流程;也听过PPO、DPO的名称,却无法厘清二者与RLHF的迭代关系、核心差异及适用场景。今天我们就循序渐进拆解三项技术的底层原理、完整训练流程、核心优势与落地短板,同时系统梳理三者的迭代逻辑与落地适配场景,理解大模型“贴合人类偏好、规范输出内容”的底层逻辑,掌握主流的模型对齐、偏好优化实操思路。
二、初识大模型对齐
1. 对齐核心定义
正式展开技术拆解前,首先明确大模型对齐的核心定义。简单来说,大模型对齐是一套优化模型输出、贴合人类偏好、匹配主流价值观与日常使用习惯的精细化调优流程,是预训练模型落地商用的关键收尾环节。
1.1 预训练模型的缺陷
预训练阶段的大模型,核心目标是依托海量文本数据,学习语法规则、语义逻辑、通用知识与内容规律,仅具备基础的文本生成能力,不具备主观对错判别能力与人类偏好认知能力。因此,原生预训练模型存在诸多落地短板:
- 输出内容冗余啰嗦,核心信息不突出,阅读体验差;
- 缺乏内容甄别能力,容易凭空编造信息,产生严重的模型幻觉问题;
- 输出内容可能携带偏见、争议性、不良导向等不合规话术;
- 语境理解能力薄弱,无法精准捕捉复杂对话意图,频繁出现答非所问的情况。
1.2 大模型对齐的核心目标
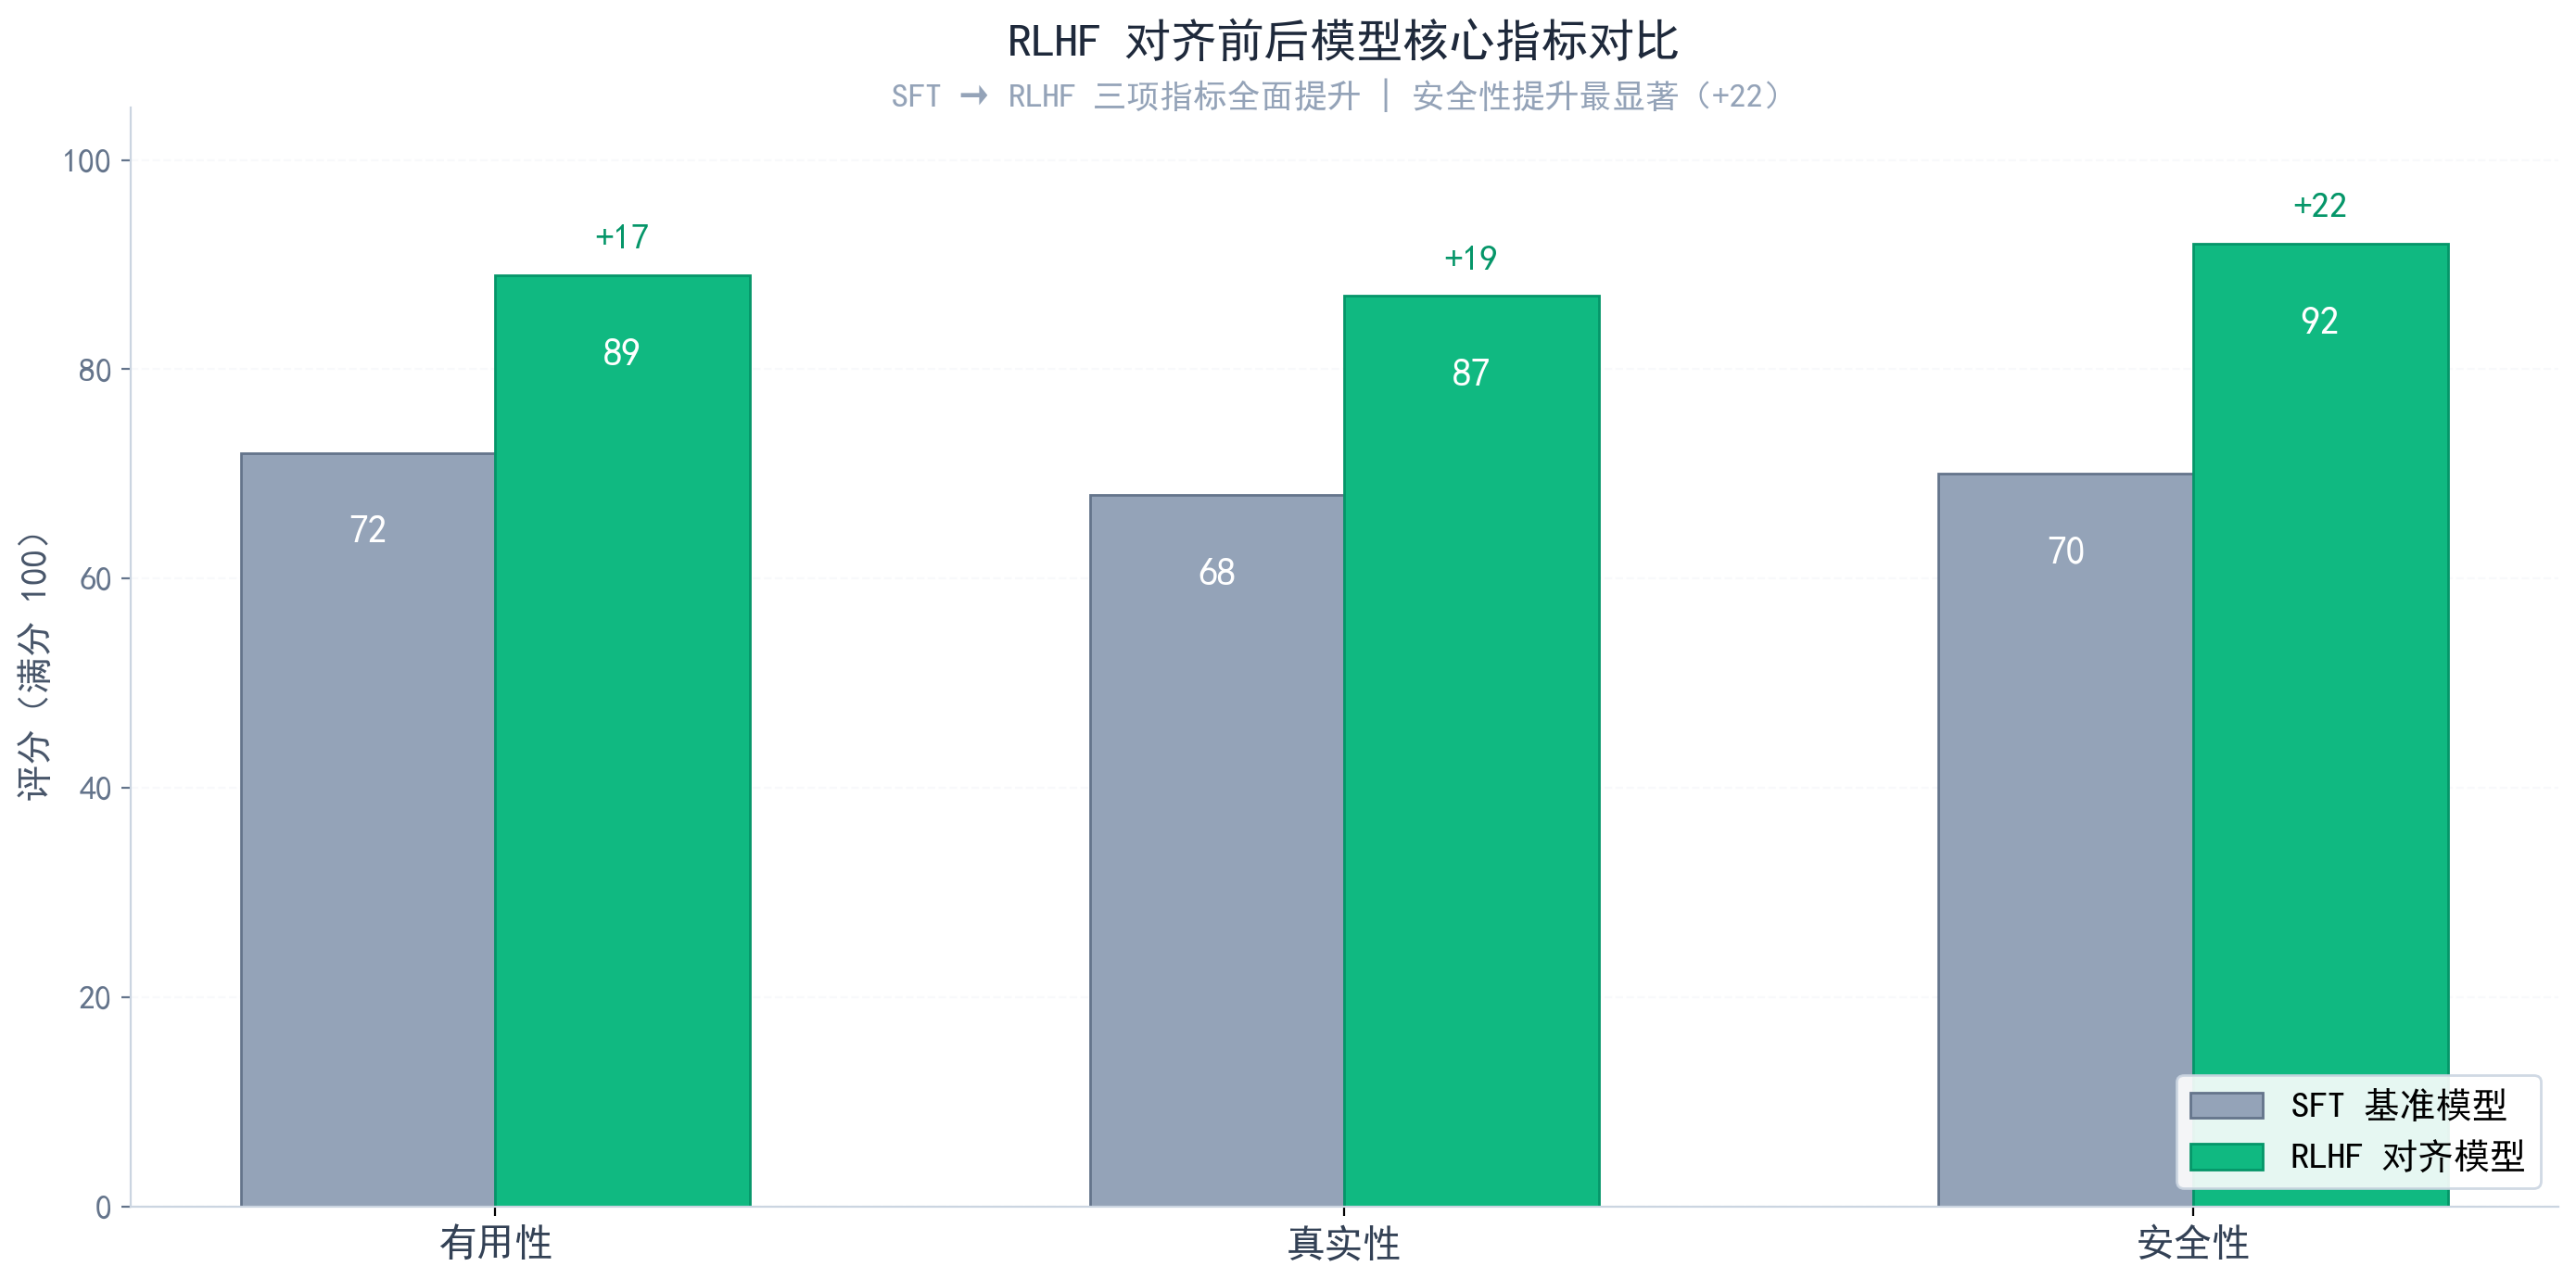
对齐技术的核心价值,就是针对性修复预训练模型的各类缺陷,所有对齐方案的优化目标高度统一,主要聚焦三大维度:
- 有用性:精准解析用户指令意图,输出内容贴合提问需求、逻辑清晰、重点突出,彻底解决答非所问、无效凑字、内容空洞等问题。
- 真实性:有效抑制模型幻觉,大幅减少虚假信息、错误知识的输出,保障回答内容严谨、可溯源、符合客观事实。
- 安全性:自动识别并过滤暴力、歧视、谣言等不良内容,贴合主流人类价值观,确保模型输出合规可控、正向积极。
简单区分两大核心阶段:
- 预训练的核心作用是让模型“学会认知知识、掌握语言表达能力”,搭建基础的通用能力底座;
- 而对齐的核心作用是让模型“规范表达逻辑、精准贴合人心、输出优质内容”,完成落地优化。
2. 对齐前置基础
所有高阶大模型对齐技术,都必须以SFT监督微调为前置基础。若跳过SFT环节直接开展RLHF或DPO对齐训练,极易出现模型优化失效、参数崩塌、训练崩溃等严重问题,导致对齐工作完全无效。
2.1 SFT监督微调核心定义
SFT监督微调,是依托高质量人工标注的对话数据集,对预训练大模型开展的首轮定向微调。其核心作用是在强化学习对齐之前,帮助模型建立基础的指令理解能力与对话表达规范,为后续高阶对齐搭建稳定可靠的技术底座。
2.2 SFT监督微调核心作用
- 规范输出格式:让模型适配人类问答、指令执行、内容创作等各类场景的输出范式,统一语句结构与表达逻辑,规避语句断裂、格式混乱、逻辑杂乱等问题。
- 夯实指令理解能力:通过海量多样化指令样本训练,让模型精准识别不同用户意图,有效区分通用问答、逻辑推理、专业创作、问题求解等场景的需求差异。
- 奠定对齐基础:经过SFT微调后的模型,是RLHF、PPO、DPO所有对齐优化的基准模型,后续所有偏好迭代、参数更新、效果优化,均基于SFT模型展开。
2.3 SFT监督微调的天然短板
SFT仅能复刻标注数据中的标准答案,优化模式较为固定,存在明显的能力局限性,无法满足高阶落地的个性化、精细化需求:
- 不具备内容优劣判别能力,无法区分同一提问下不同回答的质量差异;
- 输出范式单一固化,无法适配用户个性化偏好,如简洁回答、详细解读、通俗表达等差异化需求;
- 仅能被动复刻标注内容,无法自主迭代优化输出质量,必须依靠强化学习对齐技术补足能力短板。
3. 对齐技术演进
3.1 第一代对齐方案:RLHF+PPO
- 核心构成:以RLHF为完整对齐流程框架,PPO为流程末端的核心优化算法,二者搭配组成初代工业对齐方案。
- 技术特点:依托人工偏好标注、独立奖励模型训练、多轮强化学习迭代完成精细化对齐,技术链路完整、优化精度高。
- 优缺点:对齐效果达到行业顶尖水平,适配顶级商用大模型,但整体流程繁琐、算力消耗巨大、训练难度极高,落地成本居高不下。
3.2 第二代对齐方案:DPO轻量化对齐
- 技术定位:针对RLHF+PPO方案的痛点迭代升级,是高效低成本的轻量化平替技术。
- 核心创新:通过严谨的数学推导,直接剔除奖励模型、多模型联动、复杂迭代采样等冗余模块,无需传统强化学习复杂流程即可完成对齐。
- 优缺点:在近乎持平的对齐效果基础上,大幅提升训练效率、降低落地门槛,是当前中小参数模型的主流对齐方案。
3.3 三者核心逻辑关系
三者并非并列技术,而是基础流程框架+核心执行算法+轻量化迭代方案的递进迭代关系:
- RLHF是完整的大模型对齐流程体系;
- PPO是落地RLHF的核心算法;
- DPO是RLHF+PPO的轻量化优化升级版。
三、RLHF核心体系
1. RLHF核心概念
RLHF全称为基于人类反馈的强化学习,是大模型对齐领域经典且成熟的完整技术范式,也是初代ChatGPT实现高精度对齐的核心依托。RLHF不等同于单一算法,它是一套涵盖数据、建模、迭代的三阶段完整训练流程体系。
1.1 RLHF核心底层逻辑
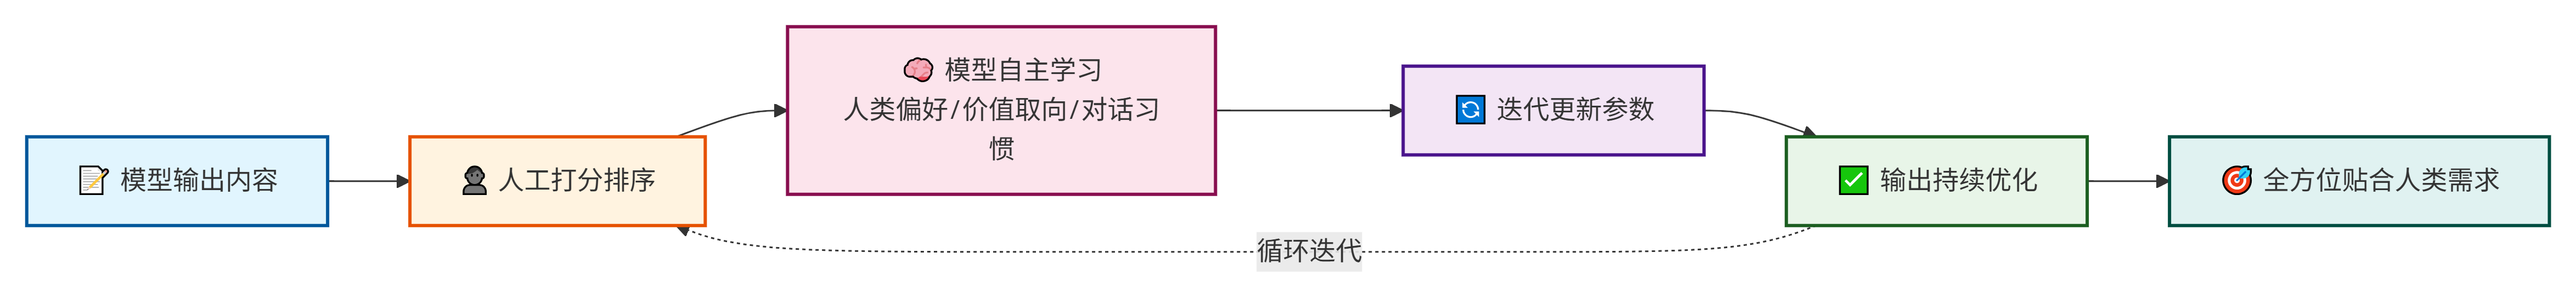
其核心思路贴合人类的学习成长逻辑:通过人工对模型输出内容进行打分、优劣排序,让模型自主学习人类的审美偏好、价值取向与对话习惯,持续迭代更新参数,逐步优化输出内容,最终实现全方位贴合人类需求。
1.2 RLHF对比SFT的核心优势
- 具备优劣判别能力:SFT只能机械学习固定标准答案,无质量判别能力;RLHF可精准区分回答的优劣差异,建立清晰的优质输出标准。
- 适配个性化需求:能够适配不同用户、不同场景的多样化偏好,突破SFT输出范式单一、灵活性不足的局限。
- 支持持续迭代:可不断接入新增的人类反馈数据,持续打磨模型输出质量,动态适配需求变化。
2. RLHF完整流程
RLHF的完整落地流程分为三个层层递进、缺一不可的核心阶段,实现从基础SFT模型到高精度对齐模型的完整升级,具体拆解如下:
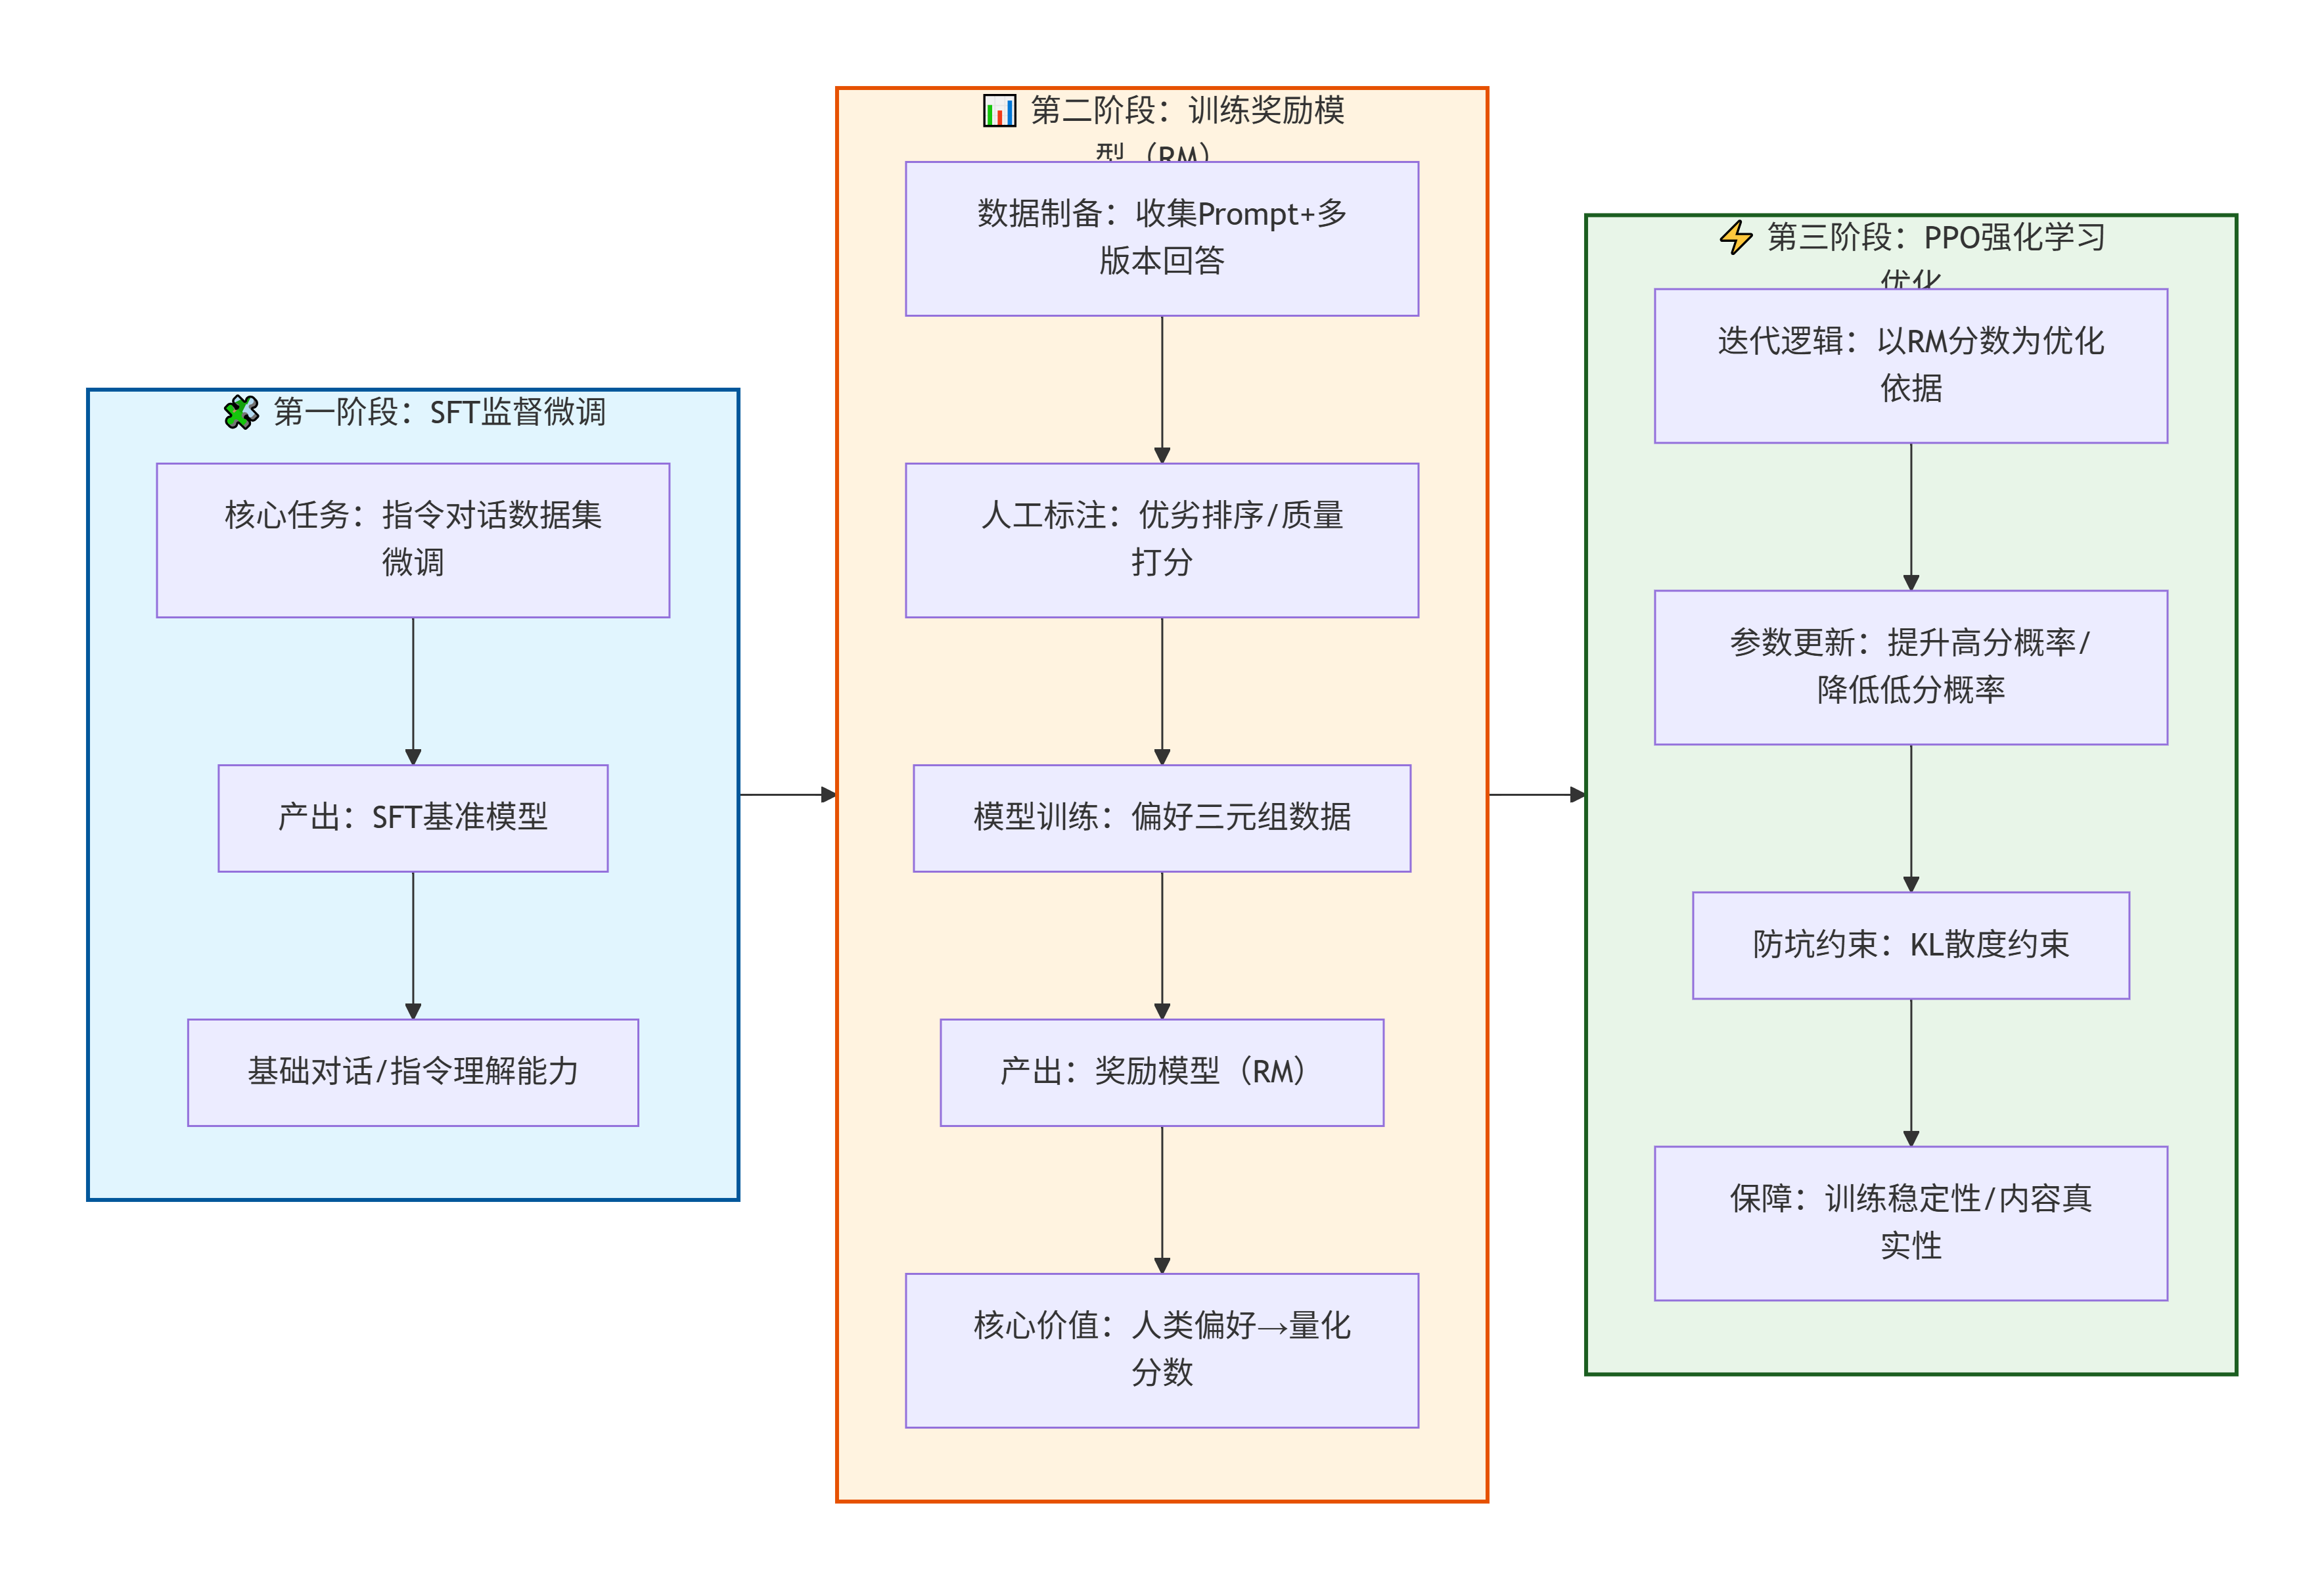
第一阶段:SFT监督微调(对齐前置基础)
- 核心任务:依托高质量指令对话数据集,对预训练大模型开展首轮微调,生成具备基础对话与指令理解能力的SFT基准模型。
- 核心作用:本阶段不涉及强化学习,仅搭建模型基础对话能力,确保模型可正常解析用户指令、生成规范文本,为后续强化学习对齐提供稳定基准。
第二阶段:训练RM奖励模型(对齐核心创新)
这是RLHF区别于普通微调的关键环节,也是实现人类偏好量化、支撑自动化迭代的核心:
- 数据制备:批量收集用户提问prompt,由SFT模型生成多版本回答,通过人工标注完成内容优劣排序与质量打分。
- 模型训练:基于“用户prompt+人类优选回答+人类淘汰回答”的偏好三元组数据,独立训练专属奖励模型(RM)。
- 核心功能:可对任意模型对话内容自动输出0-1区间的量化奖励分数,分数越高代表内容越贴合人类偏好。
- 核心价值:将人类模糊、主观的喜好标准,转化为模型可识别、可学习的量化指标,替代低效的人工实时打分,大幅提升训练迭代效率。
第三阶段:PPO强化学习优化(核心迭代落地)
- 迭代逻辑:以奖励模型的量化分数为优化依据,对SFT基准模型进行参数迭代更新,持续优化输出质量。
- 参数更新规则:提升高分优质回答的生成概率,降低低分劣质回答的输出概率,实现偏好拟合。
- 防坑约束机制:引入KL散度约束,限制优化后模型与原始SFT模型的输出差异,杜绝模型为追逐高分生成套话、假话的“奖励黑客”问题,保障训练稳定性与内容真实性。
3. RLHF优劣说明
结合完整的RLHF训练流程,可清晰梳理其核心优劣势,这也是后续DPO技术迭代升级的核心依据,所有特性均贴合工业界真实落地场景:
3.1 RLHF核心优势
- 对齐效果顶尖:依托真实人工偏好反馈与精准量化奖励打分,可深度贴合人类审美与使用需求,模型输出的有用性、安全性、流畅度均处于行业顶尖水平,适配GPT等千亿级顶级大模型。
- 场景适配广泛:可针对智能对话、内容创作、逻辑推理、专业问答等全场景,通过定制化偏好数据实现精细化、场景化对齐。
- 迭代能力极强:支持持续接入新增人工反馈数据,不断修复模型短板、优化输出效果,可动态适配用户需求与行业合规标准的更新迭代。
3.2 RLHF核心短板
- 训练链路繁琐:需要独立训练SFT基准模型、RM奖励模型、PPO策略模型,三大模型联动训练,链路冗长、工程复杂度极高。
- 落地成本极高:高度依赖海量高质量人工偏好标注数据,同时多模型并行训练需要巨额算力支撑,中小团队与个人开发者完全无法承担。
- 训练稳定性差:训练过程极易出现奖励过拟合、奖励黑客、模型模式崩溃等问题,超参数调参难度极大,极度依赖资深工程经验。
四、PPO优化算法
1. PPO基础定位
为避免概念混淆,首先明确二者从属关系:RLHF是完整的大模型对齐流程体系,PPO是RLHF第三阶段的核心落地算法,是实现强化学习参数迭代、完成偏好优化的核心工具,没有PPO算法支撑,RLHF的高阶对齐流程无法落地。
1.1 PPO技术基础定义
PPO全称为近端策略优化,是迭代式策略梯度强化学习算法,专门解决传统强化学习训练不稳定、参数更新失控、极易崩盘的行业痛点,也是目前工业界适配大模型训练最稳定、应用最广泛的强化学习优化算法。
1.2 PPO在大模型对齐中的核心定位
PPO的核心作用是承接奖励模型的量化打分,以小幅、稳定、可控的方式更新大模型参数,持续提升优质回答的生成概率,同时全程规避训练崩盘、参数失效、模型退化等问题,保障RLHF对齐流程稳定落地。
2. PPO核心原理
PPO的核心设计理念可概括为小幅迭代、稳步优化、拒绝激进更新,针对性解决了传统策略梯度算法更新无约束、训练极易失控的核心问题,具体原理拆解如下:
1. 核心痛点对比
- 传统强化学习:参数更新幅度无任何约束,单次迭代更新力度过大,容易直接破坏模型原有学习到的知识,导致模型失效、训练彻底崩盘。
- PPO算法:增设专属裁剪约束机制,严格管控每一轮参数的更新幅度,实现精细化微调,从根源保障训练稳定性。
2. PPO三大核心运行逻辑
- 新旧策略对照:训练全程保留原始SFT旧模型与待优化新模型,迭代过程中对比两者同一提问下的回答生成概率差异,精准锚定优化方向。
- 裁剪更新幅度:设置固定裁剪阈值,一旦新模型参数更新幅度过大,立即截断约束,确保每一轮迭代都是小幅微调,杜绝激进更新带来的风险。
- 奖励最大化优化:在保障训练稳定的前提下,以奖励模型分数为核心依据,最大化优质样本的奖励收益,让模型持续偏向高质量输出。
3. 辅助约束机制:KL散度正则化
该机制专门用于解决奖励黑客问题,通过约束优化后新模型与原始SFT基准模型的输出差异,避免模型为追逐高分刻意生成冗余套话、虚假内容,防止模型偏离原始知识体系,保障优化的真实性与合理性。
4. 通俗类比
传统强化学习如同大刀阔斧改造模型,容错率极低,稍有偏差就会彻底失效;而PPO如同精修细调,仅小幅优化局部参数,在稳定可控的前提下持续提升模型输出质量,安全性与稳定性大幅提升。
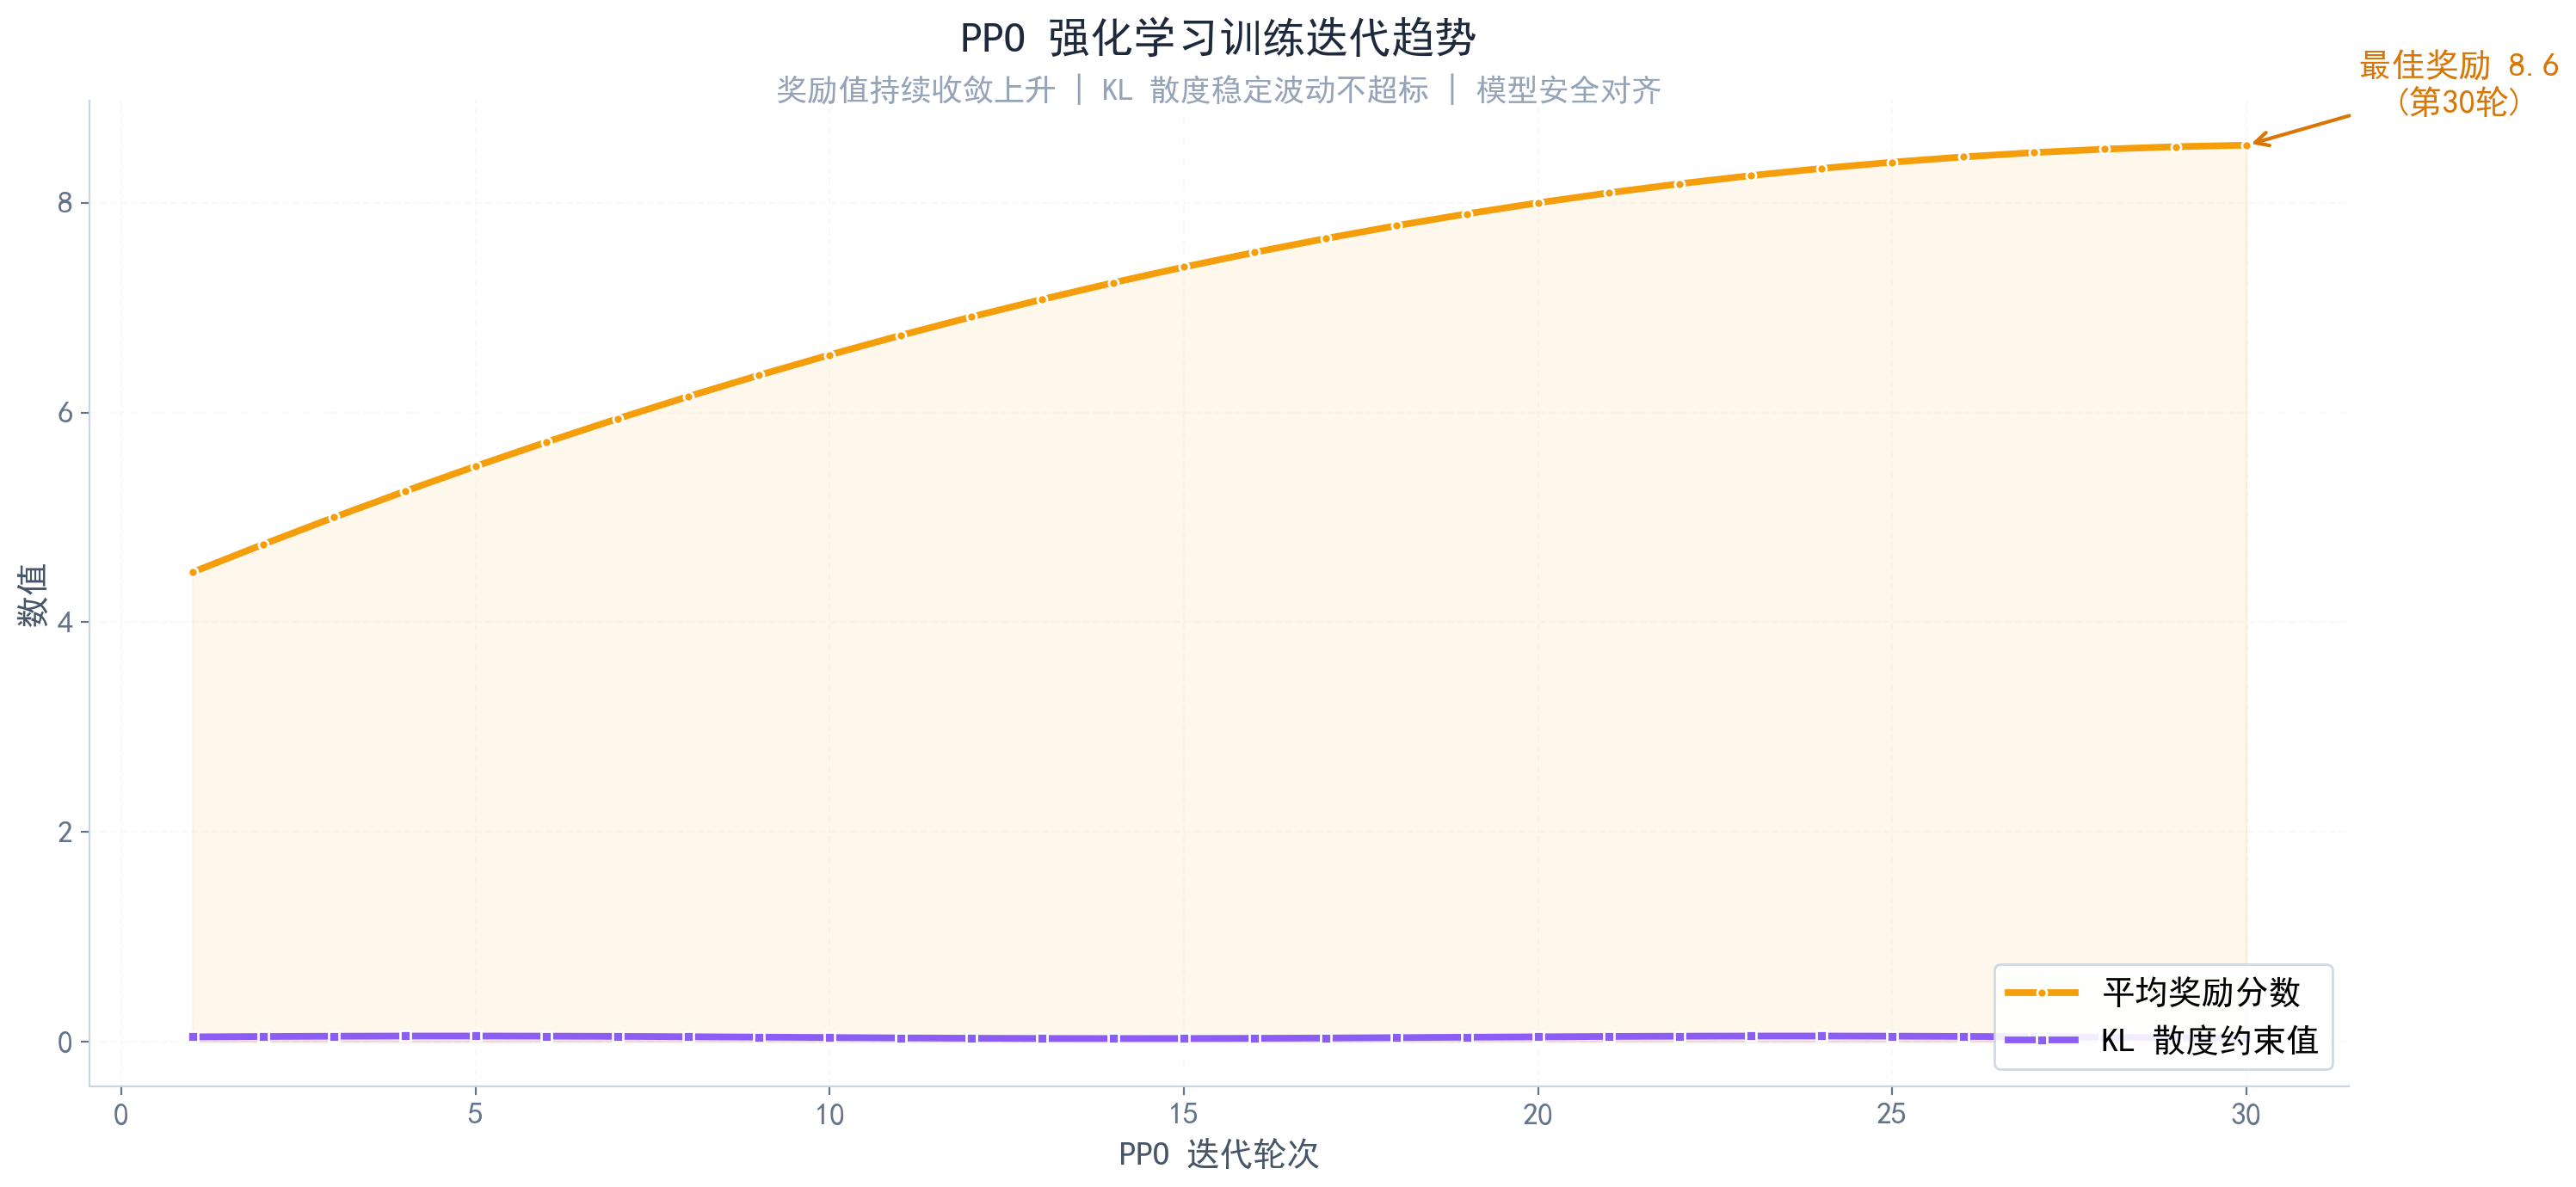
3. PPO训练流程
在大模型对齐场景中,PPO采用循环迭代的训练模式,通过多轮重复优化直至模型效果收敛,完整流程包含四个核心步骤,每一步都具备明确的工程落地价值:
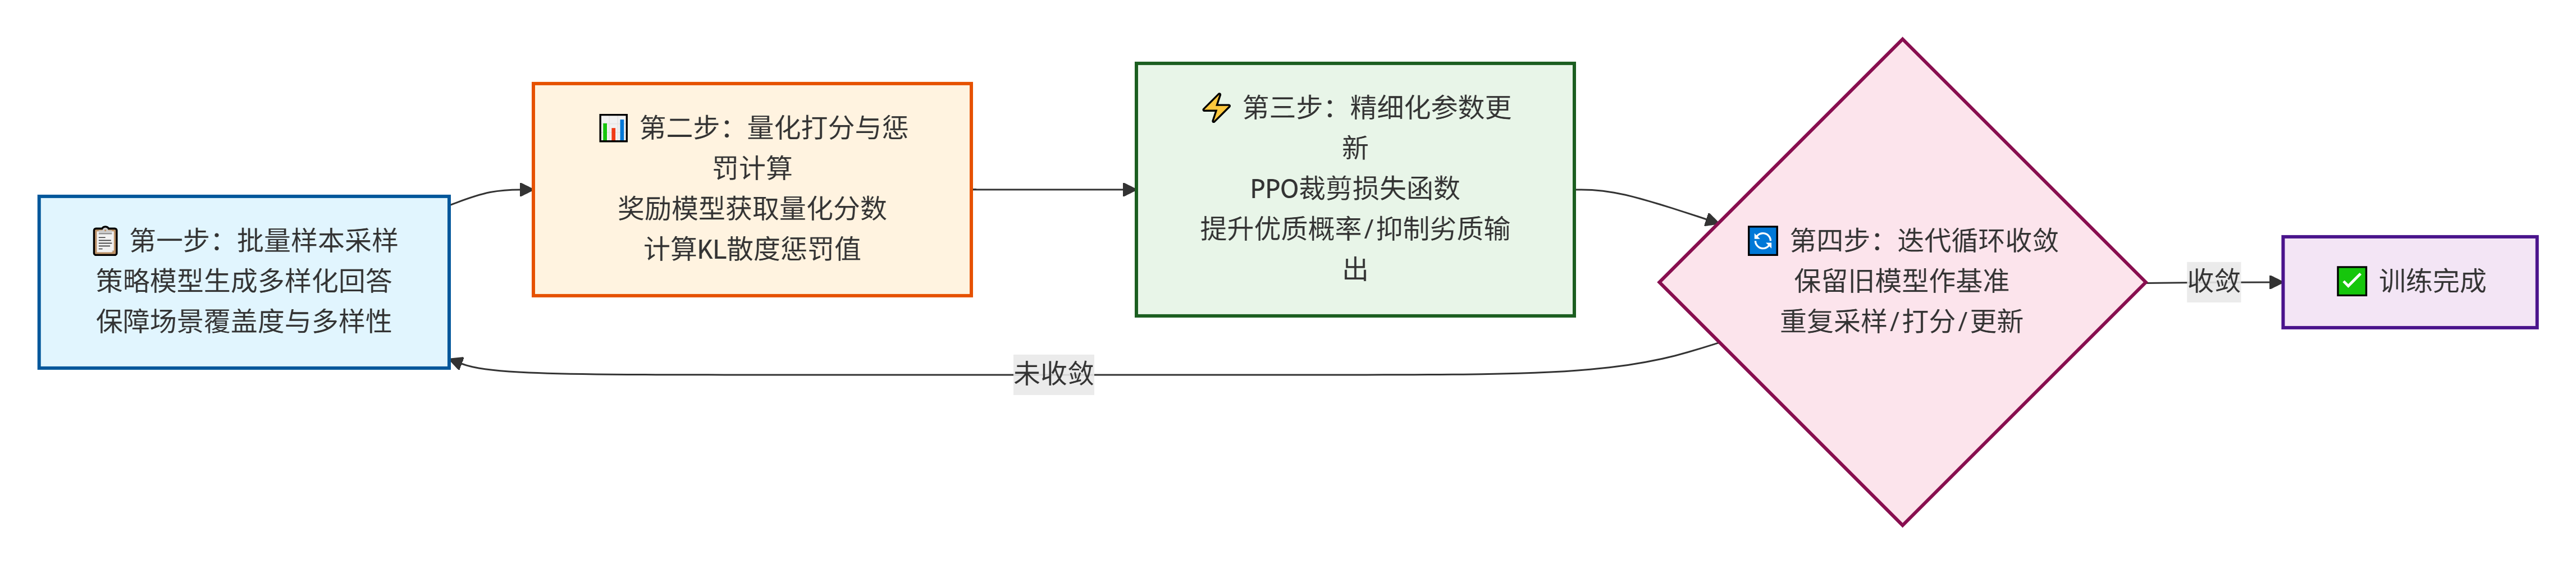
- 1. 批量样本采样
- 以当前待优化的策略模型为主体,输入批量多样化用户提示词,自动生成对应的对话回答,作为本轮迭代的训练样本,充分保障样本的场景覆盖度与多样性。
- 2. 量化打分与惩罚计算
- 将批量生成的样本输入奖励模型,获取每一条样本的量化奖励分数;
- 同时计算样本的KL散度惩罚值,为后续参数更新提供收益与惩罚双重依据。
- 3. 精细化参数更新
- 依托PPO专属裁剪损失函数,结合奖励收益与KL约束惩罚,小幅迭代更新模型参数,精准提升优质回答的生成概率;
- 同时抑制劣质内容输出。
- 4. 迭代循环收敛
- 单轮更新完成后,保留旧模型参数作为基准,重复采样、打分、参数更新全流程;
- 经过多轮迭代直至模型指标稳定、效果不再提升,即可结束训练。
实操注意点:
- PPO训练流程虽有标准化框架,但落地细节繁杂,学习率、裁剪系数、KL权重、批次大小等超参数直接决定优化效果;
- 参数设置偏差极易导致优化失效、模型退化,也是工程落地的核心难点。
4. PPO技术优缺点
经过实践落地验证,PPO算法的优劣势特征十分鲜明,直接决定了传统RLHF对齐的落地门槛与适用场景:
4.1 PPO核心优势
- 训练稳定性极强:通过裁剪机制与KL散度双重约束,彻底解决传统强化学习梯度爆炸、训练崩盘的痛点,完美适配大模型大规模、长周期的训练需求。
- 对齐精度高:依托量化奖励分数精准拟合人类偏好,参数优化方向精准可控,模型输出质量的提升效果稳定且显著。
- 场景适配性广:兼容各类大模型底座与全场景偏好对齐需求,是目前很多商用模型的首选对齐算法。
4.2 PPO核心短板
- 训练链路冗余:需要同时维护策略模型、奖励模型、参考模型三套模型并行训练,算力资源消耗极大、资源占用率高。
- 工程落地门槛高:超参数数量多、调参逻辑复杂,极度依赖专业工程经验,中小团队与个人开发者难以独立落地。
- 训练效率低下:迭代流程繁琐、样本采样成本高、单轮迭代周期长,整体训练速度缓慢,迭代效率偏低。
五、DPO轻量化对齐
1. DPO技术定位
DPO全称为直接偏好优化,是一种轻量化对齐技术,核心定位是RLHF+PPO高效平替升级版,专门针对传统对齐方案流程繁琐、算力成本高、落地难度大的核心行业痛点优化迭代。
1.1 传统方案的核心痛点
RLHF+PPO方案需要独立训练奖励模型、多模型联动运行、反复迭代采样,整体流程冗长、算力成本高昂、落地门槛极高,绝大多数中小团队与个人开发者无法落地,行业亟需轻量化替代方案。
1.2 DPO核心创新结论
经过严谨的数学推导验证:无需单独训练奖励模型、无需复杂强化学习迭代,仅依托成对偏好数据,即可实现与PPO等价的大模型对齐优化效果。
1.3 DPO核心价值
DPO彻底砍掉传统RLHF的所有冗余模块,将复杂的强化学习对齐问题,简化为简单高效的概率对比优化问题,在几乎不损失对齐效果的前提下,大幅降低落地算力成本与技术门槛,现已成为中小模型轻量化微调的主流方案。
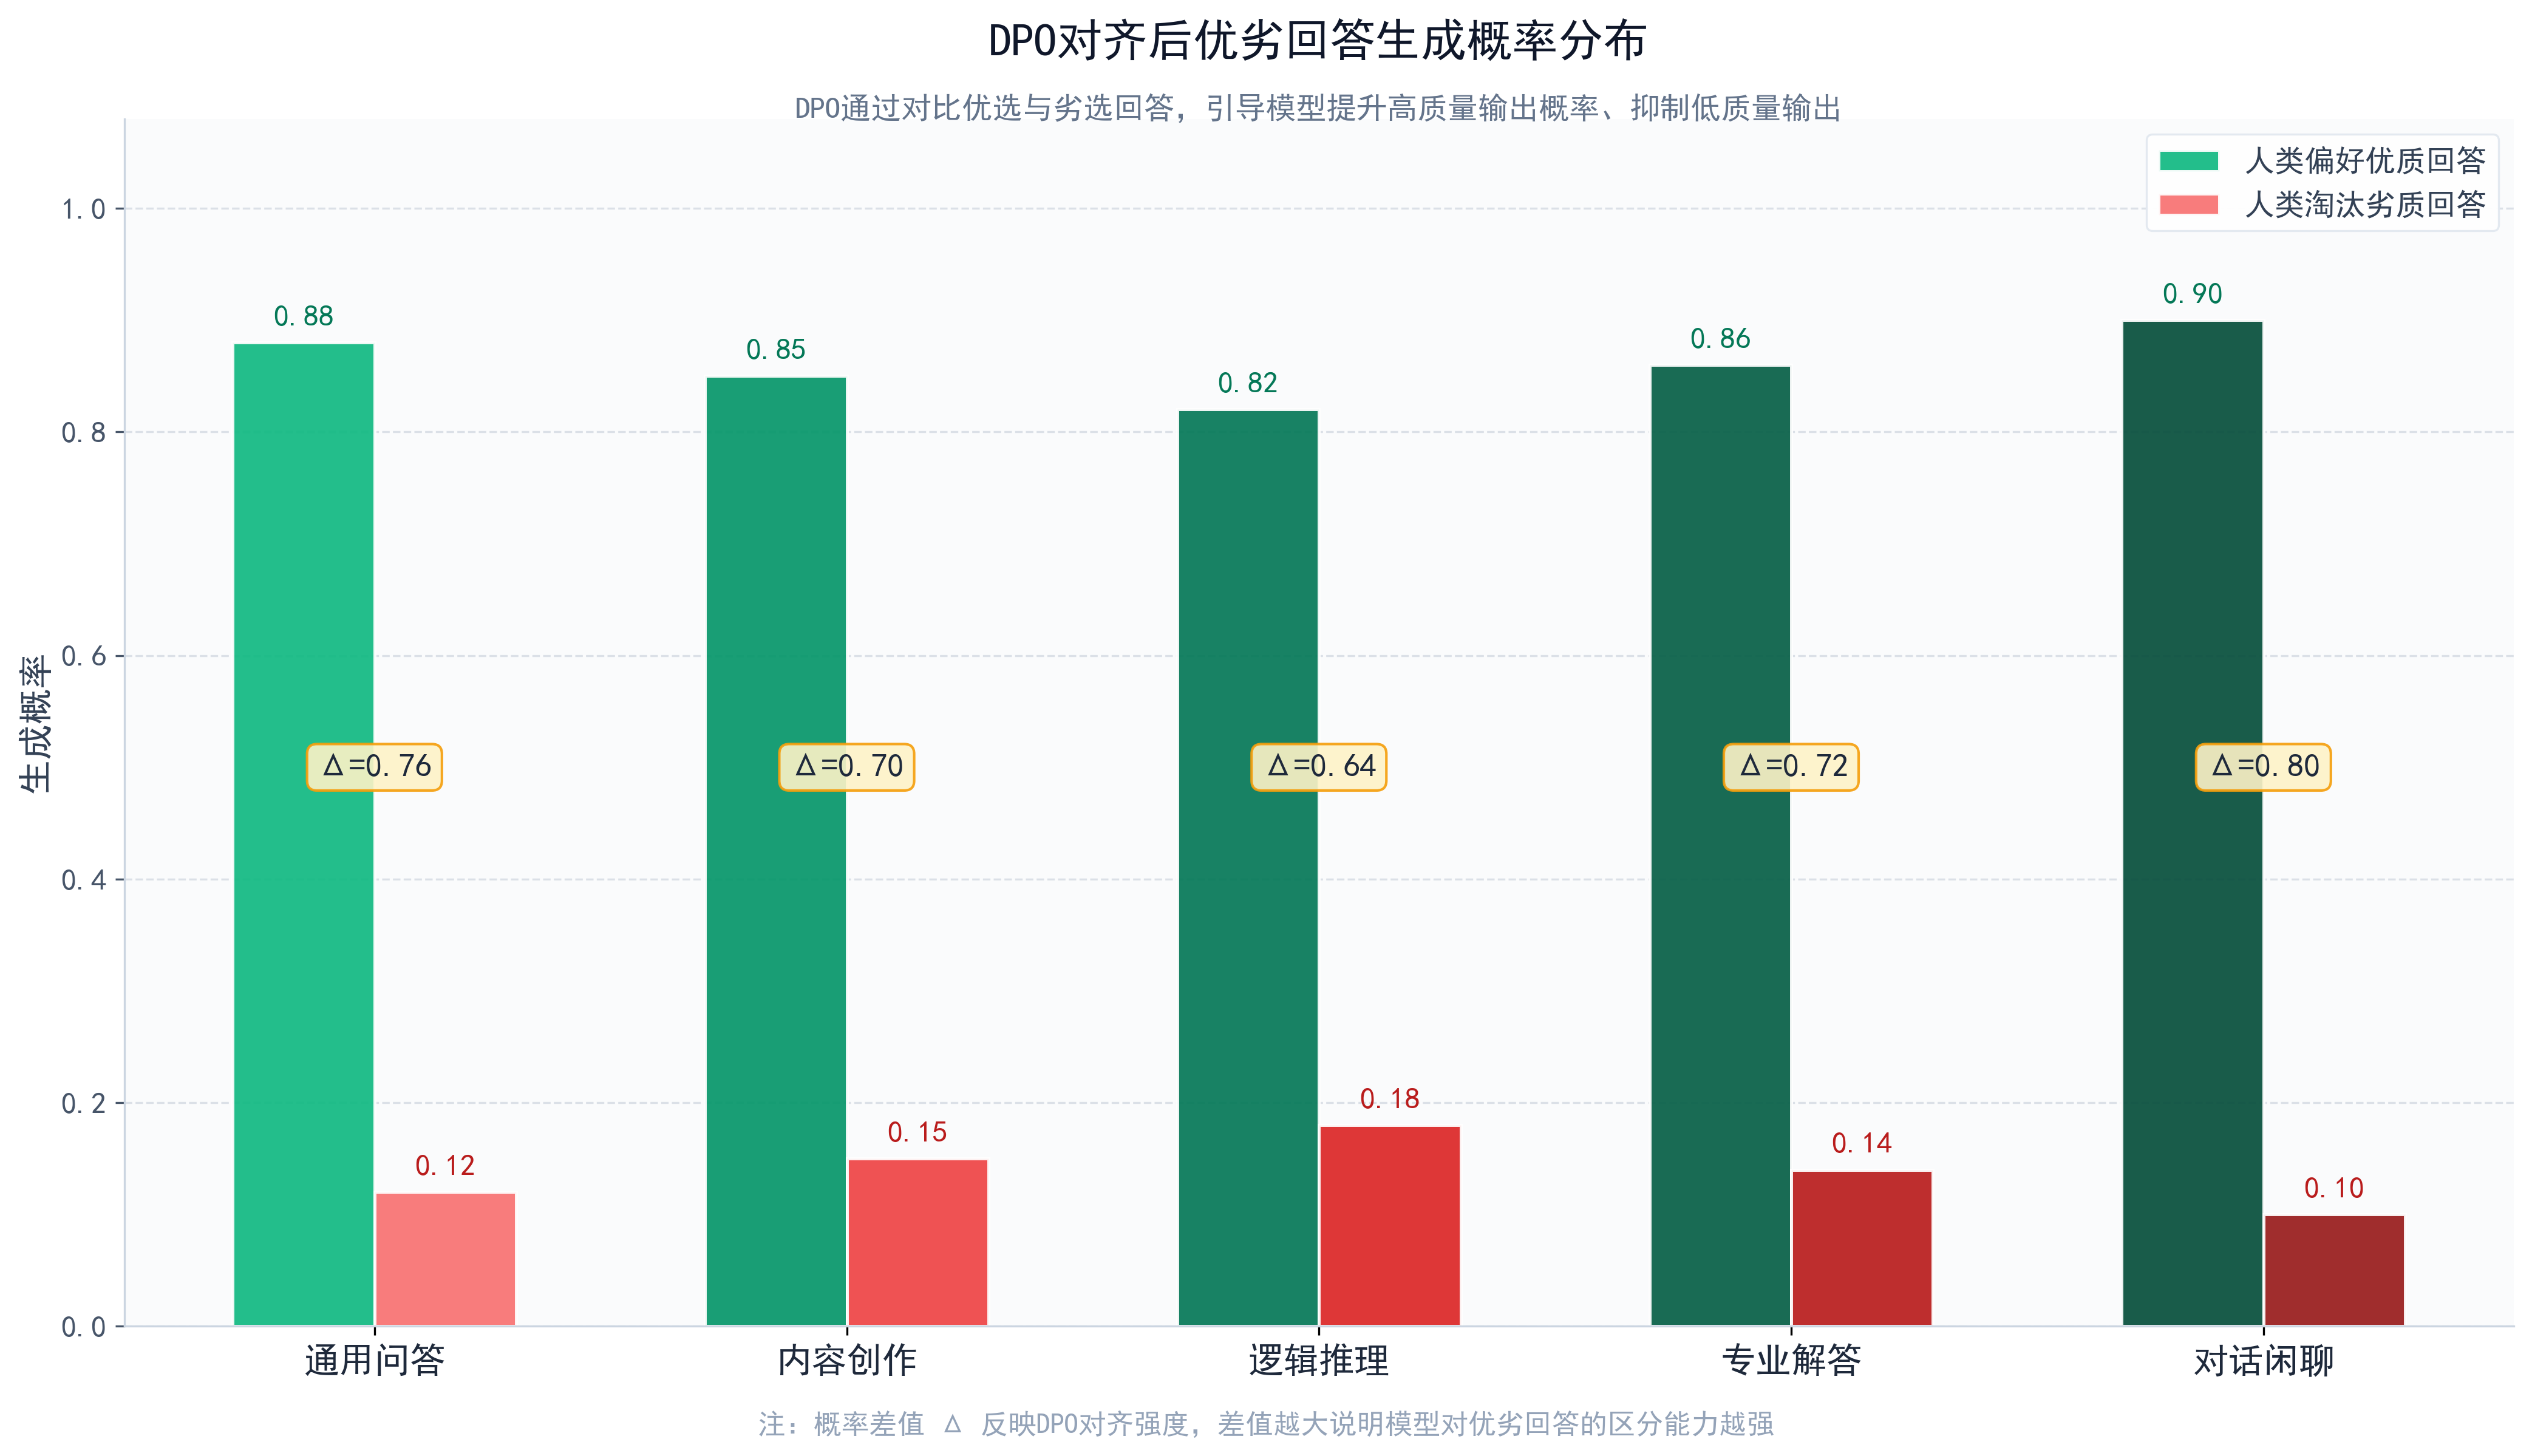
2. DPO核心原理
DPO摒弃了传统RLHF打分、多轮迭代的复杂逻辑,核心围绕“优劣回答概率差优化”展开,原理简洁易懂、零基础可快速掌握,具体拆解如下:
2.1 训练数据一致性
DPO与RLHF使用完全同源的训练数据,均采用"用户prompt+人类优选chosen回答+人类淘汰rejected回答"的三元组偏好数据,无需额外标注成本,可直接复用现有偏好数据集。
2.2 核心优化逻辑
无需人工打分、无需奖励模型量化评估,直接让模型自主判别回答优劣,通过双向约束完成参数优化:
- 正向优化:同一用户提问下,最大化模型生成人类偏好优质回答的概率。
- 反向约束:同步最小化模型生成劣质、非偏好回答的概率,拉大优劣输出的差距。
2.3 核心技术保障
- 通过专属DPO损失函数,持续拉大模型对优劣回答的生成概率差值,实现精准的偏好对齐;
- 同时设置温度参数β精准控制优化强度,有效规避模型过拟合、训练波动等问题,保障全程训练稳定。
2.4 理论优势
从数学底层可验证,DPO是PPO最优策略的等价简化形式,对齐效果上限与PPO基本持平,但训练流程精简90%以上,完美兼顾优化效果、训练效率与落地成本。
3. DPO训练流程
相较于RLHF三阶段的复杂训练流程,DPO的训练链路极度精简,仅需两大核心步骤,依靠单一模型即可完成全量对齐,落地门槛大幅降低:
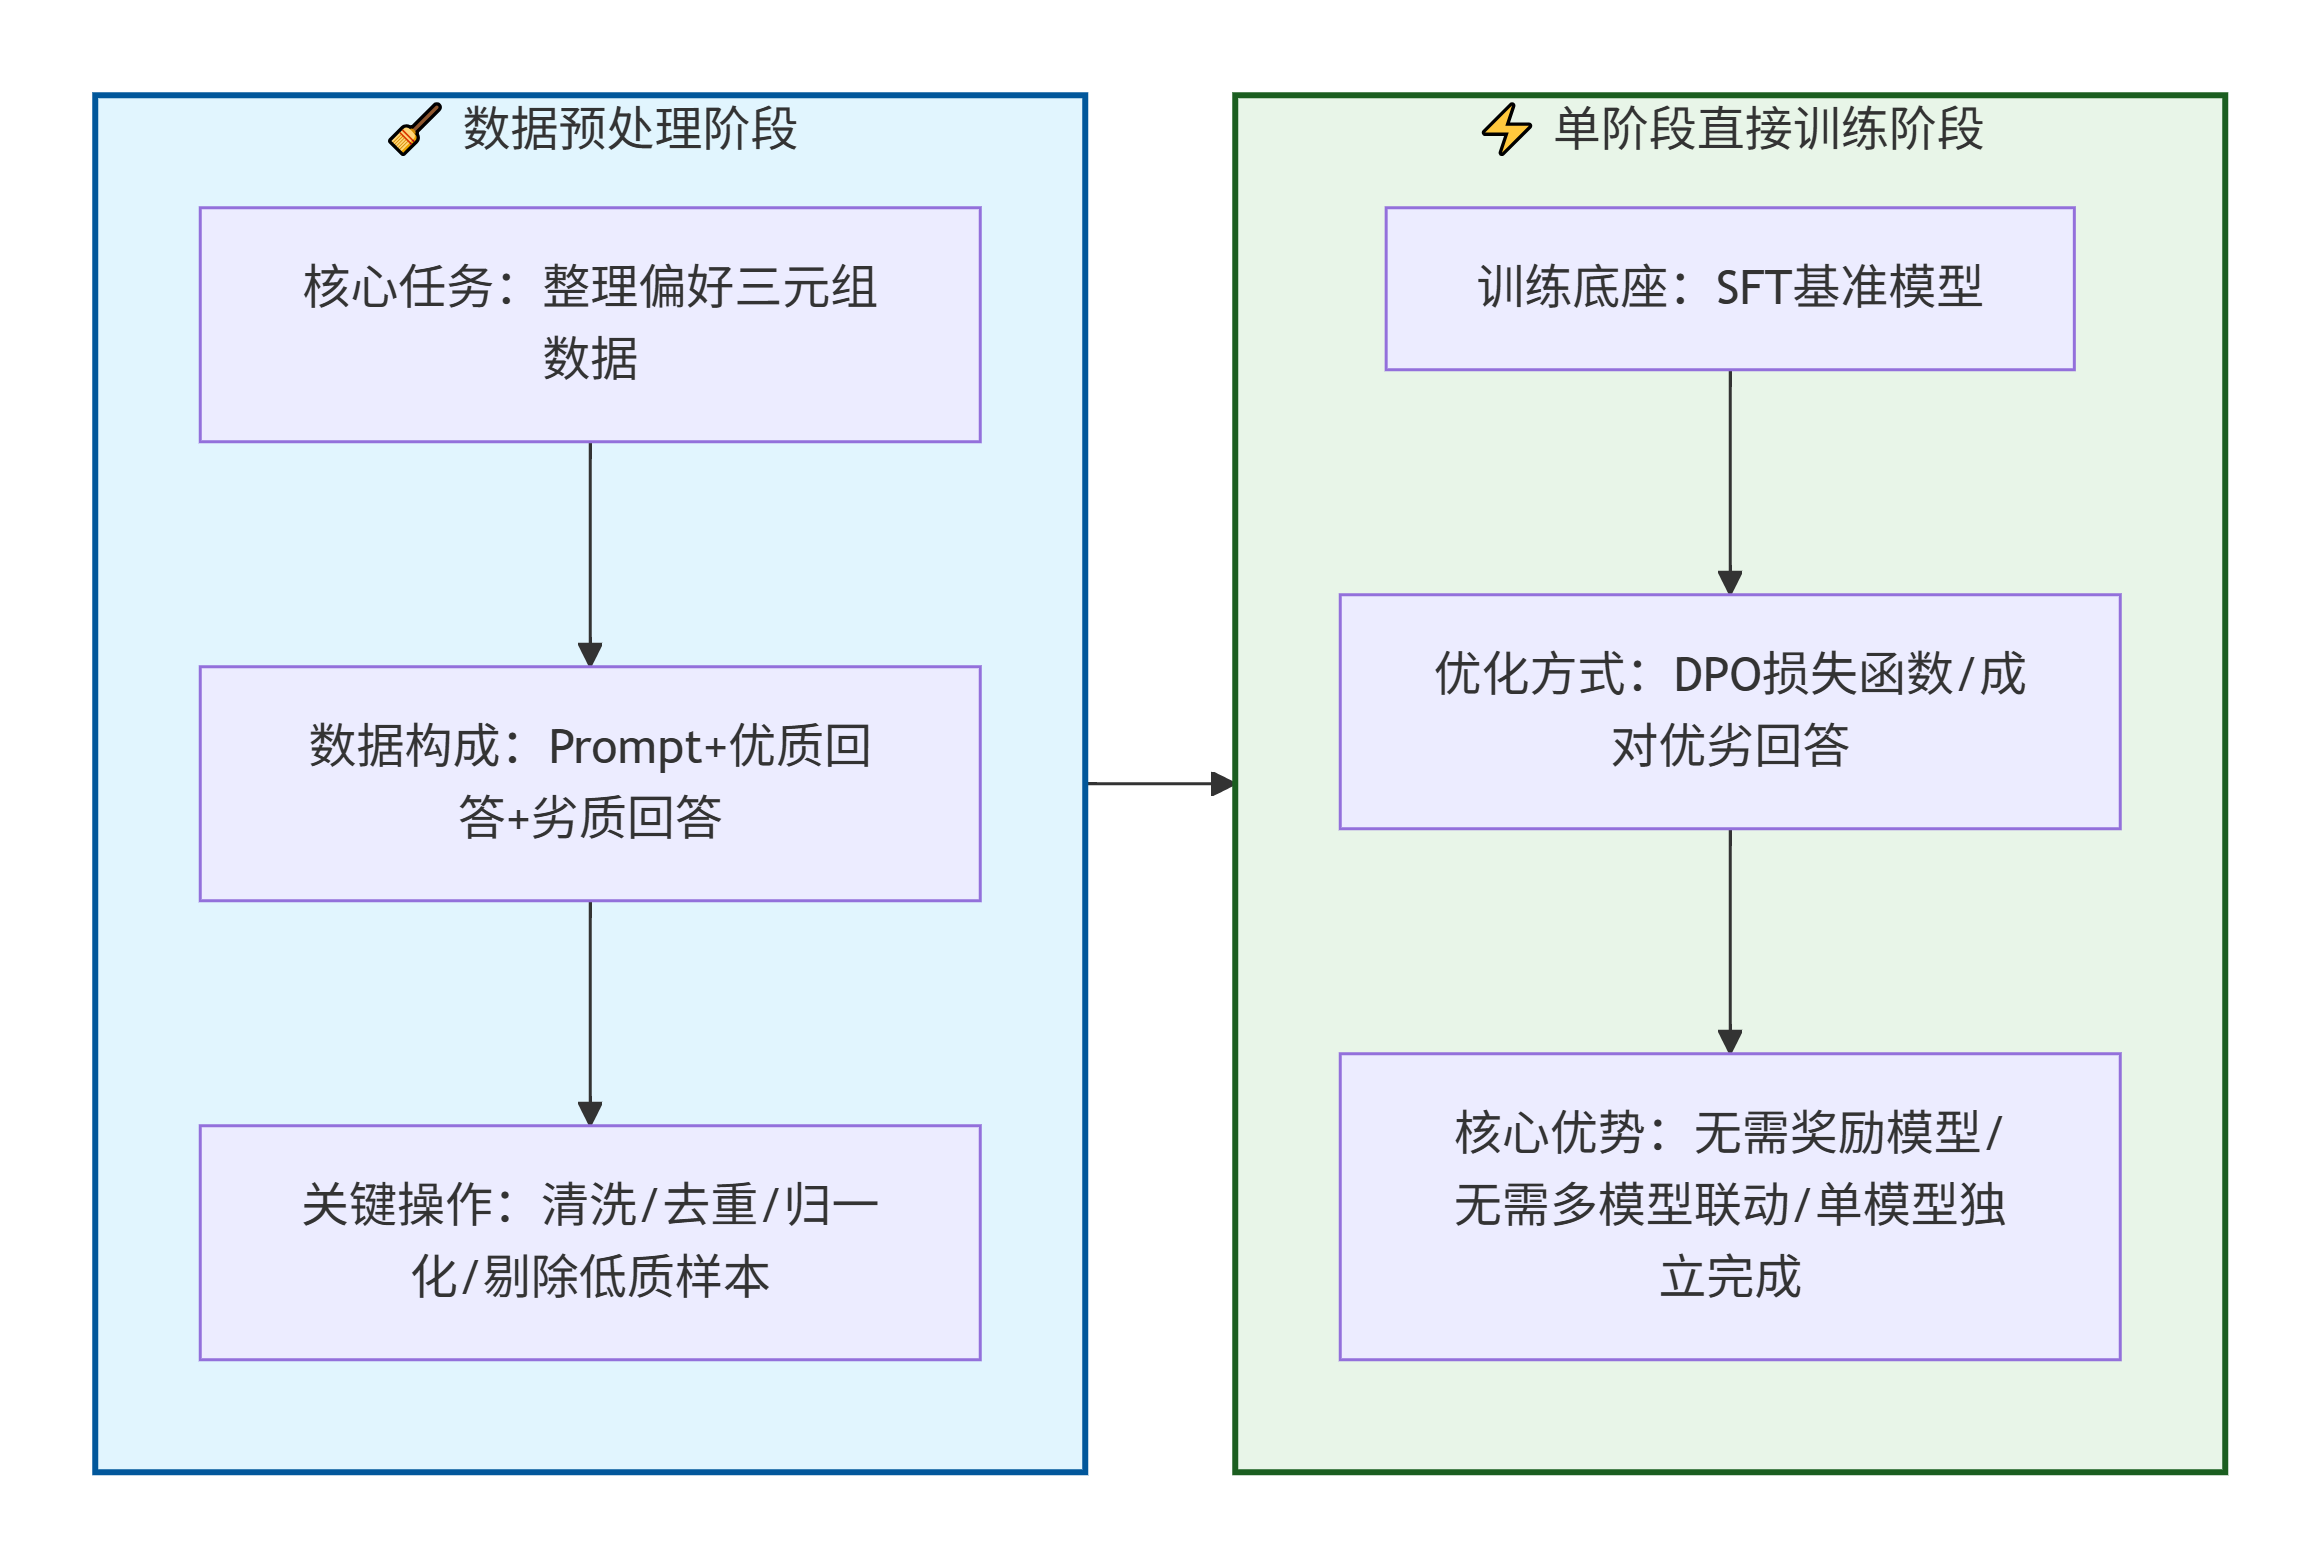
1. 数据预处理阶段
- 核心任务:整理标准化的偏好三元组数据,统一数据格式,筛选高质量训练样本。
- 数据构成:单条样本包含用户提问prompt、人工优选的优质回答、人工淘汰的劣质回答三部分内容。
- 关键操作:完成数据清洗、去重、格式归一化,剔除标注混乱、质量低劣的样本,从源头保障训练效果。
2. 单阶段直接训练阶段
- 训练底座:基于成熟的SFT基准模型开展迭代训练,无需额外预训练。
- 优化方式:依托DPO专属损失函数,输入成对优劣回答,让模型自主学习偏好差异、迭代更新参数。
- 核心优势:无需奖励模型打分、无需多模型联动、无需反复采样迭代,全程单模型独立完成。
落地效果 :
- 实测场景下,DPO的训练速度是PPO的数倍,算力消耗大幅降低,普通开发者、中小团队无需高端算力设备,即可快速完成大模型对齐微调落地。
4. DPO适配场景
DPO作为RLHF+PPO的迭代优化方案,优劣势针对性极强,与PPO形成完美互补,可精准适配不同层级、不同需求的模型落地场景:
4.1 DPO核心优势
- 流程极简,落地门槛低:彻底剔除奖励模型、多模型联动、复杂迭代采样等冗余环节,单模型即可完成对齐,工程实现难度大幅降低。
- 训练稳定,无衍生问题:无需人工量化打分,从根源规避PPO常见的奖励过拟合、奖励黑客、模型崩溃等疑难问题,训练过程平稳可控。
- 低成本、高效率:算力资源消耗极低、训练迭代速度快、超参数简单易调,适配轻量化、快速迭代的开发场景。
4.2 DPO核心短板
- 极致效果略有差距:在千亿级超大模型、超高精度精细化对齐的顶级商用场景中,DPO的细节优化能力与极致效果略逊于PPO。
- 数据依赖性强:对齐效果高度依赖高质量偏好三元组数据,劣质、标注混乱、样本失衡的数据集会直接导致优化失效、模型退化。
4.3 精准场景选型
- 优先PPO+RLHF:超大参数商用模型、极致输出质量要求、复杂行业定制对齐、算力资源充足的大厂研发场景。
- 优先DPO:中小参数模型微调、低成本快速迭代、个人科研学习、初创团队落地,以及需要规避PPO训练不稳定问题的研发场景。
六、技术核心对比
1. 核心差异汇总
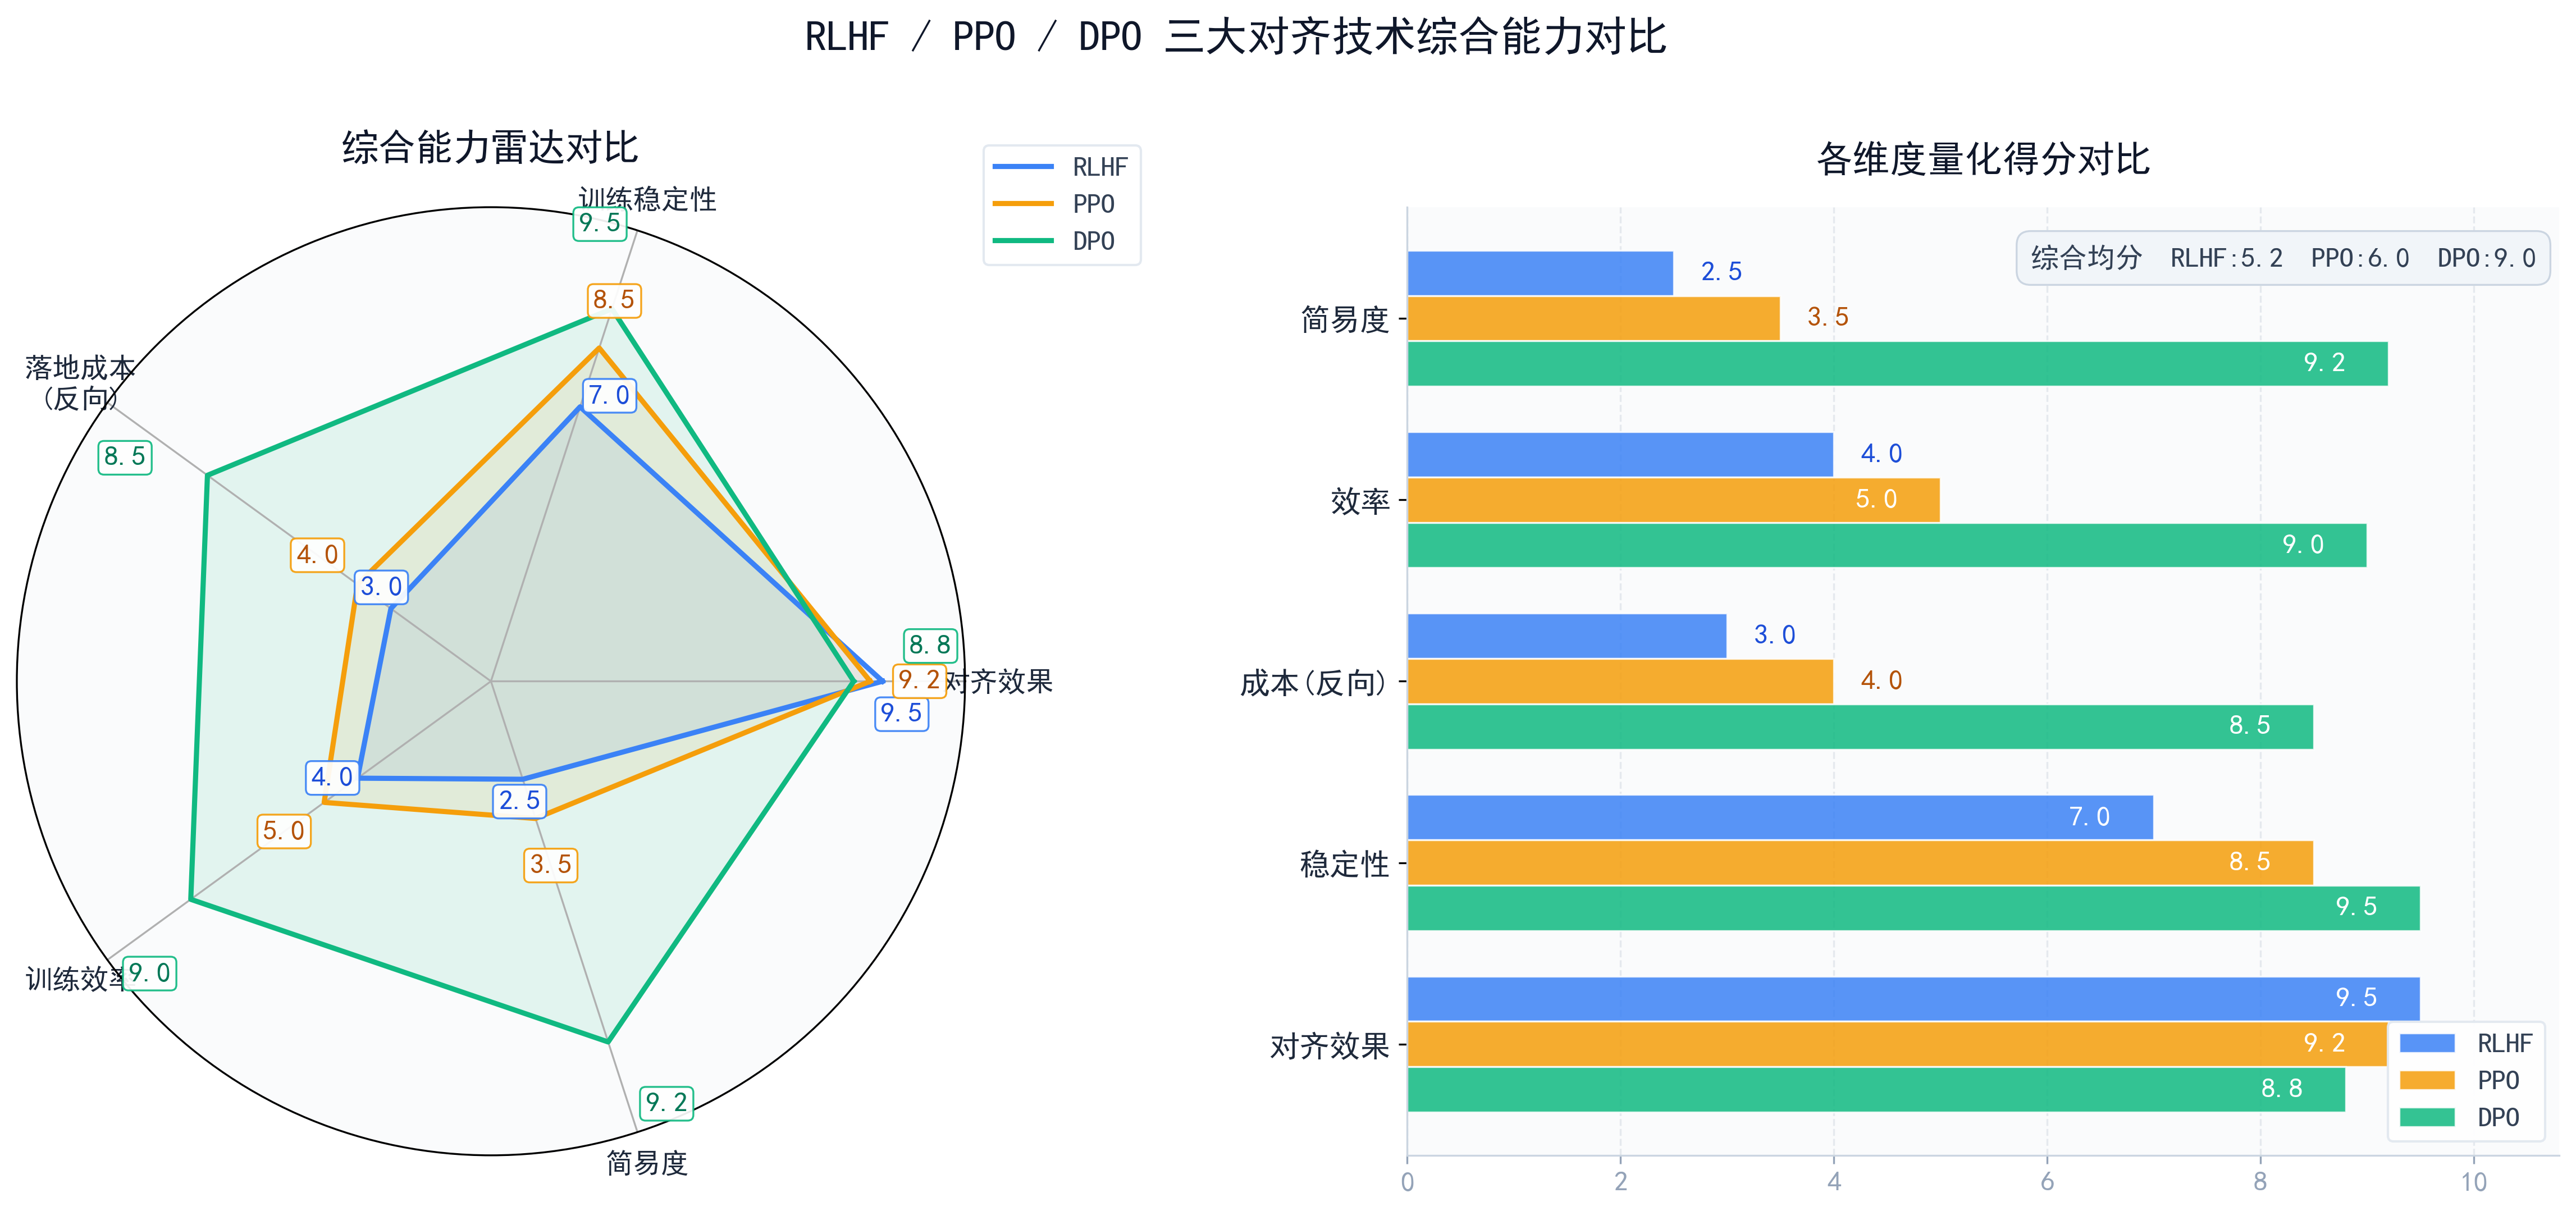
为彻底厘清RLHF、PPO、DPO三者的区别与内在关联,杜绝概念混淆,我们从六大核心维度开展全方位对比,直观呈现三者的技术差异与定位区别:
1.1 核心定位差异
- RLHF:完整的大模型偏好对齐流程体系,涵盖数据标注、奖励建模、强化学习迭代全链路。
- PPO:RLHF流程末端的核心优化算法,专门负责模型参数的迭代更新与效果优化。
- DPO:RLHF+PPO的轻量化替代方案,是等价简化、高效落地的完整对齐技术体系。
1.2 训练模块差异
- RLHF+PPO:需要SFT基准模型、奖励模型、参考模型三大模型联动训练,模块繁杂、架构复杂。
- DPO:仅需单一SFT基准模型,无需任何额外训练模块,架构极简、部署便捷。
1.3 落地成本差异
- RLHF+PPO:人工标注、算力资源、工程研发的综合成本极高,仅具备充足资源的大厂可落地。
- DPO:综合落地成本仅为传统方案的1/3甚至更低,轻量化、低成本、易普及。
1.4 训练稳定性差异
- RLHF+PPO:训练链路复杂,易出现奖励黑客、过拟合、训练波动、模型退化等问题,整体稳定性较差。
- DPO:训练逻辑简洁清晰,无额外衍生风险,全程训练平稳稳定,几乎无崩盘风险。
1.5 对齐效果差异
- RLHF+PPO:极致对齐效果最优,细节打磨精细,适配顶级商用高精度对齐场景。
- DPO:整体效果无限接近PPO,小幅效果差距可通过高质量训练数据补足,可覆盖绝大多数通用落地场景。
1.6 落地难度差异
- RLHF+PPO:工程落地门槛极高,调参复杂、链路冗长,极度依赖资深研发经验。
- DPO:上手门槛极低,调参简单、流程标准化,个人开发者与中小团队可快速落地。
2. 场景选型适配
结合三类技术的核心特性、落地成本与优劣势,推荐可直接复用的行业标准化选型规则,适配所有大模型微调对齐场景,无需反复试错验证:
2.1 优先选用RLHF+PPO方案的场景
- 超大模型商用落地:百亿、千亿级参数底座模型,需要极致的对话流畅度、安全性与稳定性,面向C端用户正式商用上线。
- 高端定制化对齐:金融、医疗、法律等专业领域,需要精细化适配行业偏好、合规规范与复杂业务逻辑。
- 大厂研发场景:具备充足算力资源、专业标注团队、资深工程研发人员,不计成本追求最优对齐效果。
2.2 优先选用 DPO 方案的场景
- 中小模型轻量化微调:几十亿及以下参数模型,用于私有化部署、轻量化业务场景,需要快速迭代优化效果。
- 低成本落地需求:个人学习、科研实验、初创团队开发,无高额算力与数据标注预算。
- 通用场景适配:普通对话、内容创作、简单问答等无需极致精细化对齐的通用落地场景。
- 规避训练风险:需要彻底规避PPO调参复杂、训练不稳定、奖励黑客等疑难问题的研发场景。
七、自动化评估指标
1. 评估核心意义
大模型对齐训练完成后,不能依靠人工肉眼主观判别效果,必须依托标准化、自动化的量化评估指标完成效果验收。
1.1 主观评测的核心弊端
人工主观评测存在效率低下、评判标准不统一、容易出现主观误判、无法批量验证模型效果等诸多问题,完全无法支撑模型高频次迭代优化的落地需求。
1.2 自动化评估核心价值
- 高效批量验证:可一次性批量检测海量测试样本,快速完成全维度模型效果验收,大幅提升迭代效率。
- 客观量化标准:以数据指标为核心评判依据,规避主观判断偏差,精准、公正地反映模型真实性能。
- 精准排查问题:可快速识别模型退化、过拟合、对齐不足、幻觉严重等各类问题,为后续迭代优化、参数调优提供明确方向。
2. 核心评估指标体系
针对RLHF、PPO、DPO三类主流对齐模型,根据实用性、真实性、安全性三大核心维度构建标准化自动化评估指标体系,所有指标均可量化、可落地、可横向对比:
2.1 偏好对齐核心指标(对齐效果核心)
该类指标用于直接评判模型偏好对齐的优劣程度,是对齐训练的核心验收标准:
- 偏好胜率:统计优化后模型相对原始SFT模型的优质输出占比,数值越高,代表对齐优化效果越好。
- 平均奖励分数:通过奖励模型对批量样本统一打分,统计整体平均分,直观反映模型整体输出质量,主要适配PPO/RLHF模型评测。
- 概率差值:DPO专属核心评测指标,统计模型对优劣回答的生成概率差值,差值越大,模型的偏好区分能力越强,对齐效果越好。
2.2 模型基础能力指标(防能力退化)
该类指标用于验证对齐训练不会破坏模型原始基础能力,有效规避过度对齐导致的模型能力退化问题:
- 困惑度:用于评估模型输出流畅度,数值越低,代表语句通顺度越高、逻辑连贯性越强。
- 语义相似度:检测模型回答内容与用户提问意图的匹配度,有效杜绝答非所问、偏离主题等问题。
- 指令匹配度:验证模型对复杂、多条件指令的理解与执行能力,保障模型基础可用性与实用性。
2.3 安全与稳健性指标(落地合规保障)
该类指标用于检测模型输出安全性与复杂场景适配稳定性,是模型商用落地的核心合规保障:
- 幻觉率:统计模型输出虚假信息、错误知识的占比,量化模型真实性优化效果。
- 不良内容生成率:检测模型输出暴力、歧视、谣言等违规内容的概率,精准验证模型安全过滤能力。
- 稳健性得分:测试模型在模糊指令、歧义提问、复杂场景下的输出稳定性,适配真实复杂的落地场景。
3. 评估落地技巧
为保障自动化评估结果客观精准、具备实际迭代参考价值,实操落地过程中需遵循两大核心原则,规避评测误区、保障迭代有效性:
3.1 分层评估原则
严格遵循“基础能力→对齐效果→安全鲁棒性的分层评测顺序,循序渐进完成全维度验证:
- 优先验证模型基础能力无退化,确保模型基础功能正常、可用好用;
- 再精准评测对齐偏好效果,量化验证优化带来的能力提升;
- 最后检测模型安全鲁棒性,确保模型输出合规稳定,满足落地要求。
2. 对比评估原则
所有评测均以原始SFT模型为基准对照组,横向对比PPO、DPO优化后的模型指标变化:
- 精准量化对齐优化带来的效果提升,直观体现技术迭代价值;
- 及时排查模型参数退化、过拟合、优化失效等各类问题;
- 为后续模型迭代、参数调优、数据优化提供精准的数据支撑。
八、应用实践示例
1. SFT监督微调示例
SFT是所有对齐技术的前置核心,本示例实现基础的指令监督微调,搭建对齐基准模型,为后续PPO、DPO优化提供稳定底座。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments
from trl import SFTTrainer

# 1. 加载基座模型与分词器
model_path = "qwen-7b-base"
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    torch_dtype=torch.float16,
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_path)
tokenizer.pad_token = tokenizer.eos_token

# 2. 构造极简指令微调数据集
train_data = [
    {"instruction": "解释什么是大模型对齐", "output": "大模型对齐是通过精细化微调,让模型输出贴合人类偏好、价值观与使用习惯的优化流程,主要解决模型幻觉、答非所问、输出不规范等问题。"},
    {"instruction": "简述SFT的作用", "output": "SFT监督微调可以规范模型输出格式、夯实指令理解能力,为RLHF、DPO等高阶对齐技术提供稳定的基准模型。"}
]

# 3. 配置训练参数
train_args = TrainingArguments(
    output_dir="./sft_model",
    per_device_train_batch_size=4,
    learning_rate=2e-5,
    num_train_epochs=3,
    fp16=True,
    logging_steps=10,
    save_strategy="epoch"
)

# 4. 初始化SFT训练器并启动微调
trainer = SFTTrainer(
    model=model,
    tokenizer=tokenizer,
    args=train_args,
    train_dataset=train_data,
    dataset_text_field="output",
    max_seq_length=512
)

# 执行微调,输出SFT基准模型
trainer.train()
trainer.save_model("./sft_baseline_model")
print("SFT监督微调完成,已生成对齐基准模型")
2. PPO强化学习对齐示例
本示例基于SFT基准模型+奖励模型,实现RLHF第三阶段PPO迭代优化,包含样本采样、奖励打分、KL约束更新核心逻辑,还原经典RLHF+PPO对齐流程。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, AutoModelForSequenceClassification
from trl import PPOTrainer, PPOConfig
from datasets import Dataset

# 1. 加载SFT基准模型、奖励模型与分词器
sft_model_path = "./sft_baseline_model"
reward_model_path = "./reward_model" # 预训练完成的RM奖励模型

model = AutoModelForCausalLM.from_pretrained(sft_model_path, torch_dtype=torch.float16, device_map="auto")
ref_model = AutoModelForCausalLM.from_pretrained(sft_model_path, torch_dtype=torch.float16, device_map="auto")
reward_model = AutoModelForSequenceClassification.from_pretrained(reward_model_path, torch_dtype=torch.float16, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained(sft_model_path)
tokenizer.pad_token = tokenizer.eos_token

# 2. 配置PPO核心参数(含KL散度约束,规避奖励黑客)
ppo_config = PPOConfig(
    batch_size=4,
    learning_rate=1e-5,
    num_ppo_epochs=2,
    kl_coeff=0.05,  # KL散度约束权重,控制模型更新幅度
    clip_range=0.2,  # PPO裁剪阈值,保障训练稳定
    output_dir="./ppo_rlhf_model"
)

# 3. 构造推理Prompt数据集
prompt_data = Dataset.from_list([
    {"query": "简述RLHF的三阶段流程"},
    {"query": "PPO算法的核心优势是什么"},
    {"query": "大模型对齐的核心目标有哪些"}
])

# 4. 初始化PPO训练器
ppo_trainer = PPOTrainer(
    config=ppo_config,
    model=model,
    ref_model=ref_model,
    tokenizer=tokenizer,
    dataset=prompt_data
)

# 5. 迭代执行PPO对齐训练
for batch in ppo_trainer.dataloader:
    # 批量采样模型输出
    query_tensors = batch["input_ids"]
    response_tensors = ppo_trainer.generate(query_tensors, max_new_tokens=128)

    # 奖励模型打分,获取量化奖励值
    rewards = reward_model(response_tensors).logits.squeeze(-1)

    # PPO参数更新,小幅迭代优化模型
    stats = ppo_trainer.step(query_tensors, response_tensors, rewards)
    print(f"PPO迭代训练完成,本轮训练指标:{stats}")

# 保存最终对齐模型
ppo_trainer.save_model("./ppo_final_align_model")
print("RLHF-PPO强化学习对齐训练完成")
3. DPO轻量化对齐示例
本示例实现极简DPO对齐,无需奖励模型、无需复杂PPO迭代,仅通过优劣偏好数据即可完成对齐,完整复现DPO轻量化、低成本的核心优势。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments
from trl import DPOTrainer

# 1. 加载SFT基准模型与分词器
model_path = "./sft_baseline_model"
model = AutoModelForCausalLM.from_pretrained(model_path, torch_dtype=torch.float16, device_map="auto")
ref_model = AutoModelForCausalLM.from_pretrained(model_path, torch_dtype=torch.float16, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained(model_path)
tokenizer.pad_token = tokenizer.eos_token

# 2. 构造DPO专属偏好数据集(prompt+优质回答+劣质回答)
dpo_train_data = [
    {
        "prompt": "对比RLHF和DPO的差异",
        "chosen": "RLHF是三阶段复杂对齐流程,依赖奖励模型和PPO迭代,效果顶尖但成本极高;DPO是轻量化方案,无需奖励模型,训练简单、成本更低,效果接近PPO。",
        "rejected": "RLHF和DPO没有区别,都是大模型微调算法。"
    },
    {
        "prompt": "什么是模型奖励黑客问题",
        "chosen": "奖励黑客是模型为追逐高分,刻意生成冗余套话、虚假内容的现象,通过KL散度约束可有效规避,是RLHF训练的核心风险。",
        "rejected": "奖励黑客是模型自动优化打分的正常功能。"
    }
]

# 3. 配置DPO训练参数
dpo_args = TrainingArguments(
    output_dir="./dpo_align_model",
    per_device_train_batch_size=4,
    learning_rate=1.5e-5,
    num_train_epochs=3,
    fp16=True,
    logging_steps=10,
    save_strategy="epoch"
)

# 4. 初始化DPO训练器并启动训练
dpo_trainer = DPOTrainer(
    model=model,
    ref_model=ref_model,
    args=dpo_args,
    train_dataset=dpo_train_data,
    tokenizer=tokenizer,
    beta=0.1,  # DPO温度参数,控制优化强度
    max_length=512,
    max_prompt_length=128
)

# 执行轻量化对齐训练
dpo_trainer.train()
dpo_trainer.save_model("./dpo_final_align_model")
print("DPO轻量化对齐训练完成,低成本完成模型偏好优化")
九、总结
RLHF是大模型对齐领域经典且完整的技术体系,依托人工反馈标注、奖励模型建模、强化学习多轮迭代的完整链路,让模型精准贴合人类偏好,是顶级商用大模型高精度对齐的核心基石,整体效果顶尖,但流程复杂、成本高昂。PPO作为RLHF的核心执行算法,凭借小幅稳定迭代的约束机制,解决了大模型强化学习训练不稳定的核心痛点,是传统高精度对齐场景的最优技术选择。
而DPO是对齐技术迭代优化的核心产物,跳出了传统强化学习的复杂框架,以极简的概率对比逻辑剔除所有冗余模块,用极低的算力与人力成本,实现无限接近PPO的对齐效果,彻底降低了大模型偏好优化的落地门槛,成为当下轻量化对齐的主流方案。
三项技术的迭代逻辑,本质是工业界对效果、成本、效率三大核心要素的持续平衡:从极致效果导向的复杂商用方案,到兼顾效果与成本的轻量化普惠方案,精准适配不同层级、不同预算、不同需求的落地场景。同时,自动化量化评估是大模型对齐落地的最后关键闭环,通过标准化指标精准验证模型优化效果,让模型迭代从主观试错变为数据驱动的精准优化。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号