一张图读懂:量化到底什么时候省电
原创
一张图读懂:量化到底什么时候省电
原创
四王爷
发布于 2026-09-16 13:54:04
发布于 2026-09-16 13:54:04
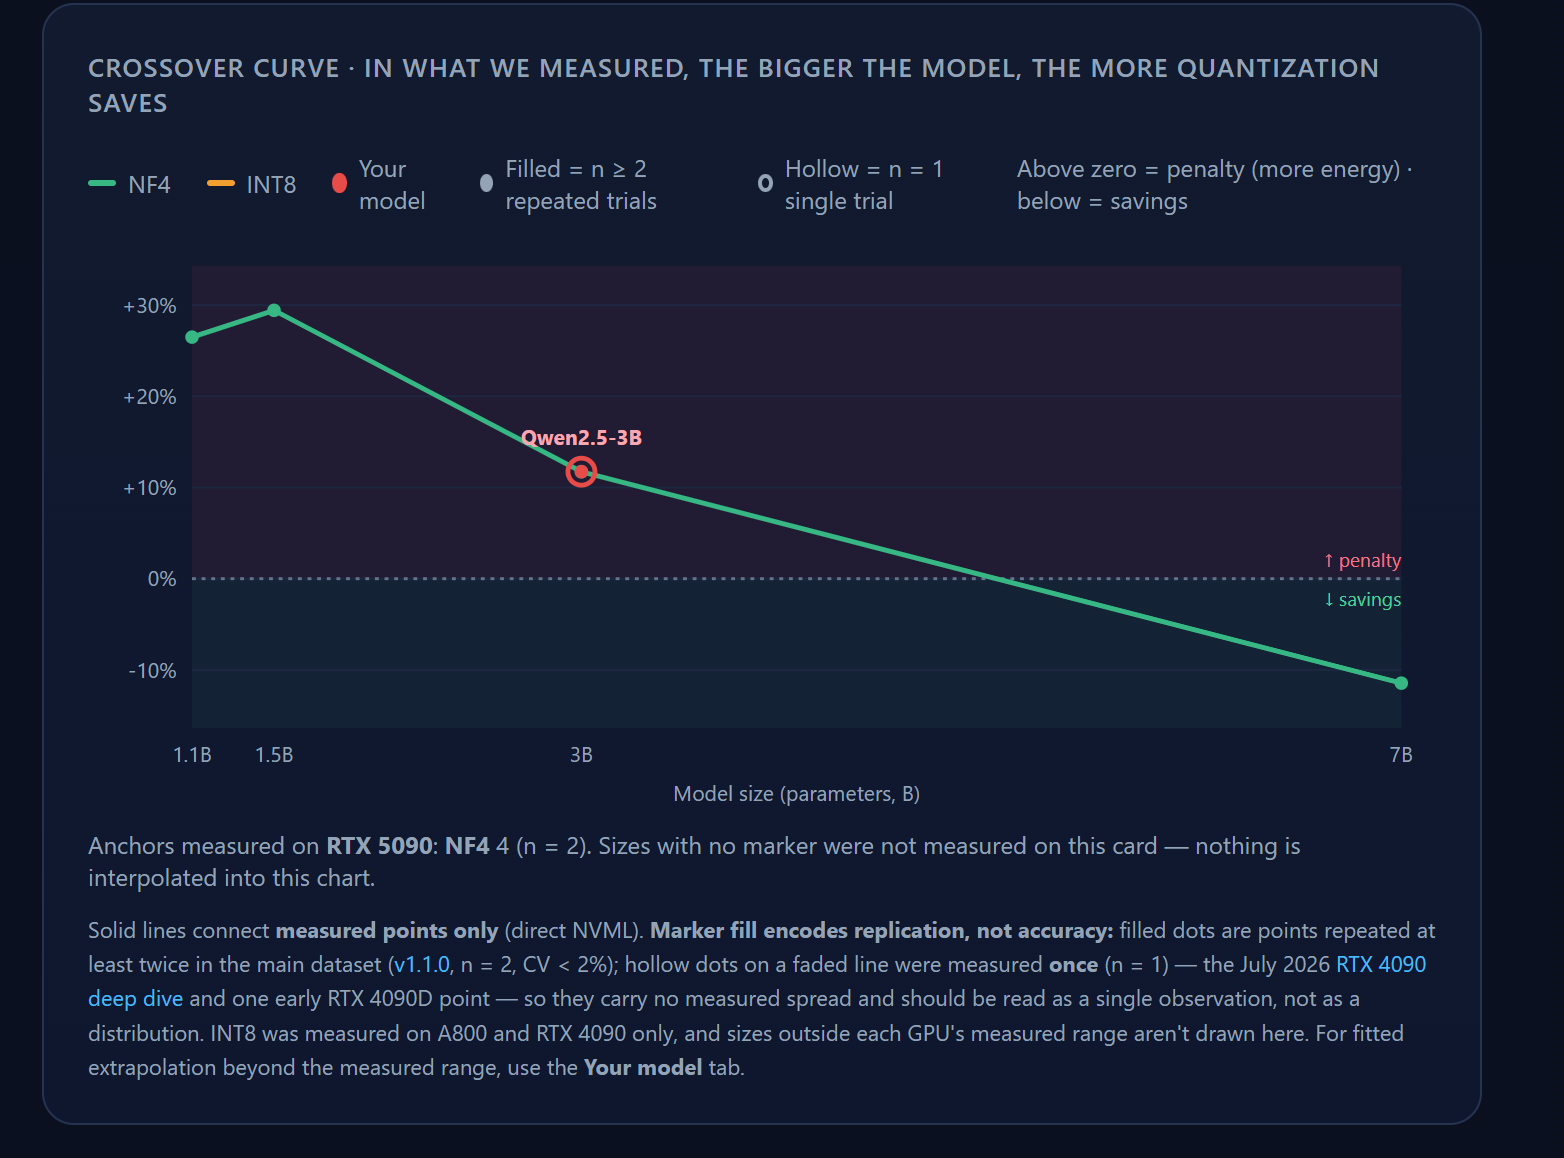
这张图叫 crossover curve,横轴是模型规模(1.1B–7B),纵轴是 NF4 量化相对 FP16 的每 token 能耗变化:零线以上是正数,量化更费电(penalty);零线以下是负数,量化省电(savings)。绿线是 NF4,橙线是 INT8,红圈是你自己测出来的点(Your model)。
图要说的话浓缩在标题里,而且标题本身就带着分寸——**"in what we measured"(在我们测过的范围内),模型越大,量化越省**。RTX 5090 上的 NF4 锚点:1.1B 时 +27%,1.5B 时 +29%,3B 时 +11%,到 7B 转成 −11%。也就是说:小模型量化是稳亏的,1.5B 附近亏得最狠;穿越零点的临界规模落在 3B 和 7B 之间;过了临界点,量化才开始把能耗省回来。这和数据集的另一条结论完全一致——比特数预测的是显存占用,预测不了能耗的正负号,符号由规模和架构决定。
图中红圈是 Qwen2.5-3B 的 overlay 点,+11%,恰好压在 3B 的实测锚点上。这个功能没有任何上传:你的数字被编码进链接本身,打开就把自己叠到曲线上,跟站内数据当场对齐。
这张图真正值得学的,是它对"什么没测"的处理:
一,**只连实测点,不做插值**。线是折线不是平滑曲线,1.1B 和 7B 之间长什么样,图不替你想象。脚注明说:没有锚点的规模,什么都不会被画进图里。
二,**标记的实心与空心编码的是"重复次数",不是"准确度"**。实心点 = 至少重复 2 次(数据集 v1.1.0,n=2,变异系数小于 2%);空心点 = 只测过一次(七月 RTX 4090 的 deep dive 和一个早期 4090D 点),脚注特意提醒:单次观测要当作一个点来读,不要当成一个分布。这个区分太重要了——很多图表把"测了一次"和"测了多次"画得一模一样,读者无从知道误差棒该不该存在。
三,**没测过的组合不画**。INT8 只在 A800 和 RTX 4090 上测过,图上就只画那里;每张卡没覆盖的规模区间,线直接断掉。想看超出实测范围的外推?图不给你,让你去 Your model 标签页看拟合模型的外推——实测和拟合被明确分成两个世界,不混在一张图里冒充同一类证据。
这张图最容易读错的地方也值得点一下:它不是"量化省电曲线",而是"某张卡上、某几个规模、实测出来的能耗符号"。换一张卡、换一个运行时,锚点会动,临界点也会动。图给你的不是一条定律,而是一组钉在硬件上的实测坐标——以及一组没钉上的、诚实的空白。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号