台积电COUPE技术进展及演进路线 | SEMICON Taiwan 2026

台积电COUPE技术进展及演进路线 | SEMICON Taiwan 2026
光芯
发布于 2026-09-16 20:57:21
发布于 2026-09-16 20:57:21
2026年8月31日,SEMICON Taiwan现场,台积电发表主题为"How COUPE Redefines AI Interconnects"的技术演讲。这场演讲从AI算力的指数级增长切入,到铜线互连的物理极限,再到台积电COUPE的架构细节与性能数据,勾勒出台积电在AI时代光I/O路线上的最新进展和完整图景。
01 AI算力狂奔,互连成了新瓶颈
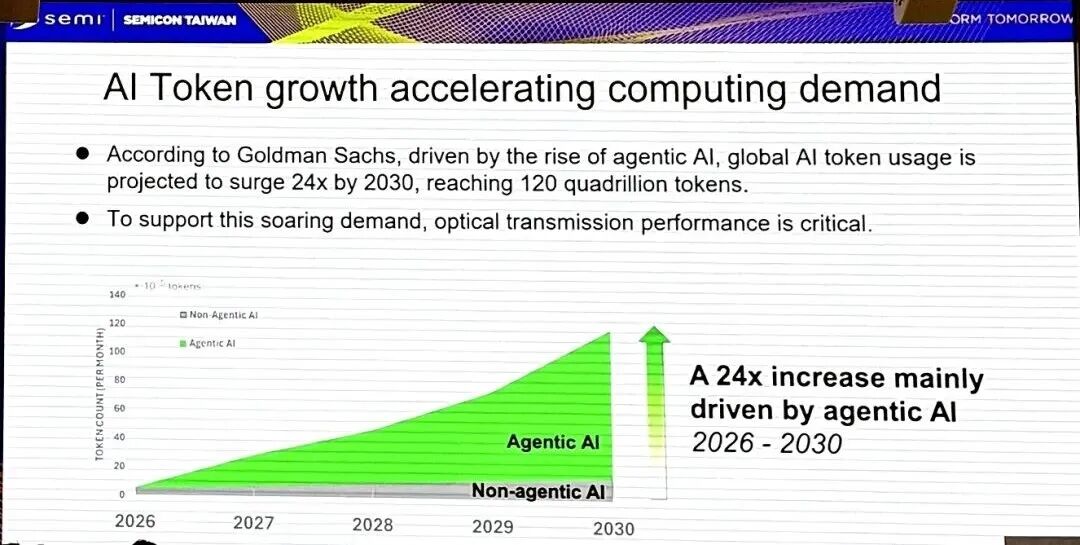
演讲开篇即给出一组关键预测:据高盛数据,受智能体AI(agentic AI)崛起的驱动,全球AI Token使用量从2026年到2030年预计将激增24倍,达到每月120千万亿(120 quadrillion),要支撑如此庞大的算力需求,光传输性能是关键前提。
AI增长背后的I/O之墙
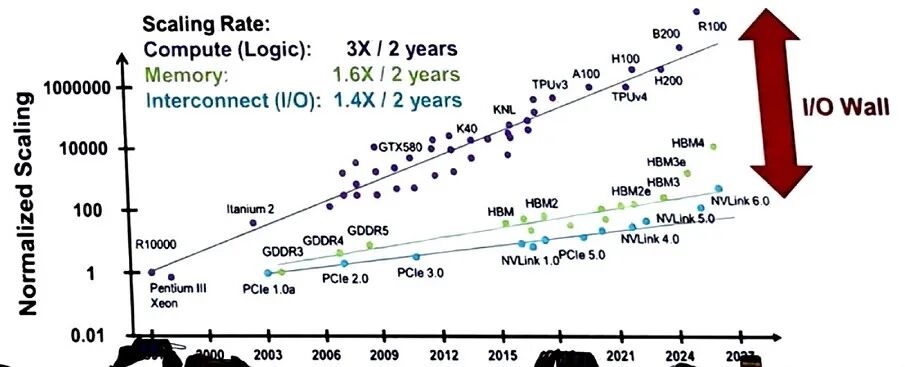
台积电用归一化趋势曲线图点破真正瓶颈:AI算力(logic)每两年增长3倍,内存带宽每两年增长1.6倍,而互连I/O带宽每两年仅增长1.4倍,三者之间持续扩大的剪刀差形成所谓了的"I/O Wall"——算力跑得越快,数据搬运越跟不上。如何提升I/O传输性能已成为AI系统继续扩展的关键命题。
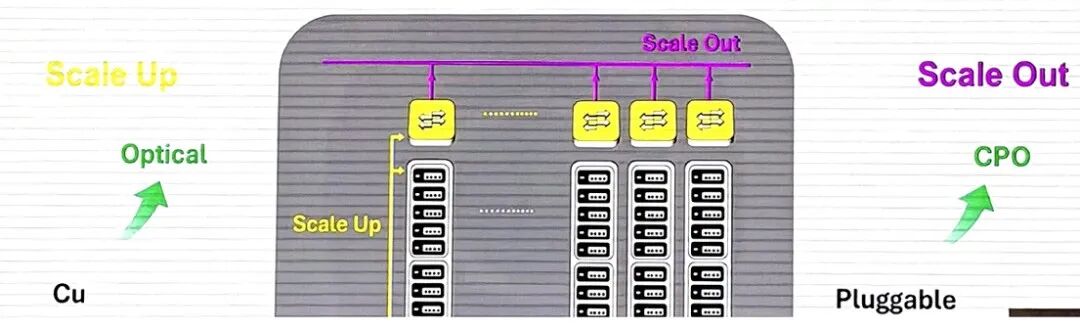
传统铜互连在高频工作下受短距离限制,无法同时满足scale-up(单机柜内GPU互连)和scale-out(跨机柜集群互连)的需求。光传输则可以扩展信号传输距离,为两种扩展场景都提供了可行路径。
从铜到光:四代互连的能效跃迁
台积电给出了从铜互连到光互连的四代演进路径,以及每一代的能效与延迟对比:
- 铜线(Cu Wire):能效基准1倍,延迟基准1倍
- 可插拔光模块(Pluggable Optics):能效2倍,延迟1倍
- 共封装光学(CPO, Co-Packaged Optics):能效4倍,延迟降至0.1倍以下
- 中介层上光学(OOI, Optics on Interposer):能效10倍,延迟降至0.05倍以下
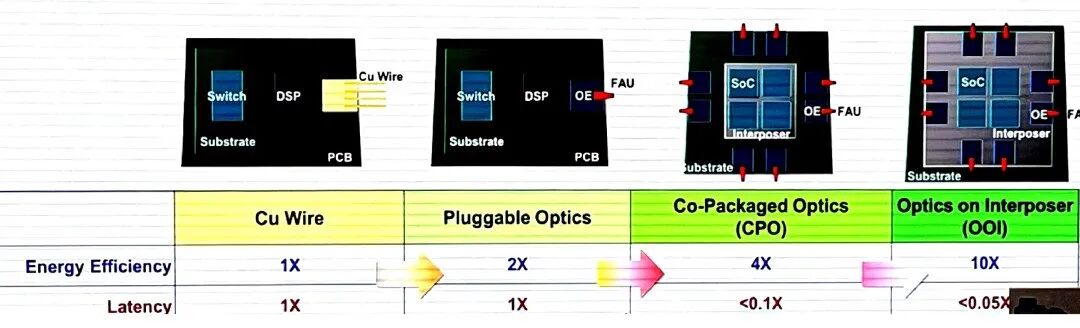
相比传统铜线,CPO与OOI可实现4到10倍的能效提升,以及10到20倍的延迟降低。台积电明确指出:高度集成、低损耗的光引擎,是实现这一跃迁的关键。
CPO的两种实现形式
在集成方式上,台积电区分了两条技术路线:
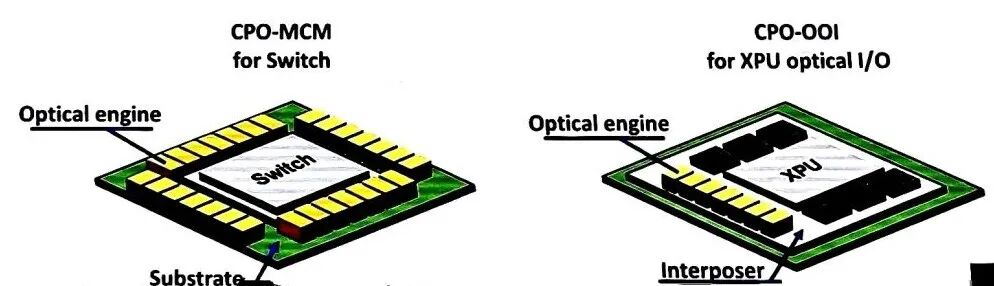
- CPO-MCM采用多芯片模块(MCM)方案,将光引擎集成在基板上,主要面向交换机(Switch)场景。
- CPO-OOI则将光引擎直接集成到XPU的中介层(Interposer)上,面向XPU光I/O场景,集成度更高。
- 两者的共同目标是缩短电信号传输路径、降低功耗,但在集成层级和目标器件上各有侧重。
02 COUPE是什么:台积电的硅光子集成方案
1. 台积电AI集成平台的三层架构
在台积电的AI集成平台中,COUPE作为光引擎模块,与CoWoS封装、SoIC堆叠等先进封装技术协同工作:
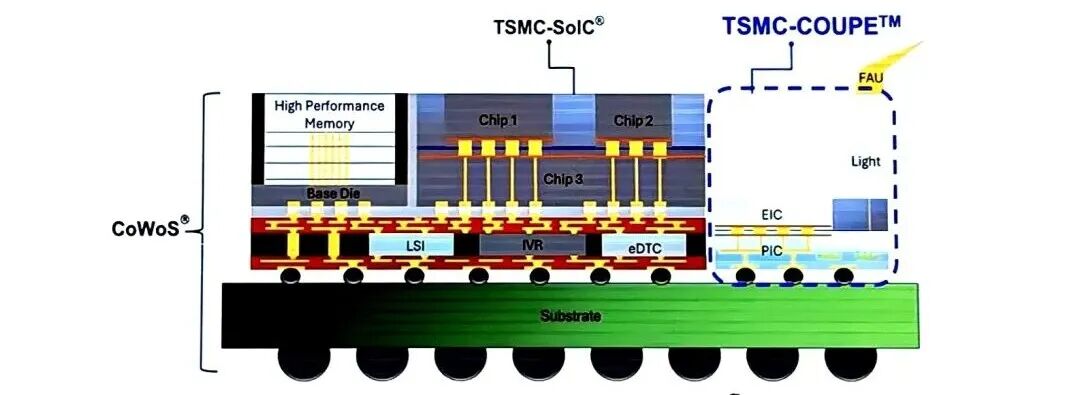
- CoWoS:提供高性能内存与逻辑芯片的集成封装基础。
- SoIC:通过Chip 1/2/3与Base Die的堆叠,实现LSI、MR、eDTC等有源元件的三维集成。
- COUPE:在封装底部集成EIC与PIC,通过FAU(光纤阵列单元)实现光信号进出。
2. COUPE堆叠结构
COUPE全称为Compact Universal Photonic Engine(紧凑型通用光子引擎)。其核心技术特征包括:
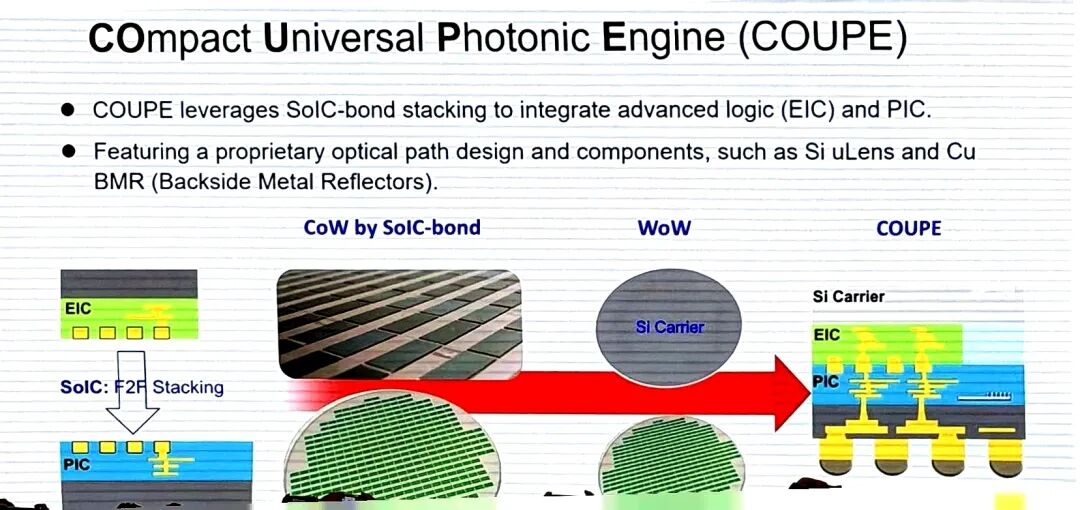
- 利用SoIC键合堆叠(F2F Stacking),将先进逻辑芯片EIC与光子芯片PIC面对面堆叠。这一堆叠方式从到CoW(Chip on Wafer)再到WoW(Wafer on Wafer),最终形成COUPE的完整路径。
- 采用专有的光路设计与组件,包括硅微透镜(Si uLens)和背面金属反射器(Cu BMR, Backside Metal Reflectors)。
3. Coupe耦合方式:GC与EC
COUPE提供两种光耦合方案,对应不同的应用需求:
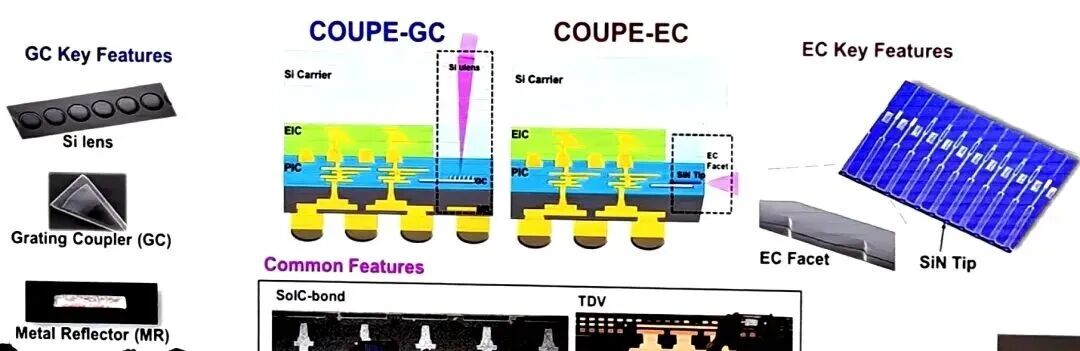
- 光栅耦合(GC):采用Si微透镜、铜背面金属反射器(Cu BMR)以及Si/SiN光栅耦合器等关键组件;
- 边缘耦合(EC):采用耦合端面(EC facet)和SiN尖端(SiN tip)等关键组件。
- 两种方案共享SoIC-bond和TDV(Through Dielectric Via)等基础特征。
4. 收发关键器件
在收发链路的关键器件上,COUPE的配置如下:
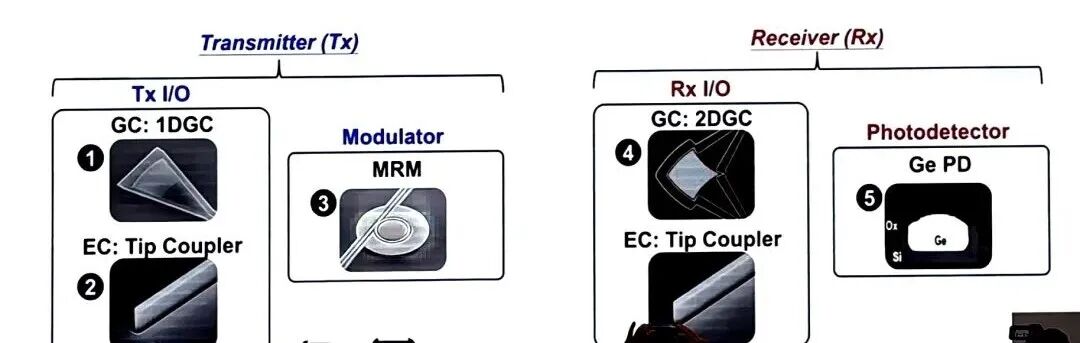
- 发射端Tx: 1D GC(一维光栅耦合器)或EC Tip Coupler(尖端耦合器)、微环调制器(MRM)
- 接收端Rx:2DGC(二维光栅耦合器)或EC Tip Coupler、锗光电探测器(Ge PD)
5. 完整光子器件PDK
台积电同时提供完整的光子器件工艺设计套件(PDK, Process Design Kit),覆盖Si和SiN两大材料体系,帮助客户设计硅光子(SiPh)产品并缩短上市时间。PDK包含的器件类型包括:
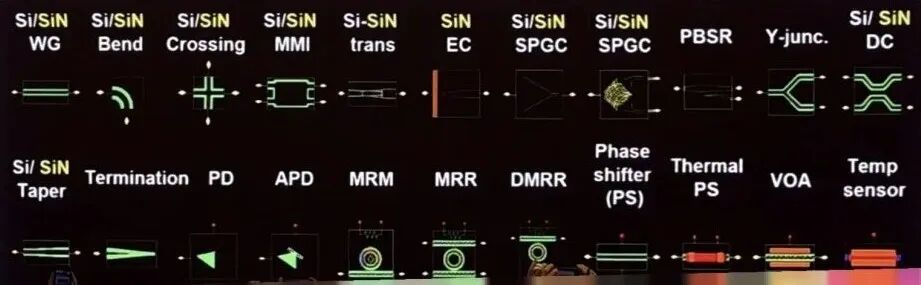
- 无源器件:波导(WG)、弯曲波导(Bend)、交叉波导(Crossing)、多模干涉仪(MMI)、Si-SiN转换(trans)、边缘耦合器(EC)、单偏振光栅耦合器(SPGC)、偏振分束旋转器(PBSR)、Y型分束器(Y-junc)、定向耦合器(DC)、锥形波导(Taper)、终端(Termination)。
- 有源器件:光电探测器(PD)、雪崩光电二极管(APD)、微环调制器(MRM)、微环谐振器(MRR)、双微环谐振器(DMRR)、相移器(PS)、热相移器(Thermal PS)、可变光衰减器(VOA)、温度传感器(Temp sensor)。
03 Coupe带宽扩展路径及路线
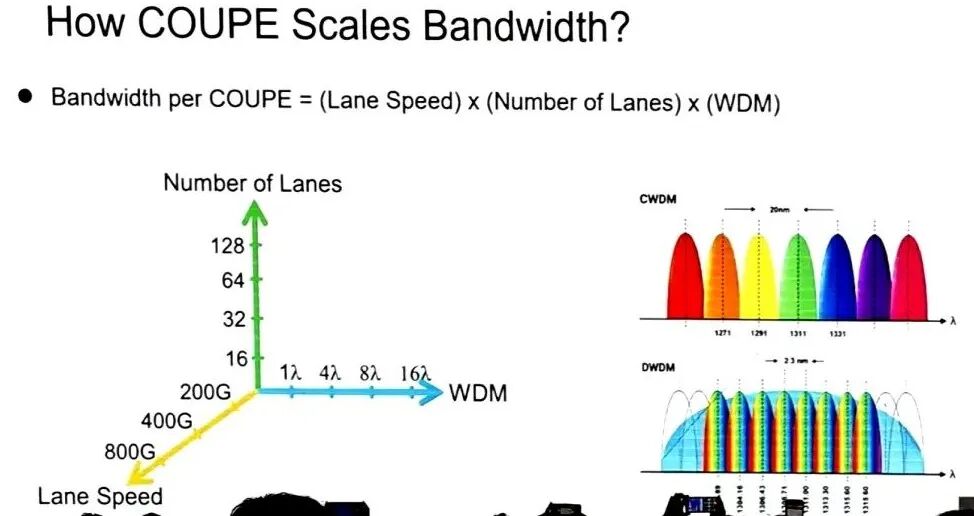
演讲用一个简洁的公式概括了单COUPE的带宽扩展逻辑:
带宽 = 通道速率× 通道数量× 波分复用
基于这个公式,台积电提出了两条互补的扩展路径:
路径一:Fast and Narrow(快而窄)——主攻通道速率和数量
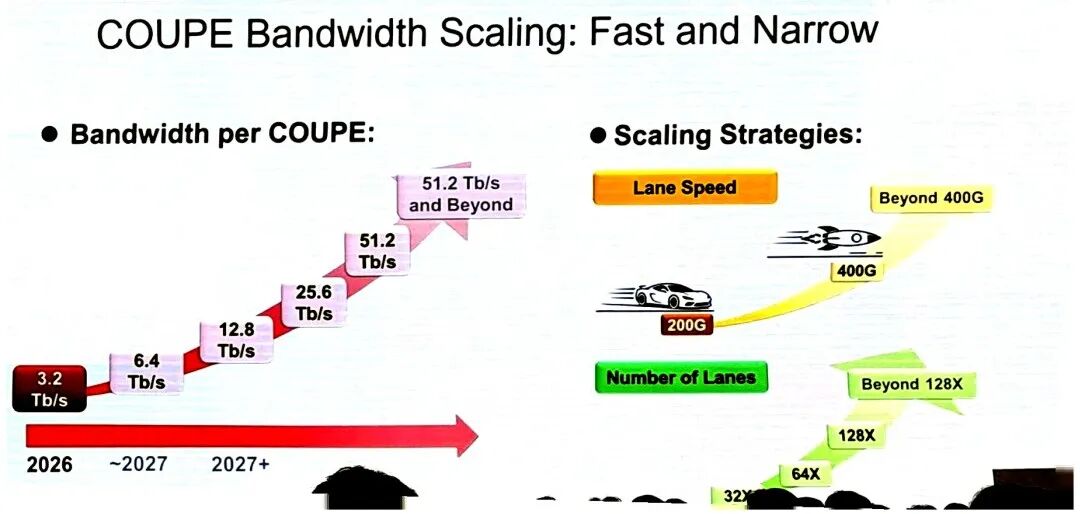
- 通道速率(Lane Speed)从200G提升至400G,并向400G以上演进。
- 通道数量(Number of Lanes)从32通道扩展至64、128通道,并向128通道以上演进。
- 这条路径的代价是撞上400G/lane的材料瓶颈,需要更高速的调制器、探测器和500GHz fT的SiGe工艺。
路径二:Slow and Wide(慢而宽)——主攻WDM波长数
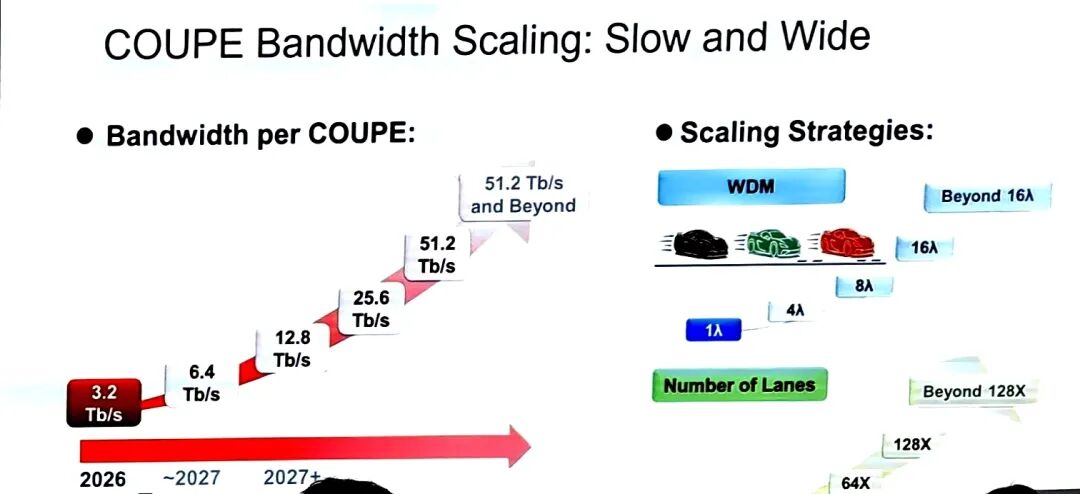
- 波分复用(WDM):波长数从1波长(1λ)扩展至4λ、8λ、16λ,并向16波长以上演进。
- 通道数量:同样从64通道扩展至128通道及以上。
- 这条路径的代价是微环对温度敏感,且需要更多波长的梳状光源。
COUPE单引擎带宽的明确路线图
- 2026年:3.2 Tb/s
- 约2027年:6.4 Tb/s
- 2027年及以后:12.8 Tb/s、25.6 Tb/s、51.2 Tb/s及以上
- 在波分复用方案上,COUPE同时支持CWDM(粗波分复用,20nm间距)和DWDM(密集波分复用,2.3nm间距),以适配不同的应用场景。
04 Coupe性能进展及规划
台积电在演讲中公布了多项具体的性能改进数据,展示了COUPE从2025到2026年的工程进展。
1. 微环调制器(MRM)带宽
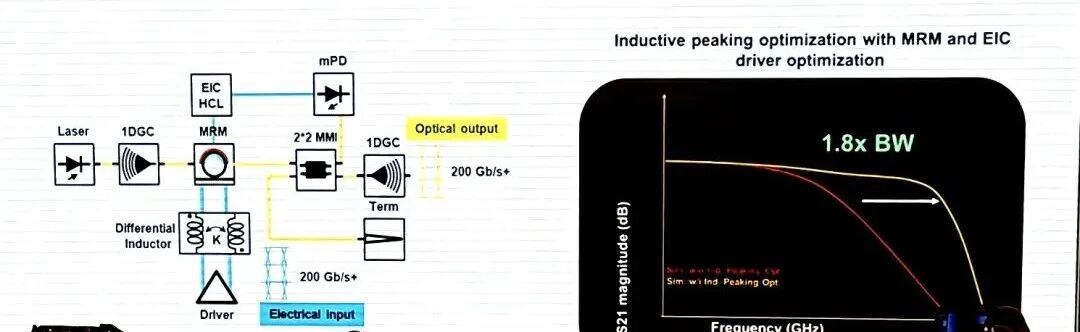
通过电感峰化(inductive peaking)优化,以及MRM与EIC驱动器的共同优化,模拟结果显示微环调制器的带宽可提升约1.8倍,支持200 Gb/s以上的传输速率。
2. 光栅耦合(GC)效率
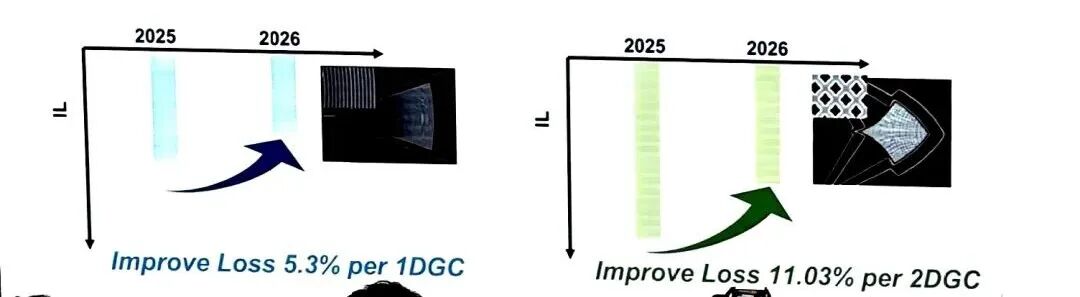
从2025到2026年,COUPE的1DGC插入损耗改善5.3%(推测<1dB),2DGC插入损耗改善11%(推测<1.8dB)。这两项改进直接降低了光链路的整体损耗预算。突破电互连极限:台积电ISSCC 2026硅光子学平台与400G+光链路技术全解析
3. 端面耦合(EC)效率
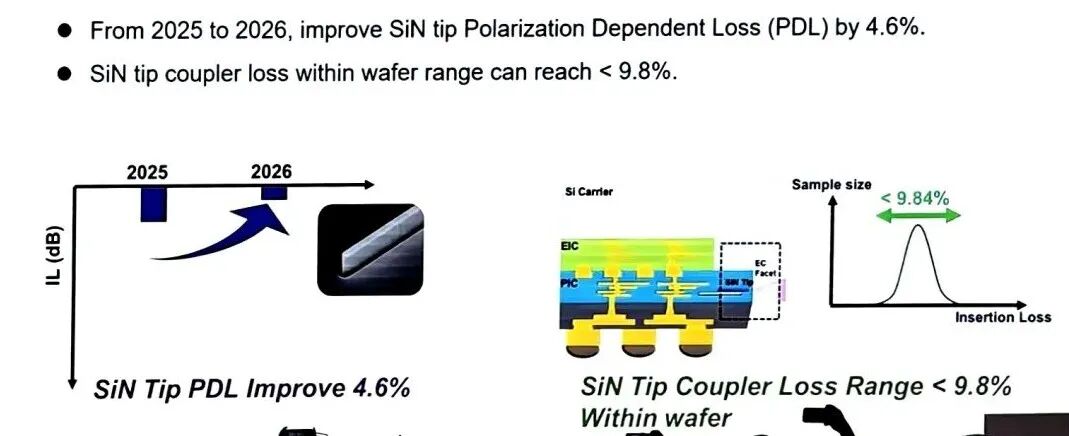
- SiN尖端耦合器的偏振相关损耗(PDL)改善了4.6%。 注:25年ofc报道的是1dB@小模场光纤耦合,3σ<0.5dB,这里报道的估计是提升到了0.73dB左右。OFC 2025:TSMC低损耗PECVD氮化硅平台
- SiN尖端耦合器的片内损耗分布可控制在9.8%以内——这一数字的意义不在于能效,而在于制程一致性:一片晶圆上所有裸片的耦合损耗差异压在10%以内,是良率语言而非研发语言。
4. 异质集成的下一步:将调制器、SOA和光源做到背面
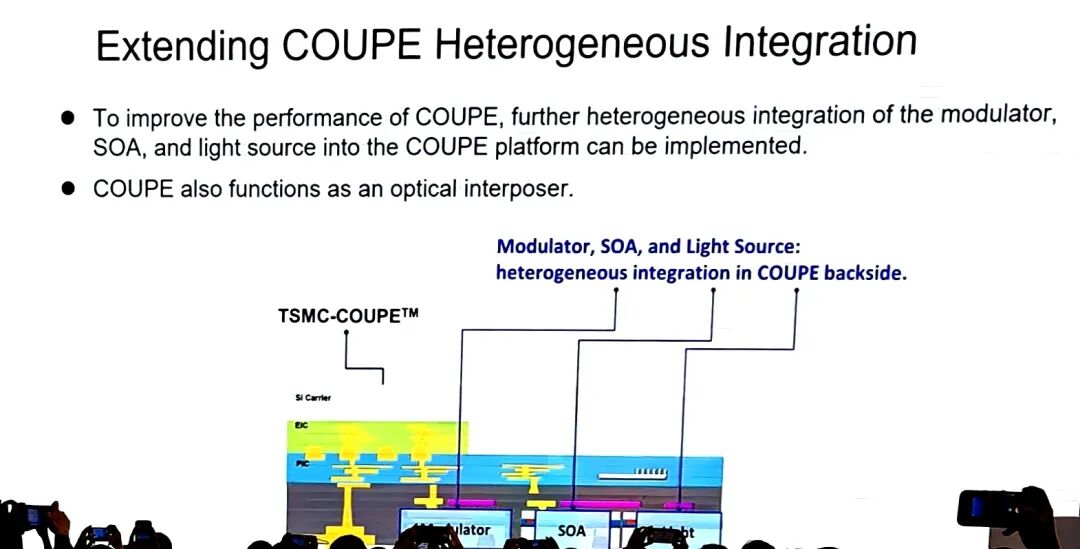
为进一步提升COUPE性能,台积电提出了异质集成的扩展方向:在COUPE背面进一步集成调制器(Modulator)、半导体光放大器(SOA)和光源(Light Source)。此外,COUPE本身也可作为光中介层(optical interposer)使用,为更复杂的光电混合系统提供基础。
05 结论:光I/O是AI与HPC的必选项
演讲最后的总结部分给出了三个核心判断:
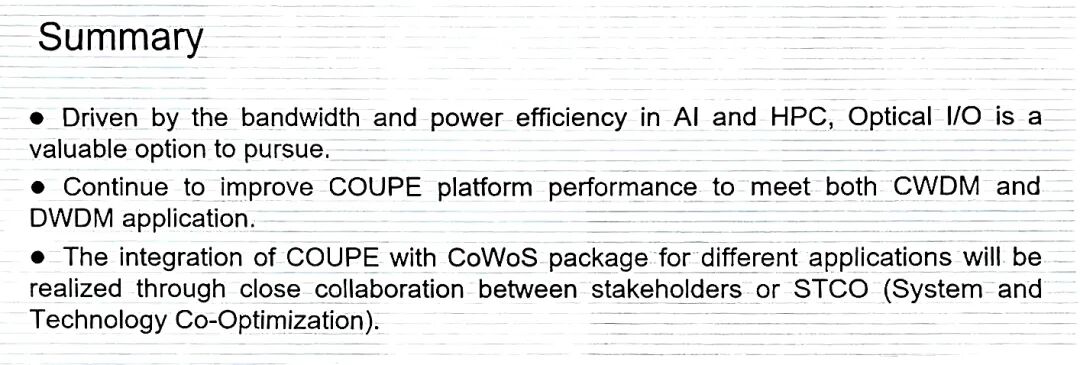
- 受AI与高性能计算(HPC)对带宽和能效的双重需求驱动,光I/O是一个值得持续投入的有价值方向。
- 台积电将持续提升COUPE平台性能,以同时满足CWDM和DWDM两类应用需求。
- COUPE与CoWoS封装的集成面向不同应用场景,将通过产业链利益相关方的密切协作,或以STCO(System and Technology Co-Optimization,系统与技术协同优化)的方式实现。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-03,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号